Datenqualitätsmetriken: Ein vollständiger Leitfaden für 2026
|
7
min. Lesezeit
Ein Dashboard sah um 8:00 Uhr morgens noch gut aus. Bis 9:15 Uhr stellte die Finanzabteilung die Umsatzdaten infrage, die Logistik ging einem Versandproblem nach und das Datenteam versuchte herauszufinden, ob das Problem bei der Ingestion, der Transformation oder in einem Quellsystem begann, dessen Struktur sich über Nacht geändert hatte.
Das ist die typische Situation, in der sich Unternehmen befinden, wenn sie beginnen, sich ernsthaft mit Datenqualität zu beschäftigen. Nicht im Moment der Theorie, sondern im Moment des Scheiterns. Ein fehlendes Adressfeld blockiert den Versand. Ein doppelter Kundeneintrag verfälscht einen KPI. Eine veraltete Tabelle speist ein Modell, das gestern noch präzise und heute unzuverlässig war.
Datenqualitätsmetriken sind das Mittel, mit dem Sie aufhören, aus dem Bauch heraus zu argumentieren, und anfangen, auf der Grundlage von Beweisen zu handeln. Sie verwandeln ein „Gefühl, dass etwas nicht stimmt“ in messbare Signale, wiederholbare Prüfungen und Incident-Workflows, denen die Menschen vertrauen können.
Inhaltsverzeichnis
Warum Datenqualitätsmetriken im Jahr 2026 unverzichtbar sind
Was Metriken in der Praxis verändern
Die sechs Kerndimensionen der Datenqualität erklärt
Genauigkeit
Vollständigkeit
Konsistenz
Timeliness
Gültigkeit
Eindeutigkeit
Wie man Kernmetriken der Datenqualität berechnet
Beginnen Sie mit einem Metrik-Vertrag
SQL-Formeln, die Teams tatsächlich nutzen
Schwellenwerte gehören zu Anwendungsfällen, nicht zu Tabellen
Von rohen Metriken zu handlungsrelevanten Erkenntnissen
Schwellenwerte, denen die Menschen vertrauen werden
Alarmierung, die Teams nicht dazu erzieht, Warnungen zu ignorieren
Stichproben und Baselining in unruhigen Umgebungen
Operationalisierung der Datenqualität: Ein KPI-Dashboard-Beispiel
Was das Dashboard auf einen Blick zeigt
Was die einzelnen Teams damit machen
Fortgeschrittene Herausforderungen, die Standardmetriken nicht beantworten
Mikrofehler, die sich in guten Durchschnittswerten verbergen
Warum ein einziger Score schwieriger ist, als es klingt
Wie Data Observability-Plattformen Qualitätsmetriken automatisieren
Warum Datenqualitätsmetriken im Jahr 2026 unverzichtbar sind
Teams stellen den Bedarf an Datenqualitätsmetriken meist nach einem vermeidbaren Vorfall fest. Ein Vorstandsbericht ist fehlerhaft. Eine Feature-Tabelle für maschinelles Lernen ist veraltet. Eine Schemaänderung erfolgt unbemerkt und die nachgelagerte Logik läuft weiter, als wäre nichts passiert.
Das Problem ist nicht nur die schlechte Datenqualität. Das Problem sind schlechte Daten ohne Instrumentierung.
Laut der Zusammenfassung der Datenqualitätsstatistiken von Monte Carlo prognostiziert Gartner, dass 30 % der Unternehmen aufgrund mangelhafter Datenqualität an erfolgreichen datengesteuerten Initiativen scheitern werden, während 41 % der Unternehmen mit der Verwaltung von mehr als 1.000 Datenquellen kämpfen. Bei dieser Größenordnung ist eine manuelle Überprüfung keine Disziplin mehr, sondern Wunschdenken.
Was Metriken in der Praxis verändern
Ein reifes Team fragt nicht: „Ist dieser Datensatz gut?“ Es stellt präzisere, operative Fragen:
Sind die Daten aktuell genug für die Entscheidung, die sie unterstützen sollen?
Sind die erforderlichen Felder für den aktuellen Ladevorgang eingetroffen?
Entsprechen die Datensätze den Geschäfts- und Formatregeln?
Hat sich eine Quelle strukturell verändert, ohne dass ein koordinierter Release stattgefunden hat?
Ist das Problem lokal oder systemisch über Domains und Pipelines hinweg?
Diese Fragen sind es, die das Thema Datenqualität aus der Sprache der governance in die Engineering-Arbeit überführen.
Praktische Regel: Wenn Sie einem Fehlermodus keine Metrik zuordnen können, haben Sie noch keine Monitoring-Strategie. Sie haben eine Richtlinie.
Aus diesem Grund überschneidet sich die Arbeit an der Datenqualität auch oft mit der operativen Telemetrie. Teams, die bereits ein zentralisiertes Log-Management meistern, passen sich in der Regel schneller an, weil sie Baselines, Alarmrauschen, Event-Korrelation und Incident-Ownership bereits verstehen. Datenmetriken benötigen dasselbe Betriebsmodell.
Ein gutes System strebt nicht nach Perfektion. Es misst das, was wichtig ist, auf der richtigen Ebene und mit Schwellenwerten, die an geschäftliche Konsequenzen gekoppelt sind.
Die sechs Kerndimensionen der Datenqualität erklärt
Das Standardvokabular ist nach wie vor wichtig. Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Gültigkeit und Eindeutigkeit sind die sechs Dimensionen, die in der Praxis am häufigsten verwendet werden und sich an dem in dieser Umfrage zusammengefassten ISO/IEC 25012:2008-Rahmen orientieren.
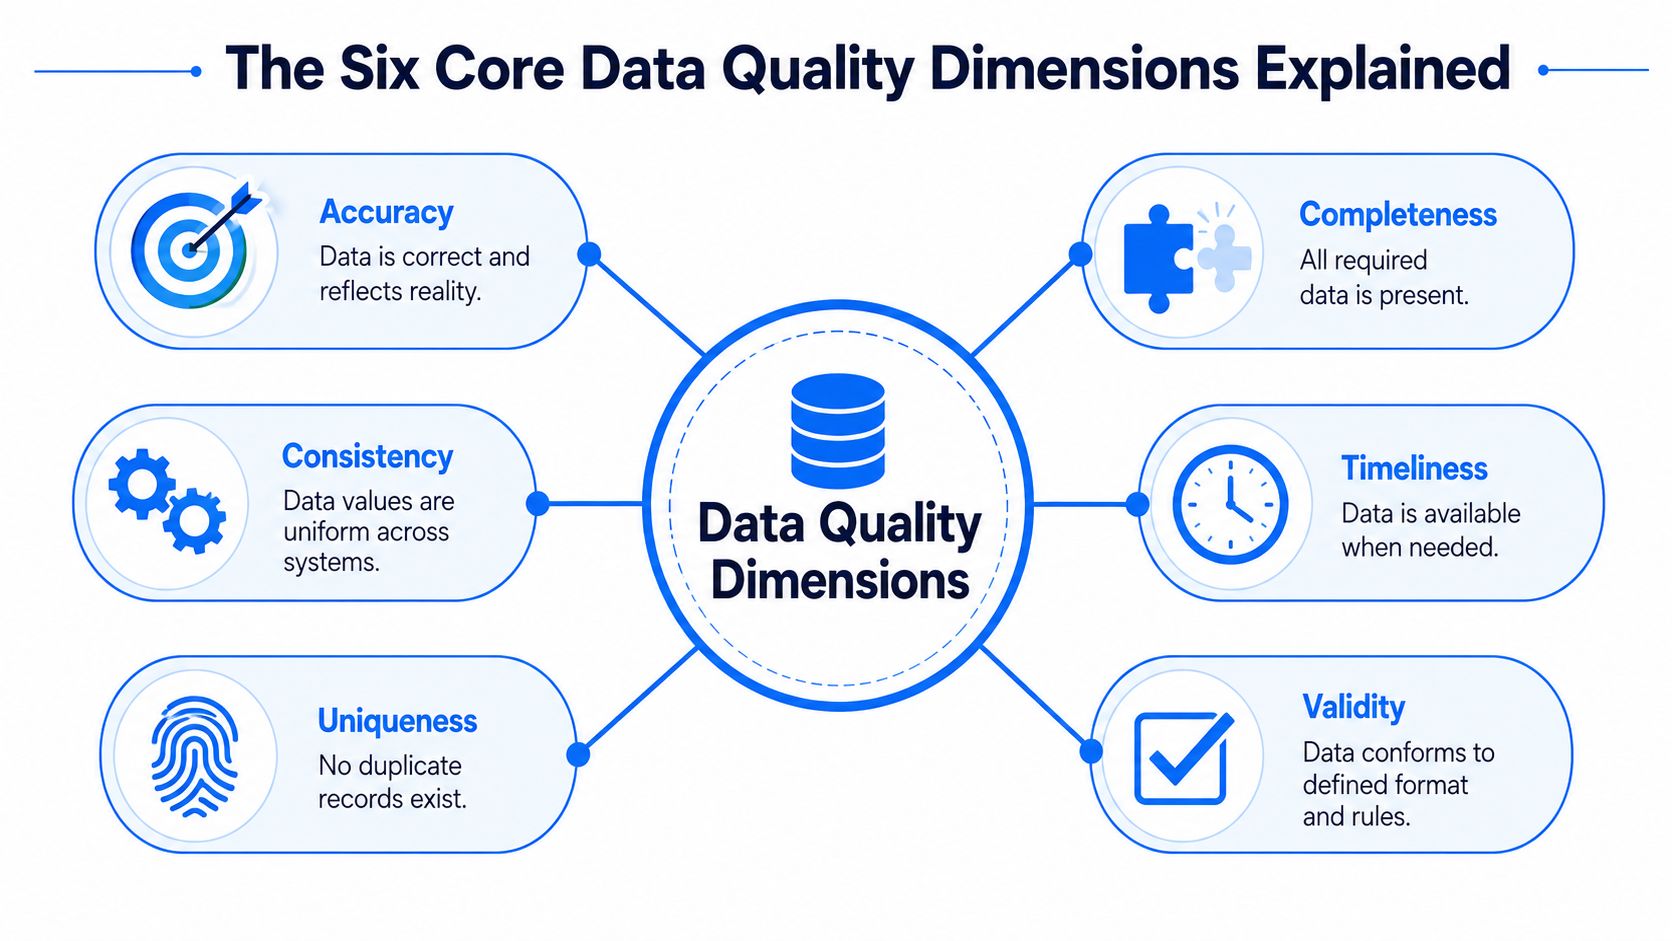
Wenn Sie eine ergänzende Referenz zu Implementierungsdetails suchen, ist dieser Leitfaden über Dimensionen der Datenqualität und wie man sie im großen Maßstab misst nützlich. Der wichtigste Schritt ist jedoch, jede Dimension einer geschäftlichen Fragestellung zuzuordnen.
Genauigkeit
Genauigkeit hinterfragt, ob die Daten die tatsächliche Gegebenheit widerspiegeln, die sie beschreiben sollen.
Eine Kundenadresse kann vollständig und formal korrekt sein, aber dennoch falsch. Ein Produktpreis kann in jeder nachgelagerten Tabelle vorhanden sein und dennoch nicht mit der freigegebenen Quelle übereinstimmen. Fehler in der Genauigkeit sind kostspielig, da die Daten strukturell oft fehlerfrei aussehen.
Geschäftliche Frage: Können wir darauf vertrauen, dass dieser Wert die Realität widerspiegelt?
Vollständigkeit
Die Vollständigkeit misst, ob die erforderlichen Daten vorhanden sind.
Dies ist die Dimension, auf die Teams zuerst stoßen, da Nullwerte leicht zu zählen und zu erklären sind. Wenn bei einer Bestellung die Lieferadresse fehlt, kann das Lager sie nicht versenden. Wenn in einer Patientenakte ein erforderliches Attribut fehlt, brechen Pflegeprozesse und Audit-Trails schnell zusammen.
Geschäftliche Frage: Haben wir alle Felder, die für die Durchführung des Prozesses benötigt werden?
Konsistenz
Die Konsistenz prüft, ob derselbe Sachverhalt über Systeme und Transformationen hinweg einheitlich bleibt.
Viele Probleme in Unternehmen verbergen sich in Situationen wie dieser: Eine Abrechnungsplattform meldet, dass ein Kunde aktiv ist. Das CRM meldet ihn als inaktiv. Das Warehouse führt beide zusammen und gibt den Wert aus, der als Letzter eingetroffen ist. Technisch gesehen ist keiner dieser Datensätze null oder ungültig, aber das Unternehmen kann bei widersprüchlichen Zuständen nicht sicher agieren.
Geschäftliche Frage: Bedeutet dieselbe Entität überall dasselbe?
Ein Großteil der „Verwirrung in der Analytik“ ist in Wahrheit ein Konsistenzproblem im semantischen Gewand.
Timeliness
Bei der Timeliness geht es darum, ob Daten genau dann eintreffen, wenn sie für ihre Verwendung benötigt werden.
Eine tägliche Umsatztabelle, die erst mittags vorliegt, ist für die monatliche Planung vielleicht völlig ausreichend, für eine operative Abstimmung um 8:30 Uhr jedoch inakzeptabel. Timeliness ist immer kontextabhängig. Verspätete Daten werden zu schlechten Daten, wenn sie das Zeitfenster für Entscheidungen verpassen.
Geschäftliche Frage: Waren die Daten innerhalb des vom Prozess geforderten Zeitfensters verfügbar?
Gültigkeit
Die Gültigkeit prüft, ob die Werte den Regeln, Wertebereichen und Formaten entsprechen.
Eine Datumsspalte könnte Text enthalten. Eine Statusspalte könnte Werte außerhalb des definierten Sets aufweisen. Ein Datensatz kann dem Schematyp entsprechen und dennoch gegen die Business-Logik verstoßen – beispielsweise mit einem Enddatum, das vor dem Startdatum liegt.
Geschäftliche Frage: Entspricht dieser Datensatz den Regeln, auf die wir uns geeinigt haben?
Eindeutigkeit
Eindeutigkeit prüft, ob Datensätze dort nur einmal vorkommen, wo sie nur einmal vorkommen sollten.
Doppelte Kunden, Rechnungen oder Transaktionen führen schnell zu spürbaren Problemen. Zahlen steigen künstlich an, Joins vervielfachen Zeilen und Teams streiten am Ende darüber, ob das Problem in der Quelle oder im Modell liegt. Eindeutigkeitsprüfungen sollten sowohl auf technischer Schlüsselebene als auch auf Ebene der Geschäftsentität existieren, da nicht alle Duplikate dieselbe Kennung teilen.
Geschäftliche Frage: Zählen wir eine Sache einmal oder mehrfach?
Hier ist die operative Abkürzung, die ich verwende:
Dimension | Hauptfehlermodus | Typisches geschäftliches Symptom |
|---|---|---|
Genauigkeit | Falscher Wert | Fehlentscheidung oder fehlerhafte Aktion |
Vollständigkeit | Fehlender Wert | Unterbrochener Workflow oder Lücke im Audit |
Konsistenz | Widersprüchlicher Wert | KPI-Streitigkeiten zwischen Teams |
Timeliness | Verspäteter Wert | Veraltete Dashboards und verzögertes Handeln |
Gültigkeit | Regelwidriger Wert | Prozessfehler oder abgewiesener Datensatz |
Eindeutigkeit | Doppelter Wert | Künstlich erhöhte Zahlen und fehlerhafte Joins |
Wie man Kernmetriken der Datenqualität berechnet
Definitionen helfen nur dann weiter, wenn man sie in wiederholbare Prüfungen umsetzen kann. Der zuverlässigste Ausgangspunkt ist die Berechnung einiger weniger Metriken im Warehouse, die Speicherung der Ergebnisse in einer Metriktabelle und die Analyse ihrer Entwicklung im Zeitverlauf.
Beginnen Sie mit einem Metrik-Vertrag
Bevor Sie SQL-Code schreiben, sollten Sie für jede Metrik vier Aspekte definieren:
Umfang des Datensatzes. Welche Tabelle, welche Partition oder welche Business Domain messen Sie?
Logik. Was genau gilt als Erfolg oder Misserfolg?
Eigentümer. Wer kümmert sich um die Warnung, wenn sich die Metrik verändert?
Geschäftliche Auswirkung. Was geht schief, wenn diese Metrik außerhalb der Toleranz liegt?
Ohne diesen Vertrag streiten sich die Teams nach der Warnung und nicht davor.
Eine einfache Metriktabelle sieht oft so aus:
column_name | purpose |
|---|---|
metric_date | Zeitpunkt der Durchführung der Prüfung |
dataset_name | gemessene Tabelle oder gemessenes Modell |
metric_name | Vollständigkeit, duplicate_rate, freshness_lag |
metric_value | numerisches Ergebnis |
threshold_status | Erfolg, Warnung, Fehler |
dimension | Vollständigkeit, Gültigkeit, Timeliness etc. |
SQL-Formeln, die Teams tatsächlich nutzen
Vollständigkeit ist der sauberste Ausgangspunkt. In den Quellen von Alation wird Vollständigkeit als der Prozentsatz der Nicht-Null-Werte in erforderlichen Feldern im Verhältnis zur Gesamtzahl der Zeilen definiert. Benchmark-Daten aus dem Gesundheits- und Finanzwesen zeigen, dass Datensätze mit weniger als 97 % Vollständigkeit 40 % mehr regulatorische Compliance-Feststellungen in diesen Sektoren verursachen, wie aus Alations Bericht über Datenqualitätsmetriken hervorgeht.
Eine grundlegende Formel lautet:
Vollständigkeit = (erforderliche Werte ungleich Null / Zeilen gesamt) * 100
Beispiel:
Bei mehreren erforderlichen Spalten sollten Sie nicht einfach den Durchschnitt bilden. Berechnen Sie jedes Feld separat und ermitteln Sie zusätzlich einen Vollständigkeitsscore auf Datensatzebene, falls der Workflow davon abhängt, dass alle Felder ausgefüllt sind.
Eindeutigkeit wird in der Regel als der Anteil der Zeilen gemessen, die nicht gegen einen erwarteten Schlüssel verstoßen.
Eindeutigkeit = 1 - (doppelte Zeilen / Zeilen gesamt)
Wenn sich eine Geschäftsentität unter verschiedenen technischen IDs duplizieren kann, fügen Sie später eine unscharfe (Fuzzy-) oder regelbasierte Zuordnung hinzu. Beginnen Sie zunächst mit exakten Duplikaten.
Gültigkeit erfordert explizite Regeln. Verlassen Sie sich nicht allein auf Schematypen.
Für Modelle im Gesundheitswesen oder in der Forschung benötigen Teams häufig domänenspezifische Regelbibliotheken. In diesem Zusammenhang ist OMOPHub zur OMOP-Datenvalidierung eine relevante Referenz, da es sich auf strukturierte Validierungs-Workflows anstelle von allgemeiner Qualitätsberatung konzentriert.
Timeliness lässt sich oft besser als Verzögerung (Lag) denn als Prozentsatz ausdrücken.
Wenn Sie über SQL-Snippets hinaus ein Entwurfsmuster für Validierungsregeln benötigen, ist diese Einführung zur Bedeutung der Data Validation in operativen Systemen eine gute Ergänzung.
Schwellenwerte gehören zu Anwendungsfällen, nicht zu Tabellen
Der häufigste Fehler besteht darin, einen einzigen Schwellenwert pro Dimension festzulegen und diesen überall anzuwenden. Das scheitert schnell.
Eine Tabelle mit Kundenidentitäten erfordert strengere Vollständigkeitsregeln als ein historisches Klickstream-Archiv. Ein Feature-Set für Risikomodelle toleriert möglicherweise einige verspätet eintreffende Anreicherungsdaten, aber keine Schemaänderungen. Ein Finanzexport akzeptiert unter Umständen kleine Abweichungen bei der Zeilenanzahl, aber keinen einzigen ungültigen Code für eine juristische Person.
Messen Sie dieselbe Dimension unterschiedlich, wenn die Kosten eines Fehlers variieren. Das ist keine Inkonsistenz, sondern verantwortungsvolles Design.
Das Data Warehouse sollte die Metrik berechnen. Der Geschäftsprozess sollte den Schwellenwert bestimmen.
Von rohen Metriken zu handlungsrelevanten Erkenntnissen
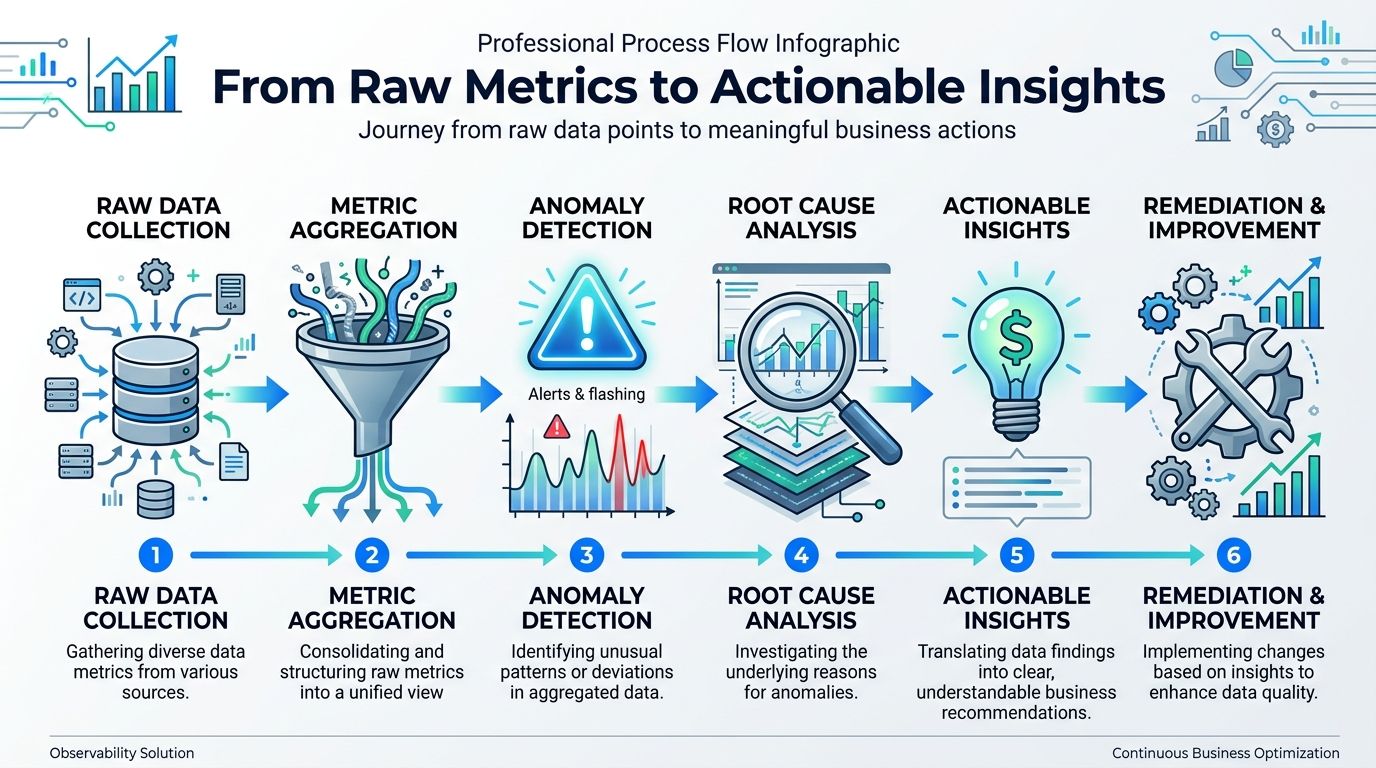
Eine Metrik an sich ist nur eine Zahl in einer Tabelle. Teams benötigen eine Interpretationslogik um sie herum. Das bedeutet Schwellenwerte, Anomalieerkennung, Routing und ausreichend Kontext, um zu entscheiden, ob das Problem nur kosmetischer Natur oder operativer Art ist.
Schwellenwerte, denen die Menschen vertrauen werden
Statische Schwellenwerte funktionieren gut, wenn die Regel klar und absolut ist. Erforderliche Felder, akzeptierte Wertebereiche und Eindeutigkeitsprüfungen für Schlüssel passen in der Regel in dieses Modell.
Dynamische Schwellenwerte helfen, wenn die Metrik naturgemäß schwankt. Zeilenanzahlen ändern sich mit der Saisonalität. Aktualitätsmuster variieren je nach Zeitplan. Verschiebungen in der Verteilung können an manchen Tagen normal und an anderen verdächtig sein.
Eine praktische Aufteilung sieht wie folgt aus:
Nutzen Sie statische Schwellenwerte für Geschäftsregeln und datenschutz- bzw. compliance-relevante Felder.
Nutzen Sie gelernte Baselines für Volumen, Aktualität und Verhaltensanomalien.
Nutzen Sie Trendprüfungen, wenn eine kontinuierliche Verschlechterung schwerer wiegt als ein einzelner fehlerhafter Durchlauf.
Alarmierung, die Teams nicht dazu erzieht, Warnungen zu ignorieren
Das Alarmierungssystem versagt, wenn bei jeder kleinsten Abweichung jemand benachrichtigt wird.
Gute Datenqualitätsalarme liefern direkt beim ersten Auslösen den nötigen Kontext mit. Der Verantwortliche sollte den Datensatz, die fehlerhafte Metrik, den aktuellen Trend, die vermutete Ursache im vorgeschalteten System sowie die Dashboards, Modelle oder operativen Prozesse sehen, die von diesem Asset abhängen. Wenn der Alarm lediglich „Vollständigkeit gesunken“ meldet, muss der Bearbeiter die grundlegende Analyse erst mühsam manuell durchführen.
Ich habe erlebt, dass sich eine einfache Regel in reifen Teams bewährt hat:
Alarmtyp | Wann zu nutzen | Erwartete Reaktion |
|---|---|---|
Harter Fehler (Hard Fail) | Regelverletzung mit unmittelbaren geschäftlichen Auswirkungen | Incident eröffnen und bei Bedarf die nachgelagerte Nutzung stoppen |
Warnung | Verschlechterung ohne unmittelbares Entscheidungsrisiko | Untersuchung während der regulären Arbeitszeit |
Trendbeobachtung | Langsame Verschlechterung | In das Backlog aufnehmen und mit dem Verantwortlichen besprechen |
Der schnellste Weg, das Vertrauen in ein Monitoring-System zu verlieren, besteht darin, technische Alarme ohne operativen Kontext zu versenden.
Stichproben und Baselining in unruhigen Umgebungen
Nicht jede Tabelle benötigt dieselbe Tiefe an Überwachung. Einige sind kritisch, andere sind Zwischenstufen und manche sind temporär.
Für eine breite Abdeckung sollten Sie mit kostengünstigen Signalen beginnen. Zeilenanzahl, Aktualität, Nullwertmuster, Schemaänderungen und Duplikatsprüfungen decken einen Großteil der tatsächlichen Fehler auf. Fügen Sie eine Validierung auf Datensatzebene hinzu, wo die Business-Logik streng ist. Führen Sie Stichproben durch, wenn die Kosten eine Rolle spielen, aber tun Sie dies gezielt. Validieren Sie beispielsweise vollständige Ladevorgänge bei Gold-Datensätzen und analysieren Sie repräsentative Stichproben bei Modellen niedrigerer Priorität.
KI-basiertes Baselining hilft am meisten, wenn die Umgebung zu unruhig für manuell konfigurierte Grenzwerte ist. Dies ist besonders nützlich in Organisationen mit vielen Datenquellen und unregelmäßigen Aktualisierungsmustern. Das Ziel ist nicht, das menschliche Urteilsvermögen zu ersetzen. Es geht darum, die menschliche Aufmerksamkeit für Abweichungen zu reservieren, die sich wesentlich vom normalen Systemverhalten unterscheiden.
Operationalisierung der Datenqualität: Ein KPI-Dashboard-Beispiel
Ein gutes Dashboard ist keine reine Galerie von Diagrammen. Es ist eine Arbeitsfläche für die Reaktion auf Incidents, die Trendanalyse und die Klärung von Zuständigkeiten.
Beginnen Sie die Seite mit einer Zusammenfassung des Systemzustands, die drei Fragen sofort beantwortet: Was schlägt aktuell fehl, was verschlechtert sich und was benötigt heute einen Verantwortlichen?
Was das Dashboard auf einen Blick zeigt
Die erste Zeile enthält in der Regel die operative Sicht:
Offene Incidents nach Schweregrad, damit die zuständigen Engineers wissen, wo sie anfangen müssen
Aktualitätsstatus nach kritischen Datensätzen, um verspätete oder fehlende Ladevorgänge aufzuzeigen
Feed für Schemaänderungen bei hinzugefügten, entfernten oder im Typ geänderten Spalten
Sich am stärksten verschlechternde Metriken über ein aktuelles Überprüfungszeitfenster hinweg
Fügen Sie dann die Analystensicht hinzu. Trendlinien für Vollständigkeit, Duplikatsraten, Gültigkeitsfehler und Aktualitätsverzögerungen helfen den Teams, einmaliges Rauschen von einem anhaltenden Abwärtstrend zu unterscheiden. Bestenlisten sind ebenfalls nützlich. Eine Ansicht der „am wenigsten stabilen Tabellen“ führt oft zu einer besseren Priorisierung als ein langes Fehlerprotokoll.
Eine Metrik verdient besondere Aufmerksamkeit: Data Downtime. Laut der Diskussion von Monte Carlo über Datenqualitätsmetriken stellen Unternehmen, die Data Downtime tracken, fest, dass 68 % der Vorfälle auf unbemerktes Schema-Drift oder Aktualitätsverletzungen zurückzuführen sind, und diese Vorfälle können innerhalb von 48 Stunden zu einer Reduzierung der Genauigkeit nachgelagerter Modelle um 15 bis 25 % führen. Deshalb sollte das Dashboard nicht nur anzeigen, ob eine Prüfung fehlgeschlagen ist, sondern auch, wie lange der betroffene Datensatz bereits unzuverlässig ist.
Was die einzelnen Teams damit machen
Data Engineers benötigen eine technische Sicht. Sie interessieren sich für fehlgeschlagene Prüfungen, die Dauer von Incidents, Lineage und wahrscheinliche vorgelagerte Ursachen.
Analytics Engineers und BI-Entwickler benötigen eine semantische Sicht. Sie müssen wissen, ob ein vertrauenswürdiges Modell immer noch den Erwartungen der Geschäftsregeln entspricht und ob Dashboards kommentiert, pausiert oder neu aufgebaut werden müssen.
governance und Business Owner benötigen eine Risikosicht. Sie wollen wissen, welche Domains wiederholt ausfallen, welche Kontrollen schwach sind und ob Probleme innerhalb der vereinbarten Fristen gelöst werden.
Eine kurze Produktvorstellung hilft, dieses Betriebsmodell greifbar zu machen:
Die besten KPI-Dashboards beschränken sich nicht auf Rot und Grün. Sie zeigen Trends, die Tragweite (Blast Radius) und die Verantwortlichen. Das macht das Monitoring zu einem System, das die Menschen in der Praxis unter Druck nutzen, und nicht nur bei Präsentationen.
Fortgeschrittene Herausforderungen, die Standardmetriken nicht beantworten
Die meisten Leitfäden enden bei den sechs Dimensionen. In der Produktionsumgebung fangen die schwierigen Fragen dort erst an.
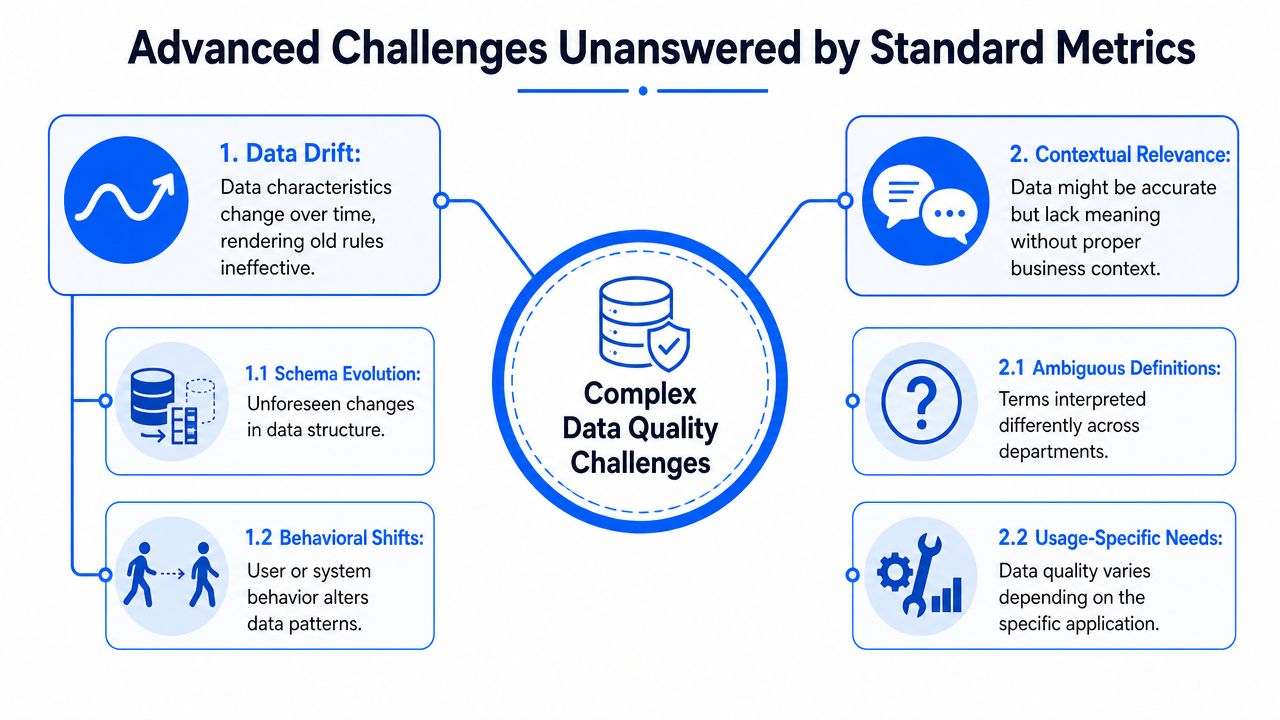
Mikrofehler, die sich in guten Durchschnittswerten verbergen
Aggregierte Metriken können fehlerfrei aussehen, während ein winziger Defekt unverhältnismäßig großen Schaden anrichtet.
Einige wenige fehlerhafte Zeilen in einer Kundentabelle können dazu führen, dass hochwertige Bestellungen falsch geroutet werden. Ein kleiner Satz fehlerhaft formatierter Datensätze kann ein einzelnes nachgelagertes Feature beschädigen, das von einem Modell verwendet wird. Die Gesamtwert von Vollständigkeit, Gültigkeit und Eindeutigkeit kann immer noch akzeptabel erscheinen, da der aggregierte Score die Auswirkungen verwässert.
Dieses Problem zeigt sich auch in Diskussionen unter Praktikern. Ein Thread von Data Engineers über Fehler mit Mikrowirkung beschreibt, wie schwierig es ist, die Auswirkungen von Fehlern zu quantifizieren, die sich nur auf wenige Zeilen auswirken, aber dennoch schwerwiegende nachgelagerte Ausfälle verursachen.
Die Lösung ist kein weiterer Durchschnittswert. Sie liegt in Segmentierung und auswirkungssensiblen Prüfungen.
Nutzen Sie Muster wie diese:
Überwachung kritischer Felder für Spalten, deren Ausfall einen Workflow blockiert, selbst wenn nur eine Handvoll Zeilen betroffen sind
Segmentbasierte Metriken nach Region, Kanal, Produktlinie oder Kundensegment, damit ein lokaler Fehler nicht in einer globalen Erfolgsquote untergeht
Pfadsensitive Validierung, die Datensätze testet, die mit hoher Wahrscheinlichkeit regulierte, finanzielle oder modellkritische Pfade durchlaufen
Geschäftliche Symptommetriken wie abgewiesene Transaktionen, nicht verknüpfbare Datensätze oder Datensätze, die für den Versand blockiert sind
Eine Metrik sollte die Kosten eines Fehlers widerspiegeln und nicht nur die Anzahl der fehlerhaften Zeilen.
Warum ein einziger Score schwieriger ist, als es klingt
Führungskräfte verlangen oft nach einer einzigen Zahl. Das ist eine berechtigte Forderung. Sie wollen Trends, Vergleiche und Priorisierungen sehen, ohne zehn verschiedene Diagramme lesen zu müssen.
Das Problem liegt in der Gewichtung.
Eine verspätete Marketingtabelle und eine doppelte Zahlungszeile sollten nicht gleichermaßen in einen einzigen Score einfließen. Ein Vollständigkeitsproblem in einem Referenzarchiv birgt nicht das gleiche Risiko wie ein Gültigkeitsproblem in einer Domain für Kundenidentitäten. Statische Gewichtungen altern zudem schlecht. Geschäftsprozesse ändern sich, Modelleingaben entwickeln sich weiter, und was früher eine Warnung war, kann heute ein kritischer Fehler sein.
Ein nützlicher Data Quality Score muss daher kontextabhängig sein. Er benötigt domänenspezifische Gewichtungen, Multiplikatoren für geschäftliche Auswirkungen und regelmäßige Neukalibrierungen. Er sollte zudem den aktuellen Zustand von zukünftigen Risiken trennen. Andernfalls erhält man eine geschönte Zahl, die zwar für die Führungsebene gut aussieht, den operativen Kräften aber kaum weiterhilft.
Ein praktisches Modell bewertet auf drei Ebenen:
Ebene | Was sie beantwortet |
|---|---|
Metrik-Score | War diese spezifische Prüfung erfolgreich, verschlechtert oder fehlerhaft |
Datensatz-Score | Ist dieses Asset für den vorgesehenen Verwendungszweck sicher |
Domain-Risiko-Score | Welcher Geschäftsbereich weist das größte operative Risiko auf |
Das wird zwar nicht jeden Einzelfall lösen. Aber es vermeidet den größten Fehler: so zu tun, als ob ein einziger, universeller Score jeden Anwendungsfall gleichermaßen gut abbilden könnte.
Wie Data Observability-Plattformen Qualitätsmetriken automatisieren
Manuelle SQL-Prüfungen sind ein solider Ausgangspunkt. Sie reichen jedoch nicht mehr aus, sobald man es mit vielen Datenquellen, sich verändernden Schemata und Teams zu tun hat, die ein kontinuierliches Monitoring anstelle einer wöchentlichen Überprüfung benötigen.
Hier spielen Data Observability-Plattformen ihre Stärken aus. Sie automatisieren die Erfassung von Metriken, definieren das Normalverhalten als Baseline, erkennen Anomalien, überwachen die Aktualität und leiten Probleme mit ausreichend Kontext für eine schnelle Behebung weiter. Zudem reduzieren sie den Wartungsaufwand, der durch manuell erstellte Regelsätze entsteht, die über Airflow-Jobs, dbt-Tests, Warehouse-Prozeduren und BI-Anpassungen verstreut sind.
Die leistungsfähigsten Plattformen kombinieren mehrere Kontrollmechanismen:
Regelbasierte Validierung für die grundlegende Business-Logik
Anomalieerkennung für Abweichungen, die niemand explizit modelliert hat
Überwachung der Timeliness für verspätete oder ausbleibende Daten
Schema-Tracking für strukturelle Änderungen, die unerwartet nachgelagerte Annahmen verletzen
Historische Analysen zur Identifizierung schleichender Verschlechterungen
Wenn Sie diese Kategorie evaluieren, ist dieser Artikel darüber, warum Data Observability für modernes Datenmanagement von entscheidender Bedeutung ist, ein nützlicher Ausgangspunkt. Ein Beispiel in diesem Bereich ist digna, das In-Database-Metrikberechnung, Anomalieerkennung, Überwachung der Timeliness, Validierung auf Datensatzebene und Schema-Tracking in vom Kunden kontrollierten Umgebungen kombiniert.
Das praktische Ziel sind nicht noch mehr Dashboards. Es sind weniger Überraschungen, eine schnellere Ursachenanalyse und klarere Zuständigkeiten, wenn Daten nicht mehr vertrauenswürdig sind.
Wenn Ihr Team versucht, von Ad-hoc-Prüfungen zu einer überwachten, operativen Datenqualitätspraxis überzugehen, ist digna eine Evaluierung wert. Es wurde für Teams entwickelt, die Anomalieerkennung, Data Validation, Überwachung der Timeliness und Schema-Tracking benötigen, ohne Produktionsdaten aus ihrer eigenen Umgebung wegzubewegen.


