Datenreich, aber informationsarm: Ein praxisnaher Leitfaden
|
7
min. Lesezeit

Sie können in einem Montagsmeeting vor einem sauberen Dashboard sitzen und trotzdem nicht wissen, ob sich die Zahl bewegt hat, weil die Kampagne funktioniert hat, weil die Quelltabelle defekt ist oder weil jemand letzte Woche die Definition geändert hat. Die Diagramme wirken poliert. Das Meeting endet trotzdem mit derselben unbehaglichen Frage: Worauf können wir uns verlassen?
Diese Lücke heißt datenreich, aber informationsarm, und sie tritt auf, wenn Teams zwar reichlich Zeilen, Ereignisse und Logs sammeln, sie aber nicht schnell genug in entscheidungsreife Informationen verwandeln können. Das Problem ist nicht nur das Volumen. Es ist die Zeit und das Vertrauen, die nötig sind, um rohe Signale in etwas zu verwandeln, auf dessen Grundlage eine Führungskraft handeln kann, ohne die Quelle anzuzweifeln.
Inhaltsverzeichnis
Woher der Begriff stammt und warum er noch immer relevant ist
Die tatsächlichen Geschäftskosten von „datenreich, aber informationsarm“
Von Regelfabriken zu KI-gestützter Observability in der Praxis
Die Dashboard-Falle und das DRIP-Problem
Ein Umsatz-Dashboard kann gesund aussehen und dennoch den einzigen Test nicht bestehen, der zählt: Kann das Team erklären, warum sich die Pipeline verändert hat? Das Marketing sagt, die Kampagne habe die Nachfrage gesteigert, der Vertrieb sagt, der Lead-Mix habe sich verschoben, die Finanzabteilung sieht eine Zahl, die nicht zur Prognose der Vorwoche passt, und der Analyst muss Warehouse-Tabellen, SaaS-Exporte und manuelle Korrekturen in Tabellenkalkulationen zusammenflicken. Das ist die Dashboard-Falle: viel Darstellung, zu wenig Entscheidung.
DRIP steht für Data Rich, Information Poor – datenreich, aber informationsarm. Der Begriff beschreibt die wachsende Lücke zwischen der Datenmenge, die ein Unternehmen sammelt, und der Menge an entscheidungsreifen Informationen, denen es vertrauen kann. Rohdaten sind eine Zeile in einer Tabelle, ein Ereignis in einem Stream oder eine Logzeile in einer Datei. Information ist dasselbe Signal, nachdem es Kontext, Aktualität, eine Verantwortlichkeit und genügend Erklärung erhalten hat, um Handeln zu begründen.
Diese Unterscheidung ist wichtig, weil Teams mehr Daten oft als Antwort auf fehlende Erkenntnisse betrachten. In der Praxis kann das die Lücke sogar vergrößern. Mehr Tabellen bedeuten mehr Joins, mehr Tools bedeuten mehr Übergaben, und mehr Übergaben bedeuten mehr Gelegenheiten, bei denen jemand eine Frage stellt, die niemand sicher beantworten kann. Wenn Sie praktisch nachvollziehen möchten, wie Dashboards in dieses Problem hineinspielen, zeigt der interne Leitfaden zu Datenqualitäts-Dashboards, warum oberflächliche Transparenz oft vor echter Kontrolle haltmacht.
Praxisregel: Wenn eine Kennzahl ein Meeting braucht, um erklärt zu werden, ist sie noch keine Information.
Das richtige Denkmodell ist Latenz, nicht Volumen. Ein Unternehmen kann über reichlich Daten verfügen und trotzdem langsam entscheiden, weil die Daten zu spät eintreffen, ihnen Kontext fehlt oder sie nicht gegen die Geschäftsregeln geprüft wurden, die sie vertrauenswürdig machen. Deshalb geht es bei DRIP weniger um Speicherung als um den Weg vom Signal zur Handlung.
Woher der Begriff stammt und warum er noch immer relevant ist
Der Ausdruck „data rich and information poor“ existiert seit Jahrzehnten, weil das Fehlerbild immer wieder in neuem Gewand auftaucht. Populär wurde er durch das Wirtschaftsbuch In Search of Excellence aus dem Jahr 1983, in dem er ein einfaches Managementproblem auf den Punkt brachte: Organisationen können Daten anhäufen, ohne sie in nutzbare Informationen umzuwandeln. Spätere Kommentare zu derselben Idee verknüpften sie mit einer Schätzung aus dem Jahr 2010, wonach die US-Wirtschaft jährlich 997 Milliarden US-Dollar durch Informationsüberflutung verlor – auf Basis von 78,6 Millionen Vollzeit-Wissensarbeitern. Deshalb findet der Ausdruck bis heute Gehör in Vorstandsetagen und Analytics-Teams (historischer Überblick über den Ausdruck und die Schätzung von 2010).
Warum die Formulierung jeden Tooling-Zyklus überdauert
Die Formulierung hat BI, Big Data und nun auch KI überdauert, weil sich das Tooling schneller verändert hat als das zugrunde liegende Problem. Ein Warehouse kann Daten zentralisieren, ein Dashboard kann sie zusammenfassen und ein Modell kann sie bewerten, doch keiner dieser Schritte garantiert, dass das Ergebnis zeitnah, erklärbar oder vertrauenswürdig genug für Handlungen ist. Deshalb gehört der Ausdruck in jede ernsthafte Analytics-Diskussion des Jahres 2025, besonders wenn Teams schneller neue Systeme hinzufügen, als sie den Entscheidungsweg verbessern.
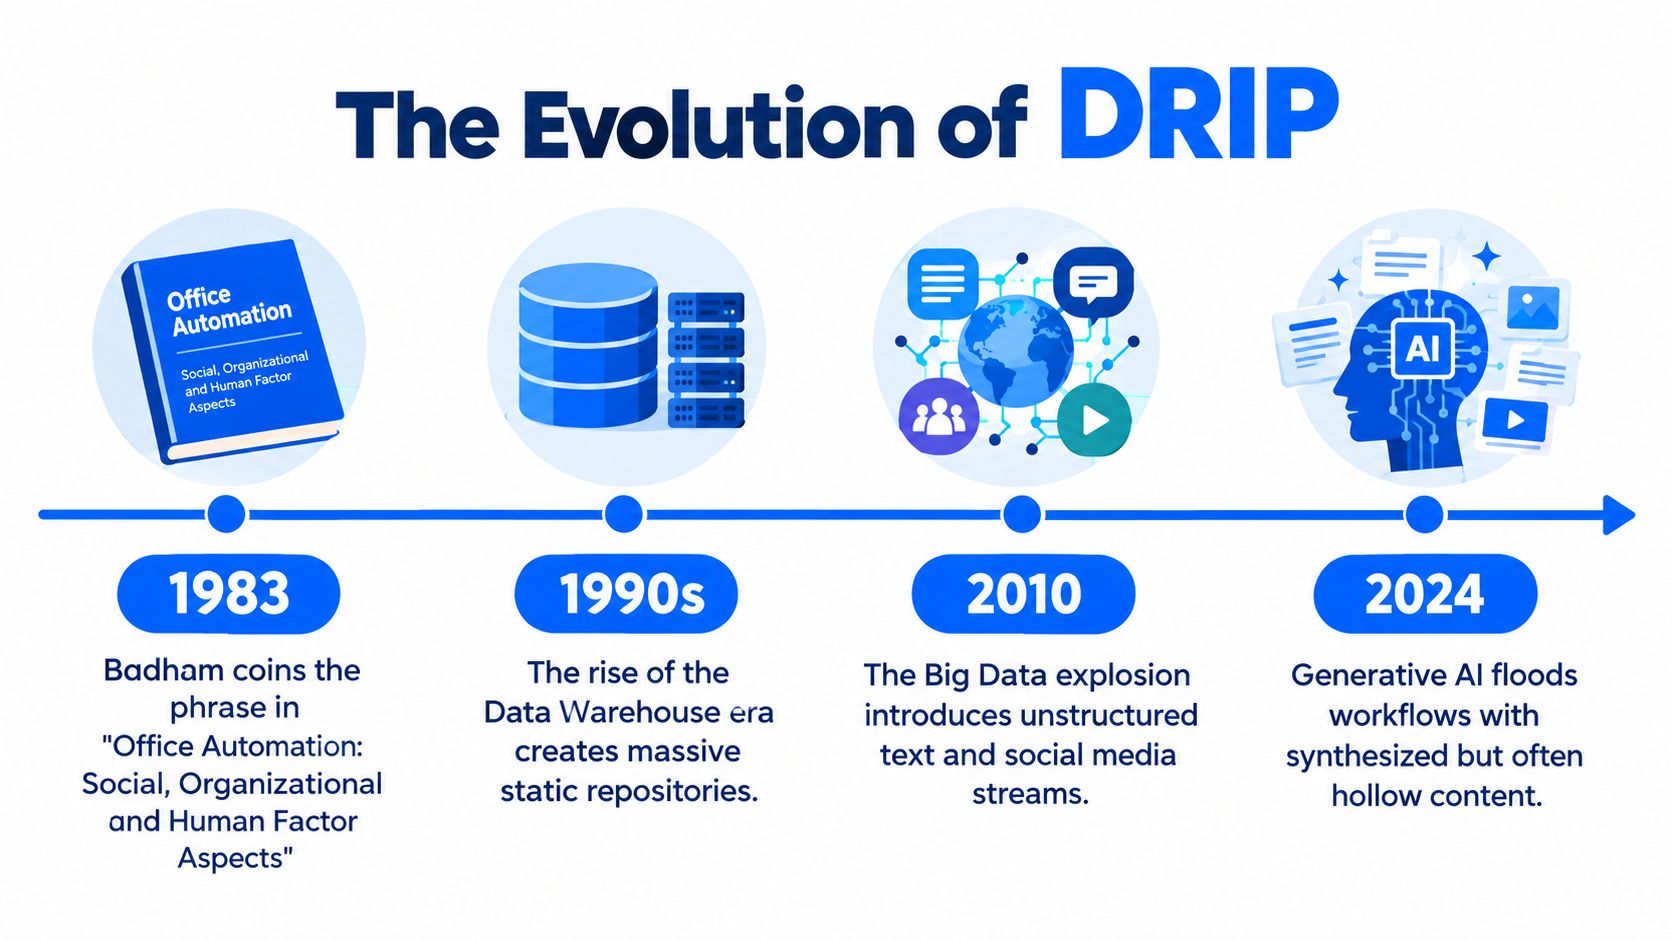
Der Ausdruck hat Bestand, weil das Symptom ständig seine Form ändert – nicht, weil die Diagnose veraltet wäre.
Die moderne Wendung ist KI. Generative Tools können mehr Zusammenfassungen, mehr Prognosen und mehr Text erzeugen, doch wenn die zugrunde liegenden Daten veraltet oder nicht vertrauenswürdig sind, bleibt das Ergebnis hohl. DRIP ist nach wie vor die passende Kurzformel, weil es auf den eigentlichen Fehler verweist: Informationen kommen nicht in einer Form an, die Menschen sicher nutzen können.
Was die Lücke zwischen Daten und Informationen verursacht
Die häufigste Ursache ist Fragmentierung. Eine einzelne Geschäftsfrage hängt oft von Daten ab, die über Warehouses, SaaS-Anwendungen, operative Speicher und Tabellenkalkulationen verteilt sind. Die Antwort muss also mehrere Verantwortungsgrenzen überwinden, bevor ihr jemand vertrauen kann. In dieser Situation ist die Verzögerung nicht nur technisch, sondern auch interpretativ, denn jede Übergabe schafft eine weitere Gelegenheit, dass Definitionen auseinanderlaufen.
Vier strukturelle Ursachen, die in realen Teams auftreten
Die Lücke entsteht meist aus einer Mischung aus Fragmentierung, Tool-Wildwuchs, Überlastung und Latenz. Eine hilfreiche Methode, das Problem zu erfassen, ist der Vergleich der strukturellen Ursache mit dem Symptom, das sie hervorruft.
Ursache | Typischer Umfang im Jahr 2025 | Operatives Symptom |
|---|---|---|
Datenfragmentierung | Viele Systeme, die jeweils einen Teil der Antwort enthalten | Teams streiten darüber, welche Tabelle maßgeblich ist |
Tool-Wildwuchs | Mehrere Analytics- und Observability-Tools parallel | Keine gemeinsame Sicht auf Qualität, Aktualität oder Lineage |
Informationsüberflutung | Zu viele Dashboards und Kennzahlen konkurrieren um Aufmerksamkeit | Meetings füllen sich mit Zahlen, aber es wird keine Entscheidung getroffen |
Verarbeitungslatenz | Daten treffen ein, nachdem das Entscheidungsfenster verstrichen ist | Führungskräfte handeln auf Basis veralteter Zahlen oder warten auf eine manuelle Aktualisierung |
Das Überlastungsproblem ist nicht abstrakt. Moderne Studien zum Arbeitsplatz zeigen, dass Wissensarbeiter ständig unterbrochen werden und viele Teams Zeit mit der Suche über verschiedene Anwendungen hinweg verbringen, statt auf Basis des Ergebnisses zu handeln (Zusammenfassung zur Überlastung am Arbeitsplatz). Mit anderen Worten: Das Unternehmen hat nicht nur mehr Daten, sondern auch mehr Reibung zwischen Frage und Antwort.
Eine nützliche ergänzende Lektüre ist die Analyse im Artul.ai-Blog, warum Zusammenfassungen von Earnings Calls scheitern, denn sie zeigt dasselbe Muster in einem anderen Kontext: Das Rohmaterial ist vorhanden, aber die verwertbare Aussage tritt nicht klar hervor.
Warum Latenz wichtiger ist als Datenvolumen
Batch-Pipelines dominieren in vielen Umgebungen nach wie vor, sodass die Entscheidung oft fällt, bevor die aktuellsten Daten eintreffen. Das erzeugt eine zeitliche Diskrepanz. Eine Führungskraft sieht einen KPI, geht davon aus, dass er die Gegenwart widerspiegelt, und entscheidet auf Basis von Daten, die womöglich bereits veraltet sind. Das Problem ist nicht, dass dem Unternehmen Signale fehlen. Das Problem ist, dass das Signal die Entscheidung zu spät erreicht – und ohne den Kontext, der zu seiner Interpretation nötig ist.
Wenn Sie diese Lücke verkleinern möchten, ist der interne Überblick über heterogene Datenquellen eine hilfreiche Perspektive, weil er die Kosten verstreuter Eingaben greifbarer macht.
Die tatsächlichen Geschäftskosten von „datenreich, aber informationsarm“
Schlechte Datenqualität ärgert nicht nur Analysten. Sie erzeugt eine Kostenleiter, die mit jedem Schritt steiler wird, den fehlerhafte Daten nachgelagert zurücklegen. Eine vielzitierte Branchenschätzung besagt, dass schlechte Datenqualität Organisationen durchschnittlich 12,9 Millionen US-Dollar pro Jahr kostet, und die in derselben Quelle zitierte D&B-Studie beschreibt eine Eskalation von 1 $, 10 $, 100 $: Prävention kostet etwa 1 $ pro Datensatz, das Erkennen und Beheben eines Problems etwa 10 $ pro Datensatz und die Korrektur eines Fehlers nach einem Ereignis etwa 100 $ pro Datensatz (Kosteneskalation und Auswirkungen auf Unternehmen).
Kosten beginnen klein und wachsen dann schnell
Diese Eskalation ist der Grund, warum späte Erkennung so schmerzt. Ein fehlerhafter Wert, der bei der Validierung abgefangen wird, ist günstig. Derselbe fehlerhafte Wert in einem Dashboard ist teurer. Sobald er eine Preis-Engine, einen Compliance-Bericht oder einen kundennahen Workflow erreicht, steigt die Reparaturrechnung sprunghaft, weil Menschen das Problem zurückverfolgen, die geschäftlichen Auswirkungen erklären und nachgelagerte Entscheidungen rückgängig machen müssen.
Phase | Kosten pro Datensatz | Typischer Auslöser | Beispiel |
|---|---|---|---|
Prävention | 1 $ | Validierung, bevor fehlerhafte Daten in die Pipeline gelangen | Eine Regel blockiert einen ungültigen Code bei der Aufnahme |
Erkennung und Behebung | 10 $ | Analysten finden und beheben das Problem, nachdem es aufgetreten ist | Ein fehlgeschlagener Ladevorgang wird auf eine fehlerhafte Datei zurückgeführt |
Korrektur nach Auswirkung | 100 $ | Der Fehler erreicht einen Bericht, Workflow oder regulatorischen Prozess | Ein falscher Wert verändert eine Preis- oder Compliance-Entscheidung |
Eine günstige Korrektur ist eine, die Sie abfangen, bevor sich der Fehler ausbreitet.
Die versteckten Kosten sind entgangene Chancen. Wenn ein Team Tage damit verbringt, die Wahrheit abzugleichen, verpasst es die Gelegenheit zu handeln, solange sich der Markt noch bewegt. Ein Händler mit einer Preis-Engine, die an eine sechs Monate alte Kostentabelle gekoppelt ist, bemerkt den Fehler womöglich erst, wenn die Margen abdriften oder ein Wettbewerber ihn dazu zwingt. Dann besteht der Schaden nicht nur im falschen Preis. Es ist das Vertrauen in die Zahlen, das die Geschäftsleitung verliert.
Deshalb ist DRIP eine Steuer auf Entscheidungslatenz. Sie zahlen sie mit langsameren Reaktionen, mehr Abstimmungsarbeit und mehr Meetings, in denen bewiesen wird, dass die Daten stimmen, statt zu entscheiden, was als Nächstes zu tun ist. Der interne Business Case für Datenqualität ist hier relevant, denn die Wirtschaftlichkeit verbessert sich erst, wenn Teams die Ausbreitung von Fehlern reduzieren und nicht nur aufräumen.
So diagnostizieren Sie Ihren eigenen DRIP-Zustand
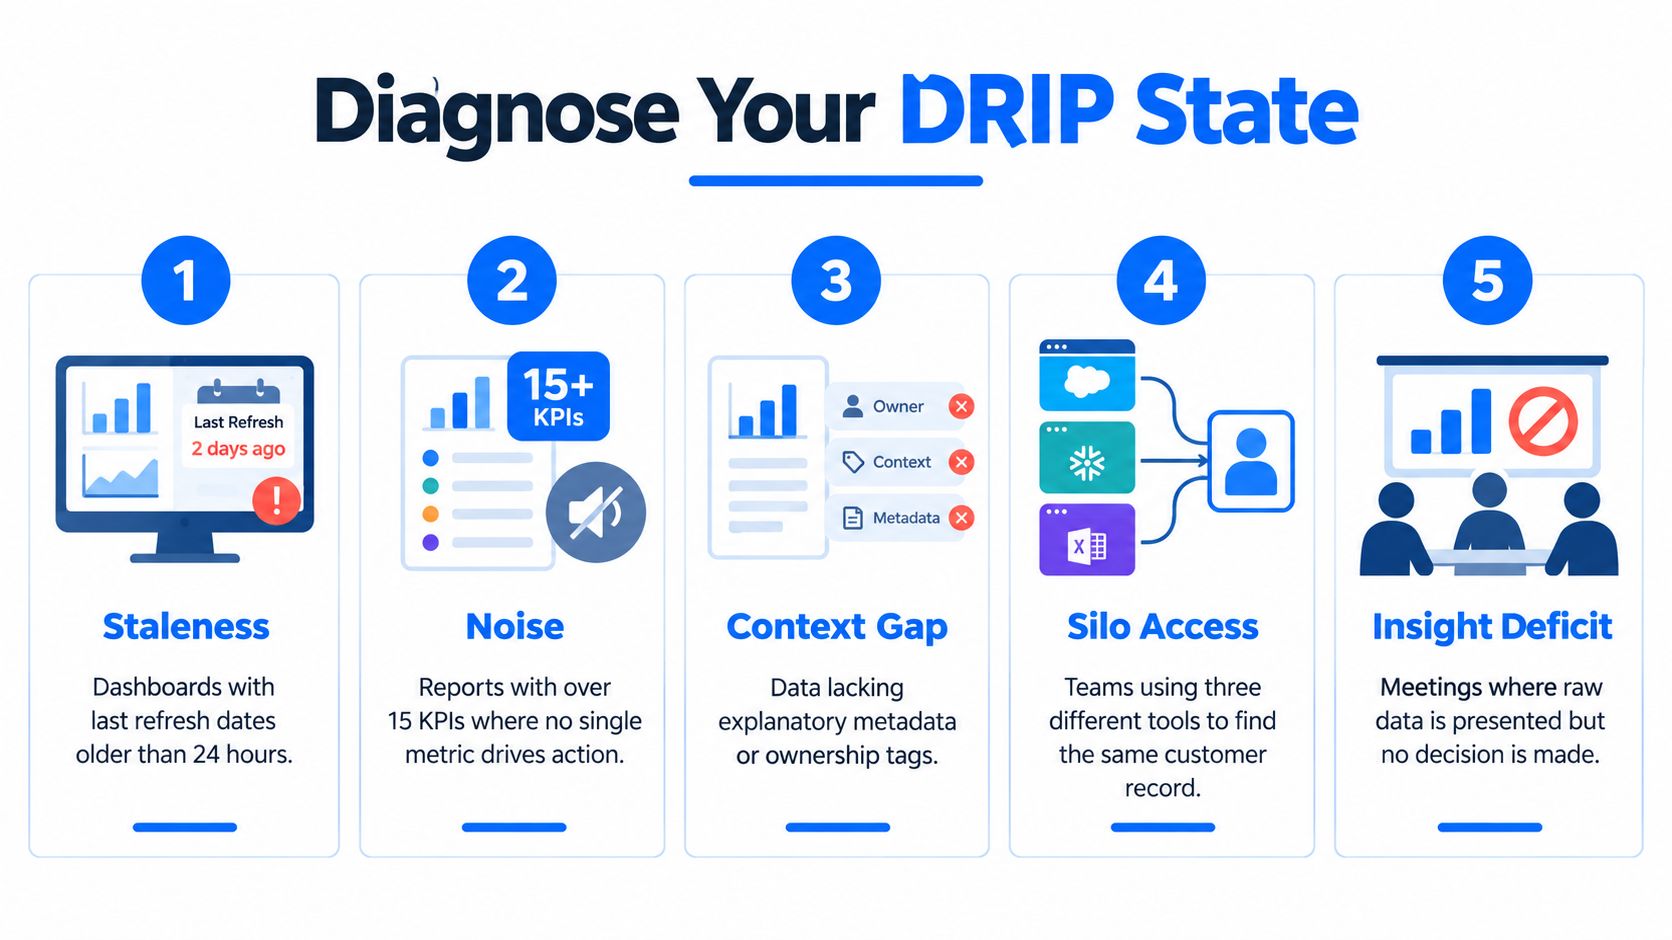
Sie brauchen keine Umfrage, um zu wissen, ob sich Ihr Team im DRIP-Bereich befindet. Sie müssen nach Symptomen suchen, die sich in der täglichen Arbeit zeigen. Das deutlichste ist Veraltung, die leicht zu erkennen ist, wenn die Aktualisierung eines Dashboards unbemerkt ihr Service-Level überschreitet oder sich der Zeitstempel eines Berichts seit Wochen nicht verändert hat. Wenn die Zahl aktuell aussieht, der Ladevorgang dahinter aber nicht, ist das Dashboard reine Dekoration.
Fünf Signale, die meist gemeinsam auftreten
Veraltung: Die Aktualisierung ist verspätet, der Zeitstempel hat sich nicht geändert oder der letzte Lauf wurde nicht rechtzeitig abgeschlossen.
Stille Verteilungsverschiebungen: Ein KPI verändert seine Form ohne offensichtlichen geschäftlichen Grund.
Schema-Drift: Eine Quelltabelle fügt Felder hinzu, entfernt oder benennt sie um, und die nachgelagerte Logik läuft weiter.
Manuell geflickte Lieferfehler: Jemand lädt die Datei neu, bearbeitet den Extrakt oder startet den Job erneut, ohne die Ursache zu beheben.
Unerklärliche KPI-Bewegungen: Meetings kreisen immer wieder um dieselbe Zahl, weil niemand dem Anstieg oder Rückgang traut.
Die schnellsten Prüfungen sind zugleich die nützlichsten. Aktualitätsprüfungen zeigen Ihnen, ob die Daten zum erwarteten Zeitpunkt eingetroffen sind. Statistisches Anomalie-Scoring zeigt Ihnen, ob sich das Muster so verändert hat, dass Menschen es prüfen sollten. Schema-Diffing zeigt strukturelle Änderungen, bevor sie nachgelagerte Verbraucher beeinträchtigen. Lineage-basierte Triage zeigt Ihnen, wo der Bruch begonnen hat, statt Teams raten zu lassen. Die interne Referenz zu Data-Observability-Metriken ist eine gute Ergänzung, wenn Sie diese Prüfungen operativen Signalen zuordnen möchten.
Ein kleines Beispiel aus dem Einzelhandel, das das Muster offenlegt
Ein Analytics-Team im Einzelhandel sieht einen Umsatzrückgang, einen verspäteten Warehouse-Feed und eine Spaltenumbenennung in der vorgelagerten Produkttabelle. Keines dieser Anzeichen allein beweist, dass die Pipeline defekt ist. Zusammen deuten sie auf einen einzigen fehlgeschlagenen ETL-Job hin, den niemand gemeldet hat, weil der Bericht weiterhin angezeigt wurde und der Fehler hinter einem manuellen Workaround verborgen war.
Wenn mehr als zwei dieser fünf Signale zutreffen, befinden Sie sich bereits im DRIP-Bereich. Dann ist nicht mehr die Frage, ob die Daten existieren. Die Frage ist, ob die Organisation ihnen schnell genug vertrauen kann, um zu handeln.
Fünf operative Kontrollen, die die Lücke schließen
Ein Dashboard kann gesund aussehen, während die zugrunde liegende Pipeline bereits abdriftet. Kontrollen fangen diese Drift ab, bevor Menschen darüber streiten, welche Zahl die richtige ist. Jede deckt ein anderes Fehlerbild ab. Governance klärt Verantwortlichkeiten und Lineage. Observability macht unerwartetes Verhalten sichtbar. Pünktlichkeit hält Latenz sichtbar. Validierung blockiert fehlerhafte Datensätze, bevor sie sich ausbreiten. Schema-Tracking erkennt strukturelle Änderungen, bevor nachgelagerte Systeme sie falsch interpretieren.
Kontrolle | Gelöstes DRIP-Symptom | Minimale tragfähige Umsetzung | Fehlerbild, wenn sie fehlt |
|---|---|---|---|
Governance | Unklarheit über Verantwortlichkeiten und Lineage | Verantwortliche benennen, kritische Datenelemente definieren, Lineage pflegen | Papiertheater ohne operative Verantwortlichkeit |
Observability | Stille Anomalien und fehlende Ladevorgänge | Kontinuierliche Anomalie- und Aktualitätsprüfungen für kritische Tabellen | Teams bemerken Probleme erst, wenn Dashboards bereits falsch sind |
Pünktlichkeit | Veraltete Ergebnisse | Aktualitäts-SLAs für zentrale Pipelines und Alarme bei verpassten Zeitfenstern festlegen | Korrekte Daten treffen trotzdem zu spät ein, um noch relevant zu sein |
Validierung | Fehlerhafte Datensätze breiten sich nachgelagert aus | Prüfungen von Geschäftsregeln bei der Aufnahme und vor der Transformation | Fehler breiten sich in Reporting, Compliance und KI-Eingaben aus |
Schema-Tracking | Strukturelle Drift | Eingehendes Schema bei jedem Ladevorgang mit der erwarteten Struktur vergleichen | Nachgelagerte Jobs scheitern unbemerkt oder interpretieren die Daten falsch |
Die Kontrollen wirken zusammen, nicht stufenweise
Governance ohne Observability wird zu Prozessbürokratie. Observability ohne Validierung erkennt ein Symptom und lässt fehlerhafte Daten dennoch durch. Validierung ohne Pünktlichkeit liefert saubere Daten, die erst nach Ablauf des Entscheidungsfensters eintreffen. Schema-Tracking ohne Verantwortlichkeit löst einen Alarm aus, aber niemand ist eindeutig für die Behebung zuständig.
Deshalb brauchen Teams ein Kontrollset statt einer Einzellösung. Ein praktisches Muster ist digna, das Datenqualitäts- und Observability-Prüfungen in der Umgebung des Kunden ausführt – über Anomalien, Pünktlichkeit, Validierung, Schema-Tracking und Business-Monitoring hinweg.
Das Ziel ist, die Lücke zwischen einer Veränderung in den Daten und einer sicheren Entscheidung über das weitere Vorgehen zu verkürzen. Eine langsame Pipeline, eine verborgene Schemaänderung oder ein fehlgeschlagener Ladevorgang sollte als Vertrauensproblem sichtbar werden und nicht als Überraschung im Wochenreview. Wenn diese Kontrollen zusammenwirken, hört das Dashboard auf, eine Alarmglocke zu sein, und wird zu einer Vertrauensgrundlage für das Unternehmen.
Von Regelfabriken zu KI-gestützter Observability in der Praxis
Ein multinationaler Hersteller kann freitags Schwellenwertprüfungen für Sensor-Feeds von Hand schreiben, nur um am Montag festzustellen, dass die Regeln bereits veraltet waren. Dieses Modell skaliert nicht, wenn die Umgebung Millionen von Signalen umfasst – zumal aktuelle Kommentare aus der Fertigung darauf hinweisen, dass weniger als 1 % der täglichen Fabrikdaten für Entscheidungen genutzt werden (DRIP und das Kontextproblem in der Fertigung). Manuelle Regelfabriken machen Engineers zu Wartungspersonal und übersehen trotzdem die Momente, auf die es ankommt.
Was sich ändert, wenn Observability die Baseline lernt
KI-gestützte Observability ersetzt starre Schwellenwerte durch gelernte Baselines, sodass ein Monitor einen neuen Bruch melden kann, wenn sich Kardinalität, Aktualität oder Schemaverhalten außerhalb der normalen Muster bewegen. Das ist wichtig, wenn der Fehler neuartig ist. Eine Regel, die für die Pipeline des Vormonats geschrieben wurde, erkennt keine neue Feldanordnung und kein unerwartetes Verzögerungsmuster, ein adaptiver Monitor kann jedoch trotzdem darauf aufmerksam machen, wie in diesem Leitfaden dazu beschrieben, wie KI Datenanomalien in Datenpipelines erkennt.
Ein hilfreicher Vergleich:
Fähigkeit | Regelfabrik | KI-gestützte Observability |
|---|---|---|
Einrichtung von Schwellenwerten | Von Engineers manuell erstellt | Lernt normales Verhalten aus den Daten |
Erkennung von Änderungen | Erkennt nur bekannte Fehlerbilder | Meldet neuartige Verschiebungen bei Volumen, Aktualität oder Schema |
Wartungsaufwand | Hoch, weil Regeln schnell veralten | Geringer, weil sich Baselines mit dem Datensatz aktualisieren |
Alarmqualität | Oft laut oder fragil | Stärker auf aussagekräftige Abweichungen fokussiert |
Nutzung im Team | Zentral im Engineering angesiedelt | Modular genug für Fachteams |
Der Kompromiss ist real. KI reduziert Alarmmüdigkeit und erkennt unbekannte Muster, braucht aber dennoch Aufsicht. Baselines können driften, Modelle können veralten, und auch ein intelligentes System braucht Menschen, die Ausnahmen prüfen, die Ursache bestätigen und das Ergebnis in die Governance zurückspielen. Diese Feedbackschleife ist wichtiger als der Alarm selbst.
Bessere Automatisierung beseitigt Verantwortlichkeit nicht, sie verlagert sie nach vorn.
Die stärksten Setups kombinieren modellgestützte Erkennung mit Lineage-bewusster Bewertung der Aktualität und modularen Monitoren, die Fachteams zusammenstellen können, ohne für jede neue Regel ein Ticket aufmachen zu müssen. Das ist im großen Maßstab praxistauglich, denn die Kosten manueller Prüfungen übersteigen bereits deren Nutzen.
Ihre ersten Schritte zu mehr Informationsreichtum
Ein weiteres Dashboard vertieft DRIP in der Regel, wenn hinter dem neuen Diagramm keine Validierung, keine Lineage und keine Aktualitätsvereinbarung stehen. Jede zusätzliche Ansicht kann ein weiterer Ort sein, an dem über die Zahl gestritten wird, statt ein weiterer Weg, ihr zu vertrauen. Der erste Schritt ist nicht, mehr zu berichten, sondern die Feedbackschleife zu verkürzen.
Ein praxisnaher 90-Tage-Plan
Verantwortliche benennen: Weisen Sie jedem kritischen Datensatz und jedem geschäftlichen KPI einen menschlichen Verantwortlichen zu.
Den Vertrag schreiben: Definieren Sie, was „gut“ für die zentralen Tabellen bedeutet, einschließlich Aktualität und zulässiger Werte.
Die risikoreichste Pipeline instrumentieren: Ergänzen Sie den wichtigsten Umsatz- oder Betriebs-Feed um Anomalieerkennung und Aktualitätsprüfungen.
Validierung am Eingang hinzufügen: Prüfen Sie Datensätze in der CI oder bei der Aufnahme, bevor sich fehlerhafte Werte ausbreiten.
Schemaänderungen verfolgen: Alarmieren Sie bei neuen, fehlenden oder umbenannten Feldern, bevor Verbraucher beeinträchtigt werden.
Einen durchgängigen KPI auswählen: Verfolgen Sie ihn von der Quelle bis zum Dashboard, sodass jeder Schritt sichtbar ist.
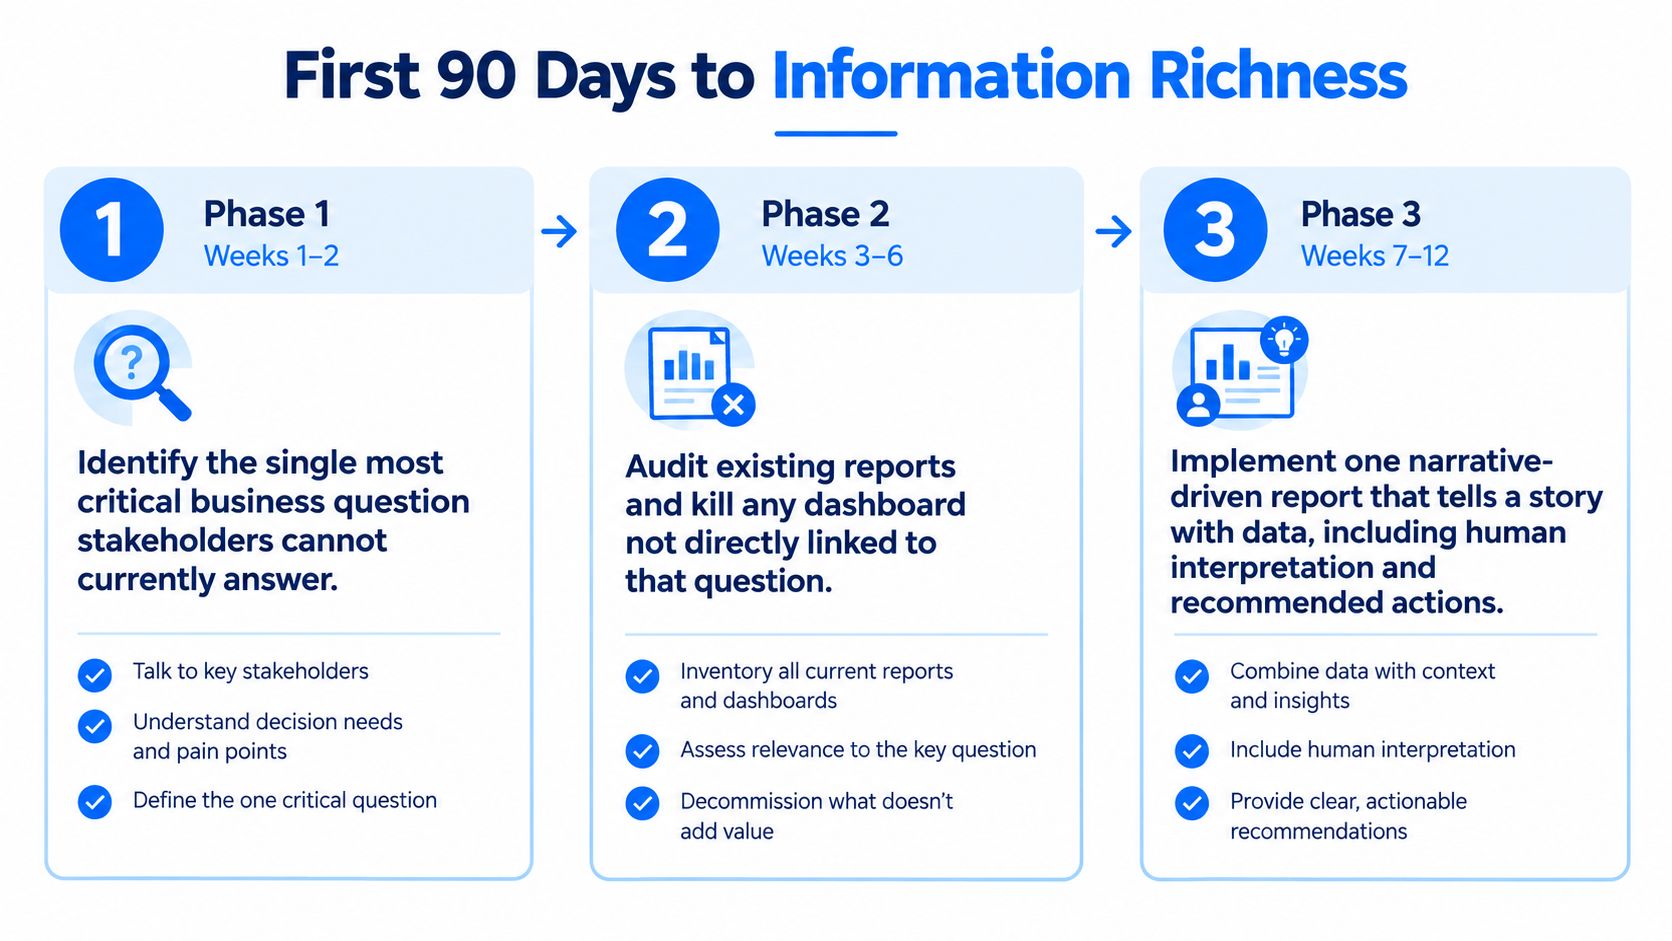
Am einfachsten beginnen Sie mit einer wöchentlichen Entscheidung, die das Team bereits trifft. Instrumentieren Sie die dahinterliegenden Daten so, dass sich die Antwort ohne hektisches Suchen verteidigen lässt. Wenn das Team die Zahl im selben Meeting erklären, ihr vertrauen und auf ihrer Grundlage handeln kann, bewegen Sie sich aus DRIP heraus und hin zu Informationsreichtum.
Wenn Sie Daten in etwas verwandeln möchten, dem das Unternehmen vertrauen kann, liefert Ihnen digna die nötigen Kontrollen: Anomalieerkennung, Pünktlichkeits-Monitoring, Validierung, Schema-Tracking und Business-Monitoring in Ihrer eigenen Umgebung. Besuchen Sie digna, um zu sehen, wie diese Kontrollen helfen können, die Lücke zwischen Rohdaten und der nächsten Entscheidung zu schließen.
Um Aktualitätsfenster und verpasste Ladevorgänge sichtbar zu machen, bevor ein veralteter KPI das Wochenreview erreicht, sehen Sie sich an, wie digna Timeliness lernt, wann jeder Datensatz eintreffen sollte.
Häufig gestellte Fragen
Was bedeutet „datenreich, aber informationsarm“?
Datenreich, aber informationsarm – auf Englisch „Data Rich, Information Poor“ oder DRIP – beschreibt die Lücke zwischen der Datenmenge, die ein Unternehmen sammelt, und der Menge an entscheidungsreifen Informationen, denen es vertrauen kann. Rohdaten sind eine Zeile, ein Ereignis oder eine Logzeile; Information ist dieses Signal mit Kontext, Aktualität, Verantwortlichkeit und genügend Erklärung, um Handeln zu begründen.
Woher stammt der Ausdruck „data rich, information poor“?
Populär wurde er durch das Wirtschaftsbuch In Search of Excellence aus dem Jahr 1983. Spätere Kommentare verknüpften ihn mit einer Schätzung aus dem Jahr 2010, wonach Informationsüberflutung die US-Wirtschaft jährlich 997 Milliarden US-Dollar kostete, basierend auf 78,6 Millionen Vollzeit-Wissensarbeitern. Deshalb findet der Ausdruck bei Analytics-Teams bis heute Anklang.
Warum sind Organisationen datenreich, aber informationsarm?
Meist wirken vier strukturelle Ursachen zusammen: Datenfragmentierung über Warehouses, SaaS-Anwendungen und Tabellenkalkulationen; Tool-Wildwuchs ohne gemeinsame Sicht auf Qualität oder Lineage; Informationsüberflutung durch zu viele Dashboards; und Verarbeitungslatenz, bei der Batch-Pipelines Daten erst liefern, wenn das Entscheidungsfenster bereits verstrichen ist.
Wie viel kostet schlechte Datenqualität ein Unternehmen?
Eine vielzitierte Schätzung beziffert den Durchschnitt auf 12,9 Millionen US-Dollar pro Jahr. Die Kosten steigen zudem mit der Zeit: etwa 1 $ pro Datensatz, um einen Fehler zu verhindern, 10 $, um ihn zu erkennen und zu beheben, und 100 $, um ihn zu korrigieren, nachdem er einen Bericht, eine Preis-Engine oder einen Compliance-Prozess erreicht hat.
Woran erkenne ich, ob mein Team datenreich, aber informationsarm ist?
Achten Sie auf fünf Signale: veraltete Dashboards, stille Verteilungsverschiebungen, Schema-Drift, manuell geflickte Lieferfehler und KPI-Bewegungen, die niemand erklären kann. Die Regel des Artikels lautet: Treffen mehr als zwei davon zu, befindet sich Ihr Team bereits im DRIP-Bereich und kann seinen Daten nicht schnell genug vertrauen.



