Datenqualitäts-Betriebsmodell: Ein praxisnaher Leitfaden für Unternehmen
|
7
min. Lesezeit

Ein regionales Forecasting-Team öffnete zum Quartalsende sein Umsatz-Dashboard und sah eine plausibel wirkende Zahl — doch die zugrunde liegende Kundenpopulation hatte sich verdoppelt. Eine Quellsystem-Migration hatte aktive und inaktive Konten zusammengeführt, niemand verantwortete die Merge-Logik, und kein Alert machte die Änderung der Zeilenanzahl früh genug sichtbar, um die Entscheidung zu stoppen. Eine Preisentscheidung wurde zurückgenommen, ein Audit monierte die Lineage-Lücke, und Engineers bauten dieselbe Pipeline dreimal neu, bevor ein Data Steward schließlich die Quelle sperrte.
Solche Vorfälle werden gern als Werkzeugproblem beschrieben. Meist sind sie es nicht. Die Organisation hatte Pipelines, Dashboards, Engineers und vermutlich reichlich Validierungscode. Was fehlte, war eine klare Antwort auf vier operative Fragen: Wer definiert akzeptable Qualität, wer verantwortet den Fehler, wer darf die Daten sperren, und wer entscheidet, wann der Fall abgeschlossen ist?
Ein Datenqualitäts-Betriebsmodell liefert genau diese fehlende Entscheidungsstruktur. Es verbindet Validierung, Observability, Pünktlichkeit, Verantwortlichkeiten und Eskalation, sodass Qualität zu einer wiederkehrenden operativen Fähigkeit wird statt zu einer Sammlung unverbundener Regeln. Der Bedarf lässt sich immer schwerer ignorieren. Eine Marktschätzung für 2026 bezifferte den globalen Markt für Datenqualitätsmanagement auf 2,66 Mrd. USD im Jahr 2025 mit einer Prognose von 4,95 Mrd. USD bis 2030 bei 13,2 % CAGR (Global Data Quality Market Report). Das Marktwachstum ist relevant, die operative Frage jedoch mehr: Kann Ihre Organisation auf ein Qualitätssignal reagieren, bevor es eine Geschäftsentscheidung verändert?
Inhaltsverzeichnis
Warum Datenqualität selbst in reifen Datenteams bricht
Was ein Datenqualitäts-Betriebsmodell tatsächlich ist
Die fünf Komponenten, die es operativ machen
Die vier Modellmuster und wie Sie wählen
Eine Entscheidungshilfe für das Startmuster
Reifegrade und messbare KPIs
Observability, Validierung und Pünktlichkeit verbinden
Validierung erkennt explizite Verstöße
Observability erkennt, was Regeln übersehen
Pünktlichkeit verdient eine eigene Kontrolle
Umsetzungs-Roadmap vom Pilot zur Enterprise-Skalierung
Fundament
Pilot-Domäne
Ausweitung
Enterprise-Skalierung
Branchenspezifische Aspekte in regulierten Sektoren
Verbreitete Irrtümer und Ihre Checkliste für nächste Woche
Fünf Maßnahmen für nächste Woche
Warum Datenqualität selbst in reifen Datenteams bricht
Der Forecasting-Vorfall trug alle äußeren Zeichen einer reifen Datenumgebung. Die Migration war genehmigt, die Pipeline lief erfolgreich, und das Dashboard aktualisierte sich planmäßig. Trotzdem gab es keine Kontrolle, die fragte, ob die Kontenpopulation noch die beabsichtigte Geschäftspopulation abbildete.
Der Fehler begann vorgelagert, wurde aber zum Unternehmensproblem. Das Forecasting-Team vertraute der aufgeblähten Umsatzsicht und nahm zum Quartalsende eine Preisentscheidung zurück. Im Audit stellten Prüfer fest, dass die Lineage an der migrierten Quelle endete und nicht erklärte, wie aktive und inaktive Konten kombiniert worden waren. Engineers bauten die Pipeline anschließend dreimal neu — jeder Versuch adressierte ein nachgelagertes Symptom statt der ungeklärten Verantwortungsfrage.
Der Data Steward sperrte schließlich die Quelle. Das beseitigte das akute Risiko, legte aber auch die fehlende operative Mechanik offen. Niemand war für die Merge-Logik verantwortlich, es gab keinen Eskalationspfad für eine auffällige Änderung der Zeilenanzahl, und keine vereinbarte Kennzahl stufte die Populationsdrift als releaseblockierendes Ereignis ein.
Praxisregel: Ein erfolgreicher Pipeline-Lauf beweist, dass Software ausgeführt wurde. Er beweist nicht, dass die entstandenen Daten noch zur Geschäftsentscheidung passen.
Dieses Muster tritt auch in Organisationen mit fähigen Engineers auf. Nach einem Vorfall werden oft weitere Tests ergänzt, doch die neuen Regeln werden zur nächsten Wartungslast, wenn niemand ihre Definitionen, Schwellenwerte oder Ausnahmen verantwortet. Eine Analyse struktureller Gründe für das Scheitern von Datenqualitätsprojekten trifft dieselbe operative Unterscheidung: Qualitätsarbeit scheitert, wenn Organisationen sie als Projekt oder Tool-Rollout behandeln, statt zu ändern, wie Teams entscheiden.
Unabhängige Governance-Forschung erklärt, warum die Lücke bestehen bleibt. In einer Befragung von 825 Teilnehmenden nannten 75 % Datenqualität als Top-Ziel, während eine andere Studie ergab, dass nur 10 % ihre Daten als exzellent und 30 % als gut einstuften — insgesamt sahen also 40 % die Qualität positiv (Precisely-Governance-Studie). Teams wissen zudem oft nicht, woher Daten stammen, wie verlässlich sie sind oder wer Fehler behebt.
Das Betriebsmodell existiert, um genau diese Unklarheit zu verhindern. Es verteilt Entscheidungsrechte vor der nächsten Migration, definiert das Signal, das ein Eingreifen auslöst, und gibt einer benannten Person die Befugnis, unsichere Daten zu stoppen.
Was ein Datenqualitäts-Betriebsmodell tatsächlich ist
Ein Datenqualitäts-Betriebsmodell ist das kodifizierte System aus Entscheidungsrechten, Rollen, Prozessen, Kontrollen und Kennzahlen, das bestimmt, wie Qualitätsprobleme über den Datenlebenszyklus hinweg erkannt, verantwortet, eskaliert und gelöst werden. Es beschreibt die Arbeit, die Menschen wiederholt leisten — nicht bloß die Standards, die sie veröffentlichen.
Eine Governance-Richtlinie formuliert Absicht. Eine Regelbibliothek speichert Tests. Eine Observability-Plattform erkennt Verhaltensänderungen in Systemen oder Datensätzen. Keine dieser Komponenten beantwortet für sich, wer einen Schwellenwert genehmigt, wer eine Ausnahme akzeptiert oder wer befugt ist, ein fehlerhaftes Feed zu sperren. Das Betriebsmodell verbindet diese Komponenten mit verantwortlichen Menschen.
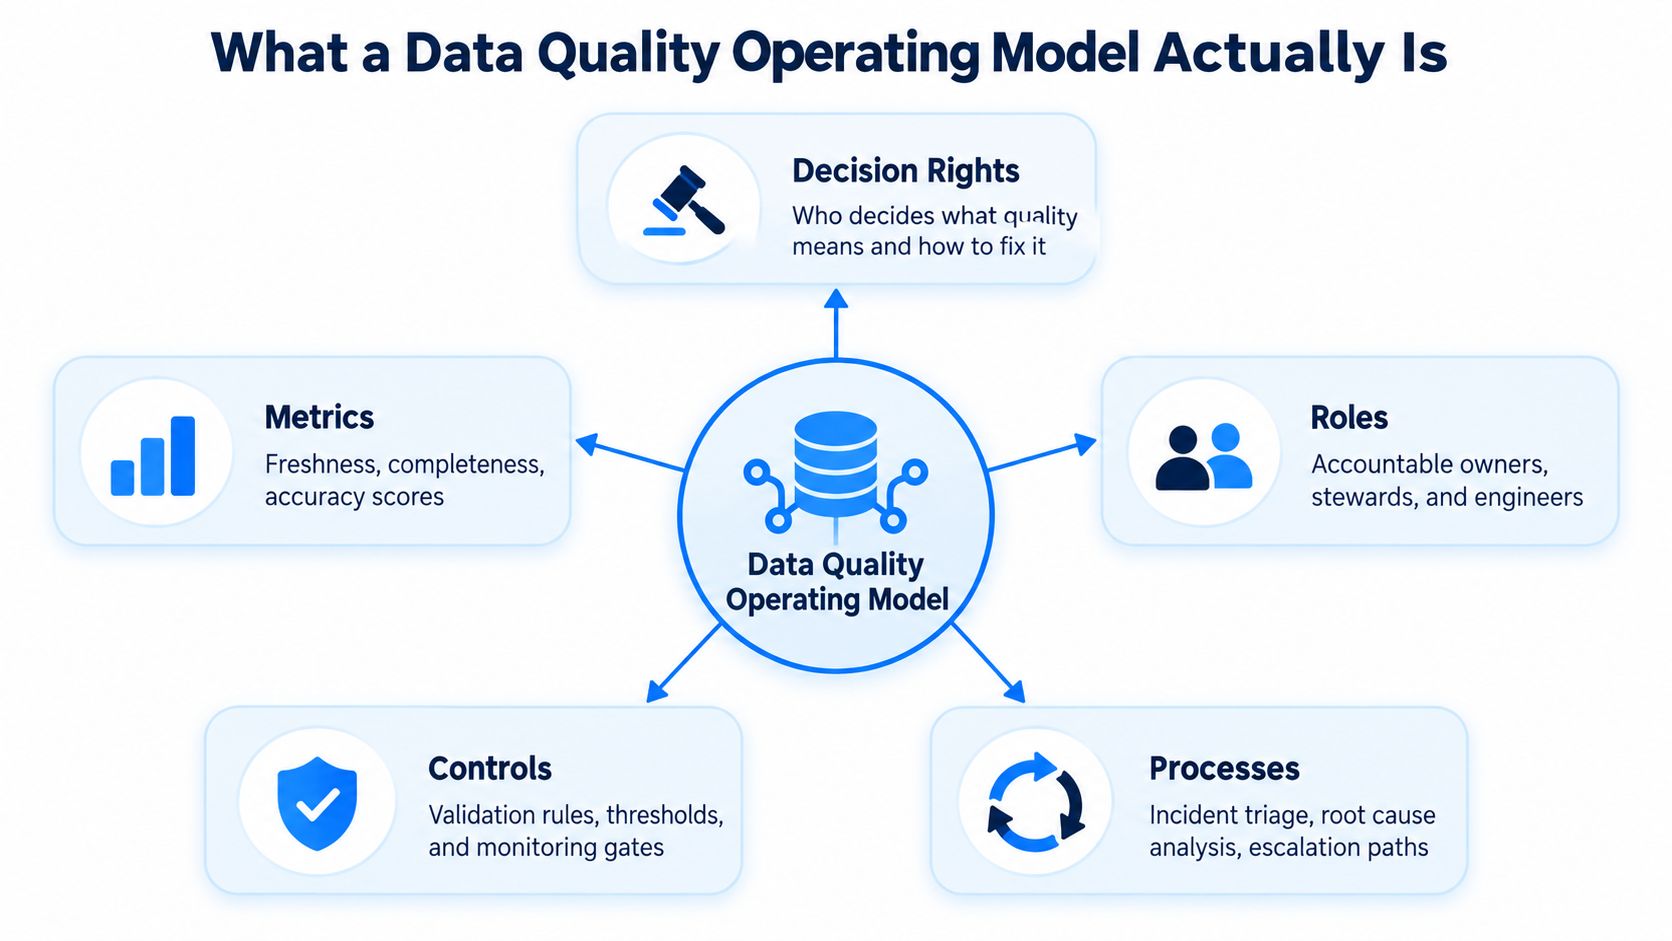
Die fünf Komponenten, die es operativ machen
Verantwortlichkeit und Ownership benennen Business Owner, Data Steward, Produzent, Plattformteam und Incident Responder für jedes kritische Datenprodukt oder -element. Der verantwortliche Owner genehmigt, was „fit for use“ bedeutet. Der Steward pflegt Definitionen und Ausnahmen. Engineers implementieren und betreiben die Kontrollen.
Standards und Regeln übersetzen fachliche Erwartungen in messbare Anforderungen. Sie können Vollständigkeit, Gültigkeit, Eindeutigkeit, referenzielle Integrität, Genauigkeit, Pünktlichkeit und strukturelle Stabilität abdecken. Jede Regel braucht einen Owner und eine dokumentierte Reaktion im Fehlerfall.
Erkennung und Kontrollen kombinieren Validierung mit Observability. Validierung prüft, ob Werte explizite fachliche oder strukturelle Kriterien erfüllen. Observability achtet auf unerwartetes Verhalten wie Volumenverschiebungen, Aktualitätslücken, Verteilungsänderungen und Schema-Evolution.
Der Workflow für Vorfälle definiert Triage, Schweregrad, Quarantäne, Ursachenanalyse, Eskalation, Behebung und Abschluss. Eine erkannte Anomalie ist keine abgeschlossene Kontrolle. Der Workflow muss festhalten, wer sie beurteilt hat und warum.
Messung und Feedback verfolgen, ob Kontrollen geschäftlichen Schaden verhindern. Nützliche Maße sind Regel-Performance, Reaktionszeiten, Abdeckung durch Owner, wiederkehrende Fehler und Nacharbeit. Die Kennzahlen sollten in Planung und Produktreviews einfließen, nicht in einem ungenutzten Dashboard versauern.
Ein praxisnaher Überblick zum Datenqualitätsmanagement hilft Teams, ihre Begriffe abzugleichen — doch Terminologie ist nicht das Ergebnis. Das Ergebnis ist eine funktionierende Vereinbarung darüber, was passiert, wenn Daten versagen.
Die vier Modellmuster und wie Sie wählen
In der Unternehmenspraxis setzt sich meist eines von vier Mustern durch. Die richtige Wahl hängt weniger von Organisationsmoden ab als von Risiko, Domänenkomplexität, Engineering-Fähigkeit und der bereits vorhandenen Governance-Basis.
Muster | Entscheidungsrechte | Ort der Verantwortung | Typisches Scheitern |
|---|---|---|---|
Zentrales Team | Eine zentrale Datenqualitäts- oder CDO-Funktion definiert Standards und priorisiert die Behebung | Zentrales Qualitätsteam, Produzenten verantworten die Korrekturen | Das Zentrum wird zum Engpass und Fachteams warten auf Freigabe |
Föderierte Domänen | Domänenteams definieren Eignungskriterien für die Daten, die sie erzeugen — innerhalb gemeinsamer Standards | Domain Owner und Stewards | Definitionen und Schwellenwerte driften zwischen Domänen auseinander |
Eingebettete Engineers | Produkt- oder Plattformteams verantworten Prüfungen als Teil von Entwicklung und Betrieb | Engineering- und Produktteams | Fachliche Bedeutung ist in technischen Tests unterrepräsentiert |
Hybrides Hub-and-Spoke | Ein Center of Excellence liefert Standards, Werkzeuge und Enablement, während Domänen die Ergebnisse verantworten | Geteilte Verantwortung zwischen zentralen und Domänenteams | Der Hub veröffentlicht Leitlinien, aber niemand setzt ihre Anwendung durch |
Ein zentrales Modell funktioniert, wenn regulatorische Auslegung konsistent sein muss oder die Engineering-Kapazität der Domänen begrenzt ist. Es stößt an Grenzen, wenn ein Team jeden fachlichen Kontext verstehen soll. Ein föderiertes Modell rückt Entscheidungen näher an die Daten, braucht aber ein starkes gemeinsames Vokabular, Änderungskontrolle und einen Eskalationsmechanismus. Eingebettete Verantwortung macht Qualität zum Teil der Lieferung — allerdings sollten Engineers die fachliche Definition von Genauigkeit nicht erraten müssen.
Das hybride Muster ist für Unternehmen oft der praktikabelste Start. Ein zentrales Team verantwortet Kontrollrahmen, gemeinsame Werkzeuge und Reporting. Domain Owner entscheiden über die Eignung, Produzenten beheben vorgelagerte Ursachen, Plattformteams betreiben die gemeinsame Infrastruktur. Das ist die Betriebslogik hinter föderierter Data Governance, in der Standards konsistent bleiben, ohne jede Entscheidung in eine zentrale Warteschlange zu zwingen.
Eine Entscheidungshilfe für das Startmuster
Regulierte Domänen: Mehrere regulierte Domänen sprechen für ein zentrales oder hybrides Modell, weil Freigaben, Nachweise und Eskalation einheitlich behandelt werden müssen.
Engineering-Reife: Starke Produktteams können eingebettete oder föderierte Verantwortung tragen. Teams ohne verlässliche Lieferpraktiken brauchen mehr zentrales Enablement.
Governance-Investition: Bestehende Gremien, Kataloge und Stewardship-Routinen erleichtern die hybride Einführung. Bei geringer Governance-Investition empfiehlt sich ein fokussierter zentraler Pilot vor der Föderierung.
Kopieren Sie nicht das Modell eines größeren Unternehmens. Wählen Sie die kleinste Struktur, die jedem kritischen Fehler einen Owner, einen Reaktionsweg und eine entscheidungsbefugte Person gibt.
Reifegrade und messbare KPIs
Ein Reifegrad-Label hat nur Wert, wenn es tägliche Entscheidungen verändert. „Fortgeschrittene Governance“ bedeutet wenig, wenn Konsumenten Fehler weiterhin zuerst finden, Verantwortlichkeiten unklar sind oder Engineers dieselbe vorgelagerte Störung immer wieder reparieren. Nutzen Sie ein Reifegradmodell für Datenqualität, um operatives Verhalten mit messbaren Ergebnissen zu verbinden.
Reifegrad | Beobachtbare Signale | Zentrale KPIs |
|---|---|---|
Ad hoc | Prüfungen variieren je Team, Verantwortung ist informell, Nutzer entdecken Fehler in Berichten | Benannte Owner für kritische Assets, Anzahl aktiver Kontrollen |
Reaktiv | Vorfälle werden nach dem Ausfall erfasst, Prioritäten sind informell, Feuerwehreinsätze wiederholen sich | MTTD, MTTR, Rückstand offener Vorfälle |
Definiert | Kritische Datensätze haben dokumentierte Regeln, Owner, Schweregrade und Eskalationswege | First-Pass-Validierungsquote, kritische Assets mit Owner |
Gemessen | Qualitätskennzahlen erscheinen in operativen Reviews, Teams analysieren wiederkehrende Ursachen | Trends bei MTTD und MTTR, Wiederholungsrate, Nacharbeitsstunden |
Optimiert | Kontrollen beeinflussen Releases, Verträge, Budgets und Verbesserungsprioritäten | Kosten schlechter Qualität, Alter offener Ausnahmen, Kontrollabdeckung, Wirkung auf Geschäfts-KPIs |
Auf der Stufe Ad hoc sollten Sie keinen zusammengesetzten Score bauen. Beginnen Sie mit einer Inventur und markieren Sie die Assets, die Umsatz, Risikosteuerung, regulatorisches Reporting oder operative Entscheidungen stützen. Der erste nützliche KPI kann simpel sein: Ist bei Ausfall einer kritischen Kontrolle jemand mit Entscheidungsbefugnis erreichbar?
Reaktive Teams brauchen Reaktionsdisziplin. Mean Time to Detect und Mean Time to Remediate — MTTD und MTTR — zeigen, ob Monitoring und Verantwortlichkeiten besser werden. Ergänzen Sie sie um die Wiederholungsrate: Ein schneller Workaround beweist nicht, dass die Ursache behoben wurde.
Auf der Stufe Definiert messen Sie, ob dokumentierte Kontrollen konsistent laufen und ob kritische Assets verantwortliche Owner haben. Die First-Pass-Validierungsquote zeigt, wie oft Daten ohne Eingriff die Validierung bestehen. Auf der Stufe Gemessen legen Wiederholungsrate und Nacharbeitsstunden die Kosten schwacher Ursachenarbeit offen. Die Kosten schlechter Qualität verbinden diese Ausfälle mit Kapazitäts- und Budgetdiskussionen.
KPIs sollen Entscheidungen stützen, nicht ein Dashboard schmücken. Eine Kontrolle mit hoher Bestehensquote schützt womöglich ein unwichtiges Feld, während eine niedrigere Quote auf einem entscheidungskritischen Datensatz sofortige Investitionen erfordert.
Ein reifes Programm misst, ob Kontrollen Geschäftsentscheidungen schützen und ob Teams aus Fehlern lernen. EYs FP&A-Trendstudie 2025 berichtete, dass nur 16 % der Organisationen über gut analysierbare Daten hoher Qualität verfügten, während 25 % ihre Daten als schlecht oder minderwertig beschrieben (EY FP&A-Trendstudie). Praktisch bedeutet das, Datenqualitätsmaße mit der Nutzung durch Analysten und der Reaktion verantwortlicher Owner zu verknüpfen, statt nur technische Bestehensquoten zu optimieren.
Observability, Validierung und Pünktlichkeit verbinden
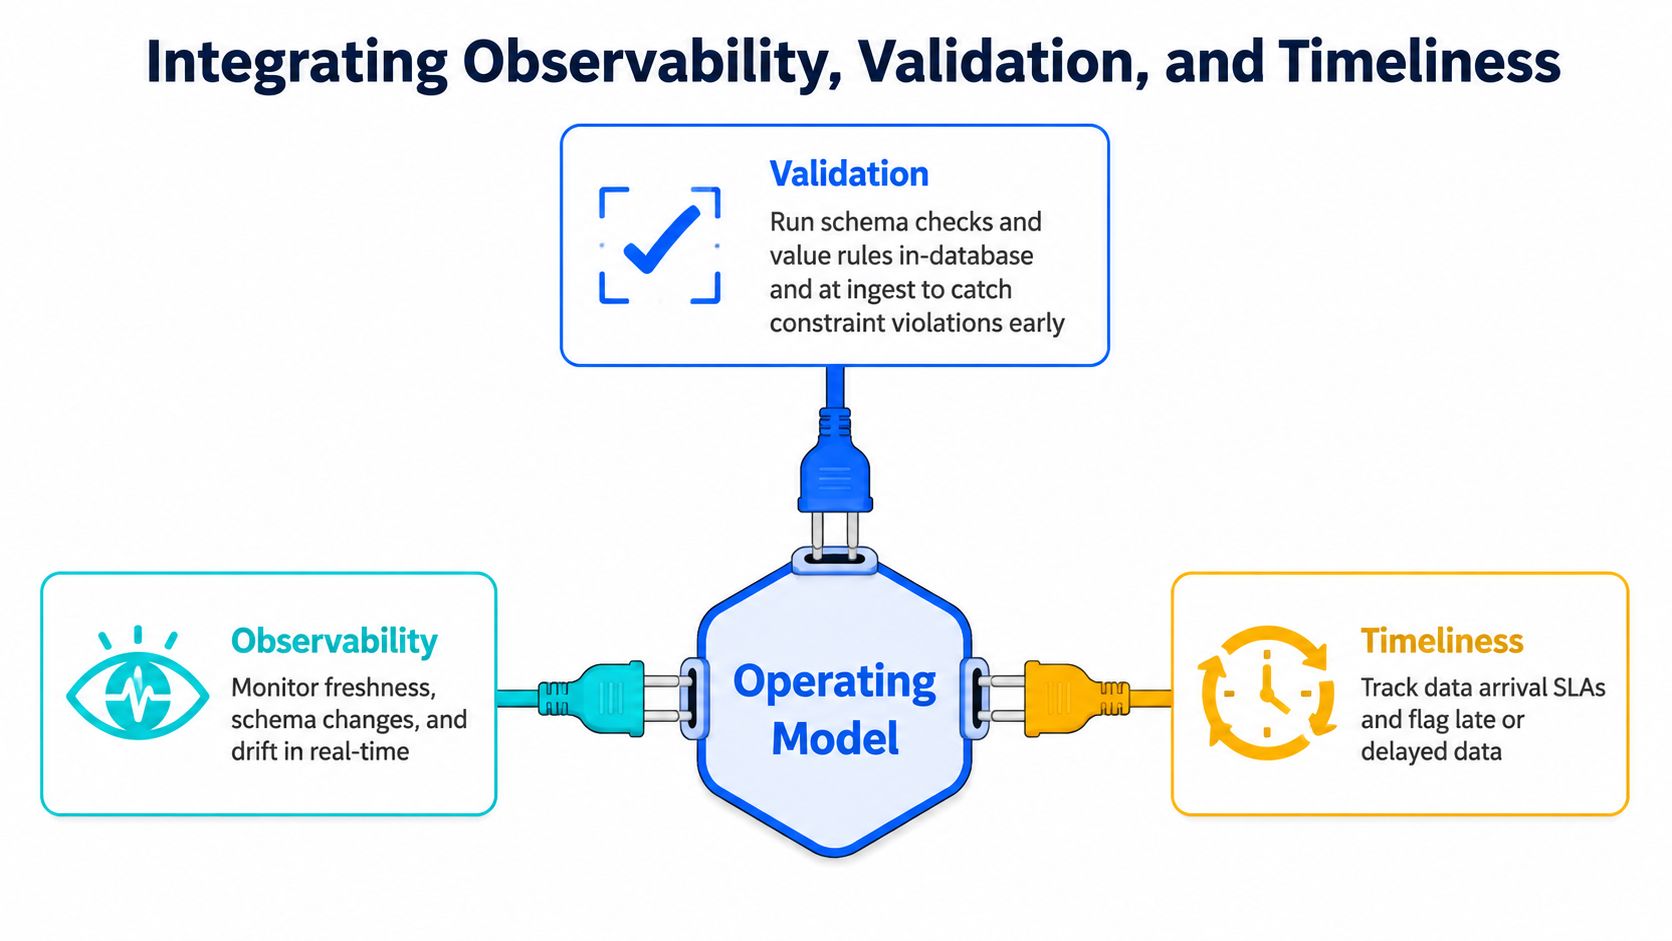
Diese Kontrollen sollten nicht zu drei parallelen Toolchains mit drei Alert-Queues werden. Sie sind komplementäre Schichten eines Betriebsmodells, und jede Schicht braucht einen klaren Owner, einen Schweregrad und eine Übergabe.
Validierung erkennt explizite Verstöße
Validierung prüft, ob ein Datensatz eine definierte Anforderung erfüllt. Auf Warehouse-Ebene können eine NOT NULL-Bedingung auf Kunden-IDs und eine referenzielle Prüfung gegen die Kundendimension ungültige Datensätze beim Schreiben abfangen. Der Datenproduzent verantwortet die Korrektur an der Quelle, der Steward die Bedeutung der Regel und der Plattform-Engineer die verlässliche Ausführung.
Nutzen Sie harte Gates für Fehler, die eine nachgelagerte Nutzung unsicher machen. Nutzen Sie weiche Gates oder Quarantänepfade, wenn das Geschäft kontrollierte Ausnahmen verträgt. Die Entscheidung liegt beim verantwortlichen Data Owner — nicht bei dem Engineer, der zufällig den Alert erhält.
Observability erkennt, was Regeln übersehen
Observability beobachtet, wie sich Datensysteme und Datensätze über die Zeit verhalten. Sie erkennt unerwartete Volumina, Verteilungen, Aktualität, Workloads und Schemaänderungen, selbst wenn jede Zeile eine statische Regel besteht. Eine plötzliche Anomalie im Transaktionsvolumen kann auf eine fehlende Quellpartition, eine doppelte Ladung oder ein untersuchungswürdiges Geschäftsereignis hindeuten.
Die Reaktion muss das Signal mit Kontext verbinden. Metadaten sollten betroffene Datenprodukte, nachgelagerte Berichte und den für den vorgelagerten Prozess verantwortlichen Produzenten ausweisen. Ohne diesen Kontext erzeugt eine Observability-Plattform Alerts, ohne Entscheidungen zu verbessern. Das zentrale Enablement-Team kann das Monitoring-Muster pflegen, während der Domain Owner beurteilt, ob die Änderung ein Vorfall ist.
Pünktlichkeit verdient eine eigene Kontrolle
Pünktlichkeit fragt, ob Werte noch dem aktuellen Zustand der realen Objekte entsprechen, die sie abbilden. Operative Teams messen sie meist als Latenz von Entstehung bis Verfügbarkeit; instrumentieren Sie daher event_time, processed_time und available_time, um Erfassungs-, Verarbeitungs- und Verfügbarkeitsverzögerungen zu unterscheiden (Forschung zu Timeliness in der Datenqualität).
Ein Aktualitätsschwellenwert sollte zu einem durchsetzbaren Service Level Objective des Datenprodukts werden. Automatische Altersprüfungen können Datensätze markieren, die das akzeptierte Alter überschreiten, und machen überfällige Daten so zum Vorfall statt zur passiven Dashboard-Notiz (Leitfaden zum Timeliness-Monitoring). Der Owner entscheidet dann, ob die Nutzung blockiert, eine Warnung veröffentlicht oder ein Fallback aktiviert wird.
Validierung fragt: „Ist dieser Wert akzeptabel?“ Observability fragt: „Ist das Verhalten ungewöhnlich?“ Pünktlichkeit fragt: „Kam die Lieferung noch rechtzeitig, um nützlich zu sein?“ Das Betriebsmodell weist jede Antwort einer Person und einem Reaktionsweg zu. Teams, die Data Observability evaluieren, sollten deshalb Workflow und Verantwortlichkeiten ebenso prüfen wie die Erkennungsfähigkeit.
Umsetzungs-Roadmap vom Pilot zur Enterprise-Skalierung
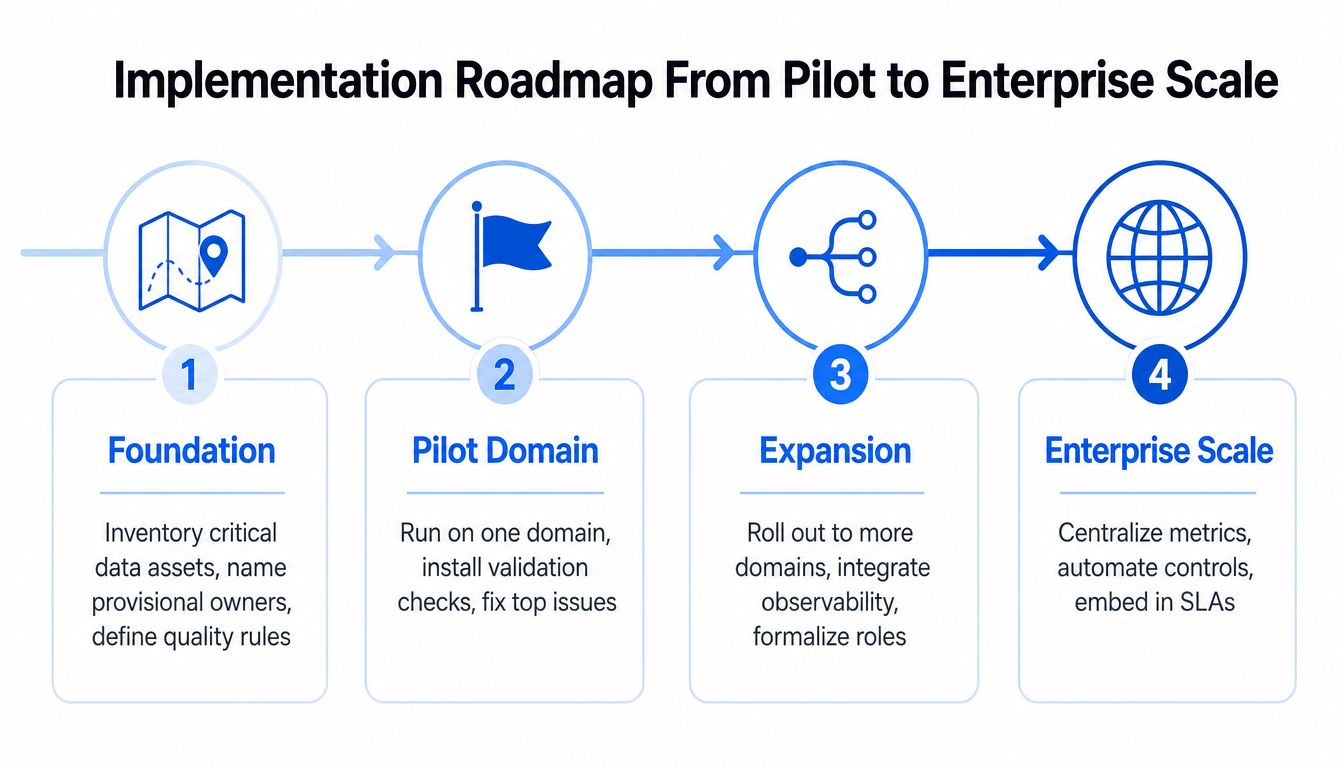
Ein verlässlicher Rollout startet mit einem eng gefassten Geschäftsrisiko und weitet sich erst aus, wenn die Verantwortungsschleife funktioniert. Breite Inventare und große Regelbibliotheken wirken produktiv, erzeugen aber oft Befunde ohne Owner, die das Vertrauen in das Programm schwächen.
Fundament
Inventarisieren Sie kritische Datenassets und kartieren Sie Konsumenten, Produzenten, Owner und bekannte Fehlerbilder. Benennen Sie vorläufige Business Owner und Stewards, definieren Sie eine Schweregrad-Taxonomie und veröffentlichen Sie einen Incident-Workflow von Erkennung über Triage, Quarantäne, Eskalation und Behebung bis zum Abschluss.
Der Governance-Lead verantwortet das Betriebsdesign. Ein Plattform-Lead verantwortet den Ausführungsweg, während Domänenverantwortliche bestätigen, welche Assets zählen. Die Abschlussbedingung ist praktisch: Jedes ausgewählte kritische Asset hat einen vorläufigen Owner, und jeder Vorfall hat einen dokumentierten Weg.
Pilot-Domäne
Wählen Sie eine wertvolle Domäne wie Umsatz oder Customer 360. Definieren Sie die ersten Datenkontrakte, implementieren Sie fokussierte Validierungs- und Pünktlichkeitskontrollen und verbinden Sie ein Observability-Signal mit dem Bereitschaftsdienst. Der Domain Owner beurteilt Fehler, der Produzent korrigiert die Quelllogik, das Plattformteam betreibt die Kontroll-Laufzeit.
Der Pilot ist abgeschlossen, wenn das Team Erkennung, Zuweisung, Ursachenanalyse, Behebung und Abschluss auf demselben Betriebsweg zeigen kann. Bewerten Sie ihn nicht an der Zahl ausgelieferter Regeln, sondern daran, ob die Verantwortlichkeit einen echten Ausfall übersteht.
Ausweitung
Replizieren Sie das Muster über mehrere Domänen, richten Sie ein DQ-Council ein und standardisieren Sie Mindestanforderungen an Kontrollen und Metadaten. Das Council sollte domänenübergreifende Konflikte lösen, gemeinsame Definitionen freigeben und wiederkehrende Fehler prüfen. Die Domänen behalten die Verantwortung für ihre Datenergebnisse.
Nützliche Abschlusskriterien sind MTTD unter 24 Stunden und 80 % der kritischen Assets mit dokumentierten Ownern. Diese Ziele sind lokale Betriebsziele, keine universellen Benchmarks. Werden sie nicht erreicht, prüfen Sie Übergaben und Eskalationsbefugnisse, bevor Sie weitere Automatisierung ergänzen.
Enterprise-Skalierung
Verankern Sie Datenqualitätsmaße in Scorecards für Datenprodukte, Release-Reviews, Service Level Agreements und Budgetgesprächen. Verfolgen Sie die Kosten schlechter Qualität über Nacharbeitsstunden, wiederkehrende Behebung und verzögerte Entscheidungen. Die zentrale Funktion wird zur Enablement- und Assurance-Schicht, während die Domänen die Verantwortung für ihre Daten behalten.
Kontinuierliche Verbesserung heißt, wirkungslose Regeln stillzulegen, Schwellenwerte bei geänderten Use Cases anzupassen und zu prüfen, ob Kontrollen geschäftlichen Schaden verhindern. Enterprise-Skalierung ist kein größeres Dashboard. Sie ist ein wiederholbares System, das Qualitätsentscheidungen im Alltag sichtbar macht.
Branchenspezifische Aspekte in regulierten Sektoren
Das Rückgrat des Betriebsmodells bleibt über regulierte Sektoren hinweg stabil, doch Entscheidungsrechte und Nachweispflichten ändern sich. Der Finanzsektor braucht Lineage-Nachweise für BCBS 239 und SOX-relevante Berichte, mit Verantwortung nah am Hauptbuch statt nur an einem groben Datensatz. Das Gesundheitswesen braucht Stewards für klinische Sicherheit, die eine Pipeline stoppen können, wenn sich Referenzdaten ändern, während Vollständigkeits- und Genauigkeitskontrollen mit dem HIPAA-Risiko verknüpft sind.
Telekommunikationsteams sollten CDR-Qualität mit Revenue Assurance verbinden. Der Netzbetrieb gehört ins DQ-Council, weil verlorene oder fehlerhafte Datensätze Abrechnung und Serviceanalyse beeinflussen können. Der öffentliche Sektor braucht Kontrollen für bürgerbezogene Daten, bei denen Aktualität und Zugänglichkeit Informationsfreiheits- und Gleichstellungsverpflichtungen stützen.
Für Organisationen, die in klinischer Forschung, Regulatorik und kommerziellen Funktionen arbeiten, können Verzeichnisse von Biotech-Führungskräften nützlichen Kontext dazu liefern, welche Stakeholder in Qualitätsentscheidungen vertreten sein sollten. Es geht nicht darum, vier getrennte Governance-Programme zu schaffen, sondern einen Verantwortungsmechanismus zu erhalten und Nachweise, Owner und Eskalationsschwellen an die jeweilige Risikoumgebung anzupassen.
Branche | Schwerpunkt der Verantwortung | Wichtigster KPI-Treiber | Besondere Kontrollschicht |
|---|---|---|---|
Finanzwesen | Verantwortliche für Hauptbuch und Berichte | Vollständigkeit der Lineage und Berichtseignung | Nachweise für BCBS 239 und SOX |
Gesundheitswesen | Klinische Sicherheit und Data Stewards | Vollständigkeit, Genauigkeit und Verlässlichkeit für die Patientenversorgung | Sicherheitsorientierter Eingriff in Pipelines |
Telekommunikation | Netzbetrieb und Revenue Assurance | Datensatzintegrität und Abrechnungssicherheit | CDR-Validierung und Abstimmung |
Öffentlicher Sektor | Verantwortliche für Programme, Barrierefreiheit und Akten | Aktualität, Zugänglichkeit und Verlässlichkeit öffentlicher Leistungen | Kontrollen für Informationsfreiheit und Gleichstellung |
Eine zentrale Richtlinie kann alle vier Sektoren tragen, doch lokale Owner müssen die Hoheit darüber behalten, was ein inakzeptabler Fehler ist. Diese Balance macht das Modell modular, ohne es unscharf werden zu lassen.
Verbreitete Irrtümer und Ihre Checkliste für nächste Woche
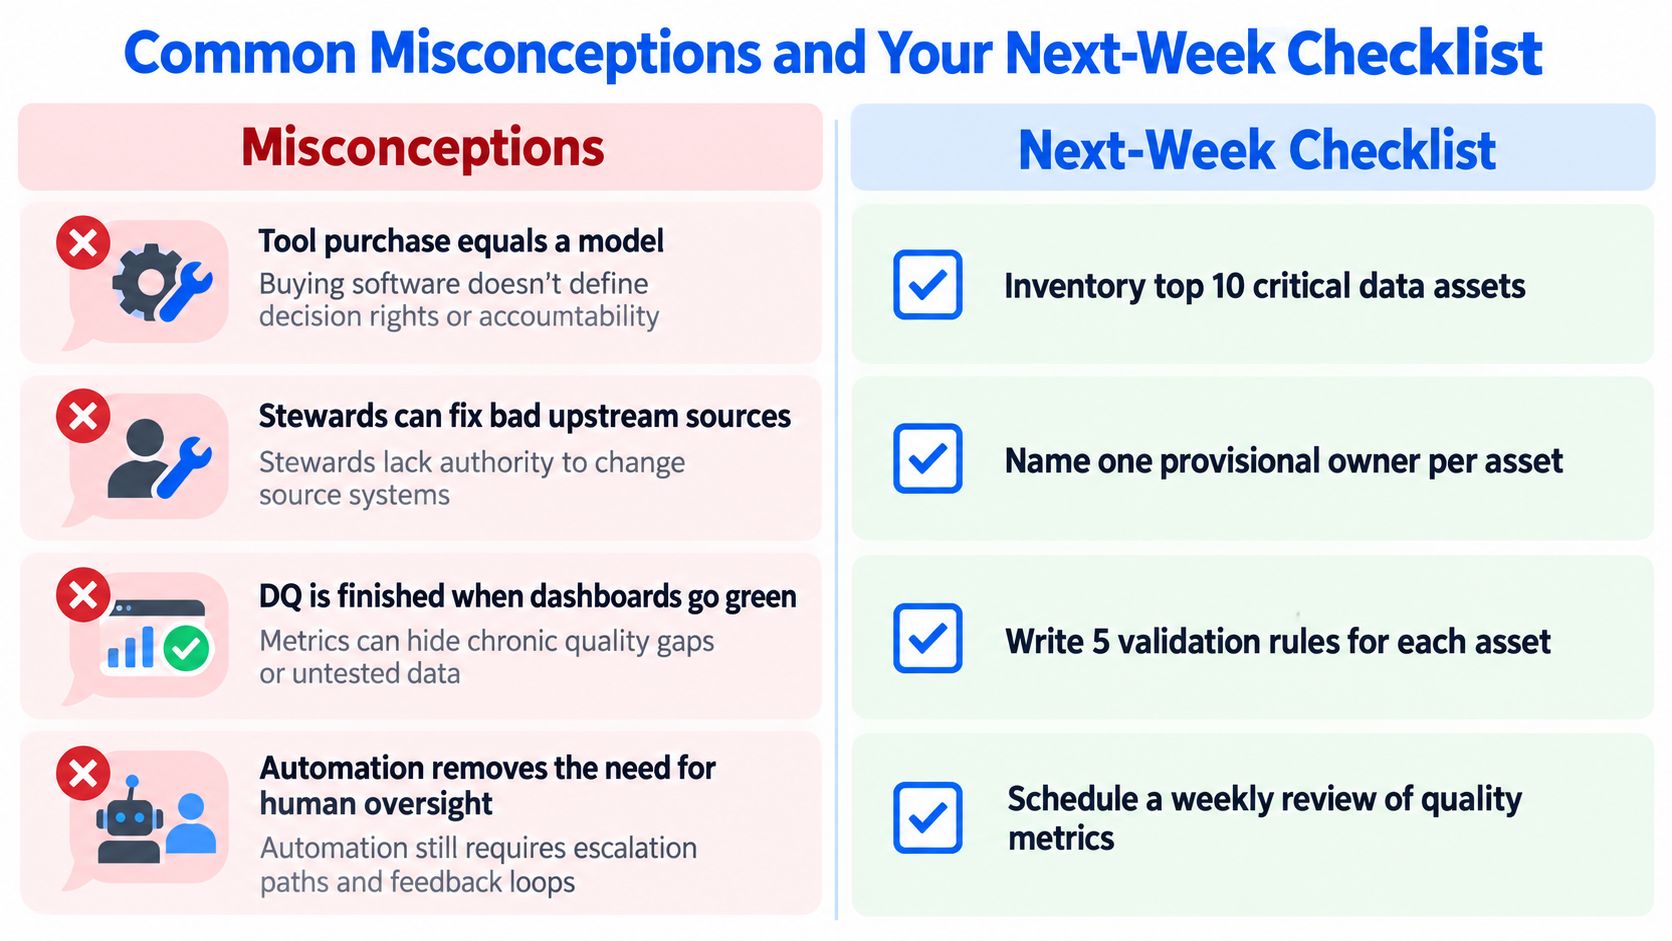
Ein Softwarekauf schafft kein Betriebsmodell. Eine Plattform kann Anomalien erkennen oder Validierung ausführen, aber Menschen müssen weiterhin Verantwortung festlegen, Schwellenwerte genehmigen, Ausnahmen entscheiden und Fehler eskalieren.
Data Stewards können außerdem nicht jeden vorgelagerten Defekt beheben. Fehlt einem Steward die Befugnis, ein Quellsystem zu ändern, verdeckt die Zuweisung des Vorfalls nur die Verantwortungslücke. Der Produzent muss die Korrektur verantworten, der Steward pflegt die Bedeutung, und das Governance-Gremium löst Konflikte.
Grüne Dashboards beweisen nicht, dass Qualität erledigt ist. Ein Datensatz kann seine getesteten Regeln bestehen, während sich eine unüberwachte Quelle ändert, eine Aktualitätszusage bricht oder eine Geschäftskennzahl aus dem erwarteten Verhalten läuft. Mehr Regeln können das verschlimmern, wenn sie Rauschen erzeugen, Logik duplizieren oder Teams dazu verleiten, Bestehensquoten statt Entscheidungssicherheit zu optimieren.
Fünf Maßnahmen für nächste Woche
Owner benennen: Bestätigen Sie für jedes kritische Datenelement oder Asset einen verantwortlichen DQ-Owner.
Quarantänerechte dokumentieren: Halten Sie fest, wer Daten sperren, in Quarantäne stellen oder freigeben darf, wenn eine kritische Kontrolle fehlschlägt.
Ein Signal an die Rufbereitschaft anbinden: Verdrahten Sie einen Observability-Alert mit einer bestehenden Engineering- oder Betriebsrotation.
Eine ungenutzte Regel abschalten: Entfernen Sie eine Prüfung, die niemand prüft oder erklären kann, und dokumentieren Sie die Entscheidung.
Einen Aktualitäts-KPI veröffentlichen: Bringen Sie eine Pünktlichkeitskennzahl in ein Führungsgremium, in dem jemand darauf reagieren kann.
Ein praxisnahes Data-Governance-Betriebsmodell braucht Entscheidungsrechte, Rollen, Gremien, Routinen, Übergaben, Leistungsbewertung, Änderungskontrolle und eine Umsetzungs-Roadmap. Behalten Sie diesen Maßstab bei der Prüfung Ihrer Checkliste im Blick: Wenn eine Aufgabe nicht benennt, wer entscheidet und was als Nächstes passiert, ist sie noch keine operative Kontrolle.
digna hilft Datenteams, In-Database-Validierung, Anomalieerkennung, Timeliness-Monitoring und Schema-Change-Tracking in einer gemeinsamen Vorfallsicht innerhalb der eigenen Umgebung zu verbinden. Besuchen Sie digna, um zu sehen, wie die Plattform ein Datenqualitäts-Betriebsmodell mit verantwortlichen Ownern, messbaren Kontrollen und handlungsfähiger Eskalation unterstützt.
So sieht das bei digna in der Praxis aus: Datenqualitäts-Monitoring über Ihre Plattformen hinweg.
Häufig gestellte Fragen
Was ist ein Datenqualitäts-Betriebsmodell?
Ein Datenqualitäts-Betriebsmodell ist die Struktur, die Qualität von einer Reihe von Projekten in den Tagesbetrieb überführt. Es legt fest, wer für welche Daten verantwortlich ist, welche Kontrollen laufen, wie Ergebnisse gemessen werden und was passiert, wenn etwas bricht.
Welche Komponenten hat ein Datenqualitäts-Betriebsmodell?
Fünf machen es operativ: Ownership und Verantwortlichkeit, definierte Kontrollen über Validierung, Observability und Pünktlichkeit, KPIs, die zeigen, ob Qualität besser wird, die Werkzeuge, die die Kontrollen ausführen, und die Routinen — Triage, Eskalation, Review —, die das Modell am Leben halten.
Sollte Datenqualität zentral oder föderiert organisiert sein?
Das hängt davon ab, wo die Verantwortung bereits liegt. Ein zentrales Team funktioniert, solange die Landschaft klein ist; ein föderiertes Modell passt zu Organisationen mit starker Domänenverantwortung; die meisten Unternehmen landen hybrid — zentrale Standards und Werkzeuge, Ausführung in den Domänen.
Welche KPIs messen den Datenqualitätsbetrieb?
Nützlich sind die Abdeckung kritischer Datensätze, Mean Time to Detect und Mean Time to Resolve, Häufigkeit und Wiederholung von Vorfällen sowie der Anteil der Probleme, die das Monitoring findet statt ein Fachanwender meldet.
Wie lange dauert die Einführung eines Datenqualitäts-Betriebsmodells?
Die praktische Reihenfolge lautet Fundament, Pilot-Domäne, Ausweitung, Enterprise-Skalierung. Ein fokussierter Pilot zeigt meist innerhalb eines Quartals messbar bessere Erkennung — und genau dieser Nachweis macht die Ausweitung finanzierbar.


