Datenklassen erklärt: Ein praktischer Leitfaden für moderne Teams
|
7
min. Lesezeit

Der gängige Rat lautet: Daten einmal klassifizieren, Labels wie öffentlich oder vertraulich vergeben und das Governance-Problem als gelöst betrachten. Dieser Ansatz verwechselt Beschreibung mit Kontrolle. Ein Label, das weder Zugriff, Validierung, Aufbewahrung, Monitoring noch Incident Response verändert, ist Dokumentation und keine Governance.
Ein nützliches Framework für Datenklassen muss beschreiben, was ein Asset enthält, wie es sich verhält und was die Organisation tun muss, wenn sich sein Risiko ändert. Dazu gehören analytischer Typ, statistische Bedeutung, Darstellungsform, geschäftlicher Kontext und Sicherheitsauswirkung. Die eigentliche Arbeit beginnt nach der Veröffentlichung der Taxonomie, denn Teams müssen jede Klasse mit Kontrollen verbinden, die in echten Datenbanken, Pipelines, Warehouses, Lakes und Dokumentenablagen greifen.
Inhaltsverzeichnis
Das verborgene Risiko statischer Datenlabels
Viele Klassifizierungsprogramme scheitern, ohne dass es jemand bemerkt: Ein Governance-Team erstellt eine Richtlinie, Verantwortliche taggen wichtige Datensätze, und Auditoren erhalten einen Katalogexport, während die Berechtigungen unverändert bleiben. Das Monitoring behandelt weiterhin jede Tabelle gleich, und Incident Responder haben kein verlässliches Signal, wenn ein gewöhnlicher operativer Datensatz zu einem Asset mit höherem Risiko wird.
Kategorien wie öffentlich, intern, vertraulich und reguliert bieten nach wie vor ein nützliches gemeinsames Vokabular. Das Scheitern beginnt, wenn Teams annehmen, dass dieses Vokabular von selbst etwas durchsetzt. Ein statisches Label maskiert kein Feld, verkürzt keine Aufbewahrung, erhöht keine Validierungsfrequenz und eskaliert keinen Alert.
Die Lücke zwischen Klassifizierung und Durchsetzung
Die Daten zeigen eine messbare operative Lücke. 55 % der befragten Organisationen hatten keine automatisierte Klassifizierung über alle wichtigen Systeme hinweg erreicht, und nur 47 % verfügten über eine Klassifizierung, die nachgelagerte Kontrollen durchsetzte, statt nur Labels zu vergeben, so der Kiteworks 2026 Data Security and Compliance Risk Report.
Diese Zahlen trennen zwei Ergebnisse, die Teams oft vermischen. Die Genauigkeit der Klassifizierung fragt, ob die zugewiesene Klasse korrekt ist. Die Wirksamkeit der Klassifizierung fragt, ob diese Klasse das Verhalten der Systeme verändert, die die Daten speichern, verarbeiten, überwachen und schützen.
Ein Team kann eine Kundentabelle korrekt als vertraulich einstufen und trotzdem breiten Analystenzugriff bestehen lassen. Es kann einen regulatorischen Bericht als hoch integritätskritisch kennzeichnen und dann zulassen, dass eine ungeprüfte Schemaänderung seine Eingangsdaten verändert. Es kann eine Pipeline als hochverfügbar klassifizieren und dabei nur überwachen, ob ein Job abgeschlossen wurde, nicht aber, ob die erwarteten Daten rechtzeitig angekommen sind.
Praxisregel: Behandeln Sie jede Klasse als Auslöser für eine Kontrollentscheidung. Wenn sich keine Kontrolle ändert, stellen Sie den operativen Wert der Klasse infrage.
Warum zusätzliche Kategorien das Problem selten lösen
Schwache Durchsetzung verleitet Teams oft dazu, die Taxonomie zu erweitern. Sie ergänzen Labels für personenbezogene Daten, Finanzdaten, kritische Daten, eingeschränkte Daten, für KI freigegebene Daten, Archivdaten und lokale Ausnahmen. Das Ergebnis wirkt präzise, doch für Verantwortliche und Tools wird es noch unklarer, welches Label gilt und welche Maßnahme folgt.
Eine kleinere Zahl verlässlicher Klassen, die mit expliziten Maßnahmen verbunden sind, funktioniert meist besser. Jede Klasse sollte praktische Fragen beantworten:
Wer darf auf das Asset zugreifen? Legen Sie die Zugriffsregeln und zulässige Ausnahmen fest.
Was muss validiert werden? Bestimmen Sie Prüfungen auf Feld-, Datensatz-, Abgleichs- oder Geschäftsregelebene.
Wie schnell müssen Fehler sichtbar werden? Legen Sie Alert-Schweregrad und Reaktionserwartungen fest.
Wie sollen Änderungen nachgewiesen werden? Bewahren Sie Lineage, Audit-Ereignisse und Verantwortlichkeiten auf.
Was passiert, wenn sich der Kontext ändert? Lösen Sie eine Überprüfung aus, statt das alte Label unbegrenzt bestehen zu lassen.
Die Datenklasse entfaltet ihren Wert, wenn ein automatisierter Prozess eine Diskrepanz zwischen dem Label und dem aktuellen Verhalten erkennen kann. Eine Schemaänderung, ein unerwartetes Liefermuster, eine neue nachgelagerte Nutzung oder eine veränderte geschäftliche Bedeutung können eine Neuklassifizierung erfordern.
Ohne diese Rückkopplung veraltet die Taxonomie, während Stakeholder ihr weiterhin vertrauen. Governance produziert dann einen Katalog, der das Risiko von gestern beschreibt, obwohl sich Berechtigungen, Pipelines und geschäftliche Nutzungen längst geändert haben. Klassifizierung muss deshalb mit Monitoring und Reaktion verbunden sein, sonst werden ihre Labels zur Belastung statt zur Absicherung.
Die drei Dimensionen von Datenklassen verstehen
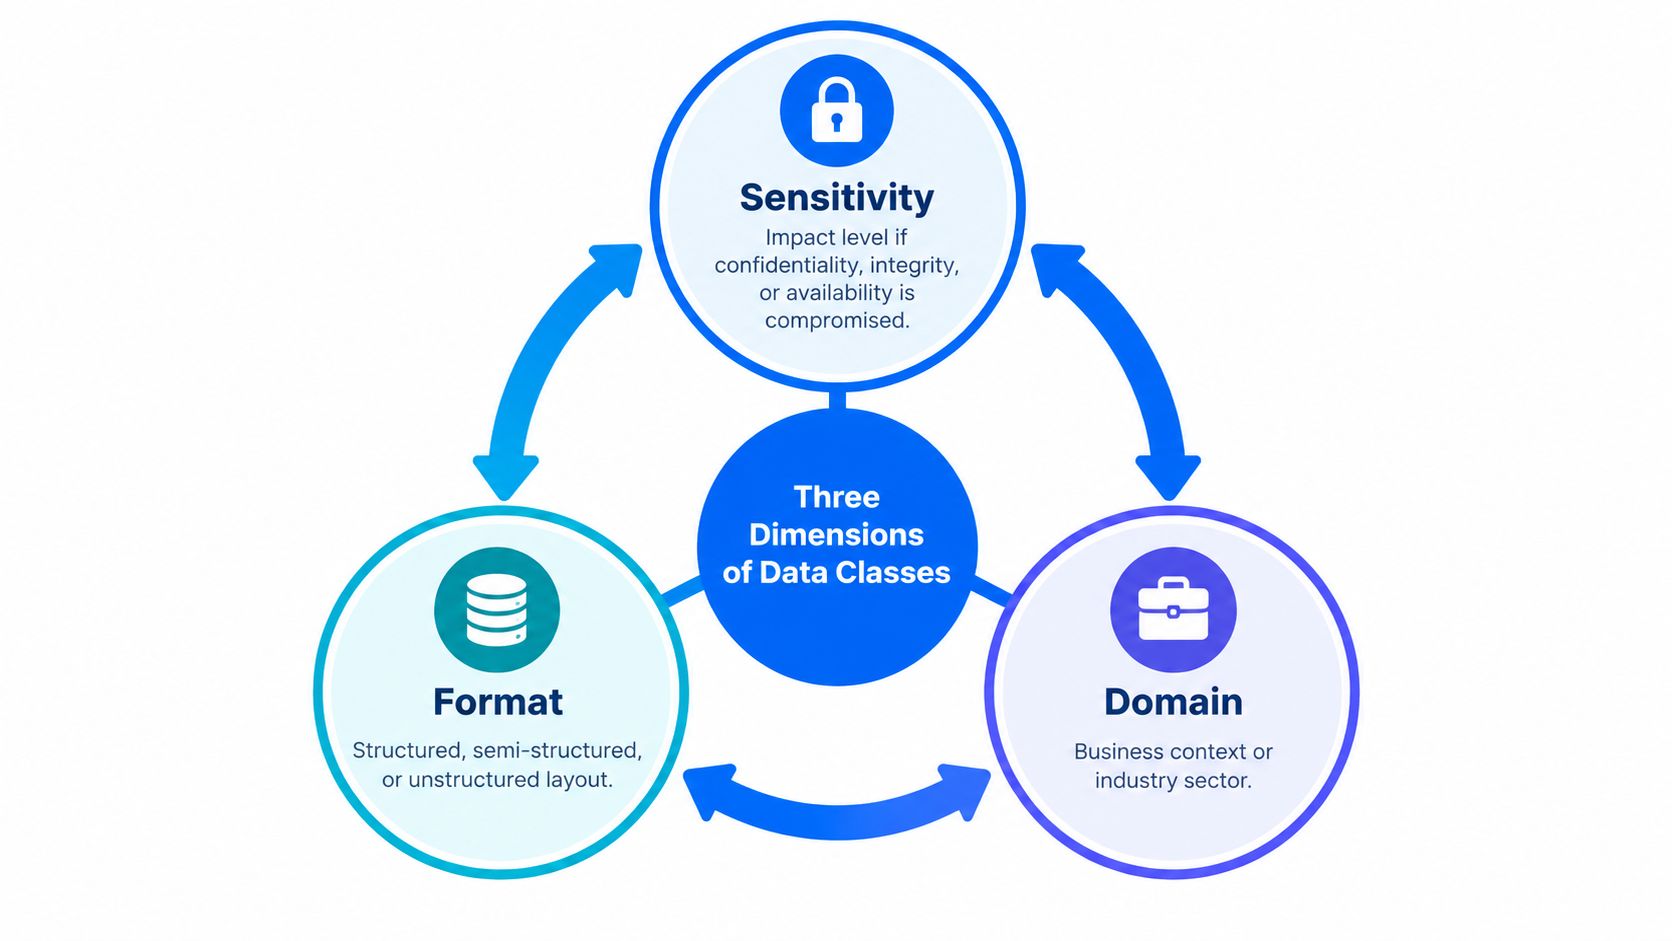
Ein verlässliches Klassifizierungssystem braucht mehr als eine Sensibilitätsskala. Es sollte Sensibilität, Format und Domäne gemeinsam bewerten, denn jede Dimension verändert die Bedeutung der anderen.
Sensibilität beschreibt die Folgen einer Kompromittierung. Das Format beschreibt, wie das Asset dargestellt ist und was sich testen lässt. Die Domäne liefert geschäftlichen Kontext, Verantwortlichkeiten und regulatorische Erwartungen. Die Klasse eines Datensatzes sollte aus dem Zusammenspiel dieser Dimensionen entstehen und nicht aus einem isoliert gewählten Label.
Sensibilität verändert die Konsequenz
Die Sicherheitsklassifizierung bewertet jeden Informationstyp unabhängig nach Vertraulichkeit, Integrität und Verfügbarkeit. Eine Klasse kann in einer Dimension niedrig und in einer anderen hoch sein. Ein öffentlicher KPI-Feed enthält vielleicht keine vertraulichen Informationen, doch falsche Werte könnten regulatorische oder operative Entscheidungen beeinflussen, was der Integrität eine hohe Tragweite gibt.
Diese Unterscheidung verhindert einen häufigen Fehler: „öffentlich“ mit „geringem Risiko“ gleichzusetzen. Auch öffentliche Daten können strenges Change Management, Abgleiche, Lineage oder Aktualitäts-Monitoring erfordern. Umgekehrt brauchen private Daten nicht zwingend in jeder Dimension identische Kontrollen.
Das Format verändert den Test
Eine relationale Tabelle unterstützt Prüfungen für Spalten, Datentypen, Eindeutigkeit, Beziehungen und Regeln auf Datensatzebene. Ein JSON-Event-Stream erfordert Aufmerksamkeit für verschachtelte Pfade, optionale Attribute, Payload-Varianten und Parserfehler. Eine Dokumentenablage braucht unter Umständen Prüfungen des Extraktionsstatus, der Metadaten und eine Bestätigung, dass gespeicherte Dateien nutzbar bleiben.
Die Darstellungsform bestimmt, welche Fehler sichtbar werden. Ein generischer Test auf fehlende Werte kann bestehen, obwohl ein verschachteltes JSON-Attribut verschwunden ist oder ein Ingestion-Job für Dokumente Dateien ohne extrahierbaren Inhalt speichert.
Die Domäne verändert die Entscheidung
Dasselbe Feld kann in unterschiedlichen Kontexten unterschiedliche Kontrollen erfordern. Ein Zeitstempel in einem Workflow im Gesundheitswesen kann über klinische Rechtzeitigkeit entscheiden. Ein Feld desselben Typs in einem öffentlichen Reporting-Feed unterstützt vielleicht Veröffentlichungspläne und Rechenschaftspflicht. Teams aus Finanzwesen, Telekommunikation, Gesundheitswesen und öffentlichem Sektor verbinden jeweils andere Konsequenzen mit Verzögerungen, Veränderungen und unvollständigen Datensätzen.
Ein praxistaugliches Modell erfasst daher Business Owner, Anwendungsfall, Kritikalität, Format und CIA-Auswirkung des Assets. Wer tiefer verstehen möchte, wie Qualitätsdimensionen diese Entscheidungen beeinflussen, findet in diesem Leitfaden Hilfe, um die Dimensionen der Datenqualität zu verstehen.
Das Ergebnis ist eine Klasse, die Engineers nicht nur sagt, was die Daten sind, sondern auch, wie sie überwacht werden sollten.
Die CIA-Triade auf die Datenklassifizierung anwenden
Eine sicherheitsorientierte Klassifizierung sollte jeden Informationstyp unabhängig nach Vertraulichkeit, Integrität und Verfügbarkeit bewerten und eine Auswirkungsstufe danach festlegen, welchen Schaden der Verlust jedes einzelnen Schutzziels verursacht. Dieses Prinzip ist in der Richtlinie zur Datenklassifizierung in Unternehmen der Organisation Amerikanischer Staaten dokumentiert.
Der praktische Fehler besteht darin, die drei Dimensionen zu einem einzigen Sensibilitätswert zusammenzufassen. Ein einzelner Wert verschleiert, warum ein Datensatz wichtig ist, und erschwert die Wahl der richtigen Kontrolle. Das High-Watermark-Prinzip löst dieses Problem: Die folgenreichste CIA-Dimension bestimmt den Gesamtschutzbedarf.
Vertraulichkeit erfordert Kontrollen gegen Offenlegung
Vertrauliche Daten verursachen Schaden, wenn Unbefugte sie einsehen, kopieren oder ableiten können. Kundendaten, Gesundheitsinformationen, Mitarbeiterdaten und geschäftlich sensibles Material brauchen Kontrollen wie eingeschränkten Zugriff, Maskierung, Verschlüsselung und Monitoring der Offenlegung.
Die Klassifizierung sollte den Informationstyp und die zulässige Nutzung bestimmen, nicht nur den Tabellennamen. Eine Tabelle namens customer_summary kann in einer Umgebung aggregierte Werte und in einer anderen direkt identifizierende Datensätze enthalten. Die Kontrolle muss dem tatsächlichen Inhalt und Kontext folgen.
Integrität erfordert Nachweise der Korrektheit
Bei Integrität geht es um unbefugte oder fehlerhafte Veränderungen. Finanzdaten, regulatorische Kennzahlen und entscheidungsrelevante Metriken können öffentlich einsehbar sein und dennoch strengen Schutz vor stillen Änderungen erfordern.
Daraus ergibt sich ein anderes Kontrollset:
Datensatzvalidierung: Prüfen Sie Werte gegen Geschäftsregeln und zulässige Beziehungen.
Abgleich: Vergleichen Sie zusammenhängende Summen oder Ergebnisse zwischen Quelle und Ziel.
Lineage: Bewahren Sie den Weg von den Quelldatensätzen bis zu den veröffentlichten Metriken.
Manipulationsnachweis: Protokollieren Sie Änderungen und machen Sie unerklärte Veränderungen sichtbar.
Ein öffentlicher Daten-Feed kann daher eine hohe Integritätsauswirkung haben und zugleich eine niedrige Vertraulichkeit. Die Klasse sollte diese Unterscheidung an Data Engineers und Incident Responder weitergeben.
Verfügbarkeit erfordert Wissen über die Lieferung
Bei Verfügbarkeit geht es um den Zugriff zu dem Zeitpunkt, an dem Nutzer und Systeme die Daten brauchen. Operative Datensätze, Feeds und Plattformabhängigkeiten können durch verspätete Lieferung, fehlende Loads oder Ausfälle versagen, selbst wenn ihr Inhalt korrekt und vertraulich geschützt bleibt.
Das Monitoring sollte daher Aktualität, Lieferlatenz, erwartete Ankunftsmuster und fehlende Loads verfolgen. Ein abgeschlossener Pipeline-Task ist kein Beweis dafür, dass nutzbare Daten angekommen sind. Die Kontrolle muss das Datenereignis beobachten, auf das nachgelagerte Nutzer tatsächlich angewiesen sind.
Eine CIA-basierte Klasse sollte direkt auf Alert-Schweregrad, Validierungsfrequenz, Aufbewahrung und Reaktionsziele bei Vorfällen abgebildet werden. Sie sollte außerdem überprüfbar bleiben. Geschäftliche Nutzungen ändern sich, Abhängigkeiten wachsen und Schemas entwickeln sich weiter. Eine Klassifizierung, die diese Veränderungen nicht aufnehmen kann, wird zu einer veralteten Annahme statt zu einem verlässlichen Sicherheitssignal.
Klassifizierung nach Datenformat strukturieren
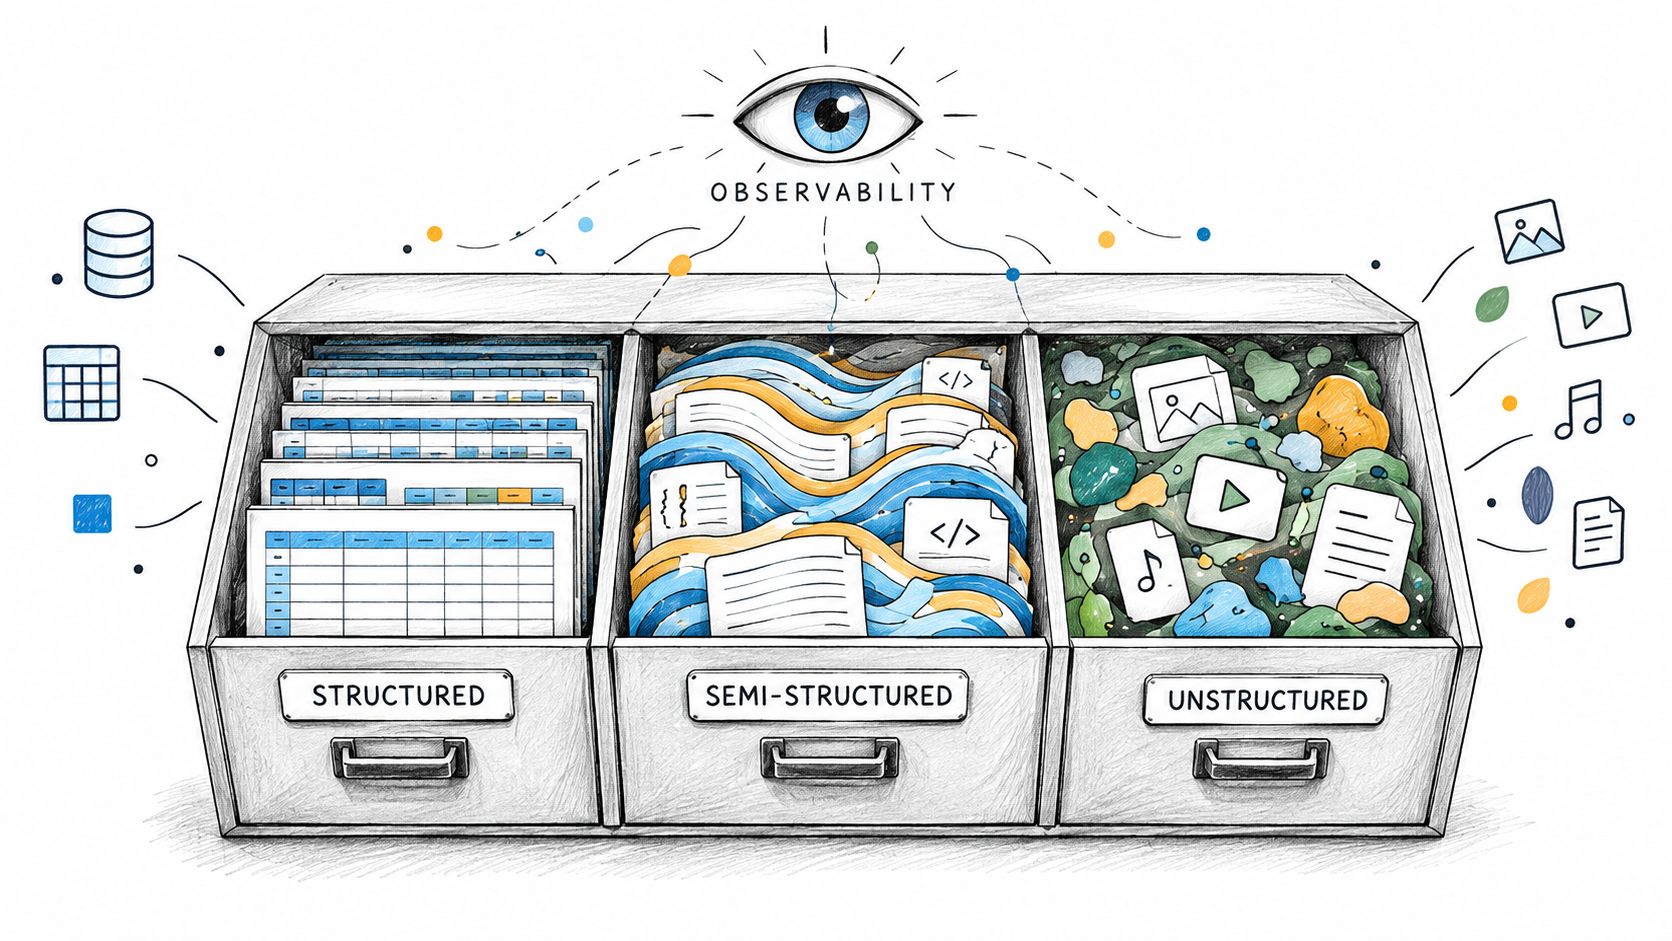
Die erste strukturelle Frage ist nicht, ob ein Datensatz sensibel ist. Sie lautet: Wie sind die Daten dargestellt? Strukturierte, semistrukturierte und unstrukturierte Assets zeigen unterschiedliche Fehlerbilder und brauchen daher unterschiedliche Observability-Kontrollen. Die Europäische Kommission nennt Qualität, Struktur, Interoperabilität, Authentizität und Integrität als wichtige Voraussetzungen, um Wert aus Daten zu schöpfen, insbesondere im KI-Umfeld, wie in ihrem Dokument zu Data Governance und Datenpolitik zusammengefasst.
Strukturierte Assets
Strukturierte Tabellen folgen einem definierten Modell. Dadurch eignen sie sich für gezielte Prüfungen:
Schemakonformität: Erkennen Sie fehlende, hinzugefügte oder umbenannte Spalten.
Typvalidierung: Bestätigen Sie, dass Werte der analytischen Erwartung entsprechen.
Eindeutigkeit: Identifizieren Sie doppelte Schlüssel oder unerwartete Wiederholungen.
Referenzielle Integrität: Prüfen Sie Beziehungen zwischen Tabellen.
Geschäftsregeln: Testen Sie Bedingungen auf Datensatzebene und zulässige Kombinationen.
Der Speichertyp ist trotzdem nicht dasselbe wie die analytische Bedeutung. Ein numerisches Feld kann eine Kategorie kodieren, etwa einen Statuscode, statt eine messbare Größe darzustellen. Statistische Daten werden üblicherweise in kategoriale und quantitative Klassen unterteilt, und diese Unterscheidung bestimmt, ob Teams Häufigkeitszählungen und die Erkennung unerwarteter Werte oder Verteilungen, Mittelwerte, Perzentile, Varianz und Ausreißeranalysen einsetzen sollten. Das OECD-Glossar statistischer Begriffe dokumentiert diesen Unterschied.
Semistrukturierte Payloads
JSON-Events und ähnliche Payloads haben oft eine erkennbare Form, aber kein konsequent durchgesetztes Schema. Das Monitoring sollte das Vorhandensein verschachtelter Felder, Strukturvarianten, Parserfehler, Änderungen an Arrays und semantischen Drift prüfen.
Eine Prüfung der Null-Rate kann einen Fehler übersehen, bei dem ein Producer einen Wert in einen anderen Pfad verschiebt oder seine Bedeutung ändert, während das Feld befüllt bleibt. Teams, die mit spaltenorientierter Speicherung arbeiten, sollten außerdem das Parquet-Dateiformat verstehen, einschließlich der Frage, wie seine Struktur die nachgelagerte Validierung und das Schema-Tracking beeinflusst.
Unstrukturierte Dokumente und Medien
Dokumente, Bilder und andere Medien erfordern ein anderes Kontrollmodell. Ein erfolgreicher Datei-Upload beweist nicht, dass die Extraktion funktioniert hat, die Metadaten vollständig sind oder die nachgelagerte Verarbeitung den Inhalt interpretieren kann.
Verfolgen Sie Ingestion-Status, Vollständigkeit der Extraktion, Gültigkeit der Metadaten und Ergebnisse der Inhaltsverarbeitung. Die Einstufung eines Assets als unstrukturiert sollte diese Prüfungen automatisch auswählen, statt relationale Annahmen anzuwenden.
Die wirksamsten Kataloge erfassen Darstellungsform, Strenge des Schemas, Verantwortlichkeiten, erwartetes Aktualisierungsverhalten und nachgelagerte Kritikalität. Das Format ist keine beschreibende Fußnote. Es bestimmt, welche Signale nachweisen können, dass das Asset nutzbar bleibt.
Klassifizierung mit ausführbaren Kontrollen verbinden
Sobald Klassen vergeben sind, stellt sich die Frage, was jede Klasse ein System tun lässt. Die Tabelle ordnet vier gängigen Klassen eine primäre Kontrolle und den Nachweis zu, der belegt, dass die Kontrolle ausgelöst wurde.
Die operativen Optionen vergleichen
Datenklasse | Primäre Kontrolle | Monitoring-Metrik |
|---|---|---|
Vertrauliche Kundendaten | Zugriffsbeschränkung, Maskierung und Prüfung der Offenlegung | Unbefugter Zugriff, Maskierungsstatus und Offenlegung sensibler Felder |
Finanzdaten mit hoher Integrität | Datensatzvalidierung, Abgleich, Lineage und Manipulationsnachweis | Regelverstöße, Abgleichsdifferenzen und strukturelle Änderungen |
Hochverfügbare operative Daten | Erkennung von Aktualität, Lieferung und Ausfällen | Ankunftszeit, fehlende Loads, Latenz und Verfügbarkeit |
Öffentliche, aber entscheidungskritische Metriken | Governance der Veröffentlichung und Integritätsvalidierung | Wertedrift, Abgleich mit der Quelle und unerklärte Änderungen |
Jede Zeile verbindet ein Label mit einer operativen Reaktion. Verantwortliche müssen „kritisch“ nicht in jedem System anders auslegen. Sie können die erforderliche Kontrolle bestimmen, Verantwortung zuweisen und die Nachweise prüfen, die entstehen, wenn die Kontrolle greift oder versagt.
Eine Klasse hat nur dann einen Wert, wenn ihre Richtlinie die Systeme erreicht, die sie durchsetzen. Katalog-Metadaten müssen unter Umständen Zugriffsbeschränkungen, Maskierung, Aufbewahrung, Monitoring, Incident-Routing oder die Prüfung von Veröffentlichungen steuern. Sind diese Ziele nicht angebunden, bleibt das Label rein beschreibend und kann falsche Sicherheit erzeugen.
Klassen über die gesamte Datenlandschaft abbilden
Beginnen Sie mit Assets mit großer Tragweite statt mit jedem Objekt in der Organisation. Vergeben Sie die mehrdimensionale Klasse, benennen Sie den Verantwortlichen, legen Sie das Ziel der Kontrolle fest und prüfen Sie, ob die Klassifizierung jedes relevante System erreicht. Kontrollieren Sie, ob jedes System beim Ausführen der Kontrolle einen Nachweis festhält, etwa ein Validierungsergebnis, ein Zugriffsereignis, ein Abgleichsergebnis oder einen Alert.
Die Empfehlungen zu Datenvalidierungsregeln und kontinuierlicher Datenqualität helfen, Klassen in Prüfungen auf Datensatzebene, Geschäftsregeln und wiederkehrende Qualitätskontrollen zu übersetzen. Die praktische Entscheidung lautet, Prüfungen zu definieren, die dem Risiko entsprechen, statt jedem Asset einen generischen Qualitätswert zuzuweisen.
Zur Verantwortung gehört auch die Neuklassifizierung. Ein Datensatz kann einen neuen Nutzer gewinnen, sein Schema ändern, zwischen Domänen wechseln oder in einen regulierten Workflow eingehen. Jedes dieser Ereignisse sollte eine Überprüfung der Klasse und eine Aktualisierung der nachgelagerten Richtlinien auslösen.
Testen Sie die Kette regelmäßig. Eine Klassifizierung, die einen Katalog aktualisiert, aber weder Monitoring, Zugriff noch Workflow-Verhalten verändert, ist keine Governance. Sie ist eine unüberprüfte Absicht.
Observability in die Infrastruktur einbetten
Klassifizierung wird durchsetzbar, wenn das Monitoring nah an den Daten läuft und auf denselben Kontext reagieren kann, der die Klasse definiert hat. Werden Produktionsdatensätze in einen externen Analysedienst verschoben, kann das unnötige Risiken schaffen, Anforderungen an die Datenresidenz erschweren und Governance-Entscheidungen von operativen Nachweisen trennen.
Eine eingebettete Architektur hält die Analyse in einer vom Kunden kontrollierten Infrastruktur. Das ist wichtig für Organisationen mit strengen Anforderungen an Sicherheit, Compliance oder Datenresidenz, einschließlich Teams, die On-Premises oder in Private-Cloud-Umgebungen arbeiten.

Kontrollen nah an der Quelle halten
Die Ausführung direkt in der Datenbank ermöglicht es Teams, Metriken zu berechnen und Validierungen durchzuführen, ohne Produktionsdaten in eine separate, vom Anbieter gehostete Umgebung zu extrahieren. Zudem lässt sich eine Klasse so leichter mit den relevanten Signalen verbinden:
Schemaverhalten: Erkennen Sie hinzugefügte, entfernte oder geänderte Felder.
Datensatzverhalten: Wenden Sie Geschäftsregelprüfungen auf einzelne Datensätze an.
Timeliness: Identifizieren Sie Verzögerungen, fehlende Loads und unerwartete Ankunftsmuster.
Geschäftsmetriken: Überwachen Sie das Verhalten kritischer Kennzahlen.
Plattformzustand: Beobachten Sie Workload, Verfügbarkeit und operative Veränderungen.
Genau diese architektonische Rolle wird für die Data-Observability-Plattform von digna beschrieben, die für den Betrieb in der eigenen Umgebung einer Organisation konzipiert ist. Die Dokumentation von digna beschreibt eine KI-gestützte Plattform für Datenqualität und Observability, die On-Premises- und Private-Cloud-Deployments unterstützt, das Monitoring in der vom Kunden kontrollierten Infrastruktur hält und die Notwendigkeit verringert, Produktionsdaten in einen externen Dienst zu extrahieren.
Gelerntes Verhalten nutzen, wo Schwellenwerte an Grenzen stoßen
Manuelle Schwellenwerte sind für harte geschäftliche Grenzen nützlich, werden aber schwer wartbar, wenn jeder Datensatz eine andere Volatilität, Saisonalität, Lieferzeit oder ein anderes operatives Verhalten aufweist. Eine KI-gestützte Baseline kann das normale Verhalten jedes Datensatzes lernen und unerwartete Veränderungen erkennen, ohne dass Teams für jede Metrik einen Schwellenwert konfigurieren müssen.
Die historische Analyse liefert den fehlenden Kontext. Engineers können Trends, Volatilität und statistische Muster untersuchen, um eine einmalige Abweichung von einem sich entwickelnden Problem zu unterscheiden. Diese Unterscheidung verbessert die Triage von Vorfällen und verhindert, dass Teams jeden Alert als isolierten Fehler behandeln.
Die entscheidende Designfrage lautet nicht „KI oder Regeln“. Verlässliche Governance nutzt deterministische Validierung für explizite Anforderungen und Verhaltenserkennung für Muster, die sich nur schwer manuell kodieren lassen. Die Klasse bestimmt, welche Kombination angemessen ist, während die Infrastruktur bestimmt, ob die Nachweise sicher, aktuell und nutzbar bleiben.
Ein operatives Klassifizierungs-Framework aufbauen
Ein praxistaugliches Framework beginnt mit einem klar abgegrenzten Inventar kritischer Assets. Wählen Sie die Datensätze aus, die wichtiges Reporting, regulatorische Arbeit, Kundenprozesse, klinische Abläufe, Telekommunikationsdienste oder Entscheidungen im öffentlichen Sektor unterstützen. Versuchen Sie nicht, zu Beginn jede Datei und jede Tabelle mit gleicher Präzision zu klassifizieren.
Weisen Sie jedem ausgewählten Asset einen mehrdimensionalen Eintrag zu:
Sensibilität beschreiben: Erfassen Sie die Auswirkungen auf Vertraulichkeit, Integrität und Verfügbarkeit getrennt.
Format beschreiben: Bestimmen Sie die strukturierte, semistrukturierte oder unstrukturierte Darstellung und ihr Schemaverhalten.
Domäne beschreiben: Erfassen Sie Business Owner, Zweck, regulatorischen Kontext und nachgelagerte Abhängigkeiten.
Kontrollen zuweisen: Ordnen Sie der Klasse Anforderungen an Zugriff, Validierung, Aktualität, Schema, Aufbewahrung und Reaktion zu.
Ausführung prüfen: Bestätigen Sie, dass Monitoring- und Richtliniensysteme die erwarteten Kontrollen angewendet haben.
Änderungen überprüfen: Bewerten Sie die Klasse neu, wenn sich Verhalten, Schema, Verantwortlichkeiten oder geschäftliche Nutzung ändern.
Der Klassifizierungseintrag sollte sowohl Governance- als auch Engineering-Teams nützen. Ein Sicherheitsverantwortlicher muss die Folgen einer Offenlegung kennen. Ein Data Engineer muss wissen, welche Tests laufen müssen. Ein Incident Responder muss wissen, wie schnell das Problem eskaliert werden sollte und welche Nachweise zu sammeln sind.
Eine Klasse ist nur so lange aktuell, wie ihre Kontrollen noch zur tatsächlichen Nutzung der Daten passen.
Dieses Betriebsmodell unterstützt auch Entscheidungen zur Datensouveränität. Teams, die Anforderungen an Datenresidenz und Governance bewerten, finden in meeting data regulations with Stoa hilfreiche Hinweise dazu, wie rechtliche Pflichten, Infrastrukturstandort und Datenhandhabung zusammenwirken.
Überprüfen Sie die Klassifizierung anhand des beobachteten Verhaltens, statt sich auf jährliche Papierarbeit zu verlassen. Ein Datensatz kann vertraulich bleiben, während seine Integritätsanforderungen steigen, weil er zur regulatorischen Eingangsgröße wird. Eine strukturierte Tabelle kann über einen neuen Ingestion-Pfad semistrukturierte Payloads erhalten. Ein Feed mit geringer Verfügbarkeitsanforderung kann operativ kritisch werden, sobald ein Geschäftsprozess von ihm abhängt.
Die Empfehlungen von digna zur Umsetzung von Data Governance helfen Teams, Verantwortlichkeiten, Qualitätskontrollen, Monitoring und Governance-Workflows zu verbinden. Ziel ist nicht die größtmögliche Taxonomie, sondern ein Satz von Klassen, der konsequent verändert, was Systeme messen, schützen, aufbewahren und eskalieren.
digna hilft Teams, eine Datenklasse in ausführbare Kontrollen zu übersetzen, mit Validierung direkt in der Datenbank, Schema-Tracking, Timeliness-Monitoring, Business-Monitoring und KI-gestützter Anomalieerkennung in Private-Cloud- oder On-Premises-Umgebungen. Besuchen Sie digna und erfahren Sie, wie Ihr Team kritische Daten überwachen kann, ohne Produktionsdatensätze in einen externen Dienst zu verschieben.
Die Klassifizierung entscheidet auch darüber, wo Daten gespeichert und verarbeitet werden dürfen. Unser Leitfaden zu Anforderungen an die Datenresidenz erklärt, wie Standortvorgaben mit den vergebenen Klassen und den dadurch ausgelösten Kontrollen zusammenwirken.
Häufig gestellte Fragen
Was ist eine Datenklasse?
Eine Datenklasse ist die Kategorie, der ein Asset aufgrund seiner Sensibilität, seines Formats und seiner Geschäftsdomäne zugeordnet ist. Eine nützliche Klasse beschreibt die Daten nicht nur: Sie bestimmt, welche Kontrollen für Zugriff, Validierung, Aufbewahrung und Monitoring gelten. Ein Label, das nachgelagert nichts verändert, ist Dokumentation und keine Governance.
Was sind die drei Dimensionen der Datenklassifizierung?
Sensibilität, Format und Domäne. Sensibilität beschreibt die Folgen, wenn die Daten kompromittiert werden, das Format beschreibt, wie sie dargestellt sind und was sich daher testen lässt, und die Domäne liefert geschäftlichen Kontext, Verantwortlichkeiten und regulatorische Erwartungen. Wer alle drei gemeinsam bewertet, erhält eine verlässlichere Klasse als mit einer einzelnen Sensibilitätsskala.
Wie wird die CIA-Triade auf die Datenklassifizierung angewendet?
Jeder Informationstyp wird getrennt nach Vertraulichkeit, Integrität und Verfügbarkeit bewertet, je nachdem, welcher Schaden durch den Verlust des jeweiligen Schutzziels entsteht. Ein öffentlicher KPI-Feed braucht vielleicht keine Vertraulichkeitskontrollen, aber dennoch strenge Integritätsprüfungen, weil falsche Werte regulatorische oder operative Entscheidungen beeinflussen könnten. Ein einziger zusammengefasster Wert verschleiert genau das.
Warum scheitern Programme zur Datenklassifizierung?
Die meisten scheitern unbemerkt, weil Labels keine Kontrollen verändern. Verantwortliche taggen Datensätze und Auditoren erhalten einen Katalogexport, doch Berechtigungen und Monitoring bleiben gleich. Laut einem zitierten Bericht aus dem Jahr 2026 verfügten nur 47 % der Organisationen über eine Klassifizierung, die nachgelagerte Kontrollen durchsetzte, und zusätzliche Kategorien erhöhen meist die Mehrdeutigkeit, statt die Durchsetzung zu verbessern.
Wie sollten strukturierte und unstrukturierte Daten unterschiedlich überwacht werden?
Strukturierte Tabellen eignen sich für Prüfungen von Schema, Typen, Eindeutigkeit, referenzieller Integrität und Geschäftsregeln. Semistrukturiertes JSON braucht Monitoring für verschachtelte Pfade, Varianten und Parserfehler, weil Werte sich verschieben können, ohne null zu werden. Unstrukturierte Dokumente und Medien brauchen Prüfungen für Ingestion, Vollständigkeit der Extraktion und Metadaten, denn ein erfolgreicher Upload beweist nicht, dass der Inhalt nutzbar ist.


