KPI-Monitoring-Prozess: Ein vollständiger Schritt-für-Schritt-Leitfaden
|
6
min. Lesezeit

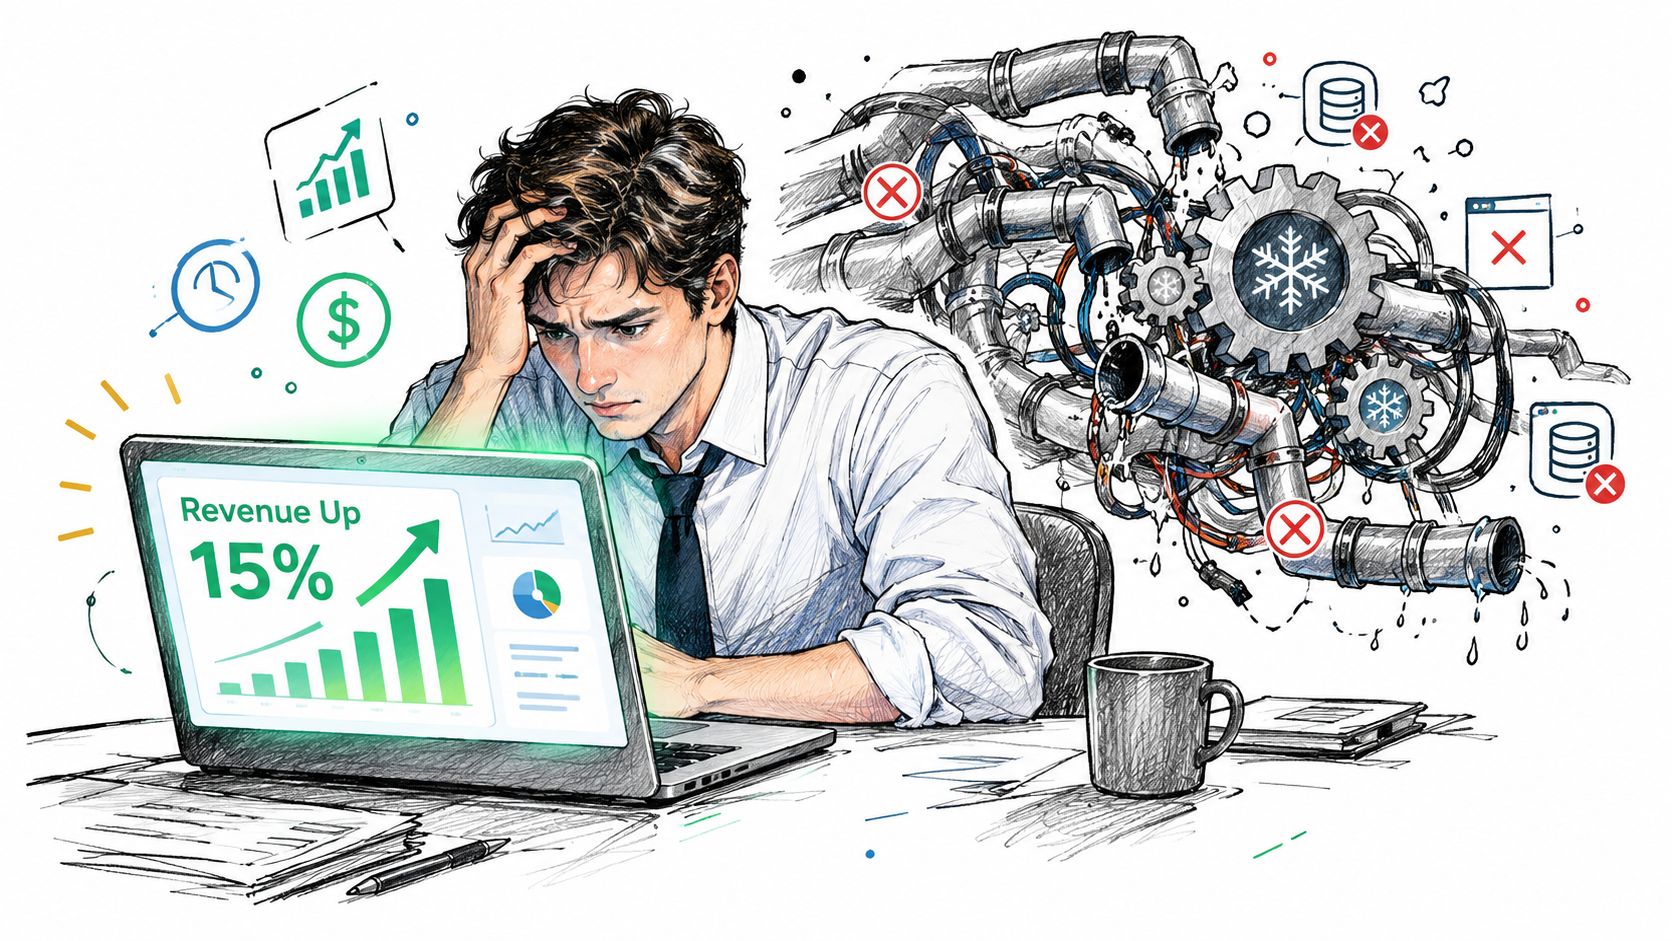
Um 9 Uhr ruft ein Stakeholder an, weil das Umsatz-Dashboard 15 % im Plus liegt. Das Team freut sich kurz, dann prüft jemand den Transaktions-Feed und stellt fest, dass die Pipeline verspätet geladen und die letzten zwei Tage ausgelassen hat. Die KPI zeigte keine bessere Performance. Sie spiegelte unvollständige Daten wider.
Deshalb muss ein verlässlicher KPI-Monitoring-Prozess mehr überwachen als Metrikwerte. Er muss feststellen, ob die Daten aktuell, vollständig und strukturell gültig sind und sich für eine Interpretation eignen. Ein Dashboard kann optisch perfekt sein und Entscheidern trotzdem falsche Sicherheit vermitteln.
Inhaltsverzeichnis
Warum Ihr KPI-Dashboard Sie täuscht
Die sechs Phasen eines KPI-Monitoring-Prozesses
Entscheidung und Verantwortlichen definieren
Eine repräsentative Baseline aufbauen
Lineage prüfen, bevor Bewegungen interpretiert werden
An der maßgeblichen Quelle berechnen
Grenzwerte und ungewöhnliches Verhalten erkennen
Alerts weiterleiten, auflösen und verbessern
Geschäftsperformance von Datentauglichkeit trennen
Zwei Alert-Pfade nutzen
Das Ergebnis prüfbar machen
Klassische Regeln versus KI-gestützte Anomalieerkennung
Wo deterministische Regeln funktionieren
Wo adaptive Erkennung hilft
Rollen, Verantwortlichkeiten und operative Praxis
Verantwortlichkeiten explizit zuweisen
Den Rhythmus nach Handlungsrelevanz festlegen
Häufige Fehler und wie Sie sie vermeiden
Typische Fehlermuster
Ihre KPI-Monitoring-Strategie mit digna aufbauen
Warum Ihr KPI-Dashboard Sie täuscht
Der Fehler beginnt meist mit einem vernünftigen Design. Ein Analytics Engineer definiert den Umsatz, verbindet die Berechnung mit einer Warehouse-Tabelle, ergänzt eine Ziellinie und veröffentlicht das Ergebnis in Power BI oder einer anderen BI-Plattform. Aus Sicht des Reporting-Tools ist die Aktualisierung des Dashboards erfolgreich, doch der vorgelagerte Transaktionsload kam zu spät oder enthielt nur einen Teil der erwarteten Daten.
Der Stakeholder sieht eine positive Entwicklung. Der Data Engineer sieht einen Lieferungsvorfall. Beide blicken auf dieselbe KPI, aber nur einer hat den Kontext, um sie richtig zu interpretieren.
Praxisregel: Betrachten Sie einen KPI-Wert erst dann als vertrauenswürdig, wenn Aktualität, Vollständigkeit, Lineage und Validierungsstatus direkt daneben verfügbar sind.
Klassisches Monitoring beobachtet oft nur die finale Zahl. Ein Schwellenwert löst vielleicht einen Alert aus, wenn der Umsatz unter ein festes Ziel fällt, meldet aber nicht unbedingt einen verspäteten Load, eine fehlende Partition, einen geänderten Spaltentyp oder einen unvollständigen Extrakt. Teams erhalten dann Alerts, die nicht erklären, ob sich das Geschäft verändert hat oder die Messung fehlgeschlagen ist.
Diese Unterscheidung beeinflusst jede operative Reaktion. Ein echter Rückgang erfordert womöglich eine kaufmännische Analyse. Ein verspäteter Datensatz erfordert eine Reparatur der Pipeline. Eine Schemaänderung erfordert unter Umständen Anpassungen an den Transformationen. Wenn der Monitoring-Prozess für alle drei Fälle denselben Alert sendet, wird die Verantwortung unklar, und die Beteiligten verlieren Zeit mit der Diagnose des falschen Problems.
Dashboards bleiben wichtig, vor allem wenn Teams aussagekräftige Power-BI-Visualisierungen erstellen müssen. Die Visualisierung ist aber die letzte Schicht und nicht das Monitoring-System selbst. Der zugrunde liegende Prozess muss die angezeigte KPI mit den Datenbedingungen verbinden, aus denen sie entstanden ist.
Ein praxistaugliches KPI-Monitoring-Dashboard sollte daher das Geschäftssignal und die Nachweise für seine Gültigkeit zeigen. Dazu gehören erwartete und tatsächliche Lieferzeiten, Zeilenanzahlen, Validierungsergebnisse, Schemaversionen und der Berechnungsstatus. Ohne diese Kontrollen bedeutet ein grünes Dashboard nur, dass es erfolgreich gerendert wurde.
Die sechs Phasen eines KPI-Monitoring-Prozesses
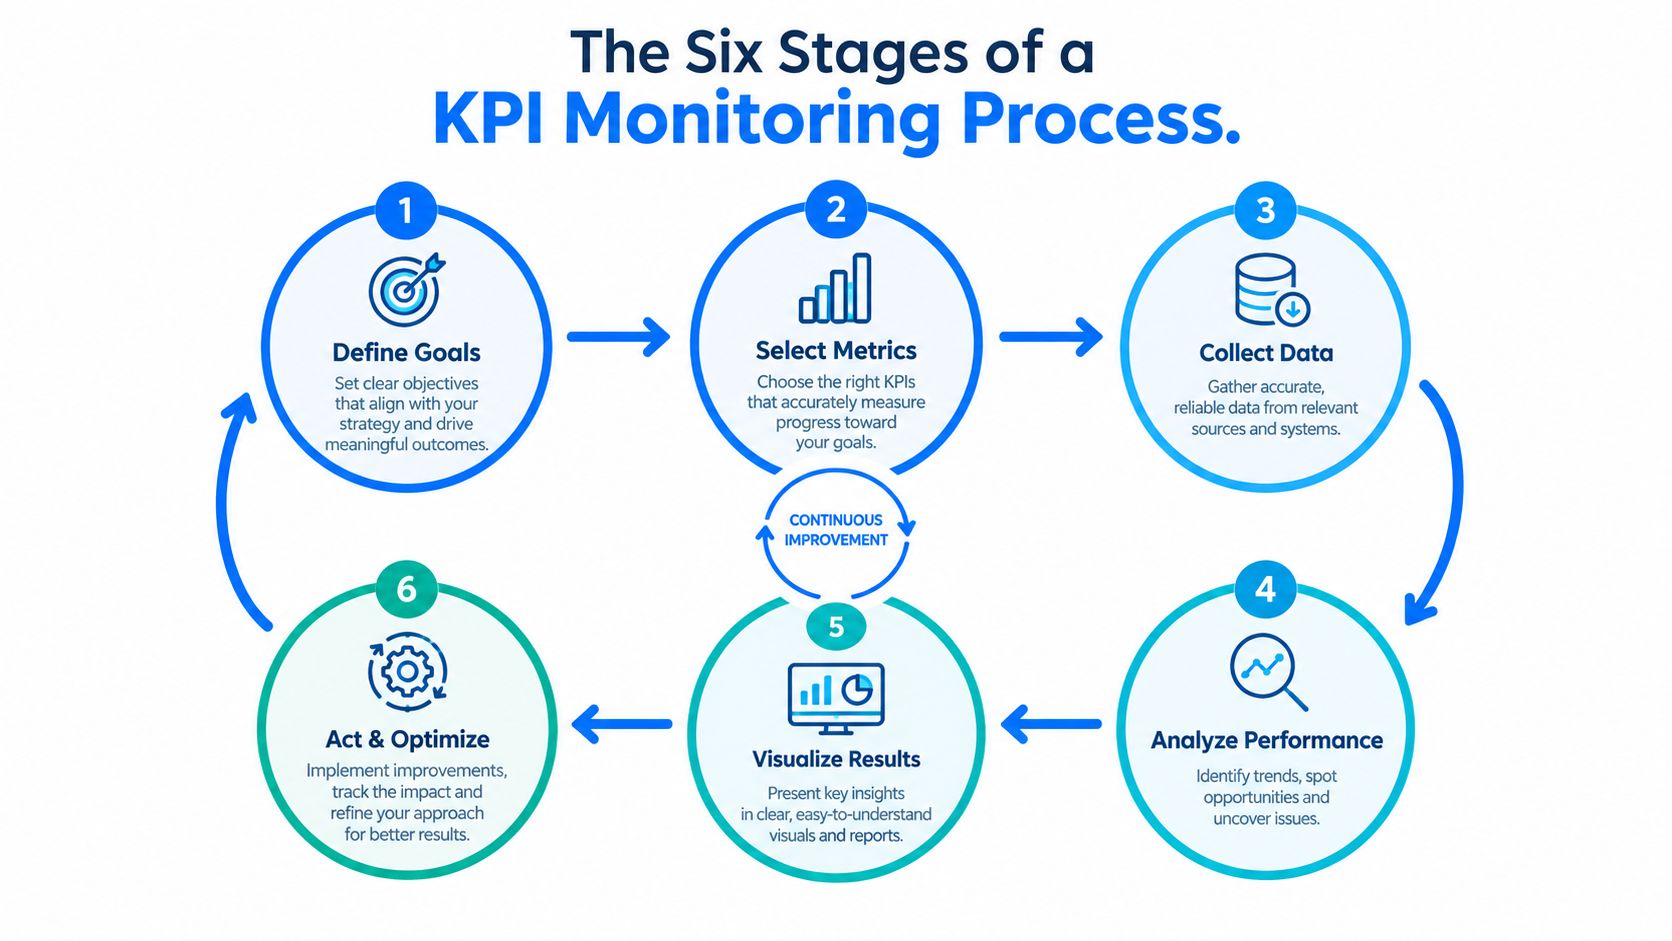
Ein belastbarer Prozess ist ein geschlossener Kreislauf. Das detaillierte Betriebsmodell umfasst acht unterschiedliche Phasen, von der Definition der Entscheidung und des Verantwortlichen bis zur Überprüfung der Schwellenwerte im Hinblick auf Fehlalarme und veränderte Bedingungen, wie im NIST AI Risk Management Framework Playbook beschrieben. In der Praxis lassen sich diese Aktivitäten in sechs Umsetzungsphasen gliedern, die Teams im Tagesgeschäft betreiben können.
Entscheidung und Verantwortlichen definieren
Beginnen Sie mit der Entscheidung, nicht mit dem Diagramm. Halten Sie fest, welche Maßnahme die KPI beeinflussen soll, wer für das Ergebnis verantwortlich ist und wer eine Abweichung untersucht. Definieren Sie Zähler, Nenner, Berechnungsgranularität, Filter, Aktualitätserwartung, akzeptablen Betriebsbereich und Eskalationspfad.
Ein Finanzdienstleister könnte eine KPI zum Abwicklungsvolumen einem Verantwortlichen aus dem operativen Bereich zuweisen, während eine Gesundheitsorganisation eine KPI zur Vollständigkeit von Abrechnungen einem Data-Governance-Verantwortlichen übergibt. In beiden Fällen braucht der Verantwortliche genug semantische Details, um beurteilen zu können, ob eine Bewegung aussagekräftig ist.
Eine repräsentative Baseline aufbauen
Ein Ziel ist nicht dasselbe wie eine Baseline. Bilden Sie historisches Verhalten aus repräsentativen Zeiträumen ab und trennen Sie normale Saisonalität, Kalendereffekte, Aktionen, geplante Wartungen und bekannte Ausfälle von echten Veränderungen. Ein fester Grenzwert kann für eine harte Compliance-Grenze sinnvoll sein, beschreibt aber keine normale Schwankung.
Lineage prüfen, bevor Bewegungen interpretiert werden
Prüfen Sie, ob Quelltabellen, Transformationen, Joins, Filter und Lieferjobs wie erwartet laufen. Eine KPI sollte ihre Lineage bis zur maßgeblichen Quelle mitführen, zusammen mit Validierungsergebnissen und dem Status der Datentauglichkeit. Ist die Quelle unvollständig, kennzeichnen oder unterdrücken Sie das Geschäftsergebnis, statt es als aktuell darzustellen.
An der maßgeblichen Quelle berechnen
Die Berechnung direkt in der Datenbank reduziert unnötige Datenbewegungen und hält die Logik nah an den kontrollierten Daten. Außerdem lässt sich die Berechnung leichter prüfen, weil das Team das Ergebnis mit Quellzeitstempel, Abfrageversion, Schemastand und Validierungsergebnis verknüpfen kann.
Grenzwerte und ungewöhnliches Verhalten erkennen
Nutzen Sie deterministische Prüfungen für definierte Grenzen und Integritätsfehler. Ergänzen Sie statistisches Monitoring für ungewöhnliche Niveaus, Veränderungen der Änderungsrate, Volatilität und Verteilungsverschiebungen. Die Kombination erfasst sowohl bekannte Verstöße als auch Verhalten, das nicht zur historischen Baseline passt.
Alerts weiterleiten, auflösen und verbessern
Leiten Sie Alerts nach Schweregrad an einen verantwortlichen Owner weiter. Eine anhaltende Abweichung mit niedrigem Schweregrad kann ein Ticket erzeugen, während ein schwerer Integritätsfehler eine sofortige Alarmierung erfordern kann. Jeder Alert sollte Runbook, Unterdrückungsfenster, Eskalationspfad, Diagnose, Behebung und geschäftliche Auswirkung enthalten.
Verlässlich wird der Prozess erst, wenn Teams seine Leistung überprüfen. Verfolgen Sie Fehlalarme, übersehene Vorfälle, Erkennungszeit, Bestätigungszeit und Behebungszeit, und kalibrieren Sie Schwellenwerte neu, wenn sich die Betriebsbedingungen ändern.
Geschäftsperformance von Datentauglichkeit trennen
Ein Alert zur Geschäftsperformance beantwortet die Frage: „Hat sich das Geschäft anders verhalten?“ Ein Alert zur Datentauglichkeit beantwortet: „Können wir der Messung vertrauen?“ Die Fragen hängen zusammen, sollten aber weder denselben Status noch dieselbe Reaktion teilen.
Eine große Lücke in vielen Empfehlungen zum KPI-Monitoring: Sie erklären die Auswahl von Metriken, legen aber nicht fest, wie man vorgeht, wenn die zugrunde liegenden Daten verspätet, unvollständig oder strukturell verändert sind. Gängige Ratschläge richten die Monitoring-Frequenz oft an der Handlungsrelevanz aus, definieren aber selten, was passiert, wenn eine geplante Aktualisierung ihr Ankunftsfenster verpasst oder eine Spalte hinzugefügt, entfernt oder umtypisiert wird, wie in diesem KPI-Design-Leitfaden beschrieben.
Zwei Alert-Pfade nutzen
Angenommen, eine KPI eines Telekommunikationsanbieters zeigt einen plötzlichen Rückgang der Kundenaktivität. Dafür gibt es mindestens zwei plausible Erklärungen:
Geschäftssignal: Das Kundenverhalten hat sich verändert, also sollte das kaufmännische oder operative Team die Ursache untersuchen.
Liefersignal: Die neueste Event-Partition fehlt, also sollte das Datenplattform-Team den Load reparieren.
Struktursignal: Eine Quellspalte hat ihren Typ geändert oder ist verschwunden, also sollten die Verantwortlichen für Transformation und Governance die Auswirkungen bewerten.
Eine einzelne rote Kachel kann diese Fälle nicht unterscheiden. Das System sollte der KPI-Berechnung den Status zu Aktualität, Vollständigkeit, Schema und Validierung beifügen. Kamen die Daten verspätet an, kann das Ergebnis als betroffen markiert und der geschäftliche Alert unterdrückt werden, bis die Quelle wieder in Ordnung ist.
Das Ergebnis prüfbar machen
Jeder KPI-Lauf sollte Datenzeitstempel, erwartete gegenüber tatsächlicher Lieferzeit, Zeilenanzahl, Schemaversion, Berechnungsstatus, Schwellenwertversion und Incident-ID festhalten. Mit diesen Feldern kann ein Analyst erklären, warum sich ein Wert verändert hat, ohne während eines Vorfalls die gesamte Pipeline-Historie rekonstruieren zu müssen.
Besonders wichtig ist diese Unterscheidung im Gesundheitswesen und im öffentlichen Sektor, wo ein scheinbar aktueller Bericht operative oder regulatorische Entscheidungen beeinflussen kann. Ein Ergebnis, das auf Teildaten beruht, sollte nicht genauso aussehen wie eines, das aus einem vollständigen, validierten Load stammt.
Der Ansatz von digna zur Data Quality Observability spiegelt dieses Betriebsmodell wider, indem er Geschäftsmetriken mit Prüfungen auf Timeliness, Validierung, Anomalien und Schemaänderungen innerhalb der Datenumgebung des Kunden verknüpft. Der praktische Nutzen ist nicht ein weiteres Dashboard. Es ist eine klarere Antwort auf die erste Frage, die sich Verantwortliche stellen sollten: Ist die Bewegung der KPI echt, oder ist die Messung unbrauchbar geworden?
Klassische Regeln versus KI-gestützte Anomalieerkennung
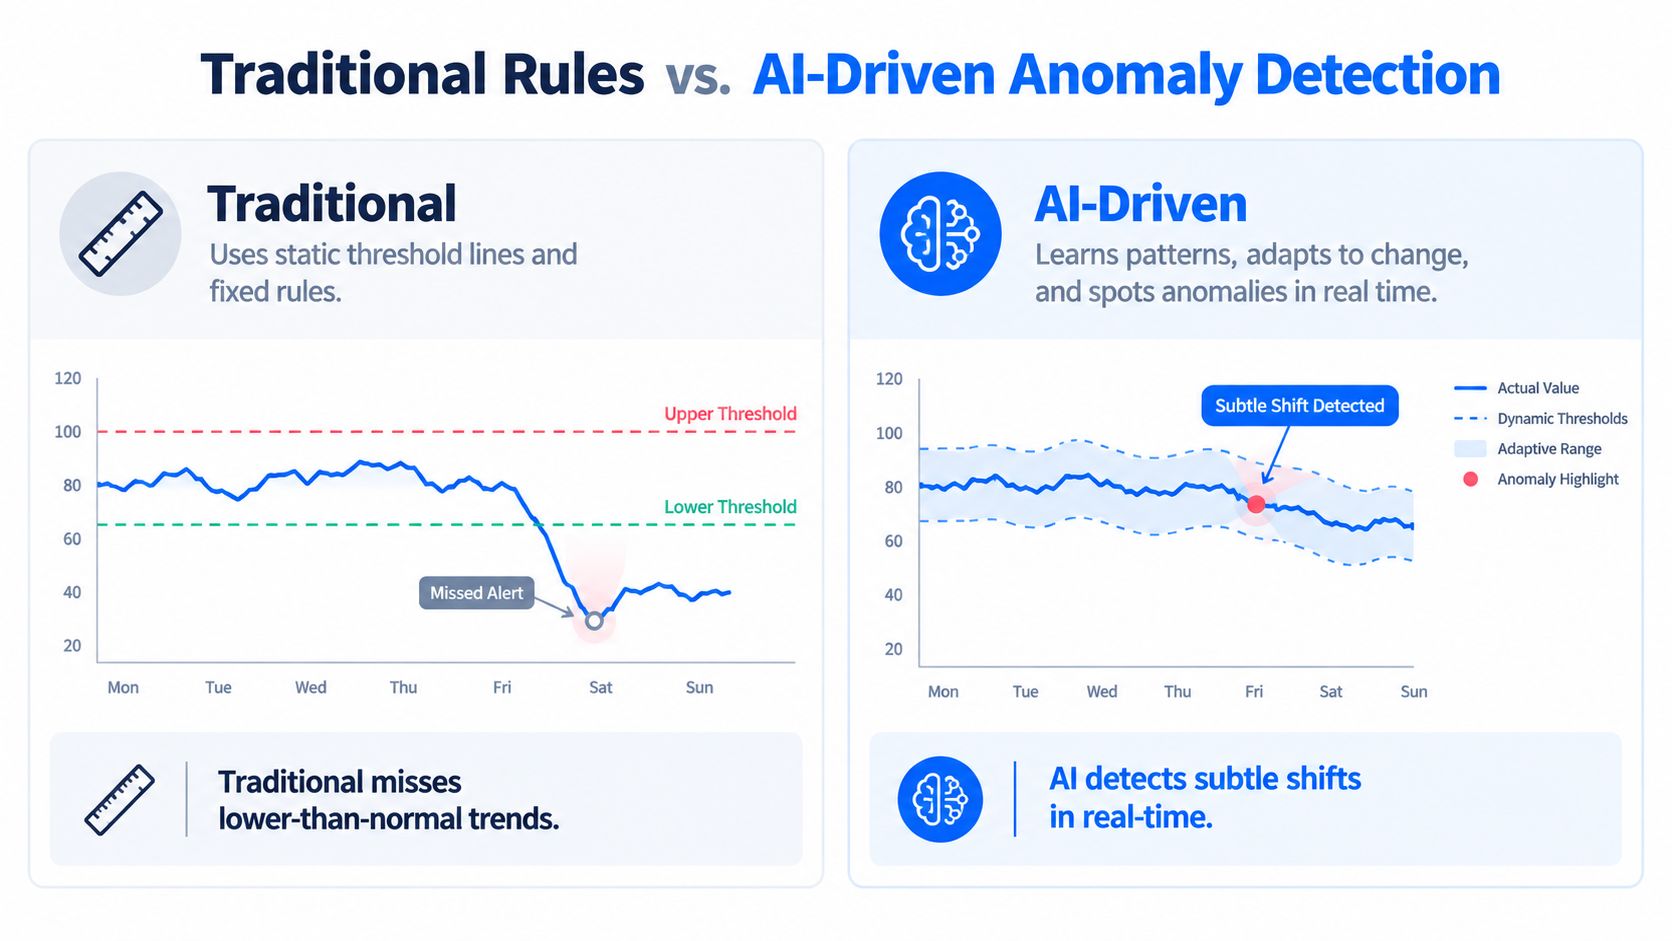
Ein fester Schwellenwert kann eine klare geschäftliche Grenze schützen, etwa durch einen Alert, wenn Transaktionen unter ein genehmigtes Limit fallen. Er kann jedoch nicht jede normale Betriebssituation beschreiben. Wochenenden, saisonale Nachfrage, verkehrsschwache Zeiten, schleichender Drift und wechselnde Volatilität können denselben Schwellenwert irreführend machen.
Daraus entstehen zwei operative Fehler. Ein empfindlicher Schwellenwert erzeugt Rauschen, ein großzügiger übersieht einen relevanten Rückgang. Teams optimieren dann die Alert-Menge statt der Entscheidungsqualität, ein Problem, das in diesen Empfehlungen zum Monitoring der SRE Golden Signals beschrieben wird.
Wo deterministische Regeln funktionieren
Deterministische Kontrollen passen zu Bedingungen, die explizit und testbar sind:
Null-Prüfungen: Pflichtfelder müssen Werte enthalten.
Eindeutigkeitsprüfungen: Identifikatoren dürfen innerhalb der definierten Granularität nicht doppelt vorkommen.
Prüfungen der referenziellen Integrität: Untergeordnete Datensätze müssen auf gültige übergeordnete Datensätze verweisen.
Schema-Prüfungen: Erforderliche Spalten und Datentypen müssen kompatibel bleiben.
Aktualitätsprüfungen: Erwartete Daten müssen innerhalb ihres definierten Lieferfensters ankommen.
Grenzwertprüfungen: Eine regulatorische oder operative Grenze darf nicht überschritten werden.
Diese Prüfungen sind transparent, erklärbar und lassen sich leicht mit einem Runbook verbinden. Sie durch Anomalieerkennung zu ersetzen, würde die Kontrollen dort schwächen, wo die erwartete Bedingung bereits bekannt ist.
Wo adaptive Erkennung hilft
Statistisches Monitoring vergleicht aktuelles Verhalten mit der eigenen Historie eines Datensatzes. Der Überblick über Arten der Anomalieerkennung beschreibt, wie dieser Ansatz ein unerwartetes Niveau, eine veränderte Änderungsrate, ein Volatilitätsmuster oder eine Verteilungsverschiebung erkennen kann, ohne dass Engineers jede normale Bedingung manuell kodieren müssen. Das ist nützlich, wenn sich eine Metrik in verkehrsschwachen Zeiten verändert oder abdriftet, bevor sie eine feste Grenze überschreitet.
Das Data Anomalies-Modul von digna nutzt KI-gestütztes Baseline-Learning und kontinuierliche Anomalieerkennung ohne manuelle Regelkonfiguration. Durch die Ausführung direkt in der Datenbank bleiben die Berechnungen in der Umgebung des Kunden. Das reduziert Datenbewegungen und verhindert, dass der Anbieter Zugriff auf Produktionsdaten erhält. Dieses Design hilft außerdem, einen Alert zu einer Geschäftsmetrik mit dem zugrunde liegenden Problem der Datentauglichkeit zu verknüpfen, statt die KPI als isoliertes Signal zu behandeln.
Setzen Sie auf ein hybrides Modell. Deterministische Regeln sollten bekannte Verträge und Compliance-Bedingungen durchsetzen, während adaptives Monitoring Verhalten abdeckt, das kein einzelner Schwellenwert abbilden kann. Leiten Sie beide Alert-Typen durch denselben Incident-Workflow, bewahren Sie aber Erkennungsmethode, Nachweise und betroffene KPI auf, damit Verantwortliche eine echte geschäftliche Veränderung von einem Messproblem unterscheiden können.
Rollen, Verantwortlichkeiten und operative Praxis
Ein KPI-Monitoring-Prozess scheitert, wenn die Verantwortung am Dashboard endet. Data Engineers betreuen Lieferung und Berechnung, Analytics Engineers sichern die semantische Korrektheit, Governance-Teams definieren Qualitätserwartungen, und Business Owner entscheiden, welche Maßnahme eine Veränderung erfordert.
NIST empfiehlt, Metriken zu wählen, die auf den relevanten Ebenen aussagekräftige Hinweise auf den Status liefern, die Häufigkeit von Monitoring und Kontrollbewertungen festzulegen und Erfassung, Analyse und Reporting wo möglich zu automatisieren, wie in seiner Publikation zum kontinuierlichen Monitoring beschrieben.
Verantwortlichkeiten explizit zuweisen
Der Data Engineer verantwortet Pipeline-Zustand, Lieferpläne, Quelländerungen und Wiederherstellungsverfahren. Der Analytics Engineer verantwortet KPI-Definitionen, Joins, Filter, Aggregationslogik und die Korrektheit des Dashboards. Das Governance- oder Datenqualitätsteam definiert Validierungsregeln, Nachweisanforderungen und akzeptable Datenbedingungen.
Der Business Owner interpretiert die KPI und entscheidet, was bei einer Abweichung geschehen soll. Diese Person kann eine kaufmännische Reaktion freigeben, eine bekannte Ausnahme akzeptieren oder einen operativen Vorfall eskalieren. Ein gemeinsames Modell für Rollen und Verantwortlichkeiten in der Datenqualität verhindert die typische Situation, in der alle einen Alert erhalten, aber niemand die Entscheidung verantwortet.
Den Rhythmus nach Handlungsrelevanz festlegen
Operative Kennzahlen mit hoher Volatilität müssen unter Umständen häufig bewertet werden, langsamere strategische Kennzahlen dagegen seltener. Wichtig ist, den Rhythmus explizit festzuhalten, einschließlich Messintervall, erwartetem Aktualisierungsplan, Zeitstempel und Empfängergruppe.
Jeder Lauf sollte Folgendes enthalten:
Liefermetadaten: Erwartete und tatsächliche Ankunftszeiten.
Datennachweise: Zeilenanzahl, Quellzeitstempel und Vollständigkeitsstatus.
Technischer Kontext: Schemaversion und Berechnungsstatus.
Kontrollkontext: Schwellenwertversion und Validierungsergebnis.
Operative Spur: Incident-ID, Verantwortlicher und Lösungsstatus.
Bevor Sie einen Produktions-Alert aktivieren, verlangen Sie Schweregrad, Runbook, Unterdrückungsfenster, Verantwortlichen und Eskalationspfad. Automatisierung sollte Nachweise sammeln und analysieren, doch Menschen bleiben für Beurteilung und Behebung verantwortlich.
Häufige Fehler und wie Sie sie vermeiden
Mehr Alerts bedeuten kein besseres Monitoring. Wenn jede kleine Abweichung eine Benachrichtigung auslöst, lernen die Verantwortlichen, den Kanal zu ignorieren, und ein relevanter Vorfall kann zwischen Routinewarnungen untergehen.
Der folgenschwerste Fehler ist, die Alert-Menge statt der Entscheidungsqualität zu optimieren. Messen Sie, ob Alerts zu Maßnahmen führen, anhand von Präzision, Incident-Abdeckung oder Recall, mittlerer Zeit bis zur Erkennung, mittlerer Zeit bis zur Bestätigung und mittlerer Zeit bis zur Behebung. Ein ruhiges Alerting-System kann gesund sein oder Vorfälle übersehen. Sie brauchen Belege.
Typische Fehlermuster
Alert-Müdigkeit: Zu viele Benachrichtigungen gewöhnen Teams daran, Alerts zu ignorieren. Kombinieren Sie Schweregrade, unterdrücken Sie Duplikate während bekannter Wartungsfenster und senden Sie nur Ereignisse, die eine Handlung erfordern.
Vanity Metrics: Eine Metrik kann beeindruckend aussehen und trotzdem keine Entscheidung unterstützen. Verknüpfen Sie jede KPI mit einem Geschäftsziel und legen Sie fest, welche Maßnahme auf eine relevante Veränderung folgt.
Keine Verantwortung: Ein Alert ohne benannten Verantwortlichen wird zum gemeinsamen Hintergrundrauschen. Benennen Sie eine verantwortliche Person, auch wenn mehrere Teams zur Diagnose beitragen.
Statische Schwellenwerte: Feste Grenzen übersehen Saisonalität, Ausfälle außerhalb der Spitzenzeiten und schleichenden Drift. Kombinieren Sie Grenzen mit Monitoring, das die Baseline berücksichtigt.
Ungeprüfte Daten: Eine KPI kann sich bewegen, weil die Quelle verspätet oder unvollständig ist. Halten Sie den Status der Datentauglichkeit neben dem Geschäftswert fest und trennen Sie die Reaktionspfade.
Jeder Alert braucht vor der Aktivierung in Produktion eine vordefinierte Reaktion. Wenn das Team nicht erklären kann, wer untersucht, welche Nachweise benötigt werden, wie lange die Unterdrückung dauert und wann eskaliert wird, ist der Alert operativ nicht einsatzbereit.
Ihre KPI-Monitoring-Strategie mit digna aufbauen
Beginnen Sie mit den KPIs, die echte Entscheidungen steuern, nicht mit jeder Metrik, die im Warehouse verfügbar ist. Definieren Sie Verantwortliche und Berechnungslogik, bauen Sie repräsentative Baselines auf, prüfen Sie die Lineage, fügen Sie Metadaten zur Datentauglichkeit hinzu und kombinieren Sie feste Kontrollen mit adaptiver Anomalieerkennung.
Ein praxisnaher Rollout kann mit einem einzigen kritischen Datensatz oder einer Fachdomäne beginnen. Ergänzen Sie dann Timeliness-Monitoring für Lieferrisiken, Validierung für Geschäftsregeln, Schema-Tracking für strukturelle Änderungen und Plattform-Observability dort, wo Workload oder Performance das Reporting beeinflussen. Die KPI-Monitoring-Tools sollten zum Betriebsmodell passen, statt jedes Team in dasselbe Alerting-Muster zu zwingen.
digna läuft in der eigenen Umgebung des Kunden, und die Prüfungen werden direkt in der Datenbank über Warehouses, Lakes und Pipelines hinweg ausgeführt. Dank des modularen Lizenzmodells können Teams mit einem einzelnen Modul starten und dann erweitern, während das Python SDK die programmatische Integration in bestehende Workflows unterstützt. Ein gemeinsames, nutzerzentriertes Dashboard bietet Data Engineers, Analysten und Stakeholdern einen zentralen Ort, um Vorfälle, Trends und Status zu prüfen.
Die stärkste Implementierung verbindet das Metrikdesign mit Erfassung, Interpretation, Eskalation und Behebung. Mit digna gelangen Teams in weniger als zwei Stunden von der Installation zu ersten Erkenntnissen und verfeinern anschließend Schwellenwerte und Workflows, während sie lernen, wie sich ihre Daten in Produktion verhalten.
digna verbindet KPI-Monitoring im Business mit Datenqualität, Timeliness, Validierung, Anomalieerkennung und Schema-Tracking in Ihrer eigenen Umgebung. Besuchen Sie digna und erfahren Sie, wie Sie einen prüfbaren Monitoring-Prozess aufbauen, der echte Performance-Veränderungen von unzuverlässigen Daten unterscheidet.
Um zu beziffern, was ein verspäteter oder unvollständiger KPI-Feed das Unternehmen tatsächlich kostet, geben Sie Ihre eigenen Zahlen in den Rechner für Data-Downtime-Kosten ein, bevor Sie entscheiden, wie viel Monitoring jede Metrik verdient.
Häufig gestellte Fragen
Was ist ein KPI-Monitoring-Prozess?
Ein geschlossener Kreislauf, der für jede KPI Entscheidung und Verantwortlichen festlegt, eine repräsentative Baseline aufbaut, die Lineage prüft, an der maßgeblichen Quelle berechnet, Grenzwerte und ungewöhnliches Verhalten erkennt und Alerts an eine verantwortliche Person weiterleitet. Ziel ist es, sowohl zu wissen, was die Metrik aussagt, als auch, ob den Daten dahinter vertraut werden kann.
Warum kann ein KPI-Dashboard irreführende Zahlen zeigen?
Das Reporting-Tool kann erfolgreich aktualisieren, obwohl der vorgelagerte Load verspätet oder nur teilweise eingetroffen ist. Im Beispiel dieses Beitrags lag der Umsatz scheinbar 15 % höher, weil die Pipeline die Transaktionen der letzten zwei Tage ausgelassen hatte. Ohne Prüfungen auf Aktualität und Vollständigkeit sehen unvollständige Daten genauso aus wie eine stärkere Geschäftsentwicklung.
Was ist der Unterschied zwischen einem Business-Alert und einem Alert zur Datentauglichkeit?
Ein Alert zur Geschäftsperformance fragt, ob sich das Geschäft anders verhalten hat, daher untersucht der kaufmännische oder operative Verantwortliche. Ein Alert zur Datentauglichkeit fragt, ob der Messung vertraut werden kann, daher repariert das Datenplattform-Team eine fehlende Partition oder ein geändertes Schema. Zwei getrennte Alert-Pfade leiten jedes Problem an das richtige Team.
Sollte KPI-Monitoring feste Schwellenwerte oder Anomalieerkennung nutzen?
Beides. Feste Schwellenwerte eignen sich für harte, explizite Grenzen wie Null-Prüfungen, Eindeutigkeit, referenzielle Integrität, Schemakompatibilität und Lieferfenster. Adaptive Anomalieerkennung vergleicht eine Metrik mit ihrer eigenen Historie und erkennt so ungewöhnliche Niveaus, veränderte Änderungsraten und Drift, die ein einzelner statischer Grenzwert entweder übersehen oder als Rauschen melden würde.
Wer sollte für das KPI-Monitoring verantwortlich sein?
Die Verantwortung ist aufgeteilt. Data Engineers verantworten Pipeline-Zustand und Lieferpläne, Analytics Engineers KPI-Definitionen und Dashboard-Logik, Governance-Teams legen Validierungsregeln und Nachweisanforderungen fest, und der Business Owner entscheidet, welche Maßnahme eine Abweichung erfordert. Eine KPI ohne benannten Verantwortlichen wird schnell zum Problem aller und zur Aufgabe von niemandem.


