Data Validation-Fehler: Ursachen, Beispiele und Behebungen
|
9
min. Lesezeit
Sie haben es wahrscheinlich schon erlebt: Die Dashboard-Aktualisierung ist abgeschlossen, die Zahlen sehen plausibel aus, und dann fragt jemand, warum sich die Abwanderungsrate (Churn) plötzlich verändert hat. Der Analyst überprüft die Visualisierung, das SQL und den geplanten Job. Stunden später stellt sich heraus, dass das Problem auf einen einzigen fehlerhaften Wert zurückzuführen ist, der früh in die Pipeline gelangt ist und die Interpretation des Datensatzes durch ein nachgelagertes System verändert hat.
Ein Data Validation-Fehler ist mehr als eine abgelehnte Tabellenzelle. Es kann sich um ein fehlendes Feld, ein ungültiges Datum, einen Code außerhalb des zulässigen Bereichs oder eine nicht existierende Beziehung handeln. Die praktische Herausforderung besteht darin, zu finden, wo der Vertrag fehlgeschlagen ist, zu entscheiden, ob die Zeile sicher repariert werden kann, und zu verhindern, dass derselbe Defekt erneut auftritt.
Inhaltsverzeichnis
Wenn eine einzige fehlerhafte Zeile das gesamte Dashboard unbrauchbar macht
Was ein Data Validation-Fehler tatsächlich bedeutet
Die oberflächliche Prüfung
Die tiefergehende Prüfung
Die Hauptmuster hinter Validierungsfehlern
Fehlende Werte
Formatfehler
Bereichsverletzungen
Codierungs- und Domänenfehler
Konsistenzbrüche
Beispiele auf Datensatzebene, die Sie in Ihren eigenen Daten erkennen können
Tabellenkalkulationsexporte
API-Ingestion
Warehouse-Datensätze
Warum die meisten Validierungsfehler upstream entstehen
Reparieren Sie den Vertrag, nicht nur die Ausgabe
Ein praktischer Workflow zur Erkennung und Behebung von Fehlern
Erfassung (Capture)
Ingestion
Warehouse
Konsum (Consumption)
Wichtige Erkenntnisse für einen zuverlässigen Datenbetrieb
Wenn eine einzige fehlerhafte Zeile das gesamte Dashboard unbrauchbar macht
Ein Finanzteam erhält jede Nacht eine CSV-Datei von einem Partnerportal. Die Datensätze sehen normal aus, bis ein Kündigungsfeld ein fehlerhaftes Datum enthält. Das Ladevorgang-Tool des Warehouse kann dieses nicht in ein Datum konvertieren und schreibt daher NULL, anstatt den Ladevorgang abzubrechen.
Das Churn-Modell behandelt ein fehlendes Kündigungsdatum als eigene Bedingung. Diese einzige Konvertierung ändert die Kohortenzuordnung des Kunden, und das Executive-Dashboard zeigt einen unerwarteten Anstieg. Die Pipeline meldet Erfolg, das Diagramm wird gerendert, und das Ergebnis ist dennoch falsch.
Der Analyst beginnt beim Dashboard und verfolgt das Ergebnis durch drei Berichte, zwei SQL-Ansichten und einen Airflow-Task. Die fehlerhafte Quellzeile taucht schließlich im Protokoll der abgelehnten Werte auf. Das Dashboard war nur das erste sichtbare Symptom.
Praktische Regel: Ein erfolgreicher Pipeline-Durchlauf beweist nur, dass die Verarbeitung abgeschlossen wurde. Er beweist nicht, dass jeder Datensatz die Regeln erfüllt, auf die sich das Unternehmen verlässt.
Die Validierung muss daher auf Datensatzebene ansetzen. Ein einzelner ungültiger Wert kann Aggregate, Machine-Learning-Features, Finanzberichte oder operative Workflows verändern, ohne einen Systemausfall zu verursachen. Die vielzitierte Benchmark von Gartner schätzt, dass eine schlechte Datenqualität Unternehmen durchschnittlich 12,9 Millionen US-Dollar pro Jahr kostet (Gartner benchmark), während eine Untersuchung von IBM aus dem Jahr 2025 ergab, dass mehr als ein Viertel der Unternehmen die jährlichen Verluste auf über 5 Millionen US-Dollar schätzt, wobei 7 % Verluste von über 25 Millionen US-Dollar melden (IBM research). Das DCI-Whitepaper über die versteckten Kosten schlechter Daten bietet weitere Diskussionen über die operativen Kosten mangelhafter Datenqualität.
Die Untersuchung erfordert zudem Kontext. Eine Data Anomalies kann echtes Kundenverhalten darstellen, während ein Validierungsfehler bedeutet, dass ein Wert gegen eine erwartete Struktur oder Regel verstößt. Eine Tabellenkalkulation markiert einen Wert möglicherweise über ein Dropdown-Menü, ein Enterprise-Import lehnt ihn eventuell anhand eines verwalteten Schemas ab, und eine Warehouse-Pipeline erzwingt unter Umständen ein irreführendes NULL. Wiederholte Fehler in diesen Schichten weisen in der Regel auf einen Fehler bei der Quellzuordnung, der Transformation oder dem Datenvertrag hin und nicht auf eine Reihe von unglücklichen Zeilen. Hintergrundinformationen zur Unterscheidung von ungewöhnlichen Werten und Regelverstößen finden Sie im digna-Leitfaden zu Data Anomalies.
Für Teams, die Dashboards über Power BI veröffentlichen, kann der Power BI-Connector-Leitfaden von Tutorial AI Klarheit über die Berichtsseite verschaffen. Die Connector-Konfiguration kann jedoch keinen ungültigen Quellwert reparieren. Die zuverlässige Behebung beginnt dort, wo der Datensatz zum ersten Mal seinen Vertrag verletzt.
Was ein Data Validation-Fehler tatsächlich bedeutet
Ein Data Validation-Fehler tritt auf, wenn ein beobachteter Wert eine Regel, ein Schema, eine Beziehung oder eine geschäftliche Erwartung nicht erfüllt. Die Regel kann einfach sein, wie „Dieses Feld muss ein Datum enthalten“, oder relational, wie „Diese Bestellung muss sich auf einen existierenden Kunden beziehen“.
Stellen Sie sich die Validierung wie einen Einlassvertrag für einen Club vor. Ein Türsteher prüft vielleicht zuerst, ob Ihr Ausweis das richtige Format hat. Eine tiefergehende Prüfung bestätigt, ob der Name auf der Gästeliste steht, das Ticket für die Veranstaltung gültig ist und die Reservierung mit der vorlegenden Person übereinstimmt. Datensysteme funktionieren auf genau dieselbe Weise.
Die oberflächliche Prüfung
Eine Formatprüfung fragt, ob ein Wert korrekt interpretiert werden kann:
2025-04-18sieht wie eine gültige Datumsdarstellung aus.jdoe@ähnelt einem E-Mail-Feld, entspricht aber nicht dem vollständigen Muster einer E-Mail-Adresse.42ist möglicherweise ein gültiger numerischer Wert.Closed Wonkann immer noch fehlschlagen, wenn der zulässige Code eigentlichclosed_wonlautet.
Diese Prüfungen verhindern Parsing-Fehler, stellen aber nicht sicher, dass der Datensatz im Kontext Sinn ergibt.
Die tiefergehende Prüfung
Die Validierung auf Datensatzebene untersucht Beziehungen und Geschäftsregeln:
Identifiziert die
customer_ideinen Kunden in der Kundendimension?Ist der Rabatt für dieses Kundensegment zulässig?
Entspricht die Gesamtsumme der Bestellung der Summe der einzelnen Posten?
Liegt das Bestelldatum nach dem Erstellungsdatum des Kontos?
Gehört der Status zum genehmigten Bereich für diesen Workflow?
Ein Dropdown-Menü in einer Tabellenkalkulation, eine API-Antwort wie HTTP 422, eine Verletzung von Warehouse-Constraints und eine Test-Suite in Great Expectations setzen alle dieselbe Grundidee auf verschiedenen Ebenen um. Jedes davon vergleicht Daten mit einem vereinbarten Vertrag.
Die Weltbank beschreibt die Validierung durch Techniken wie Bereichsprüfungen, interne Konsistenzprüfungen und Ausreißererkennung und betont die Dokumentation der Validierung in Metadaten. Diese Empfehlung finden Sie in ihrem Vortrag über Data Validation. Ein Validierungsfehler ist daher nicht bloß eine lästige Fehlermeldung. Er ist der Beweis dafür, dass ein Datensatz, eine Datei oder ein Datensatz nicht mehr den Annahmen des nachfolgenden Systems entspricht.
Sie erzielen bessere Ergebnisse, wenn Sie sich zwei Fragen getrennt stellen:
Welche Regel ist fehlgeschlagen?
Welche Schicht hat es zugelassen, dass der ungültige Wert so weit gelangt ist?
Die erste Frage repariert den Datensatz. Die zweite verhindert eine Wiederholung.
Für eine breitere Erklärung von Gültigkeit, Dimensionen und Messung vergleichen Sie diese Definition mit der Erklärung von digna zur Datengültigkeit.
Die Hauptmuster hinter Validierungsfehlern
Die meisten Validierungsvorfälle lassen sich in eine kleine Gruppe struktureller Muster einteilen. Die Klassifizierung des Fehlers hilft Ihnen, die richtige Lösung zu wählen, anstatt jede abgelehnte Zeile als separates Rätsel zu behandeln.
Die Weltbank nennt fehlende Werte, Formatprobleme, Codierungsprobleme, Bereichsprüfungen, Konsistenzprüfungen und Ausreißererkennung als wichtige Bestandteile der Validierungspraxis. Frühere Untersuchungen der Society of Actuaries zeigten zudem, dass Gültigkeitsfehler häufiger und weiter verbreitet sind als Genauigkeitsfehler, wobei fehlende Werte, Datenformatfehler und Codierungsfehler zu den Hauptproblemen der Gültigkeit gehören. Die Erkenntnisse sind in der Datenqualitätsforschung der Society of Actuaries zusammengefasst.
Muster | Beispiel für fehlerhaften Wert | Verletzte Regel |
|---|---|---|
Fehlender Wert |
| Erforderliche ID muss vorhanden sein |
Formatfehler |
| Wert muss ein analysierbares Datumsformat verwenden |
Bereichsverletzung |
| Alter muss im zulässigen Bereich liegen |
Codierungs- oder Domänenfehler |
| Wert muss mit einer genehmigten Domäne übereinstimmen |
Konsistenzbruch |
| Gesamtsumme im Header muss der Summe der Details entsprechen |
Fehlende Werte
Ein fehlender Wert wird dann zu einem Fehler, wenn das Feld für die Verarbeitung oder Interpretation erforderlich ist. Ein leeres Feld für eine Telefon-Durchwahl mag akzeptabel sein, während eine fehlende Kundennummer das Zusammenführen (Join) des Datensatzes unmöglich machen kann. Diese Fehler treten häufig in Ingestions-Protokollen, bei NOT NULL-Prüfungen oder in Berichten mit unerwartet unvollständigen Datenbeständen auf.
Formatfehler
Formatfehler treten auf, wenn das System den Wert nicht als den deklarierten Typ parsen kann. Ein als Freitext gespeichertes Datum, ein numerischer Betrag mit einem unerwarteten Symbol oder eine E-Mail ohne Domain können einen unzureichend kontrollierten Export passieren und beim Laden in einer API oder bei einer Typkonvertierung (Cast) im Warehouse fehlschlagen.
Bereichsverletzungen
Bereichsprüfungen erfassen Werte, die zwar strukturell numerisch, aber logisch unmöglich oder unzulässig sind. Ein negatives Alter, ein Geburtsdatum in der Zukunft oder ein Prozentsatz über dem zulässigen Maximum können syntaktisch gültige Zahlen sein. Die Data Validation-Referenz der Weltbank erklärt, wie Bereichs- und interne Konsistenzprüfungen dabei helfen, Fehler vor der Analyse oder dem produktiven Einsatz zu lokalisieren.
Codierungs- und Domänenfehler
Eine Domäne ist die Menge der akzeptierten Werte für ein Feld. Felder für Land, Status, Produkttyp und Risikokategorie schlagen oft fehl, weil verschiedene Systeme unterschiedliche Schreibweisen, Groß-/Kleinschreibung, Abkürzungen oder veraltete Codes verwenden. Diese Fehler führen möglicherweise nicht zu einem Parser-Fehler, aber sie fragmentieren Zählungen und machen Filter unbrauchbar.
Konsistenzbrüche
Konsistenzregeln vergleichen Felder innerhalb desselben Datensatzes oder über verwandte Datensätze hinweg. Ein Lieferland, das im Widerspruch zur zugewiesenen Region steht, eine Rechnung, deren Detailzeilen nicht mit der Gesamtsumme im Header übereinstimmen, oder eine Transaktion, die mit einem unbekannten Kunden verknüpft ist, gehören in diese Kategorie. Geschäftsanwender bemerken diese Fehler oft zuerst, weil die Ausgabe im Widerspruch zu ihrem Wissen über den Prozess steht.
Diagnostische Gewohnheit: Beginnen Sie nicht damit, den Wert zu bearbeiten. Benennen Sie zuerst das verletzte Muster. Das Muster weist in der Regel auf die verantwortliche Schicht hin.
Beispiele auf Datensatzebene, die Sie in Ihren eigenen Daten erkennen können
Derselbe Defekt sieht anders aus, je nachdem, wo er Ihnen begegnet. Eine Tabellenkalkulation zeigt möglicherweise eine verdächtige Zeichenkette an, eine API gibt eventuell eine strukturierte Ablehnung zurück, und ein Warehouse-Test meldet vielleicht eine fehlgeschlagene Beziehung. Das zugrunde liegende Problem kann dennoch identisch sein.
Tabellenkalkulationsexporte
Ein CRM-Export enthält diese Zeile:
customer_email | phone | stage |
|---|---|---|
|
|
|
Die E-Mail-Adresse schlägt bei einer grundlegenden Strukturprüfung fehl, da ihr eine vollständige Domain fehlt. Die Telefonnummer ist für einen Prozess vielleicht nutzbar, steht aber im Widerspruch zu einem anderen Prozess, der ein normalisiertes Format wie (555) 123-4567 erwartet. Die Phasen-Werte closed-won, Closed Won und CLOSED_WON stellen für einen Menschen denselben Geschäftsstatus dar, erscheinen für eine Pivot-Tabelle jedoch als drei verschiedene Kategorien.
Ein Dropdown-Menü könnte neue Varianten verhindern, normalisiert jedoch keine bereits exportierten historischen Werte. Es erklärt auch nicht, ob das Quell-CRM, die Exportvorlage oder eine manuelle Bearbeitung den Unterschied verursacht hat.
API-Ingestion
Eine API empfängt diesen Payload:
Hier verletzt customer_id eine Pflichtfeld-Regel. order_total ist eine Zeichenkette, obwohl der Empfängervertrag eine Zahl erwartet. created_at ist kein gültiges Datum, da die Kombination aus Monat und Tag nicht als reales Kalenderdatum interpretiert werden kann.
Eine HTTP-422-Antwort ist nützlich, wenn sie genau das Feld und die Regel identifiziert, die fehlgeschlagen sind. Wenn sie nur „unprocessable entity“ ausgibt, überprüfen Sie den Request-Body, den Response-Body, den Content-Type und die API-Spezifikation. Der Postman-Leitfaden zu HTTP-422-Fehlern bietet praktischen Debugging-Kontext für diese Fälle.
Warehouse-Datensätze
Eine Fakten-Tabelle im Warehouse enthält eine Zeile mit drei separaten Problemen:
order_dateliegt vor demcustomer_signup_date.customer_idverweist auf keine Zeile indim_customer.discount_percent = 150liegt außerhalb des zulässigen Bereichs.
Das erste ist ein Fehler der zeitlichen Konsistenz. Das zweite ist ein Fehler der referentiellen Integrität. Das dritte ist eine Bereichsverletzung. Keines davon ist ein reines Formatierungsproblem, und eine Korrektur des Anzeigeformats wird den Datensatz nicht vertrauenswürdig machen.
Umgebung | Feldbeispiel | Fehlerhafter Datensatzwert | Fehlerklasse |
|---|---|---|---|
Tabellenkalkulation |
|
| Format |
API-Payload |
|
| Pflichtfeld |
API-Payload |
|
| Typenkonflikt |
Warehouse Fakten-Tabelle |
| Unbekannter Dimensionsschlüssel | Referentiell |
Warehouse Fakten-Tabelle |
| Vor dem Registrierungsdatum | Zeitlich |
Warehouse Fakten-Tabelle |
|
| Bereich |
Diese Beispiele lassen sich leichter beurteilen, wenn Sie die Gültigkeit von der Plausibilität trennen. Ein Wert kann einem Datentyp entsprechen und im Kontext dennoch unplausibel wirken. Der digna-Leitfaden zur Datenplausibilität untersucht diesen Unterschied.
Warum die meisten Validierungsfehler upstream entstehen
Das schrittweise Beheben fehlerhafter Zellen fühlt sich produktiv an, weil die Fehlerzahl sofort sinkt. Es bekämpft jedoch oft nur das Symptom, während der Erzeuger, der Vertrag oder das Schema unverändert bleiben.
Ein Dropdown-Menü in einer Tabellenkalkulation regelt nur, was ein Benutzer über diese Schnittstelle eingeben kann. Es kontrolliert keine Werte, die durch eine CRM-Integration, einen Bulk-Export, einen API-Client, eine Datenbankmigration oder einen Transformationsjob erzeugt werden. Die stärkste Validierung findet nahe am Entstehungs- und Austauschpunkt der Daten statt.
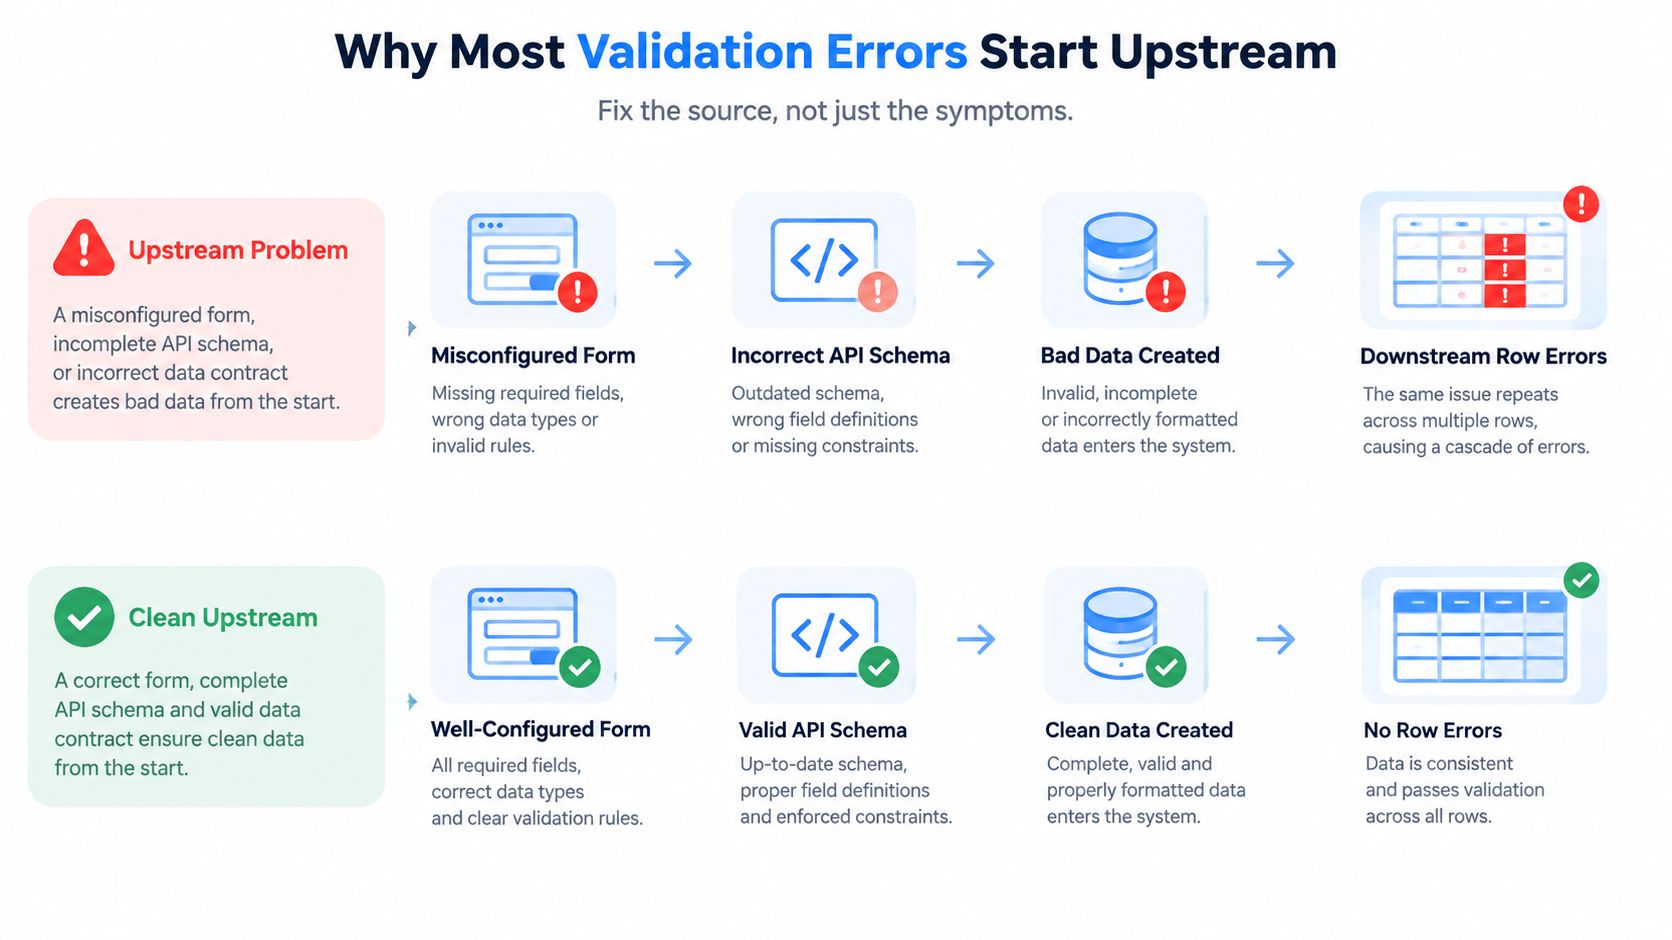
Stellen Sie sich ein API-Feld vor, das ohne einen versionierten Vertrag von customer_id in account_id geändert wird. Die empfangende Transformation befüllt customer_id daraufhin bei jedem eingehenden Datensatz mit NULL. Das Warehouse meldet dann fehlende IDs, Dashboard-Joins verlieren Zeilen und Analysten beginnen, Ausgaben manuell zu flicken. Der wiederholte Fehler ist kein Beweis für unachtsame Dateneingabe. Er ist der Beweis dafür, dass sich zwei Systeme uneins über das Schema sind.
Dasselbe Muster zeigt sich, wenn sich eine CRM-Exportvorlage ändert, ein Datenbank-Constraint gelockert wird oder eine Migration eine Pflichtfeld-Regel entfernt. Eine Änderung an der Quelle kann Tausende von nachgelagerten Fehlern verursachen, die wie einzelne fehlerhafte Zeilen aussehen.
Reparieren Sie den Vertrag, nicht nur die Ausgabe
Nutzen Sie das Fehlermuster, um die passende Maßnahme zu wählen:
Geänderter Feldname: Versionieren Sie den Payload und aktualisieren Sie den Consumer ganz bewusst.
Optionales Feld, das vorhanden sein muss: Machen Sie das Feld im Quellvertrag zum Pflichtfeld und lehnen Sie unvollständige Anfragen ab.
Ungültiger numerischer Wert: Fügen Sie einen quellseitigen
CHECK-Constraint oder eine entsprechende Validierung hinzu.Nicht erkannter Status: Pflegen Sie eine gemeinsame Domäne oder Enumeration, anstatt sich auf Freitext zu verlassen.
Fehlerhafte Beziehung: Validieren Sie referenzierte IDs, bevor Sie den abhängigen Datensatz laden.
Der digna-Leitfaden zur Daten-Ingestion bietet nützlichen Kontext, um die Ingestion als kontrollierte Datenbewegung und nicht als einfachen Dateiübertragungsschritt zu behandeln.
Ursachen-Test: Wenn derselbe Validierungsfehler nach einer Quelländerung in vielen Zeilen auftritt, überprüfen Sie den Vertrag, bevor Sie die Datensätze bereinigen.
Es ist in der Regel sicherer, ungültige Daten bei der Ingestion abzulehnen, als zuzulassen, dass sie als NULL, leerer String oder erzwungener Standardwert gespeichert werden. Wenn eine Ablehnung nicht machbar ist, verschieben Sie die Zeile zusammen mit ihrer Quell-ID, dem Regelverstoß und dem Ingestions-Zeitstempel in eine Quarantäne, damit nachgelagerte Verbraucher einen beschädigten Wert nicht mit einem echten verwechseln.
Ein praktischer Workflow zur Erkennung und Behebung von Fehlern
Ein zuverlässiger Workflow platziert Kontrollen dort, wo sie das klarste Signal und den geringsten Nacharbeitsaufwand verursachen. Beginnen Sie bei der Erfassung, gehen Sie dann über zur Ingestion, den Warehouse-Prüfungen und schließlich zum Konsum.
Erfassung (Capture)
Validieren Sie Typen, Pflichtfelder, zulässige Werte und Bereiche in Formularen, APIs und Quelldatenbanken. Eingabemasken können Benutzer anleiten, während Schema-Constraints verhindern, dass Produzenten Werte senden, die nachgelagerte Systeme nicht interpretieren können.
Eine Quelldatenbank sollte Regeln durchsetzen, die unabhängig davon gelten, wer den Datensatz schreibt. Eine API sollte Fehler auf Feldebene zurückgeben, die dem Client genau mitteilen, was zu korrigieren ist. Ein Formular sollte einen ungültigen Wert vor dem Absenden verhindern, anstatt darauf zu hoffen, dass ein Analyst ihn später findet.
Ingestion
Behandeln Sie jede eingehende Datei oder jeden Payload wie einen Vertrag. Validieren Sie jeden Datensatz gegen das erwartete Schema, verschieben Sie Fehler in die Quarantäne und geben Sie strukturierte Fehlerereignisse aus, die die Quelldatei, die Datensatz-ID, das Feld, den beobachteten Wert und die verletzte Regel enthalten.
Überschreiben Sie den Originalwert bei der Bereinigung nicht. Bewahren Sie ihn neben dem normalisierten Wert auf, damit das Team prüfen kann, was eingegangen ist und welche Transformation stattgefunden hat.
Warehouse
Führen Sie kontinuierliche Prüfungen auf Nullwerte, Eindeutigkeit, referentielle Integrität, Aktualität, Verteilungsänderungen und feldübergreifende Logik durch. Ein Warehouse-Test sollte eine einzelne abgelehnte Zeile von einem umfassenden Schemafehler unterscheiden können und genügend Kontext bewahren, damit der Eigentümer das Problem reproduzieren kann.
Die Empfehlungen der Weltbank zur Dateneingabe und Validierung betonen Kontrollen wie die Einschränkung von Antwortoptionen und die Verwendung von anzahlbasierten Prüfungen, um übersprungene oder ungültige Elemente zu reduzieren. Diese Prinzipien gelten nicht nur für Umfragen. Setzen Sie Einschränkungen frühzeitig durch und überprüfen Sie den resultierenden Datensatz anschließend unabhängig.
Konsum (Consumption)
Dashboards und Modelle benötigen ihre eigenen Prüfungen (Assertions). Vergleichen Sie erwartete Zeilenzahlen, erkennen Sie fehlende Partitionen, prüfen Sie die Join-Abdeckung und markieren Sie Metriken, die sich plötzlich ändern, ohne dass es eine entsprechende Erklärung zur Datenqualität gibt.
Wenn Formeln in Tabellenkalkulationen bearbeitet werden, kann sich die Validierung unerwartet verhalten. Microsoft Q&A weist darauf hin, dass Formelfehler wie #REF! oder #DIV/0! dazu führen können, dass die Validierung ignoriert wird, während Kopier- und Ausfüllvorgänge das erwartete Verhalten umgehen oder verändern können. Prüfen Sie Microsofts Diskussion über formelgesteuerte Validierungsfehler, wenn ein Dropdown-Menü korrekt erscheint, aber transformierte Zellen dennoch fehlschlagen.
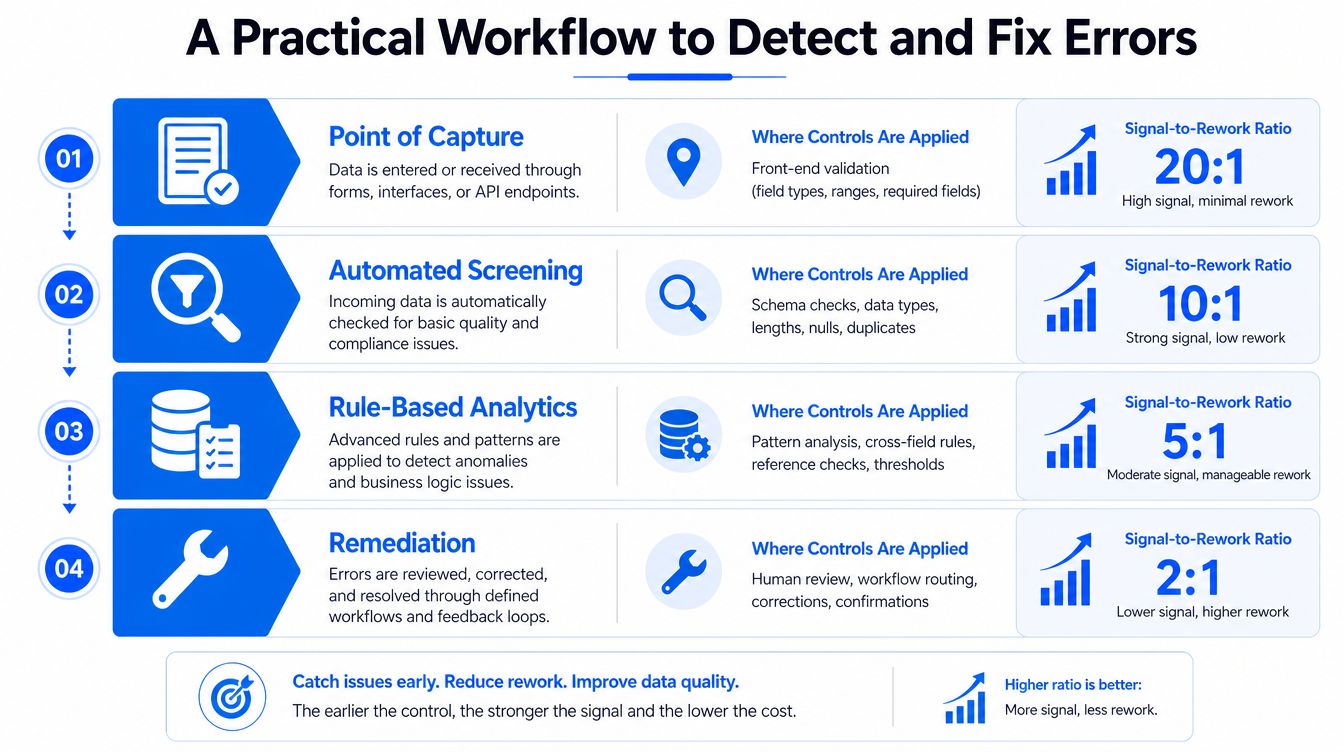
Nutzen Sie diese Reihenfolge zur Behebung:
Reparieren Sie zuerst Upstream-Verträge. Korrigieren Sie die Quellregel, das Schema, das Mapping oder das Verhalten des Produzenten.
Flicken Sie das Warehouse erst an zweiter Stelle. Isolieren, rekonstruieren (backfill) oder normalisieren Sie Datensätze, wenn die Quelle nicht sofort geändert werden kann.
Bereinigen Sie in der Analytik nur, wenn es unbedingt notwendig ist. Machen Sie die Transformation sichtbar, dokumentiert und umkehrbar.
Für kontinuierliche Prüfungen, die Regeln auf Datensatzebene mit einer breiteren Observability kombinieren, lesen Sie dignas Leitfaden zur Data Validation und kontinuierlichen Datenqualität. Die Plattform läuft innerhalb der Umgebung des Kunden, führt Metrikberechnungen in den Datenbanken des Kunden durch und kann Validierung, Timeliness, Anomalien sowie Schemaänderungen überwachen, ohne dass Produktionsdaten aus dieser Umgebung abwandern müssen.
Wichtige Erkenntnisse für einen zuverlässigen Datenbetrieb
Ein zuverlässiger Datenbetrieb hängt weniger von einer einzigen perfekten Bereinigungsaktion ab als vielmehr von einer wiederholbaren Reaktion auf wiederkehrende Fehler. Nutzen Sie diese Checkliste, wenn ein Validierungsalarm auftritt:
Klassifizieren Sie den Defekt. Entscheiden Sie, ob er fehlt, fehlerhaft formatiert ist, außerhalb des Bereichs liegt, außerhalb der Domäne liegt, inkonsistent ist, zeitlich unmöglich oder referentiell ungültig ist.
Verfolgen Sie den ersten Fehlerpunkt zurück. Identifizieren Sie den Erzeuger, den Export, das API-Mapping, die Migration oder die Transformation, die den Konflikt verursacht hat.
Reparieren Sie den Upstream-Vertrag. Ändern Sie das Schema, die Pflichtfeld-Regel, den Constraint, das Mapping oder den versionierten Payload, bevor Sie eine große Anzahl nachgelagerter Zeilen bearbeiten.
Etablieren Sie mehrschichtige Kontrollen. Validieren Sie bei der Erfassung, Ingestion, im Warehouse und beim Konsum, damit eine lautlose Konvertierung nicht unbemerkt bleibt.
Verfolgen Sie Wiederholungen. Protokollieren Sie das Feld, die Regel, die Quelle, die Pipeline und den Trend der Fehler. Wiederholte Fehler erfordern technische Anpassungen, keine wiederholte manuelle Bereinigung.
Sichern Sie Beweise. Bewahren Sie abgelehnte Datensätze, Regelergebnisse, Zeitstempel und Behebungsentscheidungen für Untersuchungen und Audits auf.
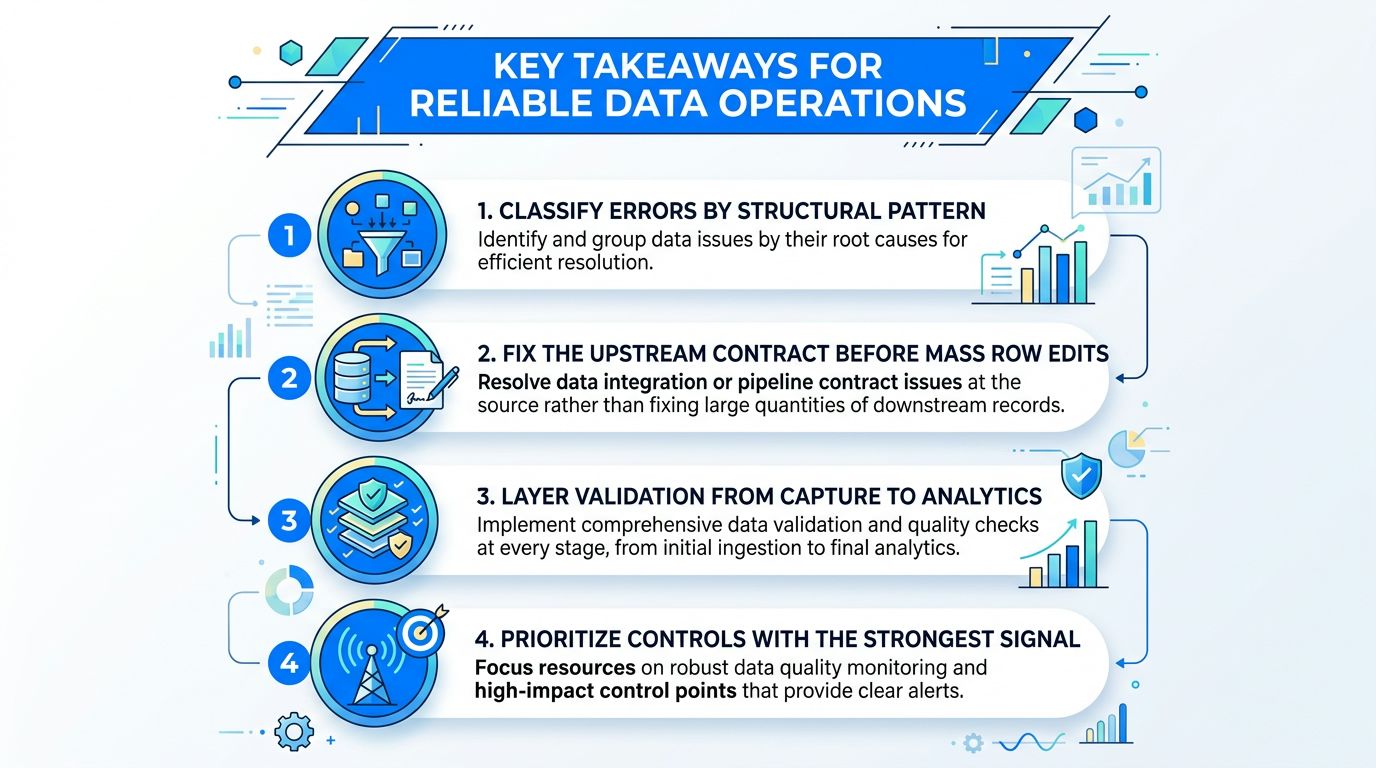
Die wichtigste Lektion ist einfach: Wiederkehrende Validierungsfehler weisen in der Regel auf einen fehlerhaften Prozess hin, nicht auf einen unachtsamen Benutzer. Eine einzelne Zeile mag der sichtbare Fehler sein, aber wiederholte Zeilen offenbaren eine Schwachstelle im Vertrag, im Schema, im Mapping oder im Monitoring weiter oben (upstream).
Validierung sollte daher beobachtbar sein. Teams müssen wissen, welche Regeln fehlschlagen, wo sie fehlschlagen, ob Fehler isoliert oder systemisch sind und welche nachgelagerten Assets von den betroffenen Daten abhängen. Diese Sichtbarkeit verwandelt eine verwirrende Dashboard-Abweichung in einen handlungsorientierten technischen Vorfall.
digna hilft Datenteams dabei, Validierungsregeln auf Datensatzebene zu definieren, Schemaänderungen zu überwachen, die Timeliness zu verfolgen und ungewöhnliches Verhalten in Warehouses und Pipelines zu erkennen – während die Daten in der Umgebung des Kunden verbleiben. Besuchen Sie digna, um zu sehen, wie Sie die wiederkehrende, zeilenweise Bereinigung durch nachvollziehbare Kontrollen für Datenqualität und Observability ersetzen können.
Häufig gestellte Fragen
Was ist ein Datenvalidierungsfehler?
Er tritt auf, wenn ein beobachteter Wert eine Regel, ein Schema, eine Beziehung oder eine fachliche Erwartung verletzt. Er ist mehr als eine abgelehnte Tabellenzelle: Ein erfolgreicher Pipeline-Lauf belegt, dass die Verarbeitung endete, nicht dass jeder Datensatz die Regeln erfüllt, auf die sich das Geschäft verlässt.
Worin unterscheiden sich Formatprüfung und Validierung auf Satzebene?
In der Tiefe. Eine Formatprüfung fragt, ob ein Wert interpretierbar ist, sodass 2025-04-18 als Datum durchgeht, während jdoe@ ein E-Mail-Muster verfehlt. Validierung auf Satzebene prüft stattdessen Beziehungen: Identifiziert customer_id eine echte Kundin, entspricht die Bestellsumme ihren Positionen, folgt das Ereignisdatum der Kontoeröffnung?
Welche Muster von Validierungsfehlern treten am häufigsten auf?
Eine kleine Menge wiederholt sich: Fehlwerte, Formatprobleme, Kodierungsfehler, verfehlte Bereichsprüfungen, Konsistenzverletzungen und Ausreißer. Die Weltbank nennt dieselben Kategorien und betont, Validierung in Metadaten zu dokumentieren, damit Regel und Begründung die Person überdauern, die sie geschrieben hat.
Was kostet ein Validierungsfehler tatsächlich?
Gartners vielzitierter Maßstab beziffert mangelhafte Datenqualität auf durchschnittlich 12,9 Millionen USD pro Organisation und Jahr. IBM-Forschung von 2025 fand, dass mehr als ein Viertel der Organisationen jährliche Verluste über 5 Millionen USD schätzt, während 7 % Verluste über 25 Millionen USD berichten.
Wie untersucht man einen Validierungsfehler?
Stellen Sie zwei Fragen getrennt. Welche Regel ist gescheitert, das repariert den Datensatz, und welche Schicht ließ den ungültigen Wert so weit reisen, das repariert die Pipeline. Wer nur die erste beantwortet, lässt denselben Defekt morgen erneut ankommen.


