Data Observability für Data Engineers: Ein praktischer Leitfaden
|
7
min. Lesezeit

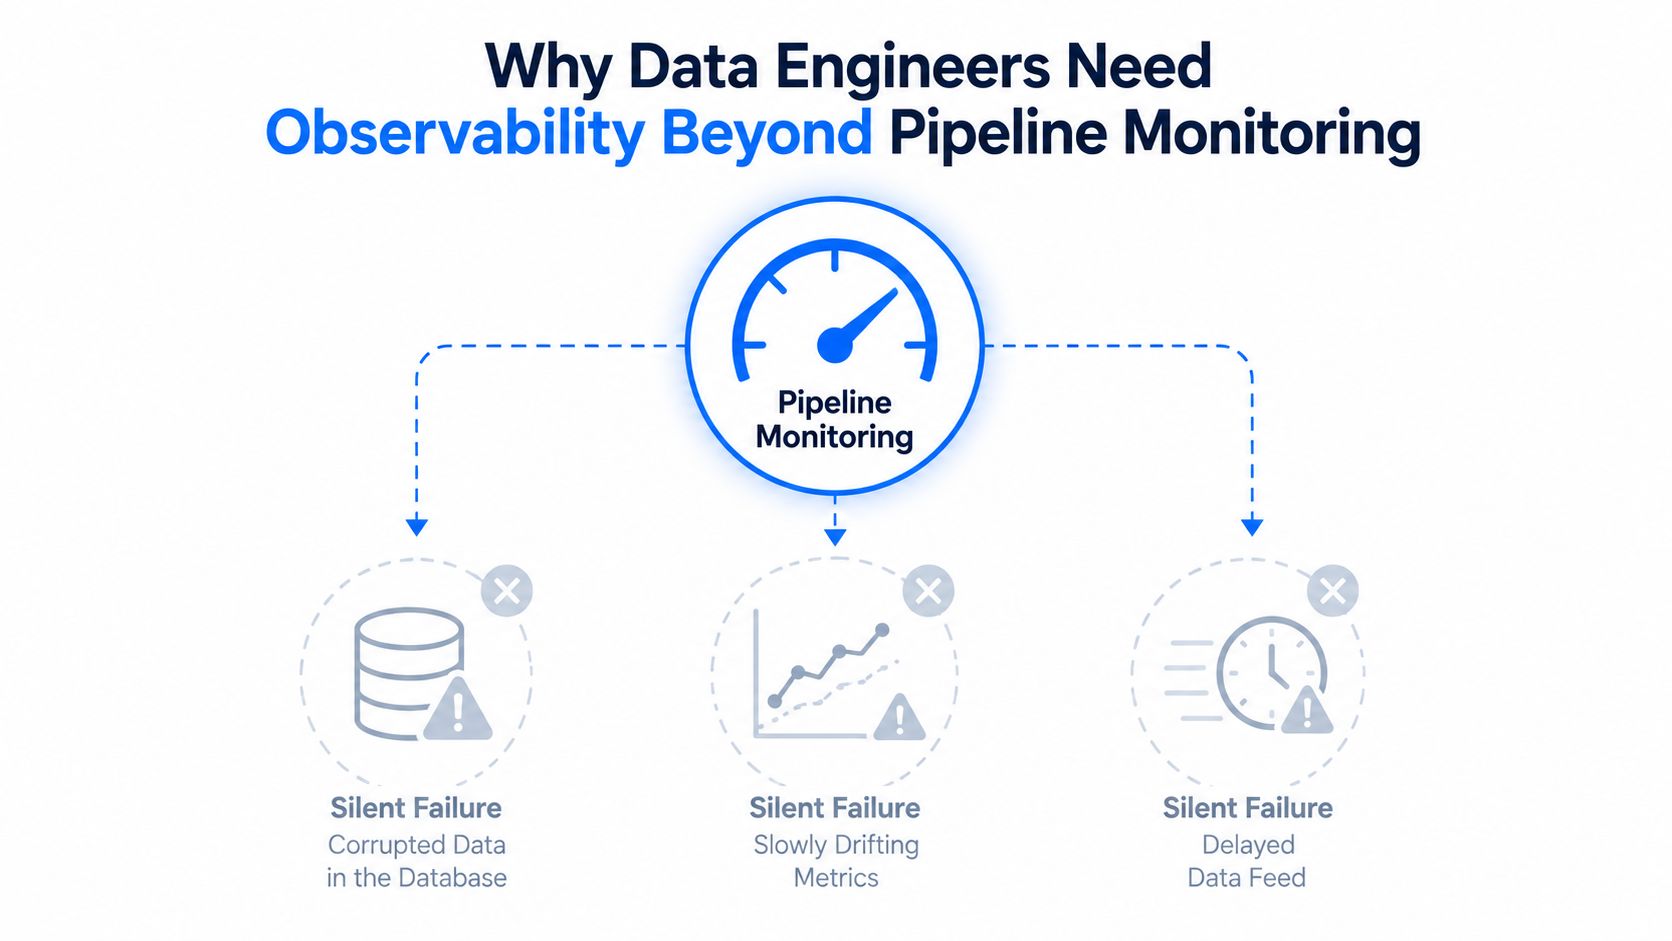
Eine Batch-Pipeline kann erfolgreich (grün) abgeschlossen werden, während das Dashboard, das sie speist, bereits fehlerhafte Daten anzeigt. Die Ladung enthält möglicherweise nur einen Teil der erwarteten Daten, ein Upstream-System hat eventuell eine Spalte hinzugefügt, die eine Transformation verändert, oder die neueste Partition hat sich um Stunden verzögert. Das Infrastruktur-Monitoring meldet einen erfolgreichen Durchlauf, während Analysten und Machine-Learning-Systeme veraltete oder fehlerhafte Ausgaben verarbeiten.
Genau in dieser Lücke verdient Data Observability für Dateningenieure ihren Platz. Sie untersucht das Verhalten der Daten, die sich durch Warehouses, Lakes, Streams und Transformationen bewegen, und verknüpft Anomalien mit Zuständigkeiten, Auswirkungen und Reaktionen. Die praktische Herausforderung besteht nicht darin, jedes erdenkliche Signal zu erfassen. Es geht vielmehr darum, eine ausreichende Abdeckung aufzubauen, um relevante Fehler abzufangen, ohne sensible Daten aus Ihrer Umgebung zu entfernen oder Ingenieure in einer Flut von Alarmen untergehen zu lassen.
Inhaltsverzeichnis
Warum Dateningenieure Observability jenseits des Pipeline-Monitorings benötigen
Monitoring-Systeme und Monitoring-Daten
Die fünf Säulen und ihr praktischer Wert
Instrumentierung der vier Kern-SLIs, die jede Pipeline benötigt
1. Erfolgsquote der Jobs
2. Aktualitätslatenz
3. Vollständigkeit und Volumen
4. Schemakonformität
Lösung des Problems der Alarmmüdigkeit, die die Observability untergräbt
Alarme um Entscheidungen herum konzipieren
Die Erkennungsqualität messen, nicht das Benachrichtigungsvolumen
Implementierung von Observability in regulierten und On-Premises-Umgebungen
Eine Bereitstellungssequenz, die die Sicherheitsüberprüfung übersteht
Heterogene Landschaften benötigen einen gemeinsamen Vertrag
Die Wahl der richtigen Alarmierungsstrategie für Ihren Data Stack
Wann einfache Regeln gewinnen
Wann adaptive Methoden helfen
Integration von Observability in Ihre bestehende Pipeline-Architektur
Prüfungen dort platzieren, wo sie eine Frage beantworten
Klein anfangen und Ihre Observability-Implementierung skalieren
Warum Dateningenieure Observability jenseits des Pipeline-Monitorings benötigen
Um 9:00 Uhr morgens zeigt ein Orchestrierungs-Dashboard einen erfolgreichen Job über Nacht an. Die Warehouse-Aufgabe wurde abgeschlossen, die Wiederholungsversuche blieben bei Null und der Compute-Cluster blieb stabil. Am späten Vormittag stellt die Finanzabteilung fest, dass in einem Umsatz-Dashboard aktuelle Transaktionen fehlen. Ein Modell, das auf derselben Tabelle trainiert wurde, liefert ebenfalls instabile Ergebnisse.
Die Pipeline ist nicht im herkömmlichen Sinne fehlgeschlagen. Sie hat eine unvollständige Partition geliefert und die Arbeit als abgeschlossen markiert. Ein nachgelagerter Join hat Datensätze ausgeschlossen, und die resultierende Tabelle sah strukturell valide genug aus, um in den Dashboards geladen zu werden. Das traditionelle Monitoring sah ein verfügbares System. Es sah keine unzuverlässigen Daten.
Monitoring-Systeme und Monitoring-Daten
Pipeline-Monitoring ist weiterhin wichtig. Die Erfolgsquote von Jobs, das Wiederholungsverhalten, die Aufgabendauer, der Zustand der Executoren und die Infrastrukturkapazität helfen Ingenieuren, betriebliche Fehler zu identifizieren. Aber diese Signale beantworten nur, ob ein Prozess lief, nicht aber, ob das Ergebnis vollständig, pünktlich, strukturell konsistent ist oder sich normal verhält.
Data Observability erweitert dies um die Inspektion der Daten selbst. Sie kombiniert technische Signale mit Kontexten wie Lineage, Eigentümern, nachgelagerten Abhängigkeiten und der geschäftlichen Kritikalität. Der Unterschied ähnelt dem zwischen der Überprüfung, ob ein Lieferwagen das Lager verlassen hat, und der Prüfung, ob das Paket die richtigen Artikel enthält und vor dem vom Kunden gewünschten Zeitpunkt angekommen ist.
Ein nützlicher Ausgangspunkt ist der digna comparison of data observability and data quality, da Qualitätsregeln und Observability verwandte, aber unterschiedliche Probleme lösen. Deterministische Tests setzen bekannte Erwartungen durch. Observability hilft dabei, unerwartete Änderungen aufzudecken, an die niemand als Test gedacht hat.
Die fünf Säulen und ihr praktischer Wert
Die meisten Data Observability-Modelle nutzen fünf Säulen – Aktualität, Verteilung, Schema, Lineage und Volumen –, wie in der Databricks' overview of data observability beschrieben.
Aktualität zeigt an, ob Daten innerhalb des erwarteten Zeitplans eingetroffen sind. Sie ist besonders wichtig für operative Dashboards, regulatorische Berichte und Prozesse, die auf aktuellen Datensätzen basieren.
Volumen vergleicht die Datenmenge mit dem normalen Verhalten. Es kann unvollständige Ladungen, doppelte Erfassungen, fehlerhafte Filter und Upstream-Ausfälle aufdecken.
Schema verfolgt Spalten, Datentypen und strukturelle Änderungen. Dies wird kritisch, wenn sich Quellsysteme unabhängig von den Warehouse-Konsumenten weiterentwickeln.
Verteilung untersucht das Verhalten von Werten, einschließlich Nullwert-Mustern, Bereichen, Eindeutigkeit und anderen Datensatzmerkmalen. Sie kann einen semantisch fehlerhaften Feed erkennen, der zwar die richtigen Spalten und Zeilenanzahlen aufweist, aber inhaltlich falsch ist.
Lineage verknüpft einen Vorfall mit den betroffenen Systemen und Teams. Ohne sie verbringen Ingenieure wertvolle Zeit bei der Fehlerbehebung mit der Suche nach Eigentümern und nachgelagerten Abhängigkeiten.
Ein reguliertes Warehouse priorisiert möglicherweise Schema und Lineage, da eine unkontrollierte strukturelle Änderung die Nachweisbarkeit von Berichten beeinträchtigen kann. Eine Streaming-Plattform legt den Schwerpunkt vielleicht eher auf Aktualität und Verteilung, da verzögerte oder anomale Ereignisse betriebliche Entscheidungen schnell verfälschen können. Eine sinnvolle Implementierung behandelt nicht jede Säule gleich. Sie bietet eine tiefere Abdeckung für Datenprodukte, deren Ausfall größere geschäftliche oder Compliance-Auswirkungen hat.
Für einen breiteren Branchenkontext ist das observability tag on ecommerce nützlich, um zu sehen, wie sich Zuverlässigkeitsprobleme außerhalb des reinen Plattform-Engineerings äußern. Die Lehre für die Praxis ist einfach: Behalten Sie das Infrastruktur-Monitoring bei und ergänzen Sie es um Signale auf Datenebene, wo ein grüner Pipeline-Status dennoch ein schlechtes Ergebnis verbergen kann.
Instrumentierung der vier Kern-SLIs, die jede Pipeline benötigt
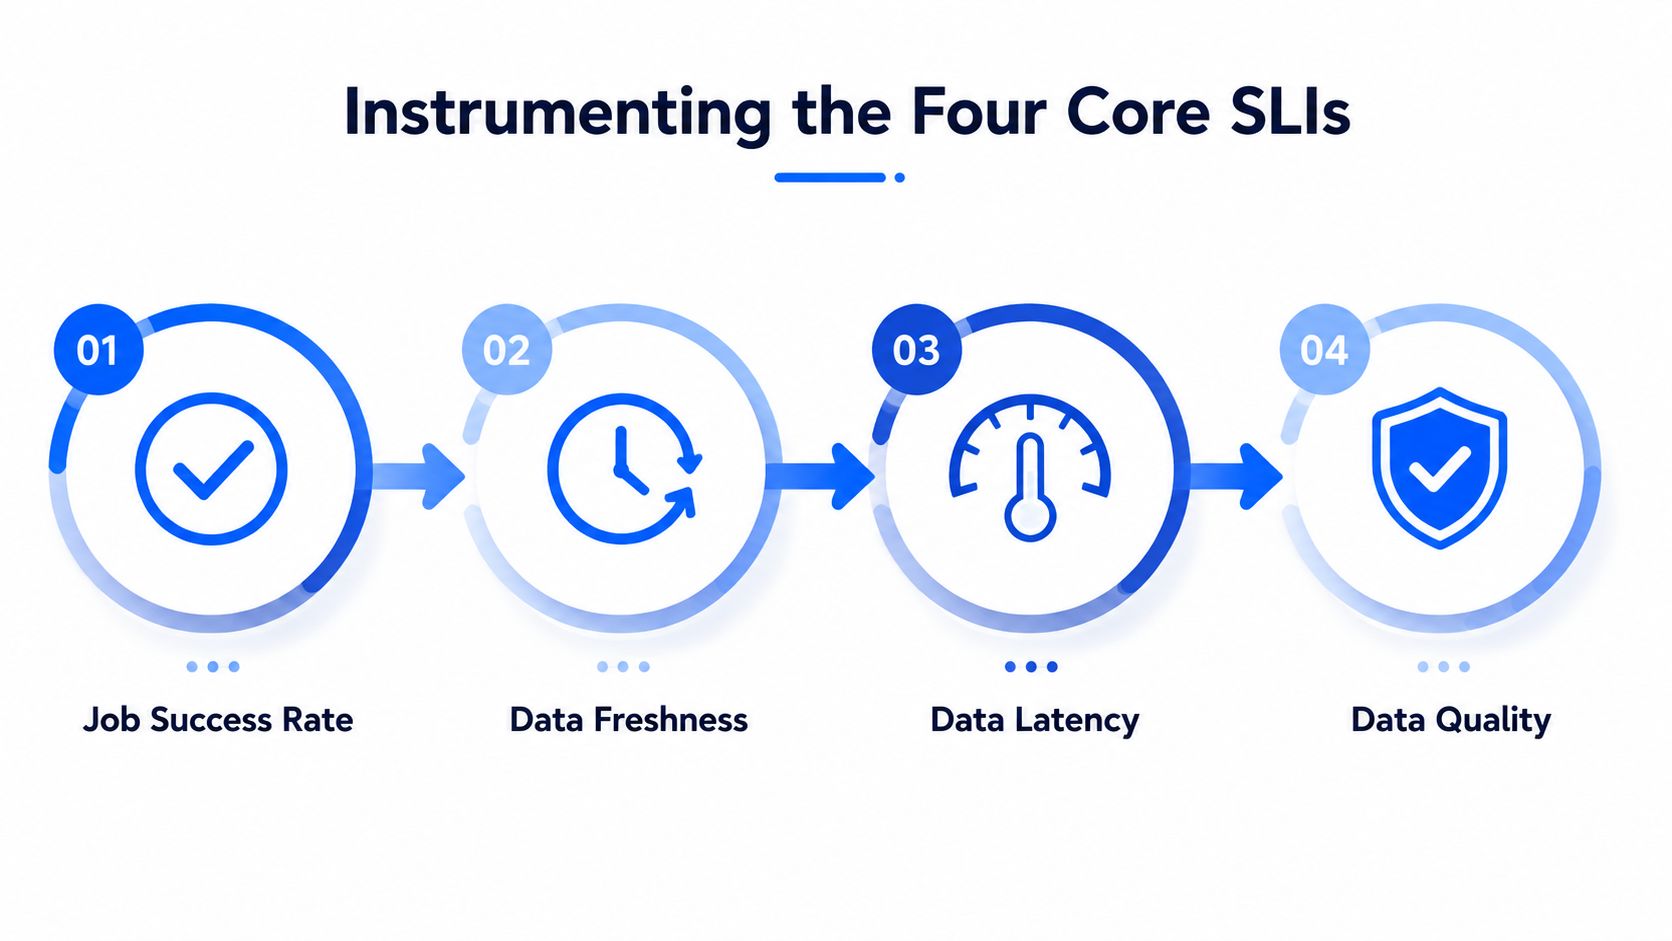
Die praktische Einführung von Observability kann mit vier Service Level Indicators (SLIs) für jede kritische Pipeline beginnen: Erfolgsquote der Jobs, Aktualitätslatenz, Vollständigkeit oder Volumen und Schemakonformität. Diese Signale decken Ausführung, Timing, Menge und Struktur ab, ohne dass vom ersten Tag an ein komplexes Monitoring-Programm erforderlich ist.
1. Erfolgsquote der Jobs
Verfolgen Sie abgeschlossene, fehlgeschlagene, wiederholte, übersprungene und abgebrochene Ausführungen. Eine einfache Erfolgsquote ist nützlich, aber bleiben Sie nicht bei einem binären Status stehen. Erfassen Sie den Ausführungspfad, die Dauer, den Zustand der Abhängigkeiten und ob der Job die erwartete Ausgabe erzeugt hat.
Bei Batch-Systemen sollten Sie ein Abschlussereignis erst dann ausgeben, wenn die Zielpartition übermittelt und validiert wurde. Unterscheiden Sie bei Streaming-Systemen die Aktivität des Prozesses vom tatsächlichen Fortschritt. Ein Consumer kann verbunden bleiben, während der Verzug (Lag) wächst oder sich fehlerhafte Datensätze anhäufen.
2. Aktualitätslatenz
Aktualität (Timeliness) misst die Zeit seit der letzten erfolgreichen Aktualisierung oder die Verzögerung zwischen der erwarteten und der tatsächlichen Bereitstellung. Für kritische Datensätze drücken Teams diese Metrik oft als p95- oder p99-Latenz aus. Dies verhindert, dass eine kleine Anzahl schneller Datensätze eine lange Verzögerung bei verspäteten Daten maskiert. Die Industry guidance on freshness monitoring setzt die Prüfung ebenfalls in Relation zum erwarteten Ingestions-Rhythmus.
Batch-Pipelines sollten die geplante Zeit, die Ankunftszeit und den Zeitpunkt der erfolgreichen Verfügbarkeit erfassen. Streaming-Systeme sollten den Verzug der Ereigniszeit (Event-Time Lag) und den Verzug der Erfassungszeit (Ingestion-Time Lag) separat verfolgen, da ein aktiver Consumer auch verspätete Ereignisse verarbeiten kann.
Nutzen Sie das historische Verhalten als Kontext, anstatt einen universellen Schwellenwert anzuwenden. Ein praktischer Ausgangspunkt vergleicht dieselbe Tageszeit mit den vorangegangenen 2–4 Wochen, wie in den Streamkap's guidance for streaming observability beschrieben. Für einen kritischen Alarm wird als statistischer Ausgangspunkt eine Abweichung von 3 Standardabweichungen vom Basiswert empfohlen, während für eine Warnung 2 Standardabweichungen verwendet werden können. Diese Werte gehören in eine Richtlinie, die auch Lieferverpflichtungen und nachgelagerte Konsequenzen berücksichtigt.
3. Vollständigkeit und Volumen
Vergleichen Sie erwartete mit tatsächlichen Zeilenanzahlen, Partitionen, Dateien oder Ereignisfenstern. Ein täglicher Batch-Job benötigt möglicherweise eine erwartete Partition und einen minimalen Zeilenbereich. Ein Stream muss den Ereignis-Durchsatz aufrechterhalten und unerklärliche Lücken in Zeitfenstern vermeiden.
Reine Zeilenanzahlen reichen nicht aus. Kombinieren Sie diese mit Duplikatsprüfungen, Monitoring der Nullwert-Rate und Partitionsabdeckung, damit eine doppelt geladene Datenmenge nicht fälschlicherweise als vollständig erscheint. Volumenanomalien treten oft auf, bevor ein Dashboard sichtlich fehlerhaft ist, was sie zu wertvollen Frühindikatoren statt zu reinen Post-Incident-Diagnosen macht.
4. Schemakonformität
Messen Sie den Prozentsatz der Zeilen, die die strukturelle Validierung bestehen, und verfolgen Sie Änderungen an Spaltennamen, Typen, Nullwert-Zulässigkeit und Verschachtelungen. Schema-Drift umfasst hinzugefügte Spalten, entfernte Spalten und Änderungen des Datentyps, wie in der Ataccama's explanation of schema tracking dokumentiert.
Platzieren Sie die Prüfung nah an der Quellgrenze und erneut vor den hochwertigen Konsumschichten. Diese Platzierung hilft dabei, eine upstream vorgenommene Vertragsänderung von einem Fehler in der Transformation zu unterscheiden. Speichern Sie die beobachtete Schemaversion mit jedem Durchlauf, damit Fehlerbeheber die erste fehlerhafte Ausgabe mit der vorausgegangenen Änderung vergleichen können.
Praktische Regel: Erst Basiswerte ermitteln, dann alarmieren. Ein Schwellenwert ohne historischen Kontext übersieht entweder eine schleichende Veränderung oder erzeugt Lärm während normaler Betriebszyklen.
Für Teams, die Liefermetriken präzise definieren möchten, bietet dieser Leitfaden zu data timeliness definitions and monitoring metrics ein nützliches Vokabular zur Trennung von Ankunfts-, Verarbeitungs- und Verfügbarkeitsverzögerungen.
Lösung des Problems der Alarmmüdigkeit, die die Observability untergräbt
Mehr Prüfungen können die Zuverlässigkeit verschlechtern, wenn niemand den Benachrichtigungen vertraut. Ein Enterprise Observability Report aus dem Jahr 2025 ergab, dass nur 13 % der Telemetriedaten genutzt wurden. Das bedeutet, das Hauptproblem ist nicht immer die fehlende Sichtbarkeit. Es kann ein Übermaß an Signalen sein, die nie zu operativen Entscheidungen führen, wie in recent enterprise observability coverage berichtet wird.
Der Fehler besteht darin, jede Abweichung als Vorfall zu behandeln. Eine kleine Verteilungsänderung bei einer explorativen Tabelle sollte nicht dasselbe Team alarmieren oder denselben Eskalationspfad nutzen wie veraltete Daten, die in regulatorische Berichte einfließen. Ingenieure benötigen eine Methode, um Signale nach Auswirkung, Vertrauen und Zuständigkeit zu priorisieren.
Alarme um Entscheidungen herum konzipieren
Jeder Alarm sollte vier Fragen beantworten:
Was hat sich geändert? Identifizieren Sie den Datensatz, das Feld, die Partition oder die Pipeline.
Wie ungewöhnlich ist es? Zeigen Sie den Basiswert, den beobachteten Wert und das Konfidenzniveau.
Wer ist für die Reaktion zuständig? Leiten Sie die Benachrichtigung an ein bestimmtes Team oder einen Service-Eigentümer weiter.
Was könnte betroffen sein? Beziehen Sie die Lineage und den Geschäftsprozess ein, der von diesem System abhängt.
Ein nützlicher Alarm könnte melden, dass eine kritische Tabelle außerhalb ihres normalen Liefermusters eingetroffen ist, die fehlende Partition identifizieren, die nachgelagerte Bericht-Abhängigkeit aufzeigen und auf den verantwortlichen Ingestion-Job verweisen. „Volumenanomalie erkannt“ ist kein Workflow für einen Vorfall. Es ist lediglich eine Aufforderung, mit einer manuellen Untersuchung zu beginnen.
Statistische Schwellenwerte helfen, willkürliche Alarmierungen zu reduzieren. Nutzen Sie 3 Standardabweichungen für kritische Alarme und 2 für Warnungen, wenn das historische Verhalten stabil ist, und unterdrücken Sie doppelte Benachrichtigungen, solange ein Vorfall offen ist. Bei saisonalen, spärlichen oder sich schnell ändernden Daten kann ein gelernter Basiswert eine feste Regel übertreffen, benötigt aber dennoch einen Eigentümer und eine geschäftsrelevante Schweregrad-Richtlinie.
Die Erkennungsqualität messen, nicht das Benachrichtigungsvolumen
Die mittlere Zeit bis zur Erkennung (Mean Time to Detect) ist oft das aufschlussreichste Maß für die Zuverlässigkeit, da Teams ein Problem erst lösen können, wenn sie von dessen Existenz wissen. Eine Branchenstudie aus dem Jahr 2026 berichtete, dass Datenteams durchschnittlich 67 Vorfälle pro Monat verzeichneten, wobei 68 % der Fälle mehr als 4 Stunden zur Erkennung benötigten und die Behebung im Schnitt 15 Stunden dauerte, so die Integrate.io's survey coverage. Die operative Konsequenz ist klar: Die Reduzierung der Erkennungsverzögerung kann mehr Wert schaffen als das Hinzufügen eines weiteren Dashboards.
Verfolgen Sie irrelevante Alarme, die keine Aktion erforderten, Alarme ohne zugewiesenen Eigentümer, wiederholte Alarme für ein und dieselbe Ursache sowie Vorfälle, die zuerst von Geschäftsanwendern entdeckt wurden. Passen Sie dann Schwellenwerte an, konsolidieren Sie verwandte Signale und entfernen Sie Prüfungen, die keine Entscheidung beeinflussen.
Ein fokussiertes data quality dashboard sollte den Teams helfen, Trends und ungelöste Vorfälle zu sehen, statt nur einen riesigen Katalog an Prüfungen anzuzeigen. Das beste Observability-Programm ist nicht das mit den meisten Alarmen, sondern dasjenige, dem die Ingenieure so weit vertrauen, dass sie danach handeln.
Implementierung von Observability in regulierten und On-Premises-Umgebungen
Ein SaaS-first-Design setzt oft voraus, dass Metadaten und Stichproben frei an einen externen Dienst übertragen werden können. Diese Annahme scheitert im Finanzwesen, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor, wo Datenresidenz, Auditierbarkeit, Zugriffskontrolle und Sicherheitsprüfungen jede architektonische Entscheidung prägen.
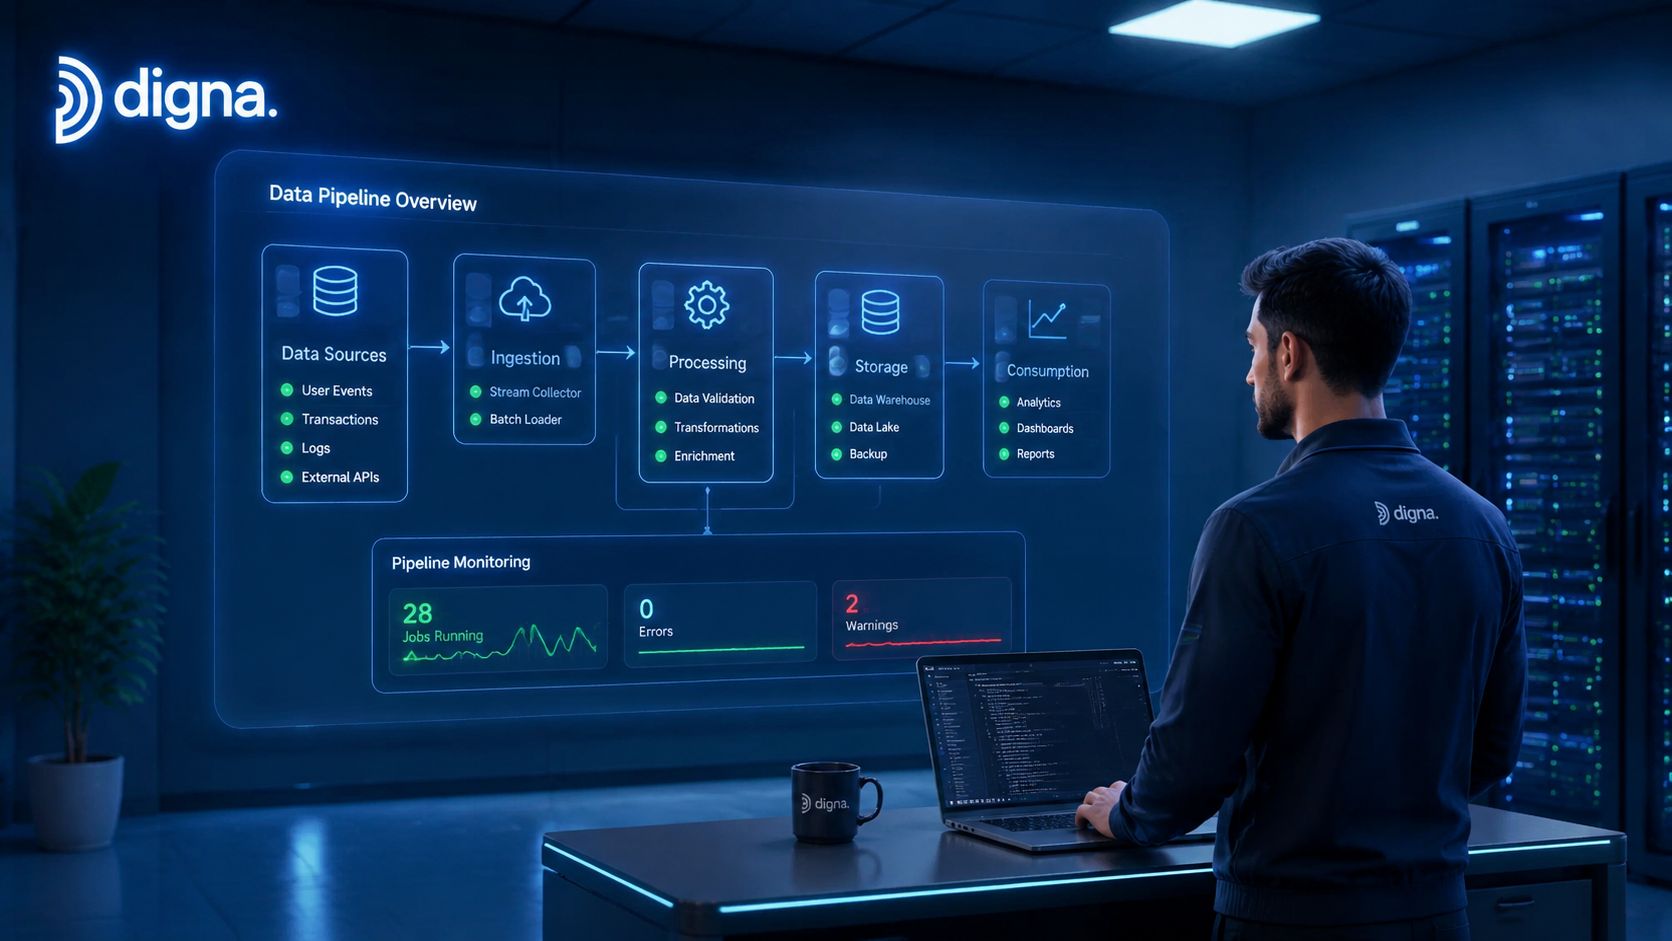
Das Implementierungsmuster, dem ich in diesen Umgebungen vertraue, belässt die Produktionsdaten innerhalb der Kunden-Sicherheitsgrenze. Die In-Database-Ausführung berechnet Metriken dort, wo die Daten bereits liegen, während die Observability-Schicht freigegebene Metadaten, Metrikergebnisse und Vorfallskontexte erhält, anstatt unbeschränkten Zugriff auf Produktionsdaten zu erhalten.
Eine Bereitstellungssequenz, die die Sicherheitsüberprüfung übersteht
Beginnen Sie mit dem Datenflussdiagramm. Dokumentieren Sie, wo Prüfungen ausgeführt werden, was die Datenbank verlässt, welches Dienstkonto sie ausführt und wo Ergebnisse gespeichert werden. Sicherheitsteams können einen spezifischen Fluss effektiver prüfen als das bloße Versprechen, dass ein Produkt „sicher“ ist.
Trennen Sie die Metrikberechnung von den Untersuchungsdaten. Zeilenanzahlen, Aktualitäts-Zeitstempel, Schema-Fingerabdrücke und aggregierte Qualitätsmetriken können für die Erkennung ausreichen. Stichproben auf Datensatzebene sollten optional, maskiert oder dort verboten sein, wo Richtlinien dies erfordern.
Nutzen Sie private Bereitstellungsgrenzen. Eine Private Cloud oder eine On-Premises-Installation kann innerhalb der VPC, des Cloud-Kontos oder des Rechenzentrums des Kunden laufen. Halten Sie Konnektoren, Scheduler, Metadaten-Stores und Benutzeroberflächen innerhalb genehmigter Netzwerkzonen.
Machen Sie Audit-Nachweise zum Teil des Designs. Speichern Sie Prüfdefinitionen, Ausführungszeiten, beobachtete Ergebnisse, Bestätigungen, Zuständigkeitsänderungen und die Historie der Fehlerbehebung. Auditoren müssen in der Regel nachvollziehen können, was geprüft wurde, wann es lief, was geschah und wer reagiert hat.
Teams sollten auch Entscheidungen zur Datenresidenz explizit dokumentieren. Der data residency requirements guide ist eine nützliche Referenz bei der Entscheidung, welche Metadaten regionale oder organisatorische Grenzen überschreiten dürfen.
Heterogene Landschaften benötigen einen gemeinsamen Vertrag
Historisch gewachsene Datenbanken, Warehouse-Plattformen, Lake-Storage, Kafka-Topics und Transformations-Tools stellen selten identische Metadaten bereit. Standardisieren Sie die Observability-Ausgabe, anstatt jede Quelle in dieselbe Instrumentierungsmethode zu zwingen. Jede Integration sollte die Identität des Assets, die Aktualisierungszeit, das Volumen- oder Vollständigkeitsergebnis, den Schemastatus, den Prüfstatus, den Eigentümer und Lineage-Referenzen bereitstellen.
Dienstkonten mit minimalen Rechten, Lesezugriff wo immer möglich, maskierte Identifikatoren und separate Anmeldeinformationen pro Umgebung reduzieren den Schadensradius des Monitoring-Systems selbst. Testen Sie die Bereitstellung vor dem produktiven Rollout in Backup-, Failover- und Offline-Netzwerkszenarien.
Der Kompromiss ist real. In-Database-Prüfungen können Warehouse-Ressourcen verbrauchen, während externes Scannen das Onboarding vereinfacht, aber Reibung bei der Governance erzeugen kann. Messen Sie Abfragekosten, verlegen Sie rechenintensive Profilierungen außerhalb der Spitzenlastzeiten und nutzen Sie kontinuierlich leichtgewichtige Metadatenprüfungen mit einer tieferen Validierung für kritische Systeme.
Die Wahl der richtigen Alarmierungsstrategie für Ihren Data Stack
Die Alarmierungsstrategie sollte sich nach dem Datenverhalten richten, nicht nach Trends bei Tools. Statische Schwellenwerte sind leicht zu erklären und zu prüfen. Statistische Baselines passen sich an normale Schwankungen an. Machine Learning kann die manuelle Regelerstellung reduzieren, führt jedoch zu Modellverhalten, das Compliance- und Plattformteams möglicherweise prüfen möchten. Eine deterministische Validierung bleibt überall dort unerlässlich, wo eine Geschäftsregel exakt durchgesetzt werden muss.
Strategie | Bestens geeignet für | Einschränkungen | Komplexität der Implementierung |
|---|---|---|---|
Statische Schwellenwerte | Vorhersagbare Zeilenanzahlen, harte Limits, vertraglich vereinbarte Lieferfenster | Scheitern bei Saisonalität, Wachstum und schleichender Veränderung | Niedrig |
Statistische Baselines | Datensatzspezifisches Volumen, Aktualität und Verteilungsverhalten | Benötigen ausreichend historischen Kontext und sorgfältige Abstimmung | Mittel |
Machine Learning Anomalieerkennung | Komplexe Muster, sich änderndes Verhalten und breite Abdeckung | Erfordert Erklärbarkeit, governance und Überprüfung von Fehlalarmen | Mittel bis hoch |
Deterministische Datensatzvalidierung | Regulatorische Kontrollen, Geschäftsregeln und exakte Anforderungen auf Zeilenebene | Kann unbekannte Muster ohne definierte Regeln nicht identifizieren | Mittel |
Wann einfache Regeln gewinnen
Nutzen Sie eine statische Regel, wenn die Fehlerbedingung eindeutig ist. Eine erforderliche Partition, die nicht eingetroffen ist, ein unzulässiger Datentyp oder ein Feld, das eine definierte geschäftliche Einschränkung erfüllen muss, sollte ein deterministisches Ergebnis liefern. Diese Prüfungen sind einfacher zu testen, Auditoren zu erklären und bei der Untersuchung von Vorfällen zu rekonstruieren.
Statische Schwellenwerte eignen sich auch gut für stabile Feeds mit hohem Volumen und klaren operativen Limits. Sie werden jedoch anfällig, wenn sich das normale Verhalten nach Stunde, Saison, Kundensegment oder Produktlebenszyklus ändert. Ein einziger globaler Schwellenwert führt oft zu Fehlalarmen bei legitimen Spitzen und übersieht eine langsame Verschlechterung.
Wann adaptive Methoden helfen
Statistische Baselines sind nützlich, wenn jeder Datensatz seinen eigenen Rhythmus hat. Vergleichen Sie Ähnliches mit Ähnlichem, wie etwa dieselbe Stunde oder dasselbe Lieferfenster, und bewahren Sie den historischen Kontext, der zum Alarm geführt hat. Machine Learning kann diesen Ansatz auf viele Datenbestände ausweiten, aber Ingenieure sollten dennoch einen Ursachencode, eine Visualisierung des Basiswerts und einen Override-Prozess einfordern.
Das solideste Design kombiniert verschiedene Methoden. Nutzen Sie die Anomalieerkennung für eine breite Abdeckung von Aktualität, Volumen und Verteilungen. Fügen Sie deterministische Prüfungen für regulatorische Felder, vertragliche Anforderungen und geschäftskritische Datensatzlogik hinzu. Leiten Sie beide über denselben Vorfalls-Workflow, damit sich Teams nicht mit separaten Alarmsystemen auseinandersetzen müssen.
Eine Monitoring- und Berichtsschicht sollte nicht nur aufzeigen, ob eine Prüfung fehlgeschlagen ist, sondern auch deren Trend, Eigentümer, Schweregrad und Relevanz für nachgelagerte Systeme darstellen. Die digna's monitoring and reporting capabilities sind ein Beispiel für dieses kombinierte Betriebsmodell, neben Tools, die auf dbt-Tests, Warehouse-Assertions oder benutzerdefinierten Orchestrierungsprüfungen basieren.
Integration von Observability in Ihre bestehende Pipeline-Architektur
Observability sollte keinen Neuaufbau erfordern. Das sicherste Muster fügt Messungen an bereits bestehenden Grenzen hinzu und sendet die Ergebnisse an einen gemeinsamen Vorfalls- und Metadaten-Workflow, ohne jede Aufgabe bei jeder Prüfung zu blockieren.

Geben Sie in Airflow Ausführungs- und Abschlussmetadaten aus DAG-Tasks aus und führen Sie Aktualitäts- und Vollständigkeitsprüfungen durch, nachdem die Zielpartition übermittelt wurde. Behalten Sie in dbt Testergebnisse und Modelllaufzeiten als erstklassige Observability-Ereignisse bei. Spark-Jobs können Eingabe- und Ausgabezahlen, die Anzahl abgewiesener Datensätze, Schema-Fingerabdrücke und Partitionsdetails veröffentlichen. Kafka-Consumer sollten Verzug, Verzögerungen bei der Ereigniszeit, Raten fehlerhafter Datensätze und das volumenbezogene Verhalten auf Topic-Ebene offenlegen.
Prüfungen dort platzieren, wo sie eine Frage beantworten
Nutzen Sie synchrone Prüfungen, wenn das Fortfahren ein inakzeptables Risiko für nachgelagerte Systeme darstellen würde. Eine Schemakonformitätsprüfung vor der Veröffentlichung eines gemeinsam genutzten Vertrags oder eine Vollständigkeitsprüfung vor der Freigabe eines regulatorischen Datensatzes kann die nächste Stufe berechtigterweise blockieren.
Nutzen Sie asynchrone Prüfungen für eine breitere Profilierung und Trendanalyse. Verteilungsmetriken, Spaltenstatistiken und historische Vergleiche können parallel zum kritischen Pfad laufen, sofern für den resultierenden Alarm ein klarer Eingrenzungsprozess existiert. Dies verhindert, dass jede analytische Prüfung zu einem Engpass in der Pipeline wird.
Der Umgang mit Schemata erfordert eine explizite Richtlinie. Klassifizieren Sie hinzugefügte Spalten, entfernte Spalten und Datentypänderungen als kompatibel, prüfpflichtig oder blockierend. Lassen Sie nicht automatisch jede additive Änderung fehlschlagen, aber akzeptieren Sie keine Änderung des Datentyps ohne Überprüfung, da dies die Interpretation der Werte durch nachgelagerte Konsumenten verändern kann.
Die Lineage sollte an den Transformationsgrenzen erfasst und nicht erst während eines Vorfalls rekonstruiert werden. Speichern Sie Quelle-Ziel-Beziehungen für Airflow-Aufgaben, dbt-Modelle, Spark-Transformationen und Streaming-Topics und verknüpfen Sie die Prüfungen direkt mit den beschriebenen Assets.
Designprinzip: Observability sollte den Betrieb der Pipeline erleichtern und nicht zu einer weiteren Abhängigkeit werden, die sie unnötig stoppen kann.
Nutzen Sie Observability-Ergebnisse schließlich zur Verbesserung der Architektur. Wiederholte Aktualitätsverzögerungen können auf ein überlastetes Extraktionsfenster hindeuten. Anhaltende Volumenanomalien weisen möglicherweise auf schwache Verträge mit Datenquellen hin. Ein Muster von Schema-Vorfällen rechtfertigt eventuell versionierte Schnittstellen anstelle von noch mehr Alarmen.
Klein anfangen und Ihre Observability-Implementierung skalieren
Alles am ersten Tag zu überwachen, führt zu einem Katalog von Prüfungen, noch bevor das Team weiß, welche Signale überhaupt von Bedeutung sind. Beginnen Sie mit einer einzigen kritischen Pipeline, vorzugsweise einem System, das Berichte für die Geschäftsführung, den Kundenservice, regulatorische Aufgaben oder ein Produktionsmodell speist. Priorisieren Sie Kandidaten nach geschäftlicher Auswirkung, Historie von Vorfällen, Tiefe der Abhängigkeiten und der Schwierigkeit, Fehler manuell zu erkennen.
Eine schrittweise Einführung lässt sich leichter rechtfertigen, da jede Phase betriebliche Belege liefert.
Tage 1–30: Kartieren Sie die ausgewählte Pipeline, identifizieren Sie Eigentümer und nachgelagerte Konsumenten, etablieren Sie SLIs für Aktualität, Job-Erfolg, Vollständigkeit und Schema und erfassen Sie den Basiswert.
Tage 31–60: Fügen Sie Verteilungs- oder Datensatzvalidierungen hinzu, wo die erste Phase Risiken aufzeigt. Passen Sie Warn- und kritische Schwellenwerte an, leiten Sie Alarme an die verantwortlichen Teams weiter und dokumentieren Sie den Reaktions-Workflow.
Tage 61–90: Analysieren Sie Vorfälle und Beinahe-Fehler, entfernen Sie störende Alarme, fügen Sie Lineage-Kontext hinzu, messen Sie die mittlere Zeit bis zur Erkennung und wählen Sie die nächste Pipeline basierend auf nachgewiesenen Risiken statt bloßem Enthusiasmus aus.
Messen Sie Ergebnisse, die technische Entscheidungen beeinflussen. Die mittlere Zeit bis zur Erkennung zeigt, ob das Team früher von Fehlern erfährt. Das Vorfallsvolumen und wiederkehrende Grundursachen zeigen, ob das Monitoring die operative Belastung verringert. Verhinderte nachgelagerte Fehler demonstrieren den Wert für Analysten, Compliance-Verantwortliche und Geschäftsinhaber.
Der Erfolg hängt auch von der Eigenverantwortung ab. Weisen Sie jedem kritischen Datensatz einen technischen Eigentümer zu, definieren Sie, wer einen Alarm bestätigen oder unterdrücken darf, und fordern Sie eine Begründung, wenn eine Prüfung deaktiviert wird. Überprüfen Sie Fehlalarme nach Vorfällen, nicht nur im Rahmen einer jährlichen Tool-Evaluierung.
digna kann dieses schrittweise Modell mit In-Database-Ausführung, Private-Cloud- oder On-Premises-Bereitstellung, Anomalieerkennung, Aktualitäts-Monitoring, Validierung auf Datensatzebene und Schema-Tracking unterstützen. Wenn Ihre Umgebung keine Produktionsdaten auf eine SaaS-Plattform übertragen darf, prüfen Sie, ob die Architektur diese Grenze wahrt und den Ingenieuren dennoch einen brauchbaren Kontext zu Vorfällen liefert.
Nutzen Sie die ersten 90 Tage, um eine geschäftskritische Pipeline zu instrumentieren, vertrauenswürdige Baselines zu etablieren und die Erkennungsqualität zu messen, bevor Sie die Abdeckung erweitern. Um einen In-Environment-Ansatz für Ihre Warehouses, Lakes und regulierten Datenflüsse zu evaluieren, besuchen Sie digna und entdecken Sie, wie sich die modulare Observability-Plattform in Ihre bestehende Architektur einfügt.
Häufig gestellte Fragen
Was fügt Observability dem Pipeline-Monitoring hinzu?
Die Inspektion der Daten selbst. Pipeline-Monitoring bleibt wichtig, weil es zeigt, ob Jobs liefen und die Infrastruktur hielt, doch es kann nicht sagen, dass ein Batch grün endete, während das gespeiste Dashboard bereits falsch ist.
Was sind die fünf Säulen?
Aktualität, Verteilung, Schema, Lineage und Volumen. Aktualität zeigt, ob Daten im erwarteten Zeitplan eintrafen, Volumen vergleicht die Menge mit normalem Verhalten, Schema verfolgt Spalten und Typen, Verteilung betrachtet Nullmuster, Wertebereiche und Eindeutigkeit, und Lineage verbindet einen Vorfall mit betroffenen Assets und Teams.
Wie unterscheidet sich Observability von Datenqualitätsregeln?
Sie lösen verwandte, aber verschiedene Probleme. Regeln kodieren Bedingungen, die jemand bereits aufschreiben konnte; Observability beschreibt Verhalten, das niemand vorab spezifiziert hat. Deshalb wird ein Team mit nur einem der beiden immer in dieselbe Richtung überrascht.
Wie sieht eine gescheiterte Pipeline aus, die nicht gescheitert ist?
Wie ein Orchestrierungs-Dashboard, das um 9:00 Uhr einen erfolgreichen Nachtjob zeigt, während die erzeugten Daten falsch sind. Die Pipeline ist im herkömmlichen Sinn nicht gescheitert, und genau deshalb meldete das Job-Status-Monitoring Erfolg.
Wo beginnt eine Engineerin?
Bei den Datensätzen, deren Verhalten sich im Nachhinein am schwersten rekonstruieren ließe. Sie zuerst zu instrumentieren liefert Lineage und Historie, die den nächsten Vorfall zu einer kurzen Untersuchung statt zu einer archäologischen Übung machen.


