Data Design Pattern: Leitfaden für moderne Teams
|
8
min. Lesezeit

Ihr Team hat ein Warehouse, eine Streaming-Pipeline und Dashboards, die sich bei derselben Kundenkennzahl widersprechen. Eine Analystin vertraut der Finanztabelle, ein anderer einem Abteilungs-Mart, und ein Dritter hat einen Filter ergänzt, damit der Bericht von gestern aufgeht. Das Problem ist nicht unbedingt die Datenbanktechnologie. Es liegt daran, dass sich niemand auf das Data Design Pattern geeinigt hat, also auf die Regeln, die bestimmen, wie Informationen strukturiert, gesteuert und nach dem Go-live geprüft werden.
Ein nützliches Muster leistet mehr, als ein ansprechendes Architekturdiagramm zu liefern. Es gibt Engineers einen wiederholbaren Weg, Daten zu erfassen, zusammengehörige Fakten zu verknüpfen, unterschiedliche Workloads zu bedienen und Fehler sichtbar zu machen, bevor Nutzer auf Basis falscher Informationen entscheiden. Die stärksten Muster machen außerdem Verantwortlichkeiten explizit, definieren zulässige Änderungen und bewahren Nachweise darüber, was das System zu einem bestimmten Zeitpunkt wusste.
Inhaltsverzeichnis
Was ein Data Design Pattern wirklich bedeutet
Teams greifen meist nach dem ersten schmerzhaften Streit zu einem Muster. Eine Pipeline funktioniert für eine Abteilung, dann braucht ein anderes Team dieselben Daten mit einer anderen Definition, einem anderen Lieferrhythmus oder einer anderen Historie. Engineers fangen an, Ausnahmen einzubauen. Analysten erstellen doppelte Transformationen. Am Ende hat die Organisation mehrere Antworten auf eine Frage, die eigentlich nur eine Antwort haben sollte.
Stellen Sie sich ein Data Design Pattern als Kochrezept vor. Das Rezept schreibt weder die Marke des Ofens noch die Farbe der Teller vor. Es legt die Zutaten fest, die Reihenfolge der Zubereitung, die Beziehungen zwischen den Komponenten und die Prüfungen, an denen der Koch erkennt, ob das Ergebnis serviert werden kann. Ein Datenmuster leistet dasselbe für Informationssysteme.

Struktur ist nur die erste Ebene
Ein Muster ist eine wiederverwendbare Antwort auf ein wiederkehrendes Designproblem. Es kann analytische Fakten und Dimensionen organisieren, jedes Geschäftsereignis bewahren, gemeinsame Definitionen zentralisieren oder Domänen erlauben, Datenprodukte nach gemeinsamen Standards zu veröffentlichen. Das Muster gibt einem Team ein Vokabular, um Entscheidungen zu treffen, bevor Implementierungsdetails die Oberhand gewinnen.
Ein Architekturdiagramm zeigt Komponenten und Verbindungen. Ein Muster geht weiter und erklärt, warum diese Komponenten existieren und wie sie sich bei Änderungen verhalten. Zwei Diagramme können ähnlich aussehen und dennoch zu sehr unterschiedlichen Ergebnissen führen, wenn eines Verantwortlichkeiten, Historie und Validierung definiert und das andere diese Fragen offenlässt.
Ein praxistaugliches Muster beantwortet drei Fragen:
Wie sind die Daten strukturiert? Bestimmen Sie Entitäten, Events, Beziehungen, Granularität, Schlüssel, Historie und Serving-Modelle.
Wie werden die Daten gesteuert? Legen Sie Verantwortlichkeiten, Benennung, fachliche Bedeutung, Zugriff, Lineage und Kompatibilitätsregeln fest.
Wie werden Fehler sichtbar? Definieren Sie Aktualitätserwartungen, Validierungsprüfungen, Schema-Monitoring, Anomalie-Schwellenwerte und Eskalation.
Faustregel: Wenn ein Muster nicht erklärt, was passiert, wenn ein Ladevorgang verspätet ist oder ein Feld seinen Typ ändert, ist es eine strukturelle Skizze und kein operatives Design.
Diese Unterscheidung ist wichtig, bevor Sie ein Warehouse, ein Lakehouse, einen Message Broker oder ein Orchestrierungstool auswählen. Technologie kann ein Muster umsetzen, aber sie kann nicht entscheiden, ob die Adresshistorie eines Kunden in einen unveränderlichen Event-Stream, in eine Tabelle mit dem aktuellen Zustand oder in beide gehört. Diese Entscheidung muss das Team zuerst treffen und dann konsequent umsetzen.
Wie Enterprise Data Warehousing die ersten Muster hervorbrachte
Ende der 1980er-Jahre versuchten Unternehmen, Informationen, die über operative Systeme verstreut waren, in etwas zu verwandeln, das Führungskräfte für Analysen nutzen konnten. Ein 1988 im IBM Systems Journal veröffentlichter Artikel verwendete den Begriff „business data warehouse“, ein wichtiger Meilenstein bei der Formalisierung der Idee, Informationen aus mehreren operativen Systemen für die Geschäftsanalyse zu integrieren. William Inmon entwickelte später das unternehmensorientierte Warehouse-Muster und veröffentlichte Building the Data Warehouse im Jahr 1992.
Nehmen wir eine Gesundheitsorganisation, die eine einfache Frage beantworten will: Wie viel hat jede Abteilung für eine Behandlungsepisode eines Patienten ausgegeben? Die Quellsysteme erfassen Termine, Abrechnungen, Zahlungen und Leistungserbringer womöglich getrennt. Nach Inmons Ansatz führt die Organisation zunächst detaillierte, historische, integrierte Daten in einem zentralen Enterprise Warehouse zusammen. Die Integrationsschicht reduziert widersprüchliche Definitionen, bevor nachgelagerte Teams themenspezifische Teilmengen erhalten. Inmons Muster nutzt in der Regel normalisierte relationale Strukturen, die Nachvollziehbarkeit unterstützen und Redundanz in der gemeinsamen Schicht verringern.
Dieser Ansatz behandelt das Warehouse als sorgfältig geführtes Bedeutungs-Hauptbuch der Organisation. Ein Finanzteam und ein Team aus dem klinischen Betrieb erhalten vielleicht weiterhin unterschiedliche Sichten, doch beide bauen auf denselben gesteuerten Grundlagen auf.
Ralph Kimballs dimensionaler Ansatz geht von einer anderen Frage aus: Welchen Geschäftsprozess müssen die Nutzer analysieren? Seine Methode, formalisiert in The Data Warehouse Toolkit, erstmals 1996 erschienen, machte Faktentabellen, Dimensionstabellen, Sternschemata und konforme Dimensionen populär. Das Team im Gesundheitswesen könnte eine Faktentabelle für Abrechnungen aufbauen, die mit den Dimensionen Patient, Leistungserbringer, Abteilung, Kostenträger und Zeit verknüpft ist. Analysten können den Geschäftsprozess direkt abfragen, ohne sich durch ein stark normalisiertes Unternehmensmodell zu arbeiten.
Die meisten Organisationen kombinieren beide Philosophien. Sie behalten eine kanonische oder integrierte Schicht für gemeinsame Bedeutung, Lineage und Governance und veröffentlichen dann dimensionale Marts für Reporting und KPI-Analysen. Dieser hybride Ansatz ist in modernen Enterprise-Data-Warehouse-Architekturen nach wie vor sichtbar, selbst wenn die zugrunde liegende Infrastruktur ein Cloud Warehouse oder Lakehouse ist.
Die bleibende Lehre ist einfach. Wo die Wahrheit liegt und wie sie konsumiert wird, sind zusammenhängende Entscheidungen, aber nicht dieselbe Entscheidung.
Dimensionale Modellierung in der Praxis
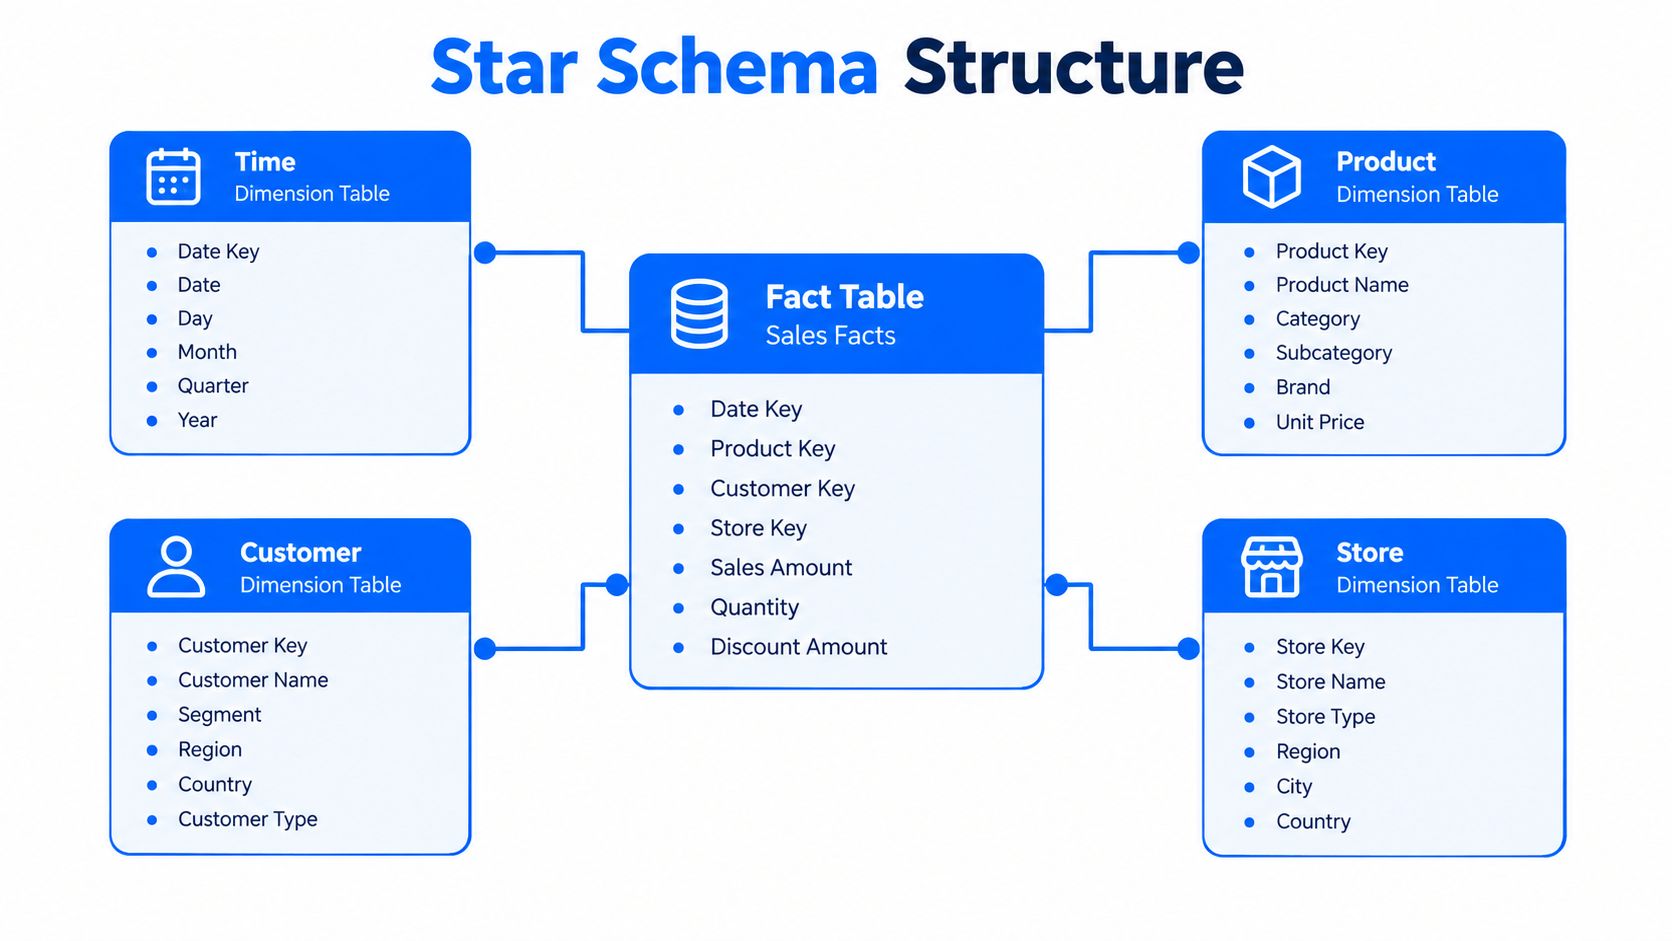
Ein Vertriebsteam fragt selten: „Kann ich Ihr normalisiertes relationales Modell erkunden?“ Es fragt: „Wie viel haben wir verkauft, an wen, über welche Filiale und in welchem Zeitraum?“ Dimensionale Modellierung funktioniert gut, weil sie Daten entlang genau dieser Geschäftsfragen organisiert.
Beginnen Sie mit einem messbaren Ereignis, etwa einer Auftragsposition. Die Faktentabelle speichert die numerischen und operativen Details des Ereignisses, darunter Menge, Umsatz, Rabatt, Bestellzeitpunkt, Produktschlüssel, Kundenschlüssel und Filialschlüssel. Die Dimensionstabellen liefern den beschreibenden Kontext, der jede Zeile nützlich macht. Das Produkt beschreibt den Artikel, der Kunde den Käufer, die Filiale den Standort, und die Zeit liefert Kalender- und Reporting-Attribute.
Die Granularität kommt vor den Spalten
Bevor Sie Felder hinzufügen, formulieren Sie die Granularität in einem Satz: „Eine Zeile steht für ein Produkt in einem Auftrag.“ Dieser Satz verhindert einen häufigen Fehler, nämlich Werte auf Auftrags- und auf Positionsebene in derselben Faktentabelle zu vermischen. Wird der Umsatz über mehrere Produktzeilen hinweg wiederholt, kann eine einfache Summe die Verkäufe überhöht ausweisen.
Eine konforme Dimension verwendet über alle Marts hinweg dieselbe fachliche Definition. Bedeutet die Kundendimension im Finanzbereich „Rechnungsempfänger“, in der Produktanalyse aber „Endnutzer“, erzeugt der gemeinsame Name eine Scheinkonsistenz. Teams müssen Bedeutung, Schlüssel, Historie und gültige Beziehungen definieren und diese Regeln dann jedem Konsumenten zur Verfügung stellen. Ein Leitfaden zu Fakten- und Dimensionstabellen kann Teams helfen, dieses Vokabular festzulegen, bevor sie Berichte erstellen.
Historische Genauigkeit erfordert eine weitere Designentscheidung. Angenommen, ein Kunde wechselt vom Segment Kleinunternehmen ins Segment Enterprise. Eine Dimension mit dem aktuellen Zustand zeigt das neueste Segment, ein historischer Umsatzbericht benötigt aber möglicherweise das Segment, das zum Zeitpunkt jeder Bestellung galt. Techniken für Slowly Changing Dimensions bewahren die passende Historie, je nachdem, ob das Unternehmen frühere Werte behalten, sie überschreiben oder Gültigkeitszeiträume erfassen möchte.
Wo sich das Muster bewährt
Dimensionale Modellierung zahlt sich aus, wenn sich die vorherrschenden Fragen darum drehen, wie viel, wie oft, wo, wann oder durch wen. Sternschemata sind für Analysten zugänglich, unterstützen vorhersehbare Joins und erleichtern es, KPI-Logik zu teilen. Ein stabiler Vertrag zwischen Fakten und Dimensionen gibt Qualitätsteams zudem klare Ansatzpunkte, um referenzielle Integrität, Null-Raten, doppelte Schlüssel und unerwartete Kennzahlen zu prüfen.
An seine Grenzen stößt das Muster, wenn der Workload von unregelmäßigen Dokumenten, großvolumigen unstrukturierten Events oder einer revisionssicheren Rekonstruktion jeder Zustandsänderung abhängt. Es kann solche Eingaben abbilden, doch wer jedes Problem in ein Sternschema zwängt, verdeckt oft die ursprüngliche Ereignishistorie. Viele ausgereifte Plattformen behalten daher Roh- oder kanonische Datensätze und stellen dimensionale Marts als Serving-Schicht bereit.
Event Sourcing und Append-only-Denken
Ein Kontostand wirkt wie ein Wert des aktuellen Zustands, doch die Abstimmung hängt von der Historie dahinter ab. Wird ein Saldo fehlerhaft geändert und speichert das System nur die letzte Zahl, haben Prüfer keine verlässliche Möglichkeit nachzuvollziehen, wie sie zustande kam.
Event Sourcing verfolgt den umgekehrten Ansatz. Statt eine Saldozeile direkt zu aktualisieren, erfasst das System Events wie eine Einzahlung, eine Abhebung, eine Überweisung oder eine Korrektur. Der aktuelle Saldo wird zu einer Projektion, die aus dieser geordneten Historie berechnet wird.

Von Events zu nutzbarem Zustand
Das Muster besteht aus drei praktischen Bestandteilen:
Append-only Event Store: Jede geschäftliche Änderung wird als neues Event erfasst. Bestehende Events werden nicht überschrieben.
Projektion: Ein Konsument liest Events und baut daraus eine abfragbare Darstellung auf, etwa den aktuellen Kontostand.
Replay und Korrektur: Ändert sich die Projektionslogik oder wird der Zustand beschädigt, kann das Team ihn aus der Ereignishistorie neu aufbauen.
Eine Korrektur löscht die ursprüngliche Transaktion nicht. Sie fügt ein kompensierendes Event hinzu, das die Chronologie bewahrt. Dadurch eignet sich das System für Audits, Debugging, historische Analysen und das Nachstellen von Vorfällen.
Das Lesemodell wird möglicherweise nicht im exakt selben Moment aktualisiert wie das Event-Log. Teams müssen daher Eventual Consistency akzeptieren und kommunizieren, wo sie zum Geschäftsprozess passt. Außerdem benötigen sie Event-Versionierung, idempotente Konsumenten, Reihenfolgeregeln, Aufbewahrungsentscheidungen und eine Strategie für Snapshots, wenn das Abspielen einer langen Historie zu teuer wird.
Wählen Sie es wegen der Nachvollziehbarkeit, nicht als Modetrend
Event Sourcing ist eine starke Grundlage, wenn das Unternehmen beantworten muss: „Was ist passiert, in welcher Reihenfolge, und warum sieht der aktuelle Zustand so aus?“ Finanz-Hauptbücher, Workflow-Historien, Lagerbewegungen und verteilte Domänen-Events sind naheliegende Kandidaten.
Als Standard für jede CRUD-Anwendung taugt es wenig. Lesezugriffe werden komplexer, weil Nutzer oft eine Projektion statt des Quell-Logs benötigen. Teams müssen Projektionscode pflegen und mit verzögerter Konvergenz umgehen. Eine herkömmliche Tabelle mit dem aktuellen Zustand kann klarer sein, wenn das Unternehmen nur den neuesten Wert braucht und keine rekonstruierbare Historie benötigt.
Lakehouse-Teams kombinieren eventorientierte Ingestion womöglich mit einem offenen Tabellenformat und materialisierten Serving-Modellen. Der Überblick über offene Tabellenformate liefert hilfreichen Kontext dazu, wie sich eine dauerhafte Datenhistorie von den Modellen trennen lässt, die Konsumenten abfragen.
Das Event-Log ist der Beweis. Die Projektion ist die bequeme Interpretation.
Kanonische Modelle versus Domänenverantwortung
Ein kanonisches Modell besagt, dass sich die Organisation in einer Integrationsschicht auf gemeinsame Definitionen einigen sollte. Ein domänenverantwortetes Modell besagt, dass das Team, das einer Geschäftsfähigkeit am nächsten ist, ein nutzbares Datenprodukt veröffentlichen und die Verantwortung für dessen Qualität übernehmen sollte.
Keine der beiden Positionen löst jedes Problem. Ein zentrales Modell kann widersprüchliche Definitionen verhindern, doch ein zentrales Team kann zur Warteschlange für jede Änderung werden. Ein Domänenmodell kann Entscheidungen näher an die Quelle bringen, doch getrennte Teams veröffentlichen womöglich unvereinbare Bedeutungen für „Kunde“, „aktives Konto“ oder „abgeschlossene Bestellung“.
Dimension | Kanonisches Modell | Data Mesh |
|---|---|---|
Verantwortung | Ein zentrales Daten- oder Integrationsteam betreut gemeinsame Definitionen | Domänenteams verantworten die Datenprodukte, die aus ihren Geschäftsfähigkeiten entstehen |
Governance | Einheitliche Unternehmensregeln lassen sich zentral leichter durchsetzen | Föderierte Standards koordinieren Teams, ohne den Domänen die Verantwortung zu nehmen |
Liefergeschwindigkeit | Domänenübergreifende Änderungen erfordern unter Umständen zentrale Prüfung und Abstimmung | Domänen können innerhalb gemeinsamer Interoperabilitätsregeln schneller iterieren |
Risiko | Das zentrale Team kann zum Engpass werden oder den Bezug zum Quellkontext verlieren | Definitionen, Qualität und Schnittstellen können ohne starke Verträge auseinanderlaufen |
Das Argument für das kanonische Modell
Kanonische Modelle eignen sich für Organisationen, die ein gemeinsames regulatorisches Vokabular, gemeinsame Finanzkontrollen oder abteilungsübergreifende Nachvollziehbarkeit benötigen. Die Integrationsschicht wirkt wie ein Wörterbuch. Sie löst Unterschiede zwischen Quellsystemen auf, bevor Analysten und Anwendungen die Daten nutzen.
Der Preis ist der Koordinationsaufwand. Ein zentrales Team muss viele Domänen verstehen, Änderungsanträge verwalten und das Modell relevant halten, während sich das Geschäft weiterentwickelt. Wird es zur einzigen Gruppe, die nützliche Daten veröffentlichen darf, verlangsamt sich die Lieferung, und Fachexperten der Domänen verlieren ihre Verantwortung.
Das Argument für Domänen
Data Mesh weist die Verantwortung Domänen wie Abrechnung, Logistik oder Kundensupport zu. Jede Domäne veröffentlicht Daten als Produkt, mit Dokumentation, Qualitätserwartungen, Zugriffskontrollen und einer Servicezusage. Eine föderierte Governance-Schicht legt weiterhin gemeinsame Regeln für Interoperabilität, Sicherheit und Auffindbarkeit fest.
Das funktioniert nur, wenn Domänenteams die Fähigkeiten und Kapazitäten haben, Datenprodukte zu betreiben. Die Organisation muss gemeinsame Werkzeuge bereitstellen und Verträge durchsetzen, sonst wird Dezentralisierung zu doppelten Pipelines mit unterschiedlichen Annahmen. Teams, die entlang von Domänengrenzen arbeiten, profitieren womöglich auch von diesem Leitfaden zur Modellierung von Aggregaten für SaaS, insbesondere wenn geschäftliche Verantwortung und Systemgrenzen in Einklang gebracht werden müssen.
Ein praktikabler Kompromiss behält eine kanonische Schicht für risikoreiche gemeinsame Konzepte bei und lässt Domänen darum herum spezialisierte Produkte veröffentlichen. Föderierte Data Governance kann diese Balance unterstützen, indem sie festlegt, was überall einheitlich sein muss und was Domänen lokal anpassen dürfen.
Die drei Kernmuster im direkten Vergleich
Die drei Muster lösen unterschiedliche Hauptprobleme. Dimensionale Modellierung optimiert die analytische Navigation. Event Sourcing bewahrt eine Abfolge von Änderungen. Kanonische Modellierung schafft eine gemeinsame Bedeutung über Systeme und Teams hinweg.
Ihre Unterschiede werden deutlicher, wenn Sie sie am Workload messen statt an persönlichen Vorlieben.
Kriterium | Dimensionale Modellierung | Event Sourcing | Kanonisches Modell |
|---|---|---|---|
Abfrageperformance | Stark bei wiederkehrenden BI-Abfragen und Aggregationen | Erfordert oft Projektionen oder Snapshots für bequeme Lesezugriffe | Hängt von der Serving-Schicht ab, normalisierte Strukturen benötigen eventuell nachgelagerte Modelle |
Eignung für Governance | Klare Verträge für Kennzahlen und Dimensionen | Starke Historie und Nachvollziehbarkeit, bei mehr Disziplin im Event-Management | Am stärksten bei zentralen Definitionen, Lineage und regulierten gemeinsamen Daten |
KI-Tauglichkeit | Nützlich für kuratierte Features und klar benannte Geschäftskennzahlen | Wertvoll für Replay, zeitliche Features und Verhaltenshistorien | Nützlich für konsistente Features und gemeinsame Semantik über Domänen hinweg |
Betriebskosten | Moderat, mit Aufwand für Modellierung und die Pflege historischer Dimensionen | Höher, weil Logs, Projektionen, Versionierung und Replay betrieben werden müssen | Höhere Koordinationskosten, insbesondere wenn viele Domänen von zentralen Änderungen abhängen |
Beste Einstiegsfrage | „Was sollen Nutzer aggregieren und vergleichen?“ | „Welche Abfolge hat diesen Zustand erzeugt?“ | „Welche Definition muss jedes System teilen?“ |
Die Tabelle kürt keinen universellen Sieger, weil eine reale Plattform oft alle drei braucht. Eine kanonische Schicht kann gemeinsame Definitionen für Kunden, Produkte und Finanzen festlegen. Dimensionale Marts können diese Definitionen in zugängliche Reporting-Modelle überführen. Event-Logs können die Nachweise bewahren, die nötig sind, um wichtige Änderungen erneut abzuspielen oder zu prüfen.
Den dominanten Workload bestimmen
Fragen Sie das Team, welcher Fehler am meisten schmerzen würde:
Ein langsamer oder verwirrender Bericht: Beginnen Sie mit dimensionaler Modellierung und definieren Sie die Granularität jeder Faktentabelle.
Eine nicht nachvollziehbare Zustandsänderung: Bewahren Sie Events und bauen Sie Projektionen aus der Append-only-Historie auf.
Widersprüchliche Unternehmensdefinitionen: Etablieren Sie kanonische Konzepte, Verantwortlichkeiten und Änderungskontrolle.
KI-Eingaben, die unbemerkt driften: Ergänzen Sie das gewählte strukturelle Muster um Verhaltensmonitoring und klare Verantwortung.
KI-Tauglichkeit ist nicht nur eine Frage der Speicherung. Embeddings, Feature-Verteilungen, Retrieval-Ergebnisse und die Aktualität von Modelleingaben können sich ändern, während das Tabellenschema gültig bleibt. Ein Muster, das nur Spalten steuert, kann semantische Fehler übersehen.
Warum ein sauberes Diagramm nicht ausreicht
Ein Whiteboard kann einen eleganten Fluss von Quellsystemen über ein Warehouse und einen Mart bis zu einem Dashboard und einem Modell zeigen. Es kann aber nicht zeigen, wer die Warnung erhält, wenn die gestrige Datei verspätet eintrifft, welche Regel einen Abrechnungsbetrag validiert oder wie ein Prüfer belegt, dass ein Bericht zu einem historischen Zeitpunkt die richtigen Daten verwendet hat.
Diese Lücke macht Architektur zum operativen Risiko. Ein verlässliches Muster definiert das erwartete Lieferverhalten, den Ort der Validierung, die Verantwortung, die Kompatibilitätsrichtlinie und die Nachweise, die nach jedem wichtigen Ladevorgang aufbewahrt werden.
Vertrauenskontrollen direkt neben die Datenbewegung setzen
Ein Team, das ein Muster wählt, sollte an drei Stellen Kontrollen festlegen:
Ingestion: Prüfen Sie Eingang, Volumen, Grundstruktur, Duplikate und Pflichtfelder.
Transformation: Validieren Sie Geschäftsregeln, Beziehungen, zulässige Werte und Abstimmungslogik.
Nutzung: Überwachen Sie das KPI-Verhalten, die für Nutzer sichtbare Aktualität, nachgelagerte Fehler und die Eignung der Modelleingaben.
Die Schema-Evolution verdient dieselbe Behandlung. Zusätzliche Nullable-Felder können mit bestehenden Konsumenten kompatibel sein, während eine Typverengung oder eine semantische Umbenennung sie brechen kann. Partitionslayouts sollten nach Möglichkeit ein Implementierungsdetail bleiben, damit Konsumenten logische Tabellen statt fest codierter Verzeichnispfade abfragen. Metadatengesteuerte Evolution, wie sie in den Designrichtlinien von Apache Iceberg dokumentiert ist, erlaubt es, physische Layouts zu ändern, während historische Dateien ihre ursprünglichen Spezifikationen behalten.
Nachweise verändern den Maßstab
Mehr als 56 % der Befragten einer Analytics-Engineering-Umfrage nannten Datenqualität als die am häufigsten genannte Herausforderung, während 38 % planten, im folgenden Jahr mehr in Datenqualität oder Observability zu investieren, so der State of Analytics Engineering 2025 von dbt. Diese Zahlen stützen eine praktische Schlussfolgerung: Governance und Observability gehören in das Muster, nicht in einen späteren Betriebs-Backlog.
Ein vertrauenswürdiges Design macht schlechte Daten leichter auffindbar, erklärbar, eingrenzbar und korrigierbar.
Halten Sie für jeden kritischen Datensatz den Verantwortlichen, das erwartete Lieferverhalten, die Schemaversion, die Validierungsergebnisse, die Lineage und die Vorfallhistorie fest. Legen Sie dann fest, was passiert, wenn eine Prüfung fehlschlägt. Stoppt die Pipeline, werden Datensätze in Quarantäne verschoben, wird eine Warnung veröffentlicht, oder läuft sie mit einem ausdrücklich eingeschränkten Status weiter? Die richtige Antwort hängt von den geschäftlichen Auswirkungen ab, doch wer die Antwort offenlässt, garantiert uneinheitliche Reaktionen.
Ihr Muster auswählen und operationalisieren
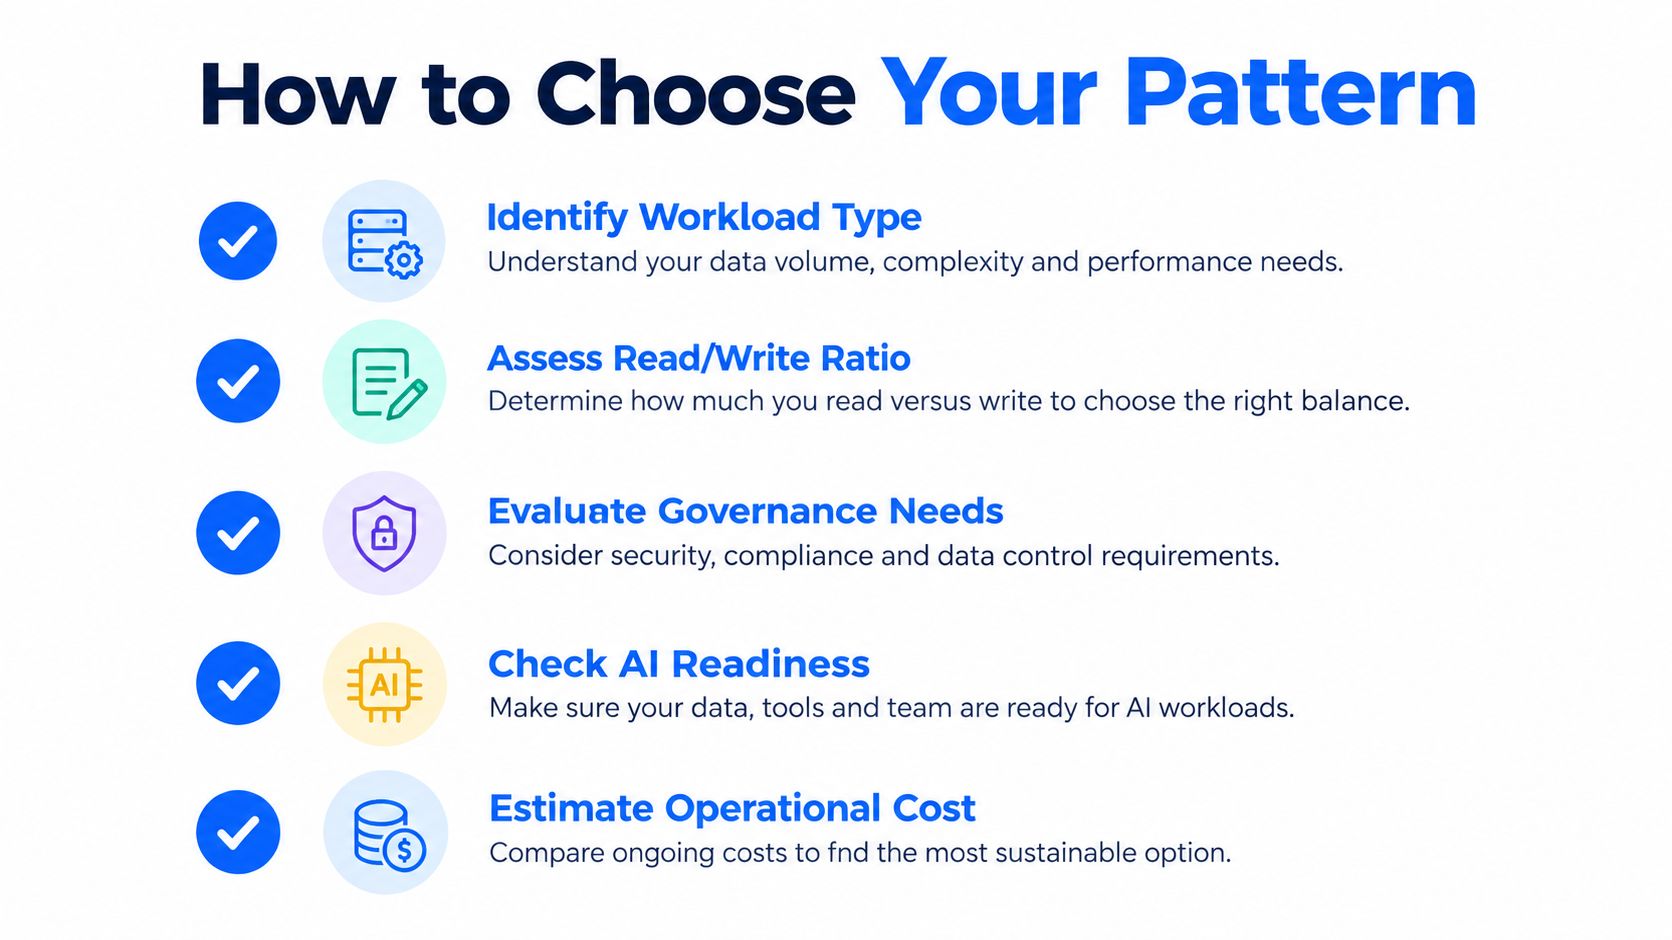
Führen Sie ein kurzes Design-Review durch und halten Sie fünf Entscheidungen schriftlich fest:
Bestimmen Sie den dominanten Workload. Reporting, Audit, operatives Serving, Echtzeitreaktion und die Generierung von KI-Features erfordern unterschiedliche Strukturen.
Wählen Sie das primäre Muster. Entscheiden Sie sich für das Modell, das das wichtigste Problem löst, und ergänzen Sie unterstützende Schichten dann gezielt.
Definieren Sie Verträge. Legen Sie Granularität, Schlüssel, Bedeutungen, Aktualitätserwartungen, Schemakompatibilität und Verantwortung fest.
Verknüpfen Sie Kontrollen. Ergänzen Sie Eingangsmonitoring, Datensatzvalidierung, Anomalieerkennung, Warnungen bei Schema-Drift, Lineage und historische Nachweise.
Testen Sie das Fehlerverhalten. Simulieren Sie verspätete Daten, unerwartete Werte, strukturelle Änderungen, doppelte Events und den Neuaufbau von Projektionen.
Erweitern Sie die Checkliste für KI-Workloads über Spalten hinaus. Legen Sie fest, wie das Team Embedding-Drift, Veränderungen von Feature-Verteilungen, nachlassende Retrieval-Qualität und veraltete Modelleingaben erkennt. Eine technisch gültige Tabelle kann dennoch ein unzuverlässiges Modell hervorbringen, wenn sich ihr Verhalten ändert, ohne dass jemand dafür verantwortlich ist.
Eine Plattform wie der Ansatz von digna für Data Product Management kann sich in diese operative Schicht einfügen, indem sie In-Database-Validierung, Aktualitätsüberwachung, Anomalieerkennung und die Verfolgung von Schemaänderungen in der Umgebung des Kunden kombiniert. Entscheidend ist nicht das Tool allein. Entscheidend ist, ob das Muster benannten Personen genug Nachweise liefert, um zu handeln, wenn sich die Daten nicht mehr wie erwartet verhalten.
digna hilft Teams, das Verhalten ihrer Daten in der eigenen Umgebung zu überwachen, durch In-Database-Validierung, Aktualitätsüberwachung, Anomalieerkennung und die Verfolgung von Schemaänderungen. Wenn Sie ein statisches Architekturdiagramm in einen operativen Vertrauensvertrag verwandeln möchten, besuchen Sie digna und erfahren Sie, wie die Plattform diese Arbeit unterstützen kann.
Da eine Typverengung oder eine semantische Umbenennung Konsumenten brechen kann, während jede Pipeline weiterläuft, erfasst der Schema Tracker von digna strukturelle Änderungen in überwachten Tabellen, sodass hinter der Kompatibilitätsrichtlinie Ihres Musters eine Warnung steht.
Häufig gestellte Fragen
Was ist ein Data Design Pattern?
Ein Data Design Pattern ist eine wiederverwendbare Antwort auf ein wiederkehrendes Datenproblem und deckt drei Dinge ab: wie Daten strukturiert sind, wie sie gesteuert werden und wie Fehler sichtbar werden. Wie ein Rezept legt es Zutaten, Reihenfolge und Prüfungen fest, nicht die Marke des Ofens, und lenkt so Entscheidungen, bevor Sie ein Warehouse oder Tool auswählen.
Was ist der Unterschied zwischen dem Ansatz von Inmon und dem von Kimball?
Inmon beginnt mit einem zentralen, normalisierten Enterprise Warehouse, das detaillierte Historie integriert, bevor Teams themenspezifische Teilmengen erhalten. Kimball geht vom Geschäftsprozess aus und baut Faktentabellen, Dimensionstabellen und Sternschemata für die direkte Analyse auf. Die meisten Organisationen kombinieren beides: Sie behalten eine integrierte Schicht für gemeinsame Bedeutung und veröffentlichen dimensionale Marts für das Reporting.
Warum sollte man zuerst die Granularität einer Faktentabelle festlegen?
Die Granularität festzulegen, etwa eine Zeile pro Produkt in einem Auftrag, verhindert, dass Werte auf Auftrags- und Positionsebene in derselben Tabelle vermischt werden. Ohne sie wird ein über mehrere Produktzeilen wiederholter Umsatz mehrfach summiert und die Verkäufe werden zu hoch ausgewiesen. Der Satz zur Granularität sollte formuliert werden, bevor Spalten hinzugefügt werden.
Wann sollte man Event Sourcing statt einer Tabelle mit dem aktuellen Zustand verwenden?
Setzen Sie Event Sourcing ein, wenn das Unternehmen erklären muss, was passiert ist, in welcher Reihenfolge und warum der aktuelle Zustand so aussieht. Finanz-Hauptbücher, Workflow-Historien und Lagerbewegungen passen gut. Für CRUD-Anwendungen, die nur den neuesten Wert benötigen, ist eine einfache Tabelle klarer, da Projektionen und Eventual Consistency echte Betriebskosten verursachen.
Sollte eine Datenplattform ein kanonisches Modell oder Data Mesh verwenden?
Oft beides. Ein praktikabler Kompromiss behält eine kanonische Schicht für risikoreiche gemeinsame Konzepte wie Kunden-, Produkt- und Finanzdefinitionen bei, während Domänenteams darum herum spezialisierte Datenprodukte veröffentlichen. Föderierte Governance entscheidet dann, was überall einheitlich sein muss und was Domänen lokal anpassen dürfen, und vermeidet so sowohl einen zentralen Engpass als auch auseinanderlaufende Definitionen.


