9 Arten der Anomalieerkennung erklärt
|
10
min. Lesezeit

Die meisten Ratschläge zur Anomalieerkennung beginnen mit Algorithmen. Das ist verkehrt herum. Anomalieerkennung beginnt mit der richtigen Definition von normal.
Keine einzelne Methode passt zu jedem Datensatz, denn Anomalien treten in verschiedenen Formen auf. Eine Punktanomalie ist ein einzelner auffälliger Wert, etwa eine plötzliche Spitze bei fehlgeschlagenen Zahlungen. Eine kontextuelle Anomalie wirkt nur im Kontext falsch, etwa ein normal aussehendes Transaktionsvolumen zur falschen Stunde. Eine kollektive Anomalie ist ein Muster über mehrere Datensätze oder Zeitschritte hinweg, etwa ein verspäteter Batch mit anschließendem Nachholschub. In der Praxis müssen Teams außerdem univariate von multivariaten Problemen trennen, denn eine einzelne Spalte, die sich seltsam verhält, ist etwas ganz anderes als mehrere Felder, die gemeinsam driften.
Diese Unterscheidung hat tiefe Wurzeln. Ein neuerer historischer Überblick verfolgt frühes Anomaliedenken in Zeitreihen zurück zu Bernoulli im Jahr 1777, dann zu Fox' Unterscheidung von Anomalietypen 1972 und Tsays Erweiterung 1988, während die moderne Praxis sich weiterhin auf Punkt-, kontextuelle und kollektive Anomalien als Kernkategorien stützt (historischer Überblick zur Anomalieerkennung in Zeitreihen). Das ist noch immer der richtige Ausgangspunkt, um zwischen den wichtigsten Arten der Anomalieerkennung zu wählen.
Eine praktische Regel funktioniert besser als ein universelles Rezept. Nutzen Sie deterministische Validierung für bekannte Bedingungen. Nutzen Sie statistische oder Zeitreihenmethoden, wenn Verhalten messbar und wiederkehrend ist. Nutzen Sie maschinelles Lernen, wenn Muster komplex, multivariat oder zu schnell veränderlich für statische Logik sind. Plattformen wie digna verbinden statistische Methoden, maschinelles Lernen, Validierung, Timeliness und Schemaüberwachung innerhalb der Kundeninfrastruktur, wenn dieses Betriebsmodell zählt.
Inhaltsverzeichnis
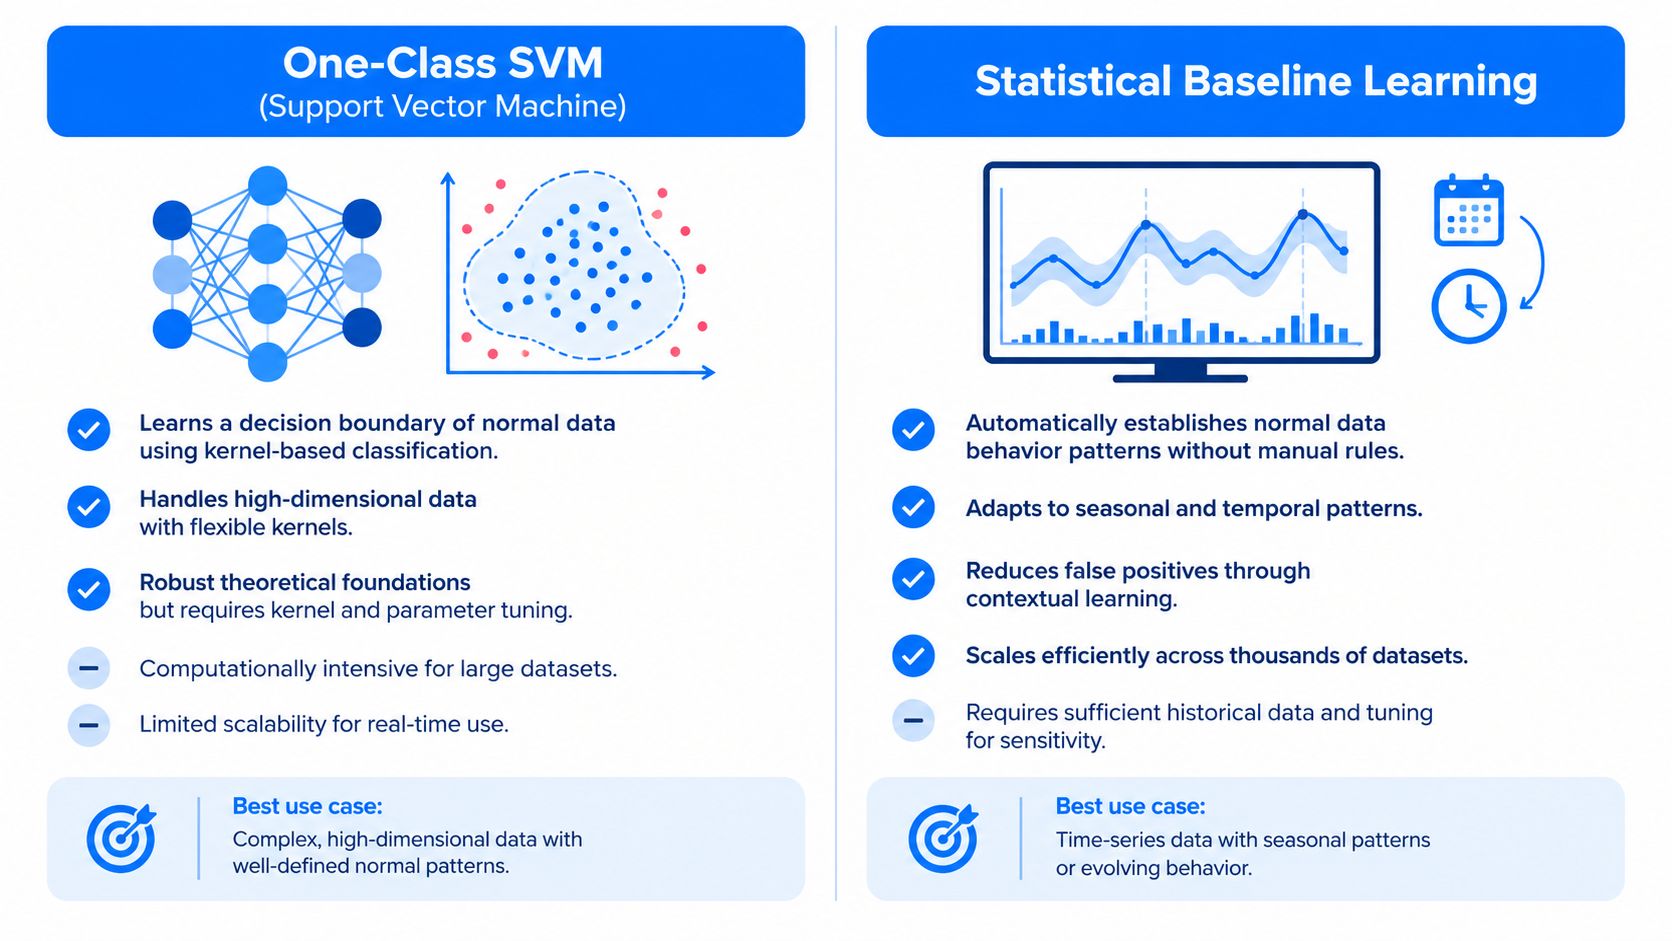
1. Statistisches Lernen von Basislinien
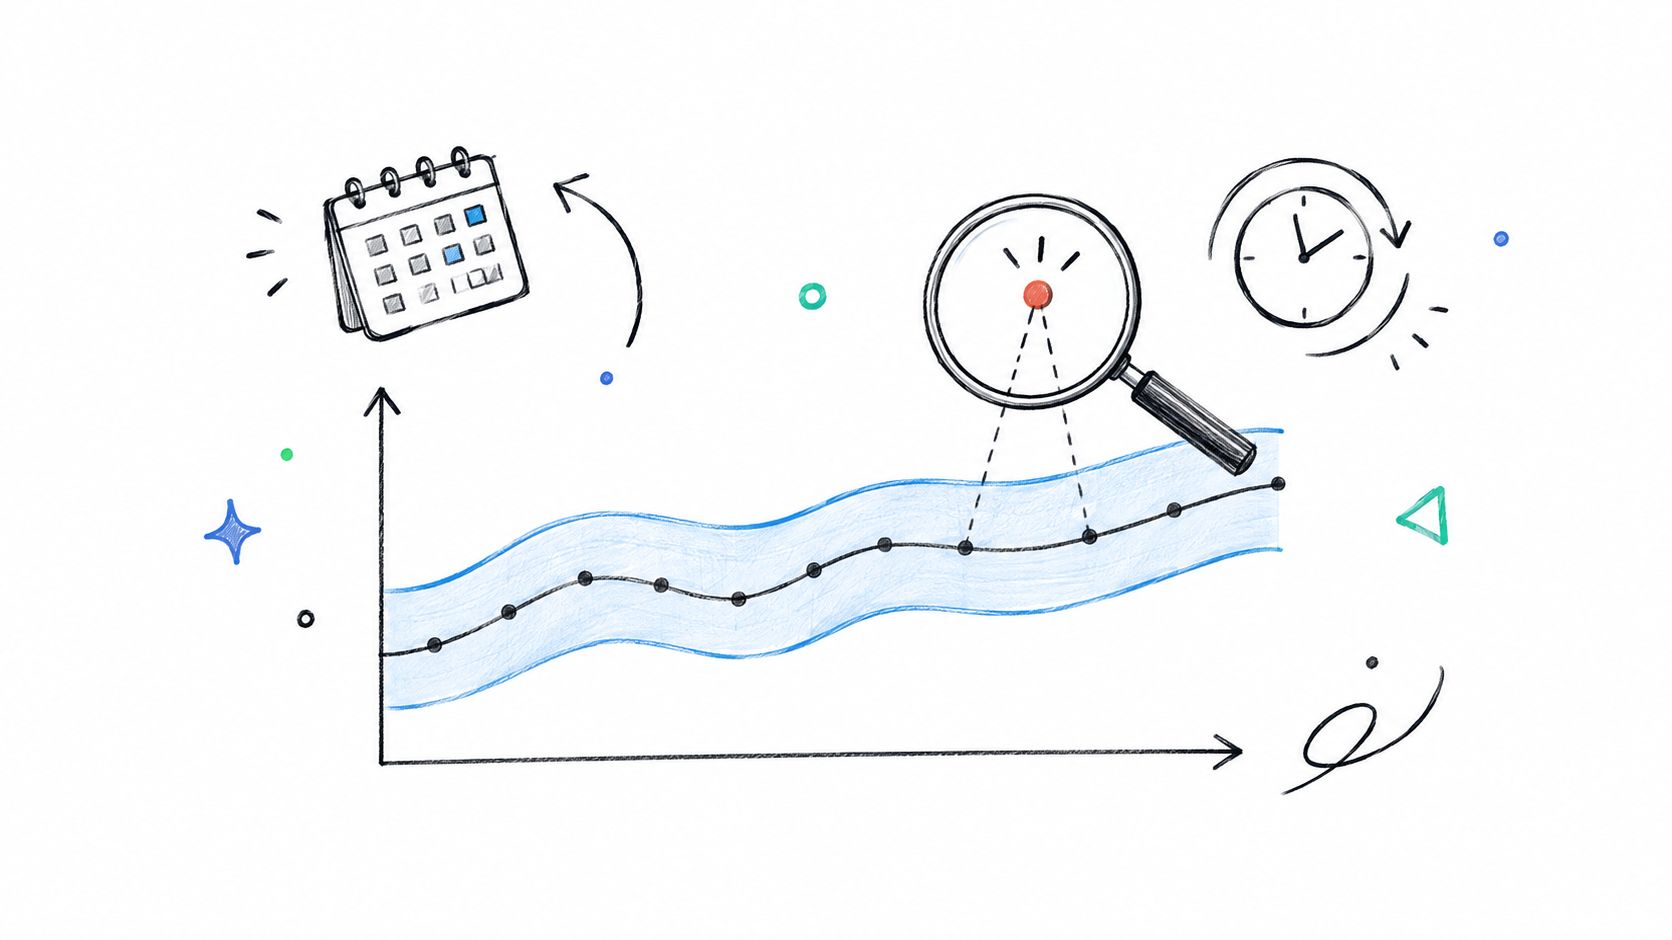
Manche Teams nennen das „KI-Anomalieerkennung“, doch die nützliche Idee ist einfacher. Das System lernt aus der Historie, wie normales Verhalten aussieht, und meldet Abweichungen von dieser Basislinie.
Diese Methode wirkt am besten, wenn eine Kennzahl über die Zeit erkennbares Verhalten zeigt. Transaktionszahlen mögen unter der Woche steigen und am Wochenende fallen. Schadensdaten treffen womöglich in vorhersehbaren Wellen ein. Support-Ereignisse springen vielleicht jeden Morgen hoch und stabilisieren sich dann. Ein Basislinienmodell kann diese Muster besser aufnehmen als eine starre Schwelle.
Hier die visuelle Intuition.
Welche Nachweise es nutzt
Das Lernen von Basislinien stützt sich auf beobachtetes statistisches Verhalten über die Zeit. Statt zu fragen „hat dieser Wert eine feste Grenze überschritten“, fragt es „ist dieser Wert für diesen Datensatz, zu dieser Zeit, unter diesem jüngsten Muster ungewöhnlich“.
Damit passt es gut zu Data Observability. Ein Finanzteam beobachtet vielleicht das tägliche Transaktionsvolumen. Ein Betriebsteam im Gesundheitswesen überwacht vielleicht Aufnahmefeeds. Eine Telekom-Datenplattform verfolgt vielleicht verspätet eintreffende Nutzungsdatensätze. In jedem Fall lernt das Modell erwartete Bereiche, Trends und wiederkehrende Schwankungen.
Ein nützliches Hintergrundkonzept ist die Verteilung von Daten in der Anomalieanalyse. Teams, die Streuung, Schiefe und erwartete Variation verstehen, stimmen Basislinien meist wirksamer ab.
Praktische Regel: Koppeln Sie das Lernen von Basislinien bei risikoreichen Datensätzen mit deterministischen Prüfungen. Gelerntes Verhalten fängt Drift. Regeln fangen bekannte Verstöße.
Wo es hilft und wo es schwächelt
Es hilft, wenn „normal“ sich über die Zeit ändert, aber weiterhin einem Muster folgt. Es schwächelt, wenn Sie zu wenig Historie haben, wenn sich der Prozess letzte Woche geändert hat oder wenn die Kennzahl vor allem Rauschen ist.
Beispiele:
Finanzwesen: unerwartete Drift im Transaktionsvolumen, obwohl keine Schwelle überschritten wurde
Gesundheitswesen: ungewöhnliche Verschiebungen der Patientenaktivität über Einrichtungen hinweg
Telekommunikation: auffällige Ankunftsraten von Daten in Ingestion-Pipelines
Häufige Abwägungen:
Stark bei der Erklärbarkeit: Teams sehen meist das erwartete Band und können erklären, warum ein Alarm ausgelöst wurde
Empfindlich gegenüber schlechten Trainingsfenstern: Vorfallszeiträume können die Basislinie verunreinigen
Besser mit stützenden Kontrollen: Validierungs- und Timeliness-Prüfungen erhöhen das Vertrauen
2. Isolation Forest
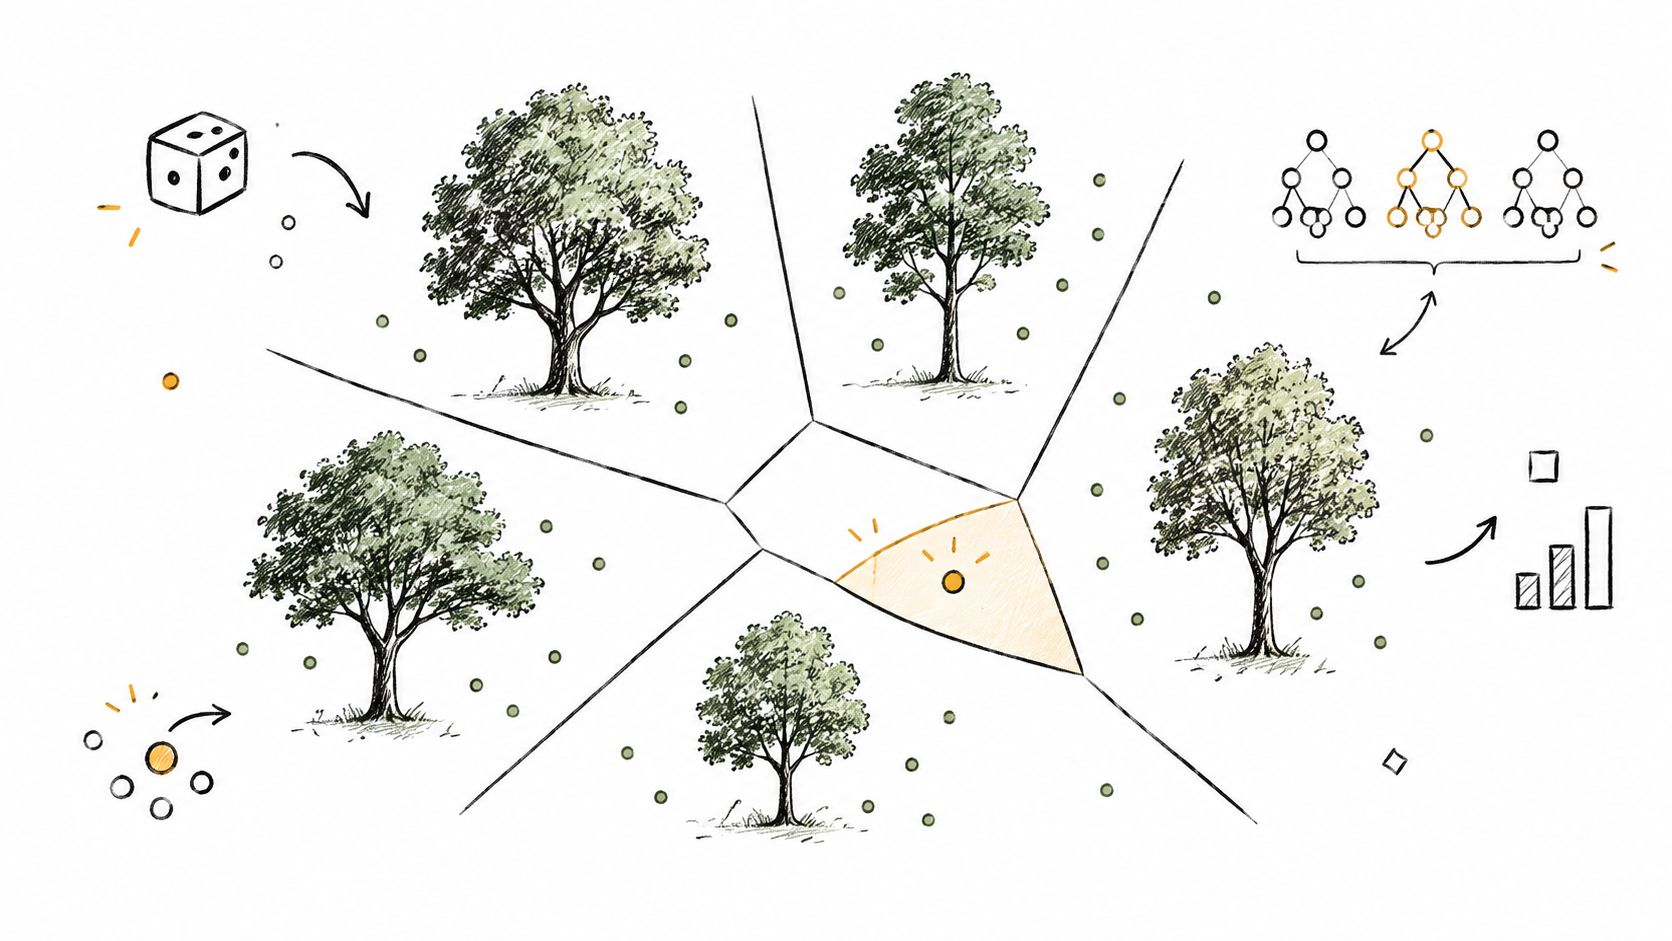
Isolation Forest ist eine Methode des maschinellen Lernens, die nur so lange seltsam wirkt, bis man sich vorstellt, was sie tut. Sie teilt die Daten immer wieder zufällig in kleinere Bereiche. Punkte, die schnell isoliert werden, sind eher Anomalien.
Dieser Ansatz macht sie für hochdimensionale Daten nützlich. Wenn Sie viele Merkmale gleichzeitig bewerten, können distanzbasierte Methoden unhandlich werden. Isolation Forest umgeht einen Teil dieser Komplexität, indem es sich darauf konzentriert, wie leicht ein Punkt vom Rest zu trennen ist.
Wie es in der Praxis funktioniert
Sie trainieren das Modell auf unbeschrifteten Daten. Es erzeugt viele Zufallsbäume. Eine normale Beobachtung braucht meist mehr Teilungen bis zur Isolation, weil sie in einem dichten Bereich liegt. Eine ungewöhnliche Beobachtung wird in weniger Schritten abgetrennt.
Das macht es zu einer vernünftigen Option, wenn Sie keine Labels haben und nicht für jede verdächtige Kombination Regeln von Hand schreiben wollen. Eine Bank bewertet Transaktionen vielleicht nach Betrag, Händlerkategorie, Zeit, Geografie und Kanal. Ein Krankenhaus analysiert vielleicht Kombinationen von Betriebskennzahlen. Ein Telekom-Team überwacht vielleicht Netzverhalten über mehrere Dimensionen.
Wenn Sie die Methode praktisch ausprobieren wollen, ist ein Python-Workflow zur Anomalieerkennung ein verbreiteter Ausgangspunkt.
Abwägungen, auf die man achten sollte
Isolation Forest kann auf multivariaten Daten gut funktionieren, doch es ist keine Zauberei. Die Merkmalswahl zählt weiterhin. Die Skalierung ebenso. Dominiert eine Variable den Wertebereich, isoliert das Modell womöglich die falschen Datensätze aus dem falschen Grund.
Gute Einsätze sind unter anderem:
Betrugsprüfung: ungewöhnliche Kombinationen über viele Transaktionsattribute hinweg
Betriebsüberwachung: Verhalten, das je Einzelkennzahl normal aussieht, in Kombination aber auffällig ist
Exploration: große unbeschriftete Datensätze, in denen Sie Kandidaten zur Prüfung brauchen
Starten Sie mit Standardparametern und prüfen Sie echte Alarme mit den Fachverantwortlichen. Ein mathematisch ungewöhnlicher Punkt ist nicht immer eine geschäftlich relevante Anomalie.
3. Z-Wert- und Standardabweichungsmethoden
Wenn Sie eine einfache Antwort auf „liegt dieser Wert ungewöhnlich weit vom Mittelwert“ brauchen, ist der Z-Wert oft die erste Methode, die man versucht.
Er misst, wie weit ein Punkt in Einheiten der Standardabweichung vom Mittelwert entfernt ist. Das klingt technisch, doch die Entscheidungslogik ist geradlinig. Ist der Wert weit genug vom Typischen entfernt, melden Sie ihn.

Bester Anwendungsfall für Z-Werte
Z-Werte sind nützlich, wenn die Kennzahl recht stabil ist und ihre Verteilung sich einigermaßen brav verhält. Verbreitete Basistechniken für praktische statistische Anomalieerkennung sind Z-Wert, Interquartilsabstand und gleitende Mittelwerte, und Teams können sie über Abstimmung oder gewichtete Bewertung kombinieren, um Fehlalarme zu senken und die Erkennung zu verbessern (praktische Notizen zu Methoden der Anomalieerkennung in Zeitreihen).
Deshalb tauchen Z-Werte weiterhin im Unternehmensmonitoring auf. Sie lassen sich leicht erklären. Ein Finanzteam kann ungewöhnliche Transaktionsbeträge melden. Ein Versorgungsteam kann ausreißende Vitalwerte beobachten. Ein Datenteam kann Zeilenzahlen in wiederkehrenden Ladevorgängen überwachen.
Wenn Sie genauer abwägen müssen, ob Mittelwert und Streuung die richtige Zusammenfassung sind, bietet dieser Leitfaden zu wie man die Verteilung von Daten beschreibt nützlichen Kontext.
Grenzen und praktische Anpassungen
Die Schwäche ist der Kontext. Ein Z-Wert auf Rohdaten kann Saisonalität, Drift oder schiefe Verteilungen übersehen. Eine Tagesumsatzkennzahl mit starkem Wochentagsmuster mag jedes Wochenende anomal aussehen, wenn Sie den Zeitkontext ignorieren.
Nutzen Sie Z-Werte mit Bedacht, wenn:
Die Kennzahl stabil ist: Zeilenzahlen, Dateigrößen, Laufzeiten oder Beträge mit geringer Drift
Sie Transparenz brauchen: Prüfung oder Stakeholder-Durchsicht fällt mit einfacher Mathematik leichter
Sie eine Basisreferenz wollen: ein starker erster Durchgang vor schwereren Modellen
Kurze praktische Anpassungen:
Nutzen Sie rollende Fenster: besser für veränderliches Zeitreihenverhalten
Bevorzugen Sie bei Bedarf Varianten: medianbasierte Alternativen gehen besser mit Ausreißern um
Ergänzen Sie Geschäftsregeln: ein statistisch ungewöhnlicher Wert kann operativ dennoch akzeptabel sein
4. Local Outlier Factor
Manche Anomalien sind nicht global extrem. Sie sind nur im Verhältnis zu benachbarten Daten seltsam. Genau dort wird Local Outlier Factor, kurz LOF, nützlich.
LOF vergleicht die lokale Dichte eines Punktes mit der Dichte seiner Nachbarn. Sitzt der Punkt in einem dünneren Bereich als die Datensätze um ihn herum, behandelt die Methode ihn als verdächtig. Das macht sie gut für gruppierte Daten, in denen „normal“ mehrere Ausprägungen hat.
Warum Dichte zählt
Denken Sie an die Nutzung in der Telekommunikation. Vielnutzende, Gelegenheitsnutzende und Firmenkonten können jeweils eigene Gruppen bilden. Ein Datensatz mag im Vergleich zur Gesamtheit normal aussehen und innerhalb des eigenen Clusters dennoch auffällig sein. LOF ist für diese Art kontextuellen Vergleichs gebaut.
Dieselbe Logik hilft in der Plattformüberwachung. Eine Gruppe von Jobs läuft vielleicht in einem Latenzband, während eine andere Pipeline-Familie in einem anderen Band läuft. LOF kann eine Aufgabe fangen, die für ihre Vergleichsgruppe auffällig ist, selbst wenn sie absolut nicht groß wirkt.
Praktische Passung und Abwägungen
LOF ist am stärksten, wenn Nachbarschaften bedeutsam sind. Es schwächt, wenn die Dimensionen zunehmen und alles dünn wird. In hochdimensionalen Daten können Nächste-Nachbarn-Beziehungen weniger aussagekräftig werden.
Nützliche Szenarien:
Telekommunikation: ungewöhnliches Kundenverhalten innerhalb ähnlicher Nutzungskohorten
Datenplattformen: auffällige Jobs im Vergleich zu vergleichbaren Jobs
Betrieb im Gesundheitswesen: Datensätze, die nicht zu benachbarten Betriebsmustern passen
Zu beachtende Punkte:
Wählen Sie die Nachbarschaftsgröße sorgfältig: zu klein und Alarme werden zappelig, zu groß und der lokale Kontext verschwindet
Skalieren Sie Merkmale zuerst: Dichtevergleiche brechen, wenn ein Merkmal dominiert
Nutzen Sie Prüfschleifen: LOF findet oft subtile Fälle, die fachliche Deutung brauchen
LOF funktioniert meist besser als Teil eines Stapels denn als Einzeldetektor. Koppeln Sie es mit einem einfachen statistischen Vorfilter oder einer deterministischen Regel, um Prüfrauschen zu senken.
5. Autoencoder-Neuronale Netze
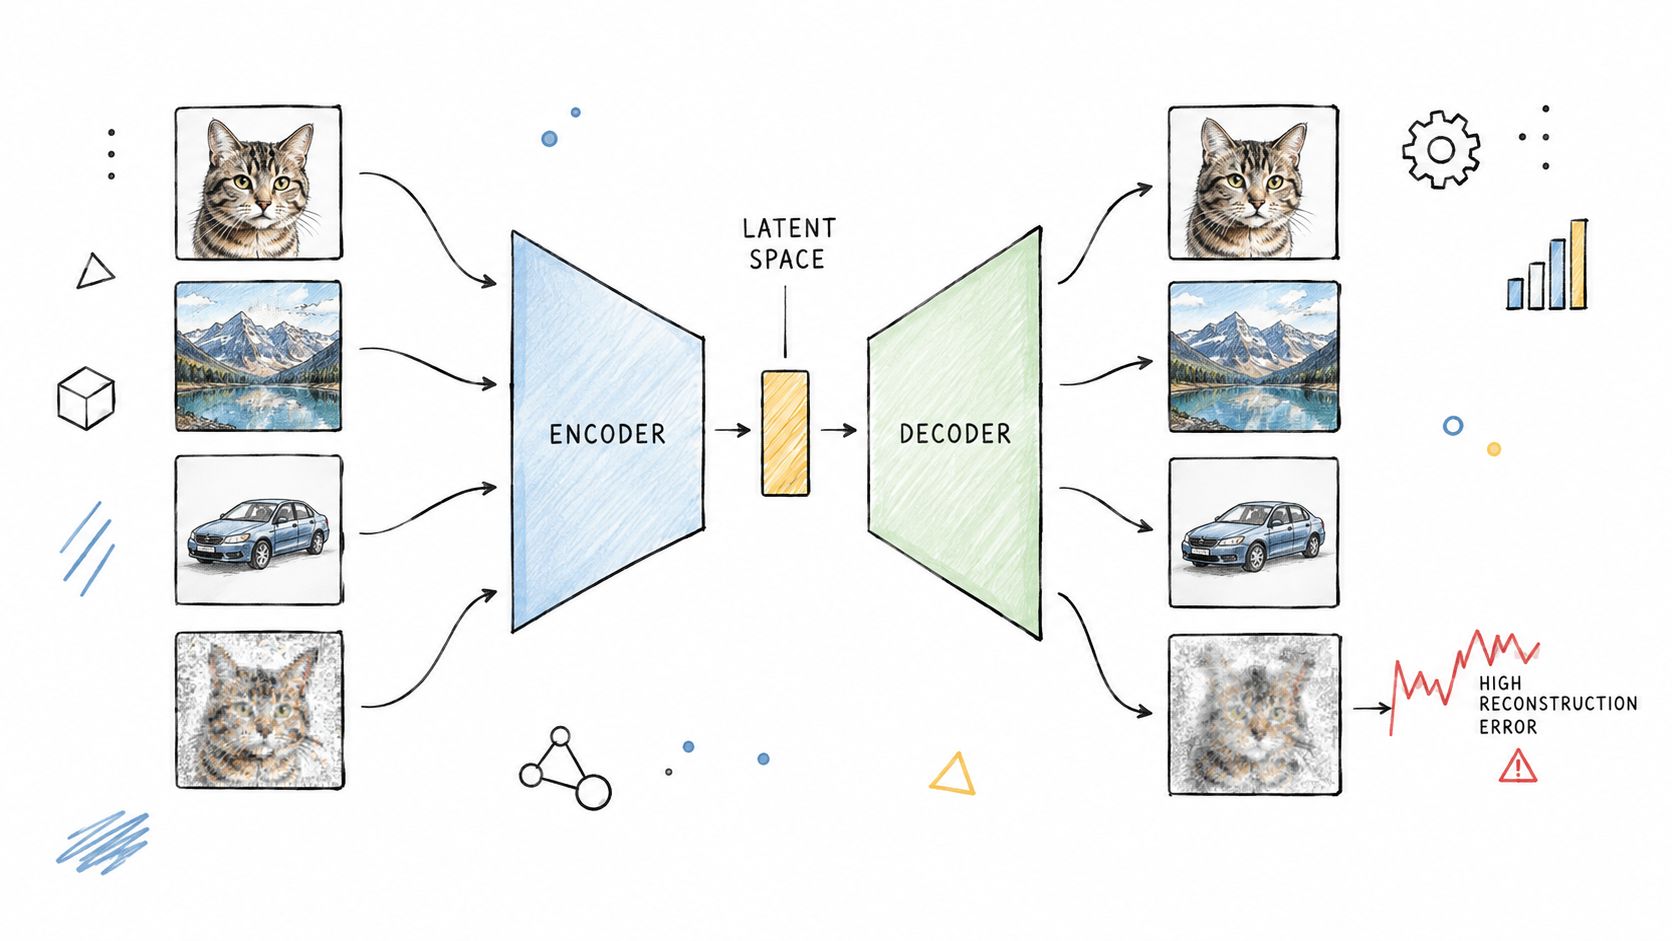
Autoencoder gehören zur Rekonstruktionsfamilie. Statt ausdrückliche Grenzen zu setzen oder Dichte zu messen, lernen sie, normale Daten zu komprimieren und wieder aufzubauen. Misslingt die Rekonstruktion, ist die Eingabe womöglich anomal.
Diese Idee ist mächtig, wenn das Muster komplex und nichtlinear ist. Es ist auch der Punkt, an dem Anomalieerkennung für nichttechnische Stakeholder schwerer erklärbar wird.
Wo Rekonstruktion hilft
Autoencoder sind nützlich, wenn normales Verhalten von vielen zusammenspielenden Variablen abhängt und einfache Grenzen es nicht erfassen. Ein Finanzteam bewertet vielleicht komplexes Preisverhalten. Ein Gesundheitsteam überwacht vielleicht Kombinationen aus mehreren Geräten oder Sensoren. Ein Telekom-Team beurteilt vielleicht Verkehrssignaturen, die sich mit linearen Methoden nicht sauber trennen lassen.
In breiten Übersichten werden Methoden der Anomalieerkennung oft in statistische Ansätze, klassische Ansätze des maschinellen Lernens und Verfahren auf Basis neuronaler Netze gruppiert (Überblick zu statistischen, Machine-Learning- und Deep-Learning-Methoden). Autoencoder sitzen klar in dieser dritten Gruppe.
Für zeitbezogenes Verhalten tauchen sie oft in breiteren Abläufen zur Anomalieerkennung in Zeitreihen auf, besonders wenn Beziehungen zwischen Signalen mehr zählen als eine einzelne Kennzahl.
Die Abwägungen sind real
Autoencoder können Muster erfassen, die einfachere Methoden verpassen. Sie brauchen auch saubere Trainingsdaten, mehr Abstimmung und stärkere Betriebsdisziplin. Lernt das Modell ein verdorbenes „normal“, wird der Rekonstruktionsfehler weniger aussagekräftig.
Nutzen Sie sie, wenn:
Muster komplex sind: nichtlineare Wechselwirkungen zählen
Beschriftete Anomalien selten sind: Rekonstruktion braucht nicht viele Fehlerbeispiele
Sie das Modell stützen können: Training, Nachtraining und Schwellenprüfung brauchen Verantwortliche
Neuronale Methoden finden oft wertvolle Anomalien, ersetzen aber selten einfachere Kontrollen. Teams brauchen weiterhin erklärbare Prüfungen für Vorfallsdurchsichten und Auditgespräche.
6. One-Class-SVM Support Vector Machine
One-Class-SVM versucht, die Grenze um normale Daten zu lernen. Alles außerhalb dieser gelernten Grenze gilt als ungewöhnlich.
Das macht sie konzeptionell anders als Isolation Forest. Isolation Forest fragt, wie leicht ein Punkt zu trennen ist. One-Class-SVM fragt, ob der Punkt in den akzeptierten Bereich normalen Verhaltens fällt.
Wann das Lernen von Grenzen sinnvoll ist
Diese Methode ist nützlich, wenn normale Datensätze eine zusammenhängende Form bilden, selbst wenn diese Form nicht linear ist. Kernfunktionen erlauben dem Modell flexiblere Grenzen, was bei multivariaten Mustern helfen kann.
Beispiele sind:
Finanzdienstleistungen: Transaktionen, die außerhalb des normalen Kundenverhaltens liegen
Gesundheitswesen: ungewöhnliche klinische Profile über mehrere Messungen hinweg
Kundenanalytik: Kontoaktivitätsmuster, die über bekannte Normen hinaus driften
Die Hauptschwierigkeit ist die Empfindlichkeit. One-Class-SVM kann stark auf Merkmalsskalierung, Parameterwahl und verrauschte Trainingsdaten reagieren. Bei großen Datensätzen kann sie zudem rechnerisch teuer werden im Vergleich zu leichteren Methoden.
Was Teams erwarten sollten
One-Class-SVM ist oft eine gute Wahl für mittelgroße, strukturierte Datensätze, in denen das Lernen nur aus der Normalklasse zum Geschäftsproblem passt. Sie ist weniger attraktiv, wenn Sie leichte Erklärbarkeit oder wartungsarmes Produktionsverhalten brauchen.
Hilfreiche Betriebsgewohnheiten:
Normalisieren Sie Eingaben: das ist selten optional
Halten Sie Merkmale bedeutsam: schwache Merkmale verzerren die Grenze
Trainieren Sie nach Prozessänderungen neu: neue Produkte, Kanäle oder Abläufe können den Normalbereich verschieben
Wenn Sie ein Modell brauchen, das sich leichter mit Prüfenden oder Betriebsverantwortlichen bespricht, gewinnen deterministische Validierung oder statistische Basislinien meist.
7. Saisonale Zerlegung und ARIMA
Zeit ändert in der Anomalieerkennung alles. Ein Wert kann allein deshalb falsch wirken, weil er zur falschen Stunde, am falschen Tag oder nach der falschen Abfolge auftauchte. Saisonale Zerlegung und ARIMA sind für dieses Problem gebaut.
Diese Methoden nutzen zeitliche Erwartung als Nachweis. Sie fragen, was als Nächstes geschehen sollte, gegeben die Historie der Reihe.
Das Benchmarking-Umfeld zeigt, warum sorgfältige Methodenwahl zählt. ADBench bewertete 30 Algorithmen zur Anomalieerkennung auf 57 Datensätzen, und das UCR Time Series Anomaly Archive stellt 250 kuratierte Zeitreihen für die Forschung bereit, was bekräftigt, dass die Algorithmenwahl stark von den Eigenschaften des Datensatzes abhängt (Überblick zu ADBench-Benchmark und UCR-Archiv).
Wonach sie suchen
Die saisonale Zerlegung trennt eine Reihe in Trend, Saisonalität und Restverhalten. ARIMA modelliert die zeitliche Abhängigkeit direkt. Beides ist nützlich, wenn die Anomalie nicht nur „hoch“ oder „niedrig“ ist, sondern „unerwartet für diesen Zeitpunkt“.
Das zählt im echten Betrieb. Ein nächtlicher Batch-Ladevorgang, der nicht planmäßig eintrifft, ist ein Timeliness-Problem. Eine Spitze der Kundenaktivität an einem Feiertag kann normal sein, wenn Saisonalität und Ereigniskontext korrekt modelliert sind. Ein Umsatzrückgang an einem ruhigen Wochenende verdient womöglich keine Eskalation.
Diese Methodenfamilie ist besonders für kollektive und Teilfolgen-Anomalien relevant. Ein neuerer Überblick hält fest, dass viele Produktionsvorfälle keine isolierten Punkte sind, sondern kollektive oder Teilfolgen-Anomalien, und hebt die praktische Lücke bei der Methodenwahl für Fälle wie verspätete Ladevorgänge, Schemadrift und mehrsignaliges Pipeline-Verhalten hervor (Überblick zur Erkennung systemischer Verschiebungen und zu Observability-Daten). Wenn Sie an der Überwachung der Datenlieferung arbeiten, wird Ihnen diese Lücke bekannt vorkommen.
Eine nützliche Umsetzungsreferenz ist dieser Leitfaden zum Erkennen von Anomalien in Zeitreihen.
Gute Passung für Data Observability
Diese Methoden sind oft die richtige Antwort für:
Fehlende oder späte Ladevorgänge: erwartete Ankunftsfenster zählen mehr als Rohwerte
Saisonale Geschäftskennzahlen: tägliche, wöchentliche oder monatliche Muster prägen normales Verhalten
Drift in wiederkehrenden Prozessen: allmähliche Abweichungen von historischem Timing oder Volumen
Eine verzögerte Pipeline ist oft eine kollektive Anomalie, keine Punktanomalie. Zeitbewusste Methoden fangen das früher als starre Schwellen.
8. Mahalanobis-Distanz
Die Mahalanobis-Distanz ist eines der nützlichsten multivariaten statistischen Werkzeuge, das viele Teams überspringen. Sie misst, wie weit ein Punkt vom Zentrum der Daten entfernt ist, und berücksichtigt dabei Maßstab und Korrelation.
Gerade dieser letzte Teil zählt. Bewegen sich zwei Variablen normalerweise gemeinsam, kann ein Datensatz auf jeder Einzelspalte völlig normal aussehen und als Kombination dennoch seltsam sein.
Warum Korrelation die Antwort verändert
Angenommen, Umsatzwachstum, Marge und Verschuldungsgrad folgen für ein Segment üblicherweise einer bekannten Beziehung. Ein Unternehmensdatensatz mit gewöhnlichen Werten je Kennzahl kann das übliche multivariate Muster dennoch verletzen. Die Mahalanobis-Distanz kann diese Unstimmigkeit wirksamer aufdecken als die einfache euklidische Distanz.
Das macht sie nützlich in Finanzwesen, klinischem Betrieb und Datenqualitätsüberwachung. Ein Gesundheitsdatensatz kann einzeln plausible Werte zeigen, die kombiniert ein unplausibles Profil ergeben. Eine Datenplattform kann Qualitätskennzahlen beobachten, die allein akzeptabel, zusammen aber verdächtig sind.
Wann man sie einsetzt
Die Mahalanobis-Distanz ist ein starker Mittelweg zwischen einfacher Statistik und vollem maschinellem Lernen. Sie bleibt erklärbar und geht dennoch besser mit multivariater Struktur um als Schwellen je Spalte.
Sie funktioniert am besten, wenn:
Variablen korreliert sind: die Kovarianz trägt nützliche Information
Sie erklärbare multivariate Prüfungen brauchen: Analystinnen können einsehen, welche Beziehungen sich verschoben haben
Die Daten strukturiert sind: stabile Kennzahlen passen oft besser als rohe Ereignisströme
Kovarianzschätzungen können in verrauschten oder hochdimensionalen Umgebungen instabil werden. Segmentierte Kovarianzschätzung und Segmentierung verbessern die Zuverlässigkeit oft.
9. Regelbasierte und deterministische Validierung
Der am meisten vernachlässigte Rat in der Anomalieerkennung lautet so. Wenn das Geschäft bereits weiß, dass eine Bedingung inakzeptabel ist, trainieren Sie kein Modell darauf, sie neu zu entdecken.
Regelbasierte Validierung nutzt ausdrückliche Logik. Pflichtfelder müssen befüllt sein. Referenzwerte müssen zu freigegebenen Listen passen. Datumsangaben müssen Reihenfolgebedingungen einhalten. Regulatorische Bedingungen müssen exakt gelten. Das ist kein „altmodisches“ Monitoring. Es ist die klarste Form von Nachweis, die Sie haben können.
Die stärkste Art von Signal
Regeln nutzen ausdrückliches Fachwissen statt erschlossener Muster. Muss eine Gesundheitsdatei verpflichtende Identifikatoren enthalten, bringt es nichts, ein statistisches Modell zu fragen, ob fehlende Identifikatoren ungewöhnlich aussehen. Sie sind ungültig. Verlangt ein Finanzprozess, dass Beträge in einem festgelegten Richtlinienbereich bleiben, ist eine deterministische Kontrolle die primäre Prüfung.
Deshalb bleiben regelbasierte Methoden in regulierten Umgebungen und kritischen Berichtsabläufen unverzichtbar. Sie geben Teams vollständige Prüfbarkeit und stabiles Betriebsverhalten.
Beispiele:
digna Data Validation: Prüfungen auf Satzebene gegen Geschäftsregeln
Finanzdienstleistungen: Kontrollen, die an Richtlinien oder regulatorische Vorgaben gebunden sind
Gesundheitswesen: Vollständigkeit von Pflichtfeldern und logische Konsistenz
Öffentlicher Sektor: auditfähige Durchsetzung erforderlicher Datenbedingungen
Wo Regeln enden
Regeln sind präzise, doch sie fangen nur, woran jemand gedacht hat. Sie erkennen keinen ungewöhnlichen Kundenmix, keine feine Kennzahlendrift und keine verschobene Basislinie im Ankunftszeitpunkt.
Neuere Übersichten betonen, dass die praktische Bewertung von Anomalieerkennung weiterhin bessere Orientierung unter Auflagen zu Datenschutz, Bereitstellung, Erklärbarkeit und Betrieb braucht, während die Observability-Forschung weiterhin die Herausforderung hervorhebt, Rauschen über Logs, Traces und Metriken hinweg mit vertrauenswürdiger Automatisierung zu senken (Überblick zu operativer, erklärbarer und bereitstellungsbewusster Anomalieerkennung). Deterministische Validierung hilft beim Vertrauen, weil Teams die genaue gescheiterte Bedingung sehen können.
Nutzen Sie Regeln für:
Bekannte Geschäftsanforderungen
Compliance- und Auditkontrollen
Risikoreiche Felder und Datensätze
Klare Eskalationswege
Vergleich von 9 Methoden der Anomalieerkennung
Methode | 🔄 Umsetzungsaufwand | ⚡ Ressourcenbedarf | 📊 Erwartete Ergebnisse | 💡 Ideale Anwendungsfälle | ⭐ Wichtigste Vorteile |
|---|---|---|---|---|---|
Statistisches Lernen von Basislinien | Mittel, automatisierte Einrichtung, Abstimmung der Empfindlichkeit | Gering–mittel, braucht historische Daten, bescheidene Rechenleistung | Kontextbewusste Anomalieerkennung mit weniger Fehlalarmen | Laufende Überwachung von KPIs und Datenqualität, saisonale Kennzahlen | Passt sich Trends und Saisonalität selbst an; skalierbar; schnell wirksam |
Isolation Forest | Mittel, Bäume trainieren und Parameter abstimmen | Gering–mittel, effizient für große und hochdimensionale Daten | Starke multivariate Anomalieerkennung in hohen Dimensionen | Betrugserkennung, hochdimensionale Betriebsdatensätze | Effizient, robust gegenüber irrelevanten Merkmalen, ohne Distanzmaß |
Z-Wert und Standardabweichung | Gering, einfache statistische Berechnungen | Minimal, vernachlässigbare Rechenlast | Schnelle, deutbare Ausreißermeldungen für Einzelkennzahlen | Zeilenzahlen, Schwellen für Einzelkennzahlen, erste Überwachungslinie | Extrem schnell, transparent, leicht prüfbar und umsetzbar |
Local Outlier Factor (LOF) | Mittel–hoch, Nachbarauswahl und Distanzmaß | Mittel–hoch, teuer bei großen Stichproben oder hohen Dimensionen | Erkennt lokale Dichteabweichungen und clusterspezifische Ausreißer | Datensätze mit unterschiedlichen Dichten oder clusterabhängigen Anomalien | Erfasst lokalen Kontext; ohne Annahme über die globale Verteilung |
Autoencoder-Neuronale Netze | Hoch, Architekturentwurf und Hyperparameter-Abstimmung | Hoch, GPUs, großer sauberer oder beschrifteter Trainingssatz hilfreich | Erkennt komplexe nichtlineare Anomalien über den Rekonstruktionsfehler | Komplexe hochdimensionale Muster, Multisensor- oder Zeitdaten | Modelliert nichtlineare Beziehungen; skaliert auf komplexe Merkmalsmengen |
One-Class-SVM | Hoch, Kernwahl und Parameterabstimmung | Mittel–hoch, Speicher und Rechenlast steigen mit der Datenmenge | Grenzbasierte Erkennung; empfindlich gegenüber Skalierung und Kernen | Datensätze mit zusammenhängendem Normalbereich, Anomalien liegen außerhalb | Flexible Entscheidungsgrenzen mit starker theoretischer Grundlage |
Saisonale Zerlegung und ARIMA | Mittel, Auswahl saisonaler und ARIMA-Parameter | Gering–mittel, braucht lange historische Reihen | Deutbare Trend- und Saisonkomponenten sowie prognostizierte Anomalien | Zeitreihen mit starker Saisonalität, Timeliness von Pipelines | Für zeitliche Daten entworfen; klare Zerlegung und Prognosen |
Mahalanobis-Distanz | Gering–mittel, Kovarianzschätzung und Inversion | Gering–mittel, braucht genügend Stichproben je Dimension | Multivariate Ausreißerwerte unter Berücksichtigung von Korrelationen | Korrelierte multivariate Qualitätsprüfungen und Überwachung | Berücksichtigt Kovarianz und Maßstab; wirksam bei korrelierten Variablen |
Regelbasierte und deterministische Validierung | Hoch, manuelles Verfassen und Pflegen von Regeln | Mittel, menschlicher Aufwand; geringe Rechenlast | Deterministische Bestanden-/Nicht-bestanden-Ergebnisse mit voller Prüfbarkeit | Regulatorische Prüfungen und kritische Geschäftsregeln | Vollständig transparent, prüfbar, exakte Durchsetzung der Geschäftslogik |
Wählen Sie die Methode, die zum Signal passt
Der praktischste Weg, die Arten der Anomalieerkennung zu verstehen, ist, sie nicht länger als rivalisierende Lager zu behandeln. Sie sind verschiedene Wege, Nachweise zu sammeln.
Nutzen Sie Z-Werte, wenn eine Kennzahl einfach und stabil ist und sich gut über Mittelwert und Streuung zusammenfassen lässt. Nutzen Sie das Lernen von Basislinien, wenn sich das Verhalten des Datensatzes über die Zeit ändert, aber weiterhin ein erwartbares Muster bildet. Nutzen Sie saisonale Zerlegung oder ARIMA, wenn Timing, Trend und Wiederkehr zählen, besonders bei fehlenden Ladevorgängen, Lieferverzögerungen und Geschäftsaktivität mit täglichem oder wöchentlichem Rhythmus. Nutzen Sie LOF und die Mahalanobis-Distanz, wenn der Kontext aus benachbarten Punkten oder korrelierten Variablen kommt. Nutzen Sie Isolation Forest, One-Class-SVM oder Autoencoder, wenn die Daten unbeschriftet, multivariat und zu komplex für statische Logik sind.
Das breitere Methodenfeld spiegelt diese Vielfalt. Anomalieerkennung in Zeitreihen wird üblicherweise in unüberwachte, überwachte und halbüberwachte Lerntypen eingeteilt, und dieselbe Literatur gruppiert Methoden in Prognose-, Rekonstruktions-, Distanz-, Kodierungs-, Nachbarschafts- und probabilistische Familien (VLDB-Überblick zu Familien der Anomalieerkennung in Zeitreihen). Das erinnert nützlich daran, dass die Algorithmenwahl beim Signal beginnen sollte und nicht beim Lieblingsmodell.
Auch die Marktrichtung weist eher auf operative Kombinationen als auf isolierte Werkzeuge. Eine Branchenprognose sieht den Markt für Anomalieerkennung von 4,28 Milliarden US-Dollar im Jahr 2024 auf 9,25 Milliarden US-Dollar bis 2032 wachsen und schreibt die Einführungsführerschaft 2025 der Software mit einem Anteil von 81,6 % und der Cloud-Bereitstellung mit 72,8 % zu (Marktprognose zur Anomalieerkennung). Das heißt nicht, dass jedes Team in einen reinen Cloud-Stack eilen sollte. Es zeigt aber, dass skalierbare, produktionsorientierte Anomalieerkennung im Unternehmensbetrieb angekommen ist.
Für Data Observability kombiniert der stärkste Aufbau meist mehrere Methoden. Eine deterministische Regel kann unmögliche Datensätze abweisen. Ein Basislinienmodell kann allmähliche Drift in Zeilenzahlen oder Werten erkennen. Ein Timeliness-Detektor kann verspätete Ladevorgänge aufspüren. Ein Schemamonitor kann strukturelle Änderungen fangen, bevor nachgelagerte Konsumenten scheitern. Dieser geschichtete Entwurf passt dazu, wie Vorfälle entstehen. Wenige Produktionsfehler kündigen sich über ein einziges perfektes Signal an.
digna ist ein einschlägiges Beispiel für diesen kombinierten Ansatz. Die Plattform läuft in der eigenen Umgebung der Kundin und vereint KI-gestützte Anomalieerkennung, Validierung auf Satzebene, Timeliness-Überwachung, Schema-Tracking, Überwachung von Geschäfts- und Plattformkennzahlen sowie Ausführung in der Datenbank. Diese Kombination zählt für Teams, die sowohl adaptive Erkennung als auch kontrollierte, prüfbare Durchsetzung brauchen.
Nutzen Sie diese Checkliste, bevor Sie eine Methode wählen:
Definieren Sie die Anomalie klar: ist es ein Punkt-, kontextuelles, kollektives, univariates oder multivariates Problem?
Bestätigen Sie die Datenhistorie: haben Sie genug saubere Historie, um normales Verhalten zu lernen?
Messen Sie Fehlalarme: wer prüft Alarme, und welches Maß an Rauschen ist akzeptabel?
Weisen Sie Reaktionsverantwortung zu: welches Team untersucht Drift, gescheiterte Regeln oder Lieferverzögerungen?
Prüfen Sie nach Prozessänderungen: trainieren, justieren oder schreiben Sie Kontrollen neu, wenn sich Produkte, Pipelines oder Zeitpläne ändern
Die richtige Methode ist jene, die zum Signal, zu den Daten und zur operativen Wirklichkeit um beide herum passt.
digna gibt Datenteams einen modularen Weg, diese Ansätze der Anomalieerkennung in der Produktion anzuwenden, vom KI-gestützten Lernen von Basislinien bis zu deterministischer Validierung, Timeliness-Überwachung und Schema-Tracking. Weil es in der eigenen Umgebung der Kundin läuft und Prüfungen in der Datenbank ausführt, passt es zu Teams, die Observability mit starker Kontrolle über Datenbewegung und Prüfabläufe brauchen. Wenn das zu Ihrem Aufbau passt, besuchen Sie digna.
Eine Methode zu wählen ist die leichtere Hälfte; sie kalibriert zu halten, während sich die Daten verschieben, ist die Arbeit, und genau dort verdient sich kontinuierliche Überwachung der Datenqualität ihren Platz.
Häufig gestellte Fragen
Wo sollte Anomalieerkennung tatsächlich beginnen?
Mit der richtigen Definition von normal, nicht mit Algorithmen. Die meisten Ratschläge starten bei der Methode, was verkehrt herum ist: Dieselbe Abweichung kann in einem Datensatz ein Vorfall und in einem anderen erwartete Saisonalität sein, und kein Modell klärt diese Frage für Sie.
Was unterscheidet statistische Basislinien von Isolation Forests?
Das statistische Lernen von Basislinien modelliert erwartetes Verhalten aus der Historie und meldet Abweichungen davon. Isolation Forests isolieren stattdessen Punkte, die sich leicht vom Rest trennen lassen, was auf hochdimensionalen Daten gut skaliert, aber weniger Intuition darüber gibt, warum ein Punkt gemeldet wurde.
Wann sollte man Z-Werte statt Dichtemethoden nutzen?
Z-Werte passen zu annähernd normalen, einvariablen Verteilungen, in denen die Abweichung vom Mittelwert bedeutsam ist. Local Outlier Factor verdient seinen Platz, wenn Dichte zählt — wenn ein Punkt global normal, relativ zu seinen unmittelbaren Nachbarn aber ungewöhnlich ist, was Z-Werte nicht sehen können.
Welche Methoden passen zu Zeitreihendaten?
Saisonale Zerlegung und ARIMA, weil sie Trend und Saisonalität vom Rest trennen und im Verbleibenden nach Abweichung suchen. Das passt gut zu Data Observability, wo eine Montagsspitze Routine ist und dieselbe Spitze am Mittwoch nicht.
Zählen regelbasierte Prüfungen neben ML noch?
Ja — deterministische Validierung ist die stärkste Art von Signal, weil sie erklärbar und prüfbar ist, wie es ein Modellwert nicht ist. Regeln enden dort, wo die unbekannten Unbekannten beginnen, und genau dort übernehmen verhaltensbasierte Methoden.