Abfragen effizient ausführen im Jahr 2026
|
6
min. Lesezeit

Sie können eine Abfrage ausliefern, die Zeilen liefert, Tests besteht und in der Produktion trotzdem Probleme verursacht. Der Schaden zeigt sich meist erst später, wenn ein Dashboard langsam ist, eine Abstimmungszahl nicht stimmt oder ein nachgelagerter Job unbemerkt Daten in der falschen Granularität verarbeitet. Wer oft genug Abfragen ausführt, lernt, dass „sie ist durchgelaufen“ die niedrigste Hürde ist und nicht diejenige, die ein Data Warehouse vertrauenswürdig hält.
Inhaltsverzeichnis
Warum das Ausführen einer Abfrage mehr ist als nur SQL auszuführen
Analytische Abfragen mit Statistiken und Prädikatdesign optimieren
Jenseits der Syntax Die semantische Validierungslücke im Query-Monitoring
Umgang mit verspäteten, sich ändernden oder unvollständigen Daten im Abfragebetrieb
Praktische Erkenntnisse für eine zuverlässige Abfrageausführung
Warum das Ausführen einer Abfrage mehr ist als nur SQL auszuführen
Früher galt eine Abfrage als eine Textzeile, die an eine Datenbank geschickt wird. Für moderne Systeme ist diese Sicht zu eng, denn die Datenbank wählt Zugriffspfade, Join-Reihenfolge und Ressourceneinsatz, während sie auf das Ergebnis hinarbeitet. Das relationale Modell von Edgar F. Codd aus dem Jahr 1970 verschob den Gedanken hin zu deklarativen Anfragen, bei denen der Benutzer das gewünschte Ergebnis angibt und das System entscheidet, wie es abgerufen wird. IBMs System R machte daraus ein praxistaugliches System mit einem kostenbasierten Query-Optimizer, der vor der Ausführung alternative Pläne verglich (IBM-Geschichte zu Patricia Selinger).
Dieser Wandel ist jedes Mal relevant, wenn ein Team eine Abfrage in einem Data Warehouse, einer operativen Datenbank oder einem Observability-Workflow ausführt. Das Ergebnis hängt vom Datenvolumen, von Zwischenergebnissen, vom Scan-Volumen und von den in diesem Moment verfügbaren Ressourcen ab, nicht nur davon, ob das SQL geparst werden kann. Für Teams, die mit Observability und Datenqualität arbeiten, ist die Abfrage die Operation, die man misst, und nicht nur der Text, den man prüft. Deshalb konzentrieren sich Plattformen, die auf dem Ausführungsverhalten aufbauen, wie die Data Observability von digna, darauf, was die Abfrage innerhalb der Datenbank tut, statt nur auf die Syntax.
Praxisregel: Behandeln Sie den Ausführungsplan als Teil der Abfrage, denn dort zeigen sich Kosten, Ressourcendruck und Plan-Drift zuerst.
Warum Syntaxprüfungen nicht ausreichen
Eine Syntaxprüfung sagt Ihnen, dass die Anweisung gültig ist. Sie sagt Ihnen nicht, ob sie zu viele Daten gelesen, in der falschen Reihenfolge verknüpft oder ein Ergebnis erzeugt hat, das plausibel genug aussah, um durch das Review zu rutschen. Genau auf diese Lücke stoßen Produktionsteams immer wieder, besonders wenn der Erfolg einer Abfrage allein daran gemessen wird, dass sie abgeschlossen wurde.
Der andere blinde Fleck ist das historische Verhalten. Dasselbe SQL kann sich anders verhalten, wenn die Daten wachsen, sich Statistiken ändern oder ein Join-Pfad weniger selektiv wird. Die Geschichte der Standardisierung erklärt auch, warum sich Teams nicht dauerhaft auf das Verhalten eines einzelnen Anbieters verlassen können: SQL hat sich über Jahrzehnte durch ANSI- und ISO-Revisionen weiterentwickelt und ist dabei die gemeinsame Sprache relationaler Systeme geblieben (ANSIs Geschichte des SQL-Standards).
Der Standard-Workflow für das Ausführen einer Abfrage
Der zuverlässigste Produktions-Workflow beginnt, bevor die Datenbank die eigentliche Arbeit leistet. Definieren Sie zuerst die benötigte Ausgabe und fordern Sie dann nur die minimal nötigen Spalten an. So bleibt die Abfrage fokussiert, und unnötige Daten werden nicht durch spätere Joins und Aggregationen geschleppt.
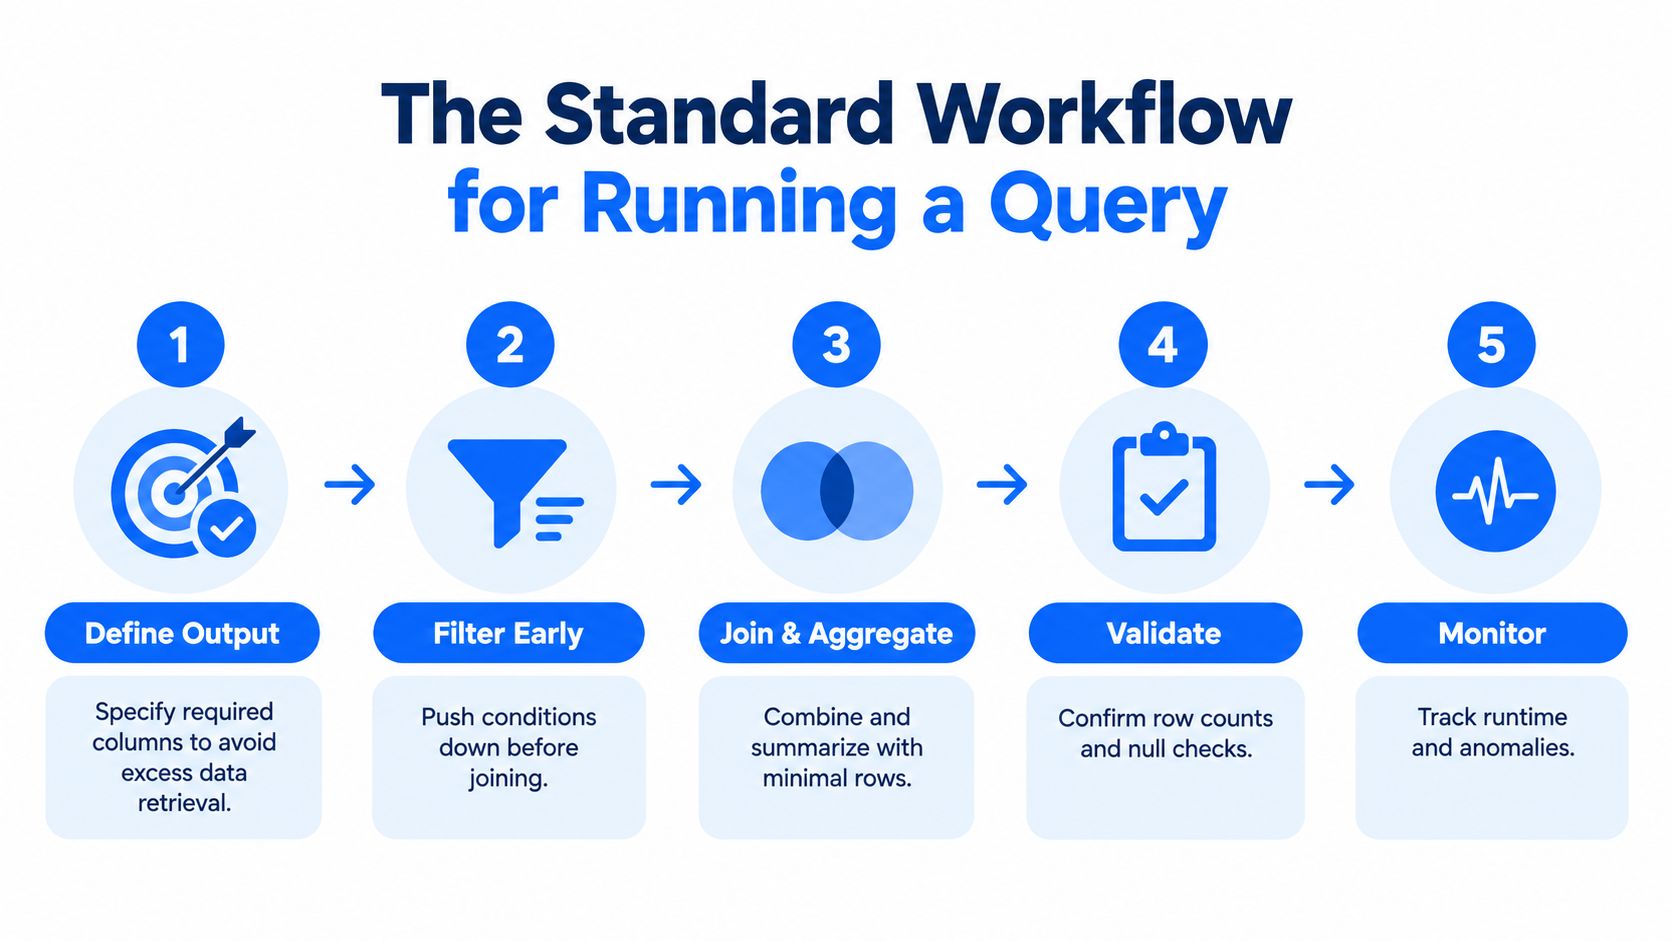
Schritt 1 Die Ausgabe definieren
Die Definition der Ausgabe sollte die gewünschte Granularität, die erwartete Zeilenmenge und die benötigten Spalten umfassen. Wenn die fachliche Frage die tägliche Kundenaktivität ist, fragen Sie nicht auf Ebene Konto-Monat ab und hoffen, dass die Zahlen später übereinstimmen. Eine Abfrage, die weniger verlangt, ist leichter nachvollziehbar, günstiger in der Ausführung und deutlich seltener für Überraschungen gut.
Schritt 2 Vor dem Join filtern
Verlagern Sie Bedingungen früh nach unten, damit die Datenbank mit weniger Zeilen arbeitet. Dieses Muster entspricht der Empfehlung von Microsoft, nur benötigte Spalten abzufragen und Daten vor JOIN-Operationen zu reduzieren, und es ist umso wichtiger, wenn Quelltabellen groß oder ungleich verteilt sind (Best Practices zur Performance von Google BigQuery).
Schritt 3 Den Ausführungsplan prüfen
Ein Plan-Review sollte Join-Reihenfolge, Scan-Volumen, Kardinalitätsschätzungen und jede Sortier- oder Aggregationsstufe abdecken, die zum Engpass werden könnte. Verlassen Sie sich nicht auf „sieht gut aus“ im SQL-Editor. Prüfen Sie, was der Optimizer erwartet, und vergleichen Sie das mit der Last, die Sie erwarten.
Schritt 4 Mit repräsentativen Daten benchmarken
Führen Sie die überarbeitete Abfrage auf realistischen Partitionen aus, nicht auf Spielzeug-Stichproben. Eine Abfrage, die auf einem schmalen Ausschnitt schnell ist, kann beim aktuellen Monat, beim größten Mandanten oder bei kaltem Cache zusammenbrechen. Messen Sie das Ergebnis am Latenz- und Ressourcenbudget, das Sie vorab festgelegt haben.
Halten Sie die Abfrage in der Produktion langweilig. Langweilig heißt begrenzt, messbar und stabil über die Partitionen, die Ihr Team tatsächlich abfragt.
Schritt 5 Das Laufzeitverhalten validieren
Nutzen Sie Plan- und Job-Metadaten, um herauszufinden, wo die Zeit verloren geht, und führen Sie die Abfrage nach jeder relevanten Änderung erneut aus. In der Praxis ist eine Abfrage erst „fertig“, wenn sie das richtige Ergebnis liefert, im Budget bleibt und sich über repräsentative Daten hinweg konsistent verhält.
Für Teams, die ein tieferes Betriebsmodell möchten, hilft Pipeline-Orchestrierung für Abfrage-Workloads, die Abfrage mit dem übrigen Datenfluss zu verbinden, statt sie als isolierten Befehl zu behandeln.
Analytische Abfragen mit Statistiken und Prädikatdesign optimieren
Analytische Workloads bleiben oft unbemerkt, bis sie lautstark scheitern. Das SQL ist gültig, aber der Optimizer erhält ein schlechtes Signal, weil die Join-Schlüssel nicht sauber zusammenpassen, die Katalogstatistiken veraltet sind oder ein Prädikat einen breiteren Scan erzwingt als nötig. Die Tuning-Empfehlungen von IBM nennen Datentyp-Abweichungen, Ausdrücke in Join-Prädikaten, Nicht-Gleichheits-Joins, unnötige Outer Joins, redundante Einschränkungen und ungenaue Katalogstatistiken als wiederkehrende Risiken, und diese Liste deckt sich mit dem, was Teams in realen Systemen sehen (IBM DB2 Leitfaden zum Query-Tuning).
Was die analytische Performance bremst
Ausdrücke auf indizierten oder Partitionierungsspalten sind eine häufige Falle. Sobald Sie die Spalte in eine Funktion verpacken, kann das Prädikat nicht mehr sargable sein. Das bedeutet, dass die Datenbank den erwarteten Zugriffspfad nicht nutzen kann und mehr Daten scannt als nötig. Die Validierung von Datentypen ist genauso wichtig, denn ein nicht passender Join-Schlüssel kann den Optimizer zu einem weniger effizienten Plan drängen.
Hier helfen auch praxisnahe Lernressourcen. Wenn Sie Ihre eigenen Datenbankkenntnisse aufbauen und die Tuning-Seite schärfen möchten, ist build database projects without a degree eine nützliche externe Lektüre, weil sie den Kompetenzaufbau an realer Arbeit statt an Theorie ausrichtet.
Eine disziplinierte Validierungsschleife
Führen Sie die Abfrage einmal auf Korrektheit aus und vergleichen Sie dann geschätzte mit tatsächlichen Zeilen in jeder Stufe. Testen Sie danach das Verhalten mit kaltem und warmem Cache, messen Sie Laufzeit und Ressourcenverbrauch und ändern Sie immer nur eine Sache auf einmal. Diese Reihenfolge ist langsamer als blindes Herumprobieren am SQL, aber sie ist der einzige Weg zu erkennen, ob eine Änderung den Plan verbessert oder die Kosten nur verschoben hat.
Eine solide Routine sollte Folgendes umfassen:
Zuerst Join-Schlüssel validieren. Stellen Sie sicher, dass die Datentypen übereinstimmen, bevor Sie Indizes oder Hints anfassen.
Schätzfehler prüfen. Wenn die Zeilenschätzungen des Plans danebenliegen, optimieren Sie die Statistiken oder die Form des Prädikats, bevor Sie die Hardware verantwortlich machen.
Ressourcenverbrauch messen. CPU, Speicher, gescannte Bytes sowie Spill- oder Shuffle-Volumen zeigen, ob die Abfrage gesund ist.
Nach jeder einzelnen Änderung wiederholen. Mehrere Änderungen auf einmal verschleiern die Ursache der Verbesserung oder Verschlechterung.
Für Teams, die ihr Query-Tuning standardisieren, ist der Leitfaden zur SQL-Abfrageoptimierung hilfreich, weil er das Prädikatdesign mit dem tatsächlichen Ausführungspfad verknüpft, statt Optimierung als Formatierungsübung zu behandeln.
Jenseits der Syntax Die semantische Validierungslücke im Query-Monitoring
Eine Abfrage kann erfolgreich ausgeführt werden und trotzdem auf relevante Weise falsch sein. Sie kann Zeilen über einen Join duplizieren, verspätet eintreffende Datensätze verlieren, versehentlich eine Datumsgrenze verschieben oder in der falschen Granularität aggregieren und dabei eine völlig saubere Ergebnismenge liefern. Deshalb sind Syntax und Ausführungsstatus für sich genommen schwache Signale.
Unabhängige Datenbankforschung zeigt, dass Fehler bei der Kardinalitätsschätzung weit verbreitet und oft die Hauptursache schlechter Abfragepläne sind (VLDB-Forschung zu Abfrageverhalten und Kardinalitätsschätzung). Das ist wichtig, weil die Annahmen des Optimizers den Plan prägen und der Plan die Performance und manchmal auch die Ergebnisqualität, auf die Sie sich verlassen.
Ausführungserfolg versus semantischer Erfolg
Ausführungserfolg bedeutet, dass die Engine die Anweisung abgeschlossen hat. Semantischer Erfolg bedeutet, dass die Abfrage die richtige Population in der richtigen Granularität und mit der richtigen fachlichen Bedeutung geliefert hat. Das sind unterschiedliche Tests, und Produktionsteams brauchen beide.
Ein Query-Monitoring, das bei der Laufzeit aufhört, übersieht die gefährlichsten Fehler. Die Abfrage kann schnell, günstig und trotzdem falsch sein. In Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor kann ein solcher Fehler Berichte, operative Entscheidungen oder Modelleingaben verfälschen, ohne einen offensichtlichen Vorfall auszulösen.
Ein stärkeres Produktionsmuster besteht darin, jede kritische Abfrage mit Erwartungen zu verknüpfen:
Erwartete Granularität. Wissen Sie, ob die Ausgabe auf Ebene Kunde-Tag, Konto-Monat oder etwas anderem liegen soll.
Abstimmungssummen. Vergleichen Sie die Summen der Ausgabe mit einer vertrauenswürdigen Kontrollsumme, sofern es eine gibt.
Repräsentative Grenzfälle. Prüfen Sie verspätete Lieferungen, doppelte Schlüssel und Grenzdaten explizit.
Verhaltens-Baseline. Vergleichen Sie die aktuelle Form des Ergebnisses mit früheren Läufen und achten Sie auf Drift.
Der In-Database-Ansatz von digna passt zu diesem Modell, weil die Prüfungen dort laufen, wo die Daten liegen. So können Teams das Verhalten validieren, ohne sensible Datensätze aus dem Data Warehouse oder dem operativen Speicher herauszubewegen. Das ist ein praktischer Vorteil, wenn das Ziel Observability ist und nicht eine weitere Kopie der Daten.
Umgang mit verspäteten, sich ändernden oder unvollständigen Daten im Abfragebetrieb
Eine Abfrage kann sauber durchlaufen und für den Produktionseinsatz trotzdem falsch sein. Eine Datei kann nach dem Stichtag eintreffen, eine Quelle kann Zeilen nachliefern, oder ein Produzent kann ohne Vorwarnung die Struktur ändern. Das SQL läuft weiterhin, aber das Ergebnis passt womöglich nicht mehr zu dem fachlichen Ausschnitt, den Sie beabsichtigt haben. Teams, die sich nur auf Bestanden-oder-Fehlgeschlagen-Prüfungen verlassen, merken es meist erst, wenn sich ein Dashboard verschiebt oder ein nachgelagerter Job die fehlerhafte Ausgabe verarbeitet.
Die Leitlinien der Europäischen Kommission zur Datenqualität betrachten Qualität als zweckabhängig und nennen Genauigkeit, Vollständigkeit, Konsistenz, Eindeutigkeit, Integrität, Aktualität, Herkunft und Methoden der Datenerhebung als Qualitätsmerkmale. Diese Sichtweise passt besser zur operativen Abfragearbeit als ein binäres Erfolgsflag.
Monitoring braucht ein Schweregradmodell
Prüfungen auf Aktualität, Periodenabdeckung, Schemaänderungen und Vollständigkeit sollten nicht alle dieselbe Reaktion auslösen. Eine verspätete, aber gültige Ladung verdient vielleicht eine Warnung. Eine fehlende Quelldatei sollte die nachgelagerte Nutzung blockieren. Wenn jedes Problem fatal ist, verlieren Teams das Vertrauen in Alerts. Wenn jedes Problem nur informativ ist, reagiert niemand schnell genug.
Starke Kontrolle entsteht durch kontextbezogene Schwellenwerte, nicht durch eine einzige Bestanden-oder-Fehlgeschlagen-Regel für jeden Datensatz.
Schwieriger ist es, verspätete, aber gültige Daten von fehlenden Daten zu unterscheiden. Historische Ankunftsmuster helfen. Saisonale Baselines ebenfalls. Und ein klarer Verantwortlicher für jede Prüfung. Bewahren Sie Belege für die Nachprüfung auf, denn die Fragen nach einem Vorfall sind meist einfach: Was hat sich geändert, wann hat es sich geändert, und war das Ergebnis noch sicher nutzbar?
Wo Kontext starre Regeln schlägt
Wenn eine Quelle normalerweise früh eintrifft, aber einmal pro Woche verspätet ist, sollte die Richtlinie dieses Muster abbilden. Wenn ein Datensatz später am Tag korrigiert wird, muss das Monitoring vorübergehende Inkonsistenzen zulassen, ohne echte Fehler zu verdecken. Das ist die Grenze zwischen dauerhafter Kontrolle und fragiler Automatisierung.
Für Teams, die eine konkrete Definition von Aktualität brauchen, bietet Kennzahlen und Monitoring für Datenaktualität einen praktischen Weg, das Regelwerk und das Schweregradmodell für Alerts festzulegen.
Verspätete und sich ändernde Eingaben brauchen auch semantische Prüfungen. Granularität, Population und fachliche Bedeutung können driften, selbst wenn die Aktualität akzeptabel aussieht. Hier hilft ein In-Database-Ansatz, weil Teams diese Bedingungen dort validieren können, wo die Daten liegen, statt Datensätze nur zur Prüfung herauszukopieren.
Praktische Erkenntnisse für eine zuverlässige Abfrageausführung
Eine Abfrage, die sauber zurückkommt, kann trotzdem falsch sein. In der Produktion hängt eine zuverlässige Ausführung davon ab, dass Performance-Kontrolle, Aktualitätskontrolle und semantische Validierung zusammenwirken, denn ein schnelles Ergebnis mit falscher Granularität oder Population ist trotzdem ein Fehlschlag.
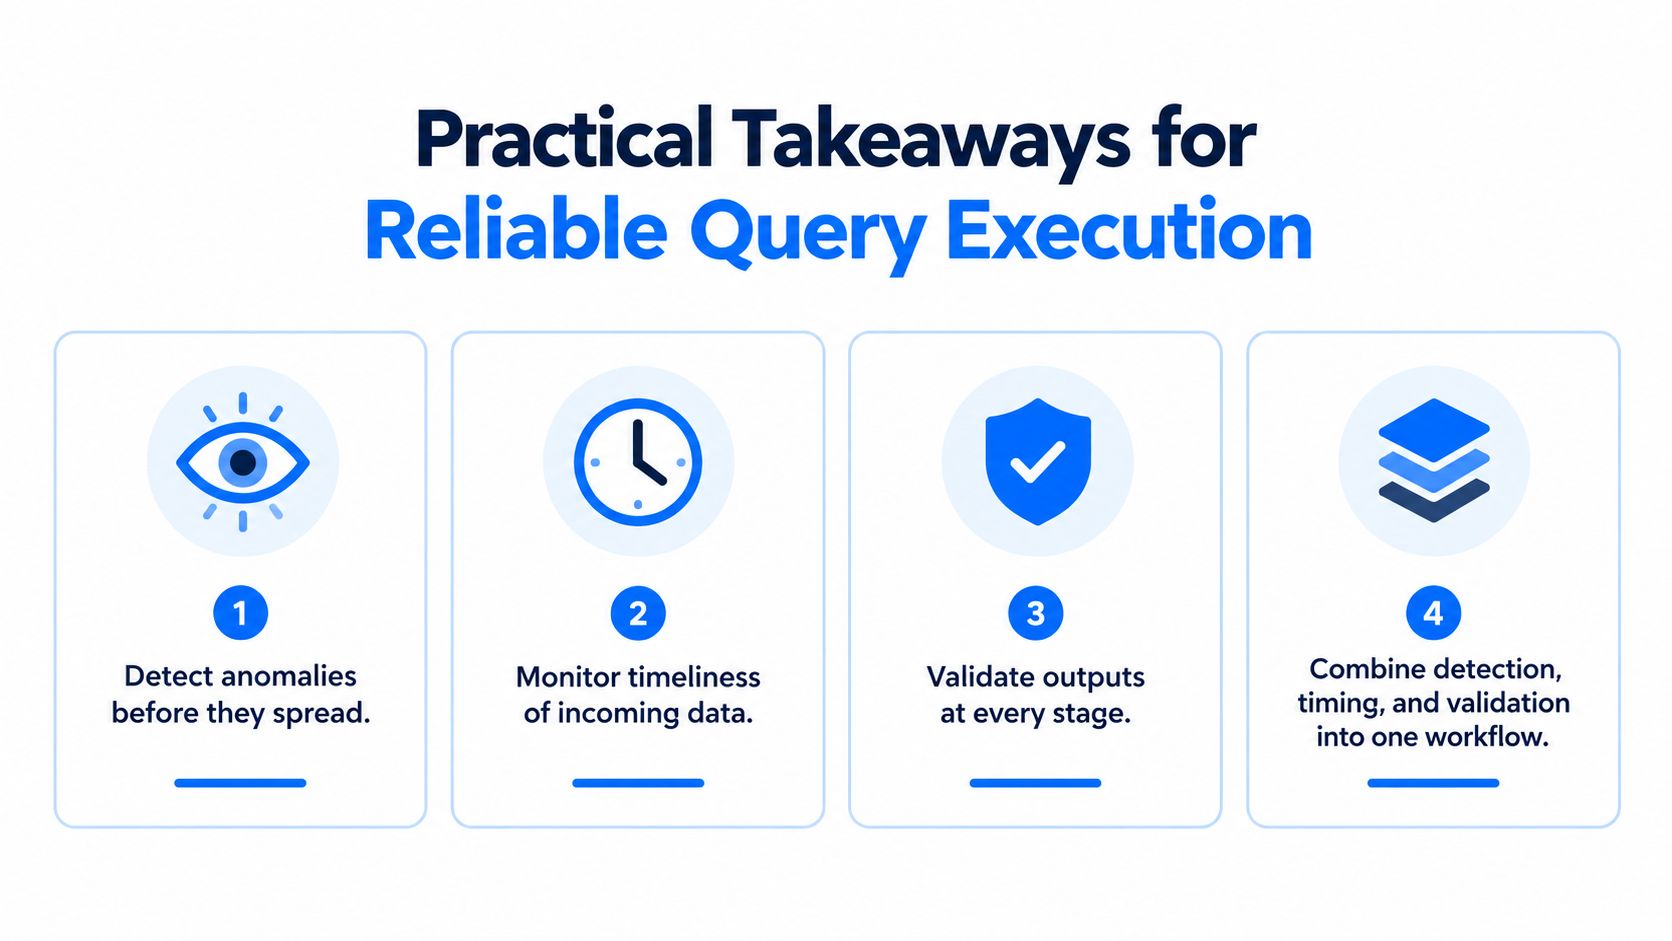
Was standardisiert werden sollte
Beginnen Sie mit der erwarteten Granularität und dem akzeptablen Latenzfenster für jede wichtige Abfrage. Halten Sie eine Baseline für Laufzeit, gescannte Zeilen und Ausgabeform fest, damit Regressionen sichtbar werden, wenn sich das Verhalten ändert. Wer nur prüft, ob die Anweisung abgeschlossen wurde, übersieht die Drift, auf die es ankommt.
Halten Sie die Richtlinie so einfach, dass sie auch unter Druck angewendet werden kann. Legen Sie fest, welche Fehler die Nutzung blockieren, welche ein Review auslösen und welche für kurze Zeit tolerierbar sind. So werden Erkennung, Validierung und Governance aufeinander abgestimmt, ohne jeden Alert zur Krise zu machen.
Was in der Produktion funktioniert
Nutzen Sie Anomalieerkennung für Drift, Aktualitätsprüfungen für Datenlieferungen und Validierung für Geschäftsregeln. Führen Sie diese Prüfungen nach Möglichkeit in der Datenbank aus, denn Daten nur zur Prüfung woandershin zu kopieren, erhöht Kosten und Risiko. Wenn das Data Warehouse das Verhalten dort testen kann, wo die Daten bereits liegen, geht die Diagnose schneller und die Alerts sind vertrauenswürdiger.
Für die Abfrage-Performance gehören Plan-Review und Baseline-Vergleich in dieselbe Schleife. Ändert sich der Plan, prüfen Sie ihn. Driften die Zeilenschätzungen, vergleichen Sie sie mit den tatsächlichen Werten. Liegt die Laufzeit noch im Budget, aber die Ausgabeform stimmt nicht, behandeln Sie das als Datenproblem und nicht als erfolgreichen Lauf.
Für Teams, die Ansätze vergleichen, ist Datenbank-Performance-Tuning für zuverlässige Abfragen eine praktische Ergänzung, weil es das Abfrageverhalten mit der Stabilität des Workloads verbindet statt mit isolierten Korrekturen.
Wenn Sie das Abfrageverhalten überwachen, Drift früh erkennen und Ausgaben validieren möchten, ohne sensible Daten zu bewegen, besuchen Sie digna. digna führt Prüfungen direkt in Ihrem Data Warehouse aus, sodass Sie Granularität, Aktualität und Drift validieren, ohne einen einzigen Datensatz zu bewegen.
Warum Prüfungen, die dort laufen, wo die Daten liegen, sicherer und schneller sind als der Export von Datensätzen in ein externes Tool, lesen Sie im Beitrag zur In-Database-Ausführung von Datenqualitätsprüfungen.
Häufig gestellte Fragen
Was bedeutet es, eine Abfrage effizient auszuführen?
Eine Abfrage effizient auszuführen heißt, dass sie das richtige Ergebnis liefert, im Latenz- und Ressourcenbudget bleibt und sich über repräsentative Daten hinweg konsistent verhält. Ohne Fehler durchzulaufen ist nur die niedrigste Hürde. Eine Abfrage kann schnell und günstig sein und trotzdem falsch, wenn sie in der falschen Granularität aggregiert oder verspätete Zeilen verliert.
Warum sollte man in SQL vor dem Join filtern?
Wer vor dem Join filtert, lässt die Datenbank mit weniger Zeilen arbeiten und senkt so Scan-Volumen und Größe der Zwischenergebnisse. Verlagern Sie Bedingungen früh nach unten und wählen Sie nur die benötigten Spalten. Der Effekt ist bei großen oder ungleich verteilten Quelltabellen am stärksten, wie auch die Performance-Empfehlungen von BigQuery betonen.
Was sollte man in einem Ausführungsplan prüfen?
Achten Sie auf Join-Reihenfolge, Scan-Volumen, Kardinalitätsschätzungen und jede Sortier- oder Aggregationsstufe, die zum Engpass werden kann. Vergleichen Sie anschließend die geschätzten mit den tatsächlichen Zeilen in jeder Stufe, denn laut Datenbankforschung sind Fehler bei der Kardinalitätsschätzung eine Hauptursache schlechter Pläne.
Warum kann eine erfolgreich ausgeführte Abfrage falsche Ergebnisse liefern?
Ausführungserfolg bedeutet nur, dass die Engine die Anweisung abgeschlossen hat. Das Ergebnis kann trotzdem Zeilen über einen Join duplizieren, verspätete Datensätze auslassen, eine Datumsgrenze verschieben oder in der falschen Granularität aggregieren. Erwartungen wie Granularität, Abstimmungssummen und eine Verhaltens-Baseline decken solche semantischen Fehler auf.
Wie sollten verspätete oder unvollständige Daten das Query-Monitoring beeinflussen?
Verspätete oder unvollständige Daten erfordern ein Schweregradmodell statt einer einzigen Bestanden-oder-Fehlgeschlagen-Regel. Eine verspätete, aber gültige Ladung verdient vielleicht nur eine Warnung, während eine fehlende Quelldatei die nachgelagerte Nutzung blockieren sollte. Historische Ankunftsmuster und saisonale Baselines helfen, verspätete von fehlenden Daten zu unterscheiden.


