Wyszukiwanie z użyciem znaków wieloznacznych: Praktyczny przewodnik na rok 2026
|
9
min. czyt.

Większość porad dotyczących symboli wieloznacznych (wildcards) sugeruje po prostu zapamiętanie znaków i przejście dalej. Ten skrót myślowy zawodzi w środowisku produkcyjnym, ponieważ błędy zwykle zaczynają się wtedy, gdy silnik bazy danych przestaje traktować wzorzec jako symbol wieloznaczny w momencie, gdy jest on najbardziej potrzebny. Rezultatem są pominięte dopasowania, mało precyzyjne wyniki lub zapytanie, które wygląda nieszkodliwie, ale wymusza powolne skanowanie całego systemu.
Spis treści
Dlaczego wyszukiwanie z użyciem symboli wieloznacznych to decyzja operacyjna, a nie tylko sztuczka składniowa
Cztery kanoniczne symbole wieloznaczne i ich dopasowania
Sekwencje o dowolnej długości
Pojedyncze znaki i klasy znaków
Alternacja i struktury przypominające wyrażenia regularne
Przegląd składni symboli wieloznacznych na różnych platformach
Rzeczywiste wzorce zapytań do eksploracji i walidacji danych
Kilka wzorców, które naprawdę się sprawdzają
Wydajność, indeksowanie i koszt wiodącego symbolu wieloznacznego
Dwie metody optymalizacji, które rzeczywiście pomagają
Kiedy symbole wieloznaczne przestają działać i jak to wykryć
Szybkie testy ujawniające błędy działania
Praktyczna lista kontrolna przed uruchomieniem zapytania z symbolem wieloznacznym
Why Wildcard Search Is an Operational Decision, Not Just a Syntax Trick
Inżynier wsparcia technicznego wpisuje *error* w pole wyszukiwania, oczekując wyświetlenia wszystkich linii logów zawierających błędy, a w odpowiedzi nie otrzymuje nic, napotyka limit czasu (timeout) lub zestaw wyników, który całkowicie ignoruje symbol wieloznaczny. Tego rodzaju awaria jest częstsza, niż przyznaje wiele zespołów, ponieważ obsługa symboli wieloznacznych zmienia się w zależności od platformy, indeksu i potoku analizatora. Ten sam wzorzec może zachowywać się inaczej w SQL, inaczej w powłoce systemowej, a jeszcze inaczej w wyszukiwarce.
Wyszukiwanie z użyciem symboli wieloznacznych najlepiej traktować jako decyzję operacyjną, a nie funkcję ułatwiającą pracę. Dokumentacja Microsoft SQL Server pokazuje, że znak % może znajdować się na początku, w środku lub na końcu wzorca, a znak _ dopasowuje dokładnie jeden znak, podczas gdy zakresy w nawiasach kwadratowych, takie jak [a-f], są również prawidłowe we wzorcach LIKE, jak udokumentowano przez Microsoft. Narzędzia klasy Enterprise utrzymują tę samą ideę w wyszukiwarkach dla użytkowników, ponieważ dopasowania częściowe są przydatne, gdy nie zna się dokładnej pisowni, ale kompromis jest zawsze taki sam – szersze wyszukiwanie zazwyczaj oznacza większe obciążenie i większe ryzyko cichego niedopasowania.
Praktyczna zasada: nie pytaj, czy symbole wieloznaczne są obsługiwane. Zapytaj, czy zapytanie nadal zachowuje się jak symbol wieloznaczny po tokenizacji, ujęciu w cudzysłów, ucieczce znaków i wyborze indeksu.
Reszta problemu jest prostsza do sformułowania niż do rozwiązania. Musisz znać podstawowe symbole, różnice między nimi na poszczególnych platformach, momenty, w których spada wydajność, oraz systemy, które całkowicie przestają rozwijać wzorzec. To jest część, którą większość przewodników omija, a która ma kluczowe znaczenie, gdy Twój edytor zapytań jest połączony ze środowiskiem produkcyjnym. Dla zespołów zarządzających niezawodnością danych jest to ta sama dyscyplina, którą stosuje się do kontroli pochodzenia (lineage) i świeżości danych, dlatego narzędzie takie jak platforma Data Observability od digna powinno być częścią tej samej dyskusji, nawet jeśli sam problem wyszukiwania leży gdzie indziej.
Cztery kanoniczne symbole wieloznaczne i ich dopasowania
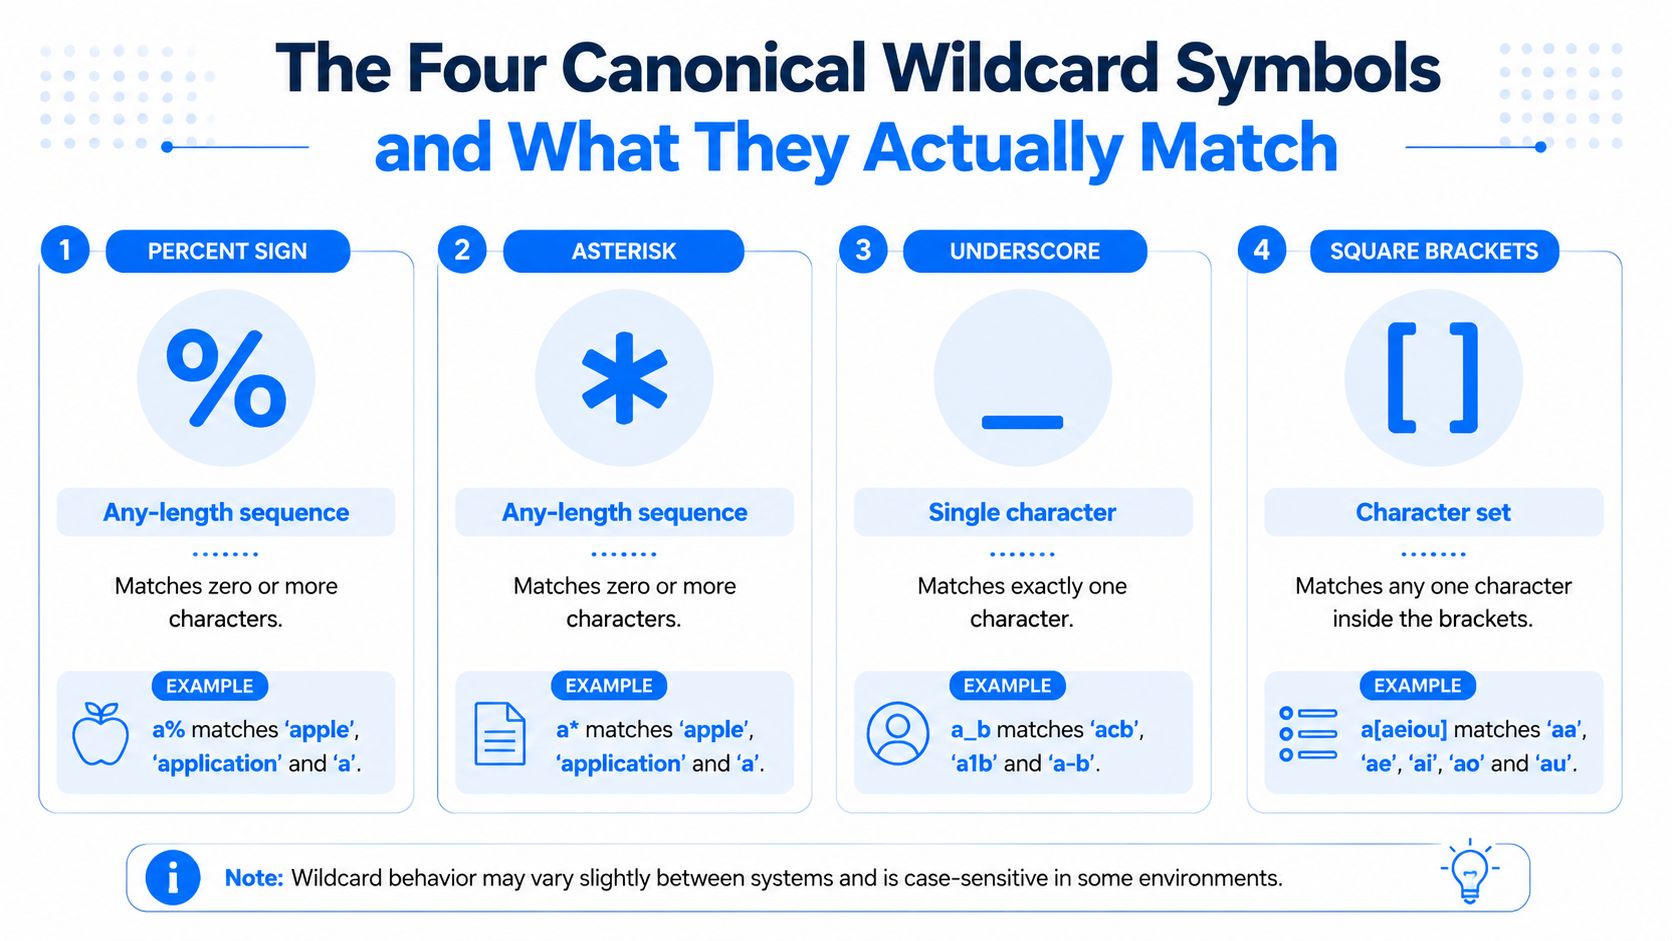
Najbezpieczniejszym sposobem myślenia o składni symboli wieloznacznych jest skupienie się na ich znaczeniu, a nie na samym symbolu. W SQL, powłokach systemowych i wyszukiwarkach ta sama intencja pojawia się pod różnymi znakami, a silnik może przestać traktować dany znak jako symbol wieloznaczny, gdy w grę wchodzi tokenizacja, cudzysłowy lub znak ucieczki.
Sekwencje o dowolnej długości
W SQL znak % dopasowuje zero lub więcej znaków. Wzorzec taki jak LIKE 'cust%' dopasuje customer_id, cust oraz custodian, ponieważ dopasowanie wymaga jedynie, aby tekst zaczynał się od cust. W powłoce POSIX odpowiednikiem tej intencji jest zazwyczaj *, więc polecenie ls /var/log/*.log wybiera pliki kończące się na .log.
Wyszukiwarki często zapożyczają tę samą ideę, używając * lub % w zależności od języka zapytań. Wyszukiwanie historii w SQL Prompt od Redgate używa * dla zera lub więcej znaków, a filtr historii Teradata używa % w tej samej roli, dlatego składnia symboli wieloznacznych wydaje się znajoma, nawet gdy zmienia się interfejs produktu Dokumentacja filtra wieloznacznego Teradata.
Pojedyncze znaki i klasy znaków
Znak _ w SQL oraz ? w powłokach systemowych i wielu narzędziach wyszukiwania dopasowują dokładnie jeden znak. Ma to znaczenie, gdy znasz ogólny kształt wartości, ale nie znasz dokładnego znaku na określonej pozycji. Wzorce status_1 i status?1 są precyzyjnymi narzędziami, a nie wyszukiwaniem rozmytym (fuzzy).
Nawiasy kwadratowe pozwalają zdefiniować klasę znaków. SQL Server obsługuje zakresy w nawiasach kwadratowych, takie jak [a-f], a Teradata obsługuje zestawy w nawiasach, takie jak [xyz] i [0-5] w swoim filtrze historii Dokumentacja symboli wieloznacznych MS SQL Server.
Alternacja i struktury przypominające wyrażenia regularne
Pionowe kreski pojawiają się częściej w wyrażeniach regularnych niż w czystej składni symboli wieloznacznych. W polu wyszukiwania wzorzec status:[active|pending] jest powszechny dla alternacji w systemach typu query-string, podczas gdy wzorzec adresu e-mail może opierać się na zestawach znaków w stylu regex, gdy składnia symboli wieloznacznych nie jest wystarczająco ekspresyjna. Przydatna zasada jest prosta: symbole wieloznaczne służą do określania ogólnego kształtu, a wyrażenia regularne do struktury.
Użyj symbolu wieloznacznego, gdy nieznana część jest szeroka, ale prosta. Użyj dokładnego dopasowania, gdy znasz wartość. Sięgaj po pełne wyrażenia regularne tylko wtedy, gdy potrzebujesz alternacji, grupowania lub walidacji, której prosty wzorzec (glob) nie jest w stanie precyzyjnie wyrazić.
W celu szybkiego porównania przed wpisaniem zapytania, profilowanie danych w digna stanowi przydatny model mentalny, ponieważ promuje ten sam nawyk – zweryfikuj kształt danych, zanim zaufasz wynikowi.
Przegląd składni symboli wieloznacznych na różnych platformach
Ta sama intencja – dopasowanie identyfikatorów zaczynających się od INV – przekłada się na inną składnię w zależności od platformy. Ta różnica ma znaczenie, ponieważ ten sam kształt zapytania może wygenerować zupełnie inne wyniki, ranking i charakterystykę obciążenia po przejściu między SQL, wyszukiwarkami i powłokami systemowymi.
Platforma | Dowolny ciąg znaków | Pojedynczy znak | Zestaw znaków | Znak ucieczki dla literału | Przykład: zaczyna się od |
|---|---|---|---|---|---|
SQL Server |
|
|
|
|
|
Filtr historii Teradata |
|
|
| Dosłowny |
|
Dopasowywanie wzorców PostgreSQL |
|
| klasy regex dla zaawansowanego dopasowywania |
|
|
Elasticsearch query string |
|
| w stylu regex tylko przy użyciu zapytań regex | Użyj znaku ucieczki dla zarezerwowanych znaków zapytania |
|
OpenSearch wildcard |
|
| brak systemu klas, zamiast tego użyj regex lub innych typów zapytań | Ostrożnie używaj znaków ucieczki dla zarezerwowanych znaków |
|
Splunk SPL | operatory wyszukiwania, a nie | n/d | funkcje regex lub analizowanie w czasie wyszukiwania | zależy od polecenia wyszukiwania |
|
Powłoka POSIX |
|
|
| ujmij wzorce w cudzysłów, aby zatrzymać ich rozwinięcie |
|
Kwestie sporne mają większe znaczenie niż same symbole. Filtr Teradata traktuje dopasowania symboli wieloznacznych jako niezależne od wielkości liter i obsługuje dosłowne traktowanie procentów w udokumentowanych przykładach, takich jak %[%]%, co przypomina, że narzędzia klasy enterprise często rozszerzają gramatykę poza standardowy SQL. SQL Server utrzymuje LIKE jako model bazowy, podczas gdy OpenSearch i Elasticsearch rezerwują znaki * i ? w składni zapytań i mogą domyślnie blokować użycie wiodących symboli wieloznacznych. Aby uzyskać szerszy pogląd na to, jak kształt zapytania wpływa na koszt wykonania, warto przeczytać optymalizację zapytań SQL od digna.
Symbol wieloznaczny jest uniwersalny jako idea, ale nie jako konkretny znak. Każdy silnik mapuje tę ideę na swój sposób, a błędem jest zazwyczaj zapytanie, które wygląda poprawnie, ale pomija rekordy lub obciąża indeks znacznie bardziej, niż oczekiwano.
Rzeczywiste wzorce zapytań do eksploracji i walidacji danych
Zapytania, które przynoszą tutaj największe korzyści, to zazwyczaj te, które pisze się raz, sprawdza, a następnie usuwa po zakończeniu audytu. Najlepsze zapytania w tym przypadku są celowo proste i łatwe do usunięcia po zakończeniu walidacji.
Kilka wzorców, które naprawdę się sprawdzają
W przypadku walidacji adresów e-mail w SQL Server wzorzec z nawiasami kwadratowymi jest często wystarczający do szybkiej selekcji, nawet jeśli nie jest to pełny walidator zgodny z RFC. Praktyczny przykład wygląda jak LIKE '%@[A-Za-z0-9.-]%\.com', co stanowi uproszczony filtr dla adresów kończących się na .com i zawierających prawdopodobny kształt nazwy użytkownika i domeny. Nie zastępuje to dedykowanej reguły walidacji, ale działa dobrze, gdy sprawdzasz partię danych pod kątem oczywistych uszkodzeń.
W przypadku pracy w powłoce systemowej wzorzec może być prostszy. Test archiwum w systemie Linux, taki jak find . -type f \( -name "*.csv" -o -name "*.json" \) -mtime +7, precyzyjnie izoluje nieaktualne pliki CSV i JSON, ponieważ symbol wieloznaczny odpowiada za wybór nazwy pliku, a filtr daty kontroluje cykl życia. Taki podział sprawia, że wzorzec jest czytelny, a zestaw wyników ograniczony.
W OpenSearch wyszukiwanie kodu produktu, takie jak { "wildcard": { "sku": "*aa*" } }, znajduje jednostki SKU z dwoma kolejnymi samogłoskami w środku, ale tylko wtedy, gdy pole jest zmapowane w sposób obsługujący wyszukiwanie z symbolami wieloznacznymi. Jest to przydatny wzorzec audytowy, gdy sprawdzasz, czy systemy źródłowe nie wprowadziły nieoczekiwanych formatów kodów.
Praktyczna zasada: używaj najwęższego symbolu wieloznacznego, który realizuje cel. Jeśli znasz już prefiks lub sufiks, zakotwicz go. Jeśli nie potrzebujesz dopasowania wewnątrz ciągu, unikaj go.
Kiedy weryfikuję poprawność działania wyszukiwania na potrzeby panelu (dashboardu) lub przeglądu danych, szukam najmniejszego zapytania, które wciąż ujawnia błąd. Ta sama dyscyplina pojawia się w działaniach takich jak zwiększanie widoczności marki w AI, gdzie kluczowym krokiem jest kontrolowanie kształtu zapytania, zanim system rozprzestrzeni je zbyt szeroko.
Przypadek użycia | SQL LIKE | Dopasowanie powłoki (glob) | Wyszukiwarka |
|---|---|---|---|
Audyt e-maili |
| n/d | regex lub wyszukiwanie w polach |
Czyszczenie plików | n/d |
| indeksowane zapytanie o metadane plików |
Kontrola kształtu SKU |
|
|
|
Walidacja prefiksu |
|
|
|
Najlepsze kontrole są wąskie, tymczasowe i łatwe do usunięcia po pomyślnej weryfikacji danych. To samo podejście stoi za czyszczeniem danych w SQL z digna, ponieważ oba zadania działają lepiej, gdy potwierdzisz kształt danych przed rozszerzeniem wyszukiwania.
Wydajność, indeksowanie i koszt wiodącego symbolu wieloznacznego
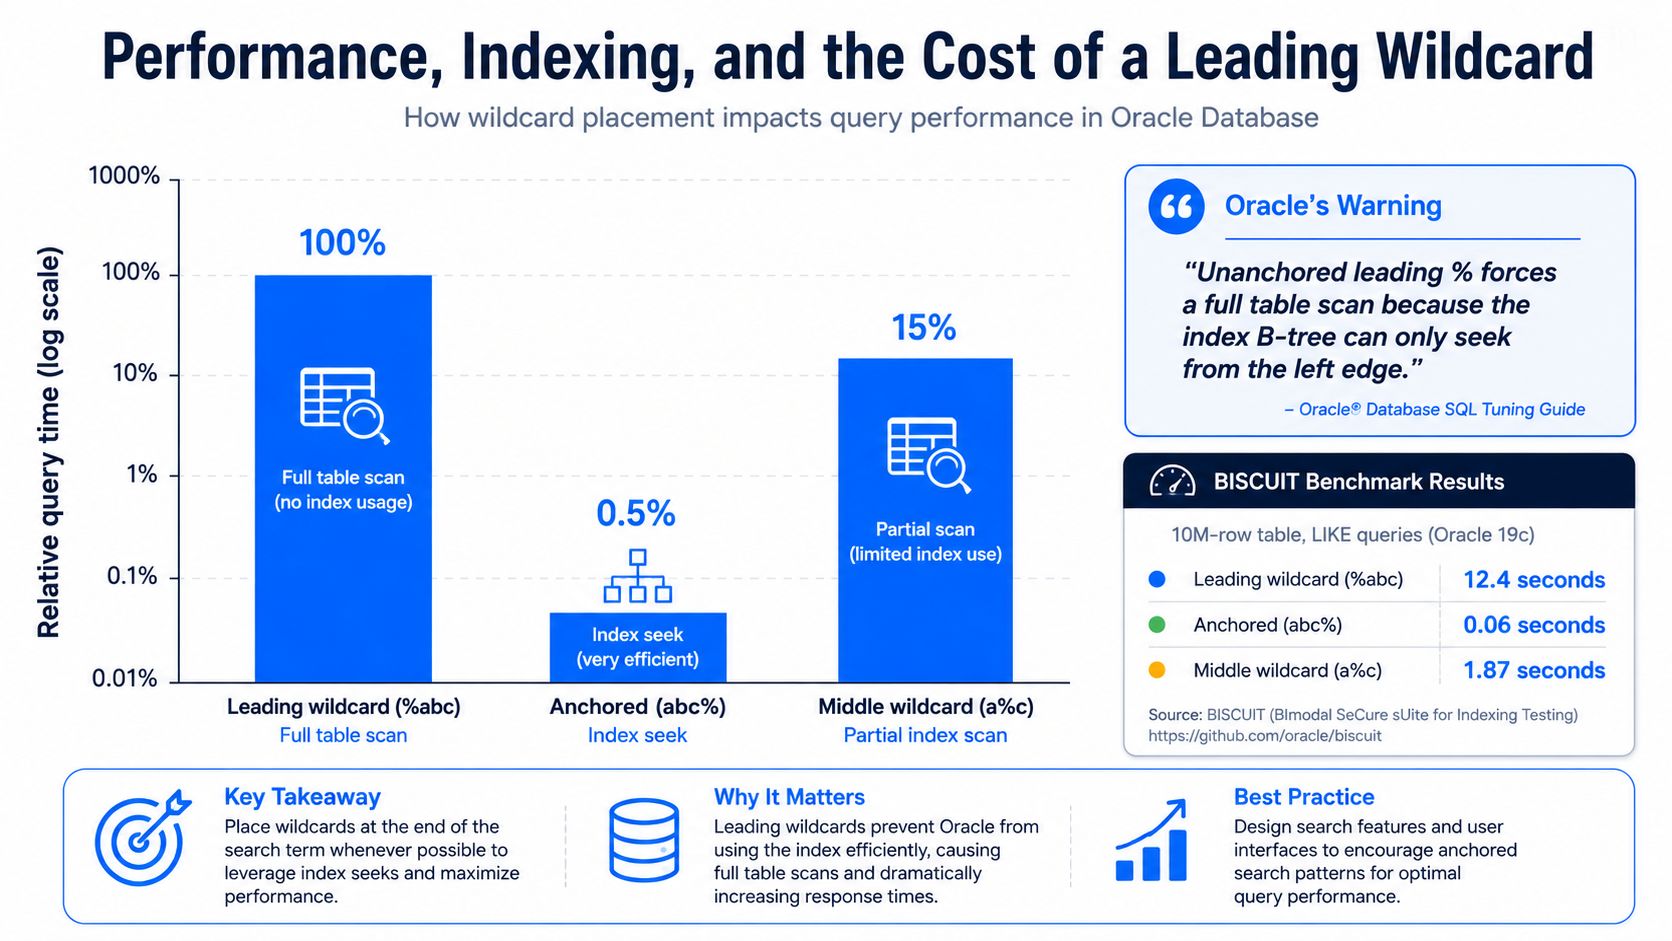
Wiodący symbol wieloznaczny zmienia ścieżkę wykonania, a koszty tego stanu rzeczy pojawiają się bardzo szybko. Oracle ostrzega, że wyszukiwania takie jak a* lub zapytania składające się wyłącznie z symboli wieloznacznych bądź znaków interpunkcyjnych mogą zająć znaczną ilość czasu, i zaleca użycie co najmniej 2 do 3 znaków niebędących symbolami wieloznacznymi przed uruchomieniem zapytania Wskazówki Oracle dot. symboli wieloznacznych.
Silnik może przeszukiwać indeks od lewej krawędzi, dlatego wzorzec abc% pozostaje przyjazny dla indeksu, podczas gdy %abc zazwyczaj już nie. Gdy tylko wzorzec przestaje dostarczać indeksowi stabilny prefiks, zapytanie zmienia się z szybkiego wyszukiwania w pełne skanowanie tabeli. W bencie referencyjnym BISCUIT wzorce z sufiksem i infiksem wykonywały się w czasie od 2,2 do 28,9 ms w porównaniu do 34,97 do 189,3 ms dla Trigram/B-tree w opublikowanym teście, a pakiet raportuje 14,4-krotne medianowe przyspieszenie w porównaniu z indeksowaniem B-tree przy 100% poprawności w 11 400 pomiarach Benchmark BISCUIT. Kompromisem jest tutaj przestrzeń dyskowa, ponieważ indeks był około 10 razy większy niż Trigram Benchmark BISCUIT.
Wyszukiwarki działają według tego samego schematu, nawet jeśli mechanizmy wewnętrzne są inne. Wiodący znak * eliminuje łatwą, zakotwiczoną po lewej stronie ścieżkę, więc silnik musi przeanalizować więcej terminów, co może obciążyć węzły koordynujące i zabezpieczenia przed nadmiernym rozwinięciem zapytań Dokumentacja symboli wieloznacznych Elasticsearch Dokumentacja symboli wieloznacznych OpenSearch. Dlatego podejście „po prostu dodaj gwiazdkę” staje się kosztownym nawykiem przy dużych indeksach.
Dwie metody optymalizacji, które rzeczywiście pomagają
Indeksy trigramowe lub n-gramowe: używaj ich, gdy częściowe dopasowania zdarzają się często i na dużą skalę. Dają one silnikowi strukturę, przeszukiwaną zamiast wymuszania pełnego skanowania.
Indeksy odwróconych pól dla wyszukiwania przyrostkowego (sufiksów): jeśli użytkownicy wyszukują po końcówkach, przechowuj odwróconą kopię ciągu znaków i zakotwicz symbol wieloznaczny po lewej stronie odwróconego pola. To zamienia problem wyszukiwania sufiksu w wyszukiwanie prefiksu.
Typowy wzorzec SQL dla podejścia z odwróconym polem jest prosty:
Dla dopasowania częściowego w PostgreSQL niezastąpione jest indeksowanie trigramowe:
Kluczowa wskazówka jest prosta: silnik bazy potrzebuje pomocy, gdy tylko oddalasz się od lewej krawędzi ciągu. Przewodnik optymalizacji zapytań SQL od digna osadza tę dyskusję w realiach kosztów wykonania, a nie tylko samej składni wzorców.
Kiedy symbole wieloznaczne przestają działać i jak to wykryć
Składnia symboli wieloznacznych może zawieść bez zgłaszania błędu, co jest gorsze niż oczywisty błąd składniowy, ponieważ zapytanie wygląda na prawidłowe. SharePoint i niektóre korporacyjne narzędzia wyszukiwania domyślnie usuwają wiodące symbole wieloznaczne, więc wyszukiwanie, które wydaje się szerokie, może w rzeczywistości stać się wąskim wyszukiwaniem prefiksowym Pomoc produktowa CAS nt. symboli wieloznacznych.
Kolejną pułapką są frazy w cudzysłowie. Wiele systemów traktuje symbole wieloznaczne wewnątrz podwójnych cudzysłowów jako dosłowny tekst, więc wzorzec "apple%" może wyszukiwać dokładny ciąg znaków apple%, zamiast rozwijać go. Działanie symboli wieloznacznych w PubMed również wykazuje subtelniejszy problem – ich użycie może zatrzymać automatyczne mapowanie terminów, co zmienia wyniki wyszukiwania w sposób trudny do uchwycenia, dopóki ktoś nie porówna wyników ręcznie.
Szybkie testy ujawniające błędy działania
Usunięty wiodący symbol wieloznaczny: uruchom
app%i porównaj z%app%na tym samym zbiorze danych. Jeśli liczba wyników prawie się nie zmienia, platforma może modyfikować Twoje zapytanie.Ignorowanie symbolu wieloznacznego w cudzysłowie: przetestuj
"apple%"w porównaniu doapple%bez cudzysłowów i porównaj surowy plan zapytania (explain), jeśli platforma go udostępnia.Wymuszanie reguły minimalnego prefiksu: spróbuj użyć wzorca z tylko jednym znakiem innym niż symbol wieloznaczny. Niektóre systemy wymagają co najmniej 3 znaków niebędących symbolami wieloznacznymi lub ograniczają liczbę symboli do jednego na termin.
Ograniczenie lub zablokowanie rozwinięcia (expansion): niektóre wyszukiwarki posiadają zabezpieczenia, które ograniczają rozwinięcie symbolu wieloznacznego, gdy wzorzec objąłby zbyt wiele unikalnych wartości.
Różnice w obsłudze wielkości liter: jedna platforma może domyślnie ignorować wielkość liter przy dopasowywaniu symboli wieloznacznych, podczas gdy inna oferuje to jako opcję. Te same dane wejściowe mogą zwracać różne wyniki w różnych systemach.
Większość problemów z symbolami wieloznacznymi wynika z rozbieżnych oczekiwań, a nie błędów logicznych.
Najszybszym sposobem na ich wykrycie jest przetestowanie tego samego wzorca na małym, znanym zbiorze danych, zanim wdrożysz go do wspólnego panelu (dashboardu) lub zapisanego zapytania. Taki mały zestaw walidacyjny pokazuje, czy silnik modyfikuje zapytanie, odrzuca symbol wieloznaczny, czy też zwraca wyniki, które wyglądają prawdopodobnie, ale nie zawierają oczekiwanych rekordów.
Praktyczna lista kontrolna przed uruchomieniem zapytania z symbolem wieloznacznym
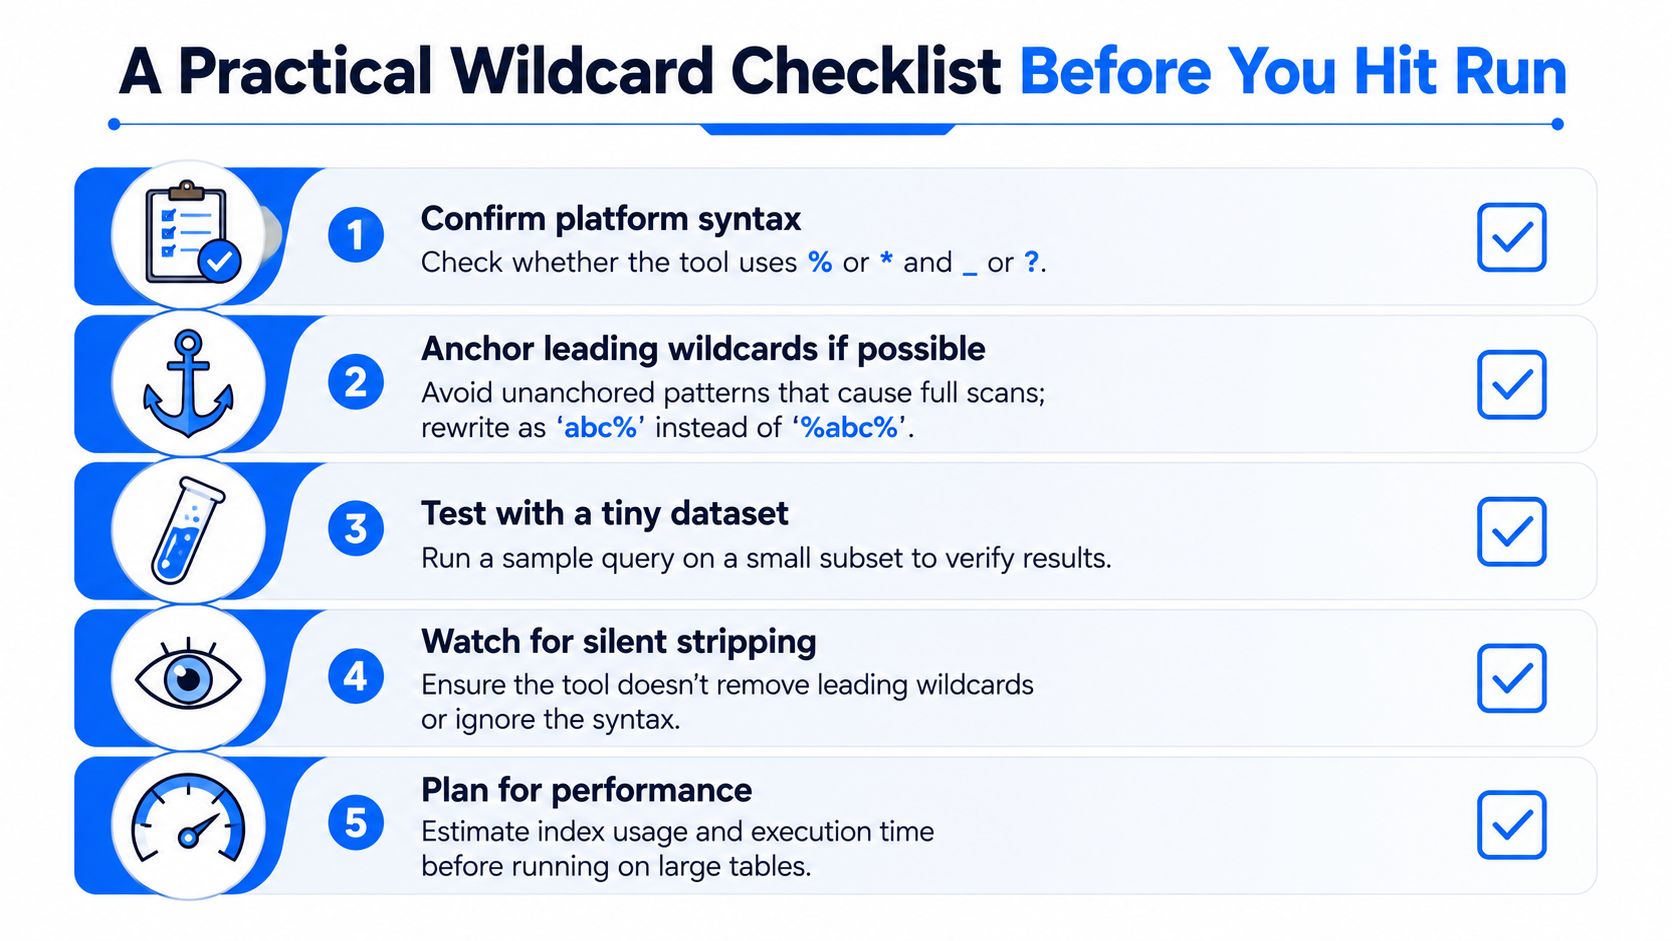
Zanim prześlesz zapytanie z symbolem wieloznacznym, najpierw zweryfikuj reguły platformy. Sprawdź, czy używa ona % czy *, czy _ czy ? dopasowuje pojedynczy znak oraz czy nawiasy, cudzysłowy lub inne zarezerwowane znaki zmieniają sposób analizowania zapytania.
Następnie przyjrzyj się samemu wzorcowi. Użyj znaków ucieczki dla znaków specjalnych, zanim trafią do parsera, i upewnij się, że zapytanie jest wystarczająco wąskie, aby silnik mógł je obsłużyć bez konieczności pełnego skanowania. Jeśli wzorzec ma działać w udostępnionym panelu, upewnij się, że filtry dat, limity wierszy i kwalifikacja indeksów nadal obowiązują.
Zarządzanie (governance) ma równie duże znaczenie. Upewnij się, że zapytanie jest rejestrowane w logach, walidowane względem docelowego schematu i przetestowane pod kątem ryzyka wstrzyknięcia kodu (SQL injection), jeśli jakakolwiek część wzorca pochodzi z danych wejściowych użytkownika. Zapytanie z symbolem wieloznacznym powinno być łatwe do wyjaśnienia kolejnemu inżynierowi bez konieczności ponownego otwierania zgłoszenia awarii.
Przechodź tę listę kontrolną za każdym razem. Większość błędów z symbolami wieloznacznymi udaje się wykryć jeszcze przed uruchomieniem zapytania.
Najczęściej zadawane pytania
Jakie są cztery kanoniczne symbole wieloznaczne?
Myśl znaczeniami, a nie symbolami. Sekwencje dowolnej długości używają % w SQL albo * w wielu wyszukiwarkach, pojedyncze znaki używają _ w SQL albo ? gdzie indziej, a klasy znaków korzystają z nawiasów kwadratowych. Czwartą kategorią jest mechanizm ucieczki, który pozwala szukać samych symboli.
Co naprawdę dopasowuje % w SQL?
Zero lub więcej znaków, przy czym może stać na początku, w środku albo na końcu wzorca. LIKE 'cust%' dopasuje customer_id, cust i custodian, bo porównanie wymaga jedynie, by tekst zaczynał się od cust, niezależnie od tego, co następuje dalej.
Czy klasy znaków działają wszędzie tak samo?
Zasadniczo tak, z różnicami produktowymi. SQL Server obsługuje zakresy w nawiasach, takie jak [a-f], we wzorcach LIKE, a Teradata obsługuje zbiory takie jak [xyz] i [0-5] w filtrze historii, dlatego składnia wieloznaczników wydaje się znajoma nawet przy zmianie produktu.
Dlaczego wyszukiwanie z wieloznacznikami to decyzja operacyjna?
Bo obsługa wieloznaczników nie jest właściwym pytaniem. Pytaj raczej, czy zapytanie nadal zachowuje się jak wieloznacznik po tokenizacji, cytowaniu, ucieczce znaków i wyborze indeksu. Zwłaszcza wieloznacznik na początku zamienia odczyt z indeksu w pełny skan, bez żadnego błędu składni.
Dlaczego wyszukiwanie z wieloznacznikami nic nie zwraca albo przekracza czas?
Zwykle dlatego, że wkroczyła jedna z tych warstw. Wpisanie *error* i brak wyników, przekroczony limit czasu albo zbiór wyników ignorujący wieloznacznik to trzy objawy tej samej przyczyny: wzorzec został przepisany albo indeks nie mógł go obsłużyć.


