Wymiary jakości danych: Wyjaśnienie 9 kluczowych metryk
|
10
min. czyt.

Jakość danych jest definiowana przez dziewięć standardowych wymiarów w zrewidowanym wydaniu DAMA-DMBOK® 2.0, a nie przez jeden uniwersalny wynik. Zestaw danych służy swojemu zamierzonemu celowi tylko wtedy, gdy odpowiednie wymiary, takie jak dokładność, kompletność, spójność, aktualność, integralność, terminowość, unikalność, poprawność i zasadność, spełniają potrzeby jego użytkowników.
Sprzeczne z intuicją jest to, że dokładne dane wciąż mogą być bezużyteczne. Rekord klienta może odpowiadać rzeczywistości, ale dotrzeć po podjęciu decyzji o kampanii, lub kompletna tabela może być sprzeczna z systemami źródłowymi, na których polegają zespoły biznesowe. Jakość danych to miara tego, jak dobrze dane służą swojemu zamierzonemu celowi, oceniana w wielu różnych wymiarach, a nie za pomocą pojedynczego wyniku.
Spis treści
Definiowanie jakości danych w nowoczesnych stosach technologicznych (Modern Data Stacks)
Jakość danych określa, czy dane są odpowiednie do określonego celu biznesowego, analitycznego, operacyjnego lub regulacyjnego. Zespół ds. finansów może wymagać wysoce dokładnych i spójnych danych transakcyjnych do raportowania, podczas gdy zespół ds. operacyjnych może bardziej dbać o to, czy zdarzenia docierają na czas i czy obecny jest każdy wymagany rekord. Żaden z zespołów nie może zdefiniować jakości niezależnie od decyzji, którą te dane wspierają.
Traktowanie jakości jako jednej liczby ukrywa te różnice. Tabela w hurtowni danych może przejść pomyślnie weryfikację dokładności, zawierając jednocześnie brakujące rekordy, nieaktualne wartości, zduplikowanych klientów lub nieprawidłowe formaty. Pojedynczy zagregowany wynik może również sprawić, że poważna awaria zniknie za dobrymi wynikami w niepowiązanych obszarach.
Dlaczego jeden wynik to za mało
Jakość danych to konstrukt wielowymiarowy. Analizy wskazują dokładność, kompletność, spójność, terminowość i adekwatność jako najczęściej wymieniane wymiary, podczas gdy szersze ramy obejmują poprawność, unikalność, wiarygodność, interpretowalność i bezpieczeństwo. Praktyczna konsekwencja jest prosta: przypisz każdą kontrolę do trybu awarii, któremu ma zapobiegać, zamiast pytać, czy zestaw danych jest „dobry”, czy „zły” (przegląd wymiarów jakości danych).
Dla inżyniera danych oznacza to sprawdzenie, czy dotarły wymagane ładowania, czy wartości są zgodne z typami i zakresami oraz czy rekordy zgadzają się między systemami. Dla analityka może to oznaczać potwierdzenie, że metryka ma stabilną definicję i niezawodny schemat odświeżania. Dla właściciela biznesowego kluczowym pytaniem jest, czy dane wspierają decyzję bez tworzenia niedopuszczalnego ryzyka.
Praktyczna zasada: Zacznij od decyzji, a następnie zdefiniuj wymiary, które mogą sprawić, że ta decyzja zakończy się niepowodzeniem.
Nowoczesne stosy technologiczne utrudniają zarządzanie tym kontekstem, ponieważ dane przemieszczają się przez bazy danych, interfejsy API, potoki ETL i ELT, hurtownie danych, pulpity nawigacyjne i magazyny cech AI. Każde przekazanie danych może wprowadzić inny defekt. System źródłowy może wymusić, aby pole było wymagane, podczas gdy transformacja w dalszej części potoku zamienia je w kolumnę dopuszczającą wartości null, lub opóźnione zdarzenie może być technicznie poprawne, ale bezużyteczne dla pulpitu nawigacyjnego wrażliwego na czas.
Zespoły pracujące z hurtowniami chmurowymi i integracjami korporacyjnymi mogą również skorzystać na zrozumieniu, jak partnerzy wdrożeniowi podchodzą do architektury platformy. Na przykład partnerstwo Faberwork LLC ze Snowflake dostarcza przydatnego kontekstu dla organizacji projektujących platformy danych, w których kontrole jakości muszą działać na etapach pozyskiwania, transformacji i konsumpcji.
Ramy 9 wymiarów jakości danych
Czym jest 9 wymiarów jakości danych? Zrewidowane wydanie DAMA-DMBOK® 2.0 identyfikuje dziewięć standardowych wymiarów, co do których panuje powszechna zgoda: Dokładność (Accuracy), Kompletność (Completeness), Spójność (Consistency), Aktualność (Currency), Integralność (Integrity), Terminowość (Timeliness), Unikalność (Uniqueness), Poprawność (Validity) i Zasadność (Reasonableness). Rewizja dodaje Aktualność (Currency) do wcześniejszego zestawu ośmiu wymiarów i używa określenia Reasonableness zamiast Reasonability (szczegóły rewizji DAMA-DMBOK® 2.0).
Używaj tej tabeli jako podręcznego punktu odniesienia, a nie jako substytutu kontekstu biznesowego. Każdy wymiar opisuje inny sposób, w jaki dane mogą zawieść.
Wymiar | Definicja | Przykład korporacyjny |
|---|---|---|
Dokładność (Accuracy) | Dane poprawnie reprezentują rzeczywisty podmiot, zdarzenie lub wartość, którą opisują. | Adres pocztowy klienta zgadza się z adresem przechowywanym w zaufanym źródle operacyjnym. |
Kompletność (Completeness) | Wymagane rekordy, pola i wartości są obecne dla zamierzonego zastosowania. | Każda zatwierdzona transakcja finansowa zawiera identyfikator konta, kwotę i datę zaksięgowania. |
Spójność (Consistency) | Dane nie są sprzeczne między systemami, tabelami, rekordami lub zdefiniowanymi regułami biznesowymi. | Hurtownia danych i baza danych rozliczeniowych klasyfikują to samo konto z takim samym statusem klienta. |
Aktualność (Currency) | Dane odzwierciedlają bieżący stan rzeczywistego obiektu lub procesu. | Rekord zapasów odzwierciedla ostatni znany stan magazynowy, a nie starszy stan. |
Integralność (Integrity) | Relacje między elementami danych pozostają prawidłowe i spójne logicznie. | Każda pozycja zamówienia odwołuje się do istniejącego rekordu zamówienia i produktu poprzez prawidłowe powiązania. |
Terminowość (Timeliness) | Dane stają się dostępne w czasie odpowiednim dla ich zamierzonego zastosowania. | Pulpit nawigacyjny ryzyka otrzymuje wymagany strumień danych transakcyjnych przed rozpoczęciem przeglądu biznesowego. |
Unikalność (Uniqueness) | Każdy rzeczywisty obiekt pojawia się tylko raz tam, gdzie duplikacja zniekształciłaby przypadek użycia. | Główny rejestr klientów zawiera jeden kontrolowany rekord dla każdego podmiotu będącego klientem. |
Poprawność (Validity) | Wartości są zgodne ze swoim zdefiniowanym typem, formatem, zakresem, domeną lub regułą. | Status transakcji należy do dozwolonego zestawu statusów, a kwota używa oczekiwanego typu numerycznego. |
Zasadność (Reasonableness) | Wartości i relacje są prawdopodobne w danym kontekście i nie naruszają oczekiwanego zachowania biznesowego. | Ilość sprzedaży jest technicznie poprawna, ale zostaje oznaczona, ponieważ jest mało prawdopodobna w kontekście produktu i zamówienia. |
Różnice te mają znaczenie podczas diagnozy. Brakujący identyfikator klienta to problem z kompletnością, natomiast identyfikator w nieprawidłowym formacie to problem z poprawnością. Zduplikowany klient to kwestia unikalności, podczas gdy klient powiązany z niewłaściwym kontem może wskazywać na błąd integralności lub dokładności.
W przypadku wdrożenia należy połączyć każdy wymiar z metryką i działaniem. Kontrola kompletności może zliczać brakujące wymagane wartości, kontrola unikalności może identyfikować nieoczekiwane duplikaty, a kontrola poprawności może testować typy danych, formaty, klasy i zakresy. Zespoły szukające dodatkowych praktycznych środków mogą wykorzystać te przykłady metryk jakości danych jako punkt wyjścia do projektowania własnych kontroli.
Jak wymiary oddziałują na siebie i tworzą kompromisy
Wymiary jakości danych nie funkcjonują w izolacji. Poprawa jednego może utrudnić utrzymanie innego, szczególnie gdy potoki mają stałe okna czasowe dostarczania lub nierówną jakość źródła.
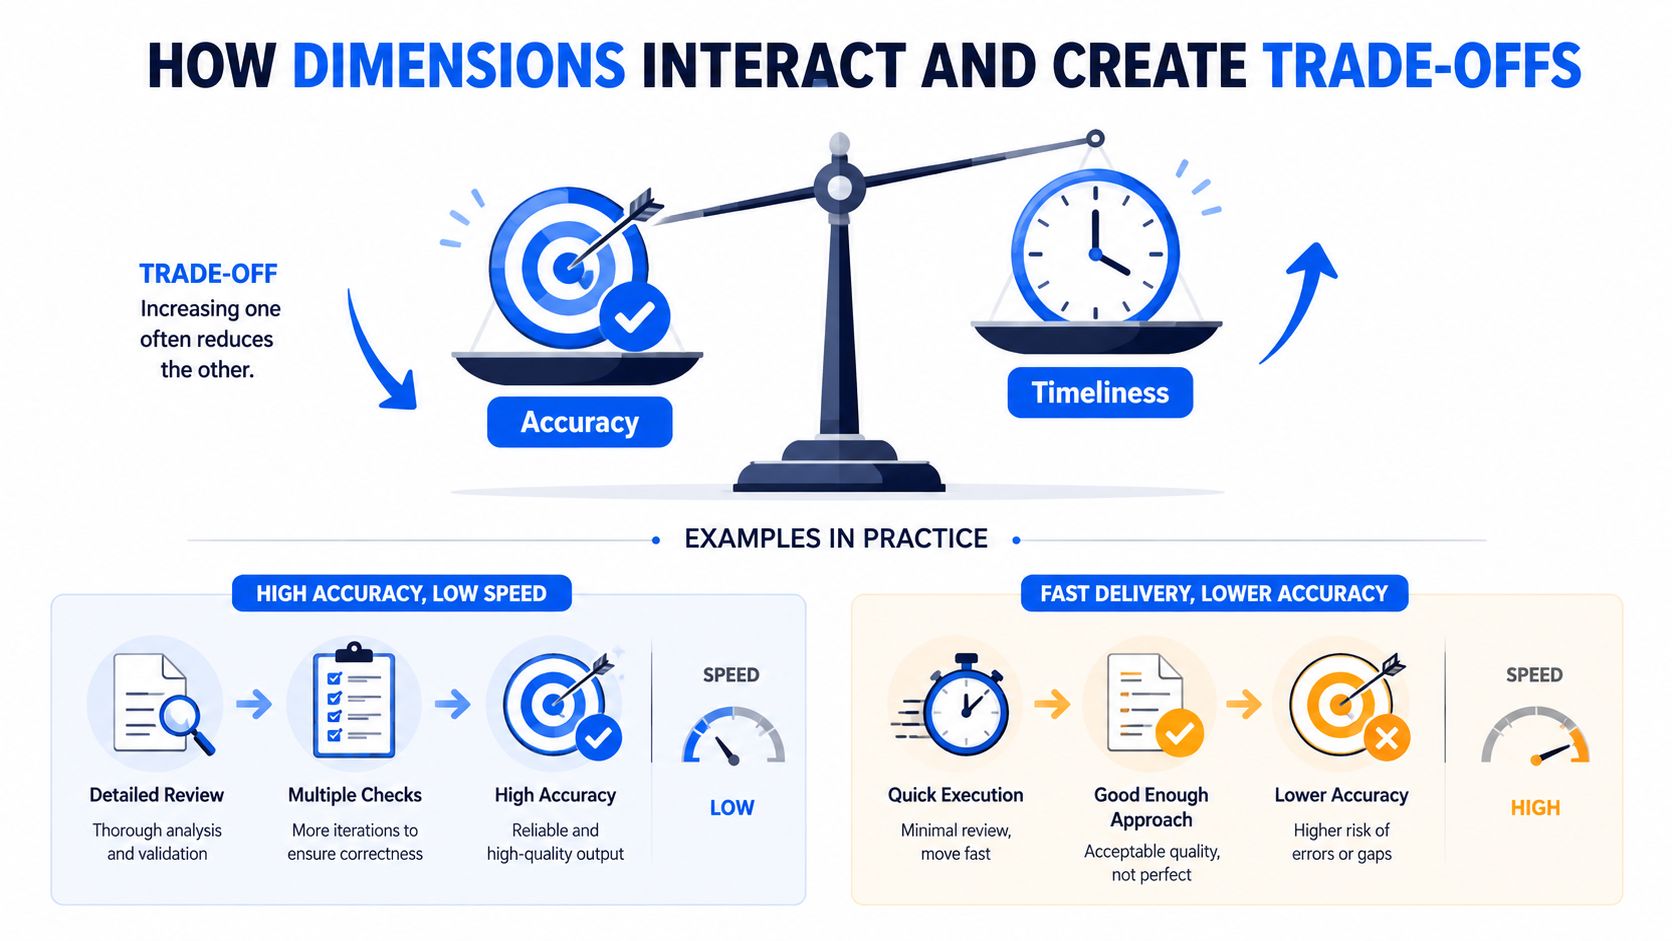
Rozważmy ładowanie hurtowni otrzymującej transakcje klientów w ciągu dnia. Zespół inżynierów może opóźnić publikację do czasu, aż uzgadnianie rozwiąże rozbieżności, poprawiając dokładność i spójność. Opóźnienie to może spowodować, że pulpit nawigacyjny ominie swoje okno decyzyjne, zmniejszając terminowość i aktualność. Natychmiastowa publikacja pozwala zachować świeżość, ale może ujawnić niekompletne lub sprzeczne rekordy.
Typowe konflikty w środowisku produkcyjnym
Dokładność a terminowość to najbardziej wyrazisty kompromis. Raport regulacyjny może uzasadniać wstrzymanie danych do czasu zakończenia uzgadniania, podczas gdy przepływ pracy związany z monitorowaniem oszustw może wymagać niedoskonałego, ale natychmi感wego sygnału. Dokonaj wyboru w oparciu o konsekwencje czekania i działania na podstawie prowizorycznych danych.
Poprawność a kompletność mogą wchodzić w konflikt podczas pozyskiwania danych. Rygorystyczna reguła może odrzucać nieprawidłowo sformatowane wartości i chronić odbiorców końcowych przed niepoprawnymi danymi. Odrzucenie może pozostawić tabelę docelową niekompletną, chyba że potok podda rekordy kwarantannie, zgłosi błąd i zapewni ścieżkę naprawczą.
Spójność a autonomia źródła tworzy kolejne napięcie. Standaryzacja statusu klienta w systemie CRM, platformie rozliczeniowej i hurtowni danych poprawia spójność, ale każdy system może używać tego pola do uzasadnionego celu lokalnego. Zarządzana definicja kanoniczna, połączona z udokumentowanymi atrybutami specyficznymi dla systemu, może działać lepiej niż wymuszanie jednolitości wszędzie.
Potok usług finansowych zazwyczaj priorytetowo traktuje dokładność, spójność, kompletność i integralność na potrzeby krytycznego raportowania biznesowego. Kanał personalizacji e-commerce może stawiać na pierwszym miejscu terminowość i aktualność, dopuszczając jednocześnie kontrolowane, opóźnione wzbogacanie danych. Żaden zestaw priorytetów nie ma zastosowania do każdego przypadku użycia.
Architektura również wpływa na ten kompromis. Potoki wsadowe mogą wstrzymać całą dostawę w celu uzgodnienia, podczas gdy systemy strumieniowe często publikują zdarzenia tymczasowe i korygują je później. Korekty te wymagają od odbiorców zrozumienia aktualizacji, wycofań i stanu rekordów.
Użytecznym celem jakościowym nie są „idealne dane”. Są to dane na tyle wiarygodne, by podjąć określoną decyzję, ze znanymi wyjątkami i odpowiedzialnymi właścicielami.
Monitoruj wymiary oddzielnie. Zestaw danych może być dokładny, ale spóźniony, lub kompletny, ale niespójny w systemach źródłowych. Jeden zagregowany wynik może ukryć awarię, która ma największe znaczenie. Oddzielne metryki pokazują kompromis, zamiast go uśredniać.
Od statycznych reguł do AI-Driven Observability
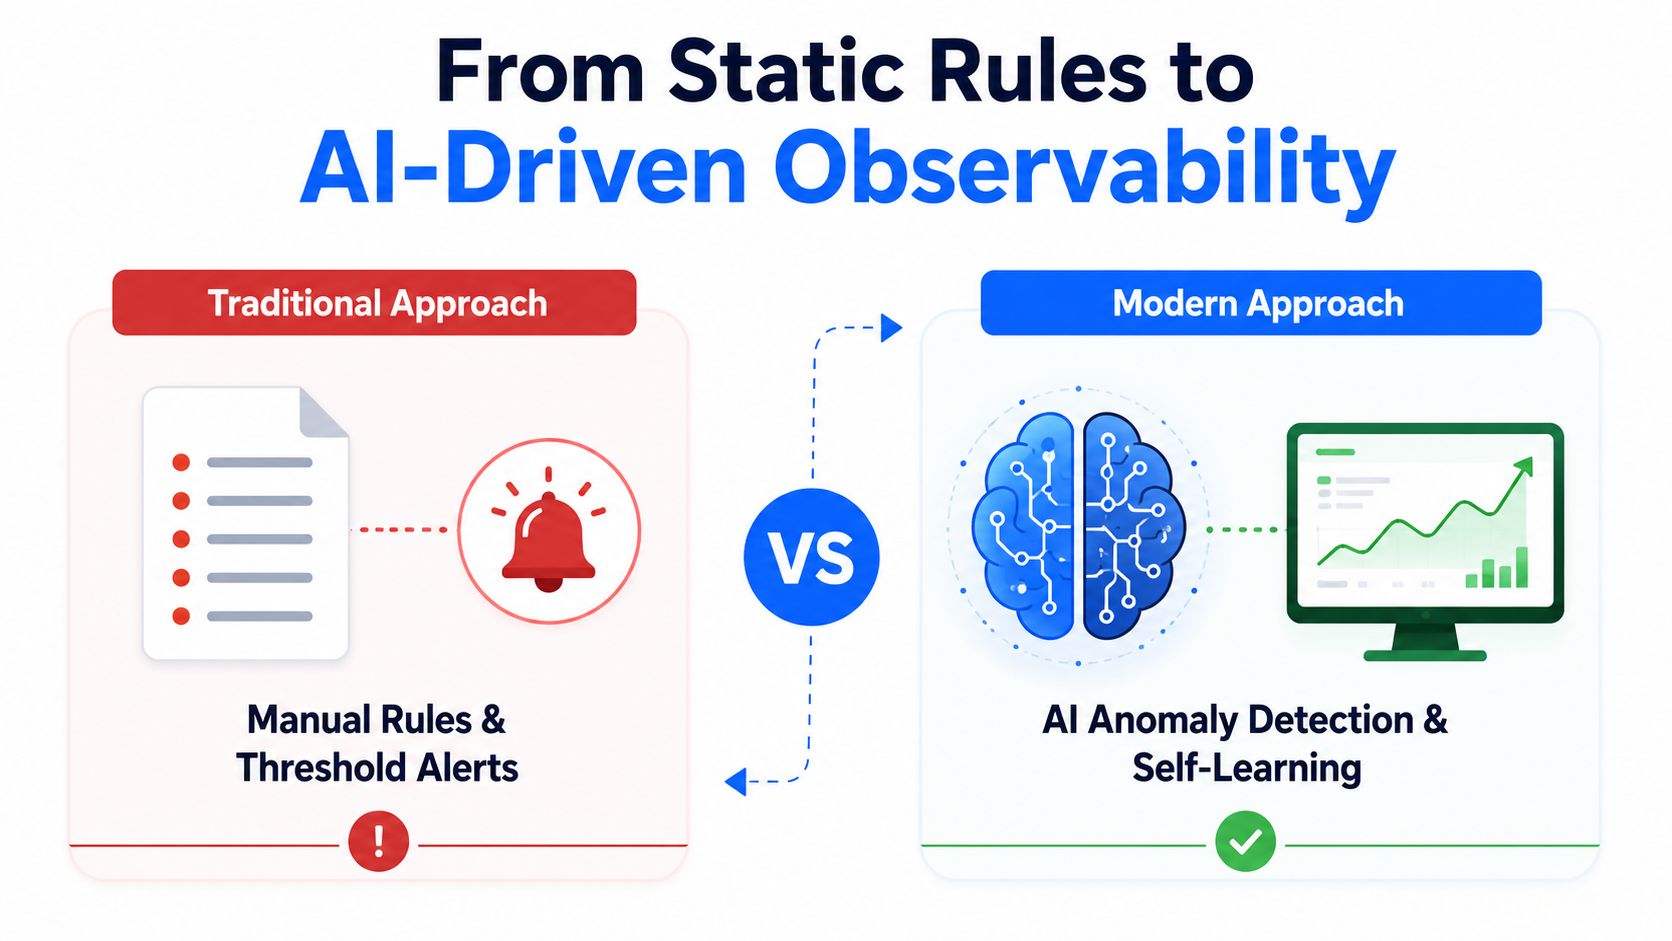
Tradycyjne monitorowanie jakości danych zależy od ręcznie pisanych testów SQL, stałych progów i alertów skonfigurowanych dla znanych trybów awarii. Te kontrole nadal mają wartość. Reguła wymagająca niepustego identyfikatora konta lub odrzucająca nieprawidłowy status jest jednoznaczna, audytowalna i łatwa do wyjaśnienia.
Słabość ujawnia się przy dużej skali. Inżynierowie muszą utrzymywać reguły w miarę zmian schematów, źródeł, procesów biznesowych i akceptowalnych zakresów. Stałe progi mogą również powodować zmęczenie alertami, gdy normalne wahania sezonowe lub operacyjne wielokrotnie wyzwalają ostrzeżenia. Testy oparte na regułach wykrywają to, co zespoły przewidziały, ale mogą przeoczyć nietypowe przesunięcia w rozkładach, wolumenach lub relacjach, których nikt nie zakodował.
Co wnosi observability
Nowoczesne Observability łączy deterministyczne kontrole z historycznymi liniami bazowymi, wykrywaniem anomalii, kontekstem pochodzenia danych (lineage) i przepływami pracy związanymi z obsługą incydentów. Zamiast pytać tylko, czy przekroczono sztywno zakodowany próg, platforma może ocenić, czy bieżące zachowanie różni się od ustalonego wzorca zestawu danych.
Takie podejście jest szczególnie przydatne w przypadku metryk takich jak liczba wierszy, rozkłady wartości, zachowanie wartości null i czas dostarczania. Nie eliminuje to reguł biznesowych. Uzupełnia je, obejmując nieoczekiwane zachowania, których statyczna walidacja może nie przewidzieć. Zespoły badające observability oparte na AI mogą również zapoznać się z wyjaśnieniem AI observability autorstwa Doczen, aby uzyskać kontekst dotyczący monitorowania systemów powiązanych z AI i zachowania danych.
Rynek wykracza również poza ustrukturyzowane tabele w hurtowniach danych. Badanie branżowe z 2025 roku wykazało, że 62% organizacji badało dane częściowo ustrukturyzowane, 28% aktywnie z nich korzystało, a 60% oceniało nieustrukturyzowane dokumenty (trendy w data observability na rok 2025). To samo źródło wykazało dojrzałość w zakresie observability na poziomie 88% w Ameryce Północnej w porównaniu z 47% w Europie, co pokazuje, że adopcja jest nierównomierna w różnych regionach.
Logi, dokumenty, strumienie zdarzeń i multimodalne korpusy AI wymagają różnych interpretacji kompletności i spójności. W przypadku kolekcji dokumentów kompletność może dotyczyć oczekiwanych plików, pól możliwych do wyodrębnienia lub użytecznego tekstu. Dla strumienia zdarzeń terminowość może zależeć od wzorców przychodzenia, a nie od codziennego odświeżania tabeli.
Zespoły mogą skorzystać z przeglądu data observability w digna, aby zrozumieć, jak ciągłe monitorowanie współgra z walidacją, wykrywaniem anomalii, śledzeniem terminowości i monitorowaniem schematów. Dobry projekt zachowuje jawne reguły dla znanych wymagań i wykorzystuje nauczone zachowania do identyfikacji odchyleń, które zasługują na zbadanie.
Wybór odpowiednich wymiarów dla Twojego przypadku użycia
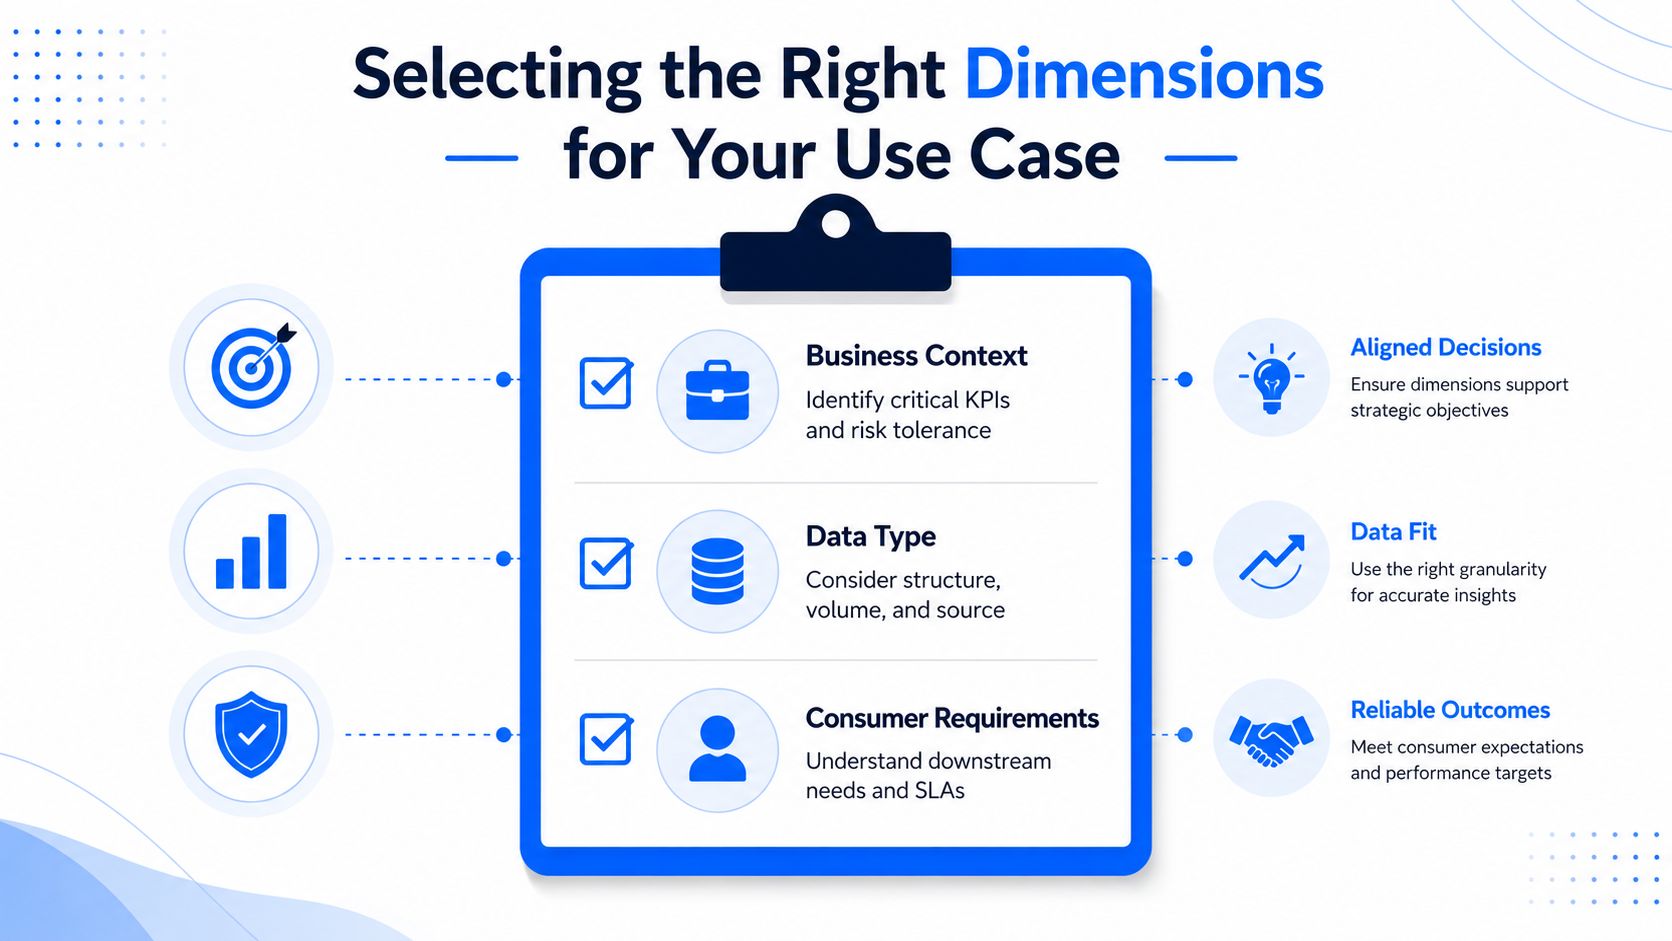
Jak zespół powinien wybierać spośród wymiarów jakości danych? Zacznij od decyzji biznesowej, zidentyfikuj elementy danych, które na nią wpływają, zrozum, jak dane przemieszczają się przez architekturę, a następnie ustal priorytety dla trybów awarii o najpoważniejszych konsekwencjach operacyjnych, regulacyjnych lub finansowych.
Ankieta z 2025 roku wskazuje, że dziedzina ta jest szersza i bardziej zależna od kontekstu niż statyczna lista kontrolna. Dodaje ona wymiary takie jak dostępność, compliance, reputacja, przenaszalność i aktualność, zwracając jednocześnie uwagę, że praktyczne wskazówki dotyczące kompromisów i ustalania priorytetów są nadal ograniczone (badanie wymiarów jakości danych).
Praktyczna metoda priorytetyzacji
Raportowanie regulacyjne zazwyczaj zaczyna się od dokładności, kompletności, spójności i integralności. Zespół powinien zidentyfikować źródło prawdy (source of record), uzgodnić kluczowe sumy, zweryfikować dozwolone wartości i zachować dowody wyjątków. Terminowość nadal ma znaczenie, ale akceptowalne okno dostawy może być zdefiniowane przez proces raportowania, a nie operacje w czasie rzeczywistym.
Analityka w czasie rzeczywistym kładzie większy nacisk na terminowość i aktualność. Pulpit nawigacyjny pokazujący bieżące warunki operacyjne może wprowadzać w błąd, gdy przesył danych jest opóźniony, nawet jeśli każdy dostarczony rekord jest dokładny. Kompletność i spójność pozostają ważne, szczególnie gdy użytkownicy porównują metryki na żywo z historycznymi danymi z hurtowni.
Magazyny cech dla AI i uczenia maszynowego (feature stores) wymagają silnej kontroli poprawności, unikalności, terminowości i integralności. Nieprawidłowe wartości cech mogą zepsuć transformacje lub zniekształcić prognozy, duplikaty mogą nadmiernie obciążyć podmioty, a nieaktualne cechy mogą błędnie przedstawiać bieżące zachowanie. Odpowiednie kontrole powinny być zgodne z definicjami cech modelu i oczekiwaniami dotyczącymi ich serwowania.
Krytyczne elementy danych (Critical Data Elements – CDE) zasługują na szerszy zakres ochrony niż atrybuty o niskim ryzyku. CDE może wspierać raport regulacyjny, proces identyfikacji klienta, obliczenia finansowe lub cechę modelu. Monitoruj dla niego kilka odpowiednich wymiarów, przypisz odpowiedzialnego właściciela i zdefiniuj, co się dzieje, gdy kontrola zakończy się niepowodzeniem.
Użyteczny pierwszy krok wygląda następująco:
Zmapuj odbiorcę: Zidentyfikuj, kto korzysta z danych i jaka decyzja od nich zależy.
Prześledź ścieżkę: Udokumentuj źródłową bazę danych, transformacje ETL lub ELT, tabele w hurtowni i produkty końcowe.
Nazwij awarię: Wybierz wymiary w oparciu o realne tryby awarii, a nie ogólną listę kontrolną.
Ustal reakcję: Zdecyduj, czy zablokować, poddać kwarantannie, ostrzec czy zarejestrować wyjątek.
Rozwijaj się stopniowo: Zacznij od elementów danych o najwyższym ryzyku, a następnie rozszerzaj monitorowanie w miarę wzrostu odpowiedzialności i gromadzenia dowodów.
Dla zespołów projektujących mierzalne kontrole, metryki jakości danych digna oferują odpowiedni punkt odniesienia do łączenia wymiarów z pomiarami operacyjnymi.
Wdrażanie ciągłego monitorowania jakości danych
Ciągłe monitorowanie oznacza, że kontrole jakości działają w miarę przesyłania i zmian danych, a nie podczas okresowego audytu. Różnica ta ma znaczenie, ponieważ opóźniony przesył danych może wpłynąć na pulpit nawigacyjny lub magazyn cech jeszcze przed kolejnym zaplanowanym przeglądem. Terminowość jest osobnym technicznym wymiarem, ponieważ dane tracą wartość biznesową, gdy nie są dostępne w oczekiwanym czasie. Zazwyczaj ocenia się ją pod kątem harmonogramów dostaw, progów opóźnień lub umów SLA dotyczących świeżości danych; dotyczy ona tego, czy dane są przetwarzane bez opóźnień, czy są aktualne i odpowiednie do zadania (badania nad terminowością danych).
Praktyczne wdrożenie można rozpocząć od jednej hurtowni o wysokiej wartości lub domeny bazy danych. Sprofiluj jej normalne zachowanie, obserwuj wzorce dostarczania i zidentyfikuj, które kolumny oraz tabele wspierają krytyczne dla biznesu przepływy pracy. Następnie dodaj kontrole odpowiadające ryzyku, zamiast próbować monitorować każdy obiekt naraz.
Modułowy model operacyjny
Platforma taka jak digna może służyć jako przykład podejścia modułowego. Zespoły mogą zacząć od modułu Data Anomalies do uczenia się linii bazowej, a następnie dodać monitorowanie Timeliness dla brakujących lub opóźnionych ładowań, Data Validation dla reguł biznesowych na poziomie rekordów oraz Schema Tracker dla dodanych, usuniętych lub zmodyfikowanych pól.
Wdrożenie powinno chronić dane tam, gdzie już się znajdują. Wykonywanie operacji wewnątrz bazy danych (in-database execution) pozwala platformie obliczać metryki i przeprowadzać analizy w bazach danych klienta, co ogranicza niepotrzebny transfer danych i wspiera środowiska o rygorystycznych wymaganiach bezpieczeństwa. Wdrożenie może mieć miejsce w chmurze prywatnej lub lokalnie (on-premises), w zależności od infrastruktury i modelu governance organizacji.
Ciągłe monitorowanie potrzebuje również kontekstu operacyjnego. Wspólny pulpit nawigacyjny powinien łączyć alerty z tabelą, której dotyczą, potokiem, właścicielem i odbiorcą końcowym. Integracje z harmonogramami, katalogami i narzędziami do współpracy pomagają zespołom przejść od wykrycia do diagnozy bez konieczności tworzenia osobnego, ręcznego procesu.
Najważniejszą decyzją projektową jest polityka reagowania. Nieudana reguła poprawności może zablokować wydanie, podczas gdy nietypowa metryka może wygenerować alert do zbadania. Brak dostawy może wezwać inżyniera dyżurnego w przypadku krytycznego strumienia danych, ale wygenerować powiadomienie o niższym priorytecie dla nieistotnego zestawu danych. Monitorowanie działa wtedy, gdy pomaga ludziom działać, a nie gdy generuje niefiltrowany strumień ostrzeżeń.
Użyj możliwości monitorowania jakości danych digna jako punktu odniesienia dla sposobu, w jaki wykrywanie anomalii, walidacja, terminowość i kontrole schematów mogą być łączone w bieżącym modelu operacyjnym.
Budowanie strategii jakości danych
Zarządzanie jakością danych to ciągła praktyka definiowania, mierzenia, monitorowania i poprawiania jakości danych w całej organizacji. Łączy ona kontrole techniczne z odpowiedzialnością, definicjami biznesowymi, reagowaniem na incydenty i governance.
Praktyczna ścieżka rozwoju to:
Przeprowadzenie audytu stanu obecnego: Sprofilowanie priorytetowych baz danych, tabel w hurtowniach, potoków i raportów końcowych.
Zidentyfikowanie CDE: Oznaczenie elementów danych, których awaria mogłaby wpłynąć na compliance, przychody, operacje, klientów lub wyniki modeli AI.
Ustalenie priorytetów dla wymiarów: Wybór wymiarów odpowiadających przypadkowi użycia i ryzyku każdego CDE.
Wdrożenie monitorowania: Połączenie jawnej walidacji z monitorowaniem anomalii, terminowości i schematów.
Przegląd i ulepszanie: Wykorzystanie incydentów i opinii interesariuszy do udoskonalania reguł, progów, odpowiedzialności i zakresu monitorowania.
Główny wniosek jest prosty: jakość jest wielowymiarowa, priorytetyzowana i ciągła. Ręczne reguły wciąż mają swoje miejsce, ale potrzebują kontekstu, odpowiedzialności i monitorowania, które potrafi wykryć zarówno znane naruszenia, jak i nieoczekiwane zachowania.
digna dostarcza korporacyjną platformę do zarządzania jakością danych i data observability, która służy do monitorowania zachowania danych, walidacji rekordów, śledzenia terminowości, wykrywania zmian schematów oraz analizowania metryk biznesowych i platformowych wewnątrz własnego środowiska klienta. Odwiedź digna, aby poznać modułowe podejście do ciągłego monitorowania w hurtowniach danych, jeziorach danych, bazach danych i potokach.



Poznaj zespół tworzący platformę
Zespół z Wiednia, składający się z ekspertów od AI, danych i oprogramowania, wspierany rygorem akademickim i doświadczeniem korporacyjnym.