Symulacja Monte Carlo: Praktyczny przewodnik dla zespołów zajmujących się danymi
|
8
min. czyt.

O 2:00 w nocy miesięczny pulpit nawigacyjny przychodów gwałtownie rośnie. Dyżurny inżynier danych otrzymuje powiadomienie, sprawdza ostatnie uruchomienie potoku i nie znajduje żadnego oczywistego błędu. Liczba ta może reprezentować rzeczywistą zmianę biznesową, częściowe ładowanie upstream lub cichą zmianę schematu, która zmodyfikowała metrykę. Odpowiedź zależy od instynktu, ponieważ zespół nie ma ilościowego poglądu na to, jak prawdopodobne jest każde z tych wyjaśnień.
Symulacja Monte Carlo zastępuje to pojedyncze zgadywanie rozkładem prawdopodobnych wyników. Poprzez wielokrotne próbkowanie niepewnych danych wejściowych zespół może oszacować prawdopodobieństwo awarii potoku, dryfu KPI lub naruszenia umowy SLA dotyczącej terminowości (Timeliness). Metoda ta ma głębokie korzenie w prawdopodobieństwie i informatyce, ale jej praktyczna wartość dla zespołów zajmujących się danymi jest prosta: zamienia niepewność w sygnał operacyjny.
Spis treści
Monte Carlo dla potoków, wskaźników KPI i umów SLA dotyczących terminowości (Timeliness)
Przekształcanie wyników symulacji w monitorowanie operacyjne
Moment, w którym żałujesz, że nie uruchomiłeś Monte Carlo
Inżynier porównuje nagły wzrost przychodów z wczorajszym pulpitem nawigacyjnym, sprawdza liczbę wierszy, analizuje ostatnie notatki z wdrożenia i pyta właściciela upstream, czy coś się zmieniło. Kontrole te są przydatne, ale dają odpowiedź tylko na pytanie, czy zespół znalazł dowody na istnienie problemu. Nie odpowiadają one na ważniejsze pytanie: jak prawdopodobne jest, że raportowany przychód jest błędny?
Weryfikacja deterministyczna może wykazać, że tabela dotarła na czas i zawiera oczekiwane kolumny. Model Monte Carlo może pójść o krok dalej, reprezentując niepewność w dostarczaniu danych upstream, zachowaniu wartości null, napływie zdarzeń i wynikach transformacji. Każde symulowane uruchomienie staje się prawdopodobną wersją nocnego przetwarzania, a uzyskany wynik pokazuje, jak często wskaźnik przychodów mieści się w dopuszczalnym zakresie lub poza nim.
Praktyczna zasada: Traktuj wartość z pulpitu nawigacyjnego jako obserwację obarczoną niepewnością, a nie jako niepodważalną prawdę.
To rozróżnienie zmienia reakcję na incydent. Jeśli większość symulowanych wyników potwierdza zaobserwowany skok, a dane wejściowe potoku wyglądają normalnie, inżynier może badać rzeczywiste zdarzenie biznesowe z większą pewnością. Jeśli wiele prawdopodobnych przebiegów daje znacząco inną wartość przy tych samych warunkach upstream, zespół ma dowód na to, by nadać priorytet Data Validation, zanim kadra kierownicza podejmie decyzje na podstawie pulpitu nawigacyjnego.
Od intuicji do prawdopodobieństwa
Metoda ta nie jest zarezerwowana do analizy kryzysowej. Nocna symulacja pozwala oszacować prawdopodobieństwo, że wieloetapowy potok zakończy się przed wyznaczonym terminem dostawy. Model monitorowania biznesowego może oszacować, czy ruch KPI jest spójny z częściowymi wartościami null i późno docierającymi rekordami. Model terminowości (Timeliness) może oszacować, jak często spowolnienie na dalszych etapach spycha dane poza oczekiwania dotyczące poziomu usług.
Zmiana myślenia jest niewielka, ale istotna. Zamiast pytać: „Czy ten potok ulegnie awarii?”, zapytaj: „W ilu prawdopodobnych wersjach dzisiejszej nocy kończy się on awarią i które założenia wpływają na ten wynik?”. To pytanie daje inżynierom danych mierzalną podstawę do alertów, eskalacji i priorytetyzacji.
Symulacja Monte Carlo została sformalizowana podczas Projektu Manhattan w latach 40. XX wieku, kiedy Stanislaw Ulam i John von Neumann zastosowali powtarzane próby losowe do problemów takich jak dyfuzja neutronów, które były niepraktyczne do bezpośredniego rozwiązania. Nazwa została przyjęta w 1949 roku przez Nicolasa Metropolis, łącząc tę metodę z przypadkiem i kasynem w Monako, jak opisano w tym historycznym ujęciu metod Monte Carlo.
Czym jest symulacja Monte Carlo
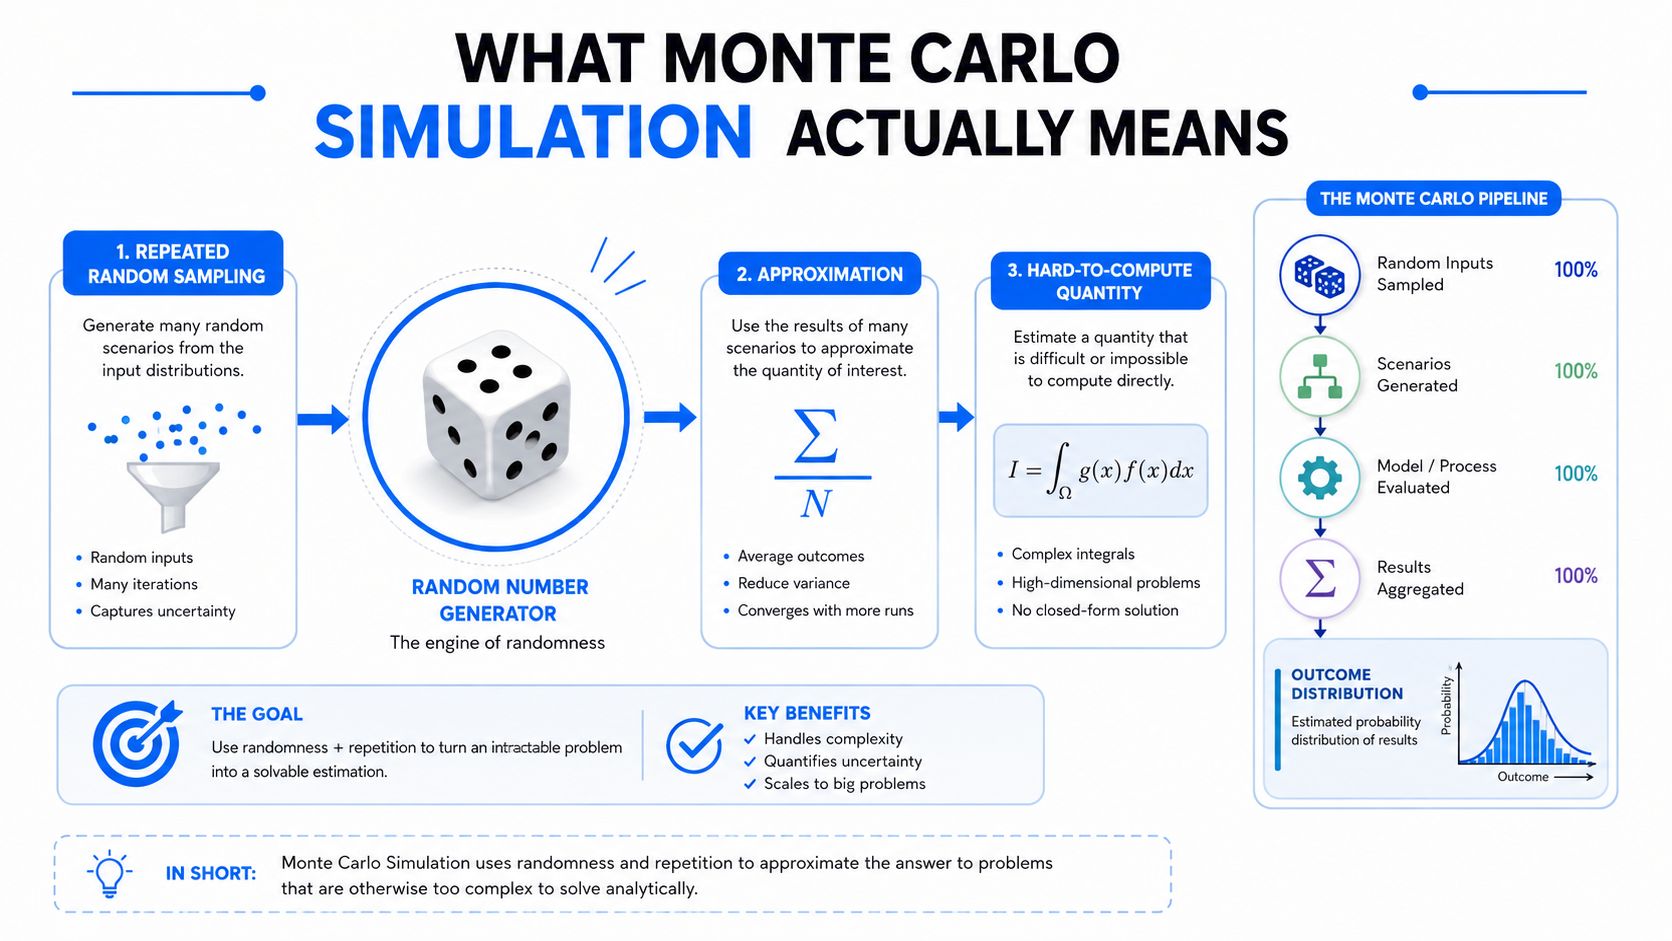
Symulacja Monte Carlo to wielokrotne losowe próbkowanie stosowane do przybliżenia wartości, która jest trudna do obliczenia analitycznego. Algorytm próbuje prawdopodobne stany, ocenia model dla każdego z nich i podsumowuje wyniki.
Rozważmy potok z pięcioma etapami upstream. Każdy etap może zakończyć się niepowodzeniem, opóźnić się lub dostarczyć niekompletne dane. Kalkulacja w pamięci może sugerować ryzyko jednego etapu, ale zależności i zmieniające się warunki sprawiają, że łączny wynik jest trudny do bezpośredniego obliczenia. Symulacja reprezentuje niepewność każdego etapu, tworzy jedną prawdopodobną wersję uruchomienia potoku, rejestruje, czy spełniła ona swój cel, i powtarza ten proces w wielu symulowanych uruchomieniach.
Model myślowy definiują trzy elementy składowe:
Model systemu: etapy, zależności, transformacje i kryteria sukcesu.
Niepewne dane wejściowe: zachowanie w przypadku awarii, czas przetwarzania, wskaźniki wartości null, opóźnienia zdarzeń lub inne zmienne reprezentowane przez rozkłady prawdopodobieństwa.
Agregator wyników: funkcja rejestrująca wynik każdego uruchomienia, taka jak status zakończenia, wartość KPI lub naruszenie umowy SLA.
Wynikiem jest rozkład odpowiedzi, a nie jedna rzekomo idealna wartość. Analitycy mogą badać prawdopodobieństwo awarii, zakres prawdopodobnych wartości KPI lub percentyl oczekiwanego czasu dostawy. Ma to znaczenie w Observability, ponieważ stan potoku rzadko pasuje do czystej granicy binarnej. Tabela może dotrzeć na czas, zawierając jednocześnie nietypowe wartości, lub przejść walidację, nadal zwiększając ryzyko na dalszych etapach.
Dlaczego wielokrotne próbkowanie działa
Wpływowe spostrzeżenie Stanisława Ulama polegało na zastąpieniu wyczerpujących obliczeń wieloma losowymi próbami. Encyklopedia Britannica używa pasjansa jako analogii: powtarzane gry pozwalają oszacować szansę na wygraną bez obliczania każdej możliwej sekwencji. To samo podejście wspiera całkowanie numeryczne, optymalizację, statystykę bayesowską oraz symulacje systemów fizycznych, biologicznych i społecznych, co podsumowano w tych notatkach z wykładów o Monte Carlo.
Dla inżyniera danych metafora kasyna jest mniej użyteczna niż rozdzielenie struktury modelu od próbkowanych danych wejściowych. Logika potoku pozostaje stała, podczas gdy niepewne wartości zmieniają się z każdym uruchomieniem. Wynikowy rozkład ujawnia ryzyko ukryte przez prognozę jednopunktową i daje platformie Observability, takiej jak digna, możliwość powiązania symulowanej awarii, dryfu KPI i ryzyka terminowości (Timeliness) z monitorowaniem operacyjnym.
Jak działa ta metoda krok po kroku
Zacznij od precyzyjnego zdefiniowania wyniku potoku. Na przykład uruchomienie kończy się sukcesem, gdy każdy wymagany etap zostanie zakończony przed wyznaczonym terminem dostawy i wygeneruje dane, które przejdą odpowiednie kontrole jakości. Naruszenie występuje, gdy jakikolwiek wymagany warunek nie zostanie spełniony.
Algorytm wykonuje następnie pięć praktycznych kroków:
Modelowanie etapów. Wypisz każdą zależność upstream i sposób, w jaki jej stan wpływa na ostateczny wynik.
Przypisanie rozkładów. Przedstaw niepewne zachowanie w przypadku awarii i czas przetwarzania za pomocą rozkładów opartych na dostępnej historii lub ocenie dziedzinowej.
Pobranie jednej próbki na etap. Każde uruchomienie tworzy jedną prawdopodobną wersję nocy.
Agregacja wyników. Zarejestruj, czy potok zakończył się pomyślnie, naruszył umowę SLA, czy też wygenerował niedopuszczalne KPI.
Powtarzanie i badanie stabilności. Kontynuuj próbkowanie, aż kluczowe szacunki wyników staną się wystarczająco stabilne do podjęcia decyzji.
Poniższy przykład wykorzystuje bibliotekę NumPy do losowego próbkowania i pandas do podsumowania. Symuluje on tysiąc nocy potoku, a następnie oblicza zaobserwowany udział uruchomień, które naruszyły umowę SLA.
Prawdopodobieństwa w tym fragmencie kodu są symbolami zastępczymi dla danych wejściowych modelu, a nie faktami produkcyjnymi. Wiarygodna implementacja oszacowałaby je na podstawie historycznych obserwacji potoku, przeanalizowała zależności między etapami i uwzględniła charakterystykę czasu przetwarzania, zamiast traktować każdą awarię jako identyczną.
Krok | Cel | Konstrukcja kodu |
|---|---|---|
Modelowanie etapów | Reprezentowanie testowanego systemu |
|
Próbkowanie niepewności | Generowanie prawdopodobnych stanów etapów |
|
Agregacja wyniku | Decyzja, czy potok uległ awarii |
|
Powtarzanie przebiegów | Budowanie rozkładu wyjściowego |
|
Podsumowanie ryzyka | Konwersja wyników na szacunkowe prawdopodobieństwo |
|
Aby uzyskać uzupełniający widok na to, jak sygnały statystyczne mogą wspierać monitorowanie danych, zobacz statystyczne rozpoznawanie wzorców. Kolejnym wyzwaniem jest uczynienie działającego skryptu na tyle niezawodnym, by mógł służyć do podejmowania decyzji operacyjnych. Wymaga to celowego próbkowania, kontroli zbieżności i redukcji wariancji.
Próbkowanie, zbieżność i redukcja wariancji
Zwykłe próbkowanie losowe jest domyślnym wyborem, ponieważ jest łatwe do wdrożenia i ma szerokie zastosowanie. Jego błąd maleje wraz z pierwiastkiem kwadratowym z liczby próbek, więc dodatkowe uruchomienia poprawiają precyzję stopniowo, a nie w magiczny sposób eliminują niepewność. Zachowanie to wynika z prawa wielkich liczb, którego silne i słabe formy stanowią podstawę zbieżności Monte Carlo, jak wyjaśniono w tym artykule referencyjnym na temat zbieżności Monte Carlo.
Ta zależność ma znaczenie, gdy zespół interpretuje prawdopodobieństwo naruszenia. Niewielka zmiana między dwoma uruchomieniami może odzwierciedlać szum próbkowania, a nie znaczącą zmianę w bazowym potoku. Śledź średnią ruchomą, badaj standardowy błąd Monte Carlo i porównuj szacunki u niezależnych wykonawców lub w łańcuchach. Test Gelmana-Rubina (R-hat) może pomóc zidentyfikować, czy równoległe łańcuchy się wymieszały, chociaż nie naprawia błędnie określonego modelu.
Wybór właściwej strategii próbkowania
Próbkowanie warstwowe dzieli domenę wejściową na rozłączne warstwy i pobiera próbki w ramach każdej z nich. Poprzez usunięcie składnika wariancji między warstwami, może ono znacznie zmniejszyć wariancję, zwłaszcza gdy potok ma odrębne tryby pracy, takie jak dni powszednie, obciążenia na koniec miesiąca lub znane okna wydań (Release). Mechanizm ten został opisany w tym technicznym opracowaniu na temat próbkowania warstwowego.
Próbkowanie według ważności przyjmuje inne podejście. Pobiera więcej próbek z obszarów, w których funkcja celu jest większa, co może przyspieszyć zbieżność, gdy interesujące nas zdarzenie jest rzadkie lub wysoce skoncentrowane, jak opisano w tym przewodniku po ulepszaniu całkowania Monte Carlo.
Technika | Jak działa | Najlepsze dopasowanie w Data Observability | Na co uważać |
|---|---|---|---|
Zwykłe próbkowanie losowe | Losuje niezależnie ze zdefiniowanych rozkładów | Ogólne modele potoków i KPI | Powolny wzrost precyzji dla rzadkich naruszeń |
Próbkowanie warstwowe | Próbkuje w ramach oddzielnych obszarów wejściowych | Różne okna obciążeń lub tryby potoków | Słabe warstwy mogą zwiększyć złożoność bez użytecznego pokrycia |
Próbkowanie według ważności | Koncentruje losowania na obszarach o dużym wpływie | Rzadkie awarie i skrajne zdarzenia SLA | Nieprawidłowe ważenie może obciążyć estymator |
Zmienne antytetyczne | Paruje komplementarne losowania | Szacunki KPI z łagodną charakterystyką odpowiedzi | Mniej przydatne, gdy model jest nieciągły |
Zmienne kontrolne | Używa skorelowanej, znanej wartości odniesienia | Metryki ze stabilną linią bazową operacji | Wymaga niezawodnej relacji kontrolnej |
Szersza rodzina metod redukcji wariancji obejmuje również wspólne liczby losowe, warunkowanie, zmienne antytetyczne, zmienne kontrolne, próbkowanie warstwowe oraz próbkowanie według ważności, co udokumentowano w tym przeglądzie metod redukcji wariancji Monte Carlo. Wskazówki dotyczące wdrażania analizy statystycznej w procesach Observability można znaleźć w artykule metody statystyczne do analizy danych.
Monte Carlo dla potoków, wskaźników KPI i umów SLA dotyczących terminowości (Timeliness)
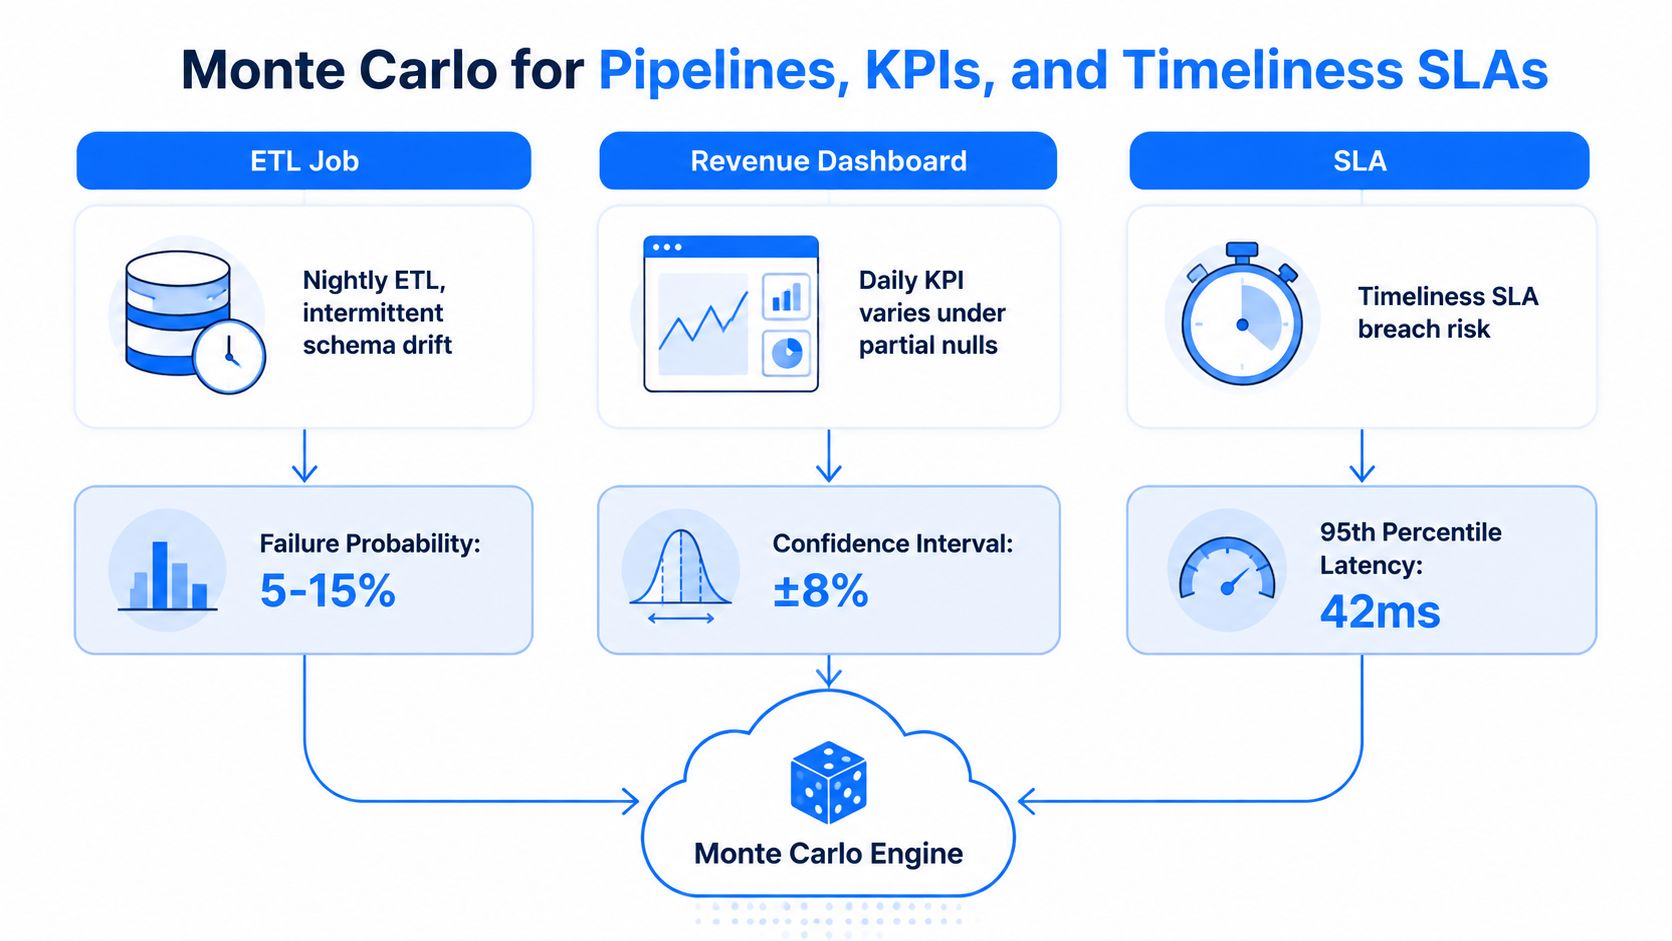
Nocny proces ETL może kończyć się sukcesem przez większość czasu, podczas gdy sporadyczny dryf schematu może czasami popsuć transformację na dalszym etapie. Pulpit nawigacyjny przychodów może wykazać gwałtowną zmianę, ponieważ część rekordów dotarła z opóźnieniem lub część wartości stała się nullem. Umowa SLA dotycząca świeżości może pozostać technicznie zgodna, podczas gdy opóźnienie przetwarzania stale zbliża się do limitu.
Są to różne problemy operacyjne, ale mają ten sam kształt. Dane wejściowe są niepewne, model łączy je z wynikiem, a użytecznym rezultatem jest rozkład prawdopodobieństwa, a nie binarny status.
Trzy historie dotyczące Observability
W przypadku procesu ETL model próbkuje dostępność etapów, kompatybilność schematów i czas przetwarzania. Każde uruchomienie daje odpowiedź na pytanie, czy cały przepływ pracy kończy się przed oczekiwanym momentem dostawy. Wynikiem monitorowania może być wskaźnik ryzyka awarii z przypisanym powiązaniem (lineage) do tabel i transformacji upstream, które w największym stopniu przyczyniają się do symulowanego ryzyka.
Dla pulpitu nawigacyjnego przychodów model próbkuje zachowanie częściowych wartości null, późno docierające zdarzenia i wpływ tych warunków na kalkulację KPI. Zamiast uznawać każdy ruch za anomalię, zespół może porównać zaobserwowaną wartość z symulowanym przedziałem i podjąć badanie, gdy obserwacja wykracza poza oczekiwany rozkład.
Monitorowanie terminowości (Timeliness) przebiega według tego samego wzorca. Model próbkuje zachowanie związane z napływem i przetwarzaniem danych, a następnie ocenia, czy wynikowy czas dostawy przekracza próg SLA. Prawdopodobieństwo naruszenia może wyzwolić alert, zanim faktyczna dostawa spóźni się z realizacją celu, pod warunkiem, że dane wejściowe i zależności są skalibrowane względem historii operacyjnej.
Od rozkładów do alertów
Platforma Observability może wykorzystać wyniki symulacji na kilka sposobów:
Ryzyko awarii: wysyłanie alertu, gdy prawdopodobieństwo awarii potoku przekroczy próg zdefiniowany przez zespół.
Niepewność KPI: pokazywanie zaobserwowanej metryki obok jej symulowanego zakresu, a następnie kierowanie do zbadania, gdy wartość odbiega od tego zakresu.
Ryzyko SLA: eskalacja, gdy przewidywane prawdopodobieństwo naruszenia rośnie, nawet jeśli bieżące obciążenie jeszcze nie uległo awarii.
Kontekst powiązań (lineage): powiązanie wyniku ze zbiorami danych i transformacjami upstream, które wpływają na symulowany wynik.
Alert nie powinien informować jedynie o tym, że liczba jest nietypowa. Powinien wyjaśniać, czy nietypowy wynik jest spójny ze znanym zachowaniem danych wejściowych, które założenia generują ryzyko i na jakie elementy na dalszych etapach może to wpłynąć. Zespoły tworzące kontrole terminowości mogą skorzystać z tego przewodnika po metrykach terminowości danych (Timeliness), aby dopasować wyniki symulacji do istniejących definicji świeżości.
Skalowanie Monte Carlo wewnątrz bazy danych
Notatnik jest użytecznym miejscem do walidacji modelu, ale staje się słabą granicą wykonania, gdy dane źródłowe zawierają miliony wierszy, a symulacja wielokrotnie potrzebuje tej samej historii przechowywanej w hurtowni danych. Pobieranie próbek przez sieć generuje dodatkowy ruch danych, tworzy kolejne środowisko do zabezpieczenia i oddziela obliczenia od systemu będącego właścicielem danych operacyjnych.
Wykonywanie zadań wewnątrz bazy danych odwraca tę granicę. Funkcje użytkownika SQL, operacje na tablicach i wektoryzowany kod Python uruchamiany na silniku danych mogą utrzymać próbkowanie blisko źródła. Hurtownia może przydzielać zasoby obliczeniowe zgodnie ze swoim modelem wykonawczym, podczas gdy przycinanie partycji ogranicza odczyty do odpowiedniej historii.

Praktyczny podręcznik skalowania
Zacznij od lokalizacji danych. Przechowuj historyczne dane wejściowe, parametry rozkładu, próbkowane wartości i podsumowania wyników tam, gdzie już działa monitorowanie na dalszych etapach. Unikaj wywołań funkcji losowych dla pojedynczych wierszy, gdy wektoryzowana lub natywna dla hurtowni operacja losowa może wydajniej generować partię danych.
Następnie dostrój plan wykonania:
Grupowanie według wykonawców: Wybierz rozmiar partii, który zapewni zajęcie procesorów bez wyczerpywania pamięci.
Przycinanie partycji: Odczytuj tylko te okna czasowe i zasoby, które są potrzebne do kalibracji.
Wektoryzacja obliczeń: Operuj na tablicach lub zbiorach zamiast wywoływać model wiersz po wierszu.
Zapisywanie podsumowań: Przechowuj percentyle i prawdopodobieństwa naruszeń zamiast zachowywać każde pośrednie losowanie, jeśli pozwalają na to wymogi audytu.
Rozdzielenie kalibracji od oceniania: Aktualizuj dopasowanie rozkładów według kontrolowanego harmonogramu, a następnie częściej uruchamiaj lekkie zadania oceniania.
Użyteczny test architektury porównuje dwa przepływy pracy: uruchomienie 100 000 iteracji wewnątrz bazy danych kontra eksportowanie próbek do notatnika. Opcja wewnątrz bazy danych pozwala uniknąć transferu sieciowego i może ponownie wykorzystać wydajność hurtowni, podczas gdy opcja z notatnikiem może wymagać dodatkowej serializacji, pamięci lokalnej i przesyłania danych. Rzeczywisty koszt i opóźnienie zależą od silnika, złożoności modelu, układu partycji i alokacji zasobów, dlatego należy przetestować obie ścieżki na reprezentatywnych danych, zamiast zakładać, że jedna z nich jest uniwersalnie tańsza.
Szersze wyjaśnienie dotyczące utrzymywania obliczeń jakości blisko danych w hurtowni można znaleźć w artykule wykonywanie kontroli jakości danych w bazie danych. Zasada projektowania jest prosta: przenieś logikę symulacji do danych zawsze, gdy wielokrotne transfery miałyby stać się wąskim gardłem.
Pułapki, walidacja i miejsca, w których założenia zawodzą
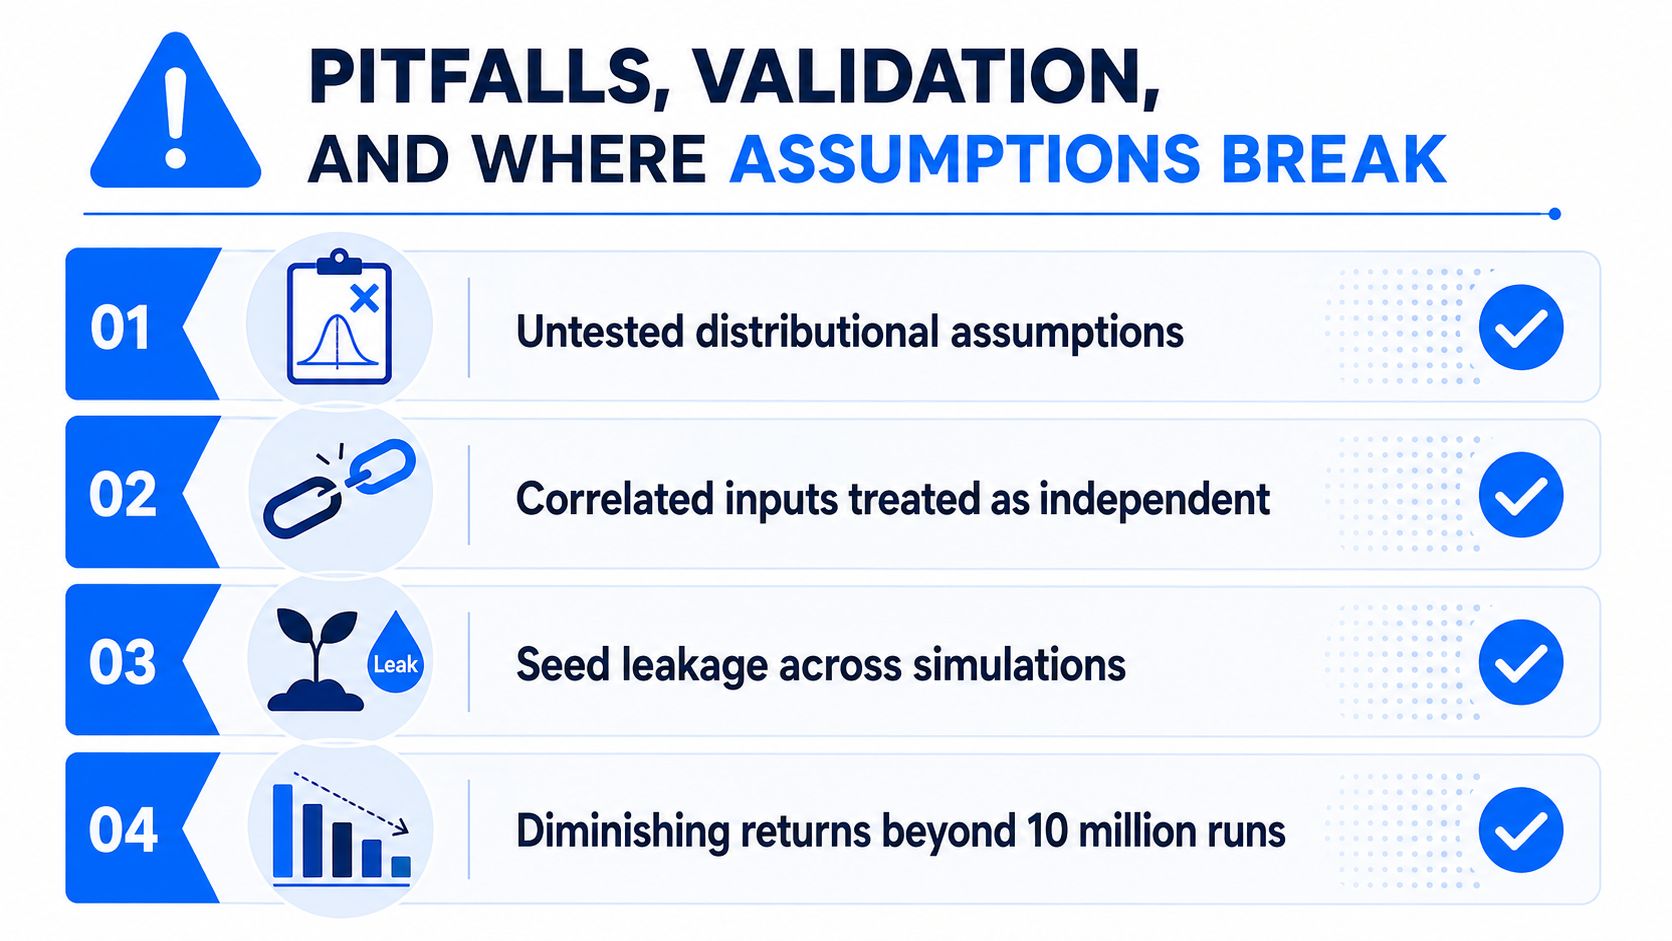
Większa liczba uruchomień nie uratuje modelu, który jest strukturalnie nierealistyczny. Mogą one sprawić, że obarczone błędem systematycznym szacunki będą wydawać się stabilne, ponieważ symulacja wielokrotnie pobiera próbki z tych samych błędnych założeń.
Najpoważniejsze problemy pojawiają się zazwyczaj jeszcze przed wykonaniem obliczeń:
Niezweryfikowane rozkłady: Rozkład normalny lub statyczny może nie odzwierciedlać skośności, zmian reżimu działania ani skrajnych przypadków operacyjnych.
Fałszywa niezależność: Skorelowane dane wejściowe, takie jak opóźnienie upstream i czas oczekiwania w kolejce downstream, mogą być próbkowane tak, jakby były od siebie niezależne.
Wyciek ziarna (seed): Współdzielone lub słabo zarządzane ziarna generatora losowego mogą powodować niezamierzone zależności między uruchomieniami.
Dryf populacji: Ciche zmiany schematu lub zmieniająca się struktura ruchu mogą unieważnić populację historyczną użytą do kalibracji.
Zbieżność w wąskim reżimie: Szacunek bieżący może wyglądać na stabilny, wykluczając jednocześnie istotny tryb operacyjny.
Najnowsza literatura poświęcona modelowaniu ryzyka zwraca uwagę na podobne problemy strukturalne, w tym statyczne rozkłady, stałe macierze korelacji, słabą spójność makroekonomiczną i wysokie zapotrzebowanie na moc obliczeniową. Główna lekcja brzmi: realizm strukturalny ma tak samo duże znaczenie jak losowe próbkowanie, szczególnie w regulowanych środowiskach finansowych i analizy ryzyka, co omówiono w tej analizie ograniczeń generowania scenariuszy Monte Carlo.
Działania walidacyjne wykrywające błędy systematyczne
Przeprowadź testy wsteczne (backtesting) symulowanych wskaźników awaryjności na podstawie logów incydentów z ostatnich 90 dni, traktując okno historyczne jako punkt odniesienia do walidacji, a nie jako dowód na to, że przyszłość będzie wyglądać identycznie. Sprawdź dopasowanie każdego brzegowego rozkładu wejściowego, zbadaj zależności między ważnymi zmiennymi i przeprowadź analizę wrażliwości dla 20% parametrów, które generują 80% wariancji, gdy zostaną one określone na podstawie analizy, a nie założone z góry.
Powtarzalność wymaga również więcej niż jednego stałego ziarna (seed). Uruchom model ponownie z nowym ziarnem i porównaj kluczowe percentyle, prawdopodobieństwa naruszeń oraz klasyfikacje alertów. Duże zmiany mogą wskazywać na niewystarczające próbkowanie, niestabilne ogony rozkładu lub zbyt czuły model.
Lista kontrolna diagnostyki po zmianie
Po każdej zmianie modelu zweryfikuj czy:
Populacja wejściowa nadal pasuje do monitorowanych zasobów.
Rozkłady brzegowe i zależności pozostają prawdopodobne.
Niezależne ziarna (seeds) dają porównywalne wyniki decyzji.
Diagnostyka zbieżności obejmuje metryki używane do generowania alertów.
Testy wsteczne nie wykazują systematycznego niedoszacowania awarii.
Założenia oraz wersja modelu są zapisywane przy każdym wyniku.
Symulacja powinna zdobywać zaufanie operacyjne poprzez walidację, a nie samą liczbę iteracji.
Przekształcanie wyników symulacji w monitorowanie operacyjne
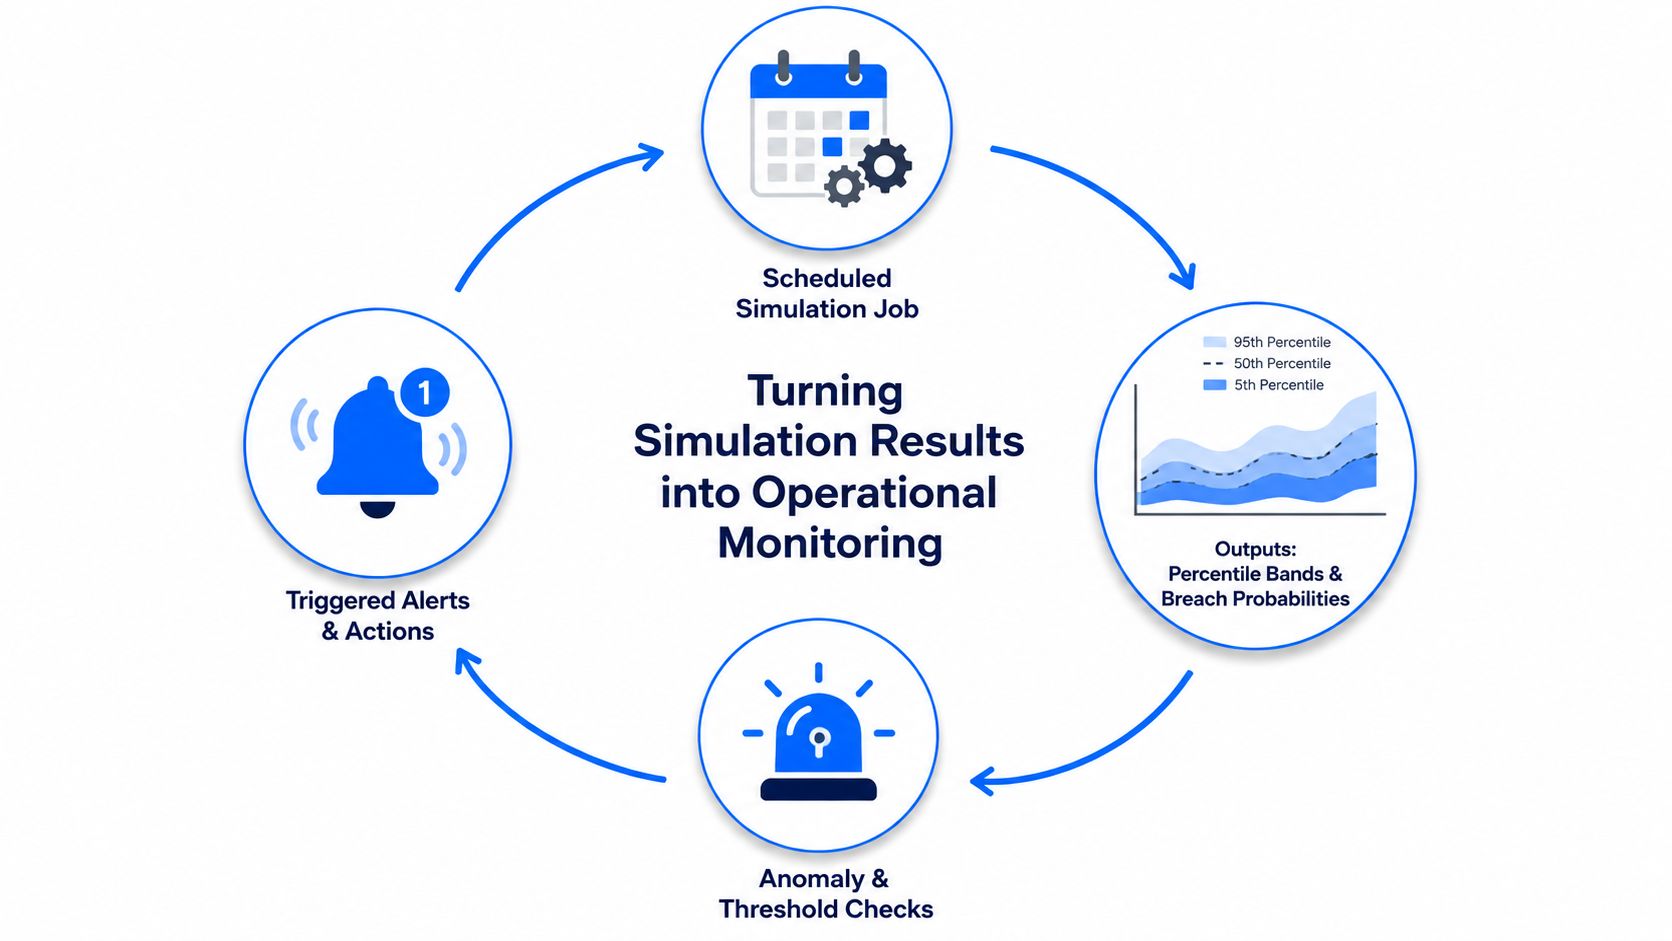
Produkcyjny proces Monte Carlo to pętla, a nie notatnik. Zaplanowane zadanie kalibruje lub ładuje aktualne rozkłady wejściowe, uruchamia model, zapisuje przedziały percentyli i prawdopodobieństwa naruszeń, a następnie przekazuje te wyniki do tych samych kontroli anomalii i progów, które obsługują inne sygnały Observability.
Najbardziej użyteczna codzienna tabela zestawia ze sobą wartości przewidywane i zaobserwowane. W przypadku KPI przechowuj zaobserwowany pomiar, odpowiedni symulowany zakres, prawdopodobieństwo powiązane z zaobserwowanym ruchem, wersję modelu i znacznik czasu uruchomienia. Dla potoku przechowuj przewidywane ryzyko awarii, rzeczywisty wynik oraz zasoby upstream użyte do wygenerowania szacunku.
Lista kontrolna integracji
Harmonogramowanie modelu: Uruchamiaj kalibrację i ocenianie z częstotliwością odpowiednią do monitorowanego zachowania.
Utrzymywanie dowodów: Przechowuj rozkłady, ziarna (seeds) lub polityki ziaren, wersje modeli oraz podsumowania wyników.
Łączenie sygnału: Przesyłaj prawdopodobieństwa naruszeń i odchylenia percentyli do logiki wykrywania anomalii i progów.
Kierowanie działań: Wysyłaj alerty do istniejących kanałów obsługi incydentów wraz z informacją o powiązaniach (lineage) i sugerowanym kontekście badania.
Przegląd wyników: Porównuj prognozy z zaobserwowanymi awariami i aktualizuj założenia w przypadku zmiany zachowania.
Takie podejście pasuje do architektury Observability działającej wewnątrz bazy danych, w której symulacje są wykonywane blisko danych, a wyniki trafiają obok metryk walidacji, schematu, anomalii i terminowości (Timeliness). Warstwa raportowania, taka jak monitorowanie i raportowanie danych, może następnie zaprezentować zaobserwowaną metrykę i jej przewidywany rozkład w tym samym widoku operacyjnym.
digna dostarcza platformę korporacyjną, która przeprowadza analizę jakości danych i Observability wewnątrz środowiska klienta, w tym wykrywanie anomalii, monitorowanie terminowości (Timeliness), walidację, śledzenie schematów oraz metryki biznesowe lub platformowe. Odwiedź digna, aby ocenić, jak jej podejście oparte na bazie danych może połączyć sygnały ryzyka Monte Carlo z procesami monitorowania, z których już korzysta Twój zespół ds. danych.
Najczęściej zadawane pytania
Co symulacja Monte Carlo mówi zespołowi danych?
Wielokrotnie losując niepewne wejścia, szacuje prawdopodobieństwo, że potok zawiedzie, wskaźnik odpłynie albo zostanie naruszone SLA dla Timeliness. Zastępuje jedno przypuszczenie rozkładem prawdopodobnych wyników dokładnie dla tych pytań operacyjnych.
Jakie są trzy bloki budulcowe modelu?
Model systemu obejmujący etapy, zależności, transformacje i kryteria sukcesu; niepewne wejścia, takie jak zachowanie awarii, czas przetwarzania, udział wartości pustych czy opóźnienia zdarzeń, wyrażone jako rozkłady prawdopodobieństwa; oraz agregator wyjścia zapisujący rezultat każdego przebiegu, na przykład status zakończenia, wartość wskaźnika albo naruszenie SLA.
Jak zmienia to reagowanie na incydenty?
Zmienia znaczenie wartości na pulpicie. Kontrola deterministyczna potwierdzi może, że tabela dotarła na czas z oczekiwanymi kolumnami, a model Monte Carlo odwzorowuje niepewność dostawy wyżej w łańcuchu, zachowania wartości pustych, dotarcia zdarzeń i wyników transformacji. Traktuj wartość na pulpicie jako obserwację obarczoną niepewnością.
Kto sformalizował symulację Monte Carlo?
Sformalizowano ją podczas Projektu Manhattan w latach czterdziestych, gdy Stanisław Ulam i John von Neumann zastosowali powtarzane próby losowe do zagadnień takich jak dyfuzja neutronów, trudnych do rozwiązania wprost. Nicolas Metropolis przyjął tę nazwę w 1949 r., wiążąc metodę z przypadkiem i kasynem w Monako.
Czy Monte Carlo może działać wewnątrz hurtowni?
Tak, i skalowanie go tam jest zwykle praktyczną drogą. Trzymanie losowania i agregacji blisko danych pozwala uniknąć przenoszenia dużych wolumenów dla analizy, której całym celem jest opisanie, jak te dane zachowują się przy prawdopodobnych wahaniach.


