Sterownik JDBC dla SQL Server: Przewodnik konfiguracji i instalacji
|
8
min. czyt.
Połączenie z SQL Server może wyglądać na stabilne przez miesiące, dopóki rutynowa poprawka, aktualizacja JVM lub odświeżenie zależności nie uczyni go kruchym z dnia na dzień. Najgorsze są te przypadki, które nie ulegają awarii w głośny sposób, ale działają ociężale z ostrzeżeniami o certyfikatach, zawieszonymi sesjami w puli lub zachowaniem typów danych, które zmienia się na tyle subtelnie, że psuje logikę przetwarzania końcowego. Dlatego sterownik JDBC dla SQL Server powinien być traktowany jak zarządzana zależność, a nie jednorazowa instalacja.
Zespoły zwykle zaczynają od parametrów połączenia i przechodzą do innych zadań. Środowisko produkcyjne ma tendencję do ujawniania ukrytej pracy: dopasowania wersji sterownika, kompatybilności środowiska uruchomieniowego Java, walidacji TLS, wyboru trybu uwierzytelniania, dostrajania puli oraz planowania cyklu życia wsparcia. Historia własnego sterownika Microsoftu pokazuje długi łuk konserwacji – sterownik wprowadzono w 2000 roku, a jego kod źródłowy udostępniono w 2016 roku, po czym wydawano go w wersjach takich jak 1.0 w styczniu 2006, 2.0 w marcu 2009, 3.0 w kwietniu 2010, 4.0 z 6 marca 2017, a późniejsze wersje, w tym 4.1, 6.0, 7.0 i 8.4, osiągały z czasem własne kamienie milowe wsparcia Informacje o wydaniu sterownika Microsoft JDBC. Ta oś czasu mówi wiele: sterownik ewoluuje wraz z platformą, a Twoje podejście produkcyjne musi ewoluować wraz z nim.
Spis treści
Wybór właściwej wersji sterownika i środowiska uruchomieniowego Java
Przykładowe konfiguracje dla pozyskiwania danych i wykonywania wewnątrz bazy danych
Dlaczego konfiguracja sterownika JDBC wymaga uwagi
Znana awaria zaczyna się od wdrożenia, które wczoraj wyglądało dobrze. Potok łączy się, wstawia kilka wierszy, a potem pojawia się poprawka SQL Server. Następnego ranka zadanie zaczyna zgłaszać błędy uzgadniania połączenia (handshake) tylko na niektórych hostach lub, co gorsza, działa dalej, podczas gdy serwer odrzuca styl połączenia, do którego klient powrócił.
Tego rodzaju awarie są powszechne, ponieważ błędna konfiguracja JDBC często pozostaje niezauważona przez inżynierów. Interfejs API REST zazwyczaj ulega awarii na granicy systemu. Z kolei sterownik bazy danych może powodować subtelne szkody operacyjne: nieświeże sesje w puli, zduplikowane ponowienia prób, pomijanie certyfikatów lub zachowanie danych, które zmienia się tylko pod obciążeniem. Cykl życia sterowników Microsoftu sprawia, że jest to tym bardziej istotne, ponieważ starsze główne wersje tracą główne wsparcie, podczas gdy nowsze wersje stale dodają zachowania dostosowane do platformy informacje o wydaniu i macierz wsparcia.
Ukryty koszt podejścia „byle się łączyło”
Działające połączenie nie oznacza bezpiecznego połączenia. Sterownik Microsoft JDBC jest sterownikiem JDBC typu 4, więc komunikuje się bezpośrednio z protokołem TDS systemu SQL Server w czystej Javie, bez bibliotek natywnych. Microsoft deklaruje, że obsługuje on Azure SQL Database, bazę danych SQL w Fabric, Azure SQL Managed Instance oraz wszystkie wspierane wersje i edycje SQL Server, w tym edycje Express przegląd sterownika. Ta szeroka kompatybilność jest użyteczna, ale ułatwia również przeoczenie błędnej konfiguracji, dopóki nie zostanie użyte konkretne środowisko uruchomieniowe, łańcuch certyfikatów lub funkcja serwera.
Zasada praktyczna: jeśli sterownik JDBC nigdy nie był testowany z dokładną wersją JVM, kompilacją sterownika i poziomem poprawek SQL Server w środowisku produkcyjnym, oznacza to, że nie został naprawdę przetestowany.
Zmiana tkwi w nastawieniu. Przestań myśleć o sterowniku jak o zwykłej instalacji hydraulicznej, a zacznij traktować go jako wersjonowaną zależność środowiska uruchomieniowego z określonymi granicami bezpieczeństwa i cyklu życia. Takie podejście zapobiega zakładaniu, że domyślne właściwości, aktualizacja Javy lub poprawka SQL Server mogą być zignorowane tylko dlatego, że aplikacja nadal się uruchamia.
Wybór właściwej wersji sterownika i środowiska uruchomieniowego Java
Wybór sterownika decyduje o stabilności środowiska uruchomieniowego i ciągłości wsparcia. Microsoft publikuje jednocześnie wiele linii sterowników, więc właściwy wybór zależy od używanego środowiska uruchomieniowego Java, funkcji SQL Server, z których korzystasz, oraz od tego, jak dużą presję na aktualizację możesz znieść bez powodowania przestojów. Najnowsza ogólnodostępna wersja (GA) sterownika to 13.4, wydana 13 marca 2026 r., a Microsoft informuje, że obsługuje ona wersje Java 8, 11, 17, 21 i 25, zachowując jednocześnie stały cykl życia, który wymaga instalacji najnowszej wersji minor w ciągu 12 miesięcy od wydania w celu zachowania pełnego wsparcia informacje o wydaniu i macierz wsparcia. Ta zasada wsparcia zamienia opóźnione aktualizacje w realne ryzyko operacyjne.
Powiązanie artefaktu ze środowiskiem uruchomieniowym
Microsoft dostarcza oddzielne warianty JAR, przy czym jre8 i jre11 muszą pasować do używanej linii JVM. Dopasuj artefakt do swojej linii JVM, aby uniknąć debugowania ścieżki klas (classpath) i środowiska uruchomieniowego pod presją czasu. Wydanie 13.4 utrzymuje aktualną historię kompatybilności i jasno określa wsparcie dla Javy, co ma znaczenie w przedsiębiorstwach, gdzie stos aplikacji i platforma uruchomieniowa nie zmieniają się w tym samym tempie uwagi do wydania 13.4 GA.
Przypisz dokładną wersję sterownika w Mavenie lub Gradle, zamiast pozwalać na dryfowanie przechodnich zależności. W środowiskach odizolowanych od sieci (air-gapped) skopiuj plik JAR jako część pakietu wdrożeniowego i traktuj go jako zarządzaną zależność, a nie plik, który przypadkowo znajduje się na dysku. Sprawdź również dokładnie ścieżki klas serwera aplikacji, ponieważ starsze spakowane sterowniki mogą przesłonić wersję, którą zamierzałeś uruchomić.
Wersja sterownika | Środowisko uruchomieniowe Java | Wersje SQL Server | Kluczowe funkcje | Status wsparcia |
|---|---|---|---|---|
13.4 | 8, 11, 17, 21, 25 | Nowoczesne cele SQL Server i Azure SQL | Obsługa metadanych VECTOR i JSON, aktualizacje bezpieczeństwa, kompatybilność z Java 21 | Najnowsza wersja GA, wsparcie zależy od nowości wersji minor |
12.x | 8, 11, 17 | Szeroka kompatybilność z SQL Server | Stabilna linia bazowa dla przedsiębiorstw | Używaj tylko wtedy, gdy środowisko uruchomieniowe lub platforma blokuje nowsze linie |
11.x | 8, 11 | Starsze środowiska korporacyjne | Starszy zestaw funkcji | Często akceptowalne dla istniejących systemów (brownfield), ale nieidealne dla nowych projektów |
10.x | 8, 11 | Kompatybilność ze starszymi systemami | Zachowanie szyfrowania sprzed zmian domyślnych | Zwróć uwagę na różnice w domyślnych ustawieniach TLS |
9.x | 8 | Starsze środowiska | Podstawowa łączność | Zachowaj tylko wtedy, gdy zmuszają do tego ograniczenia platformy |
Kiedy jTDS przestaje wystarczać
jTDS wciąż pojawia się w starszych środowiskach, zwykle dlatego, że ktoś skopiował działającą konfigurację lata temu i nikt do niej nie wracał. Problemem jest dryf funkcji. Jeśli Twoje środowisko wymaga nowoczesnych ścieżek uwierzytelniania, aktualnej obsługi TLS lub nowszej semantyki SQL Server, jTDS staje się obciążeniem migracyjnym.
Używaj sterownika Microsoftu, gdy obciążenie dotyczy współczesnych funkcji SQL Server, nowszych wymagań bezpieczeństwa lub uwierzytelniania powiązanego z Azure. Jeśli pozostawiasz starszy łącznik, udokumentuj powód i ustal plan wyjścia. Niezarządzany dług techniczny staje się incydentem produkcyjnym w najmniej odpowiednim momencie.
Prawidłowe budowanie adresu URL połączenia
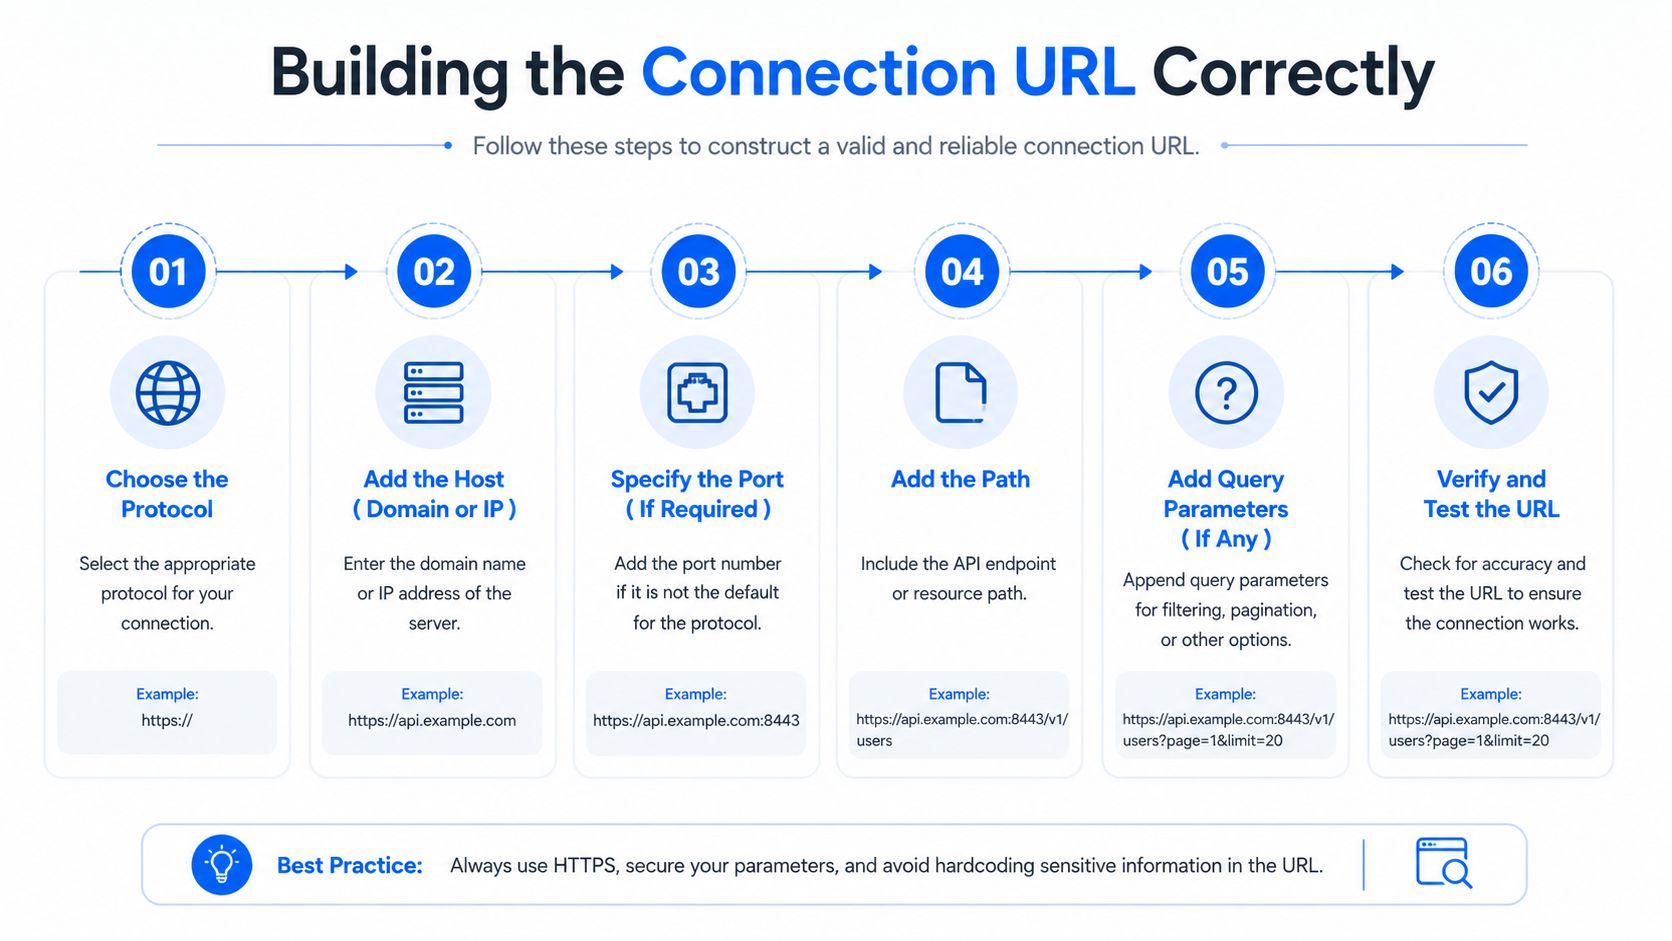
Adres URL połączenia JDBC z SQL Server pozostaje łatwy do zarządzania tylko wtedy, gdy budujesz go we właściwej kolejności. Zacznij od hosta, instancji i portu, a następnie dodaj bazę danych i właściwości, które wpływają na zachowanie. Standardowy kształt to jdbc:sqlserver://[nazwaSerwera[\nazwaInstancji][:numerPortu]][;właściwość=wartość[;właściwość=wartość]], a Microsoft pozwala na umieszczenie tych właściwości w adresie URL, w obiekcie Properties przekazywanym do DriverManager.getConnection lub za pomocą setterów SQLServerDataSource dokumentacja adresu URL połączenia. Składnia jest rygorystyczna, rozdzielana średnikami, a zduplikowane właściwości są odrzucane.
W przypadku potoków pozyskiwania danych parametry połączenia są jedną z części większej ścieżki operacyjnej. Przewodnik digna po potokach pozyskiwania danych to przydatne przypomnienie, że ustawienia sterownika muszą przetrwać przekazywanie między środowiskami, zadaniami i narzędziami wdrożeniowymi.
Budowanie od celu sieciowego na zewnątrz
Zacznij od punktu końcowego, potem instancji lub portu, następnie bazy danych, a na końcu właściwości. Taka sekwencja zapobiega ukryciu prostego błędu w hoście lub porcie wewnątrz długiego ciągu opcji.
W przypadku zachowania właściwości znaczenie mają szczegóły praktyczne:
Właściwość
applicationNamema domyślną wartośćMicrosoft JDBC Driver for SQL Serveri jest ograniczona do 128 znaków, więc ustaw ją jawnie, jeśli chcesz, aby śledzenie po stronie serwera było użyteczne właściwości połączenia.Właściwość
databaseNamerównież ma limit 128 znaków, a w przeciwnym razie następuje powrót do domyślnej bazy danych serwera właściwości połączenia.Właściwość
connectRetryCountma domyślną wartość 1 i może wynosić od 0 do 255 właściwości połączenia.Właściwość
connectRetryIntervalma domyślną wartość 10 sekund i może wynosić od 1 do 60 sekund właściwości połączenia.
Umieszczaj trwałe ustawienia w kodzie lub jako infrastrukturę jako kod, a nie w jednorazowych edycjach ciągów znaków, które dryfują między środowiskami.
Preferowanie właściwości DataSource dla powtarzalnych wdrożeń
Używaj właściwości DataSource dla wdrożeń z pulą połączeń. Konfiguracja oparta na setterach jest łatwa do audytowania i odporna na nadpisywanie wartości. Łatwiej jest ją również porównywać (diff), gdy ta sama definicja aplikacji jest ponownie używana w wielu ścieżkach uruchomieniowych, co jest powszechne w frameworkach takich jak HikariCP.
Wybór trybów uwierzytelniania dla środowisk korporacyjnych
Łączność z SQL Server w przedsiębiorstwach rzadko opiera się na jednym modelu uwierzytelniania. Zespoły używają uwierzytelniania SQL dla uproszczenia, zintegrowanego uwierzytelniania Windows dla zaufania domenowego, przepływów Entra ID dla integracji z chmurą oraz tożsamości zarządzanej tam, gdzie platforma to wspiera. Właściwy wybór zależy w mniejszym stopniu od preferencji, a w większym od polityki rotacji haseł, granic federacji oraz poziomu trudności, jaki jest w stanie zaakceptować zespół ds. bezpieczeństwa.
Dopasowanie trybu do modelu sieci i tożsamości
Uwierzytelnianie SQL jest proste, ale przenosi odpowiedzialność za obsługę poświadczeń z powrotem na aplikację. Jest to w porządku w przypadku odizolowanych obciążeń i krótkotrwałych wdrożeń testowych (PoC), ale rzadko stanowi najlepsze rozwiązanie z punktu widzenia ładu korporacyjnego (governance). Zintegrowane uwierzytelnianie zazwyczaj lepiej pasuje do środowisk domenowych Windows, podczas gdy Entra ID jest naturalnym wyborem, gdy organizacja korzysta już z mechanizmów kontroli tożsamości Microsoftu i wzorców dostępu opartych na tokenach.
Protokół Kerberos może być silnym rozwiązaniem w zarządzanych sieciach korporacyjnych, ale zależy od prawidłowego zachowania SPN i biletów. Jeśli SPN są błędne, zespoły często napotykają powrót do NTLM lub okresowe problemy z połączeniem, które pojawiają się tylko wtedy, gdy pula odświeża sesje. Podejścia oparte na tokenach rozwiązują inny rodzaj problemów, ale wprowadzają zależności od odświeżania i bibliotek, które muszą być zaplanowane w długo działających zadaniach.
Tryb uwierzytelniania | Wymagane właściwości | Najlepszy do | Typowe pułapki | Rotacja poświadczeń |
|---|---|---|---|---|
Uwierzytelnianie SQL | username, password | Proste konta aplikacji, starsze systemy | Rozproszenie haseł, uciążliwość ręcznej rotacji | Ręczna, zarządzana przez aplikację |
Zintegrowane uwierzytelnianie Windows | ustawienia zintegrowanego uwierzytelniania, konfiguracja powiązana z Kerberos | Środowiska korporacyjne przyłączone do domeny | Problemy z SPN, wygaśnięcie biletów, niespodzianki związane z powrotem do starszych metod | Zarządzana przez infrastrukturę tożsamości |
Zintegrowane Entra ID |
| Środowiska tożsamości zorientowane na Microsoft | Zmiany zależności bibliotecznych, luki w obsłudze tokenów | Scentralizowana rotacja tożsamości |
Tożsamość zarządzana | powiązanie tożsamości chmurowej | Obciążenia hostowane w Azure z tożsamością platformy | Niedopasowanie zakresu i środowiska | Zarządzana przez platformę |
Traktowanie odświeżania tokenów jako części projektu
Długo działające zadania pozyskiwania danych kończą się niepowodzeniem w dotkliwy sposób, gdy tokeny uwierzytelniające wygasają w środku działania puli. Nie jest to błąd sterownika, lecz niedopasowanie cyklu życia metody tożsamości do czasu trwania zadania. Najbezpieczniejszy projekt to taki, w którym cykl życia poświadczeń jest widoczny dla operatora, a nie ukryty wewnątrz puli połączeń, która ponownie używa nieświeżych sesji.
Dobre pytanie decyzyjne jest proste: czy Twój zespół operacyjny potrafi wyjaśnić, jak rotują poświadczenia, jak odnawiają się sesje i co się dzieje, gdy jeden token wygasa, podczas gdy inny wątek korzysta z połączenia? Jeśli nie, ten tryb nie jest gotowy na wdrożenie produkcyjne.
Konfiguracja szyfrowania TLS i walidacji certyfikatów
Błędna konfiguracja TLS to najczęstsze źródło cichych awarii JDBC na produkcji. Microsoft dokumentuje ustawienia bezpieczeństwa połączenia wokół encrypt, trustServerCertificate, trustStore, trustStorePassword oraz hostNameInCertificate, i wyraźnie zaleca hostNameInCertificate do walidacji certyfikatów wsparcie TLS. Microsoft stwierdza również, że gdy encrypt=true i trustServerCertificate=true, sterownik nie waliduje certyfikatu TLS SQL Server, podczas gdy encrypt=true i trustServerCertificate=false dokonuje jego walidacji zachowanie szyfrowania SSL.
Nie myl szyfrowania z walidacją
Szyfrowanie i walidacja adresują różne rodzaje ryzyka. Szyfrowane połączenie, które ufa każdemu certyfikatowi, chroni kanał, ale nie tożsamość serwera. Jest to dopuszczalne w środowisku laboratoryjnym, ale stanowi słabą postawę produkcyjną dla ścieżki bazy danych.
Microsoft dokumentuje zmianę zachowania w sterowniku w wersji 10.1+, gdzie właściwość encrypt ma domyślną wartość true. Zespoły, które dokonują aktualizacji bez ponownego sprawdzenia ustawień magazynu zaufanych certyfikatów (truststore) i nazwy hosta, są zaskoczone, gdy wcześniej tolerancyjne połączenie zaczyna kończyć się niepowodzeniem. Jeśli serwer nie jest skonfigurowany do szyfrowania, Microsoft informuje, że ustawienie encrypt=true z trustServerCertificate=false zakończy się niepowodzeniem, więc zarządzanie certyfikatami i nazwami hostów staje się częścią gotowości produkcyjnej wsparcie TLS.
Wzorce produkcyjne są proste:
Programowanie z certyfikatami samopodpisanymi – używaj szyfrowania tylko wtedy, gdy akceptujesz błędy walidacji podczas testów.
Produkcja z wewnętrznymi certyfikatami CA – ustaw
encrypt=true,trustServerCertificate=falsei prawidłowo skonfiguruj truststore.Azure SQL – używaj połączeń szyfrowanych i waliduj ścieżkę certyfikatu, której oczekuje platforma.
Nazwy hostów mają większe znaczenie, niż spodziewają się zespoły
Właściwość hostNameInCertificate rozwiązuje przypadki, w których nazwa w certyfikacie serwera nie pokrywa się z celem połączenia klienta. Microsoft zaleca tę właściwość dokładnie przy takim niedopasowaniu, co zamienia niejasny błąd TLS w przejrzystą zmianę konfiguracji wsparcie TLS.
Maszyny JVM z włączonym standardem FIPS wprowadzają kolejną warstwę ryzyka. Kolejność dostawców może przerwać uzgadnianie połączenia (handshake), jeśli JVM rozwiązuje pierwotne mechanizmy TLS w nieoczekiwanej kolejności. Zmiany utwardzające zabezpieczenia tego typu wymagają testów zbliżonych do warunków produkcyjnych, przy zachowaniu tej samej polityki bezpieczeństwa, która będzie stosowana na produkcji.

Strojenie puli połączeń i mechanizmu ponawiania prób
Domyślne ustawienia puli są zazwyczaj zbyt łagodne dla obciążeń inżynierii danych. Zakładają one krótkie żądania, skromną współbieżność i bazę danych, która zawsze jest gotowa do natychmiastowej odpowiedzi. Nie pasuje to do nagłych skoków obciążeń ETL, zdarzeń przełączania awaryjnego (failover) czy zapytań analitycznych, które blokują sesje dłużej niż cykl żądania sieciowego.
Oddzielenie błędu połączenia od błędu zapytania
Właściwości loginTimeout i socketTimeout rozwiązują różne problemy, więc nie powinny być traktowane jako jedno pokrętło. Połączenie może nie otworzyć się szybko lub może się otworzyć, a następnie zawiesić podczas aktywności sieciowej bądź wykonywania zapytania. Jeśli oba limity czasu (timeouts) pozostaną nieokreślone, pula będzie czekać, podczas gdy wątki zaczną się piętrzyć za niedziałającymi połączeniami.
Wbudowane ustawienia ponawiania prób Microsoftu są na tyle specyficzne, że warto ich używać celowo. Właściwość connectRetryCount ma domyślną wartość 1, a connectRetryInterval domyślnie wynosi 10 sekund właściwości połączenia. Te wartości domyślne są dobre na początek, ale nie zastępują walidacji na poziomie puli i polityki obsługi błędów.
Właściwość | Zapytania OLTP | Masowe pozyskiwanie | Zapytania analityczne | Wartość domyślna |
|---|---|---|---|---|
loginTimeout | Krótki | Umiarkowany | Umiarkowany | Niewskazana w zweryfikowanych danych |
socketTimeout | Krótki | Dłuższy | Dłuższy | Niewskazana w zweryfikowanych danych |
queryTimeout | Krótki | Umiarkowany | Dłuższy | Niewskazana w zweryfikowanych danych |
connectRetryCount | Niski do umiarkowanego | Umiarkowany | Umiarkowany | 1 |
connectRetryInterval | Krótki | Umiarkowany | Umiarkowany | 10 sekund |
Dostrajanie pod kątem obciążenia, a nie szablonu
Obciążenia OLTP wymagają szybkiego zgłaszania błędów i sprawnej rotacji pobierających połączenia. Masowe pozyskiwanie wymaga cierpliwości podczas obciążenia sieci i serwera. Zapytania analityczne plasują się gdzieś pośrodku – potrzebują wystarczająco dużo czasu na zakończenie bez wyczerpywania puli, ale nie na tyle, aby jedno błędne żądanie bezterminowo blokowało zasoby.
W pracy nad niezawodnością pomocnym źródłem jest przewodnik digna po inżynierii niezawodności baz danych, ponieważ zachowanie sterownika i odporność bazy danych są w środowisku produkcyjnym nierozłączne. Pula, która ponawia próby zbyt agresywnie, może nasilić awarię, podczas gdy pula, która zbyt szybko zgłasza błąd, może wyolbrzymić przejściowe zakłócenia do poziomu incydentów widocznych dla użytkownika.
Zasada praktyczna: dostosuj rozmiar puli do rzeczywistej współbieżności, a nie do maksymalnej liczby wątków, jaką może utworzyć serwer aplikacji.
Strategia walidacji również ma znaczenie. Opcja testOnBorrow wcześniej wychwytuje uszkodzone sesje, podczas gdy testWhileIdle rozkłada koszt walidacji w czasie. Wybierz podejście pasujące do Twojej tolerancji na błędy przełączania awaryjnego (failover) oraz tolerancji na pobranie nieświeżego połączenia podczas krótkiej awarii SQL Server.
Wsparcie dla nowoczesnych typów danych i funkcji SQL Server
Nowoczesne funkcje SQL Server wyprzedzają większość dokumentacji JDBC. Sterownik nie jest już tylko warstwą transportową – decyduje o tym, czy Twoja aplikacja może bez niespodzianek zachować nowszą semantykę serwera, zachowanie bezpieczeństwa i kształt metadanych.
Wydanie 13.4 od Microsoftu dodaje kompatybilność z Java 21 oraz ulepszenia wsparcia dla nowszych możliwości SQL Server, takich jak obsługa metadanych VECTOR i JSON, wraz z poprawkami bezpieczeństwa dla wielu podatności CVE i bez wprowadzania zmian psujących API uwagi do wydania 13.4 GA. Ma to znaczenie produkcyjne, ponieważ sterownik może wyglądać na stabilny, a jednocześnie nie posiadać elementów niezbędnych do prawidłowej interpretacji nowego zachowania serwera.
Weryfikacja wsparcia dla funkcji przed aktualizacją serwera
Zespoły często najpierw aktualizują SQL Server, a potem odkrywają, że sterownik nie potrafi poprawnie obsłużyć nowego zachowania. Rezultatem są zazwyczaj obcięte wartości, błędy konwersji lub wywołania metadanych, które nie pasują do kształtu nowszych typów. Uwagi do wersji 13.2 i 13.4 pokazują stały rozwój natywnego wsparcia dla typów danych JSON i VECTOR, a także ulepszenia związane z kopiowaniem masowym (bulk copy) i obsługą metadanych wydanie 13.2, uwagi do wydania 13.4 GA.
Traktuj wersję sterownika jako element weryfikacji nowej funkcji. Jeśli aplikacja zależy od szyfrowania kolumn, tożsamości opartej na tokenach lub routingu tylko do odczytu (read-scale routing), zweryfikuj te ustawienia z dokładną wersją sterownika przed wdrożeniem zmian na serwerze. Dopasowanie środowiska uruchomieniowego Java również ma znaczenie, jako że wersja 13.4 wprost wskazuje kompatybilność z Java 21. Dla obciążeń, w których kształt zapytania i dostęp do metadanych ściśle ze sobą współdziałają, przydatnym uzupełnieniem jest przewodnik digna po optymalizacji zapytań T-SQL.
Funkcja SQL Server | Minimalna wersja sterownika JDBC | Wymagana właściwość połączenia | Symptom awarii w przypadku braku wsparcia |
|---|---|---|---|
Wsparcie dla typu danych JSON | 13.2 | Konfiguracja uwzględniająca funkcję | Niezgodności konwersji lub metadanych |
Wsparcie dla typu danych VECTOR | 13.2 | Konfiguracja uwzględniająca funkcję | Brakująca lub nieprawidłowa obsługa natywna |
Kompatybilność z Java 21 | 13.4 | Dopasowanie środowiska uruchomieniowego Java | Niezgodność środowiska uruchomieniowego |
Walidacja certyfikatu TLS po IP (SAN IP) | 13.4 | Konfiguracja TLS | Błąd walidacji przy łączeniu przez IP po TLS |
Modernizacja zintegrowanego uwierzytelniania Entra | 13.4 |
| Przepływ tożsamości zależy od nowszych komponentów uwierzytelniania |
Założenie, że semantyka może się zmienić, nawet gdy API pozostaje bez zmian
Sterownik może się nadal ładować, a Twój kod kompilować, podczas gdy pod maską zmienia się zachowanie. Objawia się to najczęściej wtedy, gdy obciążenie miesza wywołania metadanych, wymuszanie zabezpieczeń i ewoluujące typy danych.
Audyt sterownika przed wdrożeniem serwera kosztuje mniej niż incydent po wdrożeniu. Na to właśnie warto poświęcić czas.
Przykładowe konfiguracje dla pozyskiwania danych i wykonywania wewnątrz bazy danych
Wsadówkowe pozyskiwanie danych i wykonywanie analityczne wymagają przeciwstawnych strategii limitów czasu (timeout) i ponawiania prób. Użycie jednego profilu dla drugiego prowadzi do cichej degradacji wydajności. Zadania pozyskiwania wymagają przestrzeni na przejściowe przeciążenia oraz konfiguracji sterownika, która zapewnia płynny ruch wsadowy. Wykonywanie analiz wymaga szybszego zgłaszania błędów na zablokowanych sesjach, rygorystycznej walidacji i jasnej identyfikacji zadań, aby ślady serwera pozostały czytelne.
Profil pozyskiwania danych
Zadanie zorientowane na operacje masowe wymaga okna czasowego gniazda (socket window) na tyle długiego, by przetrwać chwilowe przeciążenie, oraz ustawień pozwalających sterownikowi sprawnie przesyłać paczki danych. Traktuj wersję sterownika jako część projektu pozyskiwania, a nie jako szum tła, ponieważ zachowanie kopiowania masowego (bulk-copy) zmienia się wraz z kompilacją sterownika i może wpłynąć na stabilność przebiegu ETL.
Praktyczna konfiguracja pozyskiwania danych często wygląda tak, z niedomyślnymi wartościami dobranymi w celu zapewnienia stabilności ETL:
URL:
jdbc:sqlserver://warehouse-host;databaseName=staging;encrypt=true;trustServerCertificate=false;applicationName=ETL LoaderWłaściwości:
connectRetryCount=2,connectRetryInterval=10,socketTimeoutustawiony na dłuższe okna wsadowe oraz włączone opcje masowego kopiowania tam, gdzie obciążenie na tym zyskujeUzasadnienie: zapobieganie awariom puli przy krótkotrwałych zakłóceniach, przy jednoczesnym zachowaniu prawidłowej walidacji certyfikatu serwera
Dla zespołów budujących kompleksową warstwę przesyłu danych referencja dotycząca budowania potoków danych ETL stanowi przydatne uzupełnienie samego profilu sterownika. Pomaga zachować spójność projektu potoku, zachowania ponawiania prób i punktów przekazywania, zamiast traktować ustawienia JDBC w izolacji.
Profil wykonywania wewnątrz bazy danych
Wykonywanie analityczne wymaga odwrotnego podejścia. Sterownik powinien szybko zgłaszać błędy przy martwych lub zablokowanych sesjach, a aplikacja powinna jednoznacznie się identyfikować, aby śledzenie po stronie serwera pozwalało powiązać aktywność z konkretnym zadaniem. Dla obciążeń raportowych lub transformacyjnych oznacza to zazwyczaj skrócenie limitów czasu, utrzymanie rygorystycznego szyfrowania i unikanie sposobów obsługi parametrów, które zniekształcają plany zapytań.
digna to jedna z opcji do pracy nad jakością danych i Observability bezpośrednio w bazie danych, gdy zespoły chcą, aby kontrole były uruchamiane w ich własnym środowisku, zamiast przesyłać dane na zewnątrz do inspekcji. Ma to znaczenie w środowiskach SQL Server, gdzie ścieżka sterownika, transformacje i warstwa monitorowania muszą pozostać blisko źródła danych.
Właściwość połączenia | Wartość dla pozyskiwania danych | Wartość dla wykonywania w bazie | Uzasadnienie |
|---|---|---|---|
applicationName | ETL Loader | Analytics Runner | Zapewnia czytelność logów serwera |
connectRetryCount | Umiarkowana | Niska | Pozyskiwanie lepiej toleruje przejściowe ponowienia |
socketTimeout | Dłuższa | Krótsza | Pozyskiwanie wymaga dłuższego czasu działania |
trustServerCertificate | false | false | Walidacja produkcyjna pozostaje nienaruszona |
encrypt | true | true | Zapewnienie ochrony transportu |
sendStringParametersAsUnicode | Zależna od obciążenia | Zależna od obciążenia | Unikanie niespodzianek z niejawna konwersją |
Dwie właściwości, które bywają błędnie kopiowane, to sendStringParametersAsUnicode oraz selectMethod. Jeśli przeniesiesz profil jednego typu obciążenia do drugiego bez ich weryfikacji, możesz pogorszyć jakość planu zapytań lub spowolnić zachowanie pakietowe w sposób, który trudno będzie powiązać ze sterownikiem.
Typowe błędy produkcyjne i jak je naprawić
Te same błędy pojawiają się wielokrotnie w incydentach JDBC związanych z SQL Server. Są nudne i właśnie dlatego przechodzą niezauważone przez przeglądy kodu. Większość z nich wynika z założenia, że skoro połączenie się otwiera, to konfiguracja musi być prawidłowa.
Najczęstsze przyczyny incydentów
Pozostawienie encrypt=false w środowisku oczekującym nowoczesnego TLS to prosta droga do awarii, gdy tylko polityka serwera zostanie zaostrzona. Brak niezależnego ustawienia loginTimeout i socketTimeout sprawia, że jedna zawieszona sesja może zbyt długo blokować gniazdo w puli. Używanie jTDS dla nowszego zachowania SQL Server rodzi długi ogon niezgodności funkcji. Brak sztywnego przypisania wersji sterownika pozwala, by odświeżenie zależności zmieniło zachowanie systemu bez celowego wdrożenia.
Domyślne wartości niektórych właściwości Microsoftu również utrudniają debugowanie, jeśli nigdy ich nie nadpiszesz. Właściwość applicationName domyślnie przyjmuje wartość Microsoft JDBC Driver for SQL Server, co nie jest wystarczająco precyzyjne, gdy śledzisz jeden potok spośród wielu właściwości połączenia. Jasna nazwa robi różnicę między zgadywaniem a wiedzą.
Pułapka parametrów Unicode jest warta osobnego omówienia. Gdy sendStringParametersAsUnicode=true wymusza niejawną konwersję na kolumnach typu varchar, wydajność wyszukiwania indeksu (index seek) może ucierpieć, ponieważ serwer musi uzgodnić typy parametrów i kolumn. Nie jest to awaria połączenia, ale bez wątpienia stanowi to problem produkcyjny.
Rozwiązania, które naprawdę działają
Używaj listy kontrolnej wdrożenia, a nie pamięci plemiennej. Przed wdrożeniem potwierdź wersję sterownika, środowisko uruchomieniowe Java, politykę TLS, tryb uwierzytelniania i ustawienia puli. Następnie zweryfikuj dokładną ścieżkę błędu, jakiej oczekujesz, gdy serwer jest niedostępny, certyfikat jest nieprawidłowy lub zapytanie trwa dłużej niż pozwala na to pula.
W zakresie kontroli operacyjnej przewodnik digna po technikach monitorowania i audytu baz danych dobrze komponuje się z przeglądem incydentów JDBC, ponieważ sterownik rzadko ulega awarii w izolacji. Zawodzi jako część szerszego potoku, a do wskazania, która warstwa uległa awarii jako pierwsza, potrzebne są logi, pomiary czasu i dowody walidacji.
Szybka ściągawka dla kluczowych właściwości połączenia
To jest ściągawka, którą warto mieć pod ręką podczas przeglądu kodu i reagowania na incydenty. Właściwe wartości domyślne zależą od Twojego środowiska, ale kluczem jest wiedza, które pokrętła mają największe znaczenie i które z nich zmieniły zachowanie na przestrzeni generacji sterowników.
Właściwość | Domyślnie | Zalecany zakres | Kiedy nadpisać |
|---|---|---|---|
encrypt | true w sterowniku 10.1+ | Zawsze włączone na produkcji | Nadpisuj tylko w kontrolowanych testach nieprodukcyjnych |
trustServerCertificate | false, gdy walidacja jest wymuszona, ale zachowanie zależy od powiązań | Pozostaw false na produkcji | Używaj tylko wtedy, gdy świadomie akceptujesz brak walidacji certyfikatów |
hostNameInCertificate | Niewskazane | Ustaw jawnie, gdy nazwy certyfikatów wymagają dopasowania | Nadpisuj zawsze, gdy walidacja nazwy hosta zakończyłaby się niepowodzeniem |
applicationName | Microsoft JDBC Driver for SQL Server | Ustaw opisową nazwę specyficzną dla aplikacji | Nadpisuj dla każdego produkcyjnego obciążenia |
databaseName | Domyślna baza danych serwera | Ustaw jawnie dla każdego obciążenia | Nadpisuj zawsze, gdy docelowa baza danych ma znaczenie |
connectRetryCount | 1 | Mała liczba całkowita dodatnia w oparciu o tolerancję | Nadpisuj dla obciążeń wrażliwych na przejściowe zakłócenia sieciowe |
connectRetryInterval | 10 sekund | Utrzymuj w umiarkowanym zakresie | Nadpisuj, gdy czas oczekiwania na ponowienie musi odpowiadać celom SLO |
loginTimeout | Niewskazana w zweryfikowanych danych | Ustaw jawnie | Nadpisuj zawsze, gdy pobieranie z puli nie może wisieć w nieskończoność |
socketTimeout | Niewskazana w zweryfikowanych danych | Ustaw jawnie | Nadpisuj dla wszystkich obciążeń produkcyjnych |
responseBuffering | Niewskazana w zweryfikowanych danych | Dostrajaj pod kątem obciążenia | Nadpisuj, gdy zachowanie pamięci i pobierania wymaga kontroli |
selectMethod | Niewskazana w zweryfikowanych danych | Ustawiaj tylko ze znajomością przyczyny | Nadpisuj, gdy wymagane jest starsze zachowanie pobierania danych |
packetSize | Niewskazana w zweryfikowanych danych | Dostrajaj ostrożnie | Nadpisuj dla ścieżek masowych lub wrażliwych na opóźnienia |
Główny wniosek jest prosty. Traktuj sterownik JDBC dla SQL Server jako kontrolowaną zależność środowiska uruchomieniowego, a nie zwykły szablonowy ciąg znaków. Jeśli potrzebujesz pomocy w utwardzaniu wersji sterowników, polityki TLS i zachowania łącznika wewnątrz rzeczywistej platformy danych, odwiedź digna i oceń, jak warstwa Observability działająca wewnątrz Twojego środowiska może współgrać z Twoimi obciążeniami SQL Server.
Najczęściej zadawane pytania
Jakim typem sterownika jest konektor JDBC dla SQL Servera?
Sterownikiem JDBC typu 4, który w czystej Javie rozmawia bezpośrednio z protokołem TDS SQL Servera, bez bibliotek natywnych. Microsoft podaje, że obsługuje Azure SQL Database, SQL database w Fabric, Azure SQL Managed Instance oraz wszystkie wspierane wersje i edycje SQL Servera, łącznie z Express.
Której wersji sterownika i środowiska Java używać?
Najnowszy sterownik GA to 13.4, wydany 13 marca 2026 r., wspierający Javę 8, 11, 17, 21 i 25. Cykl życia wymaga zainstalowania najnowszej wersji pomocniczej w ciągu 12 miesięcy od wydania, by zachować pełne wsparcie, więc świadomie przypnij artefakt.
Dlaczego liczą się pliki JAR dla jre8 i jre11?
Bo Microsoft dostarcza osobne warianty, które muszą pasować do używanej linii JVM. Ma to największe znaczenie w środowiskach korporacyjnych, gdzie stos aplikacyjny i platforma uruchomieniowa nie zmieniają się razem, bo właśnie tam niedopasowany artefakt trwa niezauważony.
Dlaczego połączenie działające miesiącami nagle się psuje?
Bo błędna konfiguracja JDBC zwykle leży poniżej poziomu, na którym inżynierowie ją zauważają. Rutynowa łatka, aktualizacja JVM albo odświeżenie zależności zmienia jedną warstwę, a działające połączenie to nie to samo co połączenie bezpieczne.
Kiedy konektor JDBC jest naprawdę przetestowany?
Dopiero wtedy, gdy przetestowano go wobec dokładnie tej JVM, wersji sterownika i poziomu łatek SQL Servera, które działają na produkcji. Wszystko inne waliduje inny system niż ten, który zawiedzie, i dlatego „łączy się” jest słabym kryterium akceptacji.


