Plik Parquet: architektura, wydajność i zastosowanie
|
10
min. czyt.

Prawdopodobnie jesteś w jednej z dwóch sytuacji. Albo wybierasz format składowania dla nowego zbioru i każda opcja brzmi mgliście „zoptymalizowana”, albo masz już Parquet na produkcji i Twoim problemem nie jest odczyt, lecz zrozumienie, dlaczego jeden zbiór jest szybki, drugi ospały, a trzeci nagle nie chce się otworzyć.
Właśnie tam większość treści o Parquet się urywa. Opisują ścieżkę idealną. Mówią, że Parquet jest kolumnowy, skompresowany i dobry do analityki, co jest prawdą, ale nie wystarcza, gdy stroisz row groups, diagnozujesz uszkodzone przesyłki albo decydujesz, czy nowe typy logiczne zepsują interoperacyjność między silnikami.
Parquet ma znaczenie, bo siedzi w centrum nowoczesnych platform danych. To format, którego wiele zespołów używa jako warstwy fizycznej pod jeziorami danych, lakehouse'ami, feature store'ami, strefami archiwalnymi i wymianą między narzędziami. Kto rozumie mechanikę pliku, podejmuje lepsze decyzje o układzie, zachowaniu zapytań, nadzorze i obsłudze awarii.
Spis treści
Czym jest plik Parquet i dlaczego ma znaczenie
Plik Parquet to otwarty kolumnowy format pliku zbudowany pod obciążenia analityczne. Zaczął jako wspólne przedsięwzięcie open source Twittera i Cloudery, ukazał się po raz pierwszy jako Parquet 1.0 w lipcu 2013 roku i stał się projektem najwyższego poziomu Apache Software Foundation 27 kwietnia 2015 roku. Jego projekt oparto na rozdrabnianiu i składaniu rekordów w stylu Dremel, co uczyniło go naturalnym wyborem dla analityki na dużą skalę w chmurowych jeziorach danych, jak opisano w tle Apache Parquet.
To pochodzenie ma znaczenie, bo obciążenia analityczne zachowują się inaczej niż systemy transakcyjne. Analitycy rzadko pobierają jeden pełny rekord naraz. Skanują wiele wierszy, dotykają kilku kolumn, ostro filtrują, jeszcze ostrzej agregują i powtarzają ten wzorzec przez cały dzień. Format wierszowy jak CSV zmusza silnik do przeczytania mnóstwa nieistotnych danych tylko po to, by odpowiedzieć na proste pytanie.
Dlaczego składowanie kolumnowe zmienia profil kosztów
Załóżmy, że Twoja tabela ma customer_id, event_date, country, device_type, revenue, campaign, browser i kilkanaście innych pól. Jeśli zapytanie potrzebuje tylko event_date i revenue, format wierszowy i tak przeciąga każde pole przez wejście-wyjście i parsowanie. Parquet nie.
To praktyczna wygrana. Składowanie kolumnowe pozwala silnikom zapytań czytać wyłącznie potrzebne kolumny, co ogranicza zmarnowane operacje wejścia-wyjścia i pamięć przy selektywnej pracy analitycznej. To jeden z powodów, dla których Parquet stał się domyślną warstwą wymiany między narzędziami, które nie dzielą jednego środowiska uruchomieniowego.
Dlaczego zespoły polegają na nim w środowiskach wielu narzędzi
Plik Parquet niesie własny schemat i metadane wewnątrz struktury pliku, więc dobrze podróżuje między Spark, Hive, Pandas, DuckDB, Trino i silnikami bliskimi hurtowni. Nie zawsze potrzebujesz zewnętrznego katalogu tylko po to, by zinterpretować zawartość.
Reguła praktyczna: jeśli Twój zespół oczekuje, że ten sam zbiór danych będzie wędrował między silnikami przetwarzania, format samoopisujący się oszczędza sporo kruchego kodu spajającego.
Parquet stał się w praktyce wspólnym językiem składowania w stosie lakehouse. Jeśli myślisz o projektowaniu platformy szerzej, to jeden z powodów, dla których fundament platformy danych tak wiele znaczy. Format pliku nie jest szczegółem na marginesie. Kształtuje to, jak każdy silnik niżej czyta, pomija, waliduje i ufa Twoim danym.
Wewnątrz architektury pliku Parquet
Najczystszy sposób na zrozumienie pliku Parquet to przestać myśleć o nim jak o bryle danych i zacząć myśleć jak o małej bibliotece.
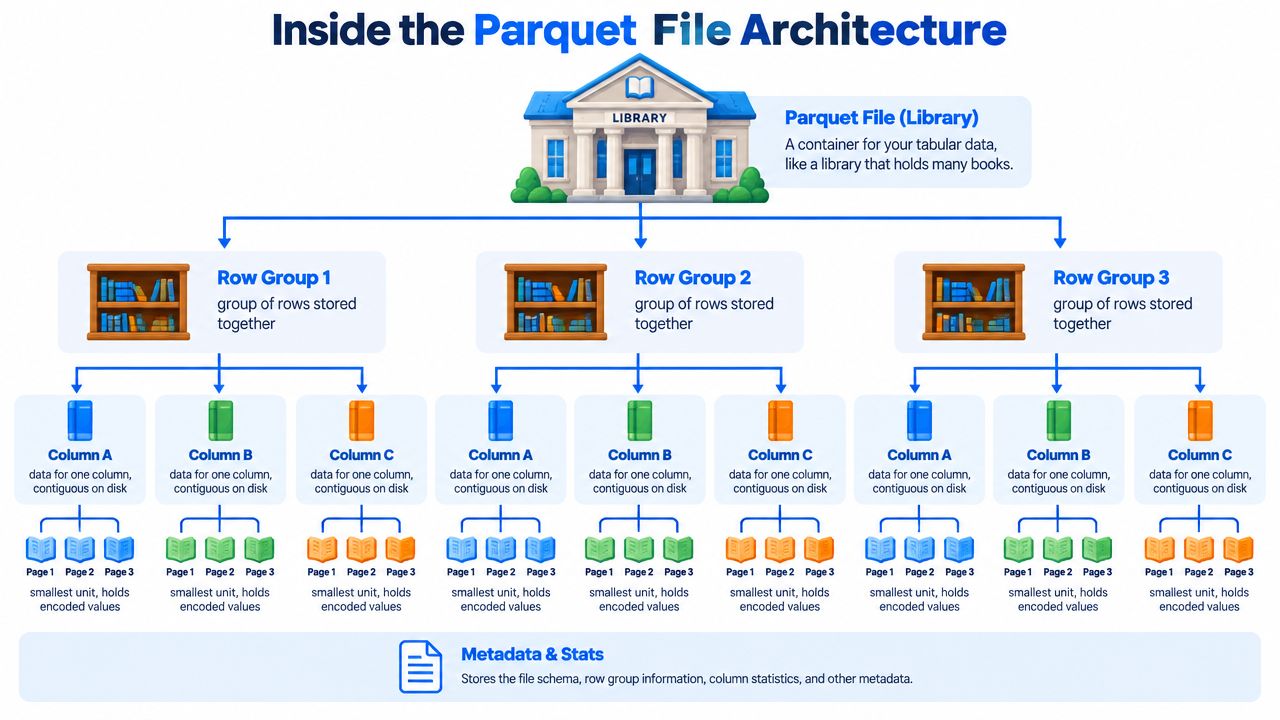
Plik to budynek. W środku row groups to działy biblioteki. Wewnątrz każdej row group każdy column chunk to regał dla jednej kolumny. A każdy column chunk zawiera pages, mniejsze jednostki czytane sekwencyjnie z dysku.
Dokumentacja koncepcji Apache ujmuje to wprost: plik zawiera jedną lub więcej row groups, każda row group zawiera dokładnie jeden column chunk na kolumnę, a każdy column chunk zawiera jedną lub więcej pages. Zaznacza też, że column chunks leżą w pliku ciągiem, co jest jednym z powodów, dla których odczyty kolumnowe są w praktyce wydajne, jak udokumentowano w referencji koncepcji Parquet.
Hierarchia, z której czytający naprawdę korzystają
Ta hierarchia nie jest akademicka. Silniki zapytań korzystają z niej bez przerwy.
Poziom pliku daje czytającemu pojedynczy obiekt do otwarcia i zbadania.
Poziom row group działa jako praktyczna jednostka równoległego skanowania.
Poziom column chunk pozwala silnikowi pobrać tylko kolumny, o które prosi zapytanie.
Poziom page to miejsce, gdzie zakodowane wartości są przechowywane i dekodowane po kolei.
Jeśli pracowałeś nad architekturą systemów danych, powinno to brzmieć znajomo. Wydajne systemy są zwykle hierarchiczne, bo hierarchia daje czytającym punkty zatrzymania. Parquet oferuje takie punkty na kilku poziomach.
Co leży na krańcach pliku
Zdrowy plik Parquet zaczyna się i kończy magicznymi bajtami PAR1. To jedna z pierwszych kontroli integralności, z których korzysta wiele narzędzi. Gdy brakuje znacznika końcowego, plik może być obcięty, niekompletny albo w ogóle nie być Parquet.
Stopka blisko końca pliku to miejsce, gdzie mieszka większość inteligencji. Przechowuje schemat, metadane row group i metadane klucz-wartość. Dlatego Parquet jest samoopisujący się. Czytający nie muszą zgadywać kształtu zbioru.
Plik Parquet łatwo się czyta, gdy strony danych są w porządku. Łatwo się go diagnozuje, gdy stopka jest w porządku. Boli, gdy transport zniszczył plik, zanim któraś z tych warstw zdążyła pomóc.
Jak Parquet obsługuje dane zagnieżdżone
Parquet zaprojektowano wokół rozdrabniania i składania w stylu Dremel, dzięki czemu reprezentuje struktury zagnieżdżone, takie jak struktury, listy i mapy, bez powtarzania nazw pól w każdym wierszu. Sztuczka polega na tym, że zapisujący rozbija zagnieżdżone rekordy na kolumnowe kawałki i zachowuje dość informacji pozycyjnej, by je później odtworzyć.
Ta informacja pozycyjna wyrażana jest zwykle przez definition levels i repetition levels. Mówiąc prosto, poziomy te pomagają czytającemu odróżnić „to pole jest puste”, „ta lista jest pusta” i „to zagnieżdżone dziecko należy do tego samego rodzica co poprzednia wartość”. Jeśli kiedyś odczytałeś dane zagnieżdżone z zaskakującymi wartościami pustymi albo niezgodnym kształtem, zwykle stoi za tym właśnie ta mechanika.
Pod spodem strony mogą używać różnych kodowań w zależności od danych i zachowania zapisującego. W prawdziwych systemach spotkasz kodowanie plain, słownikowe, run-length, bit-packing, kodowania typu delta oraz byte stream split. Rzecz nie w zapamiętaniu każdego kodowania. Chodzi o zrozumienie, że Parquet przechowuje wartości w zwartych, zakodowanych jednostkach stron, a nie jako surowy tekst wiersz po wierszu.
Jak predicate pushdown i page indexes przyspieszają zapytania
Zapytanie Parquet staje się szybkie, gdy czytający potrafi udowodnić, że duże części pliku są nieistotne, zanim otworzy strony danych. To jest ta wygrana. Kompresja pomaga przy bajtach na dysku i w sieci. Predicate pushdown pomaga w czymś cenniejszym na produkcji: mniej odczytów, mniej dekompresji i mniej pracy w silniku wykonawczym.
Punktem wyjścia są metadane stopki opisane w dokumentacji formatu pliku Parquet. Obok schematu i szczegółów układu Parquet może przechowywać statystyki kolumn dla każdej row group, w tym wartości minimalne, maksymalne i liczbę wartości pustych. Silniki zapytań używają tych statystyk, by przetestować Twój filtr na każdej row group przed skanowaniem właściwych danych kolumny.
Typowy przypadek to unaocznia. Załóżmy, że zapytanie filtruje po:
WHERE event_date BETWEEN '2026-01-01' AND '2026-01-31'
Jeśli jedna row group ma granice event_date w całości w marcu, silnik może ją wykluczyć wyłącznie na podstawie metadanych. Jeśli inna row group obejmuje daty styczniowe, ta grupa wymaga dalszej inspekcji. Wynik jest prosty:
Row groups, których min i maks nie mogą spełnić predykatu, są pomijane.
Row groups, których zakres pokrywa się z predykatem, pozostają kandydatami.
Grupy kandydujące wciąż wymagają odczytów stron lub kontroli wartości, by potwierdzić dopasowania.
Brzmi prosto, ale liczą się dwa szczegóły produkcyjne.
Po pierwsze, statystyki row group są tyle warte, ile układ danych. Jeśli wartości są zgrupowane według event_date, zakresy min i maks są wąskie, więc przycinanie jest ostre. Jeśli plik zapisano z mocno przetasowanych danych, każda row group może obejmować szeroki zakres dat, a metadane stają się znacznie mniej selektywne. Predicate pushdown wciąż działa. Ma tylko mniej materiału.
Po drugie, row groups to jednostka zgrubna. Działają jak kartony w magazynie. Jeśli etykieta mówi, że wszystko w kartonie pochodzi z marca, pomijasz cały karton. Jeśli mówi, że karton obejmuje styczeń do marca, musisz go otworzyć, nawet jeśli w środku pasować może tylko kilka styczniowych rekordów.
Tu wchodzą page indexes. Parquet obsługuje opcjonalne metadane na poziomie strony przez ColumnIndex i OffsetIndex, zdefiniowane w specyfikacji page index Parquet. ColumnIndex przechowuje granice stron i informacje o wartościach pustych dla kolumny. OffsetIndex mapuje strony na fizyczne przesunięcia i zakresy wierszy. Razem dają czytającemu drobniejszą mapę wewnątrz row group.
Praktyczny efekt łatwo przeoczyć, jeśli czyta się tylko poradniki o ścieżce idealnej. Bez page indexes silnik może wiedzieć, że row group warto sprawdzić, a mimo to przeczytać w niej wiele stron. Z page indexes silnik może pominąć strony niepasujące i skoczyć bliżej tych, które mogą spełnić filtr. Przy selektywnych zapytaniach na dużych row groups oszczędza to sporo zbędnych operacji wejścia-wyjścia.
Warto trzymać to rozróżnienie w głowie:
Statystyki row group decydują, czy w ogóle czytać daną row group.
Page indexes decydują, które strony w tej row group warto ruszyć.
To także powód, dla którego strojenie Parquet bywa niespójne między narzędziami. Wsparcie zapisu page indexes bywa różne. Wsparcie odczytu również. Jeden silnik używa ich agresywnie. Inny je ignoruje i wraca do samego przycinania row group. W 2026 roku ta luka wciąż pojawia się w mieszanych stosach, zwłaszcza tam, gdzie Spark, Trino, silniki hurtowni i czytniki Pythona dotykają tych samych plików.
Filtry Blooma należą do tej samej rodziny funkcji oszczędzających pracę, ale rozwiązują węższy problem. Mogą pomóc przy testach przynależności na kolumnach o wysokiej kardynalności, jak user_id, zakładając, że zapisujący je wytworzył, a czytający umie z nich korzystać. Gdy zespoły mówią „pushdown w Parquet przestał działać”, przyczyną zwykle nie jest sam format. To jedna z tych mechanik: słabe grupowanie, słabe statystyki, nieobsługiwane page indexes albo zachowanie czytnika, który wraca do pełnego skanu.
Takie diagnostyczne nastawienie liczy się dziś bardziej, bo nowsze typy logiczne, w tym Variant, dane geoprzestrzenne i typ FILE, poszerzają to, co zespoły wkładają do Parquet. Gdy pliki niosą bardziej złożone dane, pytanie nie brzmi już tylko „czy potrafię przeczytać ten plik?”. Brzmi „które części tego pliku mój silnik może bezpiecznie pominąć i na jakich metadanych opiera tę decyzję?”.
Parquet wobec CSV, Avro i ORC
Wybór Parquet staje się łatwiejszy, gdy przestaniesz pytać, który format jest „najlepszy”, a zaczniesz pytać, jaki wzorzec dostępu musisz obsłużyć.
CSV jest uniwersalny i łatwy do obejrzenia. Jest też słaby w schemacie, typowaniu i odczytach selektywnych. Avro jest wierszowe i zwykle lepiej pasuje, gdy zapis i odczyt kompletnych rekordów liczy się bardziej niż skanowanie kilku kolumn. ORC jest kolumnowy jak Parquet i pozostaje mocny w środowiskach mocno opartych na Hive. Parquet plasuje się pośrodku jako najpowszechniejszy międzysilnikowy format analityczny.
Kompromisy w jednym ujęciu
Format | Układ | Schemat | Kompresja | Koszt skanowania | Koszt zapisu | Najlepszy do |
|---|---|---|---|---|---|---|
Parquet | Kolumnowy, zorganizowany w row groups i column chunks | Osadzony w pliku | Mocna, wspierana przez układ kolumnowy i kodowanie | Niski przy selektywnych zapytaniach analitycznych | Wyższy niż zwykły tekst i często bardziej pracochłonny niż proste formaty wierszowe | Analityka, jeziora danych, wymiana między silnikami |
CSV | Zwykły tekst wierszowy | Brak wbudowanego w format | Możliwa kompresja zewnętrzna, ale sam plik jest tekstem | Wysoki, bo czytający muszą parsować pełne wiersze i wnioskować typy | Bardzo niski | Prosty eksport i wymiana czytelna dla człowieka |
Avro | Binarny wierszowy | Mocne wsparcie schematu | Zwarte kodowanie binarne | Lepszy do dostępu wierszowego niż do przycinania kolumn | Dobry do przepływów mocno zapisujących | Streaming, dane zdarzeń, odczyty na poziomie wiersza |
ORC | Kolumnowy | Osadzony schemat i metadane | Mocna | Niski przy skanach analitycznych | Podobne kompromisy projektowe co Parquet | Analityka skupiona na Hive i ekosystemy tabel |
Jak myśleć o tej decyzji
Używaj CSV, gdy przenośność i ludzka inspekcja liczą się bardziej niż efektywność analityczna. Pozostaje lingua franca podstawowej wymiany, ale zespoły płacą za tę wygodę później parsowaniem, słabym typowaniem i zmarnowanymi odczytami.
Używaj Avro, gdy zależy Ci na wierności wiersza, ewolucji schematu w potokach zdarzeń i wzorcach mocno zapisujących. Systemy związane z Kafką lądują tu nie bez powodu.
Używaj ORC, gdy Twój stos jest związany z przetwarzaniem w stylu Hive i zachowaniami tabel właściwymi dla ORC. Rozwiązuje wiele tych samych problemów co Parquet, ale środek ciężkości leży gdzie indziej.
Używaj Parquet, gdy większość obciążeń to filtrowane skany, projekcje i agregacje na dużych zbiorach. To format, który zwykle przeżywa zmiany narzędzi, bo rozumie go tak wielu czytających.
Praca z Parquet w Spark, Hive i Pandas
Ciekawe w używaniu Parquet nie jest samo read_parquet(). Chodzi o to, że różne zapisujące zostawiają różne odciski, a te odciski wpływają na późniejsze odczyty.
Spark, Hive i Pandas mogą pracować na tym samym zbiorze Parquet, ale nie zawsze zapiszą go tak samo. Widać to w układzie row groups, zachowaniu sortowania, jakości statystyk, strukturze katalogów partycji i w tym, jak sprawnie inny silnik zdoła później przyciąć dane.
Spark i zbiory partycjonowane
W Sparku typowy wzorzec jest prosty: odczytać DataFrame, przekształcić i zapisać Parquet z powrotem do magazynu obiektowego. Zespoły często łączą to z partitionBy(...), co tworzy drzewa katalogów w stylu Hive, takie jak event_date=2026-01-01/. Katalogi te stają się przy odczycie wirtualnymi kolumnami partycji.
To użyteczne, ale tworzy też pułapkę. Zespoły czasem partycjonują zbyt drobno i kończą ze zbyt wieloma małymi plikami. Gdy to nastąpi, metadane stopki rozpraszają się po wielu obiektach, a planowanie zapytań staje się bardziej zaszumione.
Jeśli już monitorujesz niezawodność Databricks lub Sparka, monitorowanie jakości danych w Databricks nabiera znaczenia, bo błędy układu plików ujawniają się najpierw jako niespójne zachowanie w czasie wykonania, a nie jako czytelne błędy formatu.
Hive i jego dojrzała ścieżka Parquet
Hive obsługuje Parquet od lat i w wielu środowiskach czyta go natywnie przez zwykłe abstrakcje tabel. Ważny punkt operacyjny jest taki, że tabela Hive może wydawać się „logiczna”, ale wydajność wciąż bierze się z fizycznego układu Parquet pod spodem. Jeśli pliki są źle spartycjonowane albo niosą słabe statystyki, Hive nie uratuje tego samymi metadanymi.
Niespodzianki w Pandas i PyArrow
Pandas sięga po Parquet zwykle przez PyArrow albo fastparquet. W PyArrow wybieranie kolumn przy odczycie zachowuje główną korzyść dostępu kolumnowego. To dobry nawyk, gdy analitycy potrzebują tylko wycinka zbioru.
Subtelny problem tkwi w zapisie. Plik Parquet wygenerowany w notatniku często działa dobrze przy analizie lokalnej, ale później wypada słabo, gdy inny silnik próbuje wypchnąć filtry albo zrównoleglić skany. To nie znaczy, że Pandas jest zły. Znaczy, że domyślne ustawienia notatnika to nie to samo co produkcyjny projekt składowania.
Jeśli zbiór danych rodzi się w notatniku, a kończy we wspólnym potoku, przepisz go z ustawieniami produkcyjnymi, zanim uznasz go za gotowy.
Ostatni punkt, który wiele zespołów pomija: zbiór zapisany przez Sparka i czytany przez DuckDB może zachowywać się inaczej niż zapisany przez PyArrow i czytany przez Sparka. Ten sam format, inne decyzje zapisującego.
Kompresja, kodowanie, partycjonowanie i ewolucja schematu
Zbiór Parquet może wyglądać zdrowo z zewnątrz i źle zachowywać się na produkcji. Pliki się otwierają. Zapytania zwracają wiersze. Potem jedna tabela skanuje znacznie więcej danych niż oczekiwano, druga produkuje setki maleńkich plików, a trzecia psuje się po aktualizacji zapisującego. Te cztery dźwignie zwykle to tłumaczą: kompresja, kodowanie, partycjonowanie i ewolucja schematu.
Kompresja i kodowanie rozwiązują różne problemy
Kompresja decyduje, jak bajty są ściskane do składowania. Kodowanie decyduje, jak wartości są ułożone, zanim kompresja je zobaczy.
To rozróżnienie ma znaczenie, bo słaby wybór kodowania zostawia kompresorowi zbędną pracę. Dobry wybór kodowania potrafi sprawić, że zwykła kompresja wypadnie znacznie lepiej.
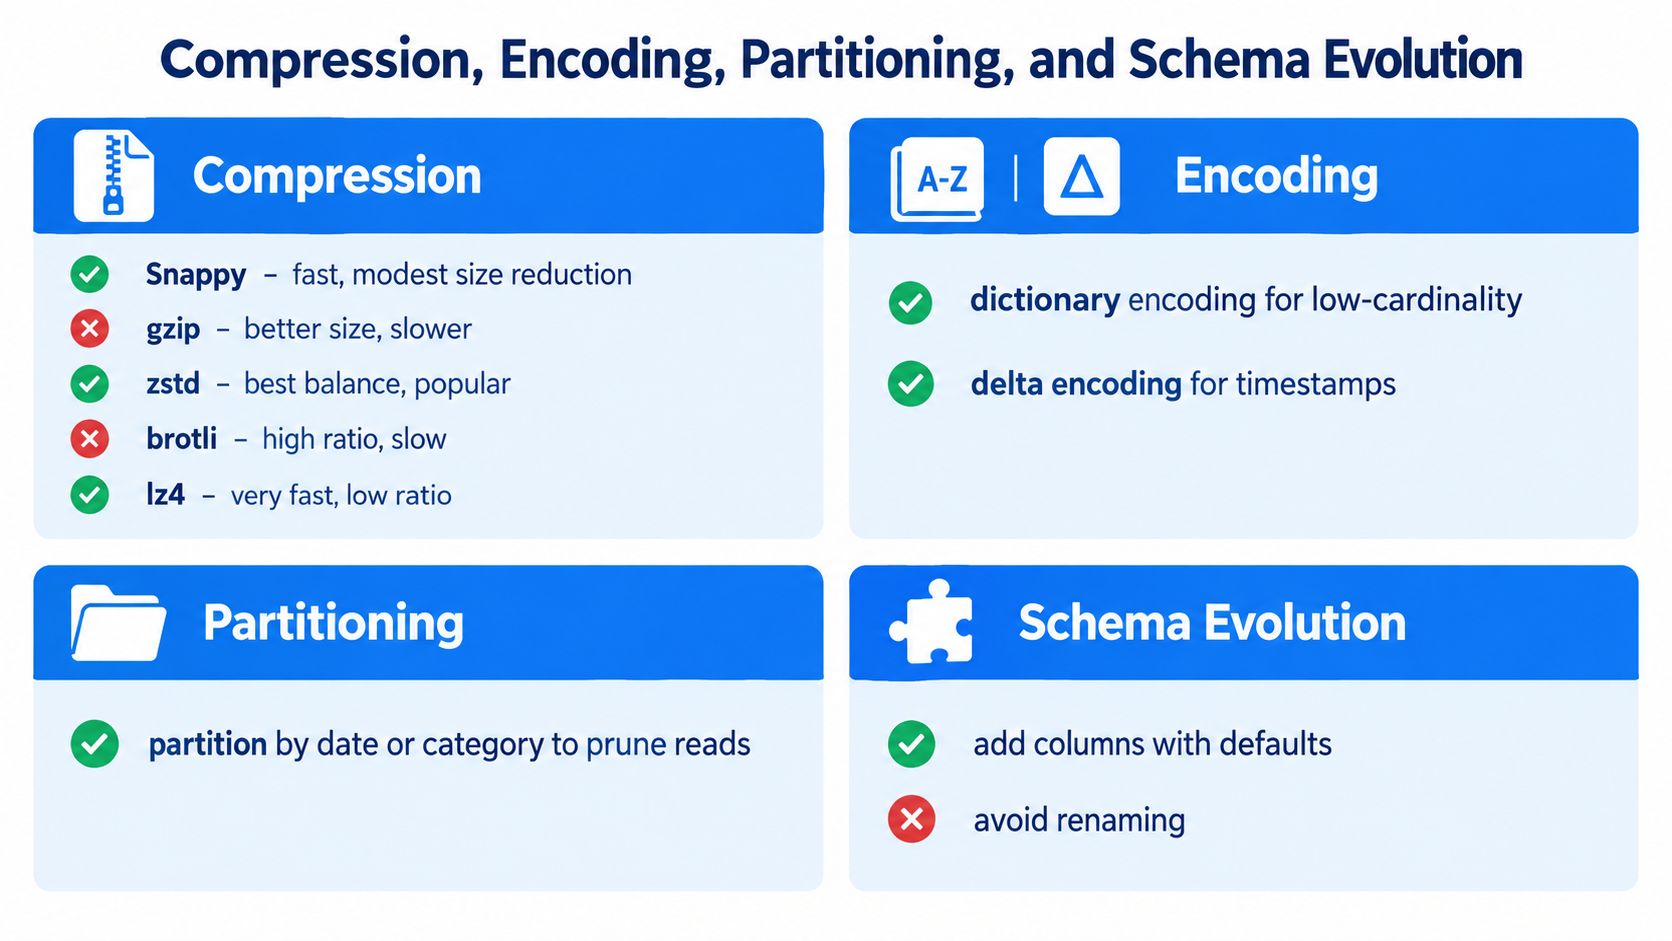
Przy kompresji kompromis dotyczy zwykle CPU wobec rozmiaru:
Snappy to typowy domyślny wybór, gdy szybki odczyt i zapis liczą się bardziej niż najmniejszy rozmiar pliku.
gzip często kompresuje ciaśniej, ale kosztuje więcej CPU.
zstd dobrze pasuje do wielu mieszanych obciążeń, bo zwykle równoważy współczynnik i szybkość.
brotli ma sens, gdy redukcja składowania liczy się bardziej niż przepustowość zapisu.
lz4 stawia na szybkość.
Kodowanie jest wrażliwsze na kształt kolumny. Kodowanie słownikowe działa dobrze, gdy kolumna powtarza ten sam niewielki zestaw wartości, jak kody krajów czy pola statusu. Kodowania delta pasują do uporządkowanych liczb całkowitych, znaczników czasu i innych wartości zmieniających się stopniowo. Byte stream split potrafi pomóc niektórym kolumnom zmiennoprzecinkowym. Jeśli kompresja to pakowanie walizki, kodowanie jest tym, jak wcześniej złożysz ubrania.
Rozmiar row group wyznacza ramy wydajności
Row groups to jedno z najmniej efektownych ustawień Parquet i jedno z najdroższych do pomylenia. Sterują tym, ile danych jest zebranych razem do skanowania, pomijania i pracy równoległej.
Zalecenia konfiguracyjne Parquet radzą duże row groups, bo większe grupy często poprawiają efektywność skanowania i kompresję. W realnych systemach zespoły często wybierają mniejsze cele, by zrównoważyć limity pamięci, rozmiar zadań i zachowanie przycinania. Większa row group daje każdemu zadaniu skanującemu więcej użytecznej pracy. Mniejsza daje silnikowi więcej okazji do pominięcia nieistotnych danych.
Pytanie nie brzmi więc, czy większe row groups są zawsze lepsze. Użyteczne pytanie brzmi: czy Twoje obciążenia zyskują bardziej na wyższej przepustowości skanowania, czy na drobniejszym pomijaniu?
Jeśli analitycy mocno filtrują po wąskim zakresie dat, przewymiarowane row groups mogą zmusić czytających do pobrania więcej danych niż trzeba. Jeśli obciążenie to głównie szerokie skany tabel, większe grupy zwykle się opłacają.
Partycjonowanie powinno odzwierciedlać, jak dane są naprawdę czytane
Partycjonowanie działa najlepiej, gdy podąża za zgrubnym, stabilnym filtrem, jak data zdarzenia, region albo inne pole pojawiające się w wielu zapytaniach. Działa źle, gdy zespoły partycjonują po kolumnach o wysokiej kardynalności, bo na papierze wyglądają selektywnie.
Dobra reguła jest prosta. Partycjonuj pod odnajdywanie plików, a nie pod każdy możliwy predykat.
Nadmierne partycjonowanie tworzy drzewo katalogów drogie w listowaniu, drogie w planowaniu i podatne na wysyp maleńkich plików. Zbyt małe partycjonowanie wpycha zbyt wiele pracy filtrującej do samych plików. Właściwy układ jest zwykle nudny. To dobry znak.
Sortowanie wewnątrz partycji bywa równie ważne jak samo partycjonowanie. Gdy wiersze o podobnych wartościach leżą razem, statystyki Parquet i page indexes mają większą szansę pomóc czytającemu czysto pominąć dane.
Przy ewolucji schematu ujawnia się dług zgodności
Dodanie kolumny dopuszczającej wartości puste jest zwykle łatwe. Zmiana nazwy pola między silnikami, zmiana typów logicznych albo przepisanie struktur zagnieżdżonych to moment, w którym zaczynają się kłopoty.
Parquet jest na tyle pobłażliwy, że zmiany potrafią wyglądać na działające przez tygodnie, zanim zawiodą u czytnika niżej. Jeden silnik może zinterpretować typ logiczny tak, drugi go poszerzyć, a trzeci zmaterializować wartości puste. Dlatego ewolucję schematu należy traktować jako proces zgodności, a nie jako pole do odhaczenia w formacie pliku.
Złożoność rośnie, bo ekosystem Parquet wciąż się zmienia. Blog projektu Apache Parquet śledzi bieżące prace nad funkcjami takimi jak Variant dla danych półstrukturalnych, typy geoprzestrzenne i typ logiczny FILE, a także szersze dyskusje o formacie i wersjonowaniu, które mają znaczenie dla zgodności między silnikami. Te funkcje są użyteczne, ale stawiają przed zespołami produkcyjnymi praktyczne pytanie: które czytniki w Twoim stosie potrafią je dziś poprawnie sparsować?
Tu pomaga zdyscyplinowane śledzenie schematu. Narzędzie takie jak śledzenie dryfu schematu dla potoków Parquet potrafi wychwycić zmiany strukturalne, zanim ujawnią się jako ciche niezgodności między czytnikami.
Bezpieczne nastawienie jest zachowawcze. Używaj nowszych funkcji Parquet, gdy rozwiązują realny problem, ale obwarowuj je kontrolami zgodności czytników, testuj pliki zapisane przez rzeczywiste silniki Twojego stosu i traktuj aktualizacje zapisującego jako zmianę zachowania, a nie rutynową łatkę.
Diagnozowanie awarii plików Parquet na produkcji
Gdy plik Parquet nie chce się odczytać, inżynierowie często najpierw obwiniają format. To zwykle zły odruch. Niedawne wskazówki społeczności pokazują, że najtrudniejsze realne awarie dotyczą często integralności pliku i transportu, a nie rdzenia projektu Parquet, i że ten sam objaw może pochodzić z problemów magazynu, zapisującego lub czytnika, a nie z samej struktury pliku, jak opisano w FAQ diagnozowania awarii Parquet.
Lepszym podejściem jest posortowanie awarii na archetypy.
Cztery klasy awarii, które oszczędzają czas
Awarie pobrania
Czytający nigdy nie dostał właściwych bajtów. Pomyśl o nieaktualnych listach obiektów, błędnych wpisach manifestu, częściowych pobraniach albo stronie błędu HTML zapisanej z rozszerzeniem.parquet.Awarie stopki
Obiekt istnieje, ale stopka jest nieobecna, uszkodzona lub nieczytelna. Obcięte przesyłki i niekompletne zapisy wieloczęściowe często lądują tutaj.Awarie wiązania schematu
Plik się otwiera, ale czytający mapuje typy inaczej, niż zamierzał zapisujący. Dostajesz ciche wartości puste, popsute pola zagnieżdżone albo niezgodności typów logicznych.Awarie dekodowania i materializacji
Metadane wyglądają dobrze, dopóki silnik nie zacznie dekodować stron albo materializować wartości w pamięci. Zgodność kompresji, uszkodzenia stron i limity właściwe czytnikowi często trafiają tutaj.
Praktyczna kolejność triage
Zastosuj prostą sekwencję, zanim zaczniesz zmieniać kod:
Najpierw zweryfikuj pobranie. Potwierdź, że obiekt jest kompletny i że to plik Parquet, a nie błędnie oznaczona treść.
Sprawdź znaczniki krańcowe i stopkę. Jeśli koniec jest zepsuty, nic powyżej nie ma znaczenia.
Zbadaj schemat i typy logiczne. Porównaj wyjście zapisującego z oczekiwaniami czytnika.
Dopiero potem diagnozuj dekodowanie. Nie skacz do teorii o kodekach, zanim nie wiesz, że plik jest cały.
Zepsute potoki Parquet często zaczynają się poza Parquet. Magazyn, transport, nazewnictwo i polityki cyklu życia obiektów powodują zaskakująco dużą część bólu.
Monitorowanie plików i obserwowalność potoków pomagają bardziej niż sama znajomość formatu. Jeśli zespoły korzystają już z monitorowania jeziora danych, często potrafią dostrzec brakujące partycje, spóźnione dostawy albo gwałtowne zmiany schematu, zanim czytnik rzuci niskopoziomowy błąd.
Główna zmiana nastawienia jest prosta. Nie pytaj „dlaczego Parquet jest zepsuty?”. Pytaj „na którym etapie bajty, metadane, wiązanie schematu albo ścieżka dekodowania przestały być wiarygodne?”.
Lista operacyjna dla plików Parquet w potokach
Zdrowy Parquet nie bierze się stąd, że format jest dobry. Bierze się stąd, że zespoły stosują te same reguły za każdym razem, gdy zapisują, walidują i publikują pliki.

Lista warta wklejenia do runbooka
Przypnij wersje zapisujących. Utrzymuj stabilne wersje bibliotek w zadaniach zapisujących ten sam zbiór. Mieszani zapisujący zwykle produkują mieszane zachowanie.
Weryfikuj statystyki stopki. Upewnij się, że metadane row group są obecne i dość wiarygodne, by czytający mogli skutecznie przycinać.
Wybieraj cele row group świadomie. Wiele zespołów ląduje w praktyce blisko 128 MB, podczas gdy zalecenia projektu wskazują 512 MB do 1 GB dla dużych row groups, zależnie od obciążenia i zachowania silnika, zgodnie z przywołanymi wcześniej wytycznymi Parquet.
Audytuj układ partycji. Struktura katalogów powinna odzwierciedlać, jak ludzie odpytują dane.
Testuj ewolucję schematu przed scaleniem. Dodane kolumny to jedno. Dryf typów logicznych to co innego.
Sprawdź wybory kompresji i kodowania. Nie dziedzicz domyślnych ustawień notatnika, zakładając, że pasują do produkcji.
Waliduj integralność transportu. Poprawny zapisujący nie chroni Cię przed zepsutymi przesyłkami ani niespodziankami magazynu obiektowego.
Obserwowalność i nadzór czynią to trwałym
Ta lista staje się użyteczniejsza, gdy powiąże się ją z automatycznymi kontrolami. Great Expectations może walidować oczekiwane reguły schematu i treści. Apache Griffin może wspierać przepływy jakości danych. Datafold pomaga porównywać zmiany między środowiskami. digna to kolejna opcja w tej kategorii. Działa wewnątrz środowiska klienta i monitoruje zachowanie danych, Timeliness, walidacje i zmiany schematu w potokach, co pasuje do tych cichych regresji Parquet, które proste kontrole plików pomijają.
Nadzór też tu należy. Metadane kolumn mogą nieść oznaczenia PII. Formaty tabel i warstwy katalogowe mogą egzekwować retencję i polityki dostępu. Uprawnienia magazynu obiektowego wciąż mają znaczenie, bo najczystszy plik Parquet na świecie jest bezużyteczny, jeśli niewłaściwe zadanie może go nadpisać.
Nawyk operacyjny: traktuj każdy zbiór Parquet jednocześnie jako problem formatu pliku i problem kontraktu. Wydajność bierze się z formatu. Niezawodność bierze się z kontraktu.
Plik Parquet jest prosty w użyciu, gdy ktoś inny podjął za Ciebie właściwe decyzje. Na produkcji tym kimś jest Twój zespół.
Jeśli Parquet niesie w Twoim środowisku krytyczne obciążenia analityczne lub AI, digna może pomóc monitorować te części, które zwykle zawodzą: dryf schematu, brakujące lub spóźnione dane, problemy jakościowe na poziomie rekordu i nietypowe zachowanie w potokach. Przydaje się to zwłaszcza wtedy, gdy problem z Parquet wcale nie jest problemem formatu, lecz dostawy, metadanych albo kontraktu powyżej. Zajrzyj do digny, jeśli chcesz mieć taką widoczność we własnym środowisku.
Wersję tej listy na poziomie zbioru danych, stosowaną ciągle zamiast plik po pliku, widać w tym, jak zarządzanie jakością danych działa w praktyce.
Najczęściej zadawane pytania
Kiedy powstał Parquet?
Parquet zaczął jako wspólne przedsięwzięcie open source Twittera i Cloudery, z Parquet 1.0 wydanym w lipcu 2013 roku, i stał się projektem najwyższego poziomu Apache Software Foundation 27 kwietnia 2015 roku. Jego projekt oparto na rozdrabnianiu rekordów w stylu Dremel, dzięki czemu reprezentuje struktury zagnieżdżone bez powtarzania nazw pól w każdym wierszu.
Jak Parquet przechowuje dane zagnieżdżone, takie jak struktury, listy i mapy?
Przez rozdrabnianie i składanie w stylu Dremel. Zapisujący rozbija zagnieżdżone rekordy na kolumnowe kawałki i zachowuje dość informacji pozycyjnej, by odtworzyć je przy odczycie, więc nazwy pól nie powtarzają się w każdym wierszu. Dlatego głęboko zagnieżdżone schematy pozostają zwarte, zamiast puchnąć jak zagnieżdżony JSON.
Dlaczego plik Parquet nie daje się odczytać?
Problemy z integralnością i transportem powodują więcej realnych awarii niż sam format. Zdrowy plik zaczyna się i kończy magicznymi bajtami PAR1, więc brak znacznika końcowego wskazuje na obcięcie, częściowe pobranie albo stronę błędu HTML zapisaną z rozszerzeniem .parquet. Sprawdź pobranie, zanim zaczniesz zmieniać kod.
Jakiego rozmiaru row group powinienem użyć?
Row groups sterują tym, ile danych jest zebranych razem do skanowania, pomijania i pracy równoległej, i należą do najdroższych ustawień, gdy się je pomyli. Większe grupy poprawiają efektywność skanowania, ale poszerzają zasięg szkód przy słabych statystykach; mniejsze dają czytającym więcej okazji do pomijania. Dostrajaj je do rzeczywistych wzorców skanowania.
Jak utrzymać wiarygodność zbiorów Parquet na produkcji?
Stosuj te same reguły przy każdym zapisie. Przypnij wersje zapisujących, żeby zadania zapisujące jeden zbiór nie dawały mieszanego zachowania, partycjonuj po stabilnych zgrubnych filtrach i waliduj silnikami czytającymi, a nie tylko zapisującym. Narzędzia takie jak Great Expectations, Apache Griffin, Datafold i digna automatyzują te kontrole.



