Narzędzia do kontroli jakości danych on-premise (lokalnych) – wyjaśnienie dla zespołów przedsiębiorstw
|
8
min. czyt.

Pulpit nawigacyjny może świecić na zielono, podczas gdy dane u jego podstaw są już błędne. Zaplanowane ładowanie dociera z opóźnieniem, system źródłowy dodaje kolumnę lub dystrybucja klientów ulega przesunięciu bez wywołania awarii potoku. Raporty nadal się odświeżają, zadania są nadal wyświetlane jako pomyślne, a firma odkrywa problem dopiero wtedy, gdy analityk kwestionuje nieoczekiwany wynik.
Ten wzorzec awarii jest powszechny w dużych środowiskach, ponieważ dane przechodzą obecnie przez magazyny, jeziora danych, legacy databases, sieci prywatne i usługi chmurowe. Kontrola jakości, która monitoruje tylko jedną platformę, może przeoczyć moment, w którym zmiana pojawiła się w środowisku. Przewodnik enterprise guide to why data issues continue creating conflicts jasno przedstawia ten szerszy problem, ale pytanie o wdrożenie pozostaje praktyczne: gdzie powinno działać monitorowanie i jak powinno funkcjonować ponad granicami zaufania?
Narzędzie on-prem data quality tool jest zatem czymś więcej niż tylko wyborem hostingu. Może ono zdefiniować model operacyjny, w którym kontrole są wykonywane blisko wrażliwych danych, zespoły zachowują kontrolę nad infrastrukturą, a inżynierowie nadal zyskują spójny widok w rozproszonych systemach. Właściwa ocena zaczyna się od wykrywania awarii, a następnie przechodzi przez bezpieczeństwo, integrację hybrydową, własność operacyjną i całkowity koszt posiadania.
Na koniec będziesz w stanie zdecydować, czy wykonywanie zadań on-premises pasuje do Twojego środowiska, które możliwości zasługują na sprawdzenie w pilotażu, jak porównać ten model z SaaS oraz jak zbudować argumentację ROI uwzględniającą zarówno uniknięcie ponownej pracy, jak i obowiązki, które przejmie Twój zespół.
Spis treści
Wprowadzenie: Dlaczego jakość danych dyskretnie zawodzi w przedsiębiorstwie
Czym naprawdę jest lokalne narzędzie do badania jakości danych
Porównanie lokalnych narzędzi jakości danych i rozwiązań SaaS
Kluczowe funkcje, które powinno posiadać każde narzędzie lokalne
Bezpieczeństwo wdrożenia i model operacyjny dla środowisk hybrydowych
Jak ocenić i wybrać odpowiednie lokalne narzędzie do badania jakości danych
Wprowadzenie: Dlaczego jakość danych dyskretnie zawodzi w przedsiębiorstwie
Inżynier platformy danych zauważa, że nocny potok danych zakończył się pomyślnie. Zadanie w magazynie nie wykazuje stanu błędu, odświeżanie pulpitu nawigacyjnego zostało zakończone, a usługa BI jest dostępna. Później lider ds. governance stwierdza, że najnowszy raport korzysta z niepełnego ładowania, podczas gdy inżynier analityki odkrywa, że kolumna źródłowa zmieniła typ i wpłynęła na działanie systemów downstream.
Żadne z tych zdarzeń nie musi skutkować twardą awarią techniczną. Opóźniony plik może zawierać prawidłowe rekordy. Tabela może pozostać dostępna do zapytań po zmianie jej rozkładu. Modyfikacja schematu może przejść przez proces pozyskiwania, jednocześnie naruszając założenia w transformacji lub modelu. Sukces operacyjny i jakość danych to różne sygnały.
To rozróżnienie ma największe znaczenie w środowiskach, w których wrażliwe systemy pozostają lokalnie (on-premises), podczas gdy obciążenia analityczne i AI działają w środowiskach chmury prywatnej lub publicznej. Branże regulowane, takie jak administracja publiczna, usługi finansowe i opieka zdrowotna, często wymagają suwerenności danych, silnych mechanizmów kontroli bezpieczeństwa lub kompatywności ze starszymi systemami. Według szacunków rynkowych wdrożenia lokalne stanowią 37,5% globalnego rynku jakości danych w 2025 r., czyli około 1,8 miliarda dolarów, z prognozowanym wzrostem poniżej chmury na poziomie 13,8% CAGR do 2034 r. (Szacunki rynkowe jakości danych MarketIntelo). Zainstalowana baza nie znika z powodu ekspansji platform chmurowych.
Zasada praktyczna: Traktuj jakość danych jako problem z monitorowaniem w całym środowisku, a nie jako test dołączony do jednego potoku.
Podejście lokalne staje się przydatne, gdy warstwa monitorowania musi respektować lokalizację danych. Zamiast kopiować wrażliwe rekordy do zewnętrznej usługi, platforma może obliczać metryki wewnątrz infrastruktury kontrolowanej przez klienta i publikować zarządzane metadane, incydenty oraz trendy osobom, które ich potrzebują.
Ten przewodnik buduje decyzję stopniowo. Zaczyna się od modelu wykonawczego, porównuje kompromisy między rozwiązaniami lokalnymi a SaaS, identyfikuje funkcje, które wychwytują różne tryby awarii, a następnie analizuje bezpieczeństwo hybrydowe, wpływ branżowy i koszty. Ostateczna decyzja nie brzmi: „który produkt ma najdłuższą listę funkcji?”. Chodzi o to, czy model operacyjny potrafi wykryć istotne zmiany, zachować granice zaufania, wspierać odpowiedzialne usuwanie skutków awarii i pozostać uzasadnionym ekonomicznie dla zespołu platformy.
Czym naprawdę jest lokalne narzędzie do badania jakości danych
Pomyśl o centrum dystrybucyjnym, które obsługuje wrażliwe produkty. Inspektor jakości może zbadać każdą przesyłkę wewnątrz magazynu, zapisać pomiary i zgłosić, czy towary spełniają wymagania. Inspektor nie musi wysyłać każdego przedmiotu do zewnętrznego zakładu tylko po to, aby obliczyć ocenę jakości.
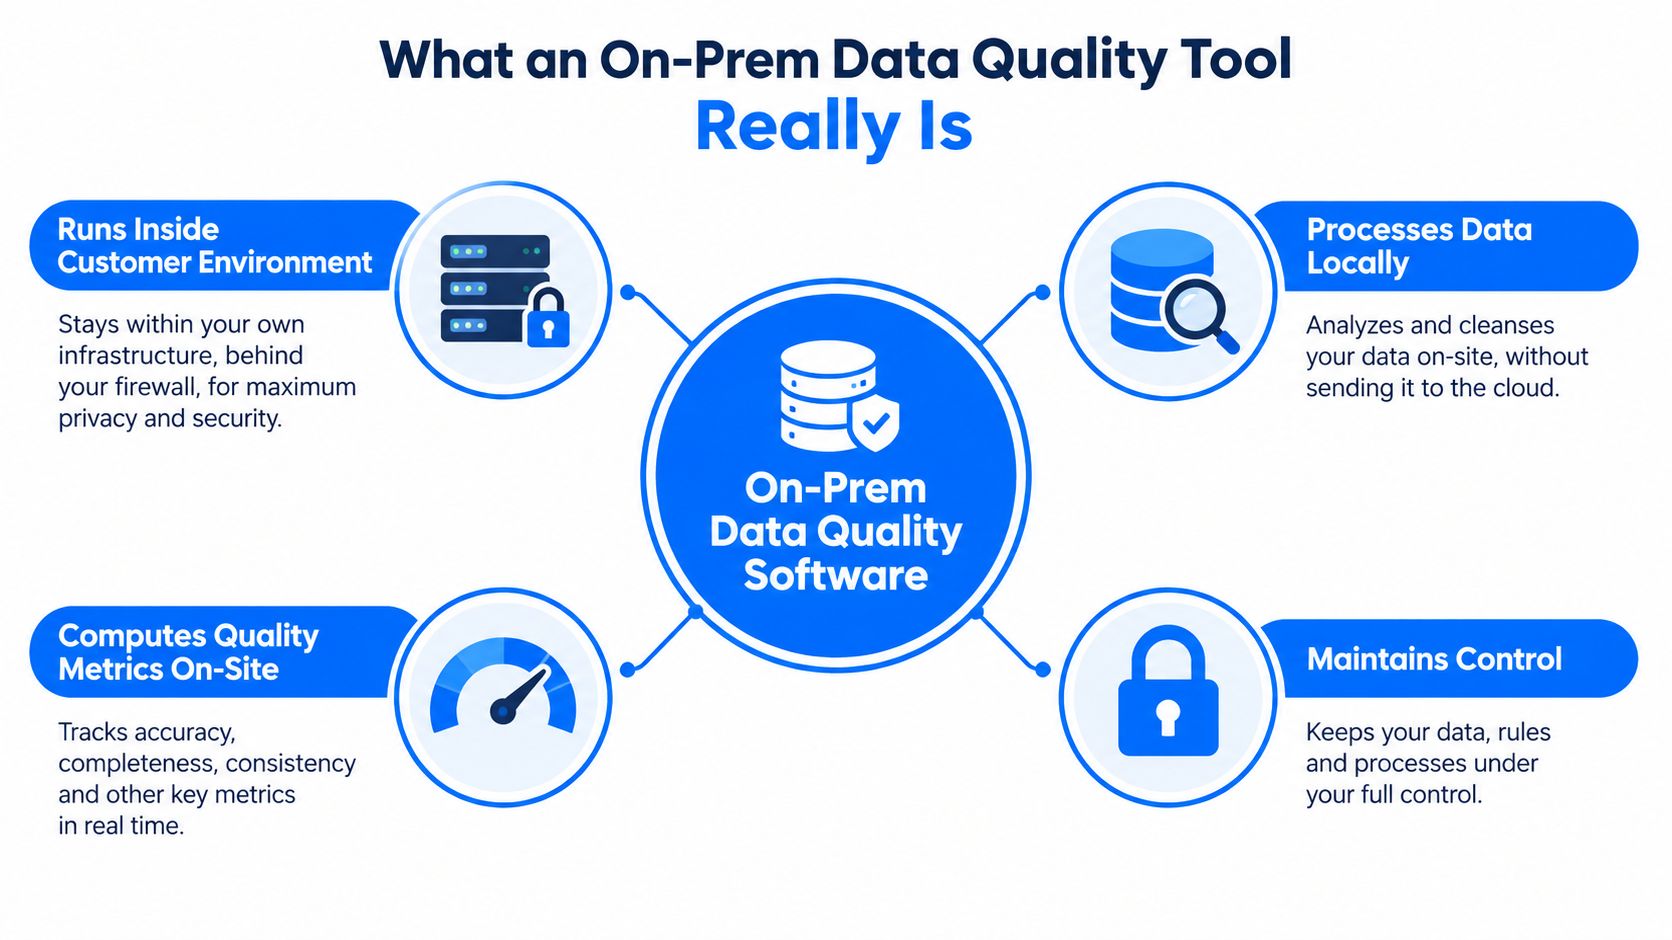
Lokalne narzędzie do badania jakości danych działa na tej samej zasadzie. Oprogramowanie działa wewnątrz własnego centrum danych klienta, chmury prywatnej, VPC lub kontrolowanej infrastruktury. Łączy się z bazami danych i platformami, na których już znajdują się rekordy, tam oblicza metryki jakości i wysyła autoryzowane wyniki do wspólnego interfejsu dla inżynierów, analityków i interesariuszy.
Zacznij od miejsca, w którym odbywają się obliczenia
Istotną różnicą nie jest to, gdzie hostowany jest interfejs użytkownika. Zapytaj, gdzie platforma odczytuje rekordy i wykonuje analizy. Wykonywanie zadań w bazie danych (in-database execution) oznacza, że narzędzie oblicza testy w środowisku bazy danych klienta, redukując ruch danych i pozostawiając wrażliwe rekordy na miejscu. Może również wspierać obliczanie metryk z mniejszym opóźnieniem, ponieważ analiza odbywa się tam, gdzie dane już się znajdują, jak opisano w wskazówkach digna dotyczących jakości danych w bazie danych.
Ta konstrukcja zmienia dyskusję o bezpieczeństwie. Zespół ds. bezpieczeństwa może przeglądać uprawnienia do bazy danych, ścieżki sieciowe, kontrolę tożsamości i dzienniki audytu w ramach ustalonych procesów przedsiębiorstwa. Platforma jakości danych staje się kolejnym kontrolowanym obciążeniem, a nie nową trasą do eksportowania danych produkcyjnych.
Oddziel wdrożenie od współpracy
Lokalne wdrożenie nie oznacza, że odizolowane zespoły muszą pracować bez wspólnego widoku. Przydatna platforma nadal zapewnia pulpity nawigacyjne pokazujące status incydentów, historię metryk, wyniki reguł, zmiany schematów i własność. Warstwa wykonawcza może pozostać blisko każdego źródła danych, podczas gdy warstwa prezentacji zapewnia różnym użytkownikom spójny obraz operacyjny.
Na przykład inżynier może badać nieudane zapytanie walidacyjne, analityk może przeglądać przesunięcie rozkładu, a lider ds. governance może potrzebować dowodu, że reguła biznesowa była monitorowana. Patrzą na różne konsekwencje tego samego stanu danych u podstaw.
Understand the governance boundary
Narzędzia SaaS zazwyczaj centralizują monitorowanie w środowisku zarządzanym przez dostawcę. Platforma lokalna zamiast tego przekazuje większą kontrolę klientowi, w tym w zakresie wdrażania, dostępu, aktualizacji, dostępności i integracji. Ta kontrola może zaspokoić wymagania dotyczące lokalizacji danych, ale wiąże się również z pracą operacyjną.
Właściwym pytaniem nie jest zatem to, czy rozwiązanie lokalne jest automatycznie bezpieczniejsze. Chodzi o to, czy Twoja organizacja może obsługiwać warstwę monitorowania zgodnie z własnymi standardami bezpieczeństwa i platformy, zachowując jednocześnie jednolity widok w środowiskach chmurowych i starszych systemach.
On-Prem vs SaaS Data Quality Tools Compared
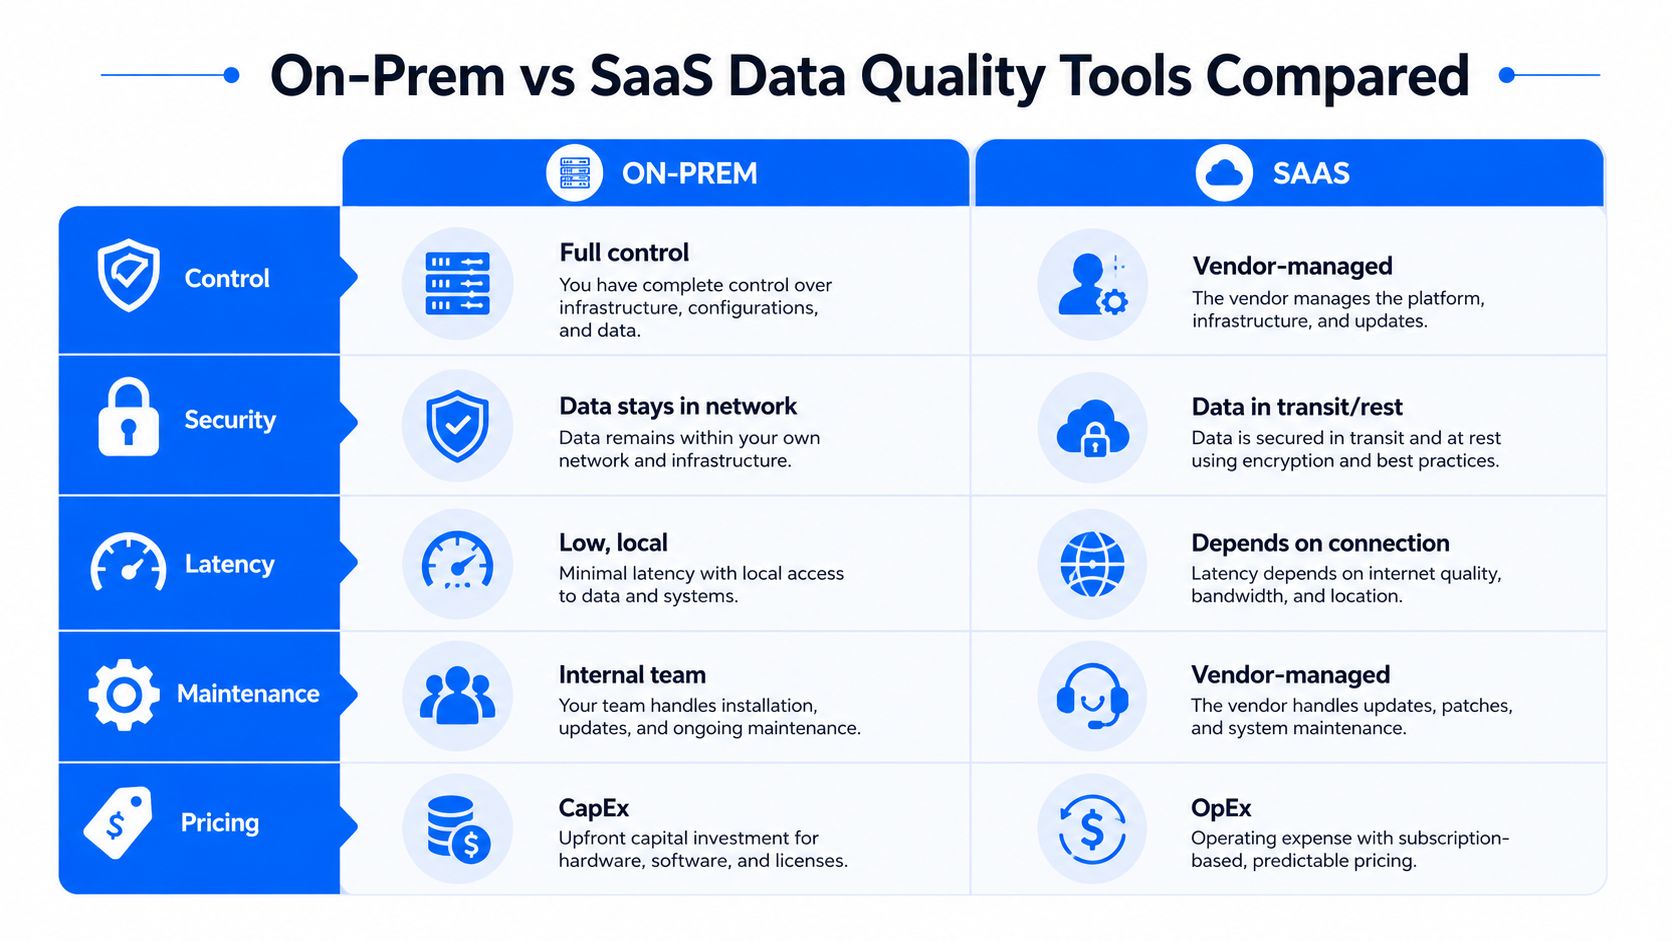
Porównanie należy rozpocząć od ograniczeń, a nie od preferencji dotyczących marki. Narzędzie lokalne zazwyczaj daje kupującemu większą kontrolę nad wykonywaniem zadań, umiejscowieniem w sieci i czasem aktualizacji. SaaS zazwyczaj zmniejsza obowiązki związane z instalacją i infrastrukturą, ale może wymagać przekroczenia przez dane, metadane lub wyniki monitorowania granicy, której zespoły podlegające regulacjom nie mogą zaakceptować.
Kryteria oceny | Narzędzie On-Prem | Narzędzie SaaS |
|---|---|---|
Kontrola | Klient kontroluje wdrożenie i infrastrukturę | Dostawca zarządza usługą |
Bezpieczeństwo | Dane mogą pozostać w sieci klienta | Ruch związany z danymi i monitorowaniem korzysta z zewnętrznych ścieżek usług |
Opóźnienie | Lokalne wykonywanie zadań może ograniczyć przesyłanie i zależność od połączeń | Wydajność zależy częściowo od łączności i architektury usług |
Utrzymanie | Zespoły wewnętrzne zarządzają operacjami i aktualizacjami | Dostawca zarządza większością operacji na platformie |
Cennik | Może wiązać się z kosztami infrastruktury i wewnętrznymi kosztami operacyjnymi | Koszty subskrypcji są powszechnie traktowane jako wydatki operacyjne |
Kompromisem jest odpowiedzialność operacyjna. Rozwiązanie lokalne daje zespołom ds. infrastruktury i bezpieczeństwa bezpośrednią kontrolę, ale muszą one planować pojemność, instalowanie poprawek, kopie zapasowe, wysoką dostępność, Observability samego narzędzia oraz przywracanie sprawności po awarii. SaaS może uprościć te obowiązki, chociaż nabywca nadal musi zarządzać dostępem, integracjami, Data Contract i własnością incydentów.
Dopasowanie decyzji do zasobów IT
Podejście lokalne jest często lepszym rozwiązaniem, gdy rekordy muszą pozostać w infrastrukturze kontrolowanej przez klienta, gdy starsze systemy są trudne do udostępnienia na zewnątrz lub gdy audytorzy wymagają szczegółowych dowodów dostępu i przetwarzania. Pasuje również do środowisk hybrydowych, w których kopiowanie danych do platformy SaaS stworzyłoby dodatkowe skomplikowanie pod względem lokalizacji, prywatności lub sieci.
SaaS może być prostszy dla zespołów o architekturze głównie chmurowej, ograniczonych możliwościach operacyjnych platformy i braku ograniczeń przed wysyłaniem wymaganych danych monitorowania do usługi zarządzanej przez dostawcę. Prostota może mieć znaczenie. Narzędzie, które zespół może wdrożyć, skonfigurować i spójnie utrzymywać, jest bardziej wartościowe niż teoretycznie idealna platforma, która nigdy nie trafia do środowiska produkcyjnego.
Decyzja ta przypomina inne wybory infrastrukturalne. Zespoły porównujące pocztę e-mail w chmurze z serwerem lokalnym stoją przed podobnym pytaniem o kontrolę, odpowiedzialność i wygodę obsługi. Ta sama zasada obowiązuje tutaj: wybierz granicę, która pasuje do modelu ryzyka i możliwości operacyjnych Twojej organizacji.
Praktyczny przegląd oprogramowania do badania jakości danych może pomóc zespołom sformułować warstwę funkcjonalną, ale wdrożenie nadal wymaga oceny każdego obciążenia z osobna. Zidentyfikuj, które zbiory danych są wrażliwe, gdzie muszą odbywać się obliczenia, jakie metadane mogą opuścić poszczególne środowiska i kto będzie wspierać platformę o drugiej w nocy.
Kluczowe funkcje, które powinno posiadać każde narzędzie lokalne
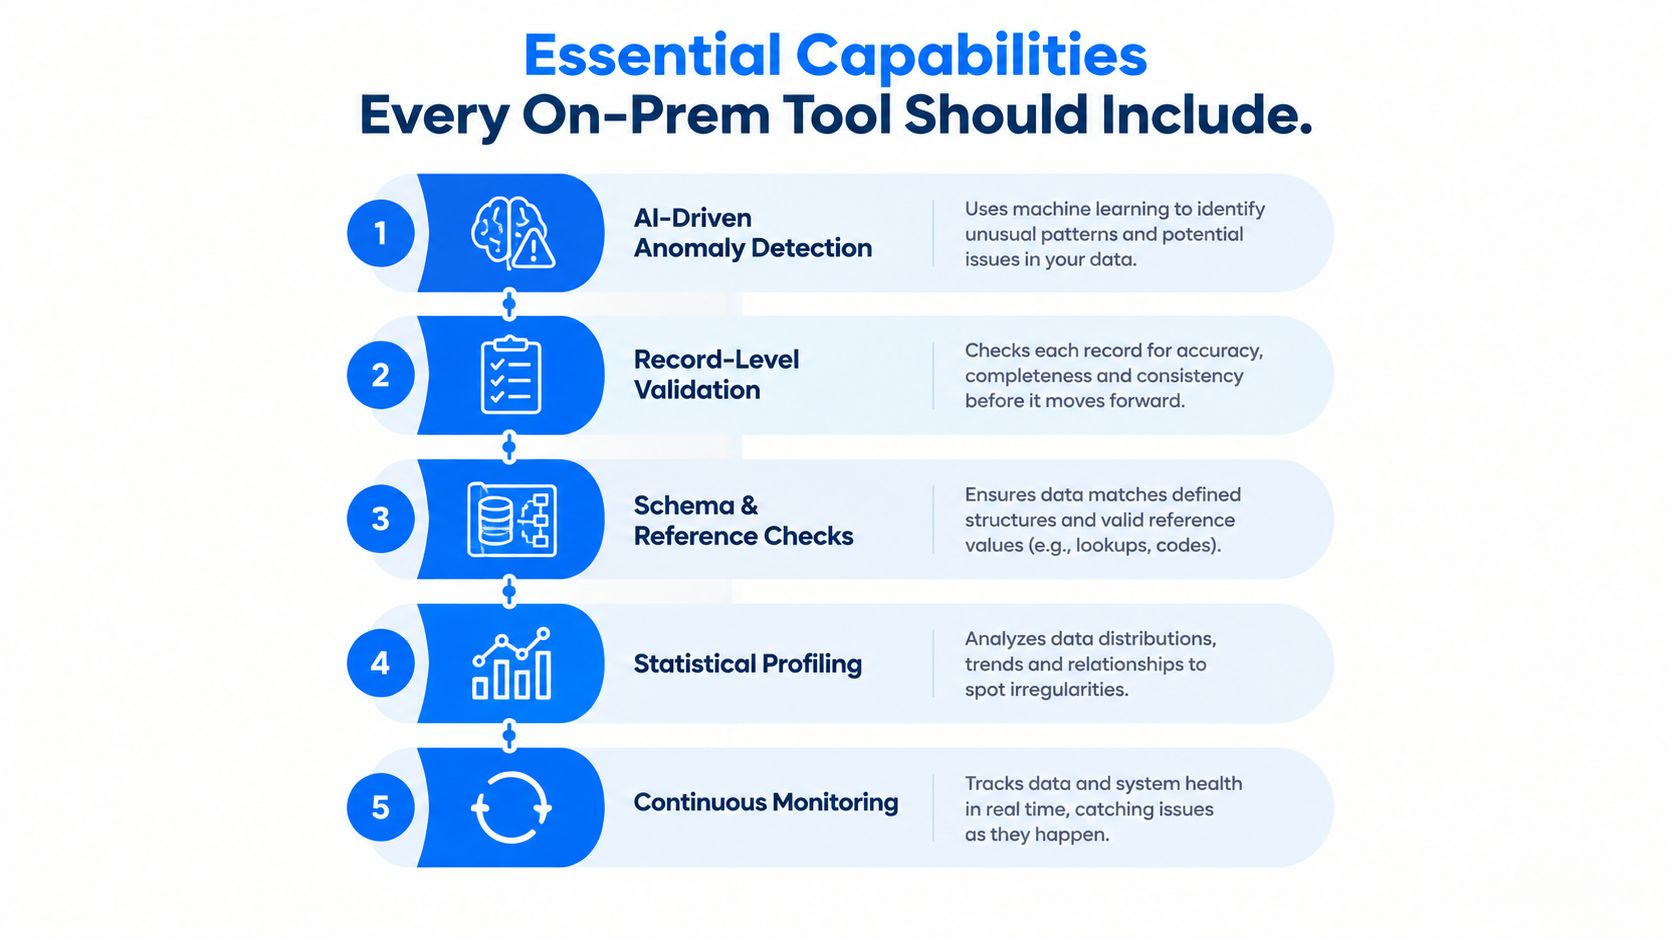
Platforma jakości zdobywa swoją pozycję poprzez wykrywanie różnych rodzajów awarii, a nie poprzez generowanie jednego ogólnego wyniku. Aktualność, wolumen, rozkład, schemat i walidacja reguł – każde z nich ujawnia inny symptom. Praktyczny model Observability łączy te sygnały, ponieważ opóźnione ładowanie niekoniecznie zmieni schemat, a ciche uszkodzenie danych może nie zmniejszyć liczby wierszy.
Aktualność i wolumen
Monitorowanie Timeliness sprawdza, czy dane dotarły wtedy, gdy oczekiwali tego odbiorcy. Powinno ono uwzględniać normalne wzorce dostarczania, harmonogramy, dane docierające z opóźnieniem, brakujące ładowania, ponowne próby i częściowe ładowania. Obliczanie oczekiwanego dostarczenia jest szczególnie przydatne, ponieważ stały próg może błędnie sklasyfikować źródło o zmiennym, ale przewidywalnym zachowaniu dostarczania.
Monitorowanie wolumenu wychwytuje inną klasę problemów. Potok może zakończyć się pomyślnie, ładując znacznie mniej lub więcej rekordów niż zwykle. Nagła zmiana wolumenu może wskazywać na zmianę filtra upstream, uszkodzone złączenie, awarię źródła lub nieoczekiwane zdarzenie biznesowe wymagające zbadania.
Rozkład i wykrywanie anomalii
Monitorowanie rozkładu bada wnętrze zbioru danych. Może zidentyfikować zmiany we wzorcach wartości, występowaniu wartości null, równowadze kategorii lub innych cechach statystycznych, których liczba wierszy nie ujawni. Oparte na sztucznej inteligencji uczenie się linii bazowej może zmniejszyć zależność od ręcznie konfigurowanych progów. Platforma uczy się normalnego zachowania dla zbioru danych i flaguje odchylenia do przeglądu.
Analityka historyczna dodaje kontekst. Pojedyncza nietypowa obserwacja może być nieszkodliwa, podczas gdy stopniowe przesunięcie metryk historycznych może wskazywać na degradację danych lub zmianę procesu. Zespoły potrzebują widoków trendów i zmienności, aby odróżnić jednorazowe zdarzenie od rozwijającego się problemu z niezawodnością.
Schemat i kontrole strukturalne
Śledzenie schematu nadzoruje umowę między producentami a konsumentami. Dodane lub usunięte kolumny, zmienione typy danych i zmodyfikowane struktury mogą uszkodzić transformacje, pulpity nawigacyjne lub modele, nawet gdy pozyskiwanie zgłasza sukces.
Silna implementacja rejestruje zmianę, identyfikuje zasoby, na które ma ona wpływ (tam, gdzie dostępna jest linia pochodzenia danych), i zapewnia zespołowi właścicielskiemu wystarczający kontekst, aby zdecydować, czy zmiana jest celowa. Monitorowanie schematu nie powinno jedynie informować, że „coś się zmieniło”. Powinno pomagać inżynierom ustalić, co się zmieniło i co może od tego zależeć.
Walidacja rekordów i logika biznesowa
Sygnały statystyczne nie zastępują reguł deterministycznych. Walidacja na poziomie rekordów sprawdza, czy wartości spełniają warunki biznesowe, powiązania referencyjne i wymogi audytu. Przykłady obejmują weryfikację, czy status jest zgodny z datą cyklu życia, czy transakcja spełnia zatwierdzoną klasyfikację lub czy wymagane pole jest wypełnione dla określonego typu rekordu.
Pięć sygnałów uzupełnia się wzajemnie. Aktualność mówi o tym, kiedy dane dotarły, wolumen – jak dużo ich dotarło, rozkład – jak zmieniło się ich zachowanie, schemat – czy przesunęła się ich struktura, a walidacja – czy rekordy spełniają założenia biznesowe.
Wykonywanie zadań w bazie danych ma znaczenie we wszystkich pięciu funkcjach. Obliczanie metryk tam, gdzie dane już się znajdują, zmniejsza niepotrzebny ruch i pozwala narzędziu działać w pobliżu dużych lub wrażliwych zbiorów danych. Platforma nadal potrzebuje wydajnych zapytań, rozsądnego harmonogramowania, uprawnień i kontroli zasobów, ponieważ lokalne wykonywanie zadań nie eliminuje potrzeby odpowiedzialnego zarządzania obciążeniem pracą.
Bezpieczeństwo wdrożenia i model operacyjny dla środowisk hybrydowych
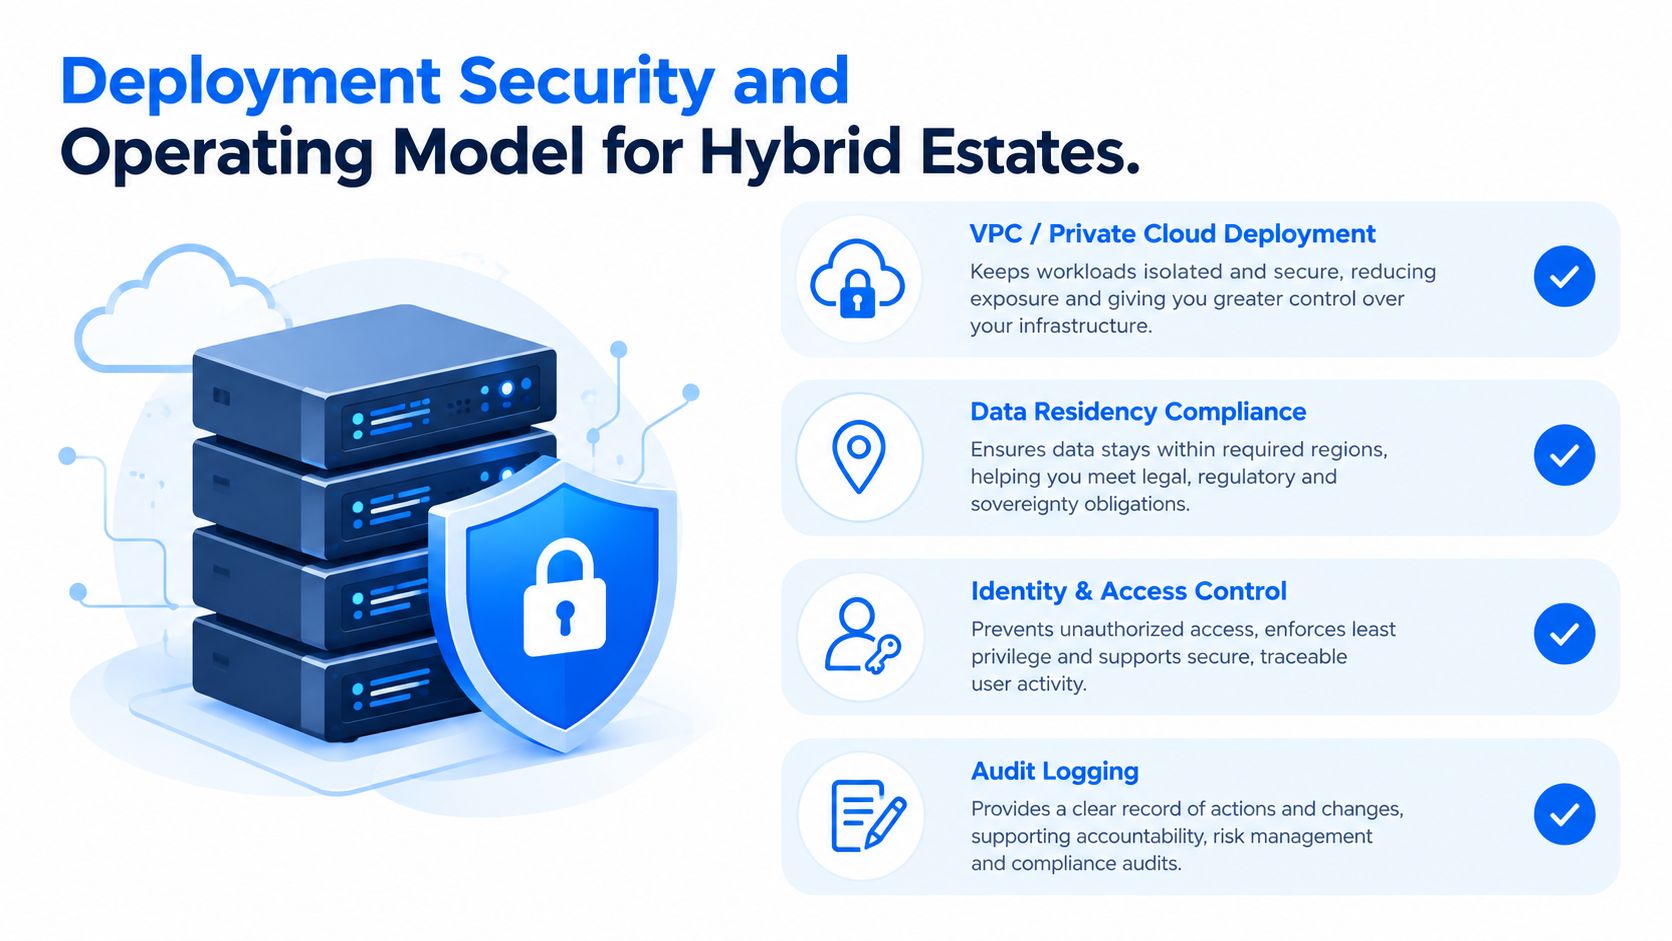
Środowiska hybrydowe ujawniają słabość traktowania modelu on-premises jako pojedynczego wyboru instalacyjnego. Klient może przechowywać dane transakcyjne w centrum danych, prowadzić magazyn w chmurze prywatnej i korzystać z usług chmurowych do analityki lub tworzenia modeli. Warstwa monitorowania musi obserwować te systemy bez przekształcania każdej granicy zaufania w problem związany z eksportem danych.
Weryfikacja granic wdrożenia
Zacznij od wspólnego przeglądu z udziałem zespołów ds. platformy danych, bezpieczeństwa, infrastruktury, prywatności i governance. Poniższe pytania pozwalają wykryć luki, zanim zakup stanie się wyjątkiem w architekturze:
Lokalizacja wykonywania zadań: Gdzie działa narzędzie i gdzie są wykonywane zapytania?
Ruch danych: Czy surowe rekordy opuszczają środowisko, czy też platforma zwraca tylko metryki i metadane?
Tożsamość: Czy narzędzie może korzystać z tożsamości przedsiębiorstwa i kontroli dostępu opartej na rolach?
Lokalizacja danych: Czy każda domena danych może pozostać w wymaganej jurysdykcji i granicy infrastrukturalnej? Przed zatwierdzeniem łączności zapoznaj się z odpowiednimi wymogami dotyczącymi lokalizacji danych.
Pochodzenie (Lineage): Czy zespoły mogą śledzić problem w zasobach chmurowych i lokalnych bez centralizowania wrażliwych rekordów?
Dostęp do systemów starszego typu: Czy platforma może łączyć się ze starszymi bazami danych i systemami operacyjnymi bez konieczności migracji?
Dowody audytowe: Czy wykonania reguł, zdarzenia dostępu, zmiany konfiguracji i decyzje dotyczące incydentów są rejestrowane?
Operacje: Kto jest właścicielem poprawek, aktualizacji, kopii zapasowych, pojemności, certyfikatów i testów odzyskiwania sprawności?
Działanie ponad granicami zaufania
Zintegrowany pulpit nawigacyjny nie wymaga jednego jeziora danych dla całego monitorowania. Model rozproszony może wykonywać kontrole lokalnie w każdym środowisku, zachowywać surowe dane u źródła i udostępniać kontrolowane wyniki jakości za pośrednictwem zatwierdzonych kanałów. Takie podejście zapewnia centralnym zespołom governance widoczność, jednocześnie pozwalając lokalnym właścicielom platform kontrolować dostęp i wykonywanie zadań.
Model operacyjny musi również definiować własność. Bezpieczeństwo może zatwierdzić łączność, ale właściciele danych muszą zdecydować, czy anomalia jest oczekiwana. Zespoły platformowe utrzymują usługę, podczas gdy zespoły domenowe usuwają wady źródłowe lub transformacyjne. Bez tych ról instalacja lokalna może stać się kolejną odizolowaną wyspą monitorowania.
Branżowe przypadki użycia: ROI i wpływ operacyjny
Uzasadnienie ekonomiczne dla lokalnej kontroli jakości danych zależy od tego, ile kosztuje Twoją organizację awaria i jakie obowiązki może ona zaabsorbować. Cena licencji to tylko jedna pozycja. Szersza kalkulacja obejmuje ponowną pracę analityków, dochodzenie inżynieryjne, opóźnione raportowanie, niepotrzebne zużycie platformy, przygotowanie do audytu oraz operacyjny koszt prowadzenia usługi monitorowania.
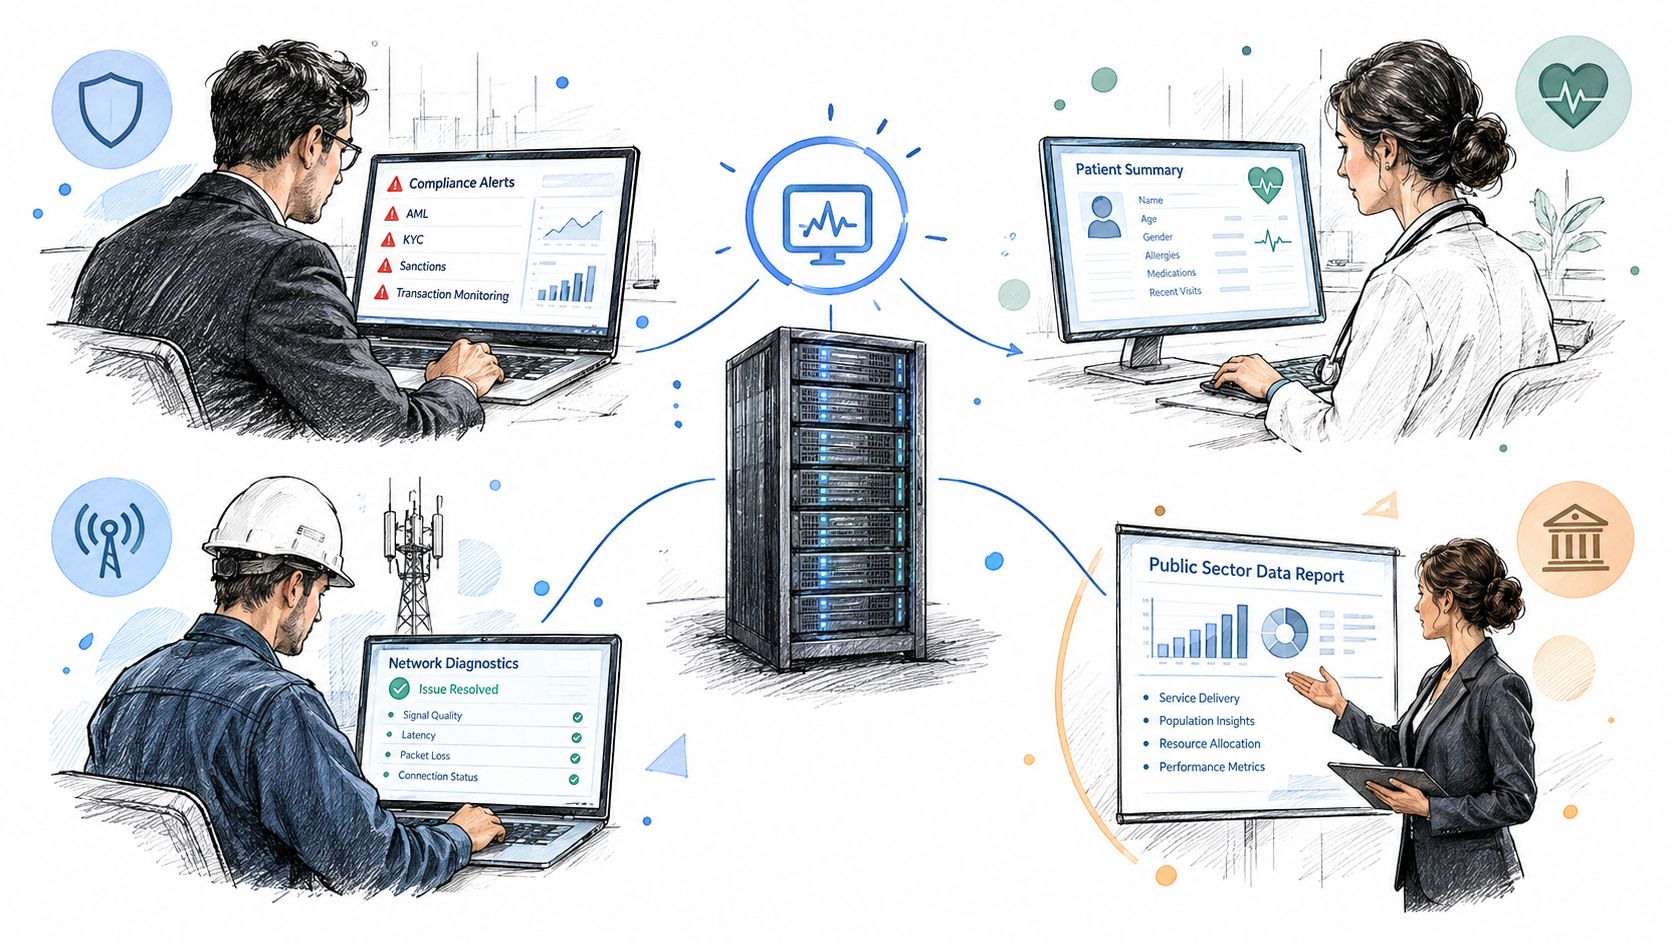
W finansach zespół może stosować walidację na poziomie rekordów do krytycznych transakcji, monitorować czas dostarczania danych o ryzyku i śledzić zmiany schematów przed przerwaniem raportowania regulacyjnego. Zespoły medyczne mogą priorytetowo traktować lokalizację danych, kontrolowany dostęp oraz dowody na to, że reguły biznesowe zostały zastosowane do wrażliwych danych klinicznych lub operacyjnych. Zespoły telekomunikacyjne często potrzebują monitorowania anomalii i wolumenu w źródłach operacyjnych o wysokiej przepustowości, podczas gdy zespoły z sektora publicznego mogą cenić identyfikowalność i spójną kontrolę nad starszymi systemami.
Mierzenie wpływu operacyjnego, a nie próżnych wskaźników
Użyteczny model ROI pyta, co się zmienia po tym, jak wykrywanie staje się ciągłe:
Wcześniejsze wykrywanie incydentów: Zespoły identyfikują opóźnione ładowania, zanim nieaktualne pulpity nawigacyjne trafią do decydentów.
Krótszy czas dochodzenia: Rozkład, schemat i kontekst historyczny zawężają poszukiwania przyczyny źródłowej.
Mniejszy nakład pracy poprawkowej: Analitycy spędzają mniej czasu na uzgadnianiu raportów, które wykorzystywały niezgodne lub niekompletne dane wejściowe.
Lepsza gotowość do audytu: Wyniki reguł i historia operacyjna dostarczają dowodów do przeglądu.
Kontrolowane zużycie: Zespoły platformowe mogą wykryć nietypowe obciążenia pracą i zachowania danych, zanim wygenerują one możliwe do uniknięcia koszty lub presję na pojemność.
Większe zaufanie: Użytkownicy biznesowi mogą widzieć status monitorowania zamiast polegać na nieformalnych zapewnieniach.
Kompromis jest jasny. Rozwiązanie lokalne może ograniczyć ruch danych i wspierać Compliance, ale nabywca bierze na siebie infrastrukturę, wdrożenie i utrzymanie. Raporty z badań nad Observability wskazują, że 56,8% respondentów uznało koszt narzędzi za problem, podczas gdy 29,3% wskazało na nieprzewidywalne roczne rachunki, a 27,3% zwróciło uwagę na wydatki CapEx i OpEx na zarządzanie danymi (Raport ManageEngine State of Observability 2025). Wyniki te wzmacniają potrzebę porównania ekspozycji na subskrypcję z wewnętrznymi obowiązkami pracowniczymi i infrastrukturalnymi, zamiast patrzenia wyłącznie na wycenioną licencję.
Czas do osiągnięcia wartości wymaga prawdziwego testu
Strona ze studium przypadku firmy Acceldata informuje, że jej platforma zweryfikowała ponad miliard wierszy dla 50 krytycznych reguł jakości danych w niecałe 2 godziny (Studia przypadków Acceldata). Jest to punkt odniesienia zgłoszony przez dostawcę, a nie obietnica dla każdego środowiska.
Opublikowane doświadczenie z wdrożenia digna jest podobnie warunkowe: „W dużym stopniu zależy to od klienta; jeśli wszystko jest przygotowane, nie trwa to dłużej niż 2 godziny. Tak było w przypadku naszej pierwszej instalacji digna w IT-Services of Austria Social Security”. Praktyczna lekcja polega na tym, aby jednoznacznie przetestować prace przygotowawcze. Zatwierdzenia połączeń, reprezentatywne tabele, reguły, własność i kierowanie alertów decydują o tym, jak szybko wdrożenie przyniesie przydatne dowody.
Jak ocenić i wybrać odpowiednie lokalne narzędzie do badania jakości danych
Użyj pilotażu, aby przetestować model operacyjny, a nie tylko interfejs. Wybierz reprezentatywne zbiory danych zarówno ze środowiska starszego typu, jak i platformy chmurowej, a następnie zweryfikuj, czy narzędzie może je monitorować bez przenoszenia wrażliwych rekordów do zewnętrznej usługi.
Twoja ocena powinna odpowiedzieć na następujące pytania:
Wykonywanie zadań: Czy metryki są obliczane w środowisku lub bazie danych klienta?
Zakres: Czy jedna platforma może łączyć wykrywanie anomalii, walidację, aktualność, schemat i analitykę historyczną?
Linie bazowe: Czy wykrywanie anomalii uczy się zachowania zbioru danych bez zmuszania inżynierów do utrzymywania każdego progu?
Kontekst: Czy alert może pokazać zasoby, których dotyczy problem, zachowanie historyczne i własność?
Integracja: Czy łączy się z bazami danych, magazynami, harmonogramami, systemami tożsamości i kanałami powiadomień już będącymi w użyciu?
Operacje: Czy Twój zespół może instalować poprawki, tworzyć kopie zapasowe, skalować i odzyskiwać system zgodnie z istniejącymi standardami?
Cennik: Czy model jest zrozumiały i pozwala uniknąć nieprzewidywalnych opłat za każde skanowanie, alert czy wywołanie API?
Adopcja: Czy inżynierowie, analitycy i użytkownicy governance mogą pracować na tym samym widoku statusu i incydentów?
Zacznij od jednego modułu o wysokiej wartości i jasno określonego zbioru danych. Zmierz, czy program pilotażowy wykrywa znane tryby awarii pod względem świeżości, rozkładu, schematu i walidacji, a następnie oblicz wewnętrzny nakład pracy wymagany do jego obsługi. Dobrze skonstruowany uzasadnienie biznesowe dla jakości danych powinno obejmować uniknięcie ponownej pracy, reagowanie na incydenty, przygotowanie do audytu, infrastrukturę, pracę platformy oraz wartość wynikającą z utrzymania danych w zatwierdzonych granicach.
Rozmowa z dostawcą powinna również obejmować dowody wdrożenia, a nie tylko demonstrację funkcji. Poproś o przegląd architektury, omówienie bezpieczeństwa, reprezentatywną integrację i test czasu do pierwszego alertu. Jeśli odnosisz się do przykładowej platformy, zachowaj dokładną stylizację marki: digna używa małej litery „d”.
digna zapewnia korporacyjną platformę jakości danych i Observability, która działa w środowisku klienta, z wykonywaniem zadań w bazie danych na potrzeby wykrywania anomalii, walidacji, aktualności i monitorowania schematów. Odwiedź digna, aby zapoznać się z lokalnym modelem operacyjnym dla hybrydowych zasobów danych i ocenić, czy spełnia on Twoje wymagania w zakresie bezpieczeństwa, ładu danych i niezawodności.
Najczęściej zadawane pytania
Co czyni narzędzie jakości danych rozwiązaniem on-premise?
To, gdzie odbywa się obliczenie, a nie gdzie hostowany jest interfejs. Liczy się, czy zapytania wykonują się wewnątrz Twojej sieci i czy surowe rekordy opuszczają środowisko, czy wracają wyłącznie wskaźniki i metadane. Ta jedna decyzja projektowa zmienia całą rozmowę o bezpieczeństwie.
Czy on-premise jest automatycznie bezpieczniejsze niż SaaS?
Nie, i to złe pytanie. SaaS centralizuje monitoring w środowisku zarządzanym przez dostawcę, a on-premise utrzymuje wykonywanie w infrastrukturze klienta i przenosi na niego odpowiedzialność operacyjną. Właściwe porównanie zaczyna się od ograniczeń: rezydencji danych, dostępu do systemów starszej generacji i dowodów audytowych.
Jakie zdolności powinien udowodnić pilotaż on-premise?
Pięć uzupełniających się sygnałów. Świeżość mówi, kiedy dane dotarły, wolumen ile ich dotarło, rozkład jak zmieniło się ich zachowanie, schemat czy ruszyła struktura, a walidacja czy rekordy spełniają intencję biznesową. Platforma, która zamiast tego daje jedną ogólną ocenę, nie zasłużyła na swoje miejsce.
Co powinien obejmować przegląd wdrożenia?
Osiem pytań uzgodnionych wspólnie przez zespoły platformy danych, bezpieczeństwa, infrastruktury, prywatności i governance: miejsce wykonywania, ruch danych, tożsamość i dostęp oparty na rolach, rezydencję per dziedzina, lineage przez granice, dostęp do starszych baz, dowody audytowe oraz to, kto odpowiada za łatki, aktualizacje, kopie i testy odtworzenia.
Jak duży jest segment on-premise?
Szacunek rynkowy umieszcza wdrożenia on-premise na poziomie 37,5 % globalnego rynku jakości danych w 2025 r., czyli około 1,8 mld USD, przy CAGR 13,8 % do 2034 r., poniżej segmentu chmurowego. Segment się utrzymuje, bo wrażliwe systemy zostają lokalnie, a analityka przenosi się do chmury.


