Monitoring i raportowanie: Praktyczny przewodnik na rok 2026
|
9
min. czyt.

Znasz już tę sytuację. Pulpity są zielone, cotygodniowy raport został wysłany na czas, a potem menedżer produktu pisze do Ciebie, ponieważ biznes zauważył nieaktualne ładowanie danych na kilka godzin przed Twoim alertem. Problem zwykle nie polega na tym, że zespołom brakuje danych, ale na tym, że zbudowały stos raportowania, który opisuje rzeczywistość po fakcie, zamiast monitorować ją na bieżąco, gdy się zmienia.
Ta luka pojawia się najpierw w środowiskach regulowanych. Systemy publiczne dawno temu nauczyły się, że linia bazowa, odchylenie, opóźnienie i naprawa znaczą więcej niż jednorazowa publikacja, dlatego CDC kładzie nacisk na regularną analizę okresową, porównywanie z poprzednimi 5 latami oraz przegląd trendów dotyczących osób, miejsc i czasu w pracach nadzorczych (Wskazówki CDC dotyczące analizy nadzoru). Observability w przedsiębiorstwach odziedziczyło tę logikę, nawet jeśli narzędzia wyglądają na nowsze.
Spis treści
Dlaczego monitorowanie i raportowanie często się nie udaje, zanim jeszcze się rozpocznie
Definiowanie wskaźników KPI, które przetrwają kontakt z rzeczywistością
Wykrywanie anomalii, Timeliness, walidacja i śledzenie schematu
Pulpity nawigacyjne i alerty, z których różne zainteresowane strony będą faktycznie korzystać
Wybory wdrożeniowe, które kształtują architekturę monitorowania
Scenariusze operacyjne (Playbooki) dla inżynierów danych i interesariuszy
Raportowanie jako dowód decyzji, a nie późniejsza refleksja nad Compliance
Dlaczego monitorowanie i raportowanie często się nie udaje, zanim jeszcze się rozpocznie
Zespół może wdrożyć pulpit nawigacyjny, podłączyć kilka alertów, a i tak przegapić kluczowy moment. System wygląda na kompletny w slajdach, a potem biznes jako pierwszy zauważa problem, ponieważ nikt nie powiązał metryk z decyzją, progiem opóźnienia ani wskazanym właścicielem.
Prawdziwa luka leży zwykle między przechwytywaniem danych a działaniem
Dyscyplina raportowania w sektorze publicznym ułatwia rozpoznanie tego niepowodzenia. Oczekuje się, że programy będą mapować to, co już istnieje, identyfikować luki i budować rekomendacje wokół lokalnego kontekstu, zamiast zakładać, że samo przechwytywanie rozwiązuje problem. Wytyczne UNICEF dotyczące wzmacniania systemów monitorowania i raportowania mówią dokładnie to samo w praktyce, nawet jeśli sformułowanie pozostaje dyplomatyczne (Systemy monitorowania i raportowania UNICEF). Ta sama luka pojawia się w platformach danych przedsiębiorstw. Potok może poprawnie gromadzić metrykę i nadal zawodzić, jeśli nikt nie zdefiniował, kto z niej korzysta, co robi dalej i jak szybko musi się o tym dowiedzieć.
Zasada praktyczna: jeśli alert nie wskazuje właściciela, progu i ścieżki naprawczej, jest to jedynie komentarz.
Słabe projektowanie wskaźników pogarsza problem. Wytyczne ONZ dotyczące weryfikacji wymagają, aby każdy wskaźnik posiadał jasną notę metodologiczną, jednostkę miary, metodę obliczania, źródło danych, metodę zbierania, częstotliwość i narzędzie, ponieważ w przeciwnym razie raportów nie można poddać audytowi ani odtworzyć (Wytyczne ONZ dotyczące weryfikacji odzwierciedlone w praktyce monitorowania powiązanej z ECDC). To jest ta część, którą zespoły w przedsiębiorstwach często pomijają. KPI bez kontraktu to zgadywanie z dołączonym wykresem i zwykle rypie się, gdy tylko odbiorcy poproszą o identyfikowalną odpowiedź.
Ciągłe monitorowanie wygrywa z jednorazową konfiguracją
Programy monitorowania zawodzą również wtedy, gdy zespoły traktują je jako jednorazową konfiguracją. Źródła się rozjeżdąją, schematy zmieniają, linie bazowe przesuwają, a kadencja raportowania, która działała przy wdrożeniu, przestaje odpowiadać rzeczywistości. Wskazówki CDC dotyczące analizy zwracają uwagę na ten sam aspekt operacyjny poprzez pracę nadzorczą, dlatego używam ich jako przypomnienia, że analiza nie jest osobną fazą od monitorowania, lecz częścią pętli kontrolnej (Wskazówki CDC dotyczące analizy nadzoru). W praktyce pierwszy przegląd powinien odpowiedzieć na pytanie, czy sygnał nadal odpowiada procesowi biznesowemu, do którego obserwacji zostaħ stworzony.
W tym miejscu historyczna dyscyplina raportowania łączy się z nowoczesnymi modułami Observability. Systemy publiczne budowano wokół linii bazowej, odchylenia, opóźnienia i naprawy. Nowoczesne stosy danych potrzebują tej samej logiki, tyle że wdrożonej za pomocą kontroli schematu, kontroli świeżości, przesunięcia dystrybucji i kierowania do właściciela, dopasowanych do modelu wdrożenia. Jeśli platforma działa w bazie danych lub lokalnie (on-prem), to ograniczenie musi kształtować projekt od samego początku, ponieważ niektóre zespoły nie mogą przesyłać telemetryki do zewnętrznej usługi, a inne nie mogą zaakceptować warstwy monitorowania oddalonej od danych, które obserwuje. Przegląd metryk jakości danych digna (przegląd metryk jakości danych digna) stanowi przydatny punkt odniesienia do tego, jak te metryki są formułowane w praktyce.
Dlatego pierwsze pytanie, jakie zadaję, nie brzmi: „Jaki masz pulpit nawigacyjny?”, lecz: „Jaką decyzję wyzwala to raportowanie i co się zmieniło od zeszłego miesiąca?”. Jeśli odpowiedź jest niejasna, stos gromadzi sygnały, nie generując żadnego działania.
Definiowanie wskaźników KPI, które przetrwają kontakt z rzeczywistością
Wiceprezes zapytała kiedyś, dlaczego jej pulpit nawigacyjny pokazuje 98% dokładności, podczas gdy inżynier dyżurujący widział 62% na kanale incydentów. Wskaźnik KPI wyglądał na czysty, dopóki ktoś nie zapytał, jak został obliczony, z którego systemu pochodzi i co uznano za awarię. To zazwyczaj moment, w którym stos raportowania przestaje być pomocą zarządczą, a staje się powodem do kłótni o definicje.
Zapisuj każdy KPI jako kontrakt, a nie hasło reklamowe
Raportowanie w sektorze publicznym zawsze traktowało linię bazową, odchylenie, opóźnienie i naprawę jako część tej samej pętli kontrolnej. Zespoły ds. danych w przedsiębiorstwach potrzebują tej samej dyscypliny, ponieważ KPI sprawdza się tylko wtedy, gdy można go wyjaśnić, odtworzyć i podjąć na jego podstawie działanie. Ramy monitorowania ECDC są przydatnym punktem odniesienia dla tego stylu szczegółowości, a praktyczna zasada jest prosta: jeśli interesariusz nie potrafi odtworzyć logiki, KPI nie jest gotowy.
Każdy KPI powinien określać źródło, jednostkę, metodę obliczania, częstotliwość, właściciela i zasadę naprawczą. Ten poziom szczegółowości ma największe znaczenie w środowiskach regulowanych, gdzie zespoły często muszą bronić liczby po fakcie i wykazać, jak została wygenerowana.
Użyj prostej listy kontrolnej:
Źródło: tabela, strumień lub system ewidencji, z którego pochodzi metryka.
Jednostka: wiersze, minuty, rekordy, procenty lub inna jawna jednostka.
Metoda obliczania: dokładna agregacja lub logika.
Częstotliwość: jak często się aktualizuje i jak często jest weryfikowana.
Właściciel: osoba lub zespół odpowiedzialny za działanie.
Zasada naprawcza: co się dzieje, gdy metryka przekroczy granicę.
Rozróżnienie między terminowością, kompletnością a poprawnością ma znaczenie, ponieważ każda z tych cech zawodzi w inny sposób. Terminowość mówi, czy dane dotarły na czas. Kompletność mówi, czy zestaw danych zawiera to, czego wymaga kolejny proces. Poprawność (walidacja) mówi, czy rekordy są zgodne z regułami biznesowymi lub strukturalnymi. Jeśli wrzucisz wszystkie trzy do jednego progu i jednego kanaħu alertów, operatorzy zaczną otrzymywać hałasliwe powiadomienia, a ważne ostrzeżenia będą ignorowane.
Oddzielam również metryki zgodności (compliance) od metryk operacyjnych i dopasowania biznesowego. Jeden pulpit nawigacyjny nie powinien zawierać wszystkich trzech rodzajów bez rozmywania przekazu dla odbiorców. Zespoły ds. zgodności potrzebują dowodów, zespoły ds. platformy – wczesnego ostrzegania, a właściciele biznesowi chcą wiedzieć, czy zestaw danych nadal wspiera podejmowaną decyzję. Rządowe wytyczne i zalecenia skupione na równości coraz częściej oczekują od monitorowania wykazania, czy dociera się do marginalizowanych grup społecznych, więc zestaw KPI musi odzwierciedlać zadawane pytanie, a nie tylko dane, które łatwo policzyć.
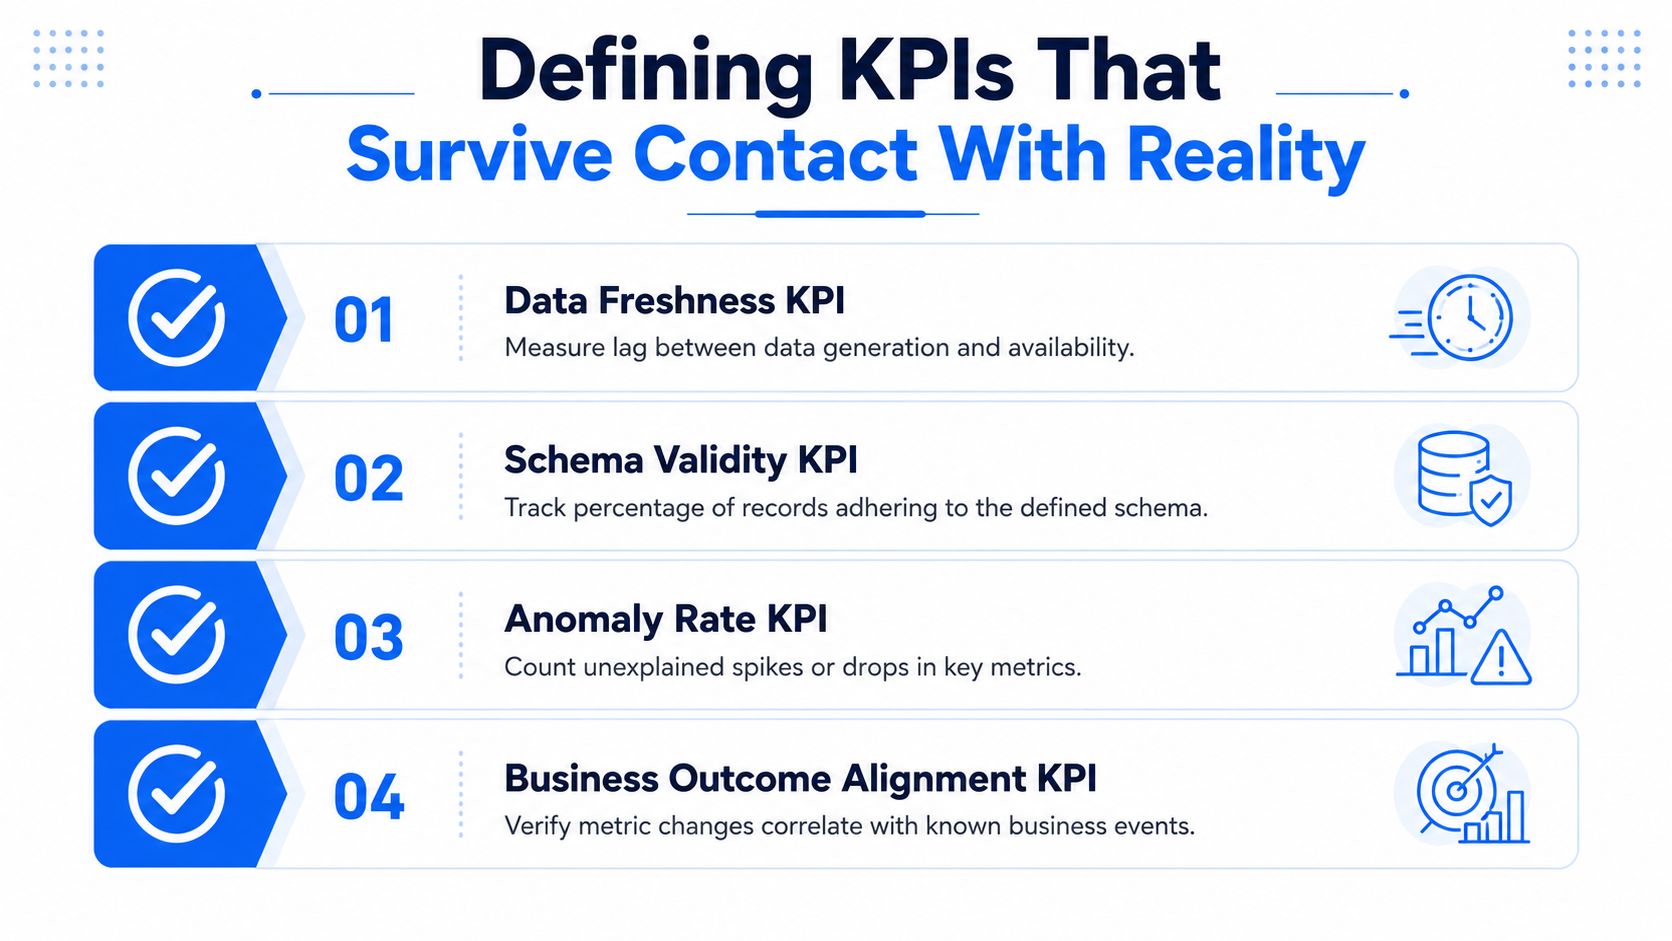
Dla zespołów wdrążających tę dyscyplinę do własnego stosu, praktycznym punktem odniesienia jest wewnętrzny przewodnik po metrykach jakości danych. Celem nie jest mnożenie wskaźników KPI. Chodzi o to, aby każdy z nich był do obrony, gdy potok zacznie działać nieprawidłowo.
Wykrywanie anomalii, terminowość, walidacja i śledzenie schematu
Zespół ds. płac zauważa, że na koniec miesiąca wolumen danych wygląda normalnie, ale jeden system źródłowy zaczął wysyłać dane o nietypowych porach, reguła w kolejnym kroku zaczęła odrzucać poprawne rekordy, a zmiana nazwy kolumny popsuła zadanie raportowania. To rodzaj awarii, którą monitorowanie musi wychwycić wcześnie. Przydatny widok to nie pojedynczy rodzaj alertu. To zestaw kontroli, które pokazują, czy potok jest opóźniony, błędny, rozjeżdża się czy też zmienił się strukturalnie, zanim ktoś będzie musiał ręcznie naprawiać szkody.
Cztery warstwy techniczne zazwyczaj decydują o tym, czy monitorowanie jest przydatne, czy ozdobne. Powinny tworzyć jeden spójny obraz niezawodności, mimo że każda z nich odpowiada na inne pytanie. Jeśli znajdują się w rozproszonych narzędziach, zespoły kończą ze zduplikowanymi alertami, niejasną odpowiedzialnością i analizą incydentów, która trwa dłużej niż sama naprawa.
Gdzie zazwyczaj pojawia się luka
Monitorowanie terminowości powinno być zazwyczaj pierwszą rzeczą do wdrożenia w środowisku regulowanym. Opóźnione ładowania, brakujące dostawy i rozjazdy w czasie szybko przekładają się na uszkodzone raporty i łatwiej je wyjaśnić interesariuszom niż subtelny spadek jakości. W przypadku wdrożeń w bazie danych lub on-prem, kontrole świeżości muszą również uwzględniać lokalne okna zadań, harmonogramy wsadowe i przepustowość sieci, ponieważ alert jest przydatny tylko wtedy, gdy odzwierciedla rzeczywistą ścieżkę operacyjną.
Walidacja na poziomie rekordów wychwytuje przypadki, które docierają na czas, ale nie spełniają reguł biznesowych. Należą tu niepoprawne stany, niemożliwe wartości i rekordy, które są zgodne ze schematem, ale naruszają logikę procesu. Historyczne raportowanie w sektorze publicznym zawsze opierało się na tej dyscyplinie – najpierw linia bazowa, potem odchylenie, a na końcu naprawa – ponieważ czysty znacznik czasu dostawy nie oznacza, że raportowi można ufać.
Śledzenie schematu obserwuje dodane kolumny, usunięte kolumny i zmiany typów danych. Chroni zadania w kolejnych krokach przed cichym uszkodzeniem, gdy zespół na wczesnym etapie wprowadza zmianę bez koordynacji. W środowiskach o ścisłej kontroli ta warstwa ma jeszcze większe znaczenie, ponieważ zmiana schematu może wpłynąć na buforowane ekstrakty, procedury składowane lub transformacje w bazie danych, które trudniej szybko załatać.
Wykrywanie anomalii porównuje bieżące zachowanie z wyuczoną linią bazową i szuka odchyleń w wolumenie, dystrybucji lub zmienności. To warstwa, która wychwytuje problemy, których nikt nie zaplanował – skok, spadek lub stopniowe przesunięcie, które w przeciwnym razie stopiłoby się z rutynowym szumem. Praktycznym odniesieniem dla tego typu monitorowania jest wykrywanie anomalii w szeregach czasowych, szczególnie gdy zespoły muszą odróżnić normalną sezonowość od zmiany wymagającej uwagi.
Warstwa | Główne pytanie | Typowy wyzwalacz | Właściciel |
|---|---|---|---|
Monitorowanie terminowości | Czy dane dotarły na czas? | Opóźnione, brakujące lub przedwczesne ładowanie | Właściciel potoku |
Walidacja | Czy rekord jest zgodny z regułami? | Naruszenie reguły biznesowej lub niepoprawna wartość | Zespół dziedzinowy lub właściciel jakości danych |
Śledzenie schematu | Czy struktura uległa zmianie? | Dodana, usunięta lub zmieniona typem kolumna | Producent właściwy lub zespół platformy |
Wykrywanie anomalii | Czy zachowanie odbiega od linii bazowej? | Niewytłumaczalny skok, spadek lub zmienność | Inżynieria danych lub Observability |
Kolejność ma większe znaczenie niż liczba narzędzi
Zacznij od terminowości, jeśli pierwszą skargą są nieaktualne raporty. Zacznij od walidacji, jeśli błędne rekordy powodują konieczność poprawek, ustalenia audytowe lub ręczne sprzątanie. Zacznij od śledzenia schematu, jeśli zmiany źródłowe często niszczą zadania w kolejnych krokach. Zacznij od wykrywania anomalii dopiero wtedy, gdy potok będzie na tyle stabilny, że nietypowe wzorce będą coś znaczyć, ponieważ wcześniej każdy alert to tylko kolejny niezweryfikowany objaw.
Trzymaj warstwy oddzielnie w implementacji, ale zjednoczone w raportowaniu. Operator potrzebuje jednego widoku incydentu, a nie czterech konkurujących ze sobą teorii na temat tego, co zawiodło. Dotyczy to zwłaszcza stosów on-prem i w bazie danych, gdzie ścieżki dostępu są węższe, a koszt przełączania się między narzędziami – wysoki.
Częstym błędem jest kupowanie nakładających się kontroli i liczenie na to, że pulpit nawigacyjny to uporządkuje. Niezawodne monitorowanie działa lepiej jako warstwowy system z jasnymi ścieżkami eskalacji i jedną historią operacyjną. Jeśli zespół nie potrafi określić, czy problemem jest opóźniona dostawa, zła zawartość, przesunięcie schematu czy zmienność zachowania, projekt monitorowania wciąż wymaga pracy.
Dla zespołów, które chcą czystego obszaru roboczego do prezentacji tego podziału, możecie skonfigurować swój obszar roboczy Writingmate.
Pulpity nawigacyjne i alerty, z których różne zainteresowane strony będą faktycznie korzystać
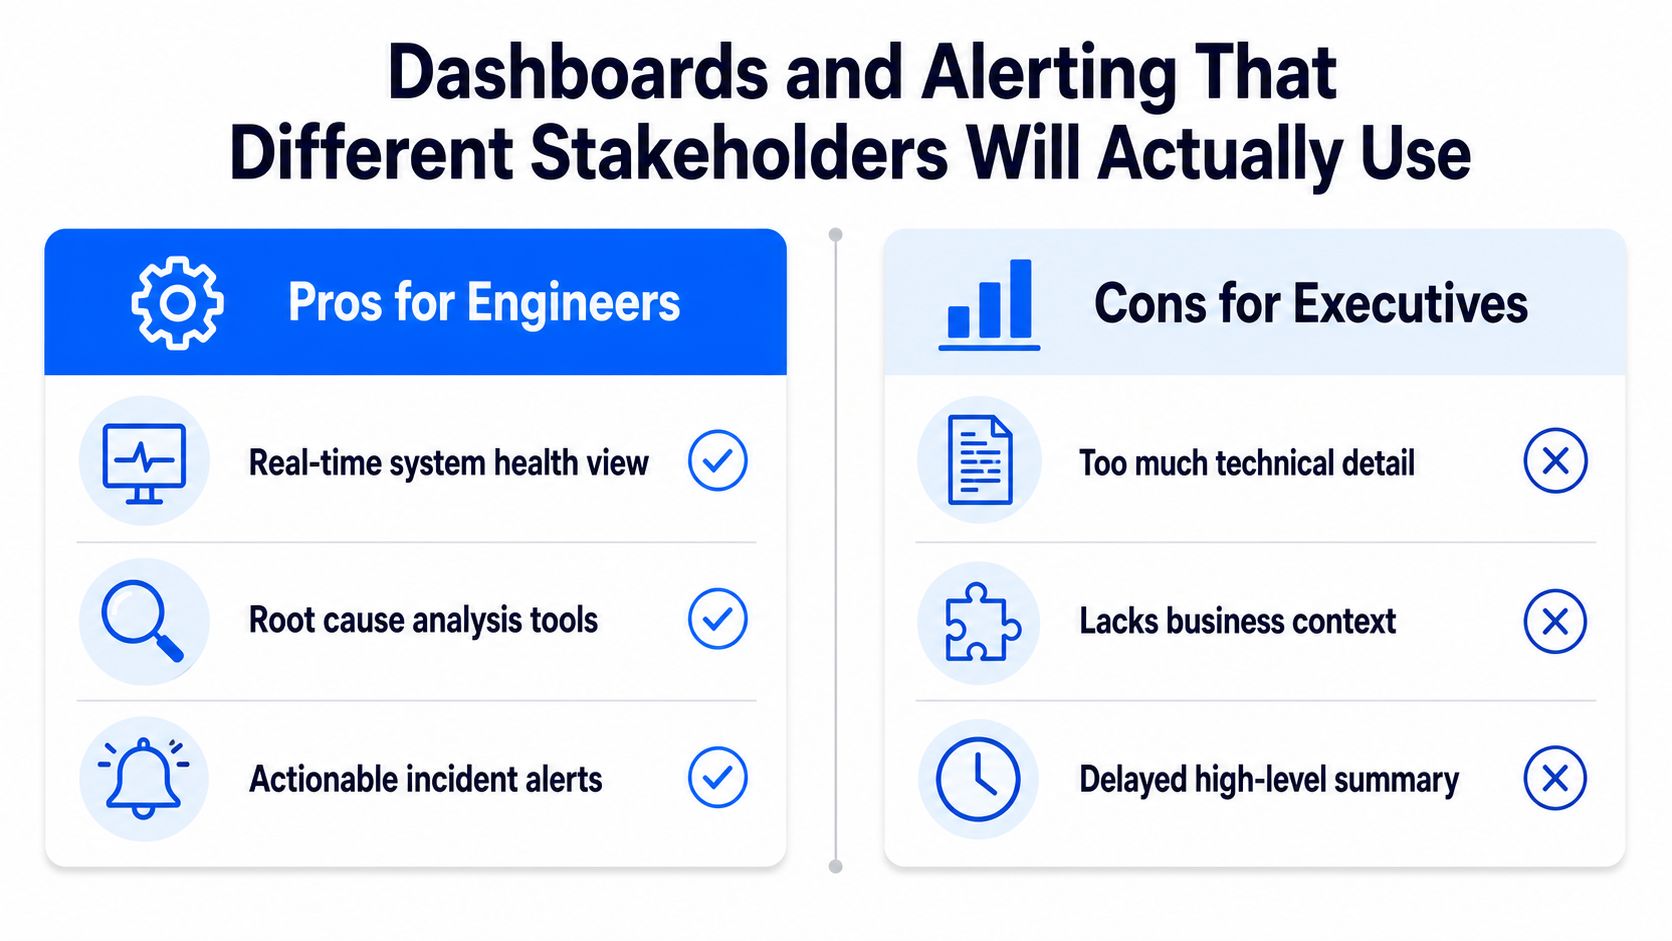
Pulpit nawigacyjny działa tylko wtedy, gdy odpowiednia osoba widzi właściwy sygnał z wystarczającym kontekstem do podjęcia działania. Inżynierowie potrzebują szczegółów, analitycy – historii trendów, a kadra kierownicza – czystego podsumowania. Jeśli jeden widok próbuje służyć wszystkim trzem grupom, zaufanie szybko spada.
Buduj dla ról, a nie dla próżnych metryk
Najlepsze pulpity nawigacyjne oddzielają stan bieżący od kontekstu historycznego. Wskazówki NASA dotyczące oceny technicznej są tutaj przydatne, ponieważ kładą nacisk na spójne formatowanie, zachowaną historię i oznaczone kolorami strefy alertów, które wspierają identyfikację trendów i analizę międzyprojektową (wytyczne oceny technicznej NASA za pośrednictwem odniesienia w stylu MRV). Ten schemat dobrze przekłada się na Observability. Stan bieżący pokazuje, co dzieje się teraz. Stan historyczny pokazuje, czy problem to chwilowe zakłócenie, powtórka czy początek poważnego incydentu.
Dla inżynierów pulpit powinien prezentować wystarczająco dużo kontekstu do szybkiej diagnozy, a następnie odsyłać do naruszonej reguły, uszkodzonej tabeli i ostatniej historii. Dla analityków przydatną warstwą jest kontekst trendu i zmienności, ponieważ muszą wiedzieć, czy ruch jest statystycznie nietypowy, czy to tylko sezonowy szum. Dla kadry zarządzającej podsumowanie powinno być czytelne bez operacyjnego żargonu.
Jeśli konfigurujesz czysty obszar roboczy dla tego podziału, możesz skonfigurować swój obszar roboczy Writingmate i zastosować ten sam nawyk w swoim stosie raportowania: jedna przestrzeń do działania, jedna do przeglądu. Przydatną ideą nie jest sam produkt, ale separacja odpowiedzialności.
Pulpit nawigacyjny potrzebuje również miejsca na głębszy widok jakości danych. Ta sama zasada operacyjna obowiązuje bez względu na to, czy sygnał pochodzi ze świeżości, walidacji, zmian schematu czy wolumenu, a dedykowany pulpit jakości danych daje zespołom jaśniejszą ścieżkę od statusu do doświadczenia badawczego niż przepełniony wykres ogólnego przeznaczenia.
Alertowanie działa tylko wtedy, gdy stopień ważności jest rzeczywisty
Przedziały stopnia ważności (severity) zmniejszają zmęczenie alertami. Nie każde odchylenie zasługuje na wezwanie i nie każdy problem powinien trafiać do tego samego kanału. Standaryzowane strefy alertów działają lepiej niż doraźne progi, ponieważ zespoły mogą kierować drobne odchylenia do kolejek przeglądu, a poważne awarie – do natychmiastowej eskalacji.
Wiarygodny system raportowania zachowuje również śledy dowodowe. Dyscypliny raportowania w sektorze publicznym wciąż mają tu znaczenie, ponieważ przydatny nawyk jest ten sam: raport musi być samowystarczalny, napisany obiektywnie, fakty muszą być oddzielone od analizy, należy też zachować powiązanie między linią bazową, odchyleniem, opóźnieniem i naprawę. Ta dyscyplina jest tak samo przydatna przy raportowaniu incydentów, jak i przy formalnym przeglądzie.
Jeśli widok raportowania nie potrafi odpowiedzieć na pytania: kto jest właścicielem problemu, jak poważny on jest i czy stan obecny różni się od ostatniego znanego dobrego okresu, to nie jest to narzędzie decyzyjne. To tylko tapeta.
Wybory wdrożeniowe, które kształtują architekturę monitorowania
Wdrożenie to nie tylko szczegół techniczny. Zmienia to, co możesz kontrolować, gdzie obliczane są metryki, co opuszcza Twoje środowisko i jak dobrze architektura pasuje do zasad governance. Jeśli Twój stos monitorowania wymaga przesyłania danych, którego nie możesz uzasadnić, model wdrożenia już działa na Twoją niekorzyść.
Wykonywanie w bazie danych zmienia równanie bezpieczeństwa
Dla regulowanych przedsiębiorstw największym pytaniem architektonicznym jest to, gdzie odbywa się obliczanie metryk. Wykonywanie w bazie danych (in-database) utrzymuje kontrole blisko danych zamiast wysyłać dane produkcyjne do chmury dostawcy, co stanowi ogromną zaletę, gdy znacząca jest prywatność, lokalizacja danych lub granice kontroli wewnętrznej. Zmniejsza to również ilość powielanej logiki, którą trzeba utrzymywać w różnych systemach.
Ma to znaczenie, ponieważ monitorowanie często dotyka wrażliwych rekordów, zanim ktokolwiek inny je zobaczy. Jeśli platforma może działać wewnątrz własnego środowiska klienta, kwestia governance staje się prostsza. Dostawca nie potrzebuje szerokiego dostępu do surowych danych produkcyjnych tylko po to, by obliczać świeżości, zmiany schematu czy wyniki walidacji.
Wdrożenia lokalne i chmura prywatna to wybory operacyjne, a nie przypisy
Wdrożenia lokalne (on-premises) i w chmurze prywatnej dają pełną kontrolę. Pozwalają zespołowi uruchomić warstwę monitorowania wewnątrz chmury klienta, VPC lub centrum danych, co często jest jedyną akceptowalną odpowiedzią, gdy polityki zabraniają przetwarzania zewnętrznego. Ceną za to jest fakt, że klient przejmuje większą część obszaru operacyjnego, w tym aktualizacje, pojemność środowiska uruchomieniowego i wewnętrzną kontrolę dostępu.
Licencjonowanie modułowe staje się tu niezwykle przydatne. Zacznij od jednego przypadku użycia, takiego jak walidacja na jednym krytycznym zbiorze danych, a następnie rozszerzaj działania, gdy pierwszy moduł udowodni swoją wartość. Przejrzysty cennik oparty na liczbie aktywnych tabel również ma znaczenie, ponieważ pozwala uniknąć problemów motywacyjnych, które pojawiają się w modelach opartych na wolumenie alertów lub wywołaniach API. Kiedy koszty rosną wraz z ilością szumu, zespoły zaczynają wyciszać te kontrole, których najbardziej potrzebują.
Jeśli cennik dostawcy karze Cię za to, że sprawdzasz dane zbyt często, Twój program monitorowania ostatecznie ograniczy swój własny zakres.
Ramy monitorowania EU ETS są dobrym przypomnieniem, że sam plan jest dokumentem kontroli operacyjnej, a nie opowiadaniem. Wymaga on jasnego przedstawienia instalacji i działań, aby uniknąć luk w danych lub podwójnego liczenia, oraz zdefiniowania obowiązków i kompetencji osób, które go realizują (Ramy monitorowania EU ETS). To ten sam standard, którego użyłbym w architekturze Observability dla przedsiębiorstw.
Model wdrożenia musi pasować do modelu kontroli. Jeśli tak się nie stanie, stos raportowania stanie się kolejnym miejscem, w którym polityka i praktyka zaczną się rozchodzić.
Operational Playbooks for Data Engineers and Stakeholders
Sygnał bez scenariusza działania (playbooka) to tylko zakłócenie. Zespoły, które dobrze prowadzą monitorowanie, nie zatrzymują się na wykrywaniu. Definiują, co dzieje się dalej, kto jest za to odpowiedzialny i jak poprawka trafia z powrotem do systemu. W tym momencie Observability zamienia się w działania operacyjne.
Daj każdemu alertowi kolejny krok
Zacznij od odpowiedzialności. Kiedy próg zostanie przekroczony, ktoś musi wiedzieć, czy ma to zbadać, eskalować, czy wyciszyć na podstawie dowodów. Ścieżka reakcji powinna być inna dla opóźnienia potoku, inna dla zmiany schematu, a jeszcze inna dla przesunięcia metryki biznesowej, ponieważ te problemy rzadko mają tę samą przyczynę źródłową lub tych samych odbiorców.
W finansach, opiece zdrowotnej, telekomunikacji i sektorze publicznym jeden model reakcji nigdy nie pasuje do wszystkiego. Zespoły ds. usług finansowych zwykle potrzebują ściślejszej kontroli wokół sygnałów dotyczących ryzyka, regulacji i transakcji. Zespoły medyczne potrzebują audytowalnych śledów dowodowych. Zespoły telekomunikacyjne potrzebują szybkiej selekcji dla dużych wolumenów danych klientów. Zespoły z sektora publicznego potrzebują identyfikowalności i weryfikowalnych decyzji.
Praktyczny playbook zazwyczaj składa się z czterech etapów:
Uruchomienie sygnału. Alert wyzwala zdefiniowane zdarzenie.
Badanie. Odpowiedzialny dyżurny wykonuje kroki diagnostyczne.
Naprawa. Zespół wdraża poprawkę lub obejście problemu.
Przegląd i ulepszenie. Analiza poincydentowa aktualizuje progi lub logikę.
Zamykaj pętlę poprzez przeglądy, a nie obwinianie
Dyscyplina raportowania w sektorze publicznym wciąż ma tutaj znaczenie. Linie bazowe, odchylenie, opóźnienie i naprawa dają zespołom sposób na oddzielenie złego źródła, zmieniającego się procesu i progu, który już nie pasuje. Jeśli próg uruchamia się zbyt często w tym miesiącu, problemem może być projekt metryki, a nie sam potok. Jeśli nigdy się nie aktywuje, próg może być zbyt luźny, a sygnał zbyt niejasny.
Kadencja przeglądów to moment, w którym raportowanie staje się żywym systemem, a model wdrożenia ma takie samo znaczenie jak logika metryki. Konfiguracje w bazie danych i on-prem zmieniają to, kto może zobaczyć dowody, gdzie działają kontrole i jak szybko operatorzy mogą zareagować. Playbook, który ignoruje to ograniczenie, kończy jako martwa polityka na papierze i rozjazd w rzeczywistej praktyce.
Raportowanie jako dowód decyzji, a nie późniejsza refleksja nad Compliance
Raport, który dodaje jedynie więcej wykresów, rzadko pomaga. Zwykle wnosi więcej szumu, więcej nieporozumień i więcej czasu spędzonego na kłótniach o to, która liczba powinna być uznana za prawdę. Raportowanie klasy decyzyjnej zaczyna się od prostszego pytania: kto potrzebuje tych informacji i co z nimi zrobi.
Różni odbiorcy potrzebują różnych dowodów
Operatorzy potrzebują sygnałów, które mogą szybko przesiać. Menedżerowie potrzebują kontekstu trendów i jasnego obrazu zmienności. Regulatorzy i kadra kierownicza potrzebują podsumowań, które mogą odtworzyć i obronić. Te grupy nie potrzebują tego samego raportu ani tego samego poziomu szczegółowości.
Trudniejszą częścią jest podjęcie decyzji, które metryki są kluczowe dla każdej grupy odbiorców. Jak wspomniano wcześniej, systemy monitorowania często zbierają dane, które wyglądają na kompletne, ale wciąż nie wspierają decyzji stojącej przed użytkownikiem. Dlatego wymiary równości i braku uprzedzeń należą do projektowania raportów, nawet gdy program zaczyna się jako czysto operacyjny. Jeśli marginalizowane grupy nie pojawiają się w raporcie, raport jest niekompletny.
Monitorowanie oparte na społeczności idzie jeszcze dalej. Standardowe raportowanie często pomija rzeczywiste doświadczenia ludzi, zwłaszcza tam, gdzie dostępność usług, przystępność, akceptowalność, równość i jakość mają bezpośrednie znaczenie dla użytkowników (Broszura informacyjna dot. monitorowania opartego na społeczności). Zautomatyzowane kontrole są konieczne, ale nie zastępują informacji zwrotnych od ludzi, na których usługa ma wpływ.
Spraw, aby raportowanie było domyślnie audytowalne
Raport jako artefakt powinien oddzielać fakty od analizy, był samowystarczalny i opierać się na potwierdzonych informacjach, a nie na plotkach. Ten standard sprawdza się zarówno w podsumowaniach incydentów, miesięcznych przeglądach biznesowych, jak i w raportach dla regulatora. Oznacza to również, że raport powinien odsyłać z powrotem do źródła, progu i podjętego działania.
Dyscyplina raportowania z sektora publicznego wciąż przynosi korzyści. Linia bazowa, odchylenie, opóźnienie i naprawa pomagają zespołom oddzielić złe źródło, zmieniający się proces i próg, który już nie pasuje. Jeśli próg uruchamia się zbyt często w tym miesiącu, problemem może być projekt metryki, a nie sam potok. Jeśli nigdy się nie aktywuje, próg może być zbyt luźny, a sygnał zbyt niejasny.
Kadencja przeglądów to moment, w którym raportowanie staje się żywym systemem, a model wdrożenia ma takie samo znaczenie jak logika metryki. Konfiguracje w bazie danych i on-prem zmieniają to, kto może zobaczyć dowody, gdzie działają kontrole i jak szybko operatorzy mogą podjąć działanie. Playbook, który ignoruje to ograniczenie, kończy jako martwa polityka na papierze i rozjazd w rzeczywistej praktyce.


