Analiza danych jakościowych: praktyczny przewodnik dla nowoczesnych zespołów
|
8
min. czyt.

Otwierasz poniedziałkowy pulpit nawigacyjny, a liczba w prawym górnym rogu nie zgadza się z tym, czego oczekiwał dział finansów. Nikt nie potrafi powiedzieć, czy problem zaczął się ubiegłej nocy, w zeszłym tygodniu, czy dwie zmiany w potoku przetwarzania wstecz. To jest moment, w którym analiza jakości danych przestaje być abstrakcyjną najlepszą praktyką, a staje się praktyczną umiejętnością przetrwania, ponieważ zadaniem nie jest tylko oczyszczenie danych po ich uszkodzeniu. Chodzi o to, aby wcześnie uwidocznić ciche problemy z danymi, mierzyć je z dyscypliną statystyczną i w pierwszej kolejności zapobiegać ich wpływowi na decyzje.
Spis treści
Kiedy pulpit nawigacyjny przestaje mówić prawdę
Uszkodzony pulpit nawigacyjny zazwyczaj nie wygląda na zepsuty. Nadal się ładuje, wykresy wciąż się renderują, a nazwy wskaźników KPI wciąż brzmią znajomo. Problem tkwi głębiej: leżące u podstaw rekordy mogą być nieaktualne, powielone, niepełne lub niespójne, przez co raport staje się dopracowaną wersją błędnej historii.
Właśnie dlatego analiza jakości danych ma znaczenie. Słaba jakość danych nie jest kwestią kosmetyczną, to ryzyko operacyjne, które może zniekształcić decyzje, zanim ktokolwiek zauważy, że wykres wygląda nieprawidłowo. Szacunki raportowane przez firmę Gartner cytowane w 2023 r. określają średni roczny koszt słabej jakości danych na 12,9 miliona dolarów na organizację, a badanie IBM z 2022 r. dotyczące kosztów słabej jakości danych wykazało, że niedokładność może powodować około 25% strat w przychodach dla dużych przedsiębiorstw z powodu błędnych decyzji. Te liczby zmieniły narrację z „proszę wyczyścić dane” na „to wymaga ciągłej obserwacji i kontroli” (statystyki jakości danych Gitnux).
Wiele zespołów wciąż traktuje jakość danych jak porządki na ostatnim etapie. Uruchamiają zadanie czyszczenia przed wysłaniem raportu, a potem mają nadzieję, że problem nie powróci. Ten model zawodzi, ponieważ awaria zazwyczaj zaczyna się na wcześniejszym etapie: przy pobieraniu, transformacjach, dryfcie schematu lub opóźnionych źródłach danych, na długo zanim ktokolwiek zobaczy wykres. Reguła na poziomie pola w formularzu, taka jak kontrole pokazane w poradniku walidacji formularzy Formcarry, wychwytuje tylko jedną warstwę problemu. Szersza dyscyplina obserwuje, jak te dane wejściowe zachowują się po wejściu do potoku, tak samo jak mechanik nasłuchuje nowego hałasu, gdy silnik już pracuje.
Praktyczna zasada: jeśli wskaźnik może ulec zmianie bez widocznego błędu, wymaga on ciągłego monitorowania, a nie jednorazowego audytu.
Nowoczesna dyscyplina łączy klasyczną statystykę opisową z automatycznym wykrywaniem anomalii i nauką punktu odniesienia, dzięki czemu zespoły mogą stale dostrzegać nietypowe zachowania w dużych zbiorach danych, zamiast polegać na okresowych, ręcznych przeglądach. Działa to również najlepiej, gdy kontrole pozostają blisko danych, na przykład profilowanie wewnątrz bazy danych, które pozwala uniknąć wyciągania ogromnych tabel do osobnego narzędzia. To jest właśnie obietnica w tym obszarze: przekształcenie niewidocznej awarii w mierzalny dryft, następnie w działanie i uważne śledzenie wrażliwych na sprawiedliwość przepływów danych za pomocą praktycznych ram, takich jak te opisane w tym przewodniku po wymiarach jakości danych.
Definiowanie analizy jakości danych bez żargonu
Dobrą analogią jest bezpieczeństwo żywności. Kuchnia nie zdobywa zaufania dlatego, że raz przeszła kontrolę. Zdobywa zaufanie, ponieważ temperatura, zaopatrzenie, higiena i świeżość są sprawdzane wielokrotnie, dzięki czemu posiłek pozostaje bezpieczny nawet wtedy, gdy zmienia się personel lub rośnie liczba zamówień.
Analiza jakości danych działa w ten sam sposób. To nie jest pojedynczy audyt ani lista kontrolna czyszczenia. To ciągły proces mierzenia, czy dane nadal zasługują na zaufanie, gdy przechodzą przez systemy, zmieniają kształt i zasilają decyzje.
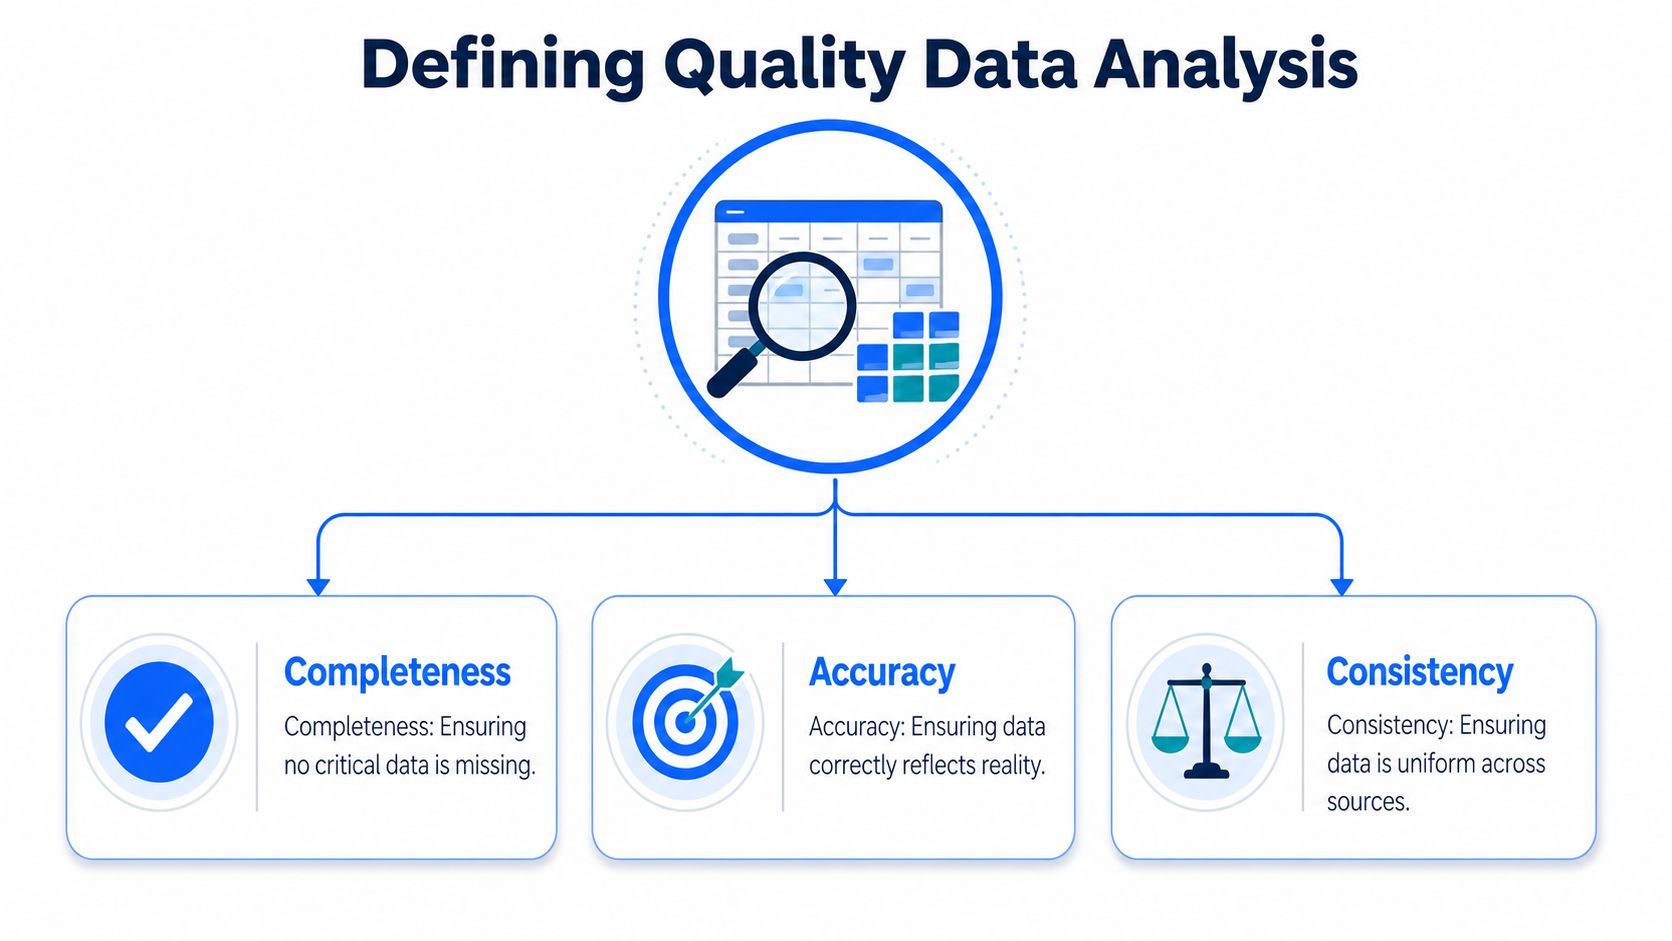
Formalna strona tego zagadnienia jest szersza, niż wielu się spodziewa. Ramy jakości statystycznej MFW identyfikują sześć wymiarów: użyteczność, dokładność, terminowość, dostępność, łatwość interpretacji i spójność (ramy jakości statystycznej MFW). Operacyjna definicja IBM rozszerza ten obraz o dokładność, kompletność, poprawność, spójność, unikalność, terminowość i przydatność do określonego celu (jakość danych IBM). Kluczowa idea jest prosta: zestaw danych może być technicznie obecny, a mimo to nie nadawać się do pytania, które zadajesz.
Czym ona nie jest
To nie jest tylko oczyszczanie danych, ponieważ czyszczenie usuwa znane wady, ale nie informuje o zmianie wskaźnika defektów. To nie jest pulpit nawigacyjny, ponieważ pulpity nawigacyjne podsumowują stan, ale nie wyjaśniają, czy dane wejściowe są wiarygodne. To nie jest pojedynczy „wynik jakości”, ponieważ jeden wynik może ukrywać wiele różnych trybów awarii.
Pomyśl o tabeli, która nie zawiera wartości pustych (null), ale jej znaczniki czasu są spóźnione o trzy dni. Albo o zbiorze danych, który jest świeży, ale jedna jednostka biznesowa używa innego kodu kategorii niż reszta firmy. W obu przypadkach liczby mogą wyglądać schludnie, ale analiza nadal jest niewiarygodna.
Przepływ pracy analizy danych na Coursera umieszcza czyszczenie, przegląd wartości odstających i interpretację wewnątrz szerszego procesu analizy, a nie jako refleksję po fakcie (przewodnik analizy danych Coursera). Ta sekwencja ma znaczenie, ponieważ kontrole jakości należą do miejsc, w których dane są zbierane, przekształcane i interpretowane, a nie tylko tam, gdzie są wyświetlane.
Kluczowe wymiary, które sprawiają, że dane są godne zaufania
Wymiary są łatwiejsze do zapamiętania, jeśli powiąże się je z konkretnymi trybami awarii. Każdy z nich odpowiada na inne pytanie i każdy może zawieść, podczas gdy inne wyglądają dobrze. Dlatego pojedynczy procent kompletności nie przedstawia pełnego obrazu.
Praktyczne porównanie
Wymiar | Co oznacza | Przykładowa awaria | Wskaźnik do monitorowania |
|---|---|---|---|
Dokładność | Wartości odpowiadają rzeczywistości | Status klienta jest oznaczony jako aktywny po rezygnacji | Wskaźnik błędów w stosunku do zaufanego źródła referencyjnego |
Kompletność | Oczekiwane dane są obecne | Wymagane pola adresowe są puste | Wskaźnik wartości pustych (null) lub brakujących pól |
Spójność | Ten sam fakt zgadza się w różnych tabelach | Przychody różnią się między modelami finansowymi a BI | Wskaźnik niezgodności między tabelami |
Unikalność | Rekordy nie są powielone | To samo zamówienie pojawia się dwukrotnie po ponownym przetworzeniu | Wskaźnik duplikatów |
Poprawność | Wartości są zgodne z regułami i formatami | Pole daty zawiera tekst | Wskaźnik naruszeń reguł |
Terminowość | Dane docierają wtedy, gdy są potrzebne | Codzienne zasilanie danymi ląduje po zamknięciu raportu | Opóźnienie wczytywania lub godziny od ostatniego odświeżenia |
Przydatność do określonego celu | Dane odpowiadają na pytanie biznesowe | Zbiór danych pomija region, którego potrzebuje zespół | Pokrycie w stosunku do zakresu decyzji |
Dokładność jest najłatwiejsza do wyjaśnienia, ale często najtrudniejsza do zweryfikowania. Liczba może być sformatowana poprawnie, a mimo to być błędna w sensie biznesowym. Dlatego zespoły ds. jakości porównują dane z systemami źródłowymi, tabelami referencyjnymi lub logiką uzgadniania, zamiast zakładać, że poprawność składniowa oznacza prawdę.
Kompletność to wymiar, który natychmiast rzuca się w oczy, ale sam w sobie może być mylący. Tabela bez wartości pustych nadal może wykluczać cały segment klientów, jeśli logika ładowania pominęła kolumnę lub odfiltrowała region. Terminowość kryje w sobie tę samą pułapkę, ponieważ świeże dane wciąż mogą być bezużyteczne, jeśli dotarły z błędną zawartością.
Spójność i unikalność zazwyczaj ujawniają się, gdy systemy są łączone. Jeśli hurtownia finansowa i raportowa baza danych się różnią, ktoś musi zdecydować, które źródło jest autorytatywne. Jeśli wkradną się duplikaty, wykres może nadal wyglądać gładko, podczas gdy sumy dryfują w górę bez żadnego oczywistego błędu.
Poprawność to obszar, w którym liczą się reguły biznesowe. Przewodnik po walidacji pól Formcarry to użyteczny zewnętrzny przykład tego, jak systemy mogą wymuszać wymagane formaty i dane wejściowe, zanim błędne rekordy rozprzestrzenią się dalej. W analityce ta sama logika dotyczy kodów pocztowych, wartości statusu, zakresów i ograniczeń dat.
Przydatny nawyk: monitoruj wymiar, który ma największe znaczenie dla decyzji, a pozostałe miej na uwadze, aby nie optymalizować jednego rodzaju zaufania, niszcząc inny.
Przydatność do określonego celu to ostateczna kontrola i to ta, którą wiele zespołów pomija. Zbiór danych może być dokładny, kompletny i spójny, a mimo to zawieść, jeśli nie zawiera wycinka biznesowego, od którego zależy pytanie. W tym miejscu wewnętrzne ramy zawarte w przeglądzie wymiarów jakości danych digna dobrze wpisują się w myślenie o governance.
Metody i przepływy pracy do przeprowadzania analizy
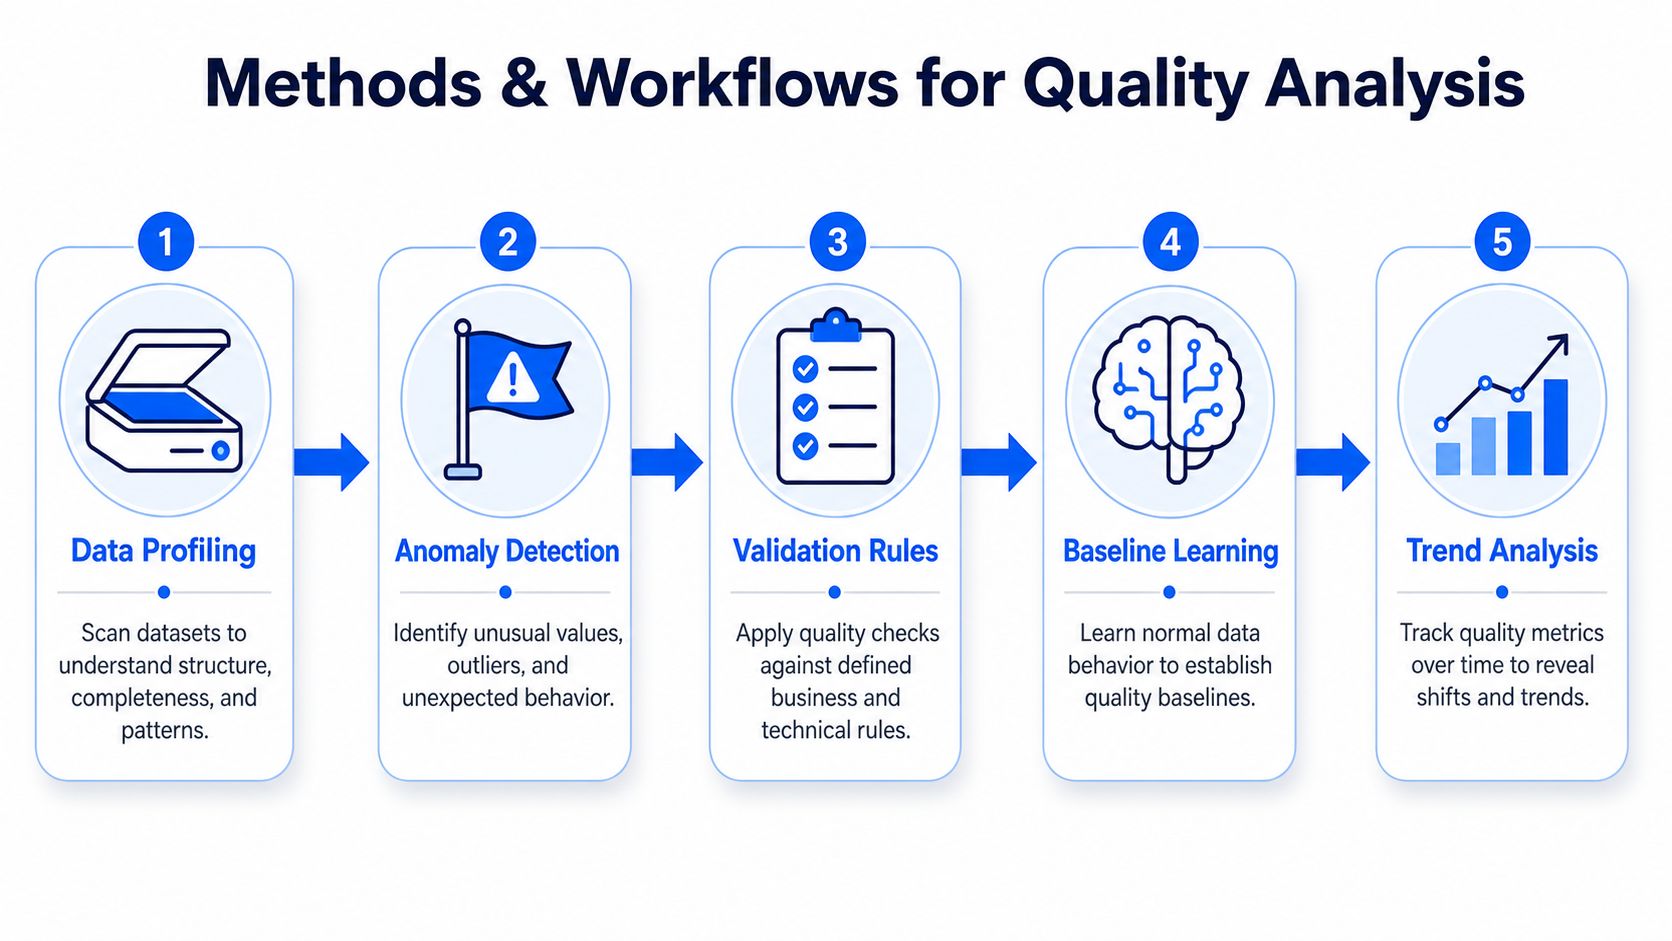
Przegląd jakości zazwyczaj zaczyna się w momencie, gdy dane lądują, a nie po awarii pulpitu nawigacyjnego. Jedna metoda wychwytuje braki, inna dryf, a trzecia wartości, które przechodzą regułę, ale nadal wyglądają źle w kontekście. Praca ta przypomina raczej triage medyczny niż jednorazowe sprzątanie, ponieważ każda kontrola odpowiada na inne pytanie dotyczące tego samego zbioru danych.
Zacznij od profilowania
Profilowanie odpowiada na proste pytanie: jak wygląda tutaj norma? Zespoły używają średniej, mediany, dominanty, odchylenia standardowego, wariancji i zakresu do podsumowania rozkładów, dostrzeżenia skośności i zrozumienia rozrzutu, co daje im punkt odniesienia, zanim zdecydują, co zasługuje na uwagę. Dobrym punktem wyjścia są techniki profilowania danych, ponieważ chodzi o poznanie kształtu danych przed wpisaniem założeń do kontroli.
Nowy członek zespołu często spodziewa się, że profilowanie będzie jednorazowym raportem. Działa to raczej jak sprawdzanie panelu instrumentów przed każdą zmianą. Jeśli wartości zamówień były stabilne przez tygodnie, a potem kolumna nagle zapełnia się zerami, ta zmiana zasługuje na przegląd, nawet jeśli żadna jawna reguła nie zawiodła.
Dodaj wykrywanie anomalii i reguły
Wykrywanie anomalii działa najlepiej, gdy porównuje bieżące rekordy z historią samego zbioru danych. Reguły Z-score i rozstępu międzykwartylowego pomagają oznaczać wartości, które leżą daleko poza normalnym przedziałem, co jest przydatne w przypadku wartości odstających, nietypowych skoków i rekordów wymagających ręcznego przeglądu.
Walidacja deterministyczna odgrywa inną rolę. Sprawdza logikę na poziomie wiersza, taką jak wymagane pola, dozwolone wartości i zależności między polami. Jeśli reguła zostanie naruszona, rekord odrzuca się, a decyzja jest natychmiastowa.
Wskazówki dotyczące analizy jakości zalecają również łączenie analizy trendów z walidacją, aby zespoły mogły wcześnie wykrywać brakujące pola, wartości spoza zakresu i opóźnienia w dostarczaniu w potoku (analityka jakości Skymes). To połączenie ma znaczenie, ponieważ powoli powtarzający się defekt może przechodzić twarde reguły, jednocześnie zmieniając kształt danych. Tabela raportowa może pozostać technicznie poprawna, stale dryfując od wartości, które ludzie myślą, że odczytują.
Poznaj punkt odniesienia, a następnie obserwuj trend
Uczenie się punktu odniesienia zastępuje statyczne progi modelami behawioralnymi, które dostosowują się do każdego zbioru danych. Zamiast pytać, czy liczba plasuje się powyżej arbitralnej linii, system pyta, czy dzisiejsze zachowanie odbiega od normalnego wzorca tej tabeli. To dobrze pasuje do danych operacyjnych, ponieważ jedno źródło może naturalnie się wahać, podczas gdy inne pozostaje wąskie i przewidywalne.
Analiza trendów wychwytuje to, co omija pojedynczy alert. Pole może nigdy nie przekroczyć twardego limitu, jednak jeśli brak danych rośnie przez tydzień, wynikowy pulpit nawigacyjny i tak zacznie dryfować. Historyczna analiza trendów jest również kluczową częścią modułu Data Analytics platformy digna, który oblicza statystyki wyższego poziomu, takie jak trend i zmienność, na podstawie kluczowych metryk danych, dzięki czemu zespoły mogą stale monitorować dane we własnym środowisku bez przenoszenia ich w inne miejsce.
Wzorce wdrażania, które się skalują
Pierwsze pytanie dotyczące wdrożenia dotyczy zazwyczaj lokalizacji. Gdzie powinny działać kontrole i jak wiele danych trzeba przenieść, aby je uruchomić? Ten wybór wpływa na opóźnienia, governance, koszty i to, jak szybko zespół może zareagować, gdy coś się zmieni. Kształtuje również to, czy analiza jakości danych pozostanie żywą kontrolą wewnątrz potoku, czy też zamieni się w osobne zadanie, które ludzie kontrolują zbyt późno.
Cztery wzorce stosowane przez zespoły
Analiza wewnątrz bazy danych uruchamia kontrole tam, gdzie dane już żyją. Pozwala to ograniczyć przesyłanie danych do minimum i spełnia wymogi bezpieczeństwa, ponieważ dane pozostają na miejscu, podczas gdy obliczane są metryki. Działa to również dobrze w przypadku profilowania statystycznego, w którym chce się mierzyć rozkłady, braki i dryf na rzeczywistej tabeli, a nie na skopiowanej próbce.
Zewnętrzne usługi skanujące kopiują lub przesyłają strumieniowo próbki do osobnego środowiska. Może to być przydatne do szybkiej kontroli, ale wiąże się z przesyłaniem danych, duplikacją i kolejnym miejscem, do którego mogą trafiać wrażliwe dane. Skopiowana próbka może pomóc zespołowi dostrzec oczywiste problemy, jednak może również ukryć subtelne przesunięcia, które ujawniają się tylko u źródła.
Kontrole natywne dla potoku żyją wewnątrz kodu ETL lub kodu transformacji. Łatwo je dołączyć do konkretnego zadania, dzięki czemu ścieżka błędu jest jasna, ale mogą stać się niestabilne, jeśli każdy zespół pisze własne reguły bez wspólnych punktów odniesienia. W praktyce ten wzorzec działa najlepiej, gdy kontrole są małe, jawne i powiązane z dokładną transformacją, którą chronią.
Platformy Observability łączą walidację, wykrywanie anomalii, śledzenie schematów i alerty w jednej warstwie. Są one najlepiej dopasowane do ciągłego monitorowania, ponieważ łączą reguły, punkty odniesienia i obsługę incydentów. Dla zespołów budujących tę ścieżkę podejście do wdrażania opisane w przewodniku wdrażania jakości danych digna pokazuje, jak te elementy mogą pozostać w środowisku klienta zamiast rozprzestrzeniać się na oddzielne narzędzia.
Jak dokonać wyboru
Jeśli priorytetem są niskie opóźnienia i ścisłe governance, wykonanie w bazie danych zazwyczaj wygrywa. Jeśli zespół potrzebuje lekkiej kontroli dla niewielkiego wycinka danych, wystarczające może być skanowanie zewnętrzne. Jeśli chcesz wymusić reguły blisko logiki transformacji, sensowne są kontrole natywne dla potoku. Jeśli potrzebujesz jednego miejsca do podglądu incydentów, trendów i statusu w wielu zbiorach danych, platforma Observability jest łatwiejsza w obsłudze.
Porada operacyjna: wybierz najpierw wzorzec, który odpowiada Twojemu największemu ograniczeniu, a nie ten, który wygląda najłatwiej na prezentacji demo.
Alertowanie również ma znaczenie. Narzędzia do monitorowania zmian schematu powinny oznaczać dodane lub usunięte kolumny, alerty o dryfcie punktu odniesienia powinny ujawniać nietypowe ruchy, a ścieżki eskalacji powinny definiować, kto co naprawia. Dowody gotowe do audytu stają się znacznie łatwiejsze do wygenerowania, gdy system rejestruje czas do wykrycia, czas do rozwiązania oraz dokładną regułę lub anomalię, która wywołała incydent. Ten zapis pomaga również zespołom ocenić, czy problem był losowym zakłóceniem, powtarzającym się błędem potoku, czy szerszą zmianą, która wymaga innego progu.
digna to jeden z przykładów platformy zbudowanej wokół tych idei, oferujący wykonywanie wewnątrz bazy danych, oparte na AI uczenie się punktu odniesienia, śledzenie schematów oraz monitorowanie terminowości wewnątrz własnego środowiska klienta. Taka konfiguracja odpowiada zespołom, które chcą ciągłych kontroli bez wyciągania danych produkcyjnych do osobnej warstwy skanującej.
Jak różne branże stosują analizę jakości danych
Te same mechanizmy działają inaczej w zależności od stawki. Zespół ds. finansów dba o uszkodzone źródła danych regulacyjnych i integralność transakcji. Zespół ds. opieki zdrowotnej martwi się o strukturę roszczeń, dokumentację medyczną i terminowość. Zespół ds. telekomunikacji musi chronić operacyjne strumienie danych o dużym natężeniu, nie tonąc w szumie informacyjnym. Zespół z sektora publicznego potrzebuje identyfikowalności i dowodów, które przetrwają audyt.
Co zmienia się w zależności od branży
Usługi finansowe zazwyczaj w pierwszej kolejności monitorują dane dotyczące ryzyka, dane transakcyjne i dane regulacyjne. Praktycznym priorytetem jest wychwytywanie spóźnionych strumieni danych, niezgodnych sum i zmian schematów, zanim raportowanie lub dalsze kontrole zaczną na nich polegać. Czas do wykrycia i czas do rozwiązania stają się kluczowymi wskaźnikami KPI, ponieważ opóźnienie może wpływać na wiele procesów jednocześnie.
Opieka zdrowotna mocno opiera się na kompletności, świeżości i stabilności strukturalnej w klinicznych i operacyjnych przepływach pracy. Zmiana schematu w danych o roszczeniach lub brakujące ładowanie w danych pacjentów może zniekształcić zarówno analitykę opieki, jak i raportowanie zgodności z przepisami, dlatego zespoły mają tendencję do uważnego obserwowania wskaźników naruszeń reguł i terminów dostaw.
Telekomunikacja mierzy się z dużymi strumieniami operacyjnymi, w których problemem często nie jest jeden błędny wiersz, ale subtelne przesunięcie w wolumenie lub formacie. Przekroczenia progów w rekordach szczegółów połączeń (CDR) i nieoczekiwane zmiany pól to rodzaje problemów, które prześlizgują się, jeśli monitorowanie jest zbyt statyczne.
Sektor publiczny potrzebuje spójności, identyfikowalności i gotowych do audytu dowodów bardziej niż czegokolwiek innego. Raport może być technicznie poprawny, ale jeśli nie można wykazać pochodzenia danych lub historii walidacji, praca ta wciąż nie spełnia oczekiwań dotyczących zaufania publicznego.
Federalny Komitet ds. Metodologii Statystycznej definiuje jakość danych jako „stopień, w jakim dane rejestrują pożądane informacje przy użyciu odpowiedniej metodologii w sposób, który podtrzymuje zaufanie publiczne” (ramy FCSM). Sformułowanie to pasuje do każdego z tych sektorów, ponieważ celem nie jest tylko dokładność, ale niezawodne użytkowanie w kontekście.
We wszystkich tych branżach wciąż pojawia się ten sam zestaw kontrolny: kontrole świeżości, walidacja na poziomie rekordów, śledzenie schematów i wykrywanie anomalii. Zmienia się pytanie biznesowe, ale dyscyplina pozostaje ta sama.
Pułapki i aspekty pomijane w większości poradników
Pojedynczy globalny wynik jakości brzmi schludnie, ale ukrywa zbyt wiele. Jedna grupa może mieć czyste, świeże dane, podczas gdy inna grupa ma braki w rekordach, jest niedoreprezentowana lub dotknięta cichą zmianą schematu. Średnia wygląda dobrze, a decyzja i tak staje się niesprawiedliwa.
Dlaczego kontrole podgrup mają znaczenie
Wskazówki dotyczące zdrowia publicznego i polityki kładą nacisk na kontrole brakujących danych podgrupa po podgrupie, oddzielną imputację, gdy braki różnią się w zależności od grup, oraz jasną dokumentację tego, kto nie może być dokładnie reprezentowany przy użyciu dostępnych danych (wskazówki ASPE dotyczące analizy sprawiedliwości społecznej). To dobitne przypomnienie, że kompletność całego zbioru danych może maskować wykluczenie. Jeśli jeden region ma mało danych lub historycznie wykluczona grupa jest systematycznie mniejsza w danych, model nadal może być stronniczy, nawet jeśli tabela jest „w większości kompletna”.
Dlaczego systemy AI są tutaj delikatne
Innym pomijanym aspektem jest sztuczna inteligencja i monitorowanie w czasie zbliżonym do rzeczywistego. Tradycyjna praca nad jakością często kończy się na okresowym profilowaniu, ale najnowsze wskazówki statystyczne podkreślają ciągły przegląd wolumenu rekordów, braków w krytycznych polach, wykonalności wartości i trendów wykraczających poza zakres, aby wcześnie wychwycić problemy w potoku (raport techniczny NISS). Ma to znaczenie, ponieważ dryf schematu, brakujące ładowania i przesunięcia rozkładu mogą popsuć kolejne modele bez wywoływania głośnej awarii.
Model nie potrzebuje spektakularnej awarii, aby pójść w złym kierunku. Jeśli jedno pole źródłowe zmieni typ, jeśli zasilanie danymi dotrze późno lub jeśli rozkład przesunie się subtelnie w czasie, wejście modelu może ulec degradacji na długo przed tym, jak ktokolwiek zauważy wynik. Dlatego ciągłe Observability wygrywa z okresowymi audytami w ustawieniach operacyjnych.
Ciągłe kontrole nie tylko chronią pulpity nawigacyjne, ale chronią założenia, od których pulpit nawigacyjny zależy.
Podejście platformowe pomaga w tym przypadku, gdy łączy naukę punktu odniesienia, walidację na poziomie rekordów, monitorowanie terminowości i ciągłe śledzenie schematów wewnątrz własnego środowiska klienta. To utrzymuje analizę blisko danych, czyli tam, gdzie te problemy są najłatwiejsze do wychwycenia.
Łączenie wszystkiego w całość przy kolejnym zestawie danych
Najszybszym sposobem na ocenę zbioru danych jest zadanie trzech pytań. Po pierwsze, co oznacza słowo dobry dla tego pytania biznesowego? Po drugie, które metody ujawnią awarie, które mają największe znaczenie? Po trzecie, gdzie powinny działać te kontrole, aby nie powodować tarć ani ryzyka?
Jeśli odpowiedź na pierwsze pytanie jest niejasna, zacznij od wymiarów, a nie od narzędzia. Dokładność, kompletność, spójność, unikalność, poprawność, terminowość i przydatność do określonego celu dają wspólne słownictwo do decydowania o tym, co jest dopuszczalne. Jeśli odpowiedź na drugie pytanie obejmuje dryf, a nie tylko defekty, wprowadź profilowanie, naukę punktu odniesienia i analizę trendów. Jeśli odpowiedź na trzecie pytanie wiąże się z wrażliwymi danymi lub dużym wolumenem, wykonanie wewnątrz bazy danych zazwyczaj zasługuje na poważne rozważenie.
Pomaga tu prosty model mentalny. Traktuj analizę jakości danych jako pętlę: zdefiniuj kryteria zaufania, zmierz zachowanie, alarmuj o odchyleniach i utrzymuj kontrole tam, polegając na tym, gdzie dane żyją. Ta pętla jest najsilniejsza, gdy jest ciągła, statystyczna i dostosowana do biznesowego przypadku użycia, a nie do ogólnej listy kontrolnej higieny.
Dwie luki, które większość zespołów wciąż pozostawia otwarte, to sprawiedliwość społeczna i gotowość na AI. Jeśli pominiesz kontrole podgrup, możesz przeoczyć to, kogo dane pomijają. Jeśli pominiesz ciągłe Observability, możesz przegapić powolne zmiany, które psują analitykę i dane wejściowe modeli.
Jeśli chcesz wdrożyć tę dyscyplinę w praktyce, digna zapewnia monitorowanie wewnątrz bazy danych pod kątem anomalii, terminowości, walidacji i zmian schematu wewnątrz własnego środowiska klienta. Odwiedź witrynę, aby zobaczyć, jak ciągła analiza jakości danych może pozostać blisko hurtowni, potoku przetwarzania i decyzji, które od nich zależą.
Najczęściej zadawane pytania
Co analiza danych oparta na jakości dodaje do zwykłej analizy?
Sprawdzenie, czy dane wejściowe zasługują na wyciągnięty wniosek. Zepsuty pulpit zwykle nie wygląda na zepsuty, więc analiza bez warstwy jakości daje wnioski, których pewność bierze się z prezentacji, a nie z dowodów.
Kiedy wskaźnik potrzebuje ciągłego monitoringu?
Gdy może się zmienić bez widocznego błędu. Ten jeden test oddziela zbiory wymagające stałych kontroli od tych, dla których okresowy audyt wciąż wystarcza.
Ile kosztuje słaba jakość na poziomie decyzji?
Szacunki Gartnera cytowane w 2023 r. wskazują średni roczny koszt 12,9 mln USD na organizację, a praca IBM Cost of Poor Data Quality z 2022 r. wykazała, że niedokładność potrafi napędzać około 25 % utraty przychodów w dużych przedsiębiorstwach poprzez błędne decyzje.
Co łączy nowoczesna dyscyplina?
Klasyczną statystykę opisową z automatycznym wykrywaniem anomalii i uczeniem linii bazowej. To połączenie pozwala zespołowi obserwować nietypowe zachowania w dużych zbiorach w sposób ciągły, zamiast polegać na okresowym przeglądzie ręcznym.
Dlaczego traktowanie jakości jako porządków ostatniej mili jest błędem?
Bo szkoda powstaje przed tą ostatnią milą. Gdy liczba dociera do raportu, usterkę odziedziczyło już każde obliczenie leżące między źródłem a ekranem.



