Jak walidować dane? Przewodnik dla nowoczesnych pipeline’ów
|
8
min. czyt.

Najprawdopodobniej zadajesz to pytanie, ponieważ coś już się zepsuło. Liczba na dashboardzie skoczyła z dnia na dzień, model zaczął generować dziwne wyniki albo uzgodnienie danych się nie powiodło i nikt nie ufa pipeline’owi, dopóki ktoś nie przekopie się przez logi. To właśnie główny kontekst pytania jak walidować dane. Nie jest ono akademickie. Jest operacyjne.
Dobra walidacja nie polega na dodaniu kilku kontroli wartości null i uznaniu sprawy za zamkniętą. Polega na ustaleniu, co musi być prawdą na poziomie rekordu, co musi pozostać stabilne w całym pipelinie, co może bezpiecznie dryfować, a co powinno natychmiast zatrzymać przetwarzanie. We współczesnych stosach technologicznych oznacza to również ochronę przed problemami, które podstawowe poradniki pomijają, zwłaszcza przed cichym dryfem schematu i kosztem nadmiernego egzekwowania reguł, które nie mają znaczenia dla biznesu.
Spis treści
Dlaczego walidacja danych to coś więcej niż odhaczanie pozycji
Dashboard przychodów rzadko zawodzi dlatego, że jeden inżynier zapomniał o kontroli. Zawodzi, ponieważ zespoły traktują walidację jako jednorazowy krok porządkowy, a nie jako część projektu pipeline’u. Zanim ktoś zauważy, że liczby są błędne, złe dane przeszły już przez transformacje, złączenia, modele BI i dalsze raporty.
Dlatego walidacja danych powinna odbywać się w wielu punktach kontrolnych, a nie tylko na końcowym wyniku. Najskuteczniejszym wzorcem jest przede wszystkim zapobieganie. Reguły walidacyjne powinny wychwytywać problemy w miejscu, w którym dane wchodzą do systemu, a następnie ponownie po krokach transformacji, w których logika może wprowadzić nowe błędy. Omówienie walidacji pipeline’ów od Great Expectations jasno to podkreśla, akcentując walidację przy pozyskiwaniu i po każdej transformacji, wraz z powtarzalną dokumentacją na potrzeby audytu.
Prawdziwym rezultatem jest zaufanie
Organizacje deklarują, że chcą czystych danych. W rzeczywistości chcą wiarygodnych decyzji. Jeśli dział finansów musi kwestionować każdy raport, analitycy muszą ręcznie sprawdzać każde odświeżenie, a inżynierowie ML nie ufają danym treningowym, platforma technicznie działa, ale operacyjnie zawodzi.
Walidacja chroni zaufanie na kilka konkretnych sposobów:
Blokuje znane błędne dane wejściowe: Wymagane pola, prawidłowe formaty i reguły biznesowe wcześnie zatrzymują oczywiste defekty.
Zawęża zakres incydentu: Gdy kontrole działają w każdym newralgicznym punkcie, zespoły wiedzą, gdzie problem się pojawił.
Sprawia, że błędy można przełożyć na działania: Niespełniona reguła jest bardziej użyteczna niż ogólnikowa skarga, że „dashboard wygląda źle”.
Wspiera zgodność z przepisami: Powtarzalna walidacja i publikowane metadane zapewniają zespołom proces, który można audytować.
Praktyczna zasada: Nie waliduj danych wyłącznie na podstawie tego, co już widziałeś. Waliduj je względem tego, co według biznesu musi być prawdą.
Reaktywne czyszczenie to za późno
Wiele zespołów nadal polega na czyszczeniu danych na dalszych etapach. Brzmi to praktycznie, dopóki błędne pole nie zostanie już zagregowane w raportach lub przekazane do systemów, z których korzystają klienci. Czyszczenie po fakcie jest wolniejsze, droższe i trudniejsze do audytu.
Lepszy model operacyjny wygląda tak:
Zdefiniuj oczekiwania biznesowe, zanim napiszesz kod.
Egzekwuj je przy pozyskiwaniu danych.
Sprawdzaj je ponownie po każdej istotnej transformacji.
Rejestruj wyniki, aby błędy były identyfikowalne i powtarzalne.
Walidacja to nie biurokracja. To mechanizm kontroli inżynierskiej, który nie pozwala, by błędne rekordy, nieaktualne dane i uszkodzone schematy zamieniały się w decyzje biznesowe.
Podstawowe wymiary walidacji danych
Pipeline może przejść wszystkie podstawowe kontrole i mimo to podważyć zaufanie. Typową awarią nie jest wartość null w wymaganym polu. Są nią dane, które wyglądają akceptowalnie, przechodzą przez cały stos i niezauważenie przestają odpowiadać rzeczywistości biznesowej po zmianie w źródle, opóźnionym ładowaniu lub nowej ścieżce kodu po stronie źródła.
Dlatego walidacja wymaga więcej struktury niż prosta bramka typu zaliczone/niezaliczone. Zespoły potrzebują sposobu na ustalenie, co musi być egzekwowane, co powinno być monitorowane, a co można przez krótki czas tolerować, ponieważ koszt blokowania jest wyższy niż koszt przeglądu. Dobrym punktem wyjścia jest sześć wymiarów jakości. Dają one zespołom wspólne słownictwo do określania, gdzie leży ryzyko i jak rygorystyczna powinna być każda kontrola.
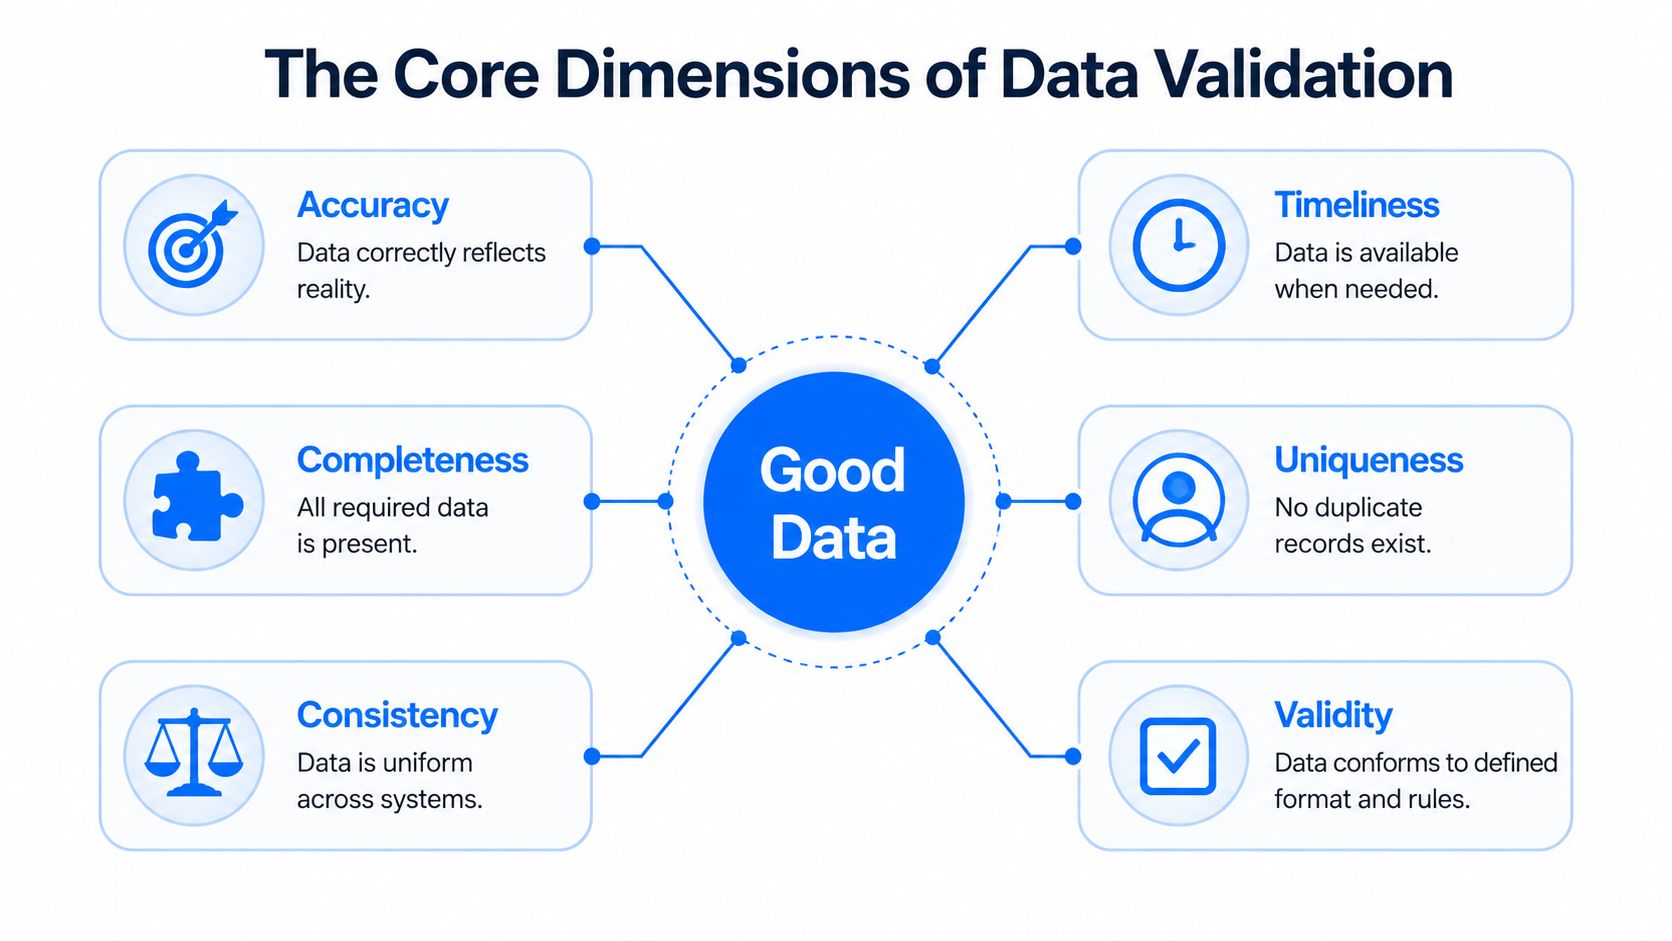
Dobre dane mają sześć wymiarów
Te wymiary brzmią znajomo, bo takie są. Błędem jest traktowanie ich jak listy kontrolnej zamiast odrębnych klas awarii o różnych kosztach biznesowych.
Wymiar | Co oznacza w praktyce | Typowy skutek w razie niespełnienia |
|---|---|---|
Dokładność | Wartość odzwierciedla rzeczywiste zdarzenie lub podmiot | Błędne ceny, błędne salda, błędny status klienta |
Kompletność | Wymagane dane są obecne tam, gdzie zależy od nich proces | Niedziałające złączenia, bezużyteczne raporty, brakujące cechy modelu |
Spójność | To samo pojęcie jest reprezentowane tak samo we wszystkich systemach | Problemy z uzgadnianiem, zduplikowana logika, spory o raporty |
Terminowość | Dane docierają w oknie czasowym oczekiwanym przez biznes | Nieaktualne dashboardy, opóźnione operacje, niedotrzymane SLA |
Unikalność | Rekord lub podmiot występuje raz, gdy tak powinno być | Zduplikowani klienci, podwójne obciążenia, zawyżone liczby |
Poprawność | Wartości są zgodne z dozwolonymi formatami, domenami i regułami | Błędy parsowania, odrzucone zdarzenia, nieprawidłowe transakcje |
Terminowość zasługuje na więcej uwagi, niż zwykle otrzymuje. Widziałem zespoły zatwierdzające zbiór danych, ponieważ każde pole przeszło kontrole typu i zakresu, podczas gdy operacje pracowały na wczorajszych danych. Tabela była poprawna. Decyzja i tak była błędna.
To samo dotyczy unikalności i spójności. Zduplikowana transakcja może kosztować więcej niż brakujące pole opcjonalne. Kod statusu, który oznacza jedno w systemie źródłowym, a co innego w hurtowni, może przejść walidację schematu i mimo to zepsuć raportowanie finansowe. Walidacja działa lepiej, gdy jej rygor wynika z wpływu na biznes, a nie z technicznej elegancji.
Różne typy walidacji wychwytują różne klasy ryzyka
Każdy wymiar wymaga innego rodzaju kontroli. Jeśli zespoły walidują tylko strukturę, umyka im znaczenie. Jeśli obserwują tylko rozkłady, umykają im naruszenia twardych reguł. Dobre pokrycie wynika z połączenia kilku typów kontroli i przypisania każdej z nich trybu egzekwowania.
Zastosuj następujące przyporządkowanie:
Walidacja schematu sprawdza strukturę. Obecność kolumn, typ danych, dopuszczalność wartości null i zmiany kontraktu.
Walidacja składniowa sprawdza format. Daty, kody walut, identyfikatory, wartości logiczne i ustandaryzowane wzorce tekstowe.
Walidacja semantyczna sprawdza znaczenie biznesowe. Data zakończenia późniejsza niż data rozpoczęcia, przejścia statusów zgodne z procesem, ceny zgodne z regułami produktowymi.
Walidacja relacyjna sprawdza integralność między tabelami. Klucze obce, osierocone rekordy i kompletność relacji nadrzędny–podrzędny.
Walidacja statystyczna sprawdza dryf zachowania. Zmiany wolumenu, zmiany odsetka wartości null, zmiany liczności i anomalie rozkładów.
Cichy dryf schematu leży pomiędzy tymi kategoriami i powoduje jedne z najtrudniejszych do zdiagnozowania incydentów. Zespół po stronie źródła może poszerzyć pole, zmienić przeznaczenie wartości wyliczeniowej, zmienić obsługę stref czasowych lub zacząć wysyłać nową opcjonalną kolumnę, którą dalszy kod ignoruje. Nic się nie zawiesza. Liczby po prostu przestają się zgadzać. W takich sytuacjach automatyczne kontrole kontraktów i monitory oparte na profilach danych są nie do przecenienia. Zespoły oceniające darmowe narzędzia do walidacji danych do kontroli schematu i monitorowania dryfu powinny szukać zarówno egzekwowania twardych reguł, jak i alertów opartych na trendach, ponieważ jedno bez drugiego pozostawia martwe pola.
Pole może być poprawne pod względem typu, a mimo to nieprawidłowe z punktu widzenia decyzji, którą wspiera.
To luka, którą podstawowe poradniki często pomijają.
Praktyczny proces projektowania reguł zaczyna się od prostego języka. Określ, co musi być prawdą, kto od tego zależy, co się stanie w razie niespełnienia i czy pipeline powinien zablokować przetwarzanie, poddać dane kwarantannie, ostrzec, czy zarejestrować zdarzenie do przeglądu. Przegląd kluczowych wymiarów jakości danych od IBM jest tu przydatny, ponieważ definiuje jakość jako przydatność do użycia, a właśnie według tego kryterium należy priorytetyzować walidację w systemach produkcyjnych.
Ostateczny wybór projektowy jest ekonomiczny. Blokowanie każdej anomalii brzmi jak dyscyplina, ale może zatrzymać operacje generujące przychody, opóźnić dalszych odbiorców i zalać zespoły mało wartościowymi alertami. Przepuszczanie wszystkiego jest jeszcze gorsze. Skuteczne programy walidacji oddzielają awarie wysokiego ryzyka od dopuszczalnej zmienności, te pierwsze egzekwują automatycznie, a drugie monitorują z jasno przypisaną odpowiedzialnością. Tak walidacja zwiększa niezawodność, nie zamieniając pipeline’u w nieustanny generator incydentów.
Wdrażanie walidacji na poziomie rekordu i pipeline’u
Walidacja działa najlepiej, gdy stosuje się ją jednocześnie na dwóch poziomach. Najpierw sprawdź każdy rekord pod kątem naruszeń reguł. Następnie sprawdź pipeline jako system pod kątem utraty danych, niezgodności i uszkodzeń strukturalnych. Jeśli robisz tylko jedno z dwóch, luki pozostają otwarte.
Zacznij od reguł na poziomie wierszy
Na poziomie rekordu podstawy są proste. Najlepsze praktyki branżowe wymagają walidacji na poziomie wierszy z zastosowaniem ośmiu konkretnych reguł, czyli pól wymaganych, kontroli typów, walidacji formatu, ograniczeń zakresu, unikalności, integralności referencyjnej, logiki biznesowej i walidacji między polami, do każdego rekordu, w połączeniu z dziennikiem audytu rejestrującym liczbę rekordów zaliczonych i niezaliczonych w każdym przebiegu na potrzeby zgodności i debugowania, jak opisano w przewodniku Flatfile po walidacji danych.
Praktyczny wzorzec SQL wygląda tak:
Nie jest to efektowne, ale jest skuteczne. Chodzi o to, by każdy błąd był jawny i możliwy do sklasyfikowania.
Zwykle potrzebne jest połączenie kilku kontroli:
Pola wymagane: Blokuj wartości null w kluczach, datach i atrybutach krytycznych operacyjnie.
Kontrole typu i formatu: Wymuszaj, by daty były datami, wartości logiczne wartościami logicznymi, a kody były zgodne z formatami referencyjnymi.
Ograniczenia zakresu: Wychwytuj niemożliwe lub niebezpieczne wartości, zanim zniekształcą dalszą logikę.
Reguły między polami: Waliduj zależności, takie jak daty rozpoczęcia i zakończenia, znaki debetu i kredytu czy kombinacje kraju i formatu kodu pocztowego.
Następnie zwaliduj pipeline jako system
Kontrole wierszy nie wychwycą wszystkiego. Pipeline może spełniać reguły na poziomie rekordów i mimo to być uszkodzony, jeśli połowa danych nigdy nie dotarła, złączenie zwielokrotniło wiersze albo liczby rekordów w źródle i w miejscu docelowym przestały się zgadzać.
Właśnie tu liczą się kontrole na poziomie pipeline’u:
Porównanie liczby wierszy: Porównuj liczby rekordów w źródle i w miejscu docelowym po ładowaniach i transformacjach.
Monitorowanie duplikatów: Sprawdzaj, czy klucze, które powinny być unikalne, pozostają unikalne po złączeniach lub sumach zbiorów.
Integralność referencyjna: Potwierdzaj, że wartości kluczy obcych istnieją w tabelach, do których się odwołują.
Kontrole poprawności agregatów: Porównuj sumy, rozkłady i wzorce wartości null między etapami.
Kontrole zgodności przy migracjach: W przypadku krytycznych pól podczas migracji waliduj każdy wiersz, gdy biznes nie może tolerować cichej utraty danych.
Wskazówki digna dotyczące walidacji migracji są tu szczególnie przydatne. Zwracają uwagę, że w przypadku krytycznych pól podczas migracji danych konieczna jest 100-procentowa walidacja na poziomie wierszy, aby potwierdzić zgodność liczby rekordów między źródłem a miejscem docelowym oraz upewnić się, że nie powstały duplikaty, żadne rekordy nie zostały niezauważenie utracone i nie istnieją rekordy niekompletne, natomiast w przypadku dużych zbiorów danych można stosować statystycznie istotne próbkowanie z wykrywaniem anomalii, gdy pełna ręczna kontrola jest niepraktyczna.
Ciężkie kontrole wykonuj w hurtowni danych
Walidacja dużych tabel często zawodzi, ponieważ zespoły wyciągają z hurtowni zbyt wiele danych i sprawdzają je w kodzie aplikacji. To powolne, drogie i trudne do skalowania. Gdy tylko to możliwe, przenoś ciężką pracę do bazy danych.
Walidacja w bazie danych lepiej sprawdza się w przypadku:
kontroli unikalności złożonych kluczy biznesowych
integralności referencyjnej między zbiorami danych
kontroli progów i zakresów w dużych tabelach
porównań profili odsetka wartości null lub rozkładów kategorii
Jeśli przed zbudowaniem własnych ram potrzebujesz lekkiego punktu wyjścia, warto zapoznać się z tymi darmowymi narzędziami do walidacji danych od digna, obok takich opcji jak testy dbt, Great Expectations i natywne kontrole SQL w hurtowni.
Hurtownia danych jest już zoptymalizowana pod kątem skanowania, porównywania, agregowania i łączenia. Niech walidacja odbywa się właśnie tam, zamiast eksportować problem gdzie indziej.
Automatyzacja walidacji i zarządzanie błędami
Ręczne kontrole wyrywkowe sprawdzają się przy debugowaniu. Nie są jednak modelem operacyjnym. Jeśli walidacja nie uruchamia się automatycznie przy każdej zmianie danych, Twój zespół polega na szczęściu i ciekawości.
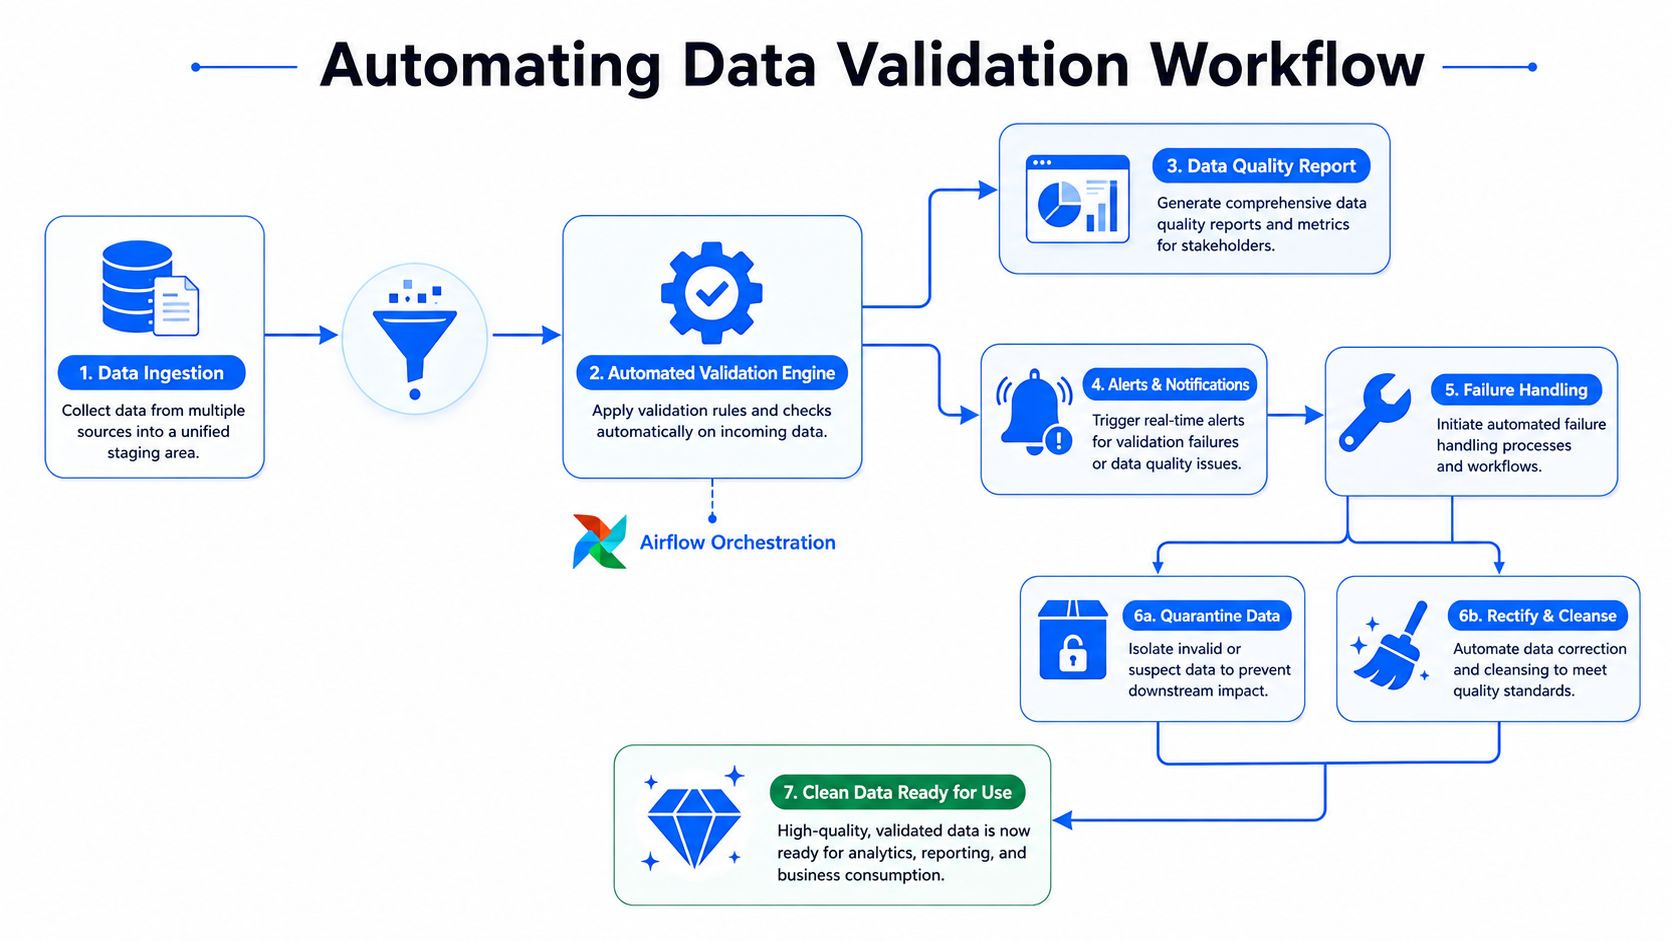
Automatyzuj kontrole tam, gdzie dane się zmieniają
Najczystszym wzorcem automatyzacji jest podejście sterowane zdarzeniami lub orkiestracją. Uruchamiaj kontrole po pozyskaniu danych, po głównych transformacjach i przed publikacją danych w warstwach udostępniania. Airflow, dbt i zadania hurtowni danych obsługują ten wzorzec.
Trwała sekwencja wygląda tak:
Pozyskaj dane i od razu zwaliduj schemat.
Uruchom reguły na poziomie rekordów na tabelach docelowych.
Po transformacjach uruchom kontrole agregatów i zgodności.
Zapisz wyniki zaliczone/niezaliczone w tabeli audytu.
Uruchom odpowiednią reakcję na błąd.
Obserwowalność i walidacja zaczynają się przenikać. Walidacja mówi, czy reguła została spełniona. Obserwowalność pomaga zrozumieć zmiany trendów, luki w terminowości i to, czy ten sam błąd powtarza się w kolejnych przebiegach. Przydatnym wprowadzeniem jest ten przegląd koncepcji obserwowalności danych i projektowania procesów.
Krótka prezentacja może pomóc zobrazować wzorzec orkiestracji:
Dobieraj reakcje na błędy według ryzyka biznesowego
Nie każda niespełniona kontrola zasługuje na tę samą reakcję. Na tym etapie zespoły często reagują albo zbyt mocno, albo zbyt słabo.
Przydatnym modelem decyzyjnym jest podział błędów na trzy kategorie:
Typ błędu | Przykład | Najlepsza reakcja |
|---|---|---|
Twarde zatrzymanie | Brak klucza głównego, nieprawidłowy okres finansowy, zerwana relacja w krytycznej tabeli faktów | Zatrzymaj pipeline |
Kwarantanna | Część wierszy narusza format lub logikę biznesową | Skieruj błędne rekordy do przeglądu |
Ostrzeżenie i kontynuacja | Niewielki dryf w niekrytycznym polu opisowym | Wyślij alert i monitoruj |
Ten kompromis jest ekonomiczny, a nie tylko techniczny. Dane branżowe pokazują, że problemy z jakością danych odpowiadają za 20–30% utraconych przychodów w sektorze finansowym i ochronie zdrowia, a mimo to nie istnieją standardowe ramy pozwalające wyznaczyć punkt, w którym nakład na walidację przewyższa krańcowe ograniczenie ryzyka, według omówienia technik walidacji i ich wpływu na biznes przez Twilio. Ta luka ma znaczenie. Zespoły muszą zdecydować, gdzie rygorystyczne egzekwowanie się opłaca, a gdzie generuje tarcia bez istotnego ograniczenia ryzyka.
Jeśli Twój stos zasila również systemy generatywne, jakość danych i monitorowanie modeli zaczynają się pokrywać. Przy ocenie kontroli w dalszych etapach warto znaleźć odpowiednią platformę do monitorowania LLM, aby zobaczyć, jak niezawodność danych wejściowych, zachowanie promptów i monitorowanie produkcyjne łączą się ze sobą.
Unikaj zmęczenia alertami
Zbyt wiele zespołów zalewa Slacka i skrzynki e-mail mało wartościowymi alertami, aż w końcu nikt ich nie czyta. Dobra automatyzacja tworzy sygnały, a nie szum.
Kilka nawyków sprawdza się szczególnie dobrze:
Kieruj według wagi: Powiadomienia dyżurne powinny być rzadkie. Większość problemów należy do dashboardów lub kolejek zgłoszeń.
Grupuj powiązane błędy: Jeśli dziesięć tabel zawodzi z powodu jednej zmiany schematu w źródle, wyślij jeden incydent.
Dodawaj kontekst: Każdy alert powinien mówić, co zawiodło, gdzie, kiedy i co system zrobił dalej.
Okresowo przeglądaj wzorce: Przewodnik Cube po najlepszych praktykach walidacji opisuje przydatny rytm stosowany w przedsiębiorstwach, w którym zespoły co kwartał przeglądają wzorce błędów i co roku aktualizują reguły, zamiast pozostawiać nieaktualne progi.
Alerty powinny mówić inżynierowi, co się stało i co zrobić dalej. Jeśli ogłaszają jedynie „walidacja nie powiodła się”, są niedokończoną pracą.
Zaawansowane strategie w skali przedsiębiorstwa
W skali przedsiębiorstwa statyczne reguły nadal mają znaczenie, ale przestają wystarczać. Potrzebujesz kontroli dla zmian, których nikt wprost nie przewidział w kodzie, zwłaszcza gdy narzędzia BI, usługi ETL i aplikacje źródłowe stale ewoluują pod spodem.
Cichy dryf schematu to problem przedsiębiorstw, który pomijają podstawowe poradniki
Wiele awarii nie wynika z wartości null ani z wartości spoza zakresu. Wynikają z subtelnej zmiany strukturalnej. Kolumna zmienia nazwę, typ zmienia się z liczby całkowitej na ciąg znaków albo narzędzie po stronie źródła automatycznie dostosowuje schemat w sposób, który utrzymuje pozyskiwanie danych, ale psuje dalszą logikę.
Dlatego śledzenie schematu należy traktować jako walidację, a nie tylko jako dbałość o metadane. Ryzyko jest większe, niż zakłada wiele zespołów. Najnowsze raporty branżowe z lat 2025–2026 wskazują, że 65% awarii pipeline’ów ML wynika z niewykrytych zmian schematu, a nie z błędów w wartościach danych, a mimo to standardowe protokoły walidacji rzadko obejmują śledzenie wersji schematu, jak przytoczono w tej dyskusji o dryfie schematu i awariach pipeline’ów.
Dojrzała praktyka walidacji schematu obejmuje:
Śledzenie wersji: Rejestruj zmiany strukturalne w czasie.
Kontrole kompatybilności: Ustal, które zmiany są wstecznie kompatybilne, a które powinny blokować publikację.
Odpowiedzialność: Powierz jednemu zespołowi zatwierdzanie zmian schematu.
Kontrole wpływu na dalsze systemy: Łącz alerty o zmianach schematu z modelami, dashboardami lub API, których dotyczą.
Dodaj wykrywanie anomalii i kontrolę terminowości
Zakodowane na sztywno reguły wychwytują tylko to, czego już wiesz, że należy szukać. Systemy korporacyjne potrzebują kolejnej warstwy, która wykrywa nieoczekiwane zmiany w rozkładach, wzorcach wartości null, proporcjach kategorii i czasie dostarczania danych.
To jedno z miejsc, w których pomaga wsparcie platformy. Narzędzia takie jak testy dbt i Great Expectations dobrze radzą sobie z walidacją opartą na regułach. Do monitorowania anomalii, terminowości, reguł na poziomie rekordów i zmian schematu bezpośrednio w bazie danych jedną z opcji jest digna, która przeprowadza analizy w środowisku klienta i ujawnia trendy, opóźnienia oraz zmiany strukturalne bez eksportowania danych produkcyjnych.
Terminowość zasługuje na takie samo traktowanie jak kontrole treści. Spóźnione dane mogą unieważnić dashboardy, nawet gdy każdy wiersz spełnia reguły typu i formatu. Monitoruj oczekiwane okna dostarczenia i sygnalizuj opóźnione ładowania, zanim interesariusze sami natrafią na nieaktualne raporty.
Zespoły budujące procesy obsługi klienta oparte na AI napotykają podobny problem w warstwie aplikacji. Dane mogą być poprawne strukturalnie, a mimo to prowadzić do niewiarygodnych wyników, jeśli dane wejściowe i instrukcje nie są kontrolowane. Dlatego wskazówki dotyczące projektowania promptów dla niezawodnej AI w obsłudze klienta są przydatne równolegle z walidacją danych. Dotyczą innej odmiany tej samej dyscypliny: definiowania akceptowalnych danych wejściowych i ograniczania cichych trybów awarii.
Nadzór chroni reguły przed dezaktualizacją
Reguły walidacyjne źle się starzeją, gdy nikt za nie nie odpowiada. Jeden zespół je pisze, inny zmienia proces źródłowy, a pół roku później kontrole są albo hałaśliwe, albo nieistotne.
Trwały model obejmuje:
Definicje reguł w prostym języku: Interesariusze biznesowi powinni móc je przeglądać bez czytania SQL.
Przypisanych właścicieli: Każdą regułę powinien utrzymywać właściciel danych, opiekun danych lub zespół ds. nadzoru.
Dziennik audytu: Przechowuj liczby wyników zaliczonych/niezaliczonych i metadane przebiegów.
Zaplanowane przeglądy: Regularnie weryfikuj progi, założenia i wyjątki.
To właśnie ta warstwa nadzoru zamienia walidację ze zbioru skryptów w operacyjny system kontroli.
Pragmatyczne ramy walidacji danych
Praktyczny program walidacji zaczyna się od ryzyka, a nie od pokrycia. Zespoły wpadają w kłopoty, gdy piszą dziesiątki kontroli dla danych o niewielkim znaczeniu, a przeoczają kilka trybów awarii, które mogą zafałszować raportowanie przychodów, zakłócić procesy obsługi klientów lub wprowadzić błędne cechy do modeli. Lepsze ramy zaczynają od dwóch pytań: co może zawieść niezauważenie i jaki jest koszt biznesowy, jeśli do tego dojdzie?

Działający model dla zespołów, które potrzebują wyników
Zacznij od zasobów danych obarczonych najwyższym ryzykiem operacyjnym lub regulacyjnym. W praktyce zwykle obejmuje to miary finansowe, identyfikatory klientów, pola związane ze zgodnością i dane wejściowe modeli. Dla każdego z nich zdefiniuj niewielki zestaw reguł, a następnie powiąż każdą regułę z działaniem. Jeśli kontrola nie zostanie spełniona, zdecyduj, czy pipeline powinien się zatrzymać, poddać kwarantannie dane, których to dotyczy, czy kontynuować z alertem.
Stosuj mieszany model egzekwowania, ponieważ nie każdy defekt należy traktować tak samo:
Stosuj ścisłe reguły do niezmienników: klucze główne, pola wymagane, integralność referencyjna i stałe formaty.
Wykorzystuj wykrywanie anomalii do zmian, których trudno z góry wyliczyć: przesunięcia rozkładów, skoki wartości null, zmiany wolumenu i opóźnione dostawy.
Jawnie śledź dryf schematu: Ciche zmiany kolumn i typów często psują dalszą logikę, zanim ktokolwiek to zauważy.
Przypisz właściciela do każdej reguły: Ktoś musi przeglądać szum, zatwierdzać wyjątki i wycofywać nieaktualne kontrole.
Wiele podstawowych poradników zawodzi właśnie pod tym względem. Traktują walidację jak bramkę typu zaliczone/niezaliczone. Systemy produkcyjne potrzebują zamiast tego modelu opartego na ryzyku. Brak klucza głównego w tabeli finansowej zasługuje na twarde zatrzymanie. Niewielka zmiana w atrybucie o niskim priorytecie może wymagać jedynie ostrzeżenia i zgłoszenia. Celem nie jest maksymalne egzekwowanie. Celem są wiarygodne dane przy koszcie, który zespół jest w stanie udźwignąć.
Od czego zacząć w tym tygodniu
Zacznij od jednego spornego pipeline’u. Wybierz ten, który ludzie już kwestionują na spotkaniach, ponieważ ma on widoczny wpływ na biznes i naturalną pętlę informacji zwrotnej.
Następnie zrób pięć rzeczy:
Nazwij pięć warunków biznesowych, które muszą być spełnione.
Przyporządkuj każdy warunek do kontroli technicznej na poziomie rekordu lub pipeline’u.
Sklasyfikuj każdy błąd według wpływu: zatrzymanie, kwarantanna, ostrzeżenie lub tylko rejestracja.
Dodaj historię przebiegów, aby zespół widział powtarzające się błędy i dryf w czasie.
Po pierwszym tygodniu przejrzyj fałszywe alarmy i zaostrz hałaśliwe reguły.
Ta sekwencja działa, ponieważ wymusza wczesne decyzje o kompromisach. Zespoły dowiadują się, które kontrole chronią zaufanie, a które jedynie powodują zmęczenie alertami. Ujawnia też rzeczywiste tryby awarii, zanim ktokolwiek zainwestuje w duży katalog reguł, którego utrzymanie będzie kosztowne.
Walidacja danych działa najlepiej jako system operacyjny niezawodności. Łączy deterministyczne reguły, wykrywanie dryfu, świadomość schematu, odpowiedzialność i obsługę błędów w jeden proces, który przetrwa zmieniające się źródła i rosnącą złożoność pipeline’ów.
Jeśli szukasz praktycznego sposobu na połączenie walidacji w bazie danych, wykrywania anomalii, monitorowania terminowości i śledzenia schematu w jednym procesie, zapoznaj się z digna. To rozwiązanie stworzone dla zespołów, które muszą walidować rekordy, wychwytywać dryf i monitorować niezawodność pipeline’ów bez wynoszenia danych produkcyjnych poza własne środowisko.
Ponieważ cichy dryf schematu umyka regułom na poziomie rekordów, digna Schema Tracker obejmuje część walidacji związaną ze śledzeniem wersji, wykrywając dodane, usunięte i zmienione pod względem typu kolumny, zanim dalsza logika przestanie działać.
Najczęściej zadawane pytania
Jak walidować dane w pipelinie?
Waliduj w wielu punktach kontrolnych, a nie tylko na wyjściu. Sekwencja opisana w artykule to: walidacja schematu przy pozyskiwaniu, reguły na poziomie rekordów na tabelach docelowych, kontrole agregatów i zgodności po transformacjach, zapis wyników zaliczonych/niezaliczonych w tabeli audytu, a następnie uruchomienie reakcji na błąd odpowiadającej ryzyku biznesowemu.
Jakie jest sześć wymiarów jakości danych?
Sześć wymiarów to dokładność, kompletność, spójność, terminowość, unikalność i poprawność. Artykuł traktuje je jako odrębne klasy awarii o różnych kosztach biznesowych: zduplikowana transakcja może kosztować więcej niż brakujące pole opcjonalne, a tabela może przejść każdą kontrolę typu, podczas gdy operacje nadal pracują na wczorajszych danych.
Jakie reguły walidacji na poziomie wierszy powinien spełniać każdy rekord?
Przewodnik Flatfile, cytowany w artykule, wymienia osiem: pola wymagane, kontrolę typów, walidację formatu, ograniczenia zakresu, unikalność, integralność referencyjną, logikę biznesową i walidację między polami. Należy je połączyć z dziennikiem audytu liczby wyników zaliczonych/niezaliczonych w każdym przebiegu. Prosty wzorzec SQL CASE może oznaczać puste identyfikatory zamówień, ujemne kwoty lub przyszłe daty zamówień.
Co powinno się stać, gdy kontrola walidacji danych nie zostanie spełniona?
Dopasuj reakcję do ryzyka biznesowego. Twarde zatrzymanie wstrzymuje pipeline w przypadku problemów takich jak brak klucza głównego lub nieprawidłowy okres finansowy. Kwarantanna kieruje część błędnych wierszy do przeglądu. Ostrzeżenie z kontynuacją pasuje do niewielkiego dryfu w niekrytycznym polu opisowym, który zamiast blokady otrzymuje alert i monitorowanie.
Dlaczego dryf schematu jest problemem walidacji danych?
Zmiany strukturalne często umykają kontrolom wartości: zmiana nazwy kolumny lub zmiana typu z liczby całkowitej na ciąg znaków może utrzymać pozyskiwanie danych, a jednocześnie zepsuć dalszą logikę. Raporty cytowane w artykule przypisują 65% awarii pipeline’ów ML niewykrytym zmianom schematu, dlatego śledzenie wersji, kontrole kompatybilności i odpowiedzialność należą do walidacji.


