Governance jakości danych: zasady, proces i praktyka
|
7
min. czyt.

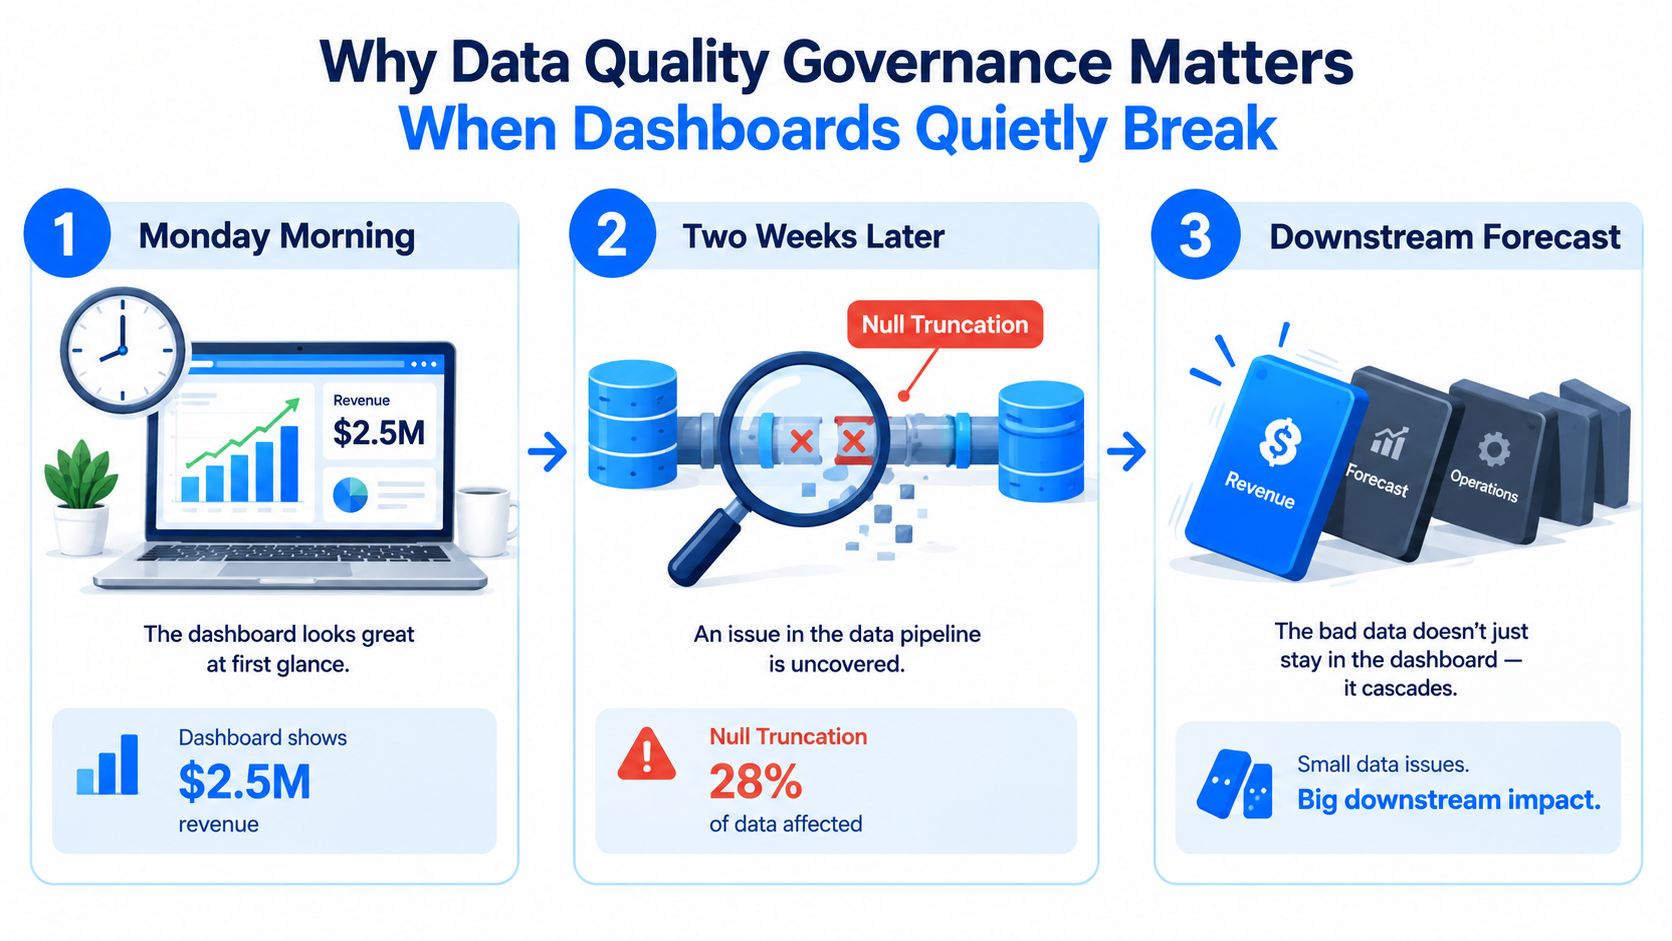
Poniedziałek rano, pulpit wygląda spokojnie. Przychód świeci na zielono, kwartał sprawia wrażenie zgodnego z planem i nikt nie zadaje niewygodnych pytań. Potem finanse odkrywają, że pipeline źródłowy obciął wartości null, prognozę zbudowano na błędnych liczbach, a czysty pulpit okazuje się bardzo kosztowną iluzją.
To moment, w którym governance jakości danych przestaje brzmieć abstrakcyjnie. To dyscyplina, która wychwyciłaby dryf, podniosła alert, przypisała właściciela i nie pozwoliła małemu problemowi wyżej w łańcuchu urosnąć do korekty w skali całej firmy. W praktyce łączy surowe pipeline'y z zaufanymi decyzjami, żeby pulpit nie tylko wyglądał poprawnie, ale poprawny pozostawał.
Reszta przewodnika idzie w kolejności, w jakiej musi o tym myśleć prawdziwa organizacja: najpierw zasady, potem role, polityki, kontrole, cykl życia i observability. Jeśli już zmagasz się z zepsutymi raportami, nieświeżymi kanałami albo danymi treningowymi AI, które nie do końca się zgadzają, praktyczne pytanie nie brzmi, czy governance ma znaczenie. Brzmi: jak uczynić je widocznym na tyle wcześnie, by zrobić coś pożytecznego.
Spis treści
Dlaczego governance jakości danych ma znaczenie, gdy pulpity psują się po cichu
Ile kosztuje słaba jakość danych i po co istnieje governance
Role i odpowiedzialności w programie governance jakości danych
Dlaczego governance jakości danych ma znaczenie, gdy pulpity psują się po cichu
Zepsuty pulpit rzadko sam się zgłasza. Zwykle przychodzi najpierw jako źle ulokowana pewność, a dopiero potem jako zamęt. W poniedziałek liczby wyglądają dobrze. Dwa tygodnie później ktoś zauważa, że system źródłowy odrzucał wartości null, a każda prognoza poniżej powstała na fikcji.
Dlatego governance nie może żyć wyłącznie w dokumentacji. Governance jakości danych to warstwa kontrolna, która wypatruje dryfu, wiąże problem z właścicielem i kieruje go dalej, zanim szkoda się rozejdzie. W nadzorowanym środowisku pipeline traktuje się jak monitorowany proces biznesowy, a nowoczesne narzędzia observability dają tej dyscyplinie sposób działania wewnątrz przepływu danych, a nie tylko na papierze.
Co pęka najpierw
Pierwsza awaria zwykle dotyka zaufania. Analitycy sprawdzają raporty po raz kolejny, zespoły spierają się, która wersja jest właściwa, a decyzje zwalniają, bo ludzie przestają wierzyć liczbom przed sobą. Ten zmarnowany wysiłek jest jednym z powodów, dla których słaba jakość danych stała się w skali tak kosztowna: podsumowanie IBM z raportu z 2025 r. wskazuje, że ponad jedna czwarta organizacji traci rocznie ponad 5 mln USD, a 7 % raportuje straty 25 mln USD lub większe.
Druga awaria jest operacyjna. Prognoza sprzedaży zbudowana na obciętych danych może prowadzić do nadmiernych zobowiązań, plan uzupełnień może przestrzelić zapas, a model może odziedziczyć ten sam zły sygnał co pulpit. Problem rośnie, bo nikt nie wychwytuje go u źródła.
Program governance jest wart dokładnie tyle, ile jego zdolność dostrzeżenia problemu, póki zostaje czas na reakcję.
Observability zmienia tę historię. Skok odsetka wartości null, nieoczekiwana zmiana schematu, spóźniony kanał albo brakujący rekord nie muszą czekać, aż zauważą to finanse. Wykrywanie anomalii sterowane AI, monitorowanie Timeliness, śledzenie schematu i walidacja na poziomie rekordu potrafią ujawnić problem wewnątrz pipeline'u, z dowodami już dołączonymi i właścicielem już wskazanym.
Zespołom, które chcą połączyć nadzorowane dane z raportowaniem na żywo, ten przegląd pulpitów jakości danych pokazuje, jak pulpity przechodzą od statycznego raportowania do aktywnej kontroli. Ta różnica ma znaczenie. Pulpit odbijający tylko przeszłość potrafi ukryć dryf. Pulpit spięty z monitorowaniem i walidacją potrafi go zgłosić na tyle wcześnie, by go poprawić.
Podstawowe zasady definiujące governance jakości danych
W najprostszym ujęciu governance jakości danych to zbiór zasad, ról i kontroli, które utrzymują dane w stanie przydatnym do zamierzonego użycia. Zasady brzmią prosto, ale każdą trzeba sprawdzić w prawdziwym procesie, na prawdziwym zbiorze, przez prawdziwego właściciela. Jeśli któraś warstwa jest mglista, całość szybko robi się miękka.
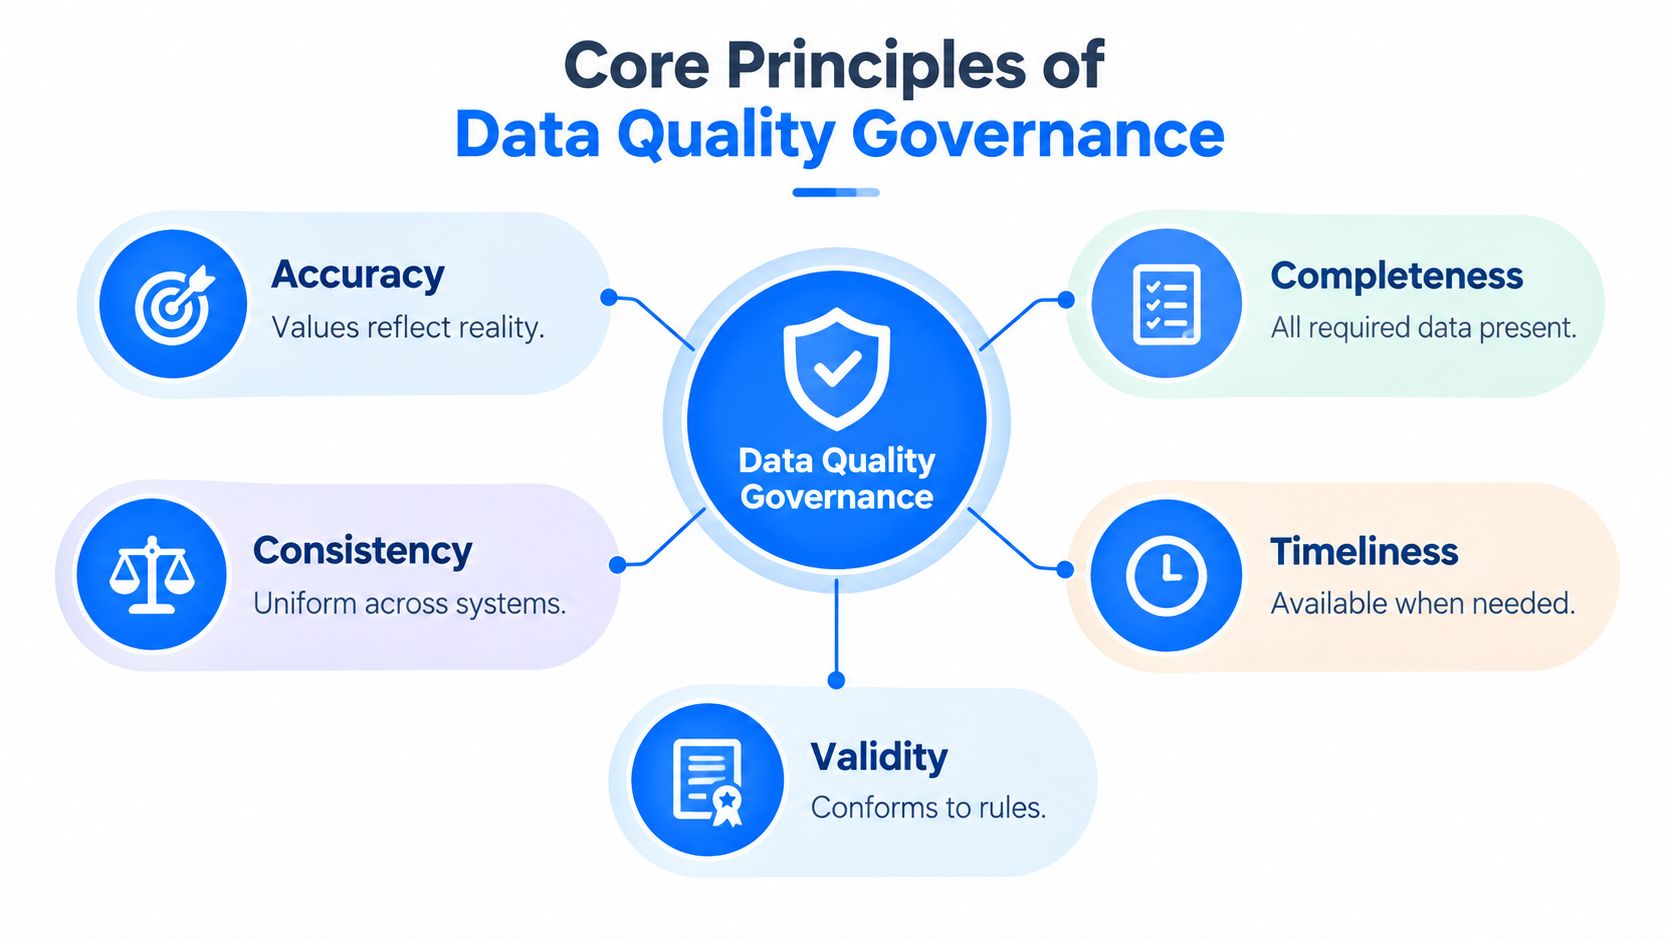
Pięć wymiarów, które liczą się w praktyce
Dokładność oznacza, że wartości odzwierciedlają rzeczywistość. Adres klienta wciąż wskazujący stare mieszkanie może przejść kontrolę formatu, a i tak jest błędny, jeśli kurier nie dostarczy tam przesyłki.
Kompletność oznacza, że wymagane dane są obecne. Rekord rejestracji bez adresu e-mail albo bez znacznika zgody może wyglądać strukturalnie poprawnie, a mimo to być bezużyteczny dla procesu biznesowego.
Spójność oznacza, że to samo znaczy to samo wszędzie. Jeśli walutę zapisuje się inaczej w finansach, a inaczej w operacjach, uzgadnianie zmienia się w ręczną pracę detektywistyczną.
Timeliness oznacza, że dane docierają dość wcześnie, by wesprzeć decyzję. Nieświeży kanał stanów magazynowych może być technicznie poprawny i nadal bezużyteczny, jeśli magazyn poszedł już dalej.
Poprawność oznacza, że dane spełniają ustalone reguły. Adres e-mail niepasujący do prawidłowego wzorca powinien odpaść wcześnie, a nie ujawnić się po odbiciu kampanii.
Pod tymi pięcioma leżą dwa atrybuty wspierające. Niezawodność mówi ludziom, że mogą polegać na tym, iż dane zachowają się zgodnie z oczekiwaniem, a dostępność oznacza, że dane są w zasięgu, gdy są potrzebne. Razem zamieniają ładnie brzmiącą zasadę w działający model operacyjny.
Jeśli szukasz pokrewnego ujęcia z innej dziedziny, artykuł o zapewnianiu rzetelności finansów parafialnych pokazuje, jak bardzo liczy się staranne prowadzenie zapisów, gdy stawką jest zaufanie publiczne i rozliczalna sprawozdawczość. Lekcja przenosi się czysto, choć kontekst się zmienia.
Zespołom wbudowującym to w szerszy model operacyjny przegląd DMBOK od digna służy jako praktyczny punkt odniesienia. Pomaga umieścić kontrole jakości w szerszej strukturze governance, zamiast traktować je jak odosobnione sprawdzenia.
Ile kosztuje słaba jakość danych i po co istnieje governance
Słaba jakość danych nie tworzy jednego wydatku. Zaczyna się od zmarnowanego czasu analityków, bo ludzie powtarzają zapytania, uzgadniają raporty i gonią tę samą rozbieżność, skoro nikt nie ufa pierwszej odpowiedzi.
Potem dociera do biznesu. Zespół, który gromadzi za dużo zapasu przez błędny kanał, płaci za ten błąd w operacjach, a nie tylko w backlogu zespołu danych. Governance istnieje po to, by zatrzymać błędy, zanim się rozejdą.
Drabina kosztów i kontrola właściwa dla każdego szczebla
Na dole drabiny reguły walidacyjne wcześnie wychwytują oczywiste problemy. Brakujące pole obowiązkowe, zniekształcony e-mail albo niemożliwa wartość powinny odpaść, zanim rekord stanie się czyimś sprzątaniem.
Szczebel wyżej wykrywanie anomalii i SLA świeżości wychwytują zmiany technicznie prawidłowe, lecz operacyjnie błędne. Kanał docierający codziennie za późno albo metryka wyskakująca poza normalny zakres wymagają uwagi, nawet jeśli schemat wciąż wygląda dobrze. To pomost między polityką a observability: regułę pisze się raz, a potem pipeline sprawdza ją bez przerwy.
Wyżej liczą się ścieżki audytu i przepływy zatwierdzeń, gdy problem dotyka ujawnień, sprawozdawczości regulowanej albo procesu wymagającego dowodu, kto co zatwierdził. Jeśli zmianę trzeba będzie później wyjaśnić, zapis tej decyzji musi powstać teraz.
Na szczycie lineage end-to-end i własność naprawy łączą wadliwy rekord z pulpitami, raportami i modelami, których dotknął. Bez tego śladu zespoły naprawiają objaw i chybiają źródła, jak łatanie przecieku bez znalezienia rury.
Zapobieganie jest tańsze niż korekta, bo każdy odbiorca poniżej mnoży koszt sprzątania.
Ta ekonomiczna logika nie jest abstrakcyjna. Przegląd literatury przytoczył 23 przykłady kosztów złych danych, w tym utrzymanie, nadmiar pracy, ponowne wprowadzanie, utratę przychodu, utratę klientów i przeróbki, dlatego governance to coś więcej niż uporządkowane metadane. Ten sam przegląd wskazał model Dun & Bradstreet szacujący, że naprawa problemu z danymi kosztuje około 1 USD na rekord przed wejściem do systemu, 10 USD na rekord po wprowadzeniu i 100 USD na rekord po zdarzeniu, więc moment zmienia ekonomię. Zobacz przegląd na temat kategorii kosztów i ekonomii w przeliczeniu na rekord.
Dla zespołu governance to praktyczny argument w prostym języku. Wychwyć problem wcześnie, a zostanie lokalny. Wychwyć późno, a dokłada się do niego każdy zespół po drodze.
Role i odpowiedzialności w programie governance jakości danych
Program governance upada najszybciej, gdy nikt nie wie, czyj jest wadliwy rekord. Lekarstwem jest prosty model odpowiedzialności, zwykle w stylu RACI, gdzie jedna grupa odpowiada za wynik, inne wykonują, a nikt nie może założyć, że problem należy do kogoś innego.
Kto za co odpowiada
Rada governance danych albo sponsor wykonawczy odpowiada za rezultat i postawę wobec ryzyka. Jeśli jakość psuje się w domenie wielokrotnie, to nie tylko techniczna uciążliwość, lecz sprawa dla kierownictwa.
Właściciele danych to zwykle wyżsi menedżerowie biznesowi. Rozstrzygają, jak wygląda akceptowalna jakość w ich domenie, a potem zatwierdzają priorytety napraw, gdy różne poprawki rywalizują o uwagę.
Data stewardzi przekładają te reguły na codzienną praktykę. Piszą definicje biznesowe, przeglądają anomalie, koordynują poprawki i pilnują, by reguły znaczyły to samo dla osób, które z nich korzystają.
Inżynierowie danych wdrażają kontrole w pipeline'ach i odpowiadają za infrastrukturę, która je egzekwuje. Jeśli kontrola nie działa tam, gdzie płyną dane, niczego nie ochroni.
Inżynierowie platformy i analityki utrzymują narzędzia, integrację przepływów i ścieżki dostarczania na tyle stabilnie, by kontrole działały bez tarcia. Partnerzy ds. zgodności wkraczają, gdy dowody muszą wytrzymać audyt lub wymóg regulacyjny.
Rola | Główny obowiązek | Odpowiada za |
|---|---|---|
Sponsor wykonawczy lub rada governance | Wyznaczanie kierunku i rozstrzyganie dużych kompromisów ryzyka | Rezultaty programu i postawę wobec ryzyka |
Właściciel danych | Definiowanie akceptowalnej jakości w domenie biznesowej | Decyzje domenowe i priorytet naprawy |
Data steward | Utrzymywanie definicji i koordynowanie poprawek | Bieżące zarządzanie jakością |
Inżynier danych | Budowanie i uruchamianie walidacji w pipeline'ach | Techniczne egzekwowanie kontroli |
Inżynier platformy lub analityki | Utrzymywanie sprawnych ścieżek monitorowania i dostarczania | Niezawodność operacyjną stosu kontrolnego |
Partner ds. zgodności | Przegląd dowodów i zgodności z polityką | Gotowość audytową i obronność regulacyjną |
Pełniejsze rozpisanie tych przekazań daje ten przewodnik po rolach i odpowiedzialnościach w jakości danych. Najważniejsze, czego pilnować, to klasyczny tryb awarii, w którym każdy sądzi, że tym samym problemem zajmuje się ktoś inny.
Polityki, standardy i zgodność sprawdzalna maszynowo
Polityki to spisana intencja. Standardy to mierzalna wersja tej intencji. Zgodność to część, w której system dowodzi, że dane spełniły standard, a nie tylko notatkę o polityce.
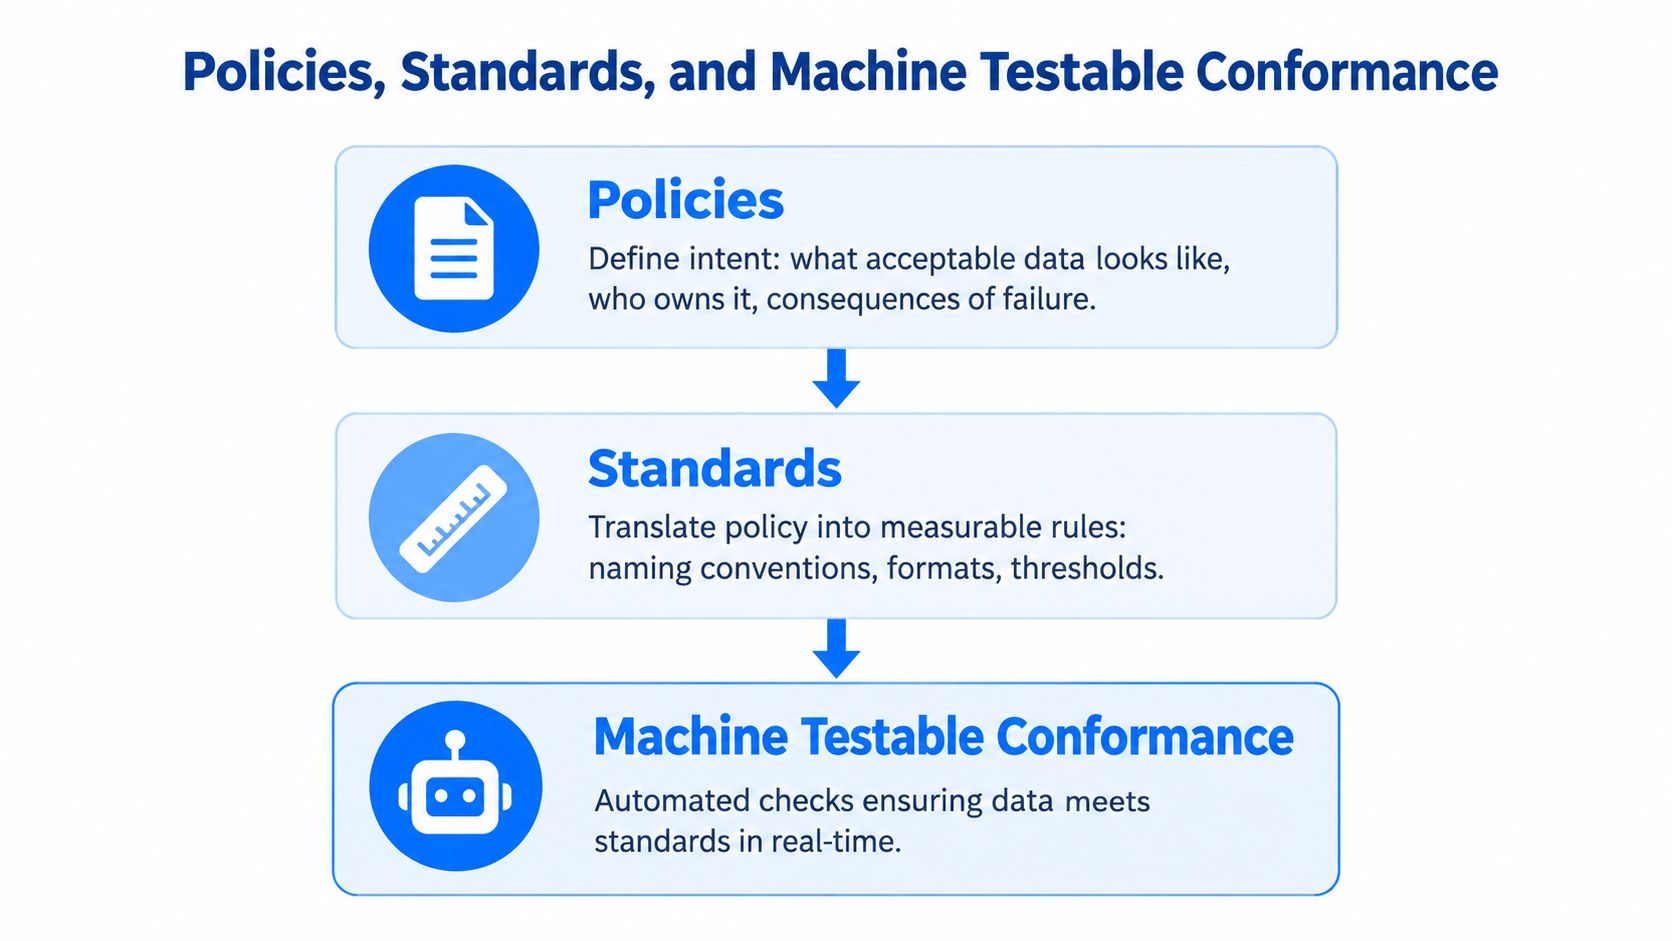
Zamiana intencji w coś, co pipeline potrafi egzekwować
Polityka może mówić, że podstawowe dane klientów muszą być dość wiarygodne do użytku operacyjnego. Standard czyni to konkretnym, na przykład wymagając, by tabela klientów lądowała w ustalonym oknie świeżości albo by pola krytyczne mieściły się poniżej zdefiniowanego progu wartości null.
To różnica między regułą a nadzieją. Polityka bez testu jest tylko aspiracją. Test bez polityki jest tylko techniczną kontrolą bez znaczenia dla governance.
ISO 8000-51:2023 czyni tę myśl bardzo konkretną. Norma określa wymagania dla wymiany deklaracji polityki data governance oraz dla automatycznego testowania zgodności zbiorów danych ze specyfikacjami wskazanymi w tych deklaracjach, wiążąc warstwę pisaną bezpośrednio z egzekwowaniem sprawdzanym maszynowo ISO 8000-51:2023.
Jak wygląda zgodność sprawdzalna maszynowo
W praktyce pojawia się jako asercje, kontrole schematu, testy kontraktów i walidatory na poziomie pipeline'u. Jeden zespół może wymuszać konwencję nazewniczą przy ingeście, drugi sprawdzać pola obowiązkowe przed treningiem modelu, a trzeci blokować publikację, gdy schemat zmieni się nieoczekiwanie.
Ramy brytyjskiego rządu są tu użyteczne, bo popychają organizacje ku formalnemu governance, uzgodnionym zasadom i standardom czyniącym dane wielokrotnie użytecznymi i interoperacyjnymi Government Data Quality Framework. To ta sama logika, której potrzebują zespoły w sektorze prywatnym, gdy chcą dowodów, a nie samych intencji.
Dla bardziej szczegółowego modelu operacyjnego strona standardów jakości danych digna jest praktycznym miejscem zakotwiczenia rozmowy. Powstrzymuje politykę, standard i egzekwowanie przed zlaniem się w jeden mglisty dokument.
Walidacja i naprawa jako ciągły cykl życia
Praca nad jakością nie jest jednorazowym porządkowaniem. To pętla. Pętla zaczyna się, gdy pojawia się coś nietypowego, a kończy dopiero po zweryfikowaniu poprawki tą samą kontrolą, która wykryła problem.
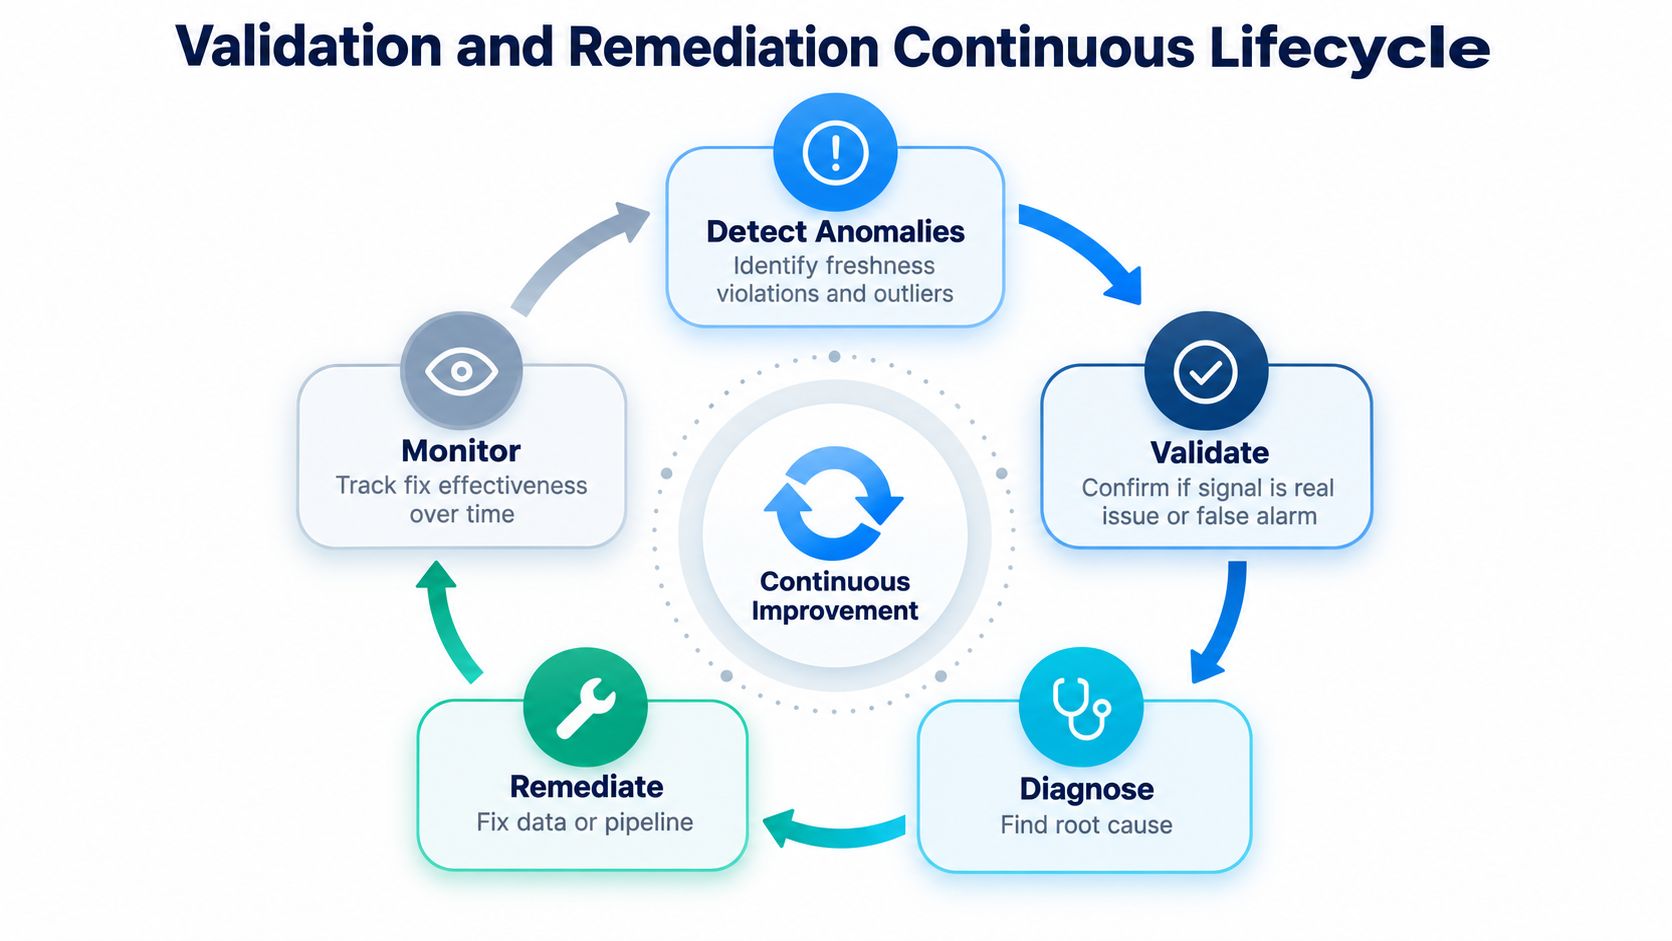
Pięcioetapowa pętla
Po pierwsze wykryj. Wykrywanie anomalii sterowane AI potrafi ujawnić wartości odstające, monitorowanie Timeliness zgłosić spóźnione ładowania, a śledzenie schematu wychwycić atrybuty dodane, usunięte albo o zmienionym typie, zanim odbiorcy poniżej poczują awarię.
Po drugie zwaliduj. Nie każdy alert jest defektem. Część to oczekiwany dryf, zmiana sezonowa albo zdarzenie biznesowe wymagające kontekstu, zanim ktokolwiek dotknie pipeline'u.
Po trzecie priorytetyzuj. Właściwe pytanie to nie tylko „czy jest zepsute?”, lecz „jaki jest wpływ i co jeszcze od tego zależy?”. Liczy się tu lineage, bo jedna wadliwa tabela może dotknąć długiego ogona raportów i modeli.
Po czwarte napraw. Popraw źródło, jeśli możesz. Jeśli nie możesz, udokumentuj logikę kompensującą i zadbaj, by obejście miało właściciela, było widoczne i tymczasowe.
Po piąte zweryfikuj. Poprawka powinna przywrócić zgodność, nie psując odbiorców. Tu liczy się walidacja na poziomie rekordu, bo liczby wierszy, integralność referencyjna i rozkłady wartości potrafią udowodnić, że poprawka zadziałała.
Dobra naprawa zamyka pętlę. Zła naprawa tylko przenosi problem do innej tabeli.
Platformy operacyjne takie jak obszar integracji Donely warto porównać, jeśli przyglądasz się, jak monitorowanie wpina się w istniejące narzędzia i przepływy. Nie chodzi o markę, lecz o wzorzec projektowy: kontrole powinny mieszkać blisko przepływu danych, a nie kilka systemów dalej.
Jak observability zamienia governance w mierzalną praktykę
Observability czyni governance realnym, bo zamienia zasady w dowody. Zamiast czekać na comiesięczny przegląd, zespoły mogą obserwować świeżość, wolumen, rozkład, schemat, lineage i poprawność rekordów w trakcie przepływu danych.
Co pokazuje użyteczny pulpit governance
Poważny pulpit powinien pokazywać bieżącą zgodność, trendy w czasie, nieudane kontrole, nierozwiązane wyjątki oraz tempo wykrywania i naprawy. Powinien też uczynić alert czytelnym w kontekście: dotknięty zbiór, proces biznesowy, uruchomienie pipeline'u, oczekiwany zakres, dotkliwość i stewarda odpowiedzialnego za działanie.
Ten kontekst ma znaczenie, bo alert bez lineage to tylko szum. Z lineage ten sam alert mówi, który raport, model albo proces operacyjny odczuje problem, jeśli nikt nie zareaguje.
Dlaczego analiza trendów ma znaczenie
Pojedynczy incydent może być jednorazowy. Powtarzalny dryf schematu albo wielokrotne uchybienia świeżości wskazują zwykle na słabość kontroli, a nie zdarzenie losowe. Analiza trendów pomaga zespołom governance oddzielić odosobnione pomyłki od awarii strukturalnych wymagających zmiany polityki lub procesu.
Liczą się też niezmienne wyniki kontroli. Dają audytorom dowody, stewardom historię, a kierownictwu coś bardziej użytecznego niż mgliste zapewnienie, że „liczby wyglądają teraz lepiej”.
Zespołom wdrażającym to produkcyjnie spojrzenie digna na observability danych dobrze pasuje do wzorca operacyjnego, bo łączy wykrywanie anomalii, walidację, monitorowanie Timeliness i śledzenie schematu wewnątrz przepływu, w którym pojawia się problem. To właśnie dystans między polityką na papierze a kontrolą w ruchu.
Zacznij od krytycznych elementów danych, a potem stopniuj alerty według ryzyka biznesowego. Gdy wszystko krzyczy naraz, nikt nie słyszy tego, co ważne.
Większa zmiana jest kulturowa. Observability nie zastępuje governance, lecz dostarcza mu faktów dość szybko, by ludzie mogli na nich działać.
Nadzór nad jakością danych dla AI i Twoje kolejne kroki
AI podnosi stawkę, bo model potrafi wzmocnić drobne defekty do wielu decyzji. Nieświeże cechy, nieudokumentowane zmiany schematu, niespójne etykiety i niekompletne próbki nie zostają lokalne, gdy wejdą w trening albo wnioskowanie.
Praktyczny program zaczyna się od zbiorów zasilających ważne modele. Przypisz właściciela i stewarda, zdefiniuj progi przydatności do celu i przetestuj dane, zanim dotrą do treningu lub produkcyjnego scoringu. Ta sama logika dotyczy pochodzenia, rozkładów cech, jakości etykiet, kompletności, Timeliness i zachowania w podgrupach przez cały cykl życia modelu.
Wykonalna lista startowa
Zinwentaryzuj produkty danych, które liczą się najbardziej: Ustal, które tabele, kanały i zestawy cech wpływają na przychód, ryzyko, obsługę lub sprawozdawczość regulowaną.
Ustaw najpierw kilka mierzalnych kontroli: Skup się na sprawdzeniach, które wychwyciłyby awarie już przez Ciebie widziane, a nie na każdym teoretycznym problemie.
Nazwij ścieżkę eskalacji: Zdecyduj, kogo się wzywa, kto rozstrzyga i kto może zatwierdzić wyjątek, gdy dane są niedoskonałe, ale wciąż użyteczne.
Dokumentuj wyjątki: Jeśli zespół przyjmuje tymczasowe obejście, zapisz to, żeby ten skrót nie stał się nową normą.
Przeglądaj powtarzalne defekty: Wykorzystaj historię awarii, czas naprawy i zgodność z polityką, by zdecydować, gdzie należy kolejna inwestycja.
Przegląd wykonany przez człowieka wciąż ma znaczenie, gdy automatyzacja nie potrafi rozstrzygnąć, czy dane są semantycznie poprawne, sprawiedliwe i odpowiednie dla zastosowania. Szczególnie dotyczy to AI, gdzie czysty schemat wciąż może ukrywać zły zestaw etykiet albo obciążoną próbkę.
Szersze branżowe spojrzenie na punkty nacisku AI przynosi to podsumowanie badania z 2026 r. o data governance i AI, które pokazuje, jak często organizacje zmagają się z jakością danych treningowych i zależnością od governance. Lekcja jest prosta: AI nie zmniejsza potrzeby governance, lecz obnaża, gdzie governance i tak było cienkie.
Jeśli chcesz zamienić tę myśl w działający program, digna dostarcza korporacyjnych możliwości jakości danych i observability, które monitorują anomalie, walidację, Timeliness i zmiany schematu wewnątrz własnego środowiska klienta. Odwiedź dignę, by zobaczyć, jak te kontrole wpasują się w Twoje pipeline'y, model governance i przepływy AI, za które odpowiadasz.
Polityki stają się mierzalne dopiero wtedy, gdy przekładają się na liczby, które ktoś śledzi co tydzień — zacznij od działającego zestawu metryk jakości danych.
Najczęściej zadawane pytania
Dlaczego governance jakości danych nie może żyć tylko w dokumentacji?
Bo zepsuty pulpit rzadko sam się zgłasza. Governance istniejące jako spisana polityka nie ma jak zauważyć cichej awarii, a właśnie tej awarii miało zapobiegać.
Co pęka najpierw, gdy governance jest tylko na papierze?
Zaufanie. Pierwszą awarią jest to, że ludzie przestają wierzyć liczbom, a drugą operacyjna, bo wysiłek przenosi się na ponowne sprawdzanie pracy, która powinna już być wiarygodna.
Ile kosztuje ten zmarnowany wysiłek?
Podsumowanie IBM z raportu z 2025 r. wskazuje, że ponad jedna czwarta organizacji traci rocznie ponad 5 mln USD z powodu słabej jakości danych, a 7 % raportuje straty 25 mln USD lub większe.
Co czyni program governance naprawdę użytecznym?
Zdolność dostrzeżenia problemu, póki jest jeszcze czas zareagować. Program, który wytwarza dokładną relację z tego, co poszło nie tak w zeszłym kwartale, jest audytem, a audyty docierają po decyzji, którą mogłyby zmienić.
W jakiej kolejności to budować?
Najpierw zasady, potem role, polityki, kontrole, cykl życia i observability. Zaczynanie od kontroli przed rolami daje sprawdzenia bez właściciela, a zaczynanie od polityk przed zasadami daje reguły, których nikt nie potrafi rozstrzygnąć.



