Definicja oceny jakości danych: praktyczny przewodnik
|
7
min. czyt.

Ocena jakości danych to systematyczny proces, który mierzy przydatność do użycia (fitness for use) w wielu wymiarach, takich jak dokładność, kompletność, aktualność, spójność i lineage, zamiast ograniczać się do pojedynczej kontroli dokładności. Współczesne podejście wyrosło z definicji „fitness for use” z 1996 roku i obejmuje dziś ustrukturyzowane ramy, takie jak sześcioczęściowy model oceny MFW.
Popularna rada brzmi: oczyść dane, policz wartości null i idź dalej. To podejście zawodzi, gdy tylko poprawny technicznie zbiór danych dociera z opóźnieniem, opiera się na sprzecznych definicjach biznesowych lub traci identyfikowalność, zanim trafi do zadań analitycznych lub machine learningu.
Spis treści
Nowe spojrzenie na definicję oceny jakości danych
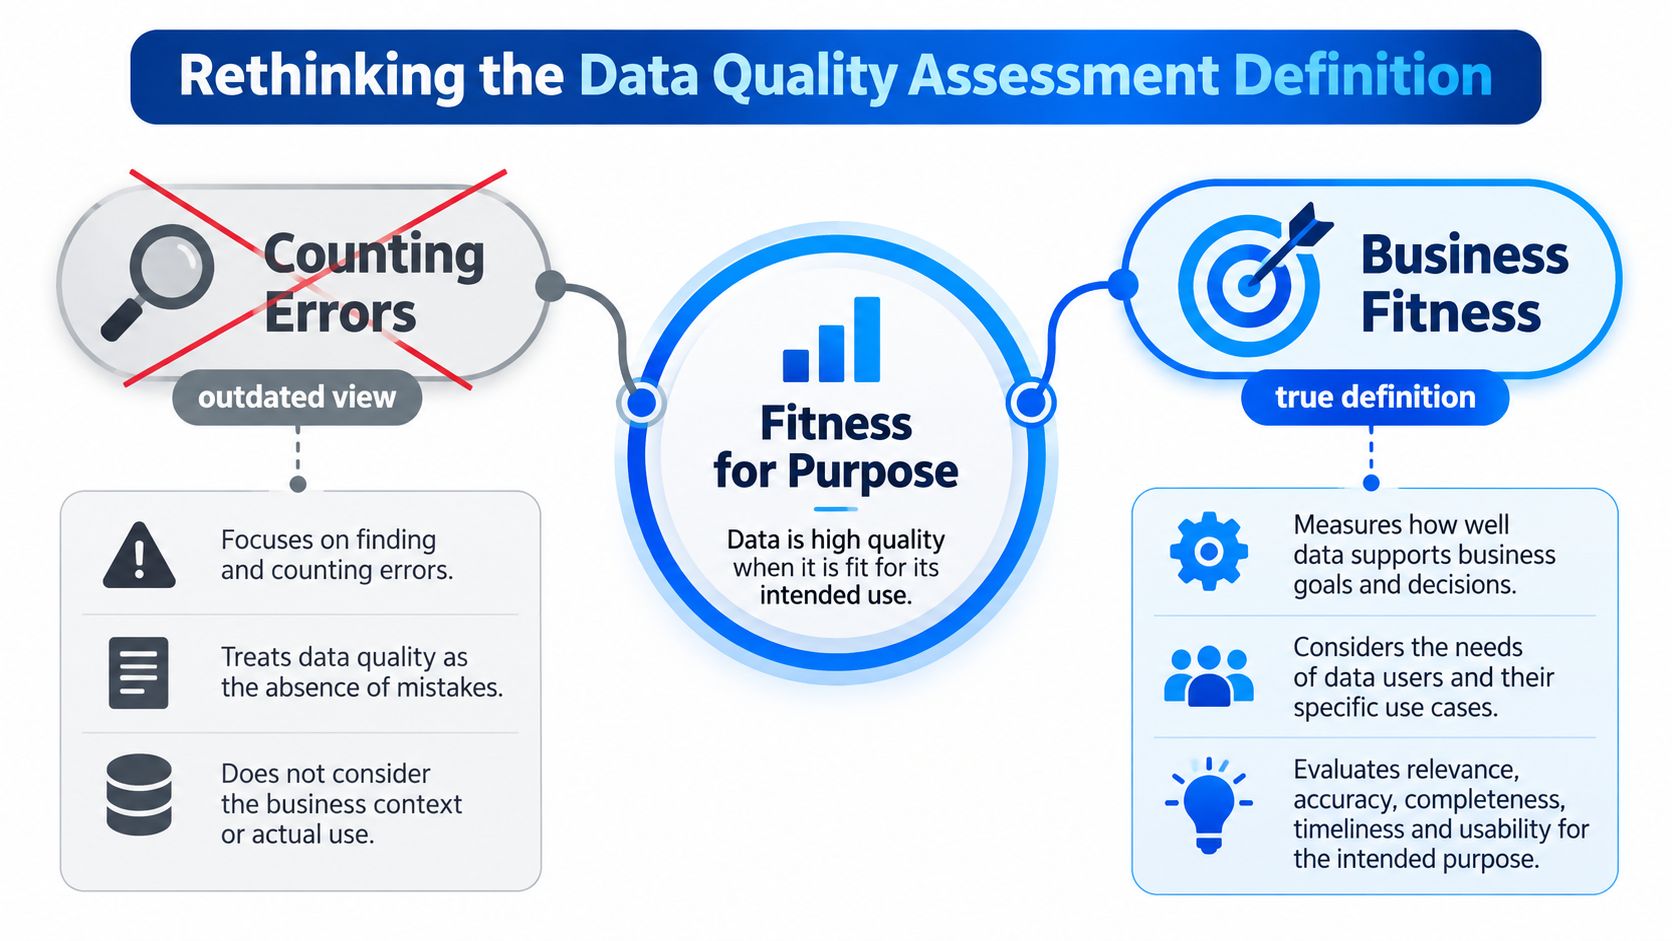
Czysty zbiór danych wciąż może dać niewiarygodny wynik. Ocena jakości danych to nie sprawdzanie, czy wartości zawierają błędy. To oparty na normach proces, który profiluje dane, mierzy wymiary istotne dla ich zastosowania i sprawdza, czy wynik służy celowi operacyjnemu, analitycznemu, regulacyjnemu lub związanemu z machine learningiem.
Poprawna technicznie tabela wciąż może zawieść na produkcji. Wczorajsze rekordy mogą być dokładne, ale docierać zbyt późno na potrzeby decyzji operacyjnej. Wypełnione pole może ukrywać brak pokrycia, ponieważ cały segment klientów nigdy nie trafił do zbioru danych. Dwa systemy mogą być wewnętrznie spójne, a jednocześnie nadawać różne znaczenie pojęciu „aktywny klient”. W analityce i AI takie konflikty semantyczne mogą tworzyć cechy (features), które wyglądają spójnie, lecz reprezentują różne pojęcia biznesowe.
Szersze podejście oparte na przydatności do użycia (fitness for use) pojawiło się w akademickich badaniach nad jakością danych w latach 90. Wang i Strong zdefiniowali w 1996 roku jakość danych jako „fitness for use”, przesuwając uwagę z liczby błędów na potrzeby konsumentów danych, co dokumentuje ten przegląd historii oceny jakości danych.
Dlaczego jeden wynik nie wystarczy
Pojedynczy wskaźnik dokładności nie pokaże, czy definicje, lineage, aktualność i pokrycie populacji wspierają decyzję. Powtarzalna ocena wiąże każdy pomiar z udokumentowanym celem i wskazuje ryzyka istotne dla danego zastosowania.
Zastosowanie operacyjne: Czy pipeline dostarcza użyteczne dane wtedy, gdy potrzebują ich procesy downstream?
Zastosowanie analityczne: Czy definicje, złączenia i pokrycie pozwalają na wniosek, którego da się bronić?
Zastosowanie regulacyjne: Czy organizacja potrafi wyjaśnić źródło, kontrole, transformacje i dowody stojące za wynikiem?
Zastosowanie AI: Czy dane treningowe i cechy reprezentują zamierzone pojęcia biznesowe na tyle spójnie, by umożliwić ewaluację i wdrożenie?
Statistics Canada opisuje jakość w swoim Data Quality Toolkit poprzez cechy takie jak trafność, pokrycie, szczegółowość, dokładność, wiarygodność, standaryzacja, aktualność, terminowość, odtwarzalność i zaufanie. Ten zakres pokazuje, dlaczego ocena jest mechanizmem kontroli operacyjnej, a nie jednorazowym werdyktem. Schematy, źródła, definicje, użytkownicy i wymagania się zmieniają, więc kontrole i odpowiedzialność muszą zmieniać się razem z nimi.
Szersze wprowadzenie znajdziesz w przewodniku o tym, czym jest jakość danych. W praktyce chodzi o to, czy właściwi użytkownicy mogą polegać na danych przy konkretnej decyzji i czy organizacja potrafi pokazać, dlaczego.
Pięć podstawowych wymiarów jakości danych
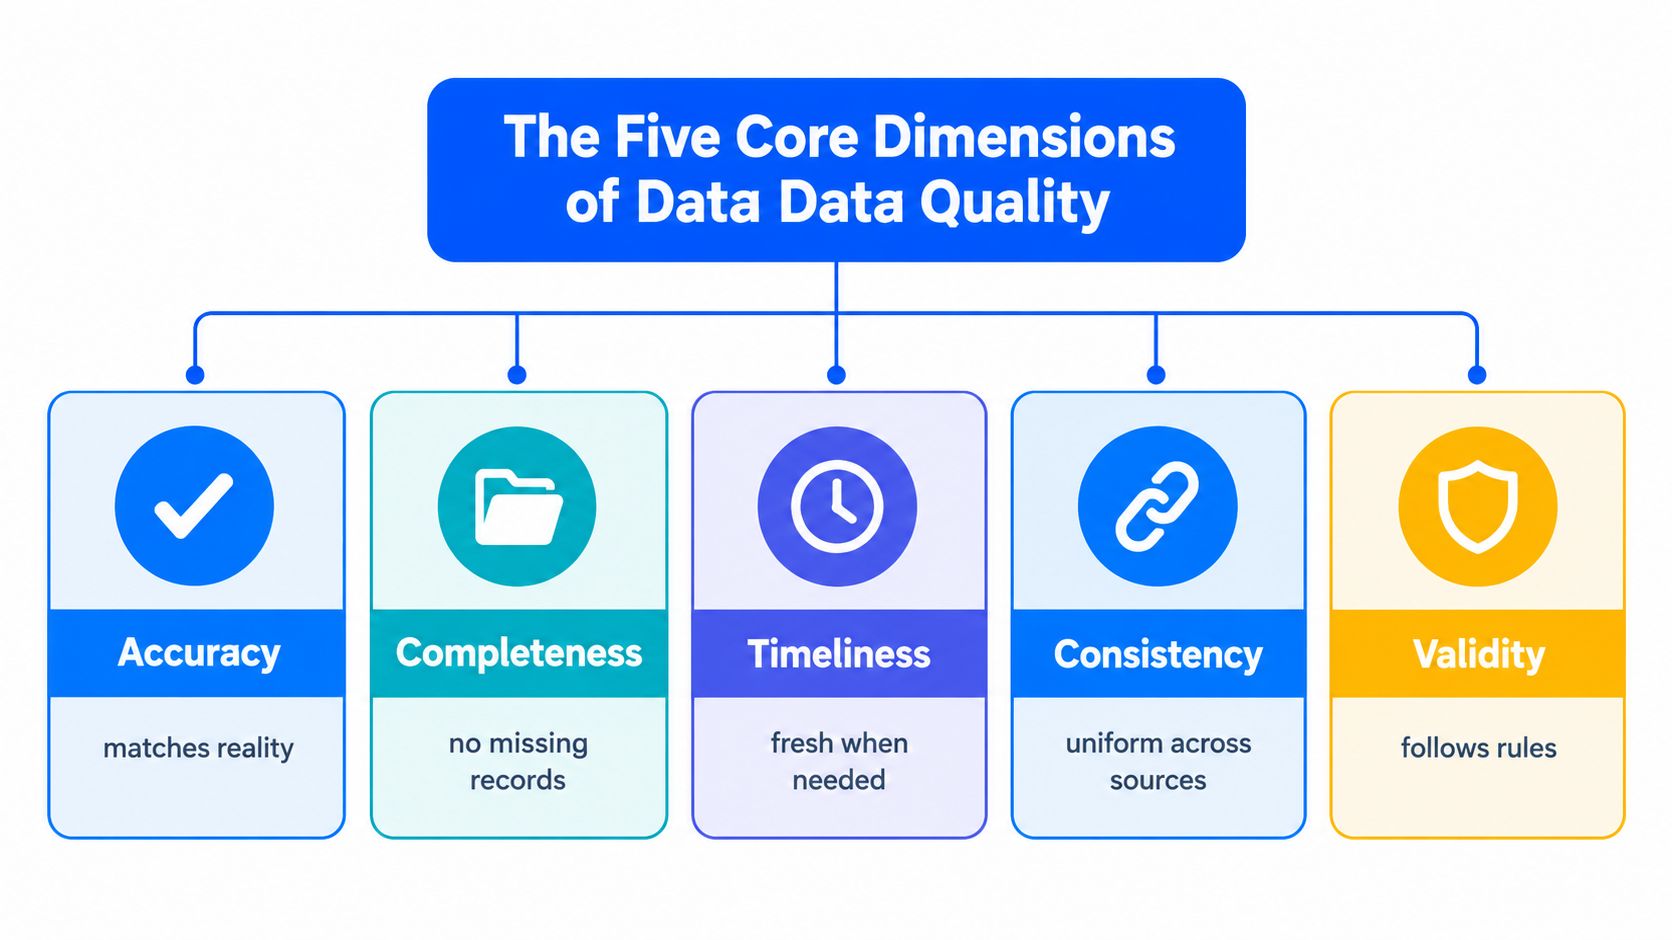
Użyteczna ocena wymaga niewielkiego zestawu wymiarów, które zespoły mogą wielokrotnie mierzyć i interpretować w kontekście. Te wymiary ujawniają różne tryby awarii. Zbiór danych może przejść kontrole formatu, a mimo to pozostać niewiarygodny dla analityki lub machine learningu, jeśli jego wartości niosą niewłaściwe znaczenie biznesowe. Wykorzystaj ten przegląd wymiarów jakości danych jako model pomiaru, a następnie dopasuj reguły do konkretnego zastosowania.
Dokładność określa, czy dane odzwierciedlają rzeczywistość lub autorytatywne źródło. Data może mieć wymagany format i mimo to być błędna. Kontrole produkcyjne mogą porównywać rekordy z systemami źródłowymi, danymi referencyjnymi, sumami uzgodnieniowymi lub zatwierdzonymi faktami biznesowymi. W machine learningu niedokładne etykiety lub cechy mogą dać model, który działa stabilnie, ale na błędnych danych wejściowych.
Kompletność określa, czy wymagane rekordy i atrybuty są obecne. Odróżnij dopuszczalną wartość null od brakującej wartości, która blokuje proces, analizę lub cechę modelu. Liczy się także pokrycie. Sprawdzaj systemy, populacje i odpowiednie okresy, zamiast oceniać kompletność wyłącznie na podstawie wypełnionych kolumn.
Aktualność mierzy, czy dane docierają wystarczająco świeże dla zamierzonego zastosowania. Raport miesięczny, alert operacyjny i cecha modelu mogą mieć różne wymagania co do świeżości. Zdefiniuj akceptowalne okna dostawy i oceń skutki opóźnienia, zamiast traktować każde opóźnienie jako równie poważne.
Spójność sprawdza, czy równoważne wartości, relacje i definicje są zgodne między systemami i transformacjami. Obejmuje formaty i kody, ale ujawnia też konflikty semantyczne. Dwa działy mogą obliczać ten sam wskaźnik inaczej, przez co dane wyglądają na czyste, ale nie pozwalają na wiarygodne porównanie ani zbudowanie zbioru treningowego.
Poprawność sprawdza, czy wartości są zgodne z zadeklarowanymi regułami, formatami, listami referencyjnymi i oczekiwaniami strukturalnymi. Reguła może potwierdzić, że status należy do zatwierdzonego zbioru. Reguły międzypolowe sprawdzają, czy powiązane atrybuty mają razem sens biznesowy, co wychwytuje błędy pomijane przez walidację na poziomie kolumn.
Dodaj identyfikowalność do modelu
Lineage nie jest osobnym filarem w modelu wizualnym, ale zespoły produkcyjne potrzebują go do interpretacji każdego wyniku. Gdy reguła nie przechodzi, inżynierowie powinni móc wskazać dotknięte źródło, transformację, tabelę, raport lub model. Bez tej ścieżki wynik opisuje objaw, nie pokazując, gdzie należy podjąć działania naprawcze.
Wytyczne związane z ISO rozróżniają jakość syntaktyczną, jakość semantyczną i jakość pragmatyczną. Składnia obejmuje zadeklarowaną strukturę, semantyka zamierzone znaczenie, a pragmatyka cel użytkownika, co wyjaśnia ten przegląd pojęć jakości w ISO 8000. To rozróżnienie chroni zespoły przed traktowaniem technicznie czystych danych jako automatycznie odpowiednich dla analityki lub AI.
Każdy wymiar potrzebuje właściciela, reguły lub metryki, akceptowalnego progu i ścieżki eskalacji. Ciągłe kontrole sprawiają, że te mechanizmy prowadzą do konkretnych działań, zamiast zostawiać model w formie listy kontrolnej.
Kontekst historyczny i normy
Definicja oceny jakości danych kształtowała się etapami. Prace akademickie z lat 90. poszerzyły pojęcie jakości z prostej poprawności do przydatności do użycia. Potem nastąpiła formalna standaryzacja: ISO opublikowała normę jakości danych w 2011 roku, o czym wspomina przywołany wcześniej przegląd historyczny. Ta zmiana nadal ma znaczenie, ponieważ wartość może być starannie sformatowana i technicznie poprawna, a jednocześnie nieść niewłaściwe znaczenie biznesowe dla analityka lub modelu machine learningu.
MFW opracował swój Data Quality Assessment Framework po dyskusji Rady Wykonawczej w grudniu 1997 roku. Dokument przedstawiono w lipcu 2001 roku, a ramy zostały publicznie opisane w 2003 roku. Ich struktura obejmuje sześć części, zaczynając od warunków wstępnych jakości, a następnie badając pięć kolejnych wymiarów. Data Quality Assessment Framework MFW oddziela warunki umożliwiające, w tym nadzór i rozwiązania instytucjonalne, od jakości produktów i procesów statystycznych.
Ten podział ujawnia częsty problem w przedsiębiorstwach. Zespół może wytwarzać poprawne technicznie rekordy w nieudokumentowanym procesie albo utrzymywać formalny nadzór nad danymi, podczas gdy same dane pozostają niekompletne. Żaden z tych wyników nie jest wiarygodny dla raportowania, prognozowania czy trenowania AI. Ocena powinna więc badać odpowiedzialność, warunki prawne, dokumentację, dojrzałość procesów i znaczenie przypisane każdemu polu, a nie tylko przechowywane wartości.
Norma ISO dotycząca profilowania danych traktuje profilowanie jako podstawę oceny. Profilowanie dostarcza analizę kolumn i statystyki zbioru danych, ale inżynierowie nadal muszą odnieść te obserwacje do wymagań biznesowych i wymiarów jakości. ISO 8000-61 łączy także zarządzanie jakością danych z dojrzałością procesów i organizacji.
Normy zamieniają opinie w dowody
Normy nie eliminują osądu. Czynią go jawnym i powtarzalnym. Zespół działający w środowisku regulowanym może udokumentować, dlaczego istnieje dany próg aktualności, które rekordy są objęte zakresem, jak obliczane jest niepowodzenie i kto akceptuje ryzyko rezydualne.
Taki ślad audytowy sprawia, że wytyczne rządowe przydają się także w sektorze komercyjnym. Podejście EPA przedstawia ocenę jakości danych jako naukową i statystyczną ewaluację tego, czy dane mają właściwy typ, jakość i ilość dla zamierzonego zastosowania. Ta sama zasada dotyczy finansów, ochrony zdrowia i analityki w sektorze publicznym.
Zespoły szukające szerszego kontekstu zarządzania danymi mogą połączyć normy z wytycznymi DAMA DMBOK. Praktyczny test jest prosty: ramy zasługują na swoje miejsce, gdy inżynierowie i właściciele danych mogą dzięki nim podejmować spójne decyzje dotyczące ryzyka semantycznego, przydatności modeli i działań naprawczych.
Ryzyka operacyjne słabej oceny
Słaba ocena rzadko kończy się wyraźnym czerwonym ostrzeżeniem. Częściej pipeline technicznie kończy się sukcesem, a jednocześnie dostarcza dane, które nie wspierają już powiązanej z nimi decyzji.
Nieaktualny dashboard to problem z aktualnością. Przemianowana kolumna źródłowa, która przechodzi przez niemonitorowaną transformację, to problem ze schematem i lineage. Raport łączący dwie poprawne, ale inaczej zdefiniowane miary to problem spójności i semantyki. Każdy z tych problemów może pozostać niewidoczny, jeśli zespoły monitorują tylko wartości null, formaty lub poprawność na poziomie wierszy.
Co psuje się najpierw
Widoczny incydent często pojawia się dopiero dalej w przepływie danych niż sam defekt jakości:
Dashboardy tracą wiarygodność: analitycy znajdują sprzeczne liczby i zaczynają ręcznie uzgadniać eksporty.
Pipeline'y ukrywają opóźnienia: status udanego joba może zatuszować plik, który dotarł późno lub zawierał tylko część danych.
Schematy zmieniają się bez ostrzeżenia: dodane, usunięte lub zmienione typem kolumny mogą zmienić zachowanie procesów downstream bez żadnego błędu aplikacji.
Modele dziedziczą niejednoznaczność: workflow machine learningu może traktować sprzeczne definicje jako porównywalne cechy, bo wartości wyglądają na strukturalnie poprawne.
Naprawa zwalnia: bez lineage i jasnej odpowiedzialności zespoły dyskutują, gdzie zaczął się problem, zamiast naprawić odpowiedzialny proces.
Koszt nie ogranicza się do poprawek. Użytkownicy mogą przestać ufać zarządzanym zbiorom danych i tworzyć prywatne arkusze kalkulacyjne lub równoległe zapytania. Inżynierowie muszą wtedy obsługiwać kilka nieoficjalnych wersji tego samego wskaźnika, co utrudnia przyszłe oceny.
Praktyczna zasada: oceniaj tryby awarii, które mogą unieważnić decyzję, a nie tylko defekty, które najłatwiej policzyć.
Ciągła ocena odpowiada na tę rzeczywistość operacyjną. Zespoły mogą profilować dane podczas onboardingu, ale monitoring produkcyjny powinien w czasie śledzić zachowanie dostaw, rozkłady, zmiany strukturalne, wyniki walidacji i wskaźniki biznesowe. Celem nie jest wyeliminowanie każdej anomalii. Chodzi o wczesne wykrywanie istotnych zmian, powiązanie ich z dotkniętymi konsumentami i dostarczenie właścicielowi wystarczających dowodów do działania.
Ręczne reguły a ciągła obserwowalność
Ręcznie pisane reguły nadal mają swoje miejsce. Sprawdzają się, gdy wymaganie jest jednoznaczne, stabilne i ważne z prawnego lub operacyjnego punktu widzenia. Pole obowiązkowe, zatwierdzony kod statusu czy warunek integralności referencyjnej powinny pozostać deterministyczne, bo organizacja potrzebuje jasnej decyzji: zaliczone albo niezaliczone.
Problem zaczyna się, gdy zespoły używają ręcznych reguł do każdego możliwego wzorca. Biblioteki reguł rosną szybciej, niż ich właściciele są w stanie je przeglądać, a reguła sensowna dla zeszłorocznego schematu może po migracji stracić znaczenie. Statyczne kontrole zwykle wykrywają też znane defekty, pomijając nietypowe, ale poprawne zmiany wolumenu, czasu, rozkładu czy zachowania.
Podejście do oceny | Skalowalność | Utrzymanie | Zdolność wykrywania |
|---|---|---|---|
Ręczne reguły deterministyczne | Mocne przy ukierunkowanych, dobrze zdefiniowanych kontrolach | Wymaga właściciela, przeglądów i aktualizacji wraz ze zmianą wymagań | Skuteczne dla znanych warunków i ograniczeń biznesowych |
Okresowe profilowanie | Przydatne do rozpoznania nieznanych zbiorów danych | Niska ciągłość operacyjna między ocenami | Wykrywa wzorce, wartości null, rozkłady i wartości odstające w momencie przeglądu |
Ciągła obserwowalność | Skaluje się na zmieniające się pipeline'y, gdy baseline'y i odpowiedzialność są zarządzane | Wymaga strojenia, triage'u incydentów i dyscypliny w nadzorze | Wykrywa odchylenia w zachowaniu, aktualności, strukturze i trendach jakości |
Ocena hybrydowa | Łączy szeroki monitoring z precyzyjnymi kontrolami | Równoważy utrzymanie między typami reguł | Obejmuje zarówno jawne wymagania, jak i wcześniej nieznane anomalie |
Jak dobrać właściwe proporcje
Ręczne reguły są właściwe, gdy biznes potrafi precyzyjnie sformułować wymaganie i wyjaśnić, dlaczego jego naruszenie ma znaczenie. Ciągłe wykrywanie jest bardziej przydatne dla zachowań, które naturalnie się zmieniają, takich jak czas dostaw czy rozkłady w zbiorach danych. Metody statystyczne i machine learning mogą ustalić oczekiwane wzorce, ale nie zastępują kontekstu biznesowego. Nietypowy wynik może być defektem, uzasadnioną zmianą sezonową albo planowaną zmianą.
Na produkcji najlepiej sprawdza się zwykle połączenie deterministycznej walidacji i adaptacyjnego monitoringu. Walidacja egzekwuje to, co zawsze musi być prawdą. Monitoring wychwytuje zmiany, o których zakodowaniu nikt wcześniej nie pomyślał.
Zespoły analizujące ten kompromis mogą też zapoznać się z dyskusją o ręcznie utrzymywanych technicznych regułach jakości danych. Ważna decyzja projektowa nie dotyczy tego, czy wygrywają reguły, czy obserwowalność. Chodzi o to, które dowody wymagają stałej polityki, a które zachowania zasługują na ciągłe porównywanie ze zmieniającym się baseline'em.
Przeprowadzanie oceny jakości danych
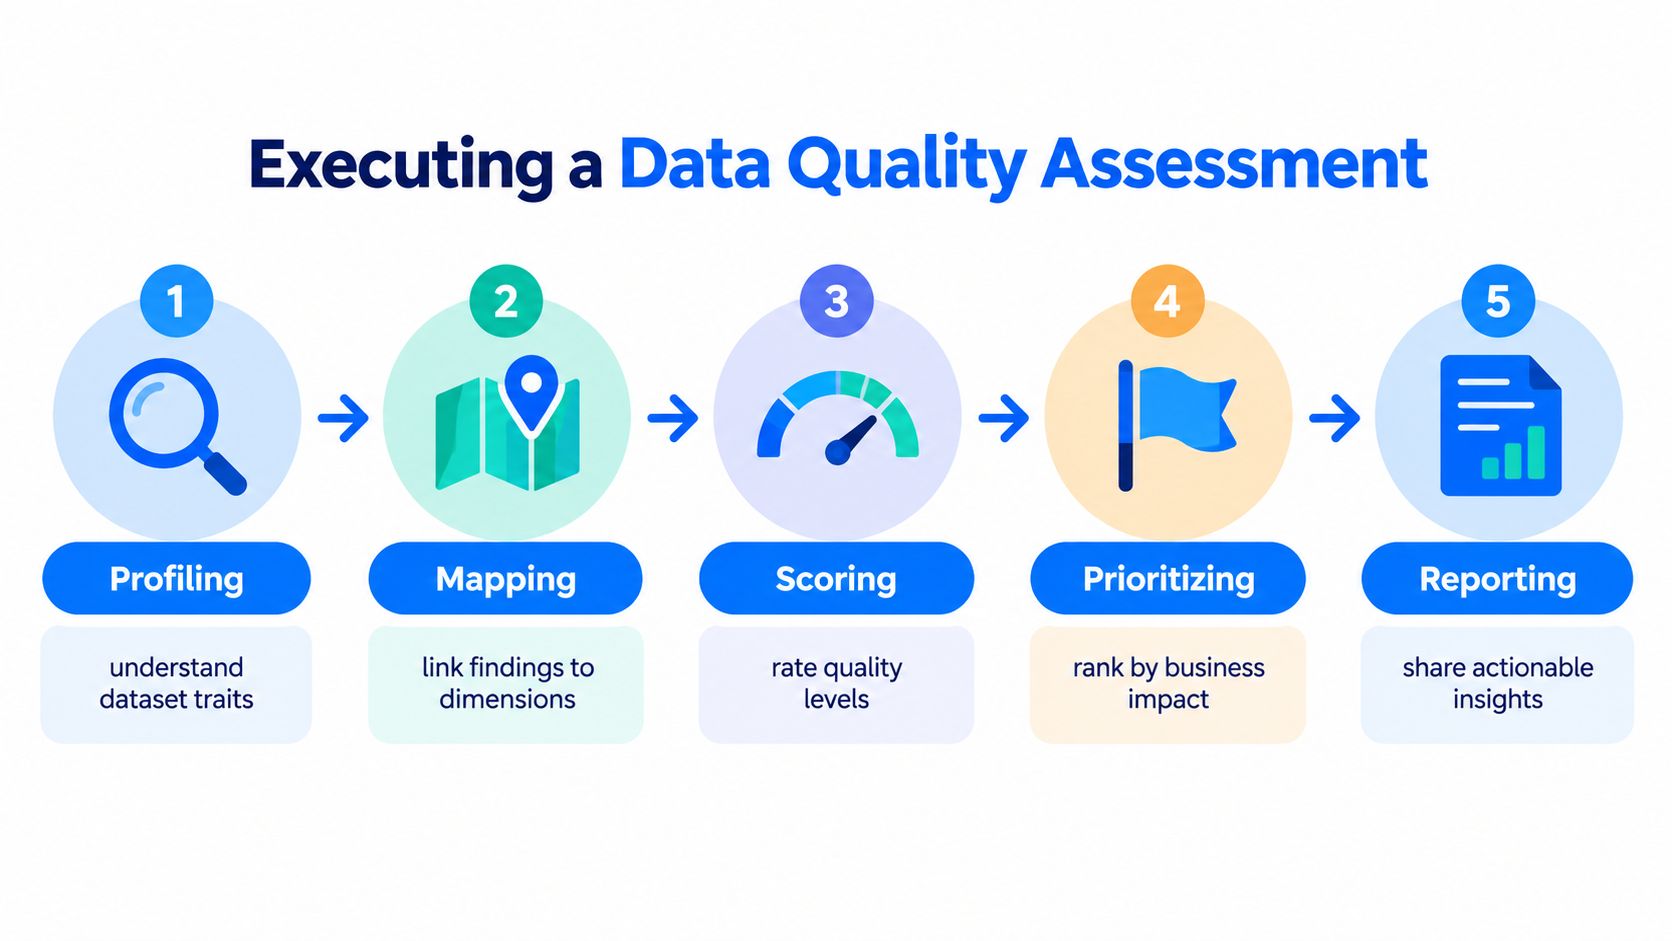
Użyteczna ocena zamienia obserwacje w decyzje. Poniższy workflow utrzymuje powiązanie między profilowaniem, pomiarem, kontekstem biznesowym i działaniami naprawczymi.
Zacznij od profilowania
Najpierw zbadaj strukturę i zachowanie zbioru danych. Zapisz kolumny, typy, wzorce wartości, wartości null, unikalność, rozkłady, relacje, historię dostaw i dostępne metadane. Profilowanie to rozpoznanie, a nie ostateczna ocena. Mówi, co wydaje się dziać, ale nie rozstrzyga, czy dany wzorzec jest akceptowalny.
Odnieś ustalenia do zamierzonego zastosowania
Następnie zidentyfikuj konsumentów i decyzję, którą wspierają dane. Przypisz każde ustalenie do wymiarów takich jak dokładność, kompletność, aktualność, spójność, poprawność i lineage. Potem zapisz wymagania semantyczne, których techniczne profilowanie nie jest w stanie wywnioskować, w tym definicje biznesowe, zakres, odpowiedzialność i autorytatywne źródło.
Brakująca wartość może być akceptowalna w jednym workflow i dyskwalifikująca w innym. Zmiana rozkładu może oznaczać dryf danych albo odzwierciedlać uzasadnione zdarzenie biznesowe. O interpretacji decyduje kontekst.
Zdefiniuj progi
Ustal mierzalne oczekiwania dla każdego zbioru danych, zamiast stosować domyślne wartości dla całej organizacji. Przydatne kontrole obejmują pola wymagane i opcjonalne, akceptowalne odsetki wartości null, limity aktualności, wykrywanie zmian schematu, oczekiwane wolumeny wierszy, dozwolone wartości i warunki uzgodnień. Wytyczne jakości oparte na normach kładą nacisk na jawne wymiary i udokumentowane wymagania, dzięki czemu wyniki są bardziej powtarzalne.
Weryfikuj i priorytetyzuj
Stosuj reguły biznesowe na poziomie rekordów równolegle z monitoringiem na poziomie zbiorów danych. Następnie uszereguj niepowodzenia według wpływu biznesowego, dotkniętych konsumentów, ekspozycji regulacyjnej i nakładu pracy na naprawę. Niewielki defekt w krytycznym polu regulacyjnym może wymagać szybszej reakcji niż większy defekt w nieużywanym atrybucie.
Ten model pomiaru zorientowany na sektor publiczny podsuwa praktyczny wzorzec: zidentyfikuj asercje powiązane z politykami, połącz je z wpływem biznesowym, skategoryzuj wady, określ ilościowo ich wpływ na zgodność i raportuj wyniki w formacie umożliwiającym drill-down.
Raportuj i wbuduj w procesy
Na koniec opublikuj wynik wraz z dowodami, właścicielami, dotkniętymi zasobami i kolejnym krokiem. Wbuduj kontrole w pipeline lub warstwę obserwowalności, aby ta sama ocena uruchamiała się przy każdej zmianie danych, a nie tylko wtedy, gdy ktoś przypomni sobie o audycie.
Praktyczny proces audytu jakości danych powinien zachowywać historię. Śledź wyniki w czasie, rejestruj zaakceptowane wyjątki i weryfikuj działania naprawcze. Bez historycznych dowodów zespoły nie odróżnią nowego incydentu od powracającej wady.
Studium przypadku - transformacja jakości danych w ITSV
ITSV, informatyczny filar austriackiego systemu ubezpieczeń społecznych, zmagało się z obciążeniem związanym z utrzymaniem dużego zbioru ręcznie tworzonych reguł jakości. Organizacja zastąpiła 9 000 ręcznie utworzonych reguł modułami digna Data Anomalies i Data Timeliness, przechodząc od modelu opartego głównie na utrzymywaniu reguł do ciągłej obserwowalności.
Wartość tej zmiany nie polegała wyłącznie na mniejszej liczbie reguł. ITSV potrzebowało podejścia do monitoringu, które skaluje się wraz ze środowiskiem danych i nie wymaga od specjalistów pamiętania każdego oczekiwanego wzorca. Ciągłe wykrywanie anomalii pomogło ograniczyć szum alertów, a monitoring aktualności skupił uwagę na tym, czy dane docierają zgodnie z oczekiwanym zachowaniem operacyjnym.

Czego uczy ten przykład
Ta transformacja ilustruje trzy praktyczne lekcje:
Liczba reguł to nie dojrzałość jakości: tysiące kontroli mogą generować duże obciążenie utrzymaniowe, nie obejmując dryfu semantycznego ani nieoczekiwanych zachowań.
Adaptacyjny monitoring chroni uwagę: ograniczenie zbędnych alertów daje inżynierom więcej czasu na badanie istotnych zmian.
Wiedza powinna być w systemie: proces monitoringu oparty na pamięci poszczególnych osób staje się kruchy, gdy ludzie zmieniają role lub odchodzą.
Przykład ITSV nie oznacza, że reguły deterministyczne są przestarzałe. Krytyczne wymagania biznesowe nadal potrzebują jawnej walidacji. Pokazuje natomiast, dlaczego zespoły zyskują, łącząc te kontrole z monitoringiem, który uczy się normalnego zachowania zbiorów danych i zgłasza odchylenia do weryfikacji.
Najsilniejszy model operacyjny przypisuje też odpowiedzialność po wykryciu problemu. Anomalia bez kontekstu, lineage i właściciela staje się kolejnym zgłoszeniem w backlogu. Anomalia powiązana z dotkniętym procesem i jasno wskazanym decydentem może stać się kontrolowanym procesem naprawczym.
Wdrożenie w przedsiębiorstwie: na co zwrócić uwagę
Wdrożenie w przedsiębiorstwie się udaje, gdy architektura oceny respektuje bezpieczeństwo, zarządzanie danymi i dotychczasowy sposób pracy zespołów. Przenoszenie danych do osobnej usługi monitoringu może tworzyć niepotrzebną ekspozycję, duplikację i tarcia przy zatwierdzaniu. Wykonywanie in-database utrzymuje obliczanie i analizę metryk w bazach danych klienta, więc dane pozostają na miejscu, a zespoły nadal otrzymują dowody jakości.
Równie ważna jest elastyczność wdrożenia. Instalacja w chmurze prywatnej lub on-premises sprawdza się w organizacjach, które potrzebują kontroli we własnej chmurze, wirtualnej chmurze prywatnej (VPC) lub centrum danych. Właściwy wybór zależy od polityki bezpieczeństwa, architektury sieci, odpowiedzialności operacyjnej i tego, jak szybko platforma musi połączyć się z istniejącymi hurtowniami danych i pipeline'ami.
Projektuj z myślą o współodpowiedzialności
Data engineer potrzebuje szczegółów incydentu i lineage. Analytics engineer musi rozumieć zachowanie metryk. Interesariusz biznesowy potrzebuje jasnego statusu i opisu wpływu. Dashboard zorientowany na użytkownika powinien obsłużyć wszystkie trzy grupy, nie zmuszając żadnej z nich do budowania własnej interpretacji.
Szukaj wdrożenia, które od początku obejmuje podstawy operacyjne:
Obliczenia in-database: dane źródłowe pozostają w środowisku kontrolowanym przez klienta.
Modułowe wdrażanie: zacznij od funkcji, która adresuje najpilniejsze ryzyko, a potem rozszerzaj zakres, gdy dojrzewają odpowiedzialność i pomiar.
Zintegrowany harmonogram: uruchamiaj oceny konsekwentnie, zamiast polegać na skryptach ad hoc.
Katalog i współpraca: łącz ustalenia z zasobami, właścicielami, incydentami i decyzjami.
Przejrzysta logika handlowa: zrozum, jak aktywne tabele, moduły, środowiska i wsparcie wpływają na model kosztów.
Monitoring oparty na AI może ograniczyć ręczne utrzymanie, ale nadal wymaga nadzoru. Zespoły muszą przeglądać baseline'y, wyjaśniać wyjątki, chronić dane wrażliwe i decydować, które ustalenia blokują dalsze wykorzystanie danych. Automatyzacja powinna eliminować powtarzalną pracę związaną z wykrywaniem i kierowaniem zgłoszeń, a nie odpowiedzialność.
Najlepsze wdrożenie nie jest więc ani gigantycznym projektem pisania reguł, ani nieprzejrzystą warstwą machine learningu. To kontrolowany system, który łączy jawne reguły biznesowe, adaptacyjne wykrywanie anomalii, lineage, monitoring aktualności, świadomość schematów i widoczną odpowiedzialność.
digna to platforma jakości danych i obserwowalności dla przedsiębiorstw, działająca w środowisku klienta, z wykrywaniem anomalii, monitoringiem aktualności, walidacją na poziomie rekordów, śledzeniem schematów, wykonywaniem in-database i wspólnymi dashboardami dla zespołów danych i interesariuszy. Odwiedź stronę digna, aby sprawdzić, jak ciągła ocena może zwiększyć wiarygodność danych dla analityki i AI.
Reguły obejmują awarie, które da się przewidzieć. Te nieprzewidywalne wychwytuje digna Data Anomalies: moduł uczy się normalnego wolumenu, rozkładu i zachowania każdej tabeli i zgłasza odchylenia, których nie przewidziała żadna ręcznie napisana reguła.
Najczęściej zadawane pytania
Czym jest ocena jakości danych?
Ocena jakości danych to oparty na normach proces, który profiluje dane, mierzy wymiary istotne dla ich zastosowania i sprawdza, czy służą one celowi operacyjnemu, analitycznemu, regulacyjnemu lub związanemu z machine learningiem. Wykracza poza liczenie błędów, ponieważ technicznie poprawna tabela wciąż może dotrzeć zbyt późno lub nieść niewłaściwe znaczenie biznesowe.
Jakie są wymiary oceny jakości danych?
Artykuł opiera się na pięciu podstawowych wymiarach: dokładności, kompletności, aktualności, spójności i poprawności, uzupełnionych o lineage dla identyfikowalności. Lineage nie jest osobnym filarem, ale pozwala inżynierom prześledzić niezaliczoną regułę aż do dotkniętego źródła, transformacji, tabeli, raportu lub modelu, dzięki czemu działania naprawcze trafiają we właściwe miejsce.
Kto zdefiniował jakość danych jako przydatność do użycia?
Wang i Strong zdefiniowali w 1996 roku jakość danych jako przydatność do użycia (fitness for use), przesuwając uwagę z liczby błędów na potrzeby konsumentów danych. Formalna standaryzacja nastąpiła, gdy ISO opublikowała normę jakości danych w 2011 roku, a MFW publicznie opisał swój sześcioczęściowy Data Quality Assessment Framework w 2003 roku.
Jak krok po kroku przeprowadzić ocenę jakości danych?
Zacznij od profilowania struktury, wartości null, rozkładów i historii dostaw, a następnie odnieś ustalenia do zamierzonego zastosowania i jego konsumentów. Potem ustal progi dla poszczególnych zbiorów danych, takie jak limity aktualności i akceptowalne odsetki wartości null, uszereguj niepowodzenia według wpływu biznesowego, a na koniec wbuduj kontrole w pipeline, aby ocena uruchamiała się ponownie przy każdej zmianie danych.
Czy kontrole jakości danych powinny opierać się na ręcznych regułach, czy na automatycznym monitoringu?
Większość zespołów potrzebuje obu: reguł deterministycznych dla wymagań, które zawsze muszą być spełnione, oraz adaptacyjnego monitoringu dla zachowań, których nikt wcześniej nie zakodował. ITSV, informatyczny filar austriackiego systemu ubezpieczeń społecznych, zastąpiło 9 000 ręcznie tworzonych reguł modułami digna Data Anomalies i Data Timeliness, zachowując jawną walidację dla krytycznych wymagań biznesowych.



