Data Observability dla inżynierów danych: Praktyczny przewodnik
|
7
min. czyt.

Potok wsadowy (batch pipeline) może zakończyć się powodzeniem (na zielono), podczas gdy zasilany przez niego pulpit nawigacyjny już wyświetla błędne dane. Ładunek może zawierać tylko część oczekiwanych danych, system nadrzędny mógł dodać kolumnę zmieniającą transformację lub najnowsza partycja może być opóźniona o kilka godzin. Monitorowanie infrastruktury zgłasza pomyślne uruchomienie, podczas gdy analitycy i systemy uczenia maszynowego konsumują nieaktualne lub uszkodzone dane wyjściowe.
Ta luka to miejsce, w którym data observability dla inżynierów danych udowadnia swoją wartość. Bada ono zachowanie danych przepływających przez hurtownie, jeziora danych, strumienie i transformacje, a następnie łączy anomalie z odpowiedzialnością, wpływem i reakcją. Praktycznym wyzwaniem nie jest zbieranie każdego możliwego sygnału. Jest nim zbudowanie wystarczającego pokrycia, aby wyłapać istotne awarie bez wyprowadzania wrażliwych danych poza Twoje środowisko i bez zasypywania inżynierów alertami.
Spis treści
Dlaczego inżynierowie danych potrzebują Observability wykraczającego poza monitorowanie potoków
Systemy monitorowania a monitorowanie danych
Pięć filarów i ich praktyczna wartość
Instrumentacja czterech kluczowych SLI, których potrzebuje każdy potok
1. Wskaźnik sukcesu zadań
2. Opóźnienie świeżości (Freshness latency)
3. Kompletność i wolumen
4. Zgodność ze schematem
Rozwiązanie problemu zmęczenia alertami, które osłabia Observability
Projektowanie alertów wokół decyzji
Mierzenie jakości detekcji, a nie liczby powiadomień
Wdrażanie Observability w środowiskach regulowanych i lokalnych (On-Premises)
Sekwencja wdrożenia, która pomyślnie przejdzie weryfikację bezpieczeństwa
Heterogeniczne środowiska wymagają wspólnego kontraktu
Wybór właściwej strategii alertów dla Twojego stosu danych
Kiedy wygrywają proste reguły
Kiedy pomagają metody adaptacyjne
Integracja Observability z istniejącą architekturą potoków
Umieszczanie kontroli tam, gdzie odpowiadają one na pytania
Zaczynanie od małych kroków i skalowanie wdrożenia Observability
Dlaczego inżynierowie danych potrzebują Observability wykraczającego poza monitorowanie potoków
O godzinie 9:00 rano pulpit nawigacyjny orkiestracji pokazuje pomyślne wykonanie nocnego zadania. Zadanie w hurtowni danych zakończyło się, liczba prób ponowienia wynosiła zero, a klaster obliczeniowy pozostał sprawny. Późnym rankiem dział finansowy zauważa, że na pulpicie nawigacyjnym przychodów brakuje ostatnich transakcji. Model wytrenowany na tej samej tabeli również zaczął generować niestabilne wyniki.
Potok nie uległ awarii w konwencjonalnym sensie. Dostarczył częściową partycję i oznaczył pracę jako zakończoną. Połączenie (join) na dalszym etapie wykluczyło rekordy, a wynikowa tabela wyglądała na strukturalnie poprawną na tyle, by pulpity nawigacyjne mogły ją załadować. Tradycyjny monitoring widział sprawny system. Nie widział niewiarygodnych danych.
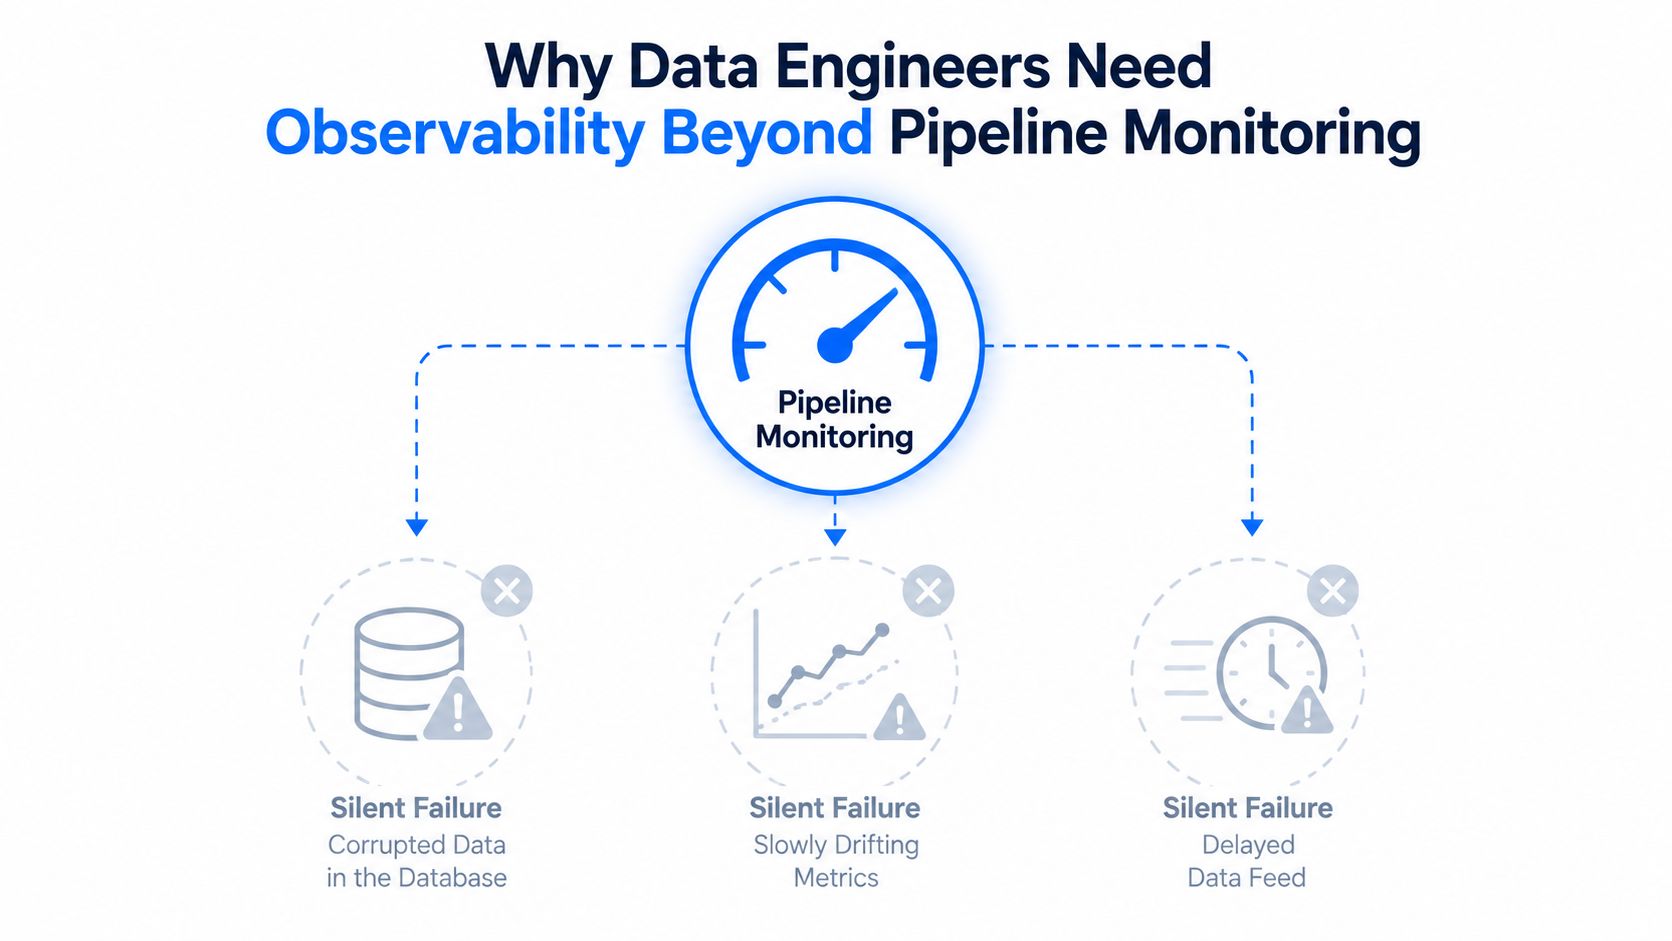
Systemy monitorowania a monitorowanie danych
Monitorowanie potoków nadal ma znaczenie. Wskaźnik sukcesu zadań, zachowanie ponownych prób, czas trwania zadań, kondycja wykonawców i wydajność infrastruktury pomagają inżynierom identyfikować awarie operacyjne. Jednak te sygnały odpowiadają na pytanie, czy proces się uruchomił, a nie czy wynik jest kompletny, terminowy, strukturalnie spójny lub zachowuje się normalnie.
Data Observability dodaje kontrolę samych danych. Łączy sygnały techniczne z kontekstem, takim jak pochodzenie danych (lineage), właściciele, zależności na dalszych etapach oraz krytyczność biznesowa. Różnica ta jest podobna do różnicy między sprawdzeniem, czy ciężarówka dostawcza opuściła magazyn, a sprawdzeniem, czy paczka zawiera właściwe przedmioty i dotarła zanim klient jej potrzebował.
Użytecznym punktem wyjścia jest digna comparison of data observability and data quality, ponieważ reguły jakości i observability rozwiązują powiązane, ale różne problemy. Testy deterministyczne wymuszają znane oczekiwania. Observability pomaga ujawnić nieoczekiwane zmiany, których nikt nie pomyślał zakodować jako test.
Pięć filarów i ich praktyczna wartość
Większość modeli Data Observability wykorzystuje pięć filarów: świeżość, dystrybucję, schemat, pochodzenie (lineage) i wolumen, jak opisano w Databricks' overview of data observability.
Świeżość wskazuje, czy dane dotarły zgodnie z oczekiwanym harmonogramem. Ma to największe znaczenie dla operacyjnych pulpitów nawigacyjnych, sprawozdawczości regulacyjnej i procesów zależnych od aktualnych rekordów.
Wolumen porównuje ilość danych z normalnym zachowaniem. Może ujawnić niekompletne ładowania, zduplikowane pobieranie, uszkodzone filtry i awarie systemów nadrzędnych.
Schemat śledzi kolumny, typy danych i zmiany strukturalne. Staje się krytyczny, gdy systemy źródłowe rozwijają się niezależnie od odbiorców w hurtowni danych.
Dystrybucja bada zachowanie wartości, w tym wzorce wartości null, zakresy, unikalność i inne cechy zestawu danych. Może wykryć semantycznie uszkodzone źródło, które nadal ma właściwe kolumny i liczbę wierszy.
Pochodzenie (lineage) łączy incydent z zasobami i zespołami, na które ma on wpływ. Bez tego inżynierowie tracą czas na reakcję, szukając właścicieli i zależności na dalszych etapach.
Regulowana hurtownia danych może traktować priorytetowo schemat i lineage, ponieważ niekontrolowana zmiana strukturalna może wpłynąć na dowody sprawozdawcze. Platforma streamingowa może kłaść nacisk na świeżość i dystrybucję, ponieważ opóźnione lub nietypowe zdarzenia mogą szybko zniekształcić decyzje operacyjne. Właściwa implementacja nie traktuje każdego filaru jednakowo. Zapewnia głębsze pokrycie produktów danych, których awaria niesie za sobą większy wpływ biznesowy lub Compliance.
W szerszym kontekście branżowym przydatny jest observability tag on ecommerce, aby zobaczyć, jak obawy o niezawodność pojawiają się poza inżynierią platformy core. Lekcja produkcyjna jest prosta: zachowaj monitorowanie infrastruktury, a następnie dodaj sygnały na poziomie danych wszędzie tam, gdzie zielony status potoku może nadal ukrywać złe wyniki.
Instrumentacja czterech kluczowych SLI, których potrzebuje każdy potok
Praktyczne wdrożenie observability można rozpocząć od czterech wskaźników poziomu usług (SLI) dla każdego krytycznego potoku: wskaźnika sukcesu zadań, opóźnienia świeżości (freshness latency), kompletności lub wolumenu oraz zgodności ze schematem. Sygnały te obejmują wykonanie, czas, ilość i strukturę, bez konieczności tworzenia skomplikowanego programu monitorowania od pierwszego dnia.
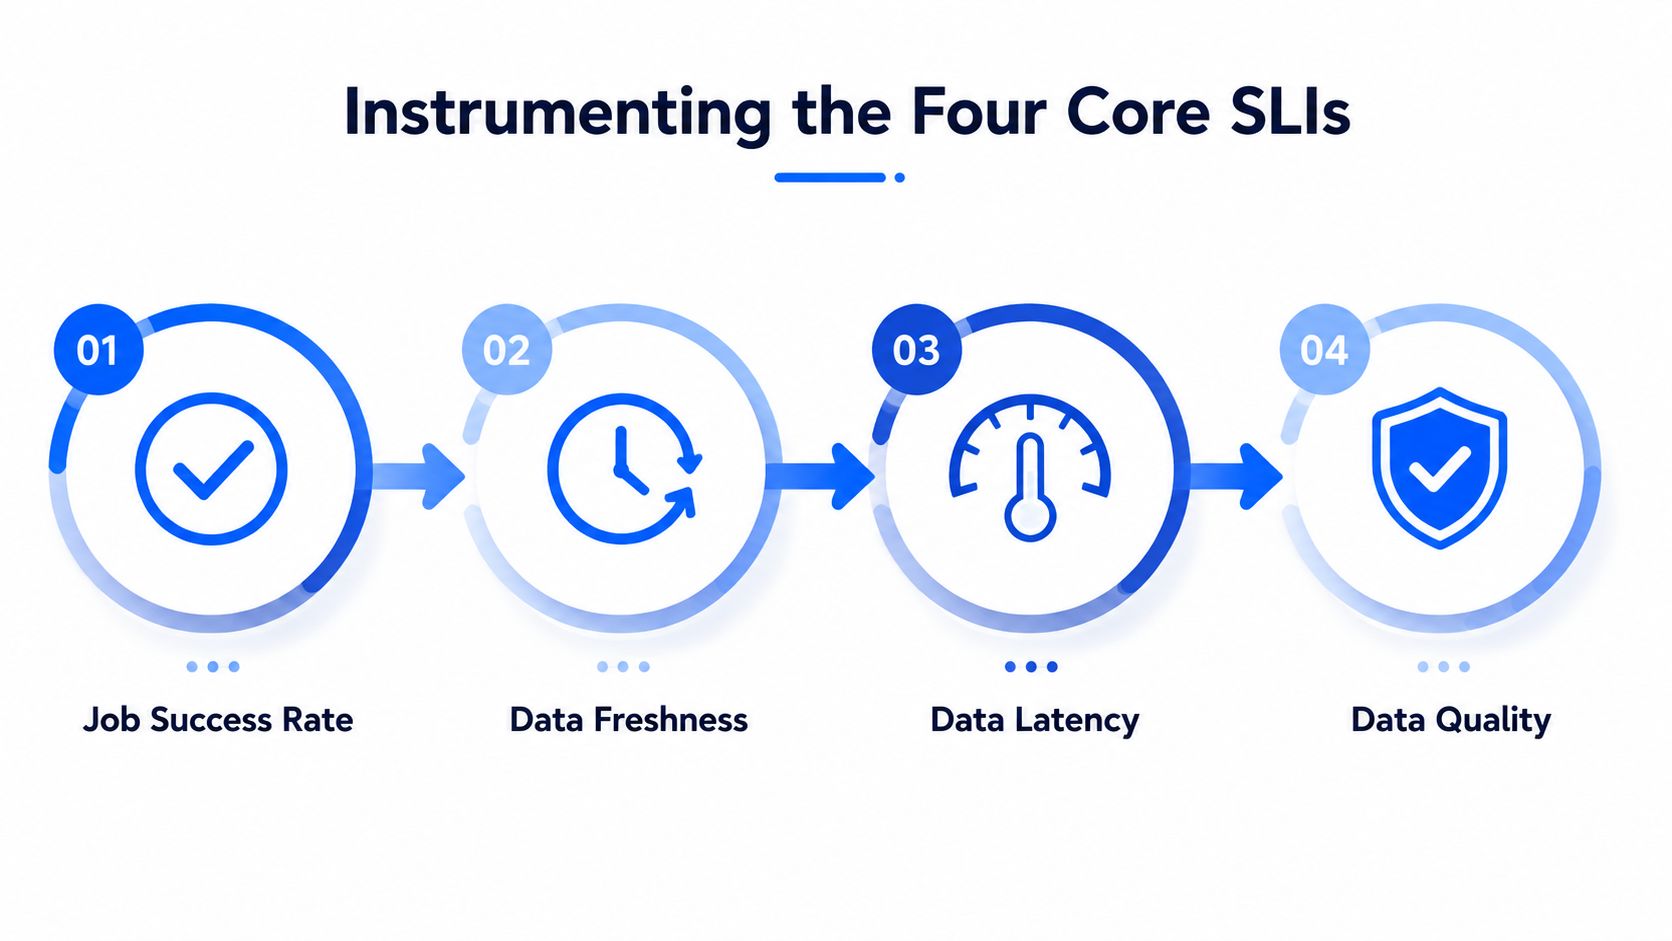
1. Wskaźnik sukcesu zadań
Śledź wykonania zakończone sukcesem, niepowodzeniem, ponowione, pominięte i te, które przekroczyły limit czasu. Prosty współczynnik sukcesu jest przydatny, ale nie poprzestawaj na statusie binarnym. Rejestruj ścieżkę wykonania, czas trwania, stan zależności oraz to, czy zadanie wygenerowało oczekiwany wynik.
W przypadku systemów wsadowych emituj zdarzenie zakończenia dopiero po zatwierdzeniu i zweryfikowaniu docelowej partycji. W przypadku systemów strumieniowych odróżniaj aktywność procesu od rzeczywistego postępu. Konsument może pozostać połączony, podczas gdy opóźnienie rośnie lub gromadzą się niepoprawnie sformułowane rekordy.
2. Opóźnienie świeżości (Freshness latency)
Świeżość mierzy czas od ostatniej pomyślnej aktualizacji lub opóźnienie między oczekiwanym a rzeczywistym dostarczeniem. W przypadku krytycznych zbiorów danych zespoły często wyrażają ten wskaźnik jako opóźnienie p95 lub p99, co zapobiega maskowaniu długiego ogona opóźnionych dostaw przez niewielką liczbę szybkich rekordów. Industry guidance on freshness monitoring również osadza tę kontrolę w kontekście oczekiwanego tempa pozyskiwania danych.
Potoki wsadowe powinny rejestrować zaplanowany czas, czas przybycia i czas pomyślnej dostępności. Systemy strumieniowe powinny śledzić oddzielnie opóźnienie czasu zdarzenia (event-time lag) i opóźnienie czasu pozyskania (ingestion-time lag), ponieważ aktywny konsument może nadal przetwarzać spóźnione zdarzenia.
Używaj zachowań historycznych jako kontekstu, zamiast stosować jeden uniwersalny próg. Praktyczny punkt odniesienia porównuje tę samą godzinę dnia w okresie ostatnich 2–4 tygodni, jak przedstawiono w Streamkap's guidance for streaming observability. W przypadku alertu krytycznego zalecanym statystycznym punktem wyjścia są 3 odchylenia standardowe od poziomu odniesienia, podczas gdy ostrzeżenie może wykorzystywać 2 odchylenia standardowe. Wartości te powinny znaleźć się w polityce uwzględniającej również zobowiązania dotyczące dostaw i konsekwencje na dalszych etapach.
3. Kompletność i wolumen
Porównuj oczekiwaną liczbę rekordów, partycji, plików lub okien zdarzeń z rzeczywistą. Dzienna partia może wymagać oczekiwanej partycji i minimalnego zakresu rekordów. Strumień może wymagać utrzymania przepustowości zdarzeń i unikania niewyjaśnionych luk w oknach czasowych.
Same liczby nie wystarczą. Połącz je z kontrolą duplikatów, monitorowaniem współczynnika wartości null i pokryciem partycji, aby zduplikowany ładunek nie wyglądał na kompletny. Anomalie wolumenu często pojawiają się zanim pulpit nawigacyjny widocznie się zepsuje, co czyni je cennymi wczesnymi wskaźnikami, a nie tylko diagnostyką po incydencie.
4. Zgodność ze schematem
Mierz procent wierszy, które przechodzą pomyślnie walidację strukturalną, a następnie śledź zmiany w nazwach kolumn, typach danych, dopuszczalności wartości null i zagnieżdżeniach. Dryf schematu (schema drift) obejmuje dodane kolumny, usunięte kolumny i zmiany typów danych, jak udokumentowano w Ataccama's explanation of schema tracking.
Utrzymuj kontrolę blisko granicy źródła i ponownie przed warstwami konsumpcji o wysokiej wartości. Takie umiejscowienie pomaga odróżnić zmianę kontraktu na wcześniejszym etapie od błędu transformacji. Przechowuj obserwowaną wersję schematu przy każdym uruchomieniu, aby osoby reagujące mogły porównać pierwszy błędny wynik ze zmianą, która go poprzedziła.
Praktyczna zasada: Najpierw punkt odniesienia (baseline), potem alert. Próg bez kontekstu historycznego albo pomija stopniowy dryf, albo generuje szum podczas normalnych cykli operacyjnych.
Dla zespołów precyzyjnie definiujących metryki dostarczania, ten przewodnik po data timeliness definitions and monitoring metrics dostarcza przydatnego słownictwa do rozróżniania opóźnień przybycia, przetwarzania i dostępności.
Rozwiązanie problemu zmęczenia alertami, które osłabia Observability
Większa liczba kontroli może pogorszyć niezawodność, gdy nikt nie ufa powiadomieniom. Raport na temat observability w przedsiębiorstwach z 2025 roku wykazał, że wykorzystano tylko 13% danych telemetrycznych, co oznacza, że głównym problemem nie zawsze jest brak widoczności. Może to być nadmiar sygnałów, które nigdy nie przekładają się na decyzje operacyjne, jak doniesiono w recent enterprise observability coverage.
Błędem jest traktowanie każdego odchylenia jako incydentu. Mała zmiana dystrybucji w tabeli eksploracyjnej nie powinna wzywać tego samego zespołu ani korzystać z tej samej ścieżki eskalacji, co nieaktualne dane zasilające sprawozdawczość regulacyjną. Inżynierowie potrzebują sposobu na klasyfikowanie sygnałów według wpływu, wiarygodności i własności.
Projektowanie alertów wokół decyzji
Każdy alert powinien odpowiadać na cztery pytania:
Co się zmieniło? Zidentyfikuj zbiór danych, pole, partycję lub potok.
Jak bardzo jest to nietypowe? Pokaż punkt odniesienia, zaobserwowaną wartość i stopień pewności.
Kto odpowiada za reakcję? Skieruj powiadomienie do wyznaczonego zespołu lub właściciela usługi.
Na co może to wpłynąć? Uwzględnij pochodzenie (lineage) i proces biznesowy zależny od tego zasobu.
Użyteczny alert może informować, że krytyczna tabela dotarła niezgodnie z normalnym wzorcem dostarczania, identyfikować brakującą partycję, wskazywać zależność raportowania na dalszym etapie oraz wskazywać odpowiedzialne zadanie pozyskiwania. „Wykryto anomalię wolumenu” to nie jest przepływ pracy nad incydentem. To zaproszenie do rozpoczęcia ręcznego dochodzenia.
Progi statystyczne pomagają ograniczyć arbitralne wzywanie personelu. Używaj 3 odchyleń standardowych dla alertów krytycznych i 2 dla ostrzegawczych, gdy zachowanie historyczne jest stabilne, a następnie wyciszaj duplikaty powiadomień, dopóki incydent pozostaje otwarty. W przypadku danych sezonowych, rzadkich lub szybko zmieniających się, wyuczony punkt odniesienia może działać lepiej niż stała reguła, ale nadal wymaga właściciela i polityki ważności uwzględniającej specyfikę biznesową.
Mierzenie jakości detekcji, a nie liczby powiadomień
Średni czas wykrycia (Mean-time-to-detect) jest często najbardziej miarodajnym wskaźnikiem niezawodności, ponieważ zespoły mogą rozwiązać problem dopiero po tym, jak dowiedzą się o jego istnieniu. Jedno z badań branżowych z 2026 roku wykazało, że zespoły zajmujące się danymi odnotowywały średnio 67 incydentów miesięcznie, przy czym 68% z nich wymagało ponad 4 godzin na wykrycie, a ich rozwiązanie zajmowało średnio 15 godzin, zgodnie z Integrate.io's survey coverage. Wniosek operacyjny jest jasny: skrócenie opóźnienia detekcji może przynieść większą wartość niż dodanie kolejnego pulpitu nawigacyjnego.
Śledź uciążliwe alerty, które nie wymagały żadnego działania, alerty bez przypisanego właściciela, powtarzające się alerty dotyczące jednej przyczyny źródłowej oraz incydenty wykryte w pierwszej kolejności przez użytkowników biznesowych. Następnie dostosuj progi, skonsoliduj powiązane sygnały i usuń kontrole, które nie wpływają na podejmowanie decyzji.
Skoncentrowany data quality dashboard powinien pomagać osobom reagującym dostrzegać trendy i nierozwiązane incydenty, a nie tylko wyświetlać dużą liczbę kontroli. Najlepszy program observability to nie ten, który ma najwięcej alertów. To ten, któremu inżynierowie ufają na tyle, by podjąć działanie.
Wdrażanie Observability w środowiskach regulowanych i lokalnych (On-Premises)
Projekt typu SaaS-first często zakłada, że metadane i próbki mogą swobodnie przemieszczać się do zewnętrznej usługi. To założenie zawodzi w usługach finansowych, opiece zdrowotnej, telekomunikacji i sektorze publicznym, gdzie rezydentność danych, audytowalność, kontrola dostępu i weryfikacja bezpieczeństwa kształtują każdą decyzję architektoniczną.
Wzorzec wdrażania, któremu ufam w tych środowiskach, zatrzymuje dane produkcyjne wewnątrz granic klienta. Wykonywanie w bazie danych (In-database execution) oblicza metryki tam, gdzie dane już się znajdują, podczas gdy warstwa observability otrzymuje dozwolone metadane, wyniki metryk i kontekst incydentu zamiast nieograniczonych rekordów produkcyjnych.
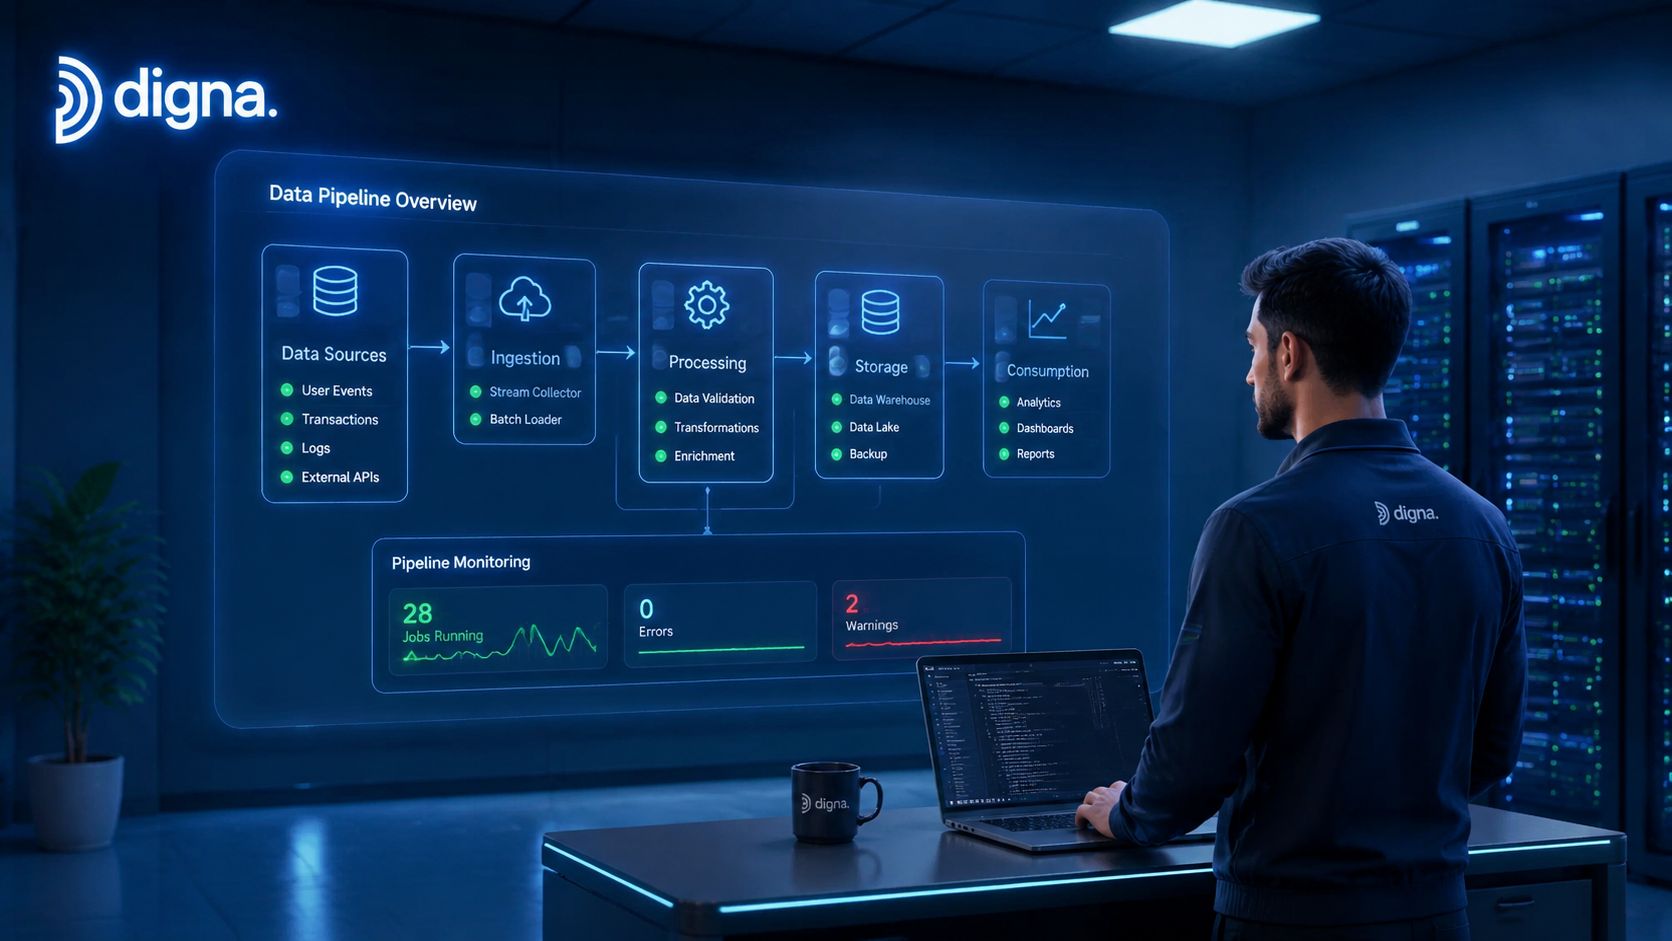
Sekwencja wdrożenia, która pomyślnie przejdzie weryfikację bezpieczeństwa
Zacznij od diagramu przepływu danych. Udokumentuj, gdzie wykonywane są kontrole, co opuszcza bazę danych, które konto usługowe je uruchamia i gdzie przechowywane są wyniki. Zespoły ds. bezpieczeństwa mogą skuteczniej zweryfikować konkretny przepływ niż obietnicę, że produkt jest „bezpieczny”.
Oddziel obliczanie metryk od danych dochodzeniowych. Liczba wierszy, znaczniki czasu świeżości, sygnatury schematu i zagregowane metryki jakości mogą być wystarczające do detekcji. Próbki na poziomie rekordów powinny być opcjonalne, maskowane lub zabronione tam, gdzie wymaga tego polityka bezpieczeństwa.
Używaj prywatnych granic wdrożenia. Instalacja w chmurze prywatnej lub lokalna (on-premises) może działać wewnątrz VPC klienta, konta chmurowego lub centrum danych. Utrzymuj konektory, harmonogramy, magazyny metadanych i interfejsy użytkownika w zatwierdzonych strefach sieciowych.
Uczyń dowody audytowe częścią projektu. Przechowuj definicje kontroli, czasy wykonania, zaobserwowane wyniki, potwierdzenia, zmiany własności i historię naprawczą. Audytorzy zazwyczaj muszą ustalić, co zostało sprawdzone, kiedy zostało uruchomione, co się stało i kto zareagował.
Zespoły powinny również wyraźnie dokumentować decyzje dotyczące rezydentności. Przewodnik data residency requirements guide jest przydatnym punktem odniesienia przy decydowaniu, które metadane mogą przekraczać granice regionalne lub organizacyjne.
Heterogeniczne środowiska wymagają wspólnego kontraktu
Tradycyjne bazy danych, platformy hurtowni danych, jeziora danych (lake storage), tematy Kafki i narzędzia transformacji rzadko udostępniają identyczne metadane. Standaryzuj dane wyjściowe observability, zamiast zmuszać każde źródło do tej samej metody instrumentacji. Każda integracja powinna publikować tożsamość zasobu, czas aktualizacji, wynik wolumenu lub kompletności, stan schematu, status kontroli, właściciela oraz referencje lineage.
Konta usługowe o najniższych uprawnieniach, dostęp tylko do odczytu tam, gdzie to możliwe, maskowane identyfikatory i oddzielne poświadczenia dla każdego środowiska ograniczają promień rażenia samego systemu monitorowania. Przetestuj wdrożenie pod kątem scenariuszy tworzenia kopii zapasowych, przełączania awaryjnego i odłączonej sieci przed wdrożeniem produkcyjnym.
Kompromis jest realny. Kontrole w bazie danych mogą zużywać zasoby hurtowni, podczas gdy skanowanie zewnętrzne może uprościć wdrożenie, ale generować tarcia w obszarze governance. Mierz koszty zapytań, planuj kosztowne profilowanie poza godzinami szczytu i stale stosuj lekkie kontrole metadanych z głębszą walidacją kluczowych zasobów.
Wybór właściwej strategii alertów dla Twojego stosu danych
Strategia alertów powinna wynikać z zachowania danych, a nie z mody na narzędzia. Statyczne progi są łatwe do wyjaśnienia i audytowania. Statystyczne punkty odniesienia dostosowują się do normalnych zmian. Uczenie maszynowe może ograniczyć ręczne tworzenie reguł, ale wprowadza zachowania modeli, które zespoły ds. zgodności (compliance) i platform mogą chcieć kontrolować. Deterministyczna walidacja pozostaje kluczowa wszędzie tam, gdzie reguła biznesowa musi być egzekwowana z pełną dokładnością.
Strategia | Najlepsza dla | Ograniczenia | Złożoność wdrożenia |
|---|---|---|---|
Statyczne progi | Przewidywalna liczba danych, sztywne limity, kontraktowe okna dostarczania | Zawodzą przy sezonowości, wzroście i stopniowym dryfie | Niska |
Statystyczne punkty odniesienia | Specyficzne dla zbioru danych zachowania dotyczące wolumenu, świeżości i dystrybucji | Wymagają wystarczającego kontekstu historycznego i dokładnego dostrojenia | Średnia |
Detekcja anomalii oparta na uczeniu maszynowym | Złożone wzorce, zmieniające się zachowania i szerokie pokrycie | Wymaga wyjaśnialności, governance oraz weryfikacji fałszywych alarmów | Średnia do wysokiej |
Deterministyczna walidacja rekordów | Kontrole regulacyjne, reguły biznesowe i dokładne wymagania na poziomie wierszy | Nie potrafi zidentyfikować nieznanych wzorców bez zdefiniowanych reguł | Średnia |
Kiedy wygrywają proste reguły
Używaj reguły statycznej, gdy warunek błędu jest jednoznaczny. Wymagana partycja, która nie dotarła, zabroniony typ danych lub pole, które musi spełniać zdefiniowane ograniczenie biznesowe, powinny dawać deterministyczny wynik. Kontrole te są łatwiejsze do przetestowania, wyjaśnienia audytorom i odtworzenia podczas analizy incydentu.
Statyczne progi sprawdzają się również w przypadku stabilnych zasileń o dużym wolumenie z jasnymi limitami operacyjnymi. Stają się podatne na błędy, gdy normalne zachowanie zmienia się w zależności od godziny, sezonu, segmentu klientów lub cyklu życia produktu. Pojedynczy globalny próg często generuje fałszywe alarmy podczas uzasadnionych szczytów i pomija powolną degradację.
Kiedy pomagają metody adaptacyjne
Statystyczne punkty odniesienia są przydatne, gdy każdy zbiór danych ma swój własny rytm. Porównuj podobne z podobnym, np. tę samą godzinę lub okno dostawy, i zachowaj kontekst historyczny, który doprowadził do alertu. Uczenie maszynowe może rozszerzyć to podejście na wiele zasobów, ale inżynierowie nadal powinni wymagać kodu przyczyny, wizualizacji punktu odniesienia i procesu nadpisywania reguł.
Najbardziej uzasadniony projekt łączy różne metody. Używaj wykrywania anomalii do szerokiego pokrycia świeżości, wolumenu i dystrybucji. Dodaj deterministyczne kontrole dla pól regulowanych, wymagań kontraktowych i krytycznej dla biznesu logiki rekordów. Kieruj obie te ścieżki przez ten sam przepływ pracy nad incydentami, aby osoby reagujące nie musiały godzić oddzielnych systemów alertów.
Warstwa monitorowania i raportowania powinna ujawniać nie tylko to, czy kontrola zakończyła się niepowodzeniem, ale także jej trend, właściciela, ważność i znaczenie na dalszych etapach. Przykładowo, digna's monitoring and reporting capabilities reprezentuje jeden z modeli takiego połączonego działania, obok narzędzi zbudowanych wokół testów dbt, asercji w hurtowni danych czy niestandardowych kontroli orkiestracji.
Integracja Observability z istniejącą architekturą potoków
Observability nie powinno wymagać przebudowy systemu. Najbezpieczniejszy wzorzec dodaje pomiary na istniejących już granicach, a następnie wysyła wyniki do wspólnego przepływu pracy dotyczącego incydentów i metadanych, bez blokowania każdego zadania przy każdej kontroli.

W Airflow emituj metadane wykonania i zakończenia z zadań DAG, a następnie uruchamiaj kontrole świeżości i kompletności po zatwierdzeniu docelowej partycji. W dbt zachowuj wyniki testów i czas wykonania modeli jako pierwszorzędne zdarzenia observability. Zadania Spark mogą publikować liczby wejściowe i wyjściowe, liczby odrzuconych rekordów, sygnatury schematów i szczegóły partycji. Konsumenci Kafki powinni ujawniać opóźnienie (lag), opóźnienie czasu zdarzenia, wskaźniki niepoprawnie sformułowanych rekordów oraz zachowanie wolumenu na poziomie tematu.
Umieszczanie kontroli tam, gdzie odpowiadają one na pytania
Używaj kontroli synchronicznych, gdy kontynuowanie procesu wiązałoby się z nieakceptowalnym ryzykiem na dalszych etapach. Kontrola zgodności ze schematem przed opublikowaniem wspólnego kontraktu lub kontrola kompletności przed udostępnieniem regulowanego zbioru danych może w uzasadniony sposób zablokować kolejny etap.
Używaj kontroli asynchronicznych do szerszego profilowania i analizy trendów. Metryki dystrybucji, statystyki kolumn i porównania historyczne mogą działać obok ścieżki krytycznej, pod warunkiem, że wynikowy alert ma jasny proces powstrzymywania skutków. Pozwala to uniknąć przekształcania każdej kontroli analitycznej w wąskie gardło potoku.
Obsługa schematów wymaga jednoznacznej polityki. Klasyfikuj dodane kolumny, usunięte kolumny i zmiany typów danych jako kompatybilne, wymagające weryfikacji lub krytyczne. Nie odrzucaj automatycznie każdej zmiany o charakterze przyrostowym, ale też nie akceptuj modyfikacji typu danych bez weryfikacji, ponieważ może to zmienić sposób, w jaki odbiorcy na dalszych etapach interpretują wartości.
Pochodzenie danych (lineage) powinno być przechwytywane na granicach transformacji, a nie rekonstruowane podczas incydentu. Przechowuj relacje między źródłem a celem dla zadań Airflow, modeli dbt, transformacji Spark i tematów strumieniowych, a następnie dołączaj kontrole do zasobów, które opisują.
Zasada projektowa: Observability powinno ułatwiać obsługę potoku, a nie stawać się kolejną zależnością, która może go niepotrzebnie zatrzymać.
Na koniec wykorzystuj wyniki observability do ulepszania architektury. Powtarzające się opóźnienia świeżości mogą ujawnić przeciążone okno ekstrakcji. Uporczywe anomalie wolumenu mogą wskazywać na słabe kontrakty źródłowe. Powtarzające się incydenty związane ze schematem mogą uzasadniać stosowanie wersji interfejsów zamiast generowania kolejnych alertów.
Zaczynanie od małych kroków i skalowanie wdrożenia Observability
Monitorowanie wszystkiego pierwszego dnia tworzy katalog kontroli, zanim zespół dowie się, które sygnały mają znaczenie. Zacznij od jednego krytycznego potoku, najlepiej od zasobu, który zasila raportowanie zarządcze, operacje z klientami, prace regulacyjne lub model produkcyjny. Sklasyfikuj kandydatów według wpływu biznesowego, historii incydentów, głębokości zależności i trudności ręcznego wykrycia awarii.
Wdrożenie etapowe jest łatwiejsze do obrony, ponieważ każdy etap dostarcza dowodów operacyjnych.
Dni 1–30: Zmapuj wybrany potok, zidentyfikuj właścicieli i odbiorców na dalszych etapach, ustal SLI dla świeżości, sukcesu zadań, kompletności oraz schematu i zarejestruj punkt odniesienia.
Dni 31–60: Dodaj walidację dystrybucji lub walidację na poziomie rekordów tam, gdzie pierwszy etap ujawnił ryzyko. Dostrój progi ostrzegawcze i krytyczne, skieruj alerty do odpowiedzialnych zespołów i udokumentuj przepływ reakcji.
Dni 61–90: Przeanalizuj incydenty i sytuacje potencjalnie wypadkowe, usuń uciążliwe kontrole, dodaj kontekst lineage, zmierz średni czas wykrycia (mean-time-to-detect) i wybierz kolejny potok na podstawie wykazanego ryzyka, a nie samego entuzjazmu.
Mierz efekty, które zmieniają decyzje inżynieryjne. Średni czas wykrycia pokazuje, czy zespół dowiaduje się o awariach wcześniej. Wolumen incydentów i powtarzające się przyczyny źródłowe ujawniają, czy monitorowanie zmniejsza obciążenie operacyjne. Uniknięcie awarii na dalszych etapach wykazuje wartość dla analityków, interesariuszy ds. zgodności (compliance) i właścicieli biznesowych.
Wdrożenie zależy również od odpowiedzialności. Przypisz każdego krytycznego zbioru danych właściciela technicznego, zdefiniuj, kto może potwierdzić lub wyciszyć alert, i wymagaj podania przyczyny w przypadku wyłączenia kontroli. Analizuj fałszywe alarmy po incydentach, a nie tylko podczas corocznego przeglądu narzędzi.
digna może wspierać ten etapowy model dzięki wykonywaniu w bazie danych, wdrożeniom w chmurze prywatnej lub lokalnej, wykrywaniu anomalii, monitorowaniu terminowości (Timeliness), walidacji na poziomie rekordów i śledzeniu schematów. Jeśli Twoje środowisko nie pozwala na przenoszenie danych produkcyjnych do platformy SaaS, oceń, czy architektura zachowuje tę granicę, jednocześnie dostarczając inżynierom użyteczny kontekst incydentu.
Wykorzystaj pierwsze 90 dni, aby wyposażyć w instrumentację jeden krytyczny dla biznesu potok, ustanowić wiarygodne punkty odniesienia i zmierzyć jakość detekcji przed rozszerzeniem pokrycia. Aby ocenić podejście in-environment dla swoich hurtowni, jezior danych i regulowanych przepływów danych, odwiedź digna i sprawdź, jak ta modułowa platforma observability może wpasować się w Twoją istniejącą architekturę.
Najczęściej zadawane pytania
Co observability dodaje do monitoringu potoków?
Badanie samych danych. Monitoring potoków nadal się liczy, bo mówi, czy zadania się wykonały i czy infrastruktura wytrzymała, ale nie powie, że wsad zakończył się na zielono, podczas gdy zasilany przez niego pulpit jest już błędny.
Jakie jest pięć filarów?
Świeżość, rozkład, schemat, lineage i wolumen. Świeżość pokazuje, czy dane dotarły w oczekiwanym harmonogramie, wolumen porównuje ilość z normalnym zachowaniem, schemat śledzi kolumny i typy, rozkład patrzy na wzorce wartości pustych, zakresy i unikalność, a lineage łączy incydent z dotkniętymi zasobami i zespołami.
Czym różni się od reguł jakości danych?
Rozwiązują pokrewne, ale różne problemy. Reguły kodują warunki, które ktoś potrafił już zapisać; observability opisuje zachowania, których nikt wcześniej nie wyspecyfikował, i dlatego zespół mający tylko jedno z dwóch bywa zaskakiwany zawsze w tę samą stronę.
Jak wygląda potok, który zawiódł, nie zawodząc?
Jak pulpit orkiestracji pokazujący o 9:00 udane nocne zadanie, podczas gdy wytworzone dane są błędne. Potok nie zawiódł w klasycznym sensie i właśnie dlatego monitoring statusu zaraportował sukces.
Od czego powinien zacząć inżynier?
Od zbiorów, których zachowanie najtrudniej byłoby odtworzyć po fakcie. Oprzyrządowanie ich w pierwszej kolejności daje lineage i historię, które zamieniają następny incydent w krótkie dochodzenie zamiast w ćwiczenie z archeologii.


