Co to jest potok danych i dlaczego ma znaczenie
|
5
min. czyt.

Pipeline danych to kompleksowy system, który automatyzuje pobieranie, przekształcanie, walidację i ładowanie danych, dzięki czemu można z nich niezawodnie korzystać w celach analitycznych, w systemach sztucznej inteligencji (AI) i przy podejmowaniu decyzji operacyjnych. W nowoczesnym środowisku produkcyjnym oznacza to zazwyczaj, że pipeline musi przesyłać dane przez warstwy przechowywania lub konsumpcji bez utraty ich świeżości, struktury czy wiarygodności.
Zapewne znasz sytuację, w której stało się zupełnie odwrotnie. Pulpit nawigacyjny świeci się na zielono, zespół zakłada, że dane są bezpieczne, a następnie ktoś odkrywa, że bazowe źródło było nieaktualne od wielu godzin, ponieważ system nadrzędny zmienił się bez ostrzeżenia.
Spis treści
Co pipeline danych faktycznie robi w środowisku produkcyjnym
Dlaczego definicja podręcznikowa to za mało
Cztery kluczowe elementy każdego pipeline'u
Pobieranie i transformacja
Przechowywanie i konsumpcja
Wybór między architekturami ETL, ELT a Streamingiem
Gdzie pasuje dany wzorzec
Jak dokonać wyboru
Ciche błędy, które psują pipeline'y
Dryft schematu i opóźnione dane
Regresja jakości i ślepy monitoring
Biznesowy koszt niezaufanych pipeline'ów
Jak rozprzestrzeniają się szkody
Dlaczego jest to ryzyko biznesowe, a nie tylko niedogodność techniczna
Jak sprawdzić, czy Twój pipeline jest gotowy do wdrożenia produkcyjnego
Praktyczna weryfikacja gotowości
Pytania, na które powinien odpowiedzieć każdy przegląd
Budowanie pipeline'ów, którym możesz zaufać
h2 id="29">Co pipeline danych faktycznie robi w środowisku produkcyjnym
Pulpit nawigacyjny przychodów może wyglądać na całkowicie sprawny, podczas gdy dane za nim stojące są już na tyle przestarzałe, że wprowadzają firmę w błąd. Zewnętrzne API zmienia format odpowiedzi, zaplanowane zadanie nadal się wykonuje, a warstwa raportowania nieprzerwanie renderuje wykresy, więc nikt nie zauważa, że liczby są nieaktualne o 18 godzin, dopóki ktoś nie porówna ich z systemem transakcyjnym.
Właśnie dlatego pipeline danych to coś więcej niż tylko ramki i strzałki. To operacyjny szkielet, który automatyzuje pobieranie, transformację, Data Validation i ładowanie danych z systemów źródłowych do warstw przechowywania lub konsumpcji, dzięki czemu analitycy, modele i użytkownicy biznesowi mogą polegać na tym, co widzą. Zapisy historyczne pokazują, że dziedzina ta ewoluowała od ręcznych skryptów wsadowych w latach 70. i 80. XX wieku do bardziej formalnych systemów ETL wokół 1992 roku, a następnie do chmurowych architektur ELT, strumieniowych i działających w czasie rzeczywistym w latach 10. i 20. XXI wieku (BytePlus).
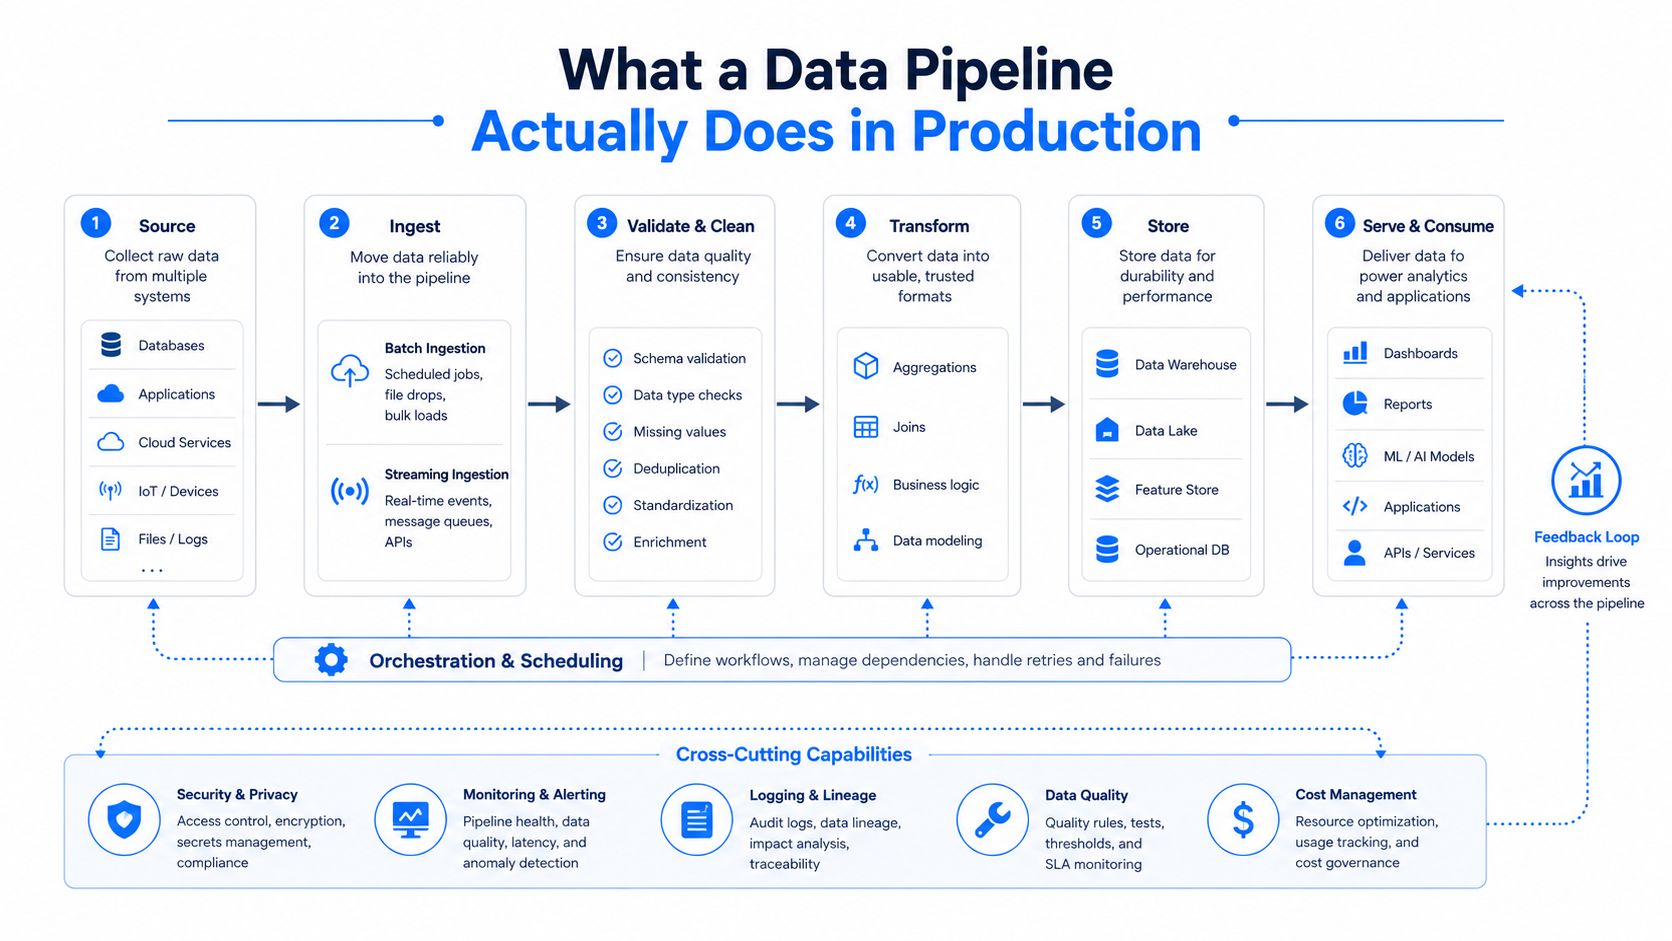
Why the textbook definition isn't enough
Prosta definicja brzmi przejrzyście, ale systemy produkcyjne rzadko takie są. Interfejsy API systemów nadrzędnych zmieniają się bez uprzedzenia, bazy danych ewoluują, pliki docierają z opóźnieniem, a zespoły docelowe nadal oczekują świeżych danych zgodnie z przewidywalnym harmonogramem. Pipeline musi absorbować te zmiany bez zamieniania każdej drobnej modyfikacji w uszkodzony pulpit nawigacyjny czy pełen złości wątek na Slacku.
Zasada praktyczna: jeśli pipeline działa poprawnie tylko wtedy, gdy nic się nie zmienia, nie jest gotowy na produkcję – po prostu ma szczęście.
To jest właśnie powód, dla którego nowoczesne zespoły myślą o Observability, logice ponawiania prób, zarządzaniu zależnościami i tolerancji na błędy jako o części samego pipeline'u, a nie o dodatkach. Pipeline produkcyjny musi chronić firmę przed niewidocznymi awariami, a nie tylko przenosić bajty z jednego systemu do drugiego.
The Four Core Components of Every Pipeline
Użytecznym sposobem na zrozumienie projektowania pipeline'ów jest porównanie ich do miejskiej sieci wodociągowej. Surowa woda wpływa do systemu, jest oczyszczana, magazynowana, a następnie dostarczana do domów. Pipeline danych opiera się na tym samym schemacie, tyle że zamiast rur i zbiorników wykorzystuje API, bazy danych, pliki, strumienie zdarzeń, hurtownie danych i pulpity nawigacyjne.
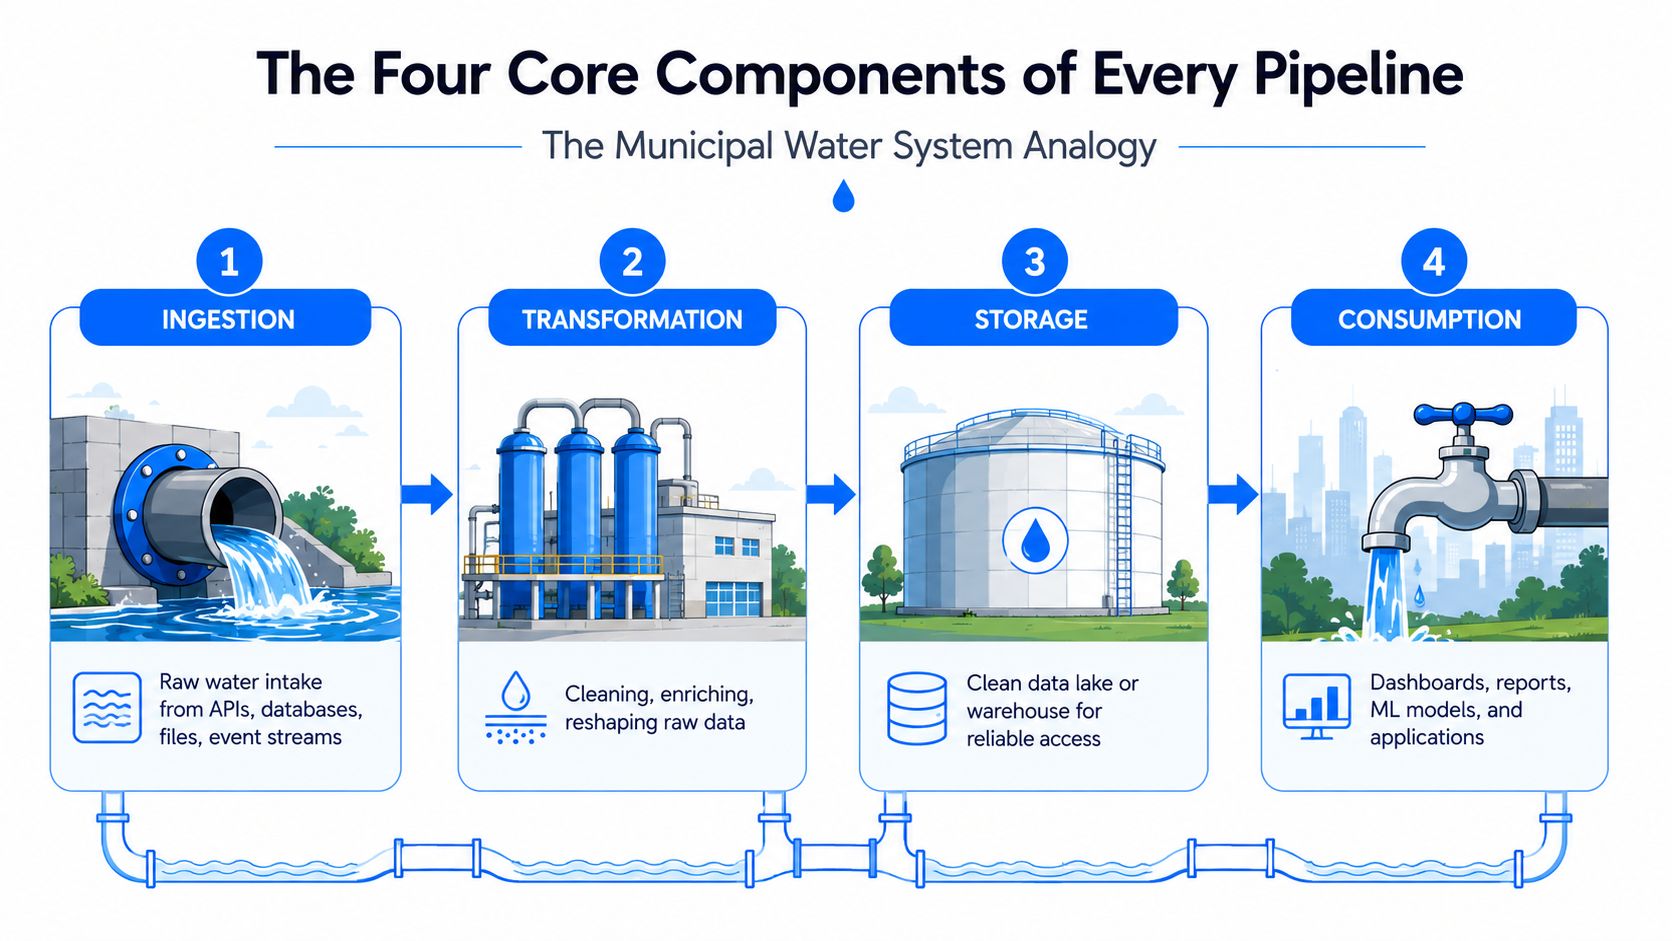
Ingestion and transformation
Pobieranie (Ingestion) to ujęcie surowej wody. Zespoły pobierają dane z API, baz SQL, aplikacji SaaS, plików i strumieni zdarzeń, często za pomocą narzędzi takich jak konektory CDC, odbiorniki webhooków czy zaplanowane zrzuty plików. Ten etap psuje się jako pierwszy, gdy zadziałają limity zapytań (rate limits), błędnie obsłużona zostanie paginacja lub gdy system nadrzędny zacznie zwracać pola w innym formacie.
Transformacja to stacja uzdatniania. Inżynierowie oczyszczają rekordy, standaryzują formaty, wzbogacają zdarzenia i agregują fakty w gotowe do użycia biznesowego wyniki. Kompromis jest prosty, ale bezwzględny: większa transformacja może poprawić jakość, ale zużywa również zasoby obliczeniowe i tworzy więcej miejsc, w których logika może rozjechać się ze źródłem.
Storage and consumption
Przechowywanie to zbiornik retencyjny. Może to być hurtownia danych, jezioro danych (data lake) lub lakehouse, a decyzja zazwyczaj sprowadza się do tego, jak zespoły chcą organizować formaty, partycje i ponowne użycie danych na dalszych etapach. Jeśli przechowywanie jest źle zaprojektowane, zespoły płacą za powtarzające się skanowania danych, powolne zapytania i kłopotliwe ponowne przetwarzanie.
Konsumpcja to kran na końcu linii. Narzędzia BI, modele ML i aplikacje operacyjne zależą od tego etapu, a każde z nich ma inne oczekiwania co do świeżości. Pulpit nawigacyjny odświeżany co noc toleruje opóźnienia, ale aplikacja dla klientów lub proces wykrywania nadużyć finansowych już nie.
W celu uzyskania bardziej szczegółowego widoku architektury przydatny jest przewodnik digna data pipeline architecture guide, jeśli chcesz przełożyć te etapy na szerszy model operacyjny.
Etap, który na schemacie wygląda najprościej, jest zazwyczaj miejscem, w którym zaczynają się problemy produkcyjne, ponieważ decyzje dotyczące przechowywania i konsumpcji decydują o tym, czy reszta pipeline'u pozostanie użyteczna.
Choosing Between ETL ELT and Streaming Architectures
ETL, ELT i streaming to nie są konkurujące ze sobą modne hasła. To różne odpowiedzi na to samo pytanie: jak szybko dane muszą się przemieszczać i jak dużej kontroli potrzebujesz, zanim ktokolwiek je zobaczy?
Where each pattern fits
ETL przekształca dane przed ich załadowaniem. Sprawdza się to dobrze w środowiskach objętych governance, gdzie zespół wymaga rygorystycznych kontroli jakości, zanim dane trafią do systemu docelowego, oraz tam, gdzie moc obliczeniowa hurtowni danych jest ograniczona lub kosztowna.
ELT najpierw ładuje surowe dane, a transformację przeprowadza wewnątrz hurtowni. To lepiej pasuje do chmurowych architektur, ponieważ przechowywanie i moc obliczeniową łatwiej skalować niezależnie, a te same surowe dane mogą być ponownie użyte w wielu modelach lub warstwach raportowania.
Streaming przetwarza zdarzenia w sposób ciągły, gdy tylko się pojawią. To odpowiednie rozwiązanie dla systemów sterowanych zdarzeniami, wykrywania nadużyć w czasie rzeczywistym i personalizacji, gdzie nieaktualne informacje stanowią problem biznesowy, a nie tylko drobną niedogodność.
Czynnik | ETL | ELT | Streaming |
|---|---|---|---|
Moment transformacji | Przed załadowaniem | Po załadowaniu | Na bieżąco, w miarę napływu zdarzeń |
Najlepsze dopasowanie | Środowiska o ścisłym nadzorze, zorientowane na przetwarzanie wsadowe | Chmurowe architektury analityczne | Przypadki użycia operacyjnego o niskim opóźnieniu |
Złożoność operacyjna | Umiarkowana | Umiarkowana | Wysoka |
Profil świeżości | Harmonogramowany | Szybszy niż klasyczny pakiet, wciąż harmonogramowany | Czas zbliżony do rzeczywistego |
Podejście do governance | Silna kontrola przed załadowaniem | Silna kontrola po stronie hurtowni | Wymaga starannego monitorowania i dyscypliny zdarzeń |
How to make the choice
Wybierz ETL, gdy mechanizmy kontroli jakości mają większe znaczenie niż elastyczność. Wybierz ELT, gdy firma oczekuje możliwości ponownego wykorzystania danych, skali i szybszej iteracji wewnątrz hurtowni. Wybierz streaming, gdy opóźnienia wpływają bezpośrednio na przychody, ryzyko lub doświadczenia klientów.
Jeśli chcesz poznać praktyczne porównanie z perspektywy wdrożenia, artykuł digna ETL data pipeline overview jest dobrym punktem odniesienia dla decyzji po stronie ETL.
Zasada decyzyjna: optymalizuj pod kątem najniższej akceptowalnej świeżości, a nie najszybszej możliwej technologii.
Brzmi to oczywiście, dopóki zespoły nie zaczną wybierać streamingu do wszystkiego, a potem przez miesiące płacić za złożoność, której wcale nie potrzebowały. Najlepsza architektura to taka, która pasuje do wymagań dotyczących opóźnień, dojrzałości governance, ograniczeń kosztowych i zdolności zespołu do jej obsługi.
Silent Failure Modes That Break Pipelines
Najbardziej niebezpieczne awarie pipeline'ów nie zgłaszają jasnoczerwonego błędu. Pozwalają na zakończenie zadania, utrzymują aktywność pulpitów nawigacyjnych i zniekształcają liczby, którym ufają liderzy.
Schema drift and late arrivals
Dryft schematu występuje wtedy, gdy źródło nadrzędne dodaje, usuwa lub zmienia nazwy pól bez poinformowania zespołu ds. danych. Jedno z powszechnych źródeł definiuje to jako niezapowiedzianą zmianę strukturalną w stosunku do schematu, na podstawie którego zbudowano pipeline, a inne zauważa, że jest to jedna z najczęstszych przyczyn awarii, gdy bazy danych aplikacji zmieniają się bez powiadomienia zespołu ds. danych (DataThere). Rezultatem mogą być wartości puste (null) tam, gdzie powinny znajdować się dane, lub agregacje pomijające pola, o których zniknięciu nikt nie wiedział.
Opóźnione dane generują inny rodzaj problemu. Okno przetwarzania wsadowego zamyka się, zanim wpłynie każdy rekord, więc codzienna metryka wygląda na kompletną, mimo że nie doszacowuje rzeczywistej aktywności. Badanie dotyczące przetwarzania wsadowego opisuje to jako dane, które docierają po zamknięciu oczekiwanego okna czasowego, ale nadal mieszczą się w zdefiniowanym okresie karencji (IJSAT).
Procesor płatności zmieniający formaty znaczników czasu lub eksport z systemu CRM usuwający pola niestandardowe mogą popsuć logikę na dalszych etapach bez przerywania samego zadania. Raport wciąż się renderuje, i to jest właśnie powód, dla którego ludzie zbyt wcześnie mu ufają.
Quality regressions and blind monitoring
Regresje jakości są wolniejsze i trudniejsze do wykrycia. Pojawiają się zduplikowane rekordy, szerzą się spójności formatów, a podstawowa walidacja wciąż przechodzi pomyślnie, ponieważ dane technicznie są obecne – są po prostu mniej wiarygodne niż wcześniej. Tradycyjny monitoring na poziomie zadań całkowicie to umyka, ponieważ sprawdza tylko, czy pipeline się uruchomił, a nie czy wynik nadal ma sens.
Dla zespołów próbujących patrzeć dalej niż tylko na samą świeżość danych, IamVera.AI's note on data freshness and AI answers stanowi przydatne przypomnienie, że nieaktualne dane wejściowe wpływają nie tylko na raporty, ale także na wnioskowanie na dalszych etapach.
Rozwiązaniem produkcyjnym jest jednoczesne monitorowanie struktury, czasu i zachowania danych wyjściowych. To stanowi różnicę między wiedzą, że zadanie zostało zakończone, a pewnością, że firma może zaufać wygenerowanym wynikom.
Aby lepiej przyjrzeć się wzorcom incydentów, poradnik digna guide on why data pipelines fail in production przypisuje te tryby awarii do praktycznych punktów detekcji.
The Business Cost of Unreliable Pipelines
Niezaufane pipeline'y nie zatrzymują się w dziale inżynierii. Uwidaczniają się w decyzjach o kampaniach, prognozach, produktach skierowanych do klientów i w zachowaniu modeli.
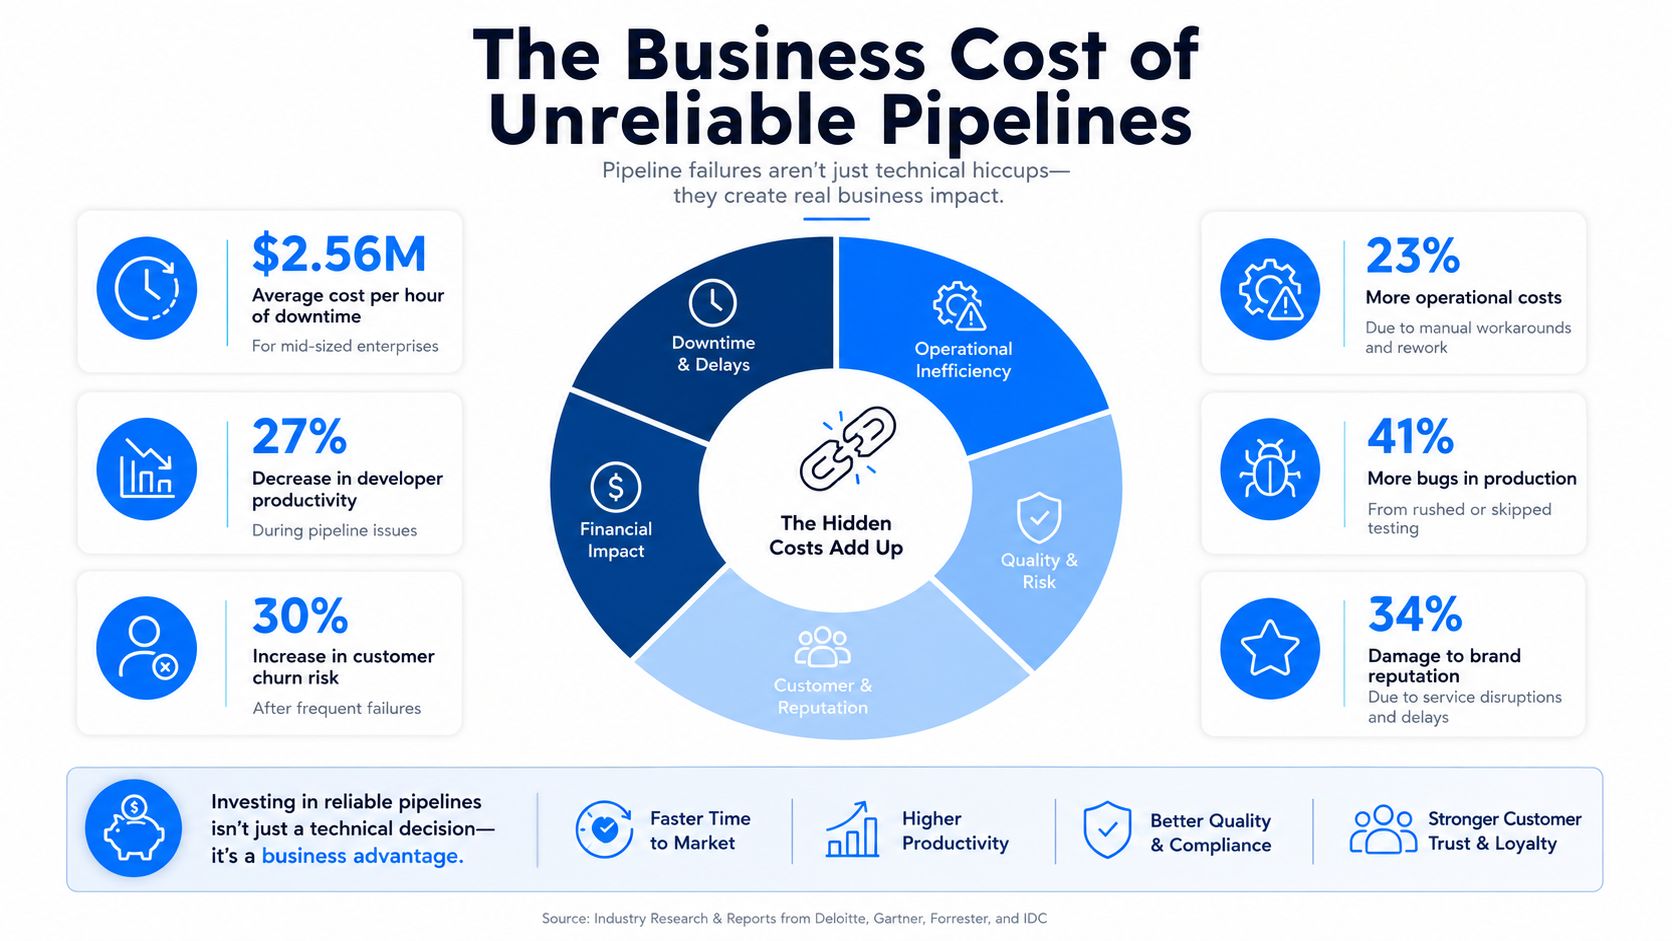
How the damage spreads
Uszkodzona warstwa pobierania prowadzi do nieaktualnych pulpitów nawigacyjnych. Zespoły marketingowe optymalizują wówczas działania pod kątem przestarzałych danych o konwersji, działy finansowe budują prognozy na podstawie niepełnych wyników, a analitycy spędzają czas na uzgadnianiu liczb zamiast na odpowiadaniu na pytania. Jeśli aplikacje klienckie korzystają z tego samego, zawodnego pipeline'u, uderzenie wizerunkowe jest natychmiastowe.
Systemy AI i ML również odczuwają ten problem. Gdy pogarsza się jakość pipeline'ów treningowych lub cech (features), model nie zawsze zgłasza głośny błąd – może dryfować i generować słabsze przewidywania lub rekomendacje, podczas gdy wszyscy zakładają, że działa bez zarzutu.
Why this is a business risk, not a tech annoyance
IBM donosi, że w badaniu IBV z 2025 roku aż 43% dyrektorów operacyjnych wskazało kwestie jakości danych jako swój główny priorytet w obszarze danych, a ponad jedna czwarta organizacji oszacowała roczne straty na kwotę powyżej 5 milionów USD, przy czym 7% traciło 25 milionów USD lub więcej (IBM). Pokrywa się to z tym, co wiele zespołów odczuwa już w praktyce: słaba jakość danych nie jest abstrakcyjnym problemem związanym z governance, to realny koszt operacyjny.
Wzorzec naprawczy jest równie bezwzględny. Cytowane badanie nad ROI z jakości danych wycenia zapobieganie na około 1 USD za rekord, wykrywanie i poprawianie błędnych danych po ich pojawieniu się na około 10 USD za rekord, a poprawianie błędu już po fakcie na około 100 USD za rekord (LightsonData). Im dłużej problem trwa, tym droższy się staje.
Jeśli szukasz prostego sposobu na przedstawienie tego problemu kadrze kierowniczej, digna data downtime cost calculator pomoże powiązać przestoje w pipeline'ach z wpływem na biznes, bez opierania dyskusji na domysłach.
Pipeline, który wygląda dobrze, generując błędne odpowiedzi, jest droższy niż ten, który szybko ulega awarii, ponieważ fałszywa pewność siebie rośnie lawinowo.
How to Know If Your Pipeline Is Production Ready
Pipeline jest gotowy do wdrożenia produkcyjnego, gdy zespół potrafi wyjaśnić, jak zachowuje się w przypadku zmian, opóźnień i częściowych awarii. Sformułowanie „przeszedł testy na środowisku stagingowym” nie wystarczy, ponieważ staging rzadko odwzorowuje chaotyczne zachowanie źródła, opóźnione rekordy czy odbiorców oczekujących świeżych danych w ściśle określonym czasie.
A practical readiness check
Observability: Każdy etap powinien generować ustrukturyzowane logi, pochodzenie danych (lineage) powinno być łatwe do odtworzenia, a alerty powinny reagować na progi świeżości, a nie tylko na fakt zakończenia zadania. Jeśli pipeline jest opóźniony, ale świeci się na zielono, model alertów jest zbyt płytki.
Validation: Twórcy i konsumenci potrzebują kontraktów schematów, walidacji jakości na poziomie wierszy oraz wykrywania anomalii w liczbie rekordów lub rozkładach wartości. Daje to szansę na wychwycenie błędnych danych wyjściowych, zanim trafią one na pulpity nawigacyjne lub do modeli.
Timeliness i powtarzalność: Zdefiniuj realne SLA dotyczące świeżości dla każdego scenariusza użycia, a następnie przetestuj, czy pipeline potrafi ponownie przetworzyć dane historyczne bez duplikowania rekordów. Jeśli nie potrafi podnieść się po awarii źródła, nie jest wystarczająco odporny na produkcję.
Użytecznym punktem odniesienia do tego typu oceny jest digna reliability measurement guide, szczególnie jeśli Twój zespół potrzebuje przełożyć niezawodność na mierzalne wskaźniki zamiast opierać się na anegdotach.
Questions every review should answer
Czy widzimy kondycję danych, a nie tylko status zadania? Jeśli nie, Wasze Observability jest niepełne.
Czy wiemy, co się zmieniło, gdy zmieniło się źródło? Jeśli nie, dryft schematu Was zaskoczy.
Czy możemy bezpiecznie ponownie przetworzyć dane? Jeśli nie, odzyskiwanie danych stworzy duplikaty lub luki.
Czy użytkownicy końcowi znają oczekiwania dotyczące świeżości? Jeśli nie, zaufanie opiera się na przyzwyczajeniu, a nie na dowodach.
Dobry standard: gotowy do wdrożenia pipeline działa nawet wtedy, gdy dane wejściowe są opóźnione, nieuporządkowane lub częściowo błędne, i informuje Cię dokładnie, kiedy to następuje.
Ten standard powinien być współdzielony przez inżynierię, analitykę i właścicieli biznesowych. W przeciwnym razie zespół zdefiniuje sukces jako „DAG się uruchomił”, podczas gdy biznes założy, że sukces oznacza „liczby się zgadzają”.
Building Pipelines You Can Trust
Nowoczesny pipeline to nie tylko rury łączące systemy. To warstwa niezawodności dla produktów danych, co oznacza, że zaufanie wynika z decyzji projektowych, a nie z samej orkiestracji.
Zespoły, które zdobywają zaufanie, konsekwentnie realizują kilka zasad. Definiują SLA dla świeżości i jakości, traktują zmiany schematów jako zdarzenia krytyczne, monitorują kondycję danych niezależnie od statusu uruchomienia i dopasowują architekturę do potrzeb odbiorców końcowych. Dbają również o jasne przypisanie odpowiedzialności, ponieważ nikt nie zaufa kluczowemu procesowi, jeśli nie wiadomo, kto ma na niego zareagować o 7 rano.
Dla zespołów poszukujących praktycznego planu działania pomocnym uzupełnieniem przedstawionych tu idei jest DataTeams guide to building a data pipeline, zwłaszcza jeśli przekładasz architekturę na codzienne decyzje wdrożeniowe.
Efekty widoczne są później – w czystszej analityce, lepszych modelach i mniejszej liczbie dyskusji o to, czy dana metryka jest prawdziwa. Niezawodne pipeline'y stają się fundamentem dla analityki w czasie rzeczywistym, sklepów z cechami (feature stores) dla uczenia maszynowego oraz zautomatyzowanych systemów decyzyjnych, które zależą od spójnych danych wysokiej jakości.
digna pomaga zespołom monitorować zmiany schematów, Timeliness, Data Validation oraz anomalie w ich własnym środowisku, czyli dokładnie taką kontrolę, jakiej potrzebują pipeline'y produkcyjne. Jeśli zwiększasz niezawodność swoich procesów lub próbujesz uczynić zaufanie do danych widocznym dla biznesu, odwiedź digna i zobacz, jak jej moduły Observability wpasowują się w Twój stos technologiczny.
Najczęściej zadawane pytania
Czym jest potok danych?
To system od końca do końca, który automatyzuje pobieranie, przekształcanie, walidację i ładowanie danych, aby dało się na nich polegać w analityce, AI i decyzjach operacyjnych. Automatyzacja jest sednem: ciąg ręcznych kroków, które przypadkiem wykonują się po kolei, nie jest potokiem.
Jakie są cztery podstawowe komponenty?
Pobieranie, przekształcanie, składowanie i konsumpcja, które dobrze odwzorowują miejską sieć wodociągową: ujęcie wody surowej, stację filtrów, zbiornik i kran. Etap, który na schemacie wygląda najprościej, zwykle jest tym, od którego zaczyna się ból na produkcji.
Dlaczego podręcznikowa definicja nie wystarcza?
Bo systemy produkcyjne rzadko zachowują się porządnie. Źródłowe API zmienia format odpowiedzi, zaplanowane zadanie i tak się kończy, warstwa raportowa dalej renderuje, a nikt nie zauważa, że liczby mają 18 godzin, dopóki ktoś nie porówna ich z systemem transakcyjnym.
Kiedy wybierać ETL, ELT albo streaming?
To nie konkurujące hasła, lecz różne umiejscowienia kroku transformacji. ETL przekształca przed załadowaniem, ELT najpierw ładuje dane surowe i przekształca je w hurtowni, a streaming przetwarza w sposób ciągły. Właściwy wybór wynika z wymaganego opóźnienia decyzji i z tego, gdzie powinno leżeć obliczenie.
Od kiedy istnieją potoki danych?
Dłużej niż sam termin. Opracowania historyczne prowadzą tę dziedzinę od ręcznych skryptów wsadowych z lat siedemdziesiątych i osiemdziesiątych, przez bardziej formalne systemy ETL około 1992 r., po natywne dla chmury ELT, streaming i architektury czasu rzeczywistego lat 2010 i 2020.


