Simulazione Monte Carlo per principianti: una guida pratica
|
6
min di lettura

La vostra dashboard dei ricavi trimestrali mostra da tre settimane la stessa linea a 4,2 milioni di $. Il grafico è rassicurante, ma la pipeline commerciale sottostante è scarna, diverse opportunità sono in ritardo e l'affidabilità della previsione è bassa. Un singolo numero nasconde un'ampia gamma di risultati plausibili.
È proprio questo il tipo di problema che la simulazione Monte Carlo aiuta i team dati a risolvere. Invece di costringere input incerti in un'unica previsione deterministica, campionate ripetutamente possibilità realistiche ed esaminate la distribuzione delle metriche risultanti. Il metodo è utile per capire come l'incertezza influisce su ricavi, consegna delle pipeline, disponibilità dei dati e sui KPI costruiti su di essi.
Indice
Perché la simulazione Monte Carlo è importante per i team dati
Dalla certezza della dashboard all'intervallo decisionale
L'idea alla base della simulazione Monte Carlo
Stimare pi greco con punti casuali
I tre elementi costitutivi
Costruire la vostra prima simulazione in Python
Leggere correttamente l'output
Casi d'uso pratici per stime e rischio
Incertezza dei ricavi
Rischio di completamento della pipeline
Lacune nella disponibilità dei dati
Quante iterazioni servono
Un controllo pratico della convergenza
Errori comuni e controlli di validazione
Adattate le distribuzioni ai dati
Preservate le relazioni tra gli input
Rendete le esecuzioni riproducibili
Validate prima di fidarvi dell'istogramma
Collegare la simulazione a qualità dei dati e osservabilità
Un workflow di produzione
Perché la simulazione Monte Carlo è importante per i team dati
Una stima puntuale è comoda perché è facile da visualizzare e discutere. Ma è anche incompleta. Quando una dashboard riporta un unico dato di ricavi, un unico tempo di completamento della pipeline o un unico tasso di null atteso, il calcolo potrebbe aver compresso input incerti in ipotesi fisse molto prima che il risultato raggiungesse uno stakeholder.
La simulazione Monte Carlo ripristina quella variabilità mancante. Ogni esecuzione rappresenta uno stato plausibile del sistema. Un'esecuzione sui ricavi potrebbe includere meno trattative concluse, date di chiusura posticipate o valori diversi delle trattative. Un'esecuzione sulla pipeline potrebbe combinare un volume di input maggiore con una contesa delle risorse. Dopo molte esecuzioni, il team può esaminare non solo la stima centrale, ma anche le parti inferiore e superiore della distribuzione dei risultati.
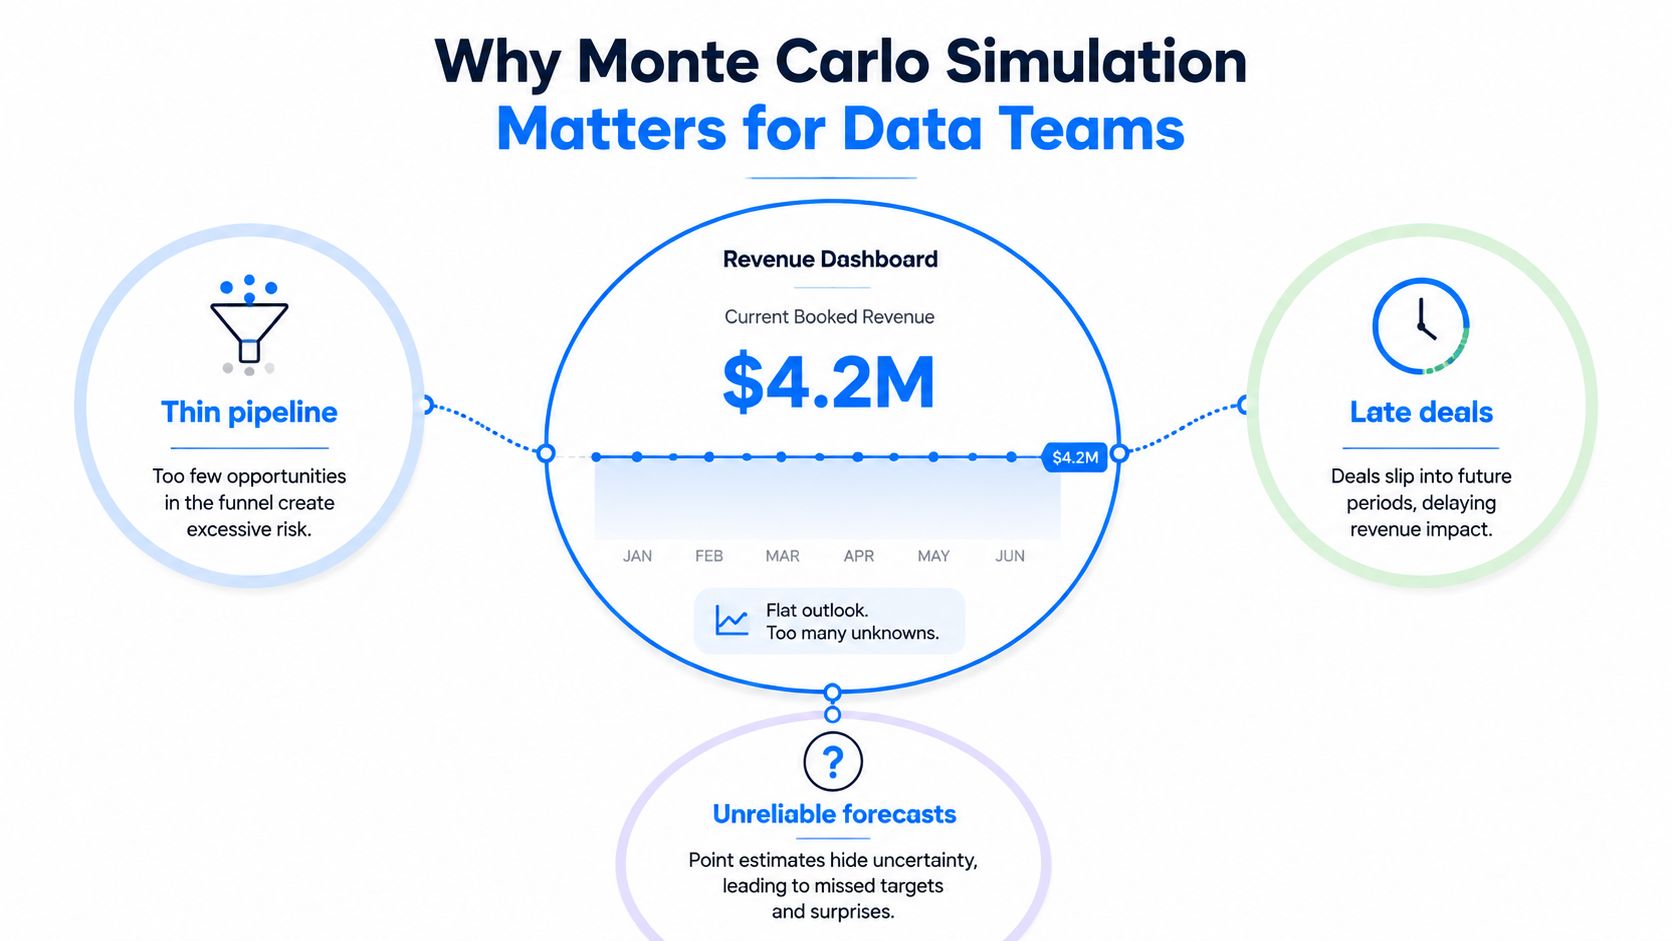
Dalla certezza della dashboard all'intervallo decisionale
Supponiamo che la dashboard dei ricavi resti piatta perché la query di reporting usa il totale della previsione corrente. Quel totale non dice nulla su quanto il risultato sia sensibile a trattative in ritardo o a fasi delle opportunità poco affidabili. Una simulazione può produrre un intervallo che risponde a domande più utili:
Esposizione dei ricavi: quanto potrebbero plausibilmente scendere i ricavi riconosciuti se le trattative incerte slittano?
Affidabilità della pianificazione: quanta parte della previsione riportata dipende da un piccolo numero di opportunità?
Risposta operativa: la finanza dovrebbe rivedere i piani di assunzione, oppure le sales operations dovrebbero prima migliorare i dati della pipeline?
Lo stesso ragionamento vale per il data engineering. Un job può avere un tempo di completamento nominale, ma il numero di righe, i ritardi a monte e la contesa delle risorse nel data warehouse creano incertezza operativa. Simulare questi input aiuta il team a stimare il rischio di mancare uno SLA invece di affidarsi a un tempo di esecuzione medio.
Regola pratica: riportate la previsione e l'incertezza che la circonda. Gli stakeholder possono agire su un intervallo quando capiscono che cosa lo determina.
Questo approccio integra le pratiche di data observability, con cui i team monitorano se i dati sono arrivati, sono cambiati o hanno violato le aspettative. Il monitoraggio vi dice che cosa sta succedendo. La simulazione aiuta a stimare quali effetti le condizioni osservate potrebbero avere sulle decisioni a valle.
L'idea alla base della simulazione Monte Carlo
La simulazione Monte Carlo si basa su un ciclo semplice: definire un sistema, generare input casuali, calcolare un risultato e ripetere. Il risultato non è un tipo speciale di numero casuale. È un insieme di risultati che approssima il comportamento di un sistema incerto.
Il classico esempio di pi greco rende visibile la logica senza bisogno di codice.
Stimare pi greco con punti casuali
Partite da un quadrato e disegnate al suo interno un cerchio che tocchi i lati del quadrato. Il quadrato definisce il dominio. Ora fate cadere punti in modo casuale su tutto il quadrato, dando a ogni posizione la stessa probabilità di ricevere un punto.
Per ogni punto, verificate se cade all'interno del cerchio. Potete farlo confrontando la sua distanza dal centro con il raggio del cerchio. I punti all'interno del cerchio formano un campione dell'area del cerchio, mentre tutti i punti insieme rappresentano l'area del quadrato.
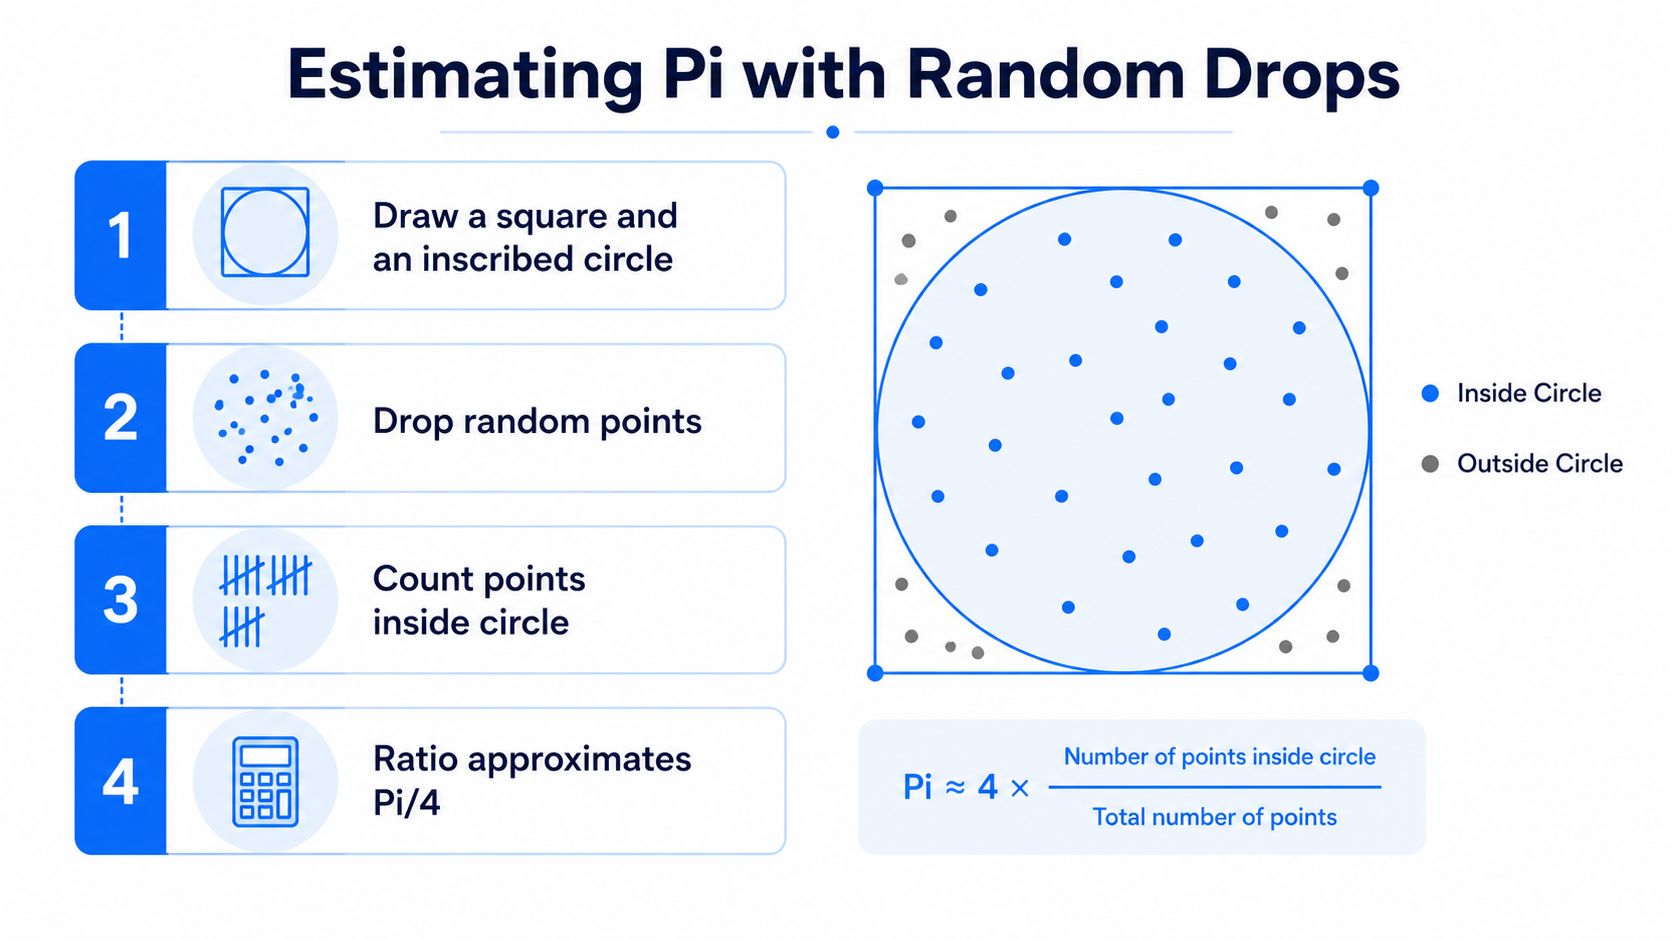
La regola di aggregazione è la parte importante. Dividete il numero di punti all'interno del cerchio per il numero totale di punti. Questo rapporto approssima l'area del cerchio divisa per l'area del quadrato, cioè π diviso quattro. Moltiplicate il rapporto per quattro e otterrete una stima di π.
Dopo un piccolo numero di prove la stima non sarà esatta. I raggruppamenti casuali creano rumore. Ripetendo l'esperimento, la stima in genere si assesta attorno al valore matematico, anche se le singole esecuzioni possono comunque differire.
I tre elementi costitutivi
Un modo semplice per i principianti di pensare a una simulazione è separarne la struttura in tre parti:
Dominio: definite lo spazio dei possibili input, come il quadrato che contiene il cerchio.
Processo di campionamento: estraete valori casuali secondo una distribuzione specificata, come punti uniformi su tutto il quadrato.
Regola di aggregazione: trasformate ogni prova in un output, quindi riassumete l'insieme con una metrica come un rapporto, una media o un percentile.
Lo stesso schema compare nel lavoro sui dati aziendali. Il dominio potrebbe essere l'insieme dei valori plausibili delle trattative, il processo di campionamento potrebbe estrarre da una distribuzione triangolare e la regola di aggregazione potrebbe sommare i ricavi attesi di tutte le opportunità. Capire come le distribuzioni descrivono i dati è essenziale, perché la distribuzione determina quali possibilità la simulazione considera comuni, rare o impossibili.
Costruire la vostra prima simulazione in Python
La prima simulazione in Python dovrebbe restare abbastanza piccola da poter essere esaminata. La libreria standard offre tutto il necessario per l'esempio di pi greco: random genera i campioni e math fornisce il valore di riferimento per calcolare l'errore.
Lo script seguente definisce gli input, fissa un seed per la ripetibilità, conta i punti all'interno di un cerchio unitario e stampa l'avanzamento a tappe significative.
Gli input hanno compiti distinti. TRIALS controlla la durata dell'esperimento, mentre SEED rende riproducibile la sequenza casuale. La riproducibilità è importante nel data engineering, perché occorre distinguere una modifica del modello dalla normale variabilità del campionamento.
Leggere correttamente l'output
A ogni tappa, lo script calcola la stima corrente e il suo errore assoluto rispetto al valore reale di π. La stima iniziale può variare sensibilmente, mentre quelle successive appaiono spesso più stabili. Questo andamento è utile, ma non considerate l'ultimo numero stampato come l'intero risultato.
Una versione più solida memorizza la stima di ogni tappa e la traccia in un grafico rispetto al numero di prove. Aggiungete una linea di riferimento orizzontale a math.pi, quindi verificate se la stima si stringe attorno a quella linea. Il grafico mostra direttamente la convergenza, ed è più informativo del confronto tra due output isolati.

La dispersione tra esecuzioni indipendenti fa parte del segnale. Un singolo risultato riproducibile è utile per il debug, ma non descrive l'incertezza del metodo.
Per il lavoro sui dati in produzione, la stessa struttura può supportare il rilevamento delle anomalie nei dati con Python. Sostituite le coordinate casuali con input operativi campionati, sostituite il test del cerchio con la vostra logica di business o di pipeline e conservate la distribuzione degli output per l'analisi.
Casi d'uso pratici per stime e rischio
L'esempio di pi greco usa una relazione geometrica, ma le simulazioni aziendali di solito propagano l'incertezza attraverso un modello di business o di pipeline. Il ciclo resta familiare: campionare gli input, applicare il modello, salvare il risultato e riassumere l'output.
Incertezza dei ricavi
Considerate un portafoglio trimestrale che contiene opportunità con valori di chiusura incerti. Per ogni trattativa, usate una distribuzione triangolare con un minimo, un valore più probabile e un massimo. Il minimo può rappresentare un risultato prudente, il valore più probabile può riflettere la valutazione commerciale attuale e il massimo può rappresentare la chiusura plausibile più favorevole.
Un'esecuzione della simulazione campiona un valore per ogni trattativa e somma questi valori. Ripetere il processo crea una distribuzione dei ricavi del portafoglio. La media fornisce una stima centrale, mentre alcuni percentili selezionati forniscono un intervallo per la pianificazione. Il valore sta nel mostrare come l'incertezza si accumula nel portafoglio, soprattutto quando un piccolo gruppo di trattative contribuisce in larga parte alla previsione.
Lo stesso stile di previsione probabilistica compare in altri contesti decisionali. Chi lavora con probabilità di eventi può trovare utile l'analisi del Monte Carlo per i trader dei mercati predittivi, perché applica il campionamento ripetuto a risultati incerti invece di affidarsi a un'unica previsione deterministica.
Rischio di completamento della pipeline
Per un job ETL, campionate numero di righe, velocità di elaborazione, orari di arrivo a monte e contesa delle risorse, tutti incerti. La logica di aggregazione può calcolare l'orario di fine previsto per ogni esecuzione. L'output decisionale è se tale orario cade prima della finestra dello SLA.
Il risultato può orientare il capacity planning. Se la distribuzione simulata degli orari di fine supera spesso la scadenza, il team ha evidenze per analizzare partizionamento, schedulazione dei carichi di lavoro, dipendenze a monte o lo SLA stesso.
Lacune nella disponibilità dei dati
Un team dati può anche simulare i dati mancanti nelle tabelle di origine. Campionate tassi di null o condizioni di caricamento mancante dal comportamento operativo osservato, applicate queste condizioni al calcolo del KPI e registrate la metrica risultante. La distribuzione degli output mostra di quanto potrebbe muoversi il KPI quando cambia la completezza delle sorgenti.
Caso d'uso | Distribuzione degli input chiave | Aggregazione | Output decisionale |
|---|---|---|---|
Incertezza dei ricavi | Distribuzione triangolare del valore delle trattative | Somma dei risultati campionati delle trattative | Intervallo di pianificazione per i ricavi del portafoglio |
Completamento della pipeline | Distribuzioni di tempo di esecuzione, volume di righe, arrivo e contesa | Calcolo dell'orario di fine e dello stato dello SLA | Priorità di capacità o di remediation |
Lacune nella disponibilità dei dati | Distribuzioni osservate di completezza e tasso di null | Ricalcolo del KPI interessato | Volatilità ed esposizione attese del KPI |
La struttura del codice cambia appena tra questi esempi. Il lavoro importante avviene nel modello degli input e nella logica di aggregazione. Se queste ipotesi non riflettono il comportamento del business o della pipeline, aumentare le esecuzioni non riparerà il modello.
Presentate i risultati come intervalli legati alle decisioni. “Il KPI può muoversi in un ampio intervallo plausibile quando la completezza delle sorgenti si deteriora” offre a un dirigente un motivo per finanziare la remediation. Un singolo numero di previsione nasconde questa scelta operativa.
Quante iterazioni servono
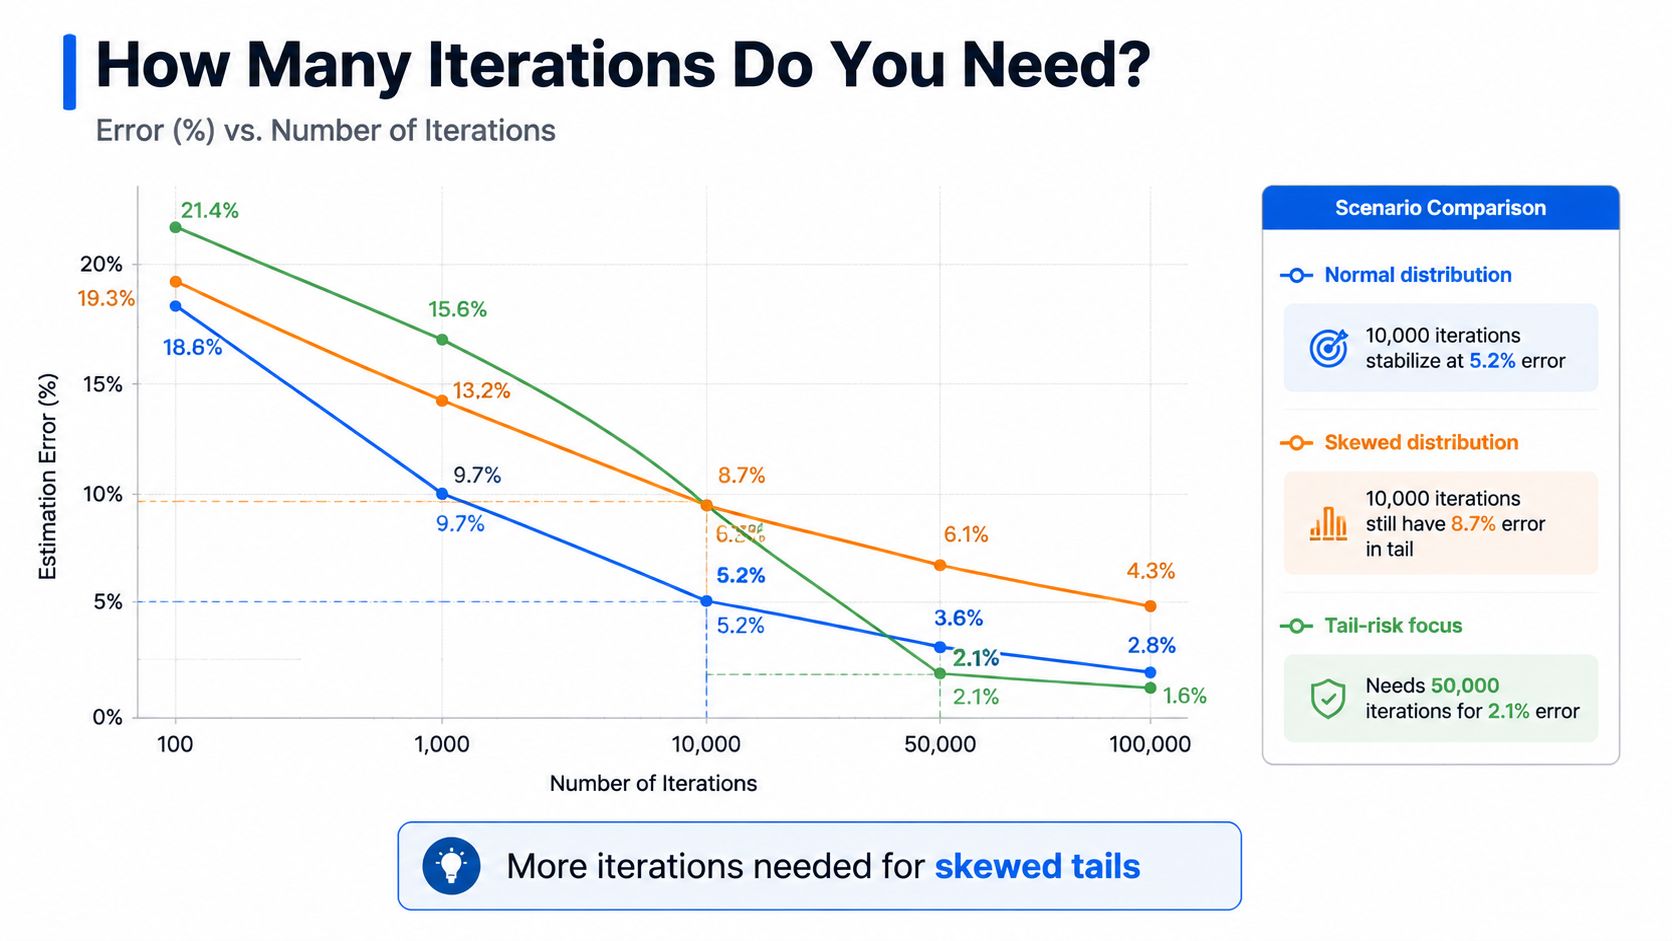
10.000 iterazioni non sono una risposta universale. Una guida pratica raccomanda 10.000 iterazioni per molte applicazioni di business e suggerisce di verificare se gli output principali cambiano meno dell'1% aumentando il numero di esecuzioni da 10.000 a 20.000. La guida mette a confronto questa raccomandazione con le indicazioni di AWS, che suggeriscono dimensioni del campione nell'ordine di 100.000 per l'accuratezza. Leggete l'analisi pratica sulla convergenza per questo confronto.
Il numero di esecuzioni necessario dipende dalla decisione e dall'output misurato. Una media può stabilizzarsi mentre un 95° percentile resta rumoroso. Input asimmetrici o a coda pesante richiedono più esecuzioni di input compatti ed equilibrati, mentre variabili correlate possono ridurre l'informazione effettiva fornita da ciascun campione.
Le indicazioni di AWS preferiscono fermarsi quando la simulazione rispetta una tolleranza di errore, incluso l'errore standard della media, invece di scegliere in anticipo un numero fisso. Questo approccio si adatta anche al data engineering, dove una stima di KPI e un percentile di rischio SLA possono richiedere precisioni diverse. Per un approfondimento sui relativi metodi statistici per l'analisi dei dati, collegate il controllo di convergenza all'uso previsto della metrica.
Un controllo pratico della convergenza
Registrate la media progressiva e i percentili delle code inferiore e superiore a checkpoint regolari. Lo schema seguente effettua un controllo ogni 500 iterazioni e vi fornisce valori da tracciare e confrontare.
Tracciate le tre serie registrate. Aumentate il numero di esecuzioni finché la media progressiva ed entrambe le linee delle code non sono abbastanza stabili per la decisione, come una scelta di capacità, un impegno finanziario o una revisione dello SLA.
Una tolleranza interna utile può essere un errore standard relativo inferiore all'1–2% per le stime puntuali e inferiore al 5% per i percentili delle code. Sono obiettivi operativi, non garanzie matematiche. Documentate perché sono adatti al caso d'uso, in particolare quando l'output incide sulla pianificazione della produzione o sulla remediation della qualità dei dati.
Errori comuni e controlli di validazione
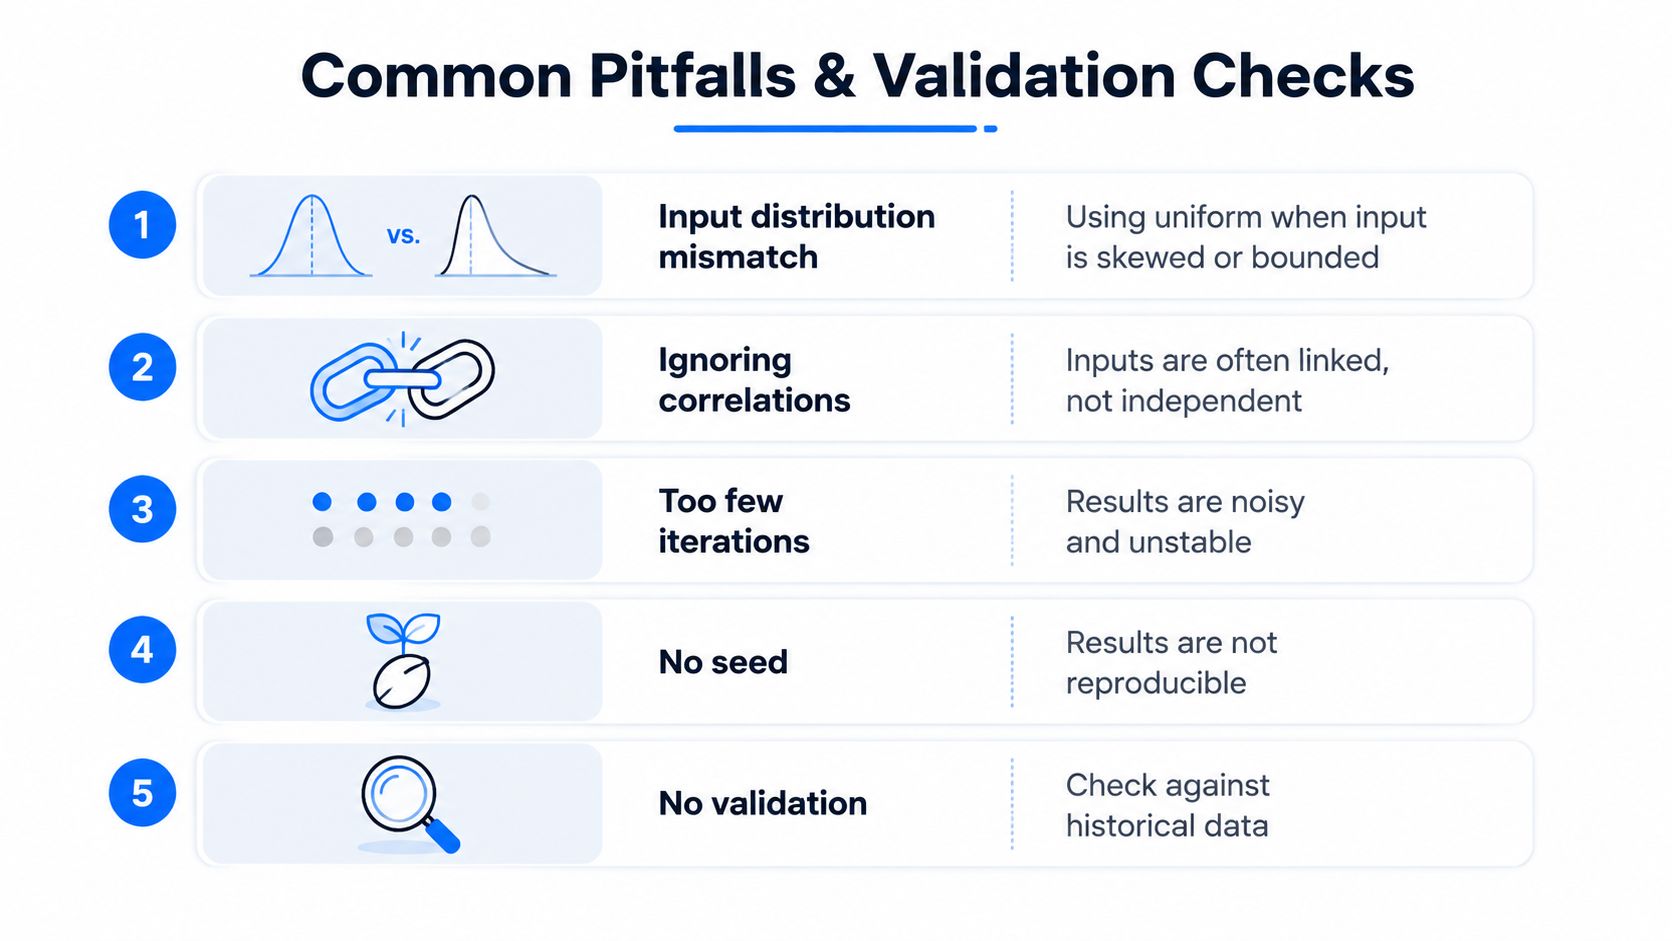
Una simulazione può produrre un istogramma impeccabile ed essere comunque sbagliata. La maggior parte degli errori nasce prima del ciclo casuale, nelle ipotesi che definiscono gli input e le relazioni.
Adattate le distribuzioni ai dati
Il campionamento uniforme è allettante perché è semplice, ma afferma che ogni valore dell'intervallo è ugualmente plausibile. Questo raramente si adatta a un input di business asimmetrico. Le trattative commerciali richiedono spesso ipotesi triangolari o di tipo PERT, mentre le misure operative positive possono richiedere una distribuzione asimmetrica a destra.
Usate le osservazioni storiche quando sono disponibili. Se lo storico è scarso, registrate il ragionamento alla base dei valori minimo, più probabile e massimo invece di presentare il giudizio degli esperti come un fatto misurato.
Preservate le relazioni tra gli input
Il campionamento indipendente può sovrastimare la diversificazione. Due opportunità di ricavo possono dipendere dallo stesso budget del cliente e due fasi della pipeline possono competere per le stesse risorse del data warehouse.
Modellate la dipendenza in modo esplicito. Una matrice di covarianza con decomposizione di Cholesky può generare campioni correlati, mentre flussi deterministici possono preservare relazioni note. Verificate la correlazione simulata rispetto alla relazione che intendevate rappresentare.
Rendete le esecuzioni riproducibili
Senza un seed, una nuova esecuzione cambia la sequenza casuale. Questo rende più difficile il debug e può creare disaccordi inutili tra i risultati di sviluppo e quelli di produzione.
Impostate un seed durante i test, registratelo con i metadati dell'esecuzione e usate flussi casuali controllati quando worker paralleli eseguono le simulazioni. Per il reporting in produzione, distinguete un'esecuzione di audit riproducibile da un insieme più ampio di esecuzioni indipendenti usate per valutare la variabilità del campionamento.
Validate prima di fidarvi dell'istogramma
Partite da un caso semplice la cui risposta può essere calcolata analiticamente. L'esempio di pi greco offre proprio questo tipo di controllo. In un modello dei ricavi, testate un portafoglio volutamente semplificato in cui il risultato atteso sia facile da ricavare. In un modello di pipeline, usate prima input fissi, poi introducete la variabilità un input alla volta.
Principio di validazione: una simulazione deve guadagnarsi la fiducia attraverso il confronto, non attraverso la cura grafica.
Infine, non pubblicate solo la media. Includete l'intervallo selezionato, le ipotesi sugli input, il seed o la configurazione dell'esecuzione e le evidenze di convergenza. Uno stakeholder deve sapere che cosa dice il modello e quanta fiducia riporvi.
Prima di condividere un risultato, verificate:
Adeguatezza degli input: le distribuzioni riflettono il comportamento osservato e limiti validi?
Dipendenze: sono stati modellati i fattori comuni e le correlazioni?
Riproducibilità: un altro ingegnere può rieseguire la stessa configurazione?
Convergenza: la media e i percentili rilevanti si stabilizzano?
Controllo di plausibilità: una versione semplificata corrisponde a un'aspettativa analitica o storica?
Comunicazione: intervalli, ipotesi e limiti sono visibili accanto alla stima puntuale?
Collegare la simulazione a qualità dei dati e osservabilità
La simulazione Monte Carlo non sostituisce il monitoraggio. Un sistema di data observability può far emergere record mancanti, problemi di freschezza, volumi insoliti, errori di validazione e modifiche di schema nel momento in cui si verificano. La simulazione risponde a una domanda diversa: quale incertezza a valle potrebbero introdurre queste condizioni in un KPI, in una dashboard o in una feature di machine learning?
Considerate un alert di freschezza su una tabella di origine. Il livello di monitoraggio registra il ritardo e il dataset interessato. Il team dati può quindi parametrizzare una simulazione con il comportamento di consegna osservato, gli schemi di completezza e la logica di dipendenza del KPI. Ogni esecuzione stima un risultato plausibile del KPI in quelle condizioni, producendo un intervallo di rischio che aiuta il team a stabilire le priorità di remediation.
Questa prioritizzazione è più utile del semplice conteggio degli alert. Un'anomalia minore in una tabella isolata può meritare un'attenzione meno immediata di un problema moderato di completezza che incide su una metrica regolamentare o su una dashboard del management. La simulazione collega l'evento tecnico all'esposizione del business.
Un workflow di produzione
Un'implementazione pratica può seguire questa sequenza:
Strumentate la pipeline: rilevate freschezza, volume, tassi di null, errori di validazione e modifiche di schema.
Create gli input del modello: convertite il comportamento di qualità osservato in distribuzioni con limiti e ipotesi espliciti.
Eseguite il modello del KPI: campionate gli input di qualità e calcolate la metrica interessata per ogni prova.
Memorizzate il risultato: salvate la configurazione dell'esecuzione, le informazioni sulla convergenza, l'intervallo degli output e il timestamp accanto alla dashboard.
Analizzate i fattori determinanti: usate l'analisi di sensitività per individuare quale condizione di qualità contribuisce maggiormente all'incertezza della metrica.
L'approccio dei metodi Monte Carlo per una migliore data observability collega queste previsioni probabilistiche ai segnali operativi di qualità. digna può combinare monitoraggio del comportamento dei dati, validazione, monitoraggio della tempestività, rilevamento delle anomalie e monitoraggio degli schemi all'interno dell'ambiente del cliente, consentendo ai team di mantenere i dati dove si trovano e di mettere in relazione le condizioni di qualità osservate con il rischio sulle metriche.
Iniziate da un KPI che gli stakeholder già mettono in discussione. Definitene le dipendenze a monte, raccogliete i segnali di qualità che lo influenzano ed eseguite una simulazione controllata con ipotesi documentate. Quando l'output si dimostra utile nell'analisi degli incidenti, aggiungetelo alla dashboard, così che gli stakeholder vedano sia lo stato attuale dei dati sia l'incertezza che circonda la metrica.
digna aiuta i team dati a monitorare qualità, tempestività, anomalie, risultati di validazione, modifiche di schema e metriche di business nel proprio ambiente, creando gli input operativi necessari per un'analisi consapevole dell'incertezza. Visitate digna per scoprire come la piattaforma può collegare i segnali di data observability ai metodi Monte Carlo per analytics più difendibili.
Domande frequenti
Qual è il ciclo Monte Carlo di base?
Quattro passaggi ripetuti molte volte: definire un sistema, generare input casuali, calcolare un risultato e ripetere. Tutto il resto, dalla scelta della distribuzione ai controlli di convergenza, è un perfezionamento di questo ciclo e non un metodo diverso.
Perché una stima puntuale è comoda ma fuorviante?
Perché è facile da visualizzare e discutere, ed è proprio per questo che sopravvive. Un totale di previsione piatto su una dashboard nasconde quanto di esso si basi su un piccolo numero di trattative incerte, e la variabilità mancante è di solito proprio la parte di cui la decisione ha bisogno.
A quali domande risponde la simulazione per una previsione dei ricavi?
A tre domande a cui un singolo numero non può rispondere: l'esposizione dei ricavi, cioè quanto potrebbero plausibilmente scendere i ricavi riconosciuti se le trattative incerte slittano; l'affidabilità della pianificazione, cioè quanta parte del totale dipende da poche opportunità; e la risposta operativa, cioè se rivedere le assunzioni o correggere prima i dati della pipeline.
Come si applica al data engineering?
Allo stesso modo. Simulare i tempi di esecuzione dei job e la loro variabilità aiuta un team a stimare il rischio di mancare uno SLA invece di affidarsi a un tempo di esecuzione medio, che è l'equivalente operativo della domanda sui ricavi.
Che cosa dovreste riportare agli stakeholder?
La previsione e l'incertezza che la circonda. Gli stakeholder possono agire su un intervallo quando capiscono che cosa lo determina, mentre un numero isolato invita a una falsa sicurezza o a una discussione su quale stima sia quella giusta.


