Ricerca con caratteri jolly: guida pratica per il 2026
|
9
min di lettura

La maggior parte dei consigli sui caratteri jolly (wildcard) vi dice di memorizzare i simboli e passare oltre. Questa scorciatoia si rompe in produzione, perché il problema nasce di solito quando il motore smette di trattare il vostro pattern come un wildcard proprio nel momento in cui vi serve di più. Il risultato sono corrispondenze mancate, un recall rumoroso o una query che sembra innocua ma impone una scansione lenta sull'intero sistema.
Indice
Perché la ricerca con wildcard è una decisione operativa, non solo un trucco di sintassi
I quattro simboli wildcard canonici e che cosa trovano
Sequenze di lunghezza qualsiasi
Caratteri singoli e classi di caratteri
Alternanza e strutture simili alle regex
La sintassi wildcard nelle diverse piattaforme in sintesi
Pattern di query reali per l'esplorazione e la validazione dei dati
Alcuni pattern che valgono la pena
Prestazioni, indicizzazione e costo di un wildcard iniziale
Due accorgimenti che aiutano davvero
Dove i wildcard smettono di funzionare e come accorgersene
Verifiche rapide che rivelano la modalità di errore
Una checklist pratica sui wildcard prima di premere Esegui
Perché la ricerca con wildcard è una decisione operativa, non solo un trucco di sintassi
Un tecnico di supporto digita *error* in una casella di ricerca, si aspetta che emerga ogni riga di log rumorosa e non ottiene nulla, oppure un timeout, oppure un insieme di risultati che ignora del tutto il wildcard. Questo tipo di errore è più comune di quanto molti team ammettano, perché la gestione dei wildcard cambia con la piattaforma, l'indice e la pipeline dell'analyzer. Lo stesso pattern può comportarsi in un modo in SQL, in un altro in una shell e in un terzo modo ancora in un motore di ricerca.
La ricerca con wildcard va trattata come una scelta operativa, non come una funzionalità di comodità. La documentazione di Microsoft su SQL Server mostra che % può trovarsi all'inizio, a metà o alla fine di un pattern e che _ corrisponde esattamente a un carattere, mentre anche gli intervalli tra parentesi quadre come [a-f] sono validi nei pattern LIKE come documentato da Microsoft. Gli strumenti enterprise mantengono viva la stessa idea nella ricerca rivolta agli utenti, perché le corrispondenze parziali sono utili quando non si conosce la grafia esatta, ma il compromesso è sempre lo stesso: un recall più ampio significa di solito più carico e più spazio per discrepanze silenziose.
Regola pratica: non chiedetevi se i wildcard sono supportati. Chiedetevi se la query si comporta ancora come un wildcard dopo tokenizzazione, virgolette, escape e selezione dell'indice.
Il resto del problema è più semplice da inquadrare che da risolvere. Dovete conoscere i simboli fondamentali, come differiscono tra le piattaforme, dove le prestazioni crollano e quali sistemi smettono del tutto di espandere il pattern. È la parte che la maggior parte delle guide sui wildcard salta, ed è quella che conta quando il vostro editor di query è collegato alla produzione. Per i team che gestiscono l'affidabilità dei dati è lo stesso tipo di disciplina che si applica ai controlli su lineage e freschezza, ed è per questo che uno strumento come la piattaforma di data observability di digna rientra nella stessa discussione, anche se il problema della ricerca in sé si trova altrove.
I quattro simboli wildcard canonici e che cosa trovano
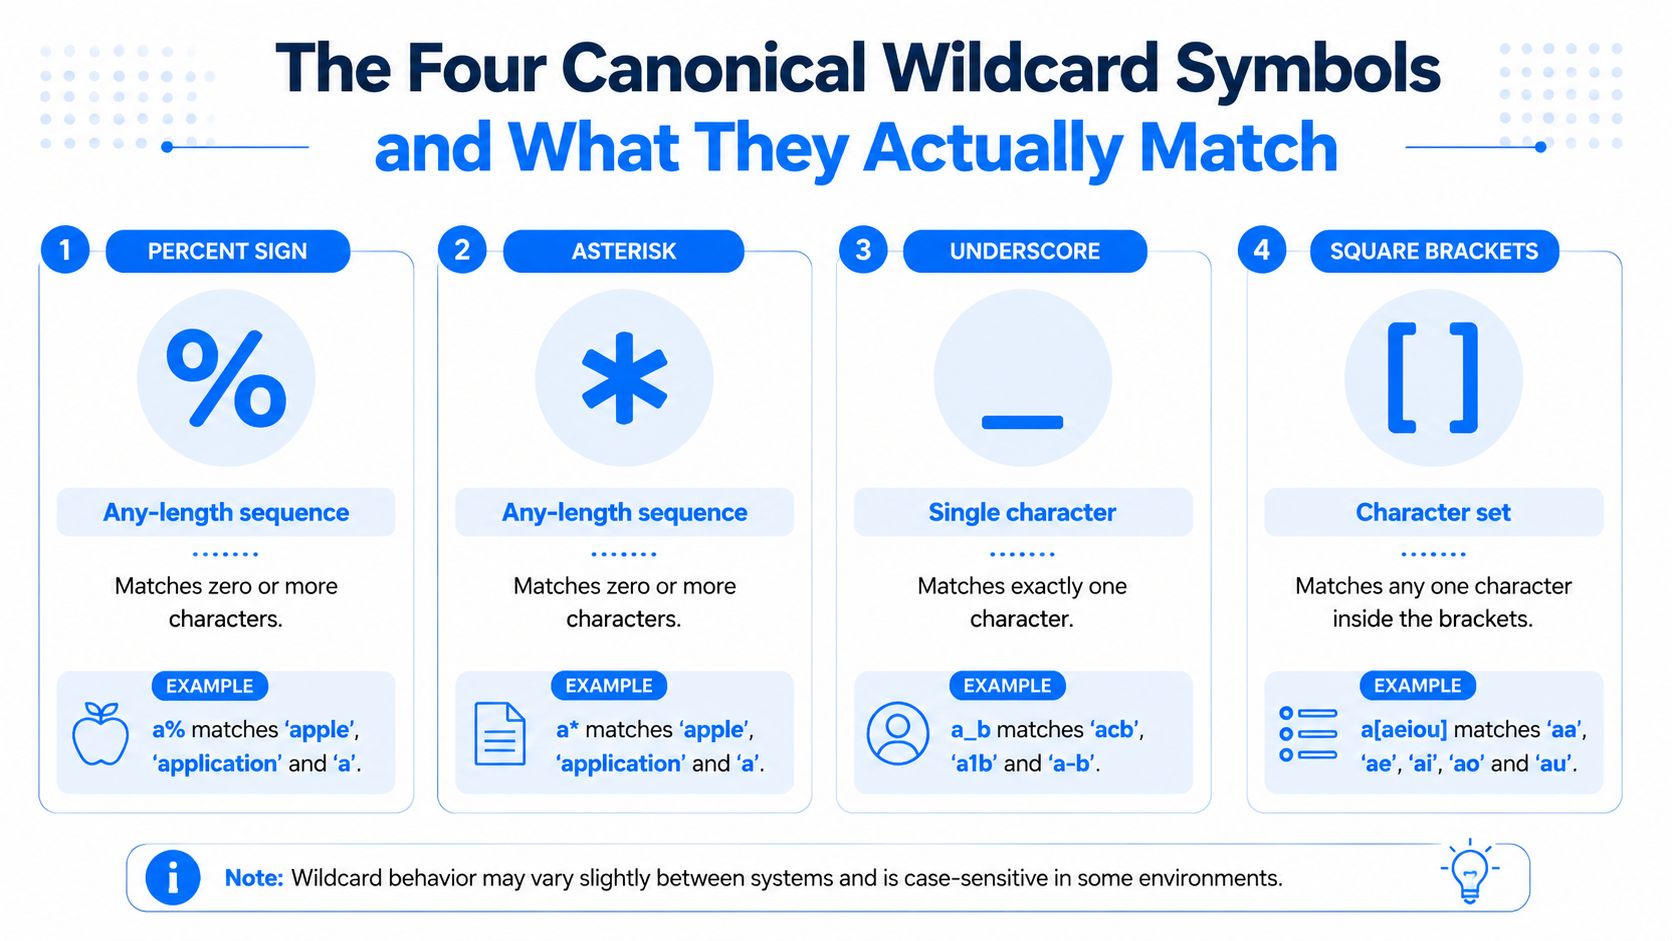
Il modo più sicuro di ragionare sulla sintassi wildcard è in base al significato, non al simbolo. In SQL, nei glob della shell e nei motori di ricerca la stessa intenzione compare sotto caratteri diversi, e il motore può smettere di trattare quel carattere come un wildcard non appena entrano in gioco tokenizzazione, virgolette o escape.
Sequenze di lunghezza qualsiasi
In SQL, % corrisponde a zero o più caratteri. Un pattern come LIKE 'cust%' troverà customer_id, cust e custodian, perché alla corrispondenza interessa solo che il testo inizi con cust. In una shell POSIX l'intenzione equivalente è di solito *, quindi ls /var/log/*.log seleziona i file che terminano con .log.
I motori di ricerca riprendono spesso la stessa idea con * o %, a seconda del linguaggio di query. La ricerca nella cronologia di SQL Prompt di Redgate usa * per zero o più caratteri e il filtro della cronologia di Teradata usa % con lo stesso ruolo, ed è per questo che la sintassi wildcard risulta familiare anche quando cambia la superficie del prodotto documentazione di Teradata sul filtro con wildcard.
Caratteri singoli e classi di caratteri
_ in SQL e ? nelle shell e in molti strumenti di ricerca corrispondono esattamente a un carattere. Questo conta quando conoscete la forma del valore ma non il carattere esatto in una posizione. status_1 e status?1 sono entrambi strumenti di precisione, non di ricerca approssimativa.
Le parentesi quadre permettono di definire una classe di caratteri. SQL Server supporta intervalli tra parentesi quadre come [a-f], e Teradata supporta insiemi tra parentesi quadre come [xyz] e [0-5] nel suo filtro della cronologia documentazione di Microsoft sui wildcard in SQL Server.
Alternanza e strutture simili alle regex
Le barre verticali compaiono più spesso nelle regex che nella sintassi wildcard pura. In un campo di ricerca, status:[active|pending] è un pattern comune per l'alternanza nei sistemi in stile query string, mentre un pattern per le email può appoggiarsi a insiemi di caratteri in stile regex quando la sintassi wildcard non è abbastanza espressiva. La regola utile è semplice: i wildcard servono per la forma, le regex per la struttura.
Usate un wildcard quando la parte sconosciuta è ampia ma semplice. Usate la corrispondenza esatta quando conoscete il valore. Ricorrete alle regex complete solo quando vi servono alternanza, raggruppamento o validazioni che un glob non può esprimere in modo pulito.
Per un rapido confronto prima di digitare, la panoramica di digna sul data profiling è un modello mentale utile, perché spinge verso la stessa abitudine: verificare la forma prima di fidarsi del risultato.
La sintassi wildcard nelle diverse piattaforme in sintesi
La stessa intenzione, trovare gli identificativi che iniziano con INV, si traduce in sintassi diverse a seconda della piattaforma. Questa differenza conta perché la stessa forma di query può produrre caratteristiche di recall, ranking e carico molto diverse quando si passa tra SQL, motori di ricerca e shell.
Piattaforma | Qualsiasi stringa | Carattere singolo | Insieme di caratteri | Escape del letterale | Esempio, inizia con |
|---|---|---|---|---|---|
SQL Server |
|
|
|
|
|
Filtro della cronologia di Teradata |
|
|
| Negli esempi il |
|
Pattern matching di PostgreSQL |
|
| classi regex per corrispondenze avanzate |
|
|
Query string di Elasticsearch |
|
| in stile regex solo con query regex | Escape dei caratteri di query riservati |
|
Wildcard di OpenSearch |
|
| nessun sistema di classi, usate regex o altri tipi di query | Escape accurato dei caratteri riservati |
|
Splunk SPL | operatori di ricerca, non | n/d | funzioni regex o parsing in fase di ricerca | dipende dal comando di ricerca |
|
Shell POSIX |
|
|
| mettete i pattern tra virgolette per bloccarne l'espansione |
|
I punti di attrito contano più dei simboli. Il filtro di Teradata tratta le corrispondenze wildcard senza distinzione tra maiuscole e minuscole e supporta la gestione del simbolo di percentuale letterale in esempi documentati come %[%]%, un buon promemoria del fatto che gli strumenti enterprise spesso estendono la grammatica oltre l'SQL da manuale. SQL Server mantiene LIKE come modello di base, mentre OpenSearch ed Elasticsearch riservano * e ? nella sintassi delle query e possono bloccare per impostazione predefinita il comportamento dei wildcard iniziali. Per una visione più ampia di come la forma della query incide sul costo di esecuzione, la guida di digna all'ottimizzazione SQL è una lettura complementare utile.
Un wildcard è portabile come idea, non come carattere. Ogni motore rimappa quell'idea al proprio confine, e la modalità di errore tipica è una query che sembra corretta ma perde record o sollecita l'indice molto più del previsto.
Pattern di query reali per l'esplorazione e la validazione dei dati
Le query che ripagano qui sono di solito quelle che scrivete una volta, esaminate e poi eliminate dopo l'audit. Le query migliori in questo contesto sono volutamente banali e facili da rimuovere una volta completata la validazione.
Alcuni pattern che valgono la pena
Per la validazione delle email in SQL Server, un pattern con parentesi quadre basta spesso per un triage rapido, anche se non è un validatore RFC completo. Un esempio pratico è LIKE '%@[A-Za-z0-9.-]%\.com', un filtro grossolano per indirizzi che terminano con .com e presentano una forma plausibile di parte locale e dominio. Non sostituisce una regola di validazione dedicata, ma funziona bene quando state controllando un caricamento alla ricerca di corruzioni evidenti.
Per il lavoro in shell il pattern può restare più semplice. Un controllo di archiviazione su Linux come find . -type f \( -name "*.csv" -o -name "*.json" \) -mtime +7 isola in modo pulito i file CSV e JSON obsoleti, perché il wildcard gestisce la selezione dei nomi dei file e il filtro sulla data gestisce il controllo del ciclo di vita. Questa separazione mantiene il pattern leggibile e l'insieme dei risultati circoscritto.
In OpenSearch, una ricerca di codici prodotto come { "wildcard": { "sku": "*aa*" } } trova gli SKU con due vocali consecutive al centro, ma solo se il campo è mappato in modo da supportare la ricerca con wildcard. È un pattern di audit utile quando volete verificare se i sistemi a monte hanno introdotto forme di codice inattese.
Regola pratica: usate il wildcard più ristretto che dimostra ciò che vi serve. Se conoscete già il prefisso o il suffisso, ancoratelo. Se non vi serve una corrispondenza interna, evitatela.
Quando verifico il comportamento della ricerca per una dashboard o una revisione, cerco la query più piccola che riveli ancora il difetto. La stessa disciplina si ritrova in attività come aumentare la visibilità del brand nell'AI, dove la mossa utile è controllare la forma della query prima che il sistema si espanda troppo.
Caso d'uso | SQL LIKE | Glob della shell | Motore di ricerca |
|---|---|---|---|
Audit delle email |
| n/d | regex o ricerca per campi |
Pulizia dei file | n/d |
| query sui metadati dei file indicizzati |
Controllo della forma degli SKU |
|
|
|
Validazione del prefisso |
|
|
|
I controlli migliori in questo ambito sono mirati, temporanei e facili da rimuovere una volta che i dati superano la revisione. È la stessa mentalità alla base della guida di digna alla pulizia dei dati in SQL, perché entrambi i lavori riescono meglio quando confermate la forma prima di allargare la ricerca.
Prestazioni, indicizzazione e costo di un wildcard iniziale
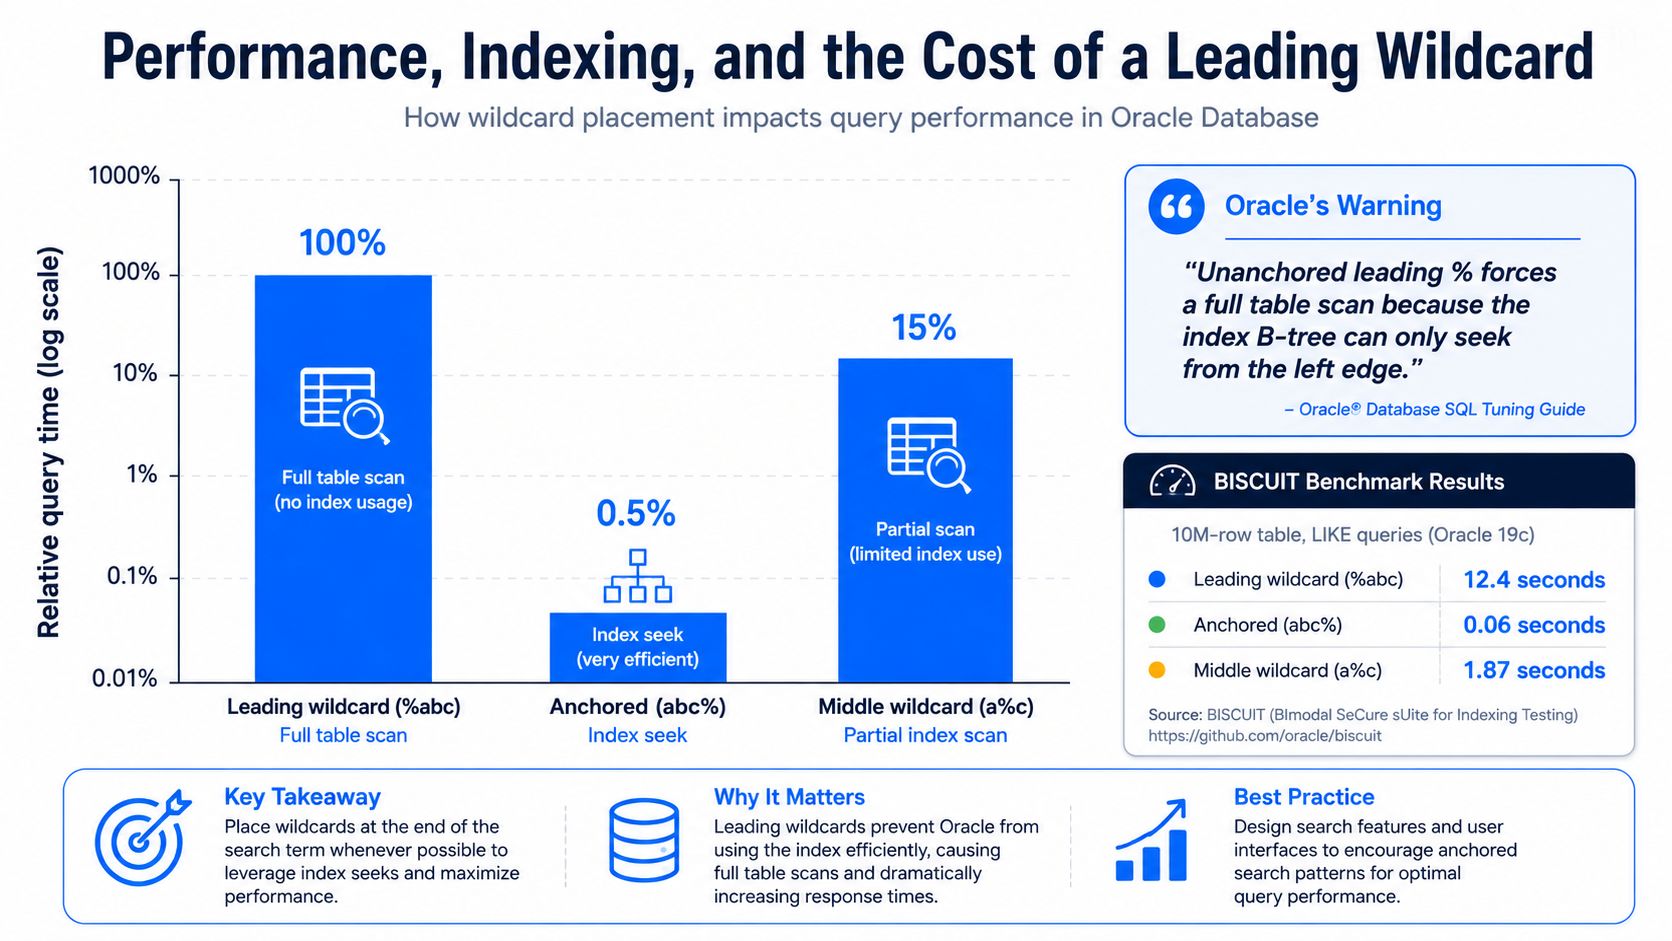
Un wildcard iniziale cambia il percorso di esecuzione, e il costo si manifesta rapidamente. Oracle avverte che ricerche come a*, o query composte solo da wildcard o punteggiatura, possono richiedere molto tempo, e raccomanda di usare almeno da 2 a 3 caratteri non wildcard prima dell'esecuzione indicazioni di Oracle sui wildcard.
Il motore può effettuare una ricerca partendo dal bordo sinistro, quindi abc% resta compatibile con l'indice mentre %abc di solito no. Quando il pattern smette di offrire all'indice un prefisso stabile, la query passa da una ricerca rapida a una scansione. Nel benchmark BISCUIT, i pattern wildcard di suffisso e infisso sono stati eseguiti in 2,2-28,9 ms contro 34,97-189,3 ms per Trigram/B-tree nel benchmark pubblicato, e la suite riporta uno speedup mediano di 14,4× rispetto all'indicizzazione B-tree con una correttezza del 100% su 11.400 misurazioni benchmark BISCUIT. Il compromesso è lo spazio di archiviazione, perché l'indice era circa 10× più grande di Trigram benchmark BISCUIT.
I motori di ricerca seguono lo stesso schema, anche se la loro implementazione interna è diversa. Un * iniziale elimina il percorso facile ancorato a sinistra, quindi il motore deve valutare più termini e può mettere sotto pressione i nodi coordinatori e i meccanismi di salvaguardia sull'espansione documentazione di Elasticsearch sui wildcard documentazione di OpenSearch sui wildcard. Ecco perché “basta aggiungere un wildcard” diventa un'abitudine costosa sugli indici di grandi dimensioni.
Due accorgimenti che aiutano davvero
Indici trigram o n-gram: usateli quando le corrispondenze parziali sono frequenti e su larga scala. Offrono al motore una struttura su cui cercare invece di imporre una scansione completa.
Indici su campi invertiti per le ricerche per suffisso: se gli utenti cercano per terminazione, memorizzate una copia invertita della stringa e ancorate il wildcard sul lato sinistro del campo invertito. In questo modo un problema di suffisso diventa un problema di prefisso.
Un pattern SQL comune per l'approccio con campo invertito è semplice:
Per le corrispondenze parziali in PostgreSQL, l'indicizzazione trigram è lo strumento principale:
Il concetto chiave è semplice. Il motore ha bisogno di aiuto non appena ci si allontana dal bordo sinistro. La guida di digna all'ottimizzazione delle query SQL mantiene questa discussione ancorata al costo di esecuzione anziché alla sintassi dei pattern.
Dove i wildcard smettono di funzionare e come accorgersene
La sintassi wildcard può fallire senza generare errori, il che è peggio di un evidente errore di sintassi, perché la query sembra valida. SharePoint e alcuni strumenti di ricerca enterprise rimuovono per impostazione predefinita i wildcard iniziali, quindi una ricerca che sembra ampia può trasformarsi invece in una ristretta ricerca per prefisso guida ai prodotti CAS sui wildcard.
Le frasi tra virgolette sono un'altra trappola. Molti sistemi trattano i wildcard tra virgolette doppie come testo letterale, quindi "apple%" può cercare la stringa esatta apple% invece di espandere il pattern. Il comportamento dei wildcard in PubMed mostra anche un problema più sottile: l'uso dei wildcard può interrompere la mappatura automatica dei termini, cambiando il recall in modi difficili da individuare finché qualcuno non confronta i risultati a mano.
Verifiche rapide che rivelano la modalità di errore
Wildcard iniziale rimosso: eseguite
app%e confrontatelo con%app%sullo stesso corpus. Se il numero di risultati cambia appena, la piattaforma potrebbe riscrivere la vostra query.Wildcard ignorato tra virgolette: testate
"apple%"rispetto aapple%senza virgolette e confrontate la spiegazione della query grezza, se la piattaforma la rende disponibile.Regola del prefisso minimo applicata: provate un pattern con un solo carattere non wildcard. Alcuni sistemi richiedono almeno 3 caratteri non wildcard o limitano a un wildcard per termine.
Espansione limitata o bloccata: alcuni motori di ricerca aggiungono meccanismi di salvaguardia che limitano l'espansione dei wildcard quando il pattern si allargherebbe troppo.
Comportamento diverso su maiuscole e minuscole: una piattaforma può trattare per impostazione predefinita le corrispondenze wildcard senza distinzione tra maiuscole e minuscole, mentre un'altra espone questo comportamento come opzione. Lo stesso input può restituire risultati diversi nei vari sistemi.
La maggior parte degli errori con i wildcard deriva da aspettative non allineate, non da errori di logica.
Il modo più rapido per individuarli è testare lo stesso pattern su un dataset piccolo e noto prima di promuoverlo in una dashboard condivisa o in una ricerca salvata. Un piccolo insieme di validazione mostra se il motore riscrive la query, elimina il wildcard o restituisce un insieme di risultati che sembra plausibile ma manca dei record attesi.
Una checklist pratica sui wildcard prima di premere Esegui
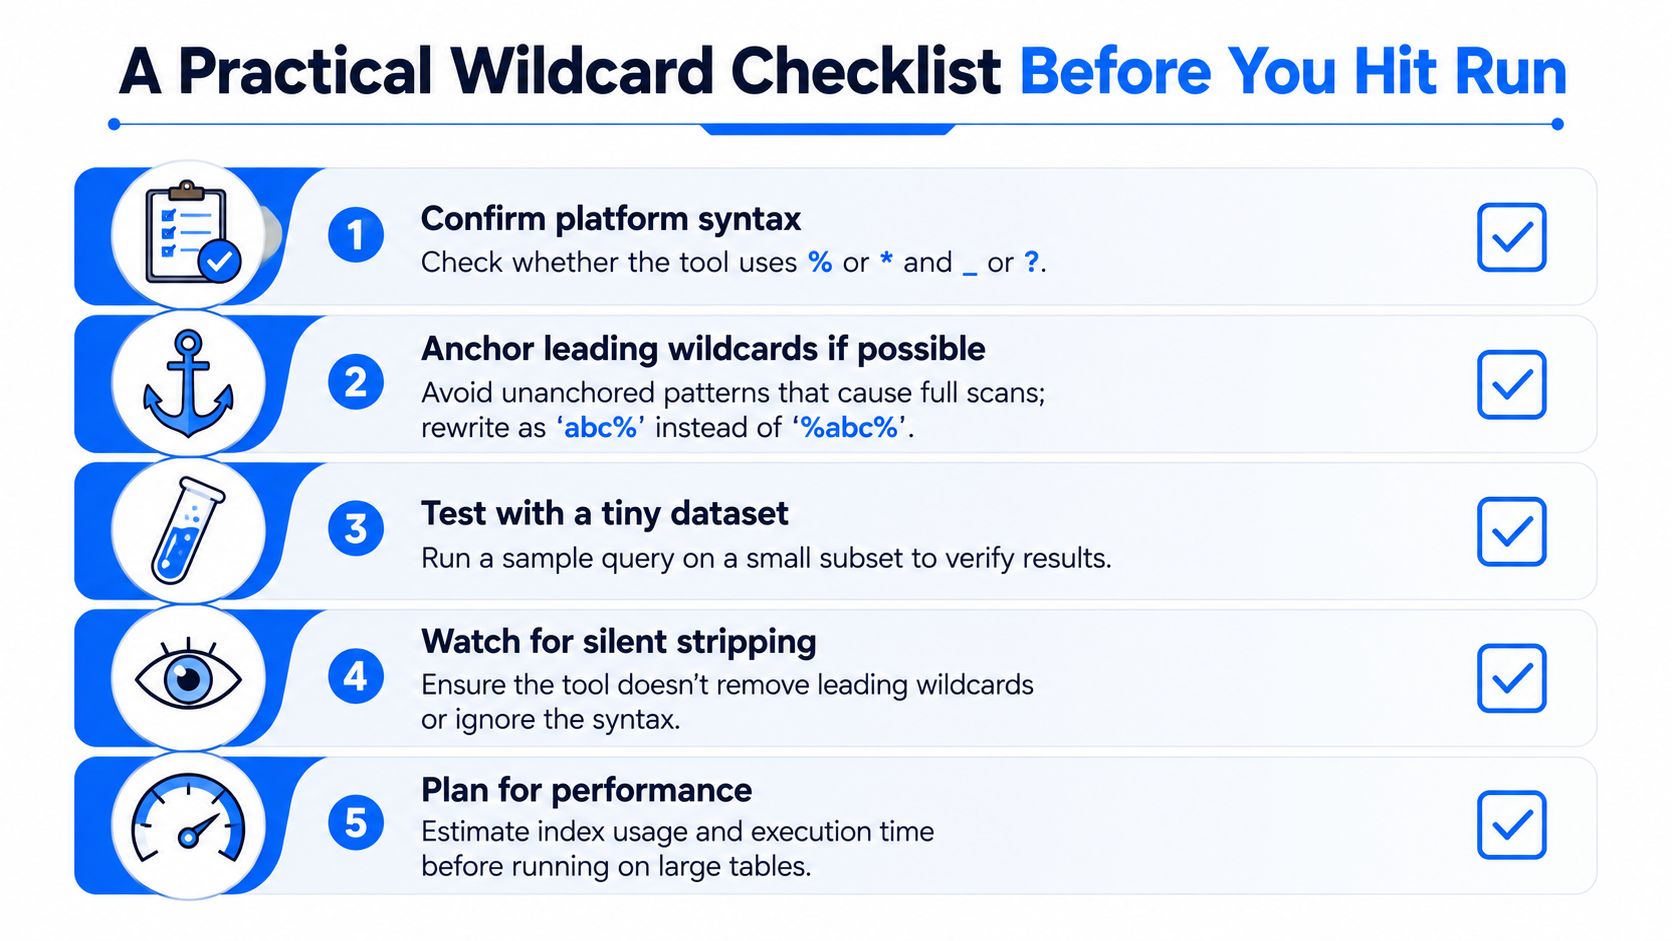
Prima di inviare una query con wildcard, verificate innanzitutto le regole della piattaforma. Controllate se usa % o *, se _ o ? corrisponde a un singolo carattere e se parentesi quadre, virgolette o altri simboli riservati cambiano il parsing.
Poi esaminate il pattern stesso. Applicate l'escape ai caratteri speciali prima che raggiungano il parser e assicuratevi che la query sia abbastanza ristretta da poter essere gestita dal motore senza una scansione ampia. Se il pattern verrà eseguito in una dashboard condivisa, confermate che filtri sulle date, limiti di righe e idoneità degli indici si applichino ancora.
La governance conta altrettanto. Verificate che la query sia registrata nei log, validata rispetto allo schema di destinazione e testata contro il rischio di injection se una parte del pattern proviene dall'input degli utenti. Una query con wildcard dovrebbe essere facile da spiegare al prossimo ingegnere senza dover riaprire il canale degli incidenti.
Applicate questa checklist ogni volta. La maggior parte degli errori con i wildcard viene intercettata prima dell'esecuzione.
Domande frequenti
Quali sono i quattro simboli wildcard canonici?
Ragionate in base al significato anziché al simbolo. Le sequenze di lunghezza qualsiasi usano % in SQL o * in molti motori di ricerca, i caratteri singoli usano _ in SQL o ? altrove e le classi di caratteri usano le parentesi quadre. La quarta categoria è il meccanismo di escape che permette di cercare i simboli stessi.
Che cosa trova esattamente % in SQL?
Zero o più caratteri, e può trovarsi all'inizio, a metà o alla fine di un pattern. LIKE 'cust%' trova customer_id, cust e custodian, perché alla corrispondenza interessa solo che il testo inizi con cust, non ciò che segue.
Le classi di caratteri funzionano ovunque allo stesso modo?
In linea di massima sì, con differenze tra prodotti. SQL Server supporta intervalli tra parentesi quadre come [a-f] nei pattern LIKE e Teradata supporta insiemi tra parentesi quadre come [xyz] e [0-5] nel suo filtro della cronologia, ed è per questo che la sintassi wildcard risulta familiare anche quando cambia la superficie del prodotto.
Perché la ricerca con wildcard è una decisione operativa?
Perché il supporto dei wildcard non è la vera domanda. Chiedetevi piuttosto se la query si comporta ancora come un wildcard dopo tokenizzazione, virgolette, escape e selezione dell'indice. In particolare, un wildcard iniziale può trasformare una ricerca indicizzata in una scansione completa senza alcun errore di sintassi.
Perché una ricerca con wildcard non restituisce nulla o va in timeout?
Di solito perché è intervenuto uno di questi livelli. Digitare *error* e non ottenere nulla, ottenere un timeout o un insieme di risultati che ignora del tutto il wildcard sono tre sintomi della stessa causa: il pattern è stato riscritto oppure l'indice non è riuscito a gestirlo.


