PERCHÉ LA PLATFORM OBSERVABILITY È IMPORTANTE
La vostra piattaforma ha dei pattern. Leggeteli.
Man mano che i workload cambiano e i volumi crescono, digna definisce una baseline per ciascuno di essi e monitora costi, tempi di esecuzione e volumi rispetto a essa. La crescita diventa un trend che potete spiegare. Tutto il resto emerge come deviazione.
Le piattaforme raramente diventano inefficienti da un giorno all'altro.
Le piattaforme raramente diventano inefficienti da un giorno all'altro. Databricks, Snowflake e Teradata sono progettate per scalare. La complessità cresce con loro, e lo fa in silenzio.
Complessità crescente
Nuovi workload, volumi maggiori, query più complesse.
Cambiamenti senza errori
Deriva dei costi e instabilità dei tempi di esecuzione, senza che nulla fallisca e senza che scatti alcun alert.
Risorse che cambiano
I pattern di utilizzo evolvono e ciò che ieri era normale smette di essere un riferimento.
Oltre lo stato di salute istantaneo
Il monitoraggio vi dice che la piattaforma è attiva. L'observability vi dice come sta cambiando.
Dalle metriche alla comprensione del comportamento
Le metriche grezze vi dicono cosa è successo. L'analisi del comportamento vi aiuta a capire cosa è cambiato. Il valore di una singola metrica offre un contesto limitato. Una query ha impiegato 18 minuti. È un problema? Dipende da ciò che accade normalmente. Se la stessa query di solito impiega 3 minuti, la variazione è significativa. Se di solito ne impiega 20, può essere del tutto normale. digna Data Anomalies identifica le deviazioni inattese; digna Data Analytics mostra come la metrica sottostante evolve nel tempo.
Monitoraggio tradizionale
Uptime del sistema
Successo o fallimento dei job
Utilizzo istantaneo
Alert basati su soglie
digna Observability
Cambiamenti di comportamento nel tempo
Aumenti graduali dei costi
Variabilità dei tempi di esecuzione
Workload drift e inefficienze nascoste
FUNZIONALITÀ MODULARI
Sfide di piattaforma diverse. Combinate le funzionalità di cui avete bisogno.
Costi, prestazioni, stabilità. Ogni ambiente dà a ciascuno un peso diverso.
Il comportamento della piattaforma è cambiato in modo inatteso?
digna Data Anomalies

Rilevate deviazioni nei tempi di esecuzione, nei consumi e nel comportamento dei workload.
È un trend o un caso isolato?
digna Data Analytics

Monitorate come costi, tempi di esecuzione e volumi evolvono nel tempo.
L'utilizzo resta entro i limiti?
digna Data Validation

Impostate soglie di consumo e ricevete un alert quando i workload le superano.
I dati della piattaforma sono arrivati?
Data Timeliness

Individuate dati di piattaforma mancanti, in ritardo o fuori dal pattern abituale.
Combinate queste e altre funzionalità di digna per costruire la soluzione di observability più adatta al vostro ambiente. Monitorate ciò che conta. Rilevate i cambiamenti inattesi. Comprendete come evolve la vostra piattaforma prima che le criticità diventino problemi operativi.
SEGNALI DELLA PIATTAFORMA
Cosa potete osservare?
Monitorate i segnali che contano per la vostra piattaforma.
ESTENDETE DIGNA
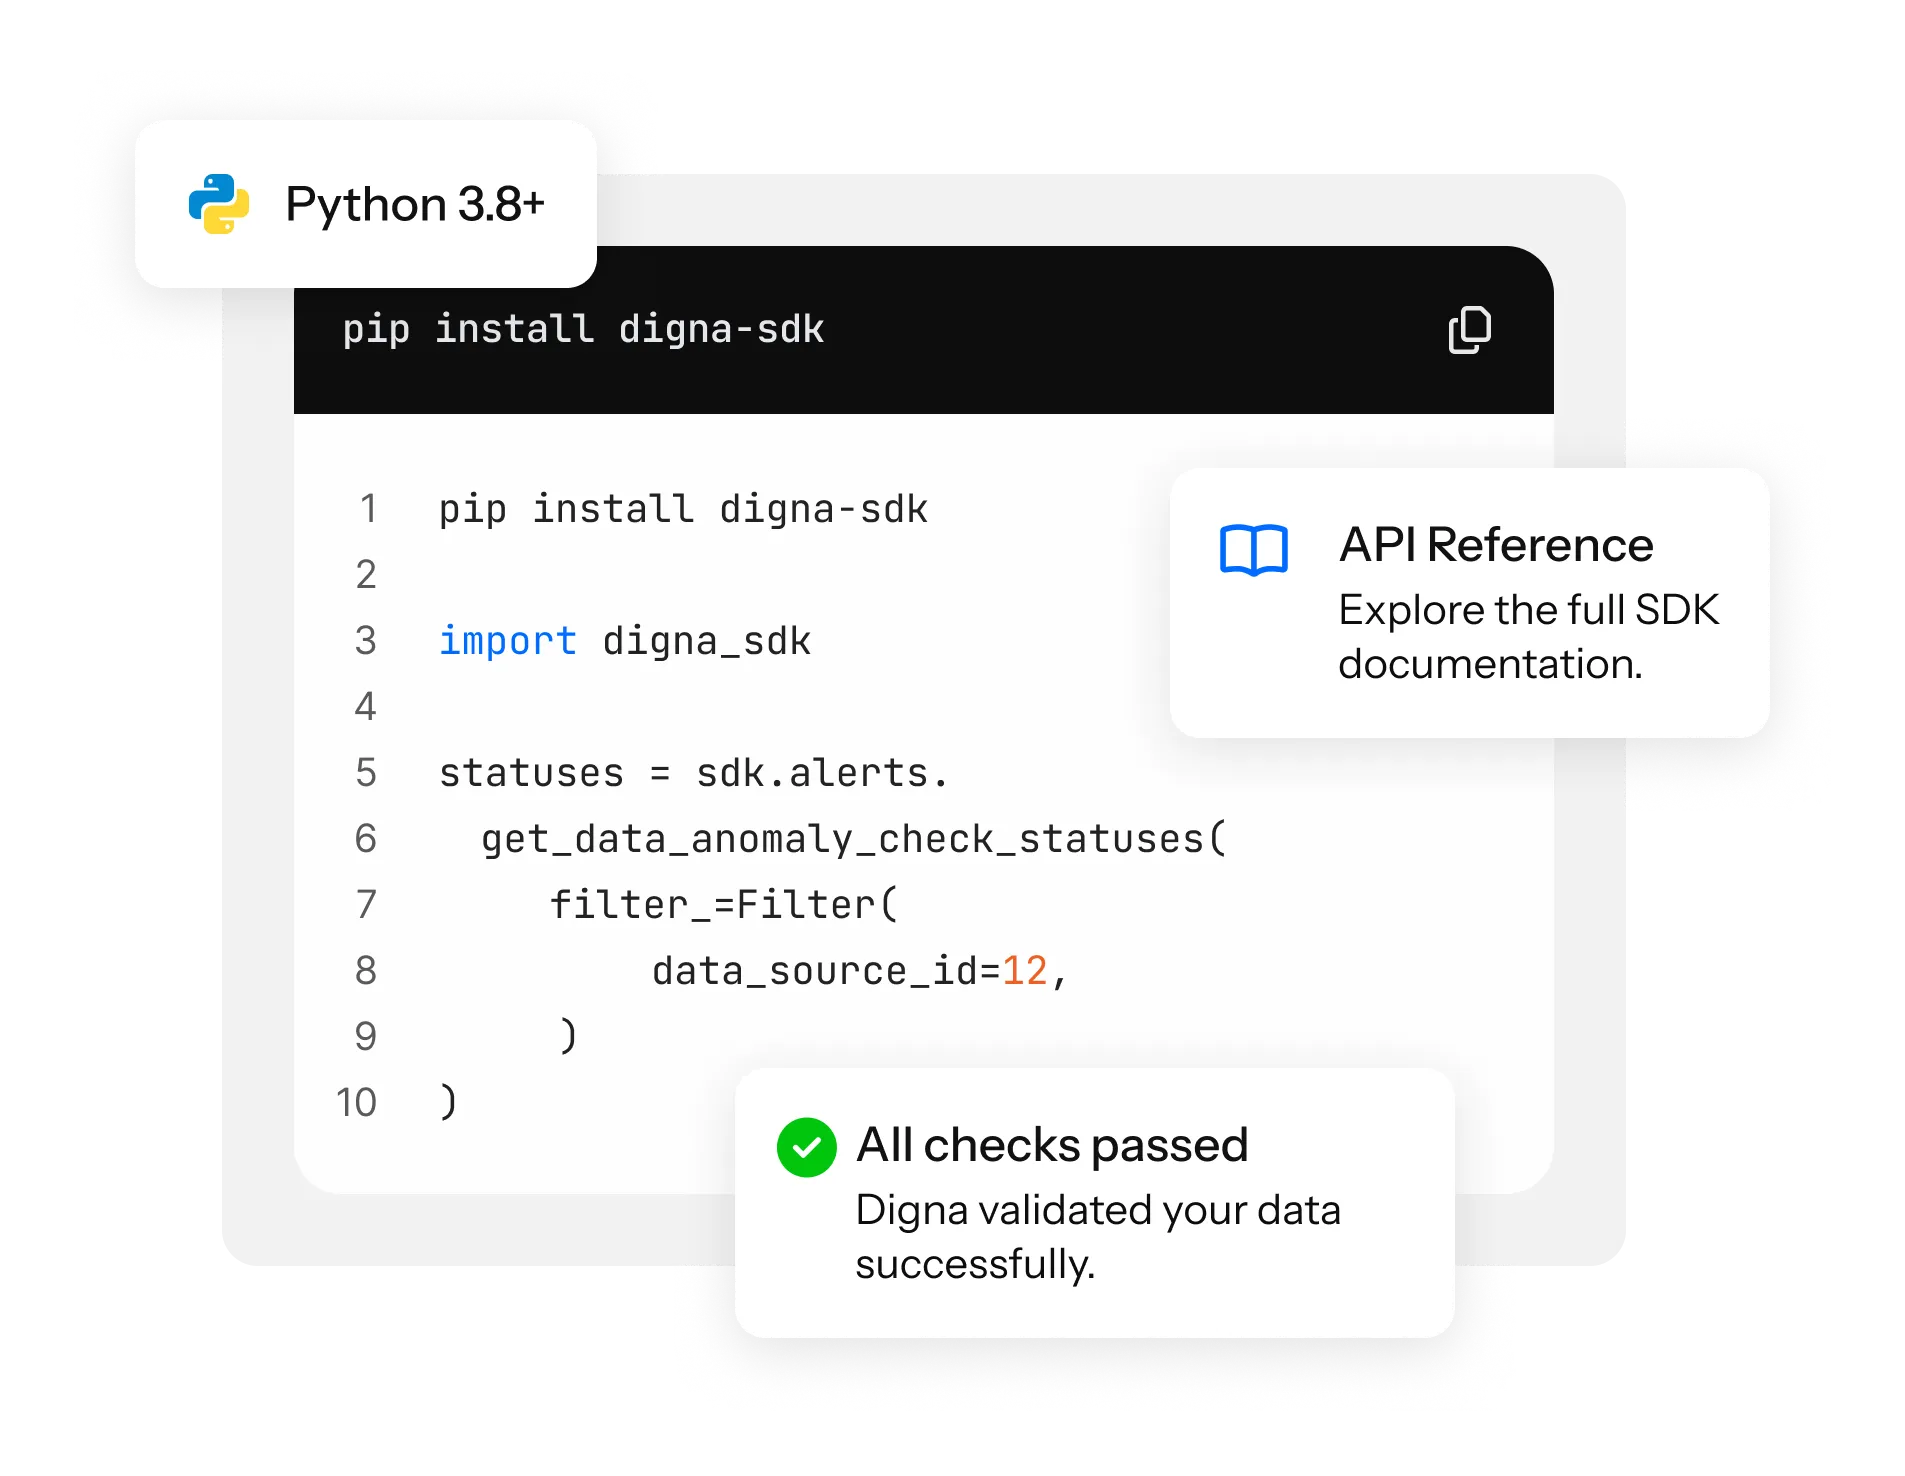
Sviluppate ed estendete con il digna Python SDK.
Integrate l'observability nei vostri workflow. Lavorate con digna in modo programmatico in applicazioni, pipeline e processi operativi.
RISORSE
Scoprite i whitepaper sulla platform observability.
Approfondimenti pratici per le moderne piattaforme dati. Anomaly detection dei costi Databricks — Come nascono le anomalie nei costi e come digna rileva picchi, derive e workload instabili.