Osservabilità della qualità dei dati: guida pratica per i team dati
|
8
min di lettura

Conoscete già quella sensazione. Alle 6:45 una dashboard sembra in perfetta salute, alle 8:00 i numeri non tornano, il VP chiede perché i ricavi sono cambiati durante la notte e il team dati sta ripercorrendo i log delle pipeline mentre tutti gli altri aspettano una risposta. Questo è il data downtime, ed è uno dei modi più rapidi per trasformare un livello di reporting affidabile in un rischio.
L'osservabilità della qualità dei dati cambia questo approccio. Invece di aspettare che le dashboard si rompano, osserva il comportamento dei dati mentre si muovono, così i team possono intercettare ritardi di freschezza, schema drift, variazioni di volume ed errori di validazione prima che si propaghino nelle decisioni. L'obiettivo non è avere più alert, ma un segnale più tempestivo, un triage più pulito e meno tempo passato a spiegare perché dei numeri non ci si può fidare.
Indice
Il costo nascosto dei dati difettosi
Un incidente del lunedì mattina raramente inizia in modo drammatico. Inizia con una tabella non aggiornata, un caricamento mancante o una silenziosa modifica allo schema che nessuno ha notato in tempo. Quando il problema emerge, il danno ha già superato il data warehouse ed è arrivato al business.
È facile sottovalutare la portata del problema. Un sondaggio Wakefield Research del 2023 commissionato da Monte Carlo ha rilevato che gli incidenti mensili sui dati sono passati da 59 nel 2022 a 67 nel 2023, con un aumento del data downtime di 1,89 volte, e che il 68% degli intervistati ha impiegato quattro ore o più per rilevare gli incidenti. Lo stesso sondaggio ha riportato un tempo medio di risoluzione di 15 ore per incidente, e oltre la metà degli intervistati ha dichiarato che almeno il 25% dei ricavi era esposto a problemi di qualità dei dati, con la quota media di ricavi interessati salita al 31% dal 26% dell'anno precedente, come riportato in una panoramica di mercato della categoria nel report sul mercato della data observability.
Come si presenta nella pratica
Un analista finanziario aggiorna una presentazione per il consiglio di amministrazione e nota un numero che non corrisponde all'export del giorno prima. Un data engineer controlla i log di orchestrazione e vede che la pipeline si è completata, il che è peggio, non meglio, perché il problema ora si nasconde nel contenuto e non nello stato del job. Il team inizia a confrontare il numero di righe, a cercare modifiche allo schema e a scrivere a responsabili che potrebbero non sapere nemmeno di aver causato il guasto.
Regola pratica: se il primo segnale di un problema è la domanda di un utente di business, il livello di monitoraggio è già troppo a valle.
Ecco perché l'observability è importante. Non sostituisce la root cause analysis e non rende magicamente corretti i dati. Vi dà un preavviso, così il team può smettere di trattare ogni incidente come una sorpresa e iniziare a gestirlo come un rischio operativo controllabile.

I team più solidi con cui ho lavorato hanno smesso di chiedersi “Perché si è rotta questa dashboard?” e hanno iniziato a chiedersi “Cosa è cambiato prima che la dashboard si rompesse?”. Tutto si gioca su questo cambio di prospettiva. L'osservabilità della qualità dei dati vi offre un modo per rispondere a questa domanda prima che sia il business a pagarne il prezzo.
Capire l'osservabilità della qualità dei dati
Una dashboard può sembrare in salute mentre la pipeline che la alimenta sta deviando. Una tabella sorgente può ancora caricarsi puntualmente, mentre lo schema cambia sotto di essa, una trasformazione inizia a rimodellare i valori e i report a valle restano errati finché qualcuno non nota la discrepanza. L'osservabilità della qualità dei dati si concentra su questi segnali di sistema, non solo sul risultato finale a livello di riga.
Il passaggio dalle regole ai segnali
I controlli basati su regole restano importanti. Sono precisi, verificabili e utili quando la logica di business deve essere applicata a livello di record. Ma si lasciano sfuggire molto, perché intercettano solo ciò che vi aspettavate già potesse rompersi. L'observability guarda a segnali esterni come freschezza, volume, schema, distribuzione e lineage, quindi usa questi andamenti per mostrare se la pipeline si sta comportando normalmente, come definito nelle linee guida pratiche sull'observability.
Questo passaggio conta soprattutto quando entra in gioco lo schema drift. Se una sorgente aggiunge, rimuove, rinomina o cambia il tipo di una colonna, una trasformazione fragile può fallire senza preavviso o inviare valori malformati alle analytics a valle prima che qualcuno se ne accorga: lo schema drift è un segnale fondamentale dell'observability. L'observability intercetta la modifica strutturale in sé, invece di aspettare che emerga l'output errato.
Il rovescio della medaglia è l'alert fatigue. Le regole statiche possono produrre un lungo flusso di alert di scarso valore, soprattutto quando le variazioni dei dati sono normali per il business. Il monitoraggio comportamentale riduce questo rumore chiedendosi se l'andamento è cambiato in modo significativo, un approccio più adatto alle pipeline moderne e al modo in cui i team indagano sugli incidenti.
L'observability dà il meglio quando osserva come si comportano i dati, non solo se una riga supera una regola.
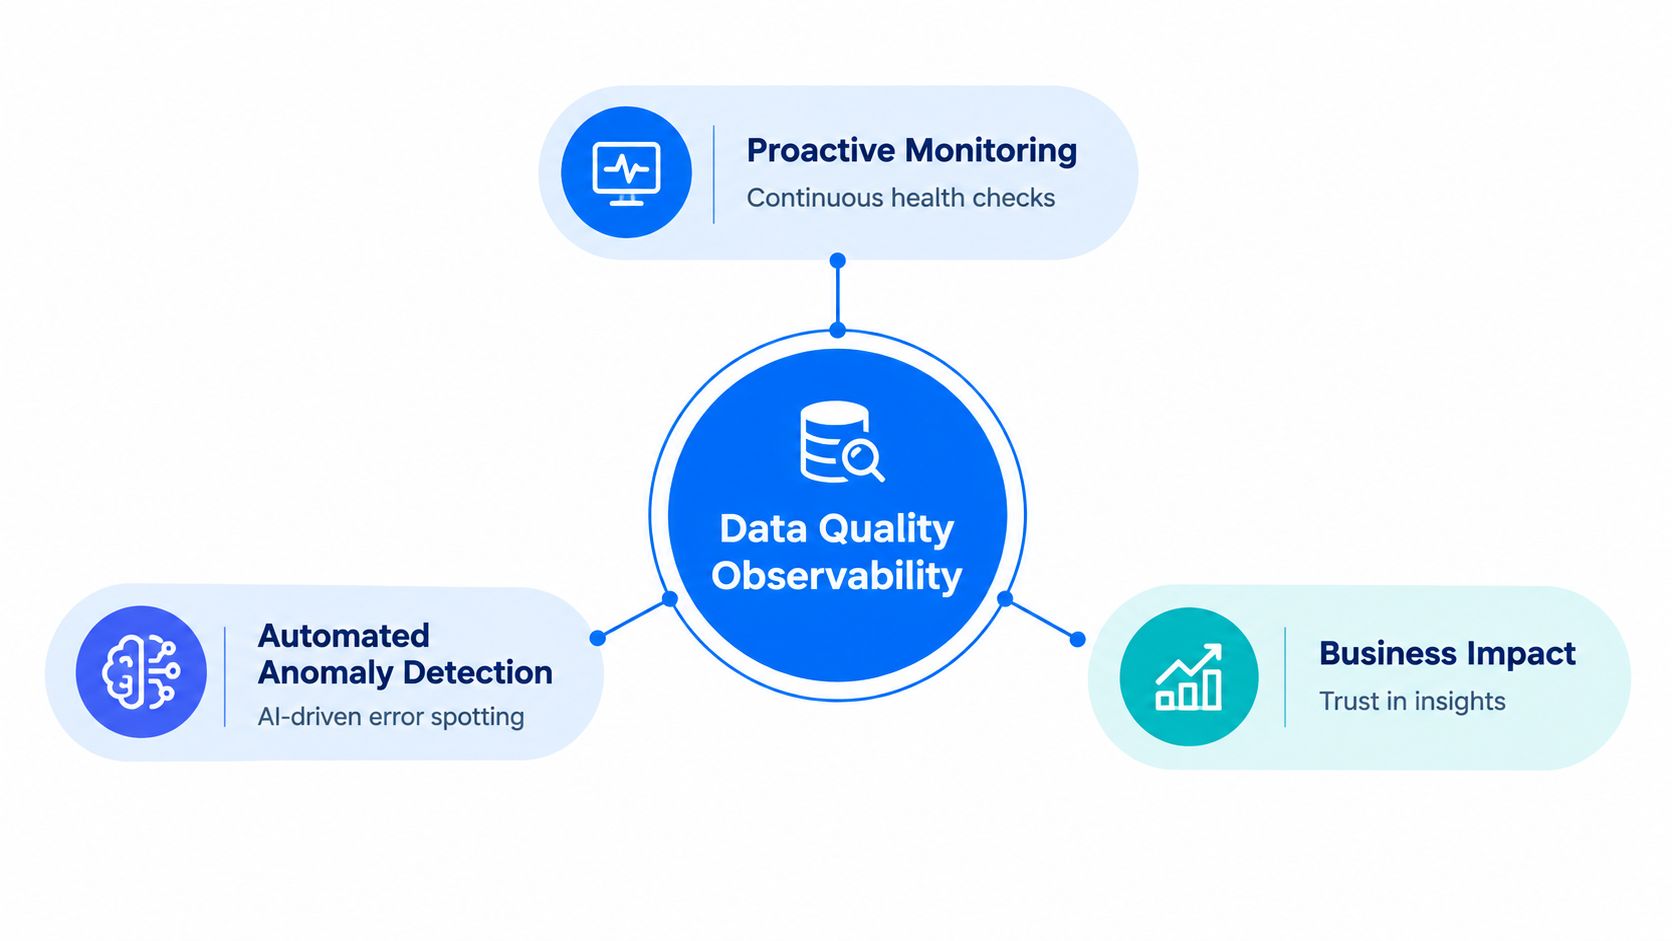
Cosa monitorare per primo
Iniziate dai segnali che vi dicono se la pipeline è attiva e coerente.
Freschezza: i dati in ritardo sono spesso il primo segnale di una pipeline bloccata o degradata.
Volume: picchi o cali improvvisi possono indicare problemi di ingestione, duplicati o caricamenti parziali.
Schema: le modifiche inattese ai campi sono spesso la via più rapida verso trasformazioni non funzionanti.
Distribuzione: i cambiamenti negli andamenti dei valori possono rivelare corruzioni silenziose che a livello di tabella sembrano ancora valide.
Lineage: sapere da dove provengono i dati e dove fluiscono aiuta a tracciare l'impatto invece di andare a tentativi.
L'obiettivo pratico è semplice. Se i controlli di qualità dei dati vi dicono se un record è accettabile, l'observability vi dice se l'intero flusso si comporta in un modo di cui potete fidarvi. Per un approfondimento su come i segnali comportamentali sostituiscono le regole statiche, consultate la panoramica sulla data observability.
Segnali chiave per monitorare la salute dei dati
Il monitoraggio funziona meglio quando ogni segnale corrisponde a una modalità di guasto e a una conseguenza per il business. I tradizionali controlli basati su regole restano utili, ma spesso trattano ogni deviazione come ugualmente urgente. L'observability basata sull'IA aggiunge baseline comportamentali, aiutando i team a distinguere la variazione attesa da un andamento che minaccia la disponibilità dei dati, il reporting a valle o le decisioni operative. L'obiettivo è avere meno alert di scarso valore e un'attenzione più rapida al data downtime.
Freschezza, volume, schema e validazione lavorano insieme
La puntualità è spesso il primo avvertimento che una pipeline si è bloccata o degradata. Le implementazioni moderne apprendono la cadenza di consegna di un dataset, calcolano quando dovrebbe arrivare il caricamento successivo e generano un alert quando è in ritardo o mancante, come descritto nelle linee guida sul monitoraggio operativo. La logica di puntualità può anche individuare le consegne che arrivano prima del previsto, il che è importante quando una sorgente si discosta dal suo ritmo abituale: questo modello basato sulla cadenza è trattato anche nelle linee guida delle piattaforme.
Il rilevamento delle anomalie aggiunge contesto a una semplice soglia. Un picco in una tabella sull'attività dei clienti potrebbe riflettere una campagna legittima, oppure indicare un feed duplicato che rielabora i record. Un modello comportamentale non può determinare da solo la spiegazione di business, ma può segnalare un cambiamento significativo prima che gli analisti si affidino ai dati interessati.
Il tracciamento dello schema limita i guasti strutturali a valle. Un feed finanziario può aggiungere un campo nullable, oppure un'estrazione sanitaria può cambiare la definizione di un tipo senza mostrare un problema evidente alla sorgente. Il guasto può emergere più tardi in una trasformazione, in un modello o in una dashboard, dove la diagnosi richiede più tempo.
La validazione collega l'observability alle regole di business. I controlli a livello di riga confrontano i valori con formati, lunghezze e metriche di qualità attesi. Supportano le attività di compliance, le evidenze di audit e la revisione mirata dei record ad alto rischio; la validazione a livello di riga è descritta nella letteratura sulla verifica.
Una guida alle metriche di data observability può aiutare ad associare ogni metrica alla modalità di guasto che dovrebbe far emergere.
Segnale | Cosa intercetta | Cosa non intercetta |
|---|---|---|
Freschezza | Caricamenti in ritardo o mancanti | Significato di business errato |
Volume | Dati mancanti, duplicati, feed rielaborati | Errori puntuali sulle righe |
Schema | Campi aggiunti, rimossi, rinominati o con tipo modificato | Errori semantici in colonne valide |
Validazione | Violazioni delle regole a livello di record | Comportamenti inattesi al di fuori dell'insieme di regole |
Il perimetro conta più della copertura
Il costo principale non sta nella scelta dei segnali, ma nell'applicarli indiscriminatamente su patrimoni dati estesi, più stack e molte tabelle. Una copertura più ampia aumenta l'overhead di calcolo, metadati e alerting, un avvertimento pratico evidenziato da Databricks. Un eccesso di alert crea inoltre affaticamento operativo. Quando gli engineer smettono di fidarsi delle notifiche, un vero disservizio dei dati può restare in coda dietro alle variazioni di routine.
Date priorità alle pipeline il cui guasto inciderebbe su ricavi, reporting, compliance od operazioni con i clienti. Il rilevamento basato sull'IA può ridurre gli alert ripetitivi legati alle soglie, mentre la validazione esplicita resta appropriata per le regole note. Usati insieme, questi approcci producono un flusso di alert più silenzioso, con responsabilità più chiare e una risposta agli incidenti più rapida.
Modelli architetturali per l'observability
La maggior parte dei fallimenti dell'observability deriva da scelte architetturali, non dal segnale di monitoraggio in sé. I team spostano troppi dati in uno strumento separato, oppure aggiungono controlli a posteriori sperando che i compromessi su latenza e sicurezza non contino. Nella pratica, l'architettura deve rispettare il luogo in cui i dati risiedono già.
Tenete i controlli vicino ai dati
Il modello più solido è l'esecuzione in-database. La logica di monitoraggio viene eseguita all'interno del data warehouse o del data lake, così i dati restano dove sono e il team evita movimenti superflui tra sistemi. Ciò è importante sia per la sicurezza sia per le prestazioni, soprattutto quando la piattaforma gestisce già dataset sensibili o carichi di lavoro pesanti.
È anche qui che la modularità dimostra il suo valore. Uno stack di observability monolitico può essere difficile da adottare perché costringe i team a un rollout esteso prima di averne dimostrato il valore. Una configurazione modulare vi consente di partire da un solo problema, come lo schema drift o la puntualità, per poi estendervi alla validazione o al monitoraggio di business una volta che il primo segnale funziona.
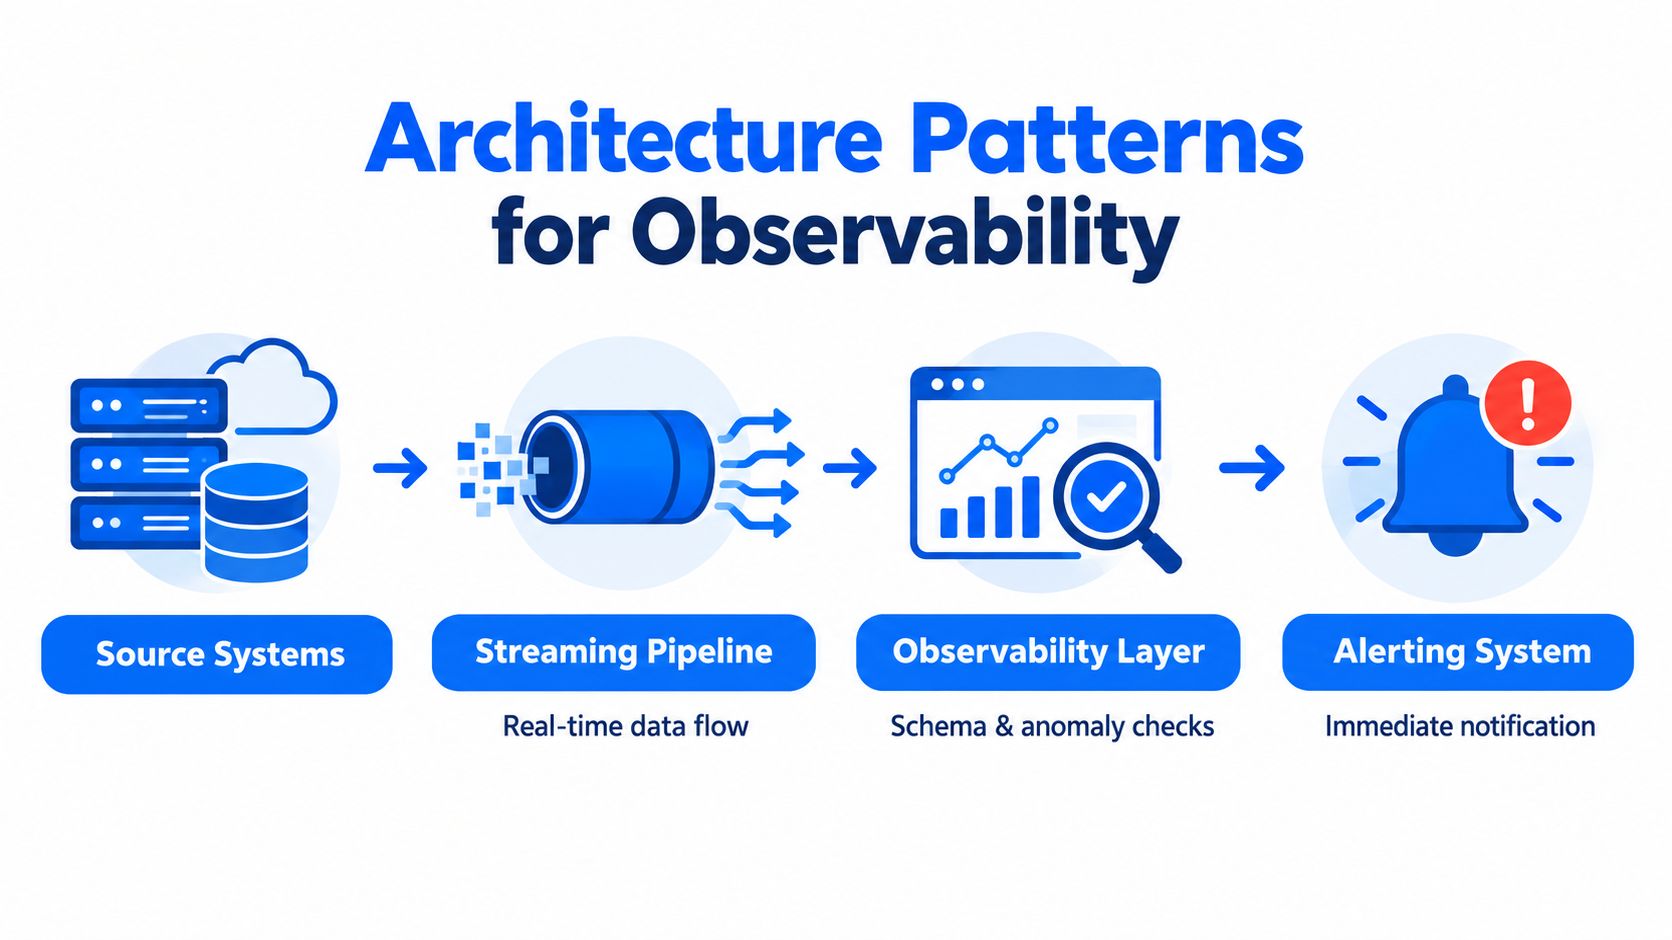
Un'architettura pulita segue di solito questa sequenza:
I sistemi sorgente generano dati operativi o analitici.
Le pipeline streaming o batch spostano i dati nell'ambiente governato.
Un livello di observability valuta i segnali di freschezza, schema e anomalie dove i dati risiedono già.
Un sistema di alerting instrada al responsabile giusto solo gli incidenti significativi.
Perché le piattaforme modulari sono più facili da rendere operative
Una piattaforma modulare mantiene ridotto il blast radius quando introducete l'observability in uno stack maturo. Potete puntarla prima sulle tabelle più importanti, per poi estenderla man mano che il team acquisisce fiducia nella qualità del segnale. Ciò rende anche il rollout più semplice per i team di data engineering, perché la logica di monitoraggio evolve insieme alle pipeline invece di imporre un modello operativo separato.
La guida all'architettura dell'observability di digna si adatta bene a questo modello modulare, soprattutto per i team che vogliono mantenere il monitoraggio vicino al data warehouse o al data lake invece di costruire un livello separato e costoso da mantenere.
Il punto non è l'architettura fine a se stessa, ma ridurre gli attriti, ridurre la movimentazione dei dati e assicurarsi che il livello di monitoraggio non diventi un'ulteriore fonte di rumore operativo.
Il ruolo dell'observability in analytics e IA
Analytics e IA falliscono rapidamente quando i dati in ingresso deviano. Una dashboard può essere errata perché un feed è in ritardo. Un modello può diventare inaffidabile perché i valori delle feature cambiano. In entrambi i casi, il problema resta spesso invisibile finché il business non ne vede l'effetto.
Perché l'IA alza l'asticella
Una fonte del 2025 sul mercato e sul divario di adozione ha rilevato che il 48% degli intervistati indica la scarsa qualità dei dati come principale ostacolo alla preparazione per l'IA, mentre un altro sondaggio ha rilevato che il 74% delle organizzazioni considera importante monitorare i processi di business critici e il 54% afferma che la qualità del rilevamento degli alert è il fattore che incide di più sul ROI dell'observability, come sintetizzato nell'analisi dei protagonisti del mercato. Non sono numeri astratti. Mostrano che i team non considerano più l'observability una questione di engineering di nicchia, ma un prerequisito per l'IA e per il reporting direzionale.
Ciò è importante perché le pipeline di IA non dipendono solo da record puliti. Dipendono da input stabili, da un comportamento prevedibile delle feature e da segnali a valle affidabili. Se i dati che alimentano il modello cambiano forma, il modello può comunque restituire un risultato, ma quel risultato può diventare meno utile senza alcun segnale evidente di errore.
Le metriche di business meritano la stessa disciplina
L'observability si è inoltre spinta oltre il classico monitoraggio delle pipeline, verso il monitoraggio dei processi di business. Questo passaggio è importante, perché ai dirigenti non interessa se una differenza di schema era interessante. Interessa sapere se il churn dei clienti, il volume degli ordini, la gestione dei sinistri o altri KPI di business sono usciti dall'intervallo atteso. Monitorare queste metriche sui dati sottostanti offre ai team un modo più tempestivo per vedere le derive operative, senza aspettare che sia il livello di reporting a farle emergere.
La guida alla preparazione per l'IA di digna è in linea con questa visione più ampia, perché l'observability non riguarda più solo la salute tecnica. Si tratta di dimostrare che le fondamenta dei dati possono supportare analytics, automazione e IA senza creare punti ciechi.
Quando i team fanno le cose per bene, smettono di chiedersi se la dashboard è attiva. Iniziano a chiedersi se i segnali dietro la dashboard meritano ancora fiducia.
Piattaforme modulari ed esempi concreti
Il vantaggio dell'observability modulare è che permette ai team di risolvere uno specifico problema di affidabilità senza acquistare un modello operativo completamente nuovo. Ciò è importante negli ambienti enterprise, dove i team di finanza, sanità, telecomunicazioni e settore pubblico affrontano modalità di guasto diverse e livelli di tolleranza al rumore diversi.
Dove si inserisce l'observability modulare
Un team di servizi finanziari di solito si preoccupa di tempistiche, integrità delle transazioni e reporting a valle. Se un feed regolamentare arriva in ritardo, il problema non è solo operativo: incide sulla fiducia nel reporting e può tradursi a cascata in scadenze mancate. Una piattaforma modulare può concentrarsi prima su puntualità e rilevamento delle anomalie per i feed critici, per poi aggiungere tracciamento dello schema e validazione dove le regole di business contano di più.
Un team sanitario ha vincoli diversi. I dataset clinici e operativi richiedono spesso validazione, stabilità strutturale e tracciabilità tra i sistemi sorgente. Le modifiche allo schema in una pipeline EHR possono essere dirompenti quanto una consegna in ritardo, perché possono compromettere le analytics o i flussi di reporting a valle anche quando il sistema sorgente sembra funzionare correttamente.
Perché un'unica piattaforma può restare focalizzata
digna è una delle opzioni di questa categoria e la sua configurazione modulare combina rilevamento delle anomalie basato sull'IA, monitoraggio della puntualità, tracciamento dello schema e validazione a livello di record all'interno dell'ambiente del cliente. Questo modello è utile quando i team vogliono mantenere i dati dove sono e aggiungere observability senza trasferire i dati di produzione in un servizio esterno separato.
La pagina dei casi d'uso di digna è adatta ai team che vogliono confrontare come questi moduli rispondono a esigenze operative diverse. La parte importante, però, non è il brand, ma il principio di progettazione: partite dai segnali che corrispondono alle vostre pipeline a più alto rischio, poi estendetevi solo dove il monitoraggio aumenta la fiducia più di quanto aggiunga overhead.
Se una piattaforma non sa spiegare perché un alert è importante per il business, non è ancora completa.
Questo principio vale in tutti i settori. Il miglior rollout dell'observability è di solito quello che parte in piccolo, dimostra il proprio valore e poi cresce solo dove il team riesce a mantenere pulito il segnale.
Sfatare i luoghi comuni
Il luogo comune più diffuso è che l'observability sia solo un modo più elegante per trovare record errati. Non è così. La qualità dei record resta importante, ma il problema più difficile è decidere cosa merita attenzione, perché ogni nuova tabella monitorata aggiunge costi, metadati e overhead di alerting.
Più monitoraggio non significa sempre più fiducia
Un flusso di alert rumoroso può ridurre la fiducia più rapidamente dell'assenza totale di monitoraggio. Quando ogni minima deviazione genera una chiamata, gli engineer iniziano a ignorare gli avvisi e il sistema perde credibilità. Ecco perché il controllo del perimetro è così importante, soprattutto nei grandi patrimoni dati, dove monitorare tutto allo stesso modo è al tempo stesso costoso e dispersivo.
Un altro errore comune è pensare che l'observability sia solo per le grandi aziende. Ne beneficiano anche i team più piccoli, ma solo se si concentrano sulle pipeline più importanti. Se un team dati di tre persone monitora ogni tabella di scarso valore nel warehouse, finirà sommerso da un lavoro di cui non ha bisogno.
Usate l'observability dove il business sente il problema
La regola pratica è semplice. Monitorate per primi gli asset in cui ritardi, derive o guasti inciderebbero su reporting, esperienza del cliente, compliance o qualità dei modelli. Una volta stabilizzati questi, estendetevi ai dataset adiacenti con la stessa disciplina.
Una buona observability riduce l'incertezza. Una cattiva observability crea solo una versione più raffinata dell'alert fatigue.
Questo è il compromesso fondamentale. Più rilevamento è utile solo se il team può agire di conseguenza, e abbastanza rapidamente da fare la differenza. In caso contrario, il livello di monitoraggio diventa un'ulteriore fonte di attrito.
Costruire la vostra strategia di data observability
Una strategia efficace parte dalle pipeline che farebbero più danni in caso di guasto. Sembra ovvio, ma molti team iniziano ancora strumentando il dataset più semplice anziché il più importante. Il risultato è una dashboard pulita su una tabella a basso rischio e nessuna vera protezione dove il business è realmente esposto.
Partite dai percorsi critici, non da una copertura ampia
Individuate le tabelle, i feed e i report a valle che guidano finanza, operations, esperienza del cliente o carichi di lavoro di IA. Poi definite quali segnali contano di più per ciascuno. In una pipeline il problema chiave potrebbe essere un caricamento in ritardo, mentre in un'altra contano di più le modifiche allo schema o le variazioni di distribuzione.
Da lì, usate l'observability per ridurre la creazione manuale di regole. Ciò non significa abbandonare la validazione, ma riservare i controlli approfonditi a livello di record agli asset in cui la correttezza di business conta di più, lasciando che il monitoraggio comportamentale copra il resto del patrimonio dati. Questo equilibrio mantiene il sistema pratico.
Progettate per agire, non solo per rilevare
L'alerting dovrebbe portare a responsabilità, triage e risoluzione. Se la piattaforma non riesce a instradare un incidente al team responsabile dei dati, il segnale non si trasformerà in una correzione. Se l'alert non mostra il probabile impatto a valle, gli engineer passeranno troppo tempo a ricostruire a mano il blast radius.
Otterrete risultati migliori se fate presto queste tre scelte:
Scegliete prima le pipeline ad alto impatto: monitorate i dati il cui guasto cambierebbe le decisioni di business.
Separate il segnale dal rumore: calibrate gli alert in modo che il team veda le deviazioni significative, non ogni minima fluttuazione.
Mantenete semplice il modello operativo: usate funzionalità modulari, così l'observability cresce insieme allo stack invece di sovraccaricarlo.
L'obiettivo a lungo termine è la fiducia, non gli strumenti. Quando il monitoraggio diventa parte del modo in cui il team consegna dati affidabili, i team di analytics si muovono più velocemente, gli utenti di business fanno meno domande difensive e il data engineering smette di passare la settimana a ripulire incidenti evitabili.
Se state rafforzando la vostra strategia di osservabilità della qualità dei dati, digna offre ai team rilevamento modulare delle anomalie, controlli di puntualità, tracciamento dello schema e validazione all'interno del proprio ambiente. Visitate digna per scoprire come questo approccio può supportare analytics e IA affidabili senza aggiungere movimentazioni di dati superflue o rumore operativo.
Se volete vedere come si presenta questo approccio modulare e in-database su un'intera piattaforma, dalla freschezza e dalle modifiche allo schema fino alle anomalie e alla validazione, la nostra pagina sulla data platform observability mostra come digna monitora questi segnali senza spostare i dati fuori dal vostro ambiente.
Domande frequenti
Che cos'è l'osservabilità della qualità dei dati?
L'osservabilità della qualità dei dati osserva come si comportano i dati mentre attraversano le pipeline, usando segnali come freschezza, volume, schema, distribuzione e lineage. Invece di aspettare una dashboard non funzionante, segnala in anticipo caricamenti in ritardo, schema drift o variazioni di volume, così i team si chiedono cosa è cambiato prima che la dashboard si rompesse, anziché perché si è rotta.
In cosa la data observability si differenzia dai controlli di qualità dei dati basati su regole?
I controlli basati su regole intercettano solo i problemi che vi aspettavate già, mentre l'observability apprende il comportamento normale e segnala i cambiamenti significativi. Le regole restano preziose per una logica precisa e verificabile a livello di record, ma non colgono le rotture inattese e possono sommergere i team di alert di scarso valore. L'articolo consiglia di mantenere la validazione per le regole note e di lasciare il resto al monitoraggio comportamentale.
Quali segnali di data observability conviene monitorare per primi?
Iniziate da freschezza, volume, schema, distribuzione e lineage, perché mostrano se una pipeline è attiva e coerente. Ognuno corrisponde a una modalità di guasto: la freschezza intercetta i caricamenti in ritardo o mancanti, il volume i duplicati e i feed rielaborati, lo schema i campi aggiunti, rimossi, rinominati o con tipo modificato, anche se nessuno di essi da solo intercetta gli errori semantici.
Quanto tempo serve per rilevare un incidente sui dati?
Spesso più di quanto i team si aspettino: in un sondaggio Wakefield Research del 2023, il 68% degli intervistati ha impiegato quattro ore o più per rilevare gli incidenti sui dati. La risoluzione ha richiesto in media 15 ore per incidente e gli incidenti mensili sono passati da 59 a 67 da un anno all'altro: per questo un segnale anticipato conta più di una gestione delle emergenze più rapida.
I controlli di observability dovrebbero essere eseguiti all'interno del data warehouse?
Sì, l'esecuzione in-database è il modello architetturale più solido, perché la logica di monitoraggio viene eseguita dove i dati già risiedono invece di copiarli in uno strumento separato. Ciò migliora sicurezza e prestazioni per carichi di lavoro sensibili o pesanti, e una configurazione modulare consente ai team di partire da un solo problema, come lo schema drift, prima di estendersi.


