Master Data Management: la guida completa all'MDM
|
9
min di lettura

Ogni azienda ha lo stesso problema nascosto sotto gli occhi di tutti: cinque sistemi, cinque versioni dello stesso cliente e nessuno sa con certezza quale sia quella giusta. È proprio questo il divario che le pratiche di master data management servono a colmare e, se state leggendo queste righe, probabilmente avete appena visto un report rompersi perché un ID prodotto significava due cose diverse in due database diversi.
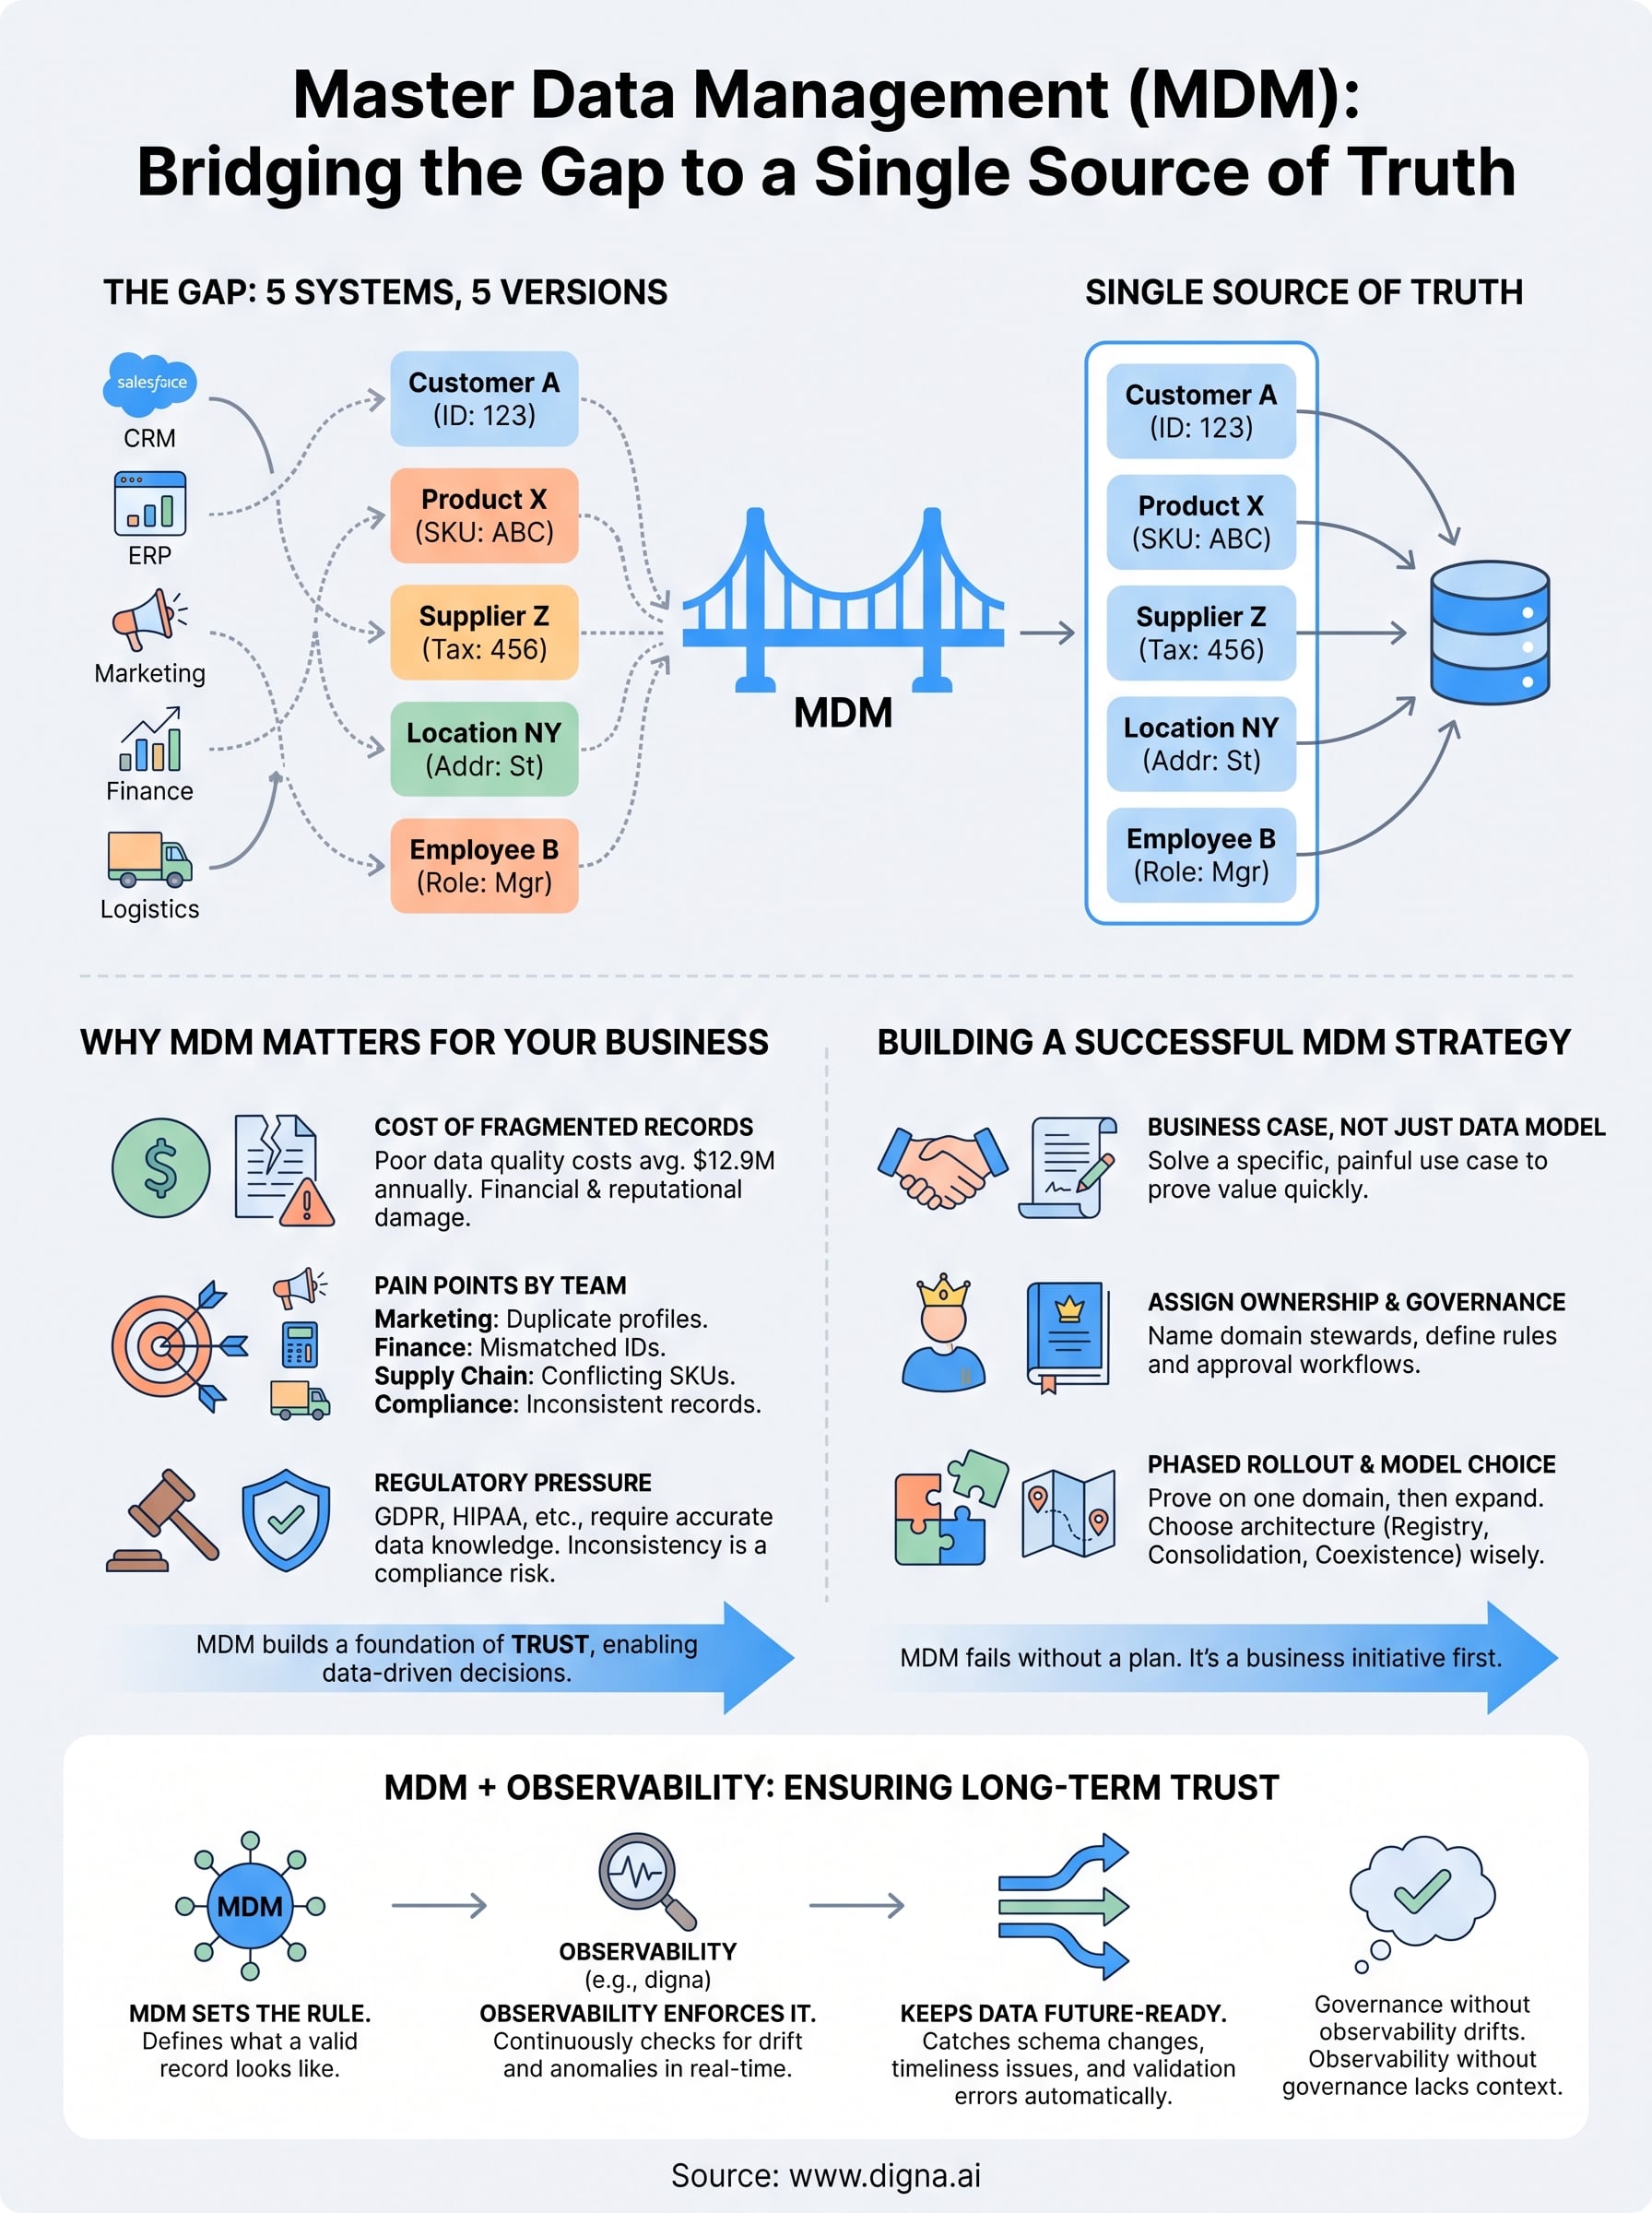
Il Master Data Management (MDM) è la disciplina che consiste nell'identificare, pulire e governare le entità di business critiche (clienti, prodotti, fornitori, sedi) da cui dipende ogni reparto, assicurandosi poi che un'unica versione coerente e affidabile di ciascun record circoli in tutti i sistemi che lo utilizzano. Se fatto bene, trasforma dati sparsi e duplicati in un'unica fonte di verità su cui i vostri team possono davvero basare le decisioni.
Questa guida spiega che cosa significa l'MDM nella pratica, perché conta al di là della parola d'ordine e come si inserisce accanto al lavoro di data quality e observability. Vedremo i componenti fondamentali di un programma di MDM, gli approcci di implementazione più comuni e il ruolo degli strumenti che monitorano e validano i dati in modo automatico, come il rilevamento delle anomalie e il tracciamento dello schema che sviluppiamo in digna, nel mantenere affidabili i master data anche molto tempo dopo la pulizia iniziale.
Perché il master data management è importante per il vostro business
I master data di cattiva qualità non si annunciano con un messaggio di errore. Si manifestano come una campagna di marketing che invia sei volte la stessa email allo stesso cliente, un report della supply chain che sovrastima le scorte del 15% o una dichiarazione di compliance che riporta un fornitore con tre partite IVA diverse. Il Master Data Management esiste perché queste piccole incoerenze, una volta moltiplicate in un'azienda con decine di sistemi e migliaia di transazioni giornaliere, si sommano fino a causare danni finanziari e reputazionali reali.
Il costo dei record frammentati
Pensate a che cosa succede quando il sistema dei mutui di una banca, il CRM e lo strumento antifrode contengono ciascuno una versione leggermente diversa dello storico degli indirizzi dello stesso cliente. Gli analisti passano ore a riconciliare i numeri invece di analizzarli, i dirigenti perdono fiducia nelle dashboard e durante un audit le autorità di vigilanza iniziano a fare domande mirate. Gartner stima da tempo che la scarsa qualità dei dati costi alle organizzazioni in media 12,9 milioni di dollari all'anno, e i master data frammentati ne sono di solito la causa principale, non un sintomo. Risolvere il problema non è un progetto IT facoltativo: è una leva diretta sui costi operativi.
Dove il problema si manifesta per primo
La maggior parte dei team non si accorge dei problemi sui master data finché non colpiscono un reparto specifico. Ecco come lo stesso problema di fondo si manifesta in modo diverso a seconda di chi ne è colpito:
Team | Sintomo di master data di scarsa qualità | Impatto sul business |
|---|---|---|
Vendite e marketing | Profili cliente duplicati | Spesa sprecata, comunicazioni incoerenti |
Finanza | ID fornitore non corrispondenti | Pagamenti in ritardo, rilievi di audit |
Supply chain | SKU di prodotto in conflitto | Eccesso di scorte o rotture di stock |
Compliance | Record di entità incoerenti | Sanzioni normative, audit falliti |
Data science | Dati di addestramento inaffidabili | Output imprecisi dei modelli di AI/ML |
Una volta individuato lo schema ricorrente in queste righe, è evidente che il problema non è un singolo dataset errato. È una lacuna strutturale nel modo in cui l'organizzazione definisce e governa i suoi record più importanti.
Costruire una base di fiducia
Un programma di MDM ben gestito offre a ogni reparto lo stesso punto di partenza: un unico record validato per ciascun cliente, prodotto o fornitore, a cui gli altri sistemi fanno riferimento invece di ricrearlo. Questa base condivisa è ciò che permette a una cultura data-driven di funzionare davvero, perché analisti e dirigenti smettono di dubitare dei numeri che hanno davanti.
Quando tutti lavorano sullo stesso master record, le discussioni passano da "quali dati sono giusti" a "che cosa dovremmo fare".
Questo cambiamento conta più di quanto sembri. I team che si fidano dei propri dati si muovono più velocemente. Testano nuovi modelli di prezzo, lanciano campagne personalizzate e automatizzano le approvazioni senza doversi fermare prima a verificare i fatti di base.
La pressione normativa è in aumento
Le aziende dei settori finanziario, sanitario e delle telecomunicazioni sono sottoposte a un controllo sempre più stretto sul modo in cui gestiscono i record di clienti e transazioni. Normative come il GDPR dell'UE richiedono alle organizzazioni di sapere esattamente quali sistemi contengono dati personali e di correggerli o cancellarli su richiesta, cosa quasi impossibile senza un master record che indichi dove risiedono i dati di ciascuna entità. Il Comitato europeo per la protezione dei dati ha più volte segnalato la tenuta incoerente dei registri come rischio di compliance nell'ambito delle azioni di enforcement, e le autorità di Stati Uniti e Regno Unito stanno seguendo linee di indagine simili.
In definitiva, l'MDM è importante perché incide su tutto ciò che sta a valle: accuratezza del reporting, affidabilità dei modelli di AI, esperienza del cliente e preparazione agli audit. Saltarlo non elimina il costo dei dati di cattiva qualità; si limita a rimandare il conto al team che scopre per primo la discrepanza, di solito nel momento peggiore possibile.
Come costruire una strategia di master data management
Un programma di master data management fallisce rapidamente quando parte dal software invece che da un piano. I team di successo trattano l'MDM prima come un'iniziativa di business e solo dopo come un progetto tecnico, il che significa definire che aspetto hanno dei "buoni" master data prima che qualcuno valuti un fornitore. Se la strategia è corretta, la scelta degli strumenti diventa molto più semplice in seguito.
Partite da un business case, non da un modello dati
Prima di toccare uno schema, definite con precisione il problema specifico che state risolvendo. Sono i clienti duplicati che costano budget di marketing? Sono i record fornitore non corrispondenti che rallentano la chiusura contabile? Scegliete un caso d'uso doloroso e misurabile e costruite attorno a quello. Un business case circoscritto e ben documentato vi permette di dimostrare rapidamente il valore e di assicurarvi il budget per il lavoro più impegnativo di estendere la copertura ad altri domini in seguito.
Assegnate le responsabilità prima di toccare la tecnologia
I master data non hanno alcuna possibilità di restare puliti se nessuno ne è responsabile. È qui che la data governance dimostra il suo valore: nominare gli steward per ogni dominio, definire chi può creare o modificare un record e stabilire le regole su che cosa sia "corretto". Senza questa struttura, anche il miglior algoritmo di matching non fa che automatizzare la confusione più rapidamente.
Nominate un responsabile di business per ogni dominio di master data (cliente, prodotto, fornitore, sede)
Definite workflow di approvazione per creare, unire o dismettere i record
Fissate le soglie di data quality che ogni dominio deve rispettare prima di essere considerato affidabile
Documentate le regole in uno statuto di governance che sopravviva al turnover del personale
Un modello di governance senza uno stack tecnologico è lento. Uno stack tecnologico senza governance è veloce nel diffondere errori.
Scegliete un approccio al modello dati
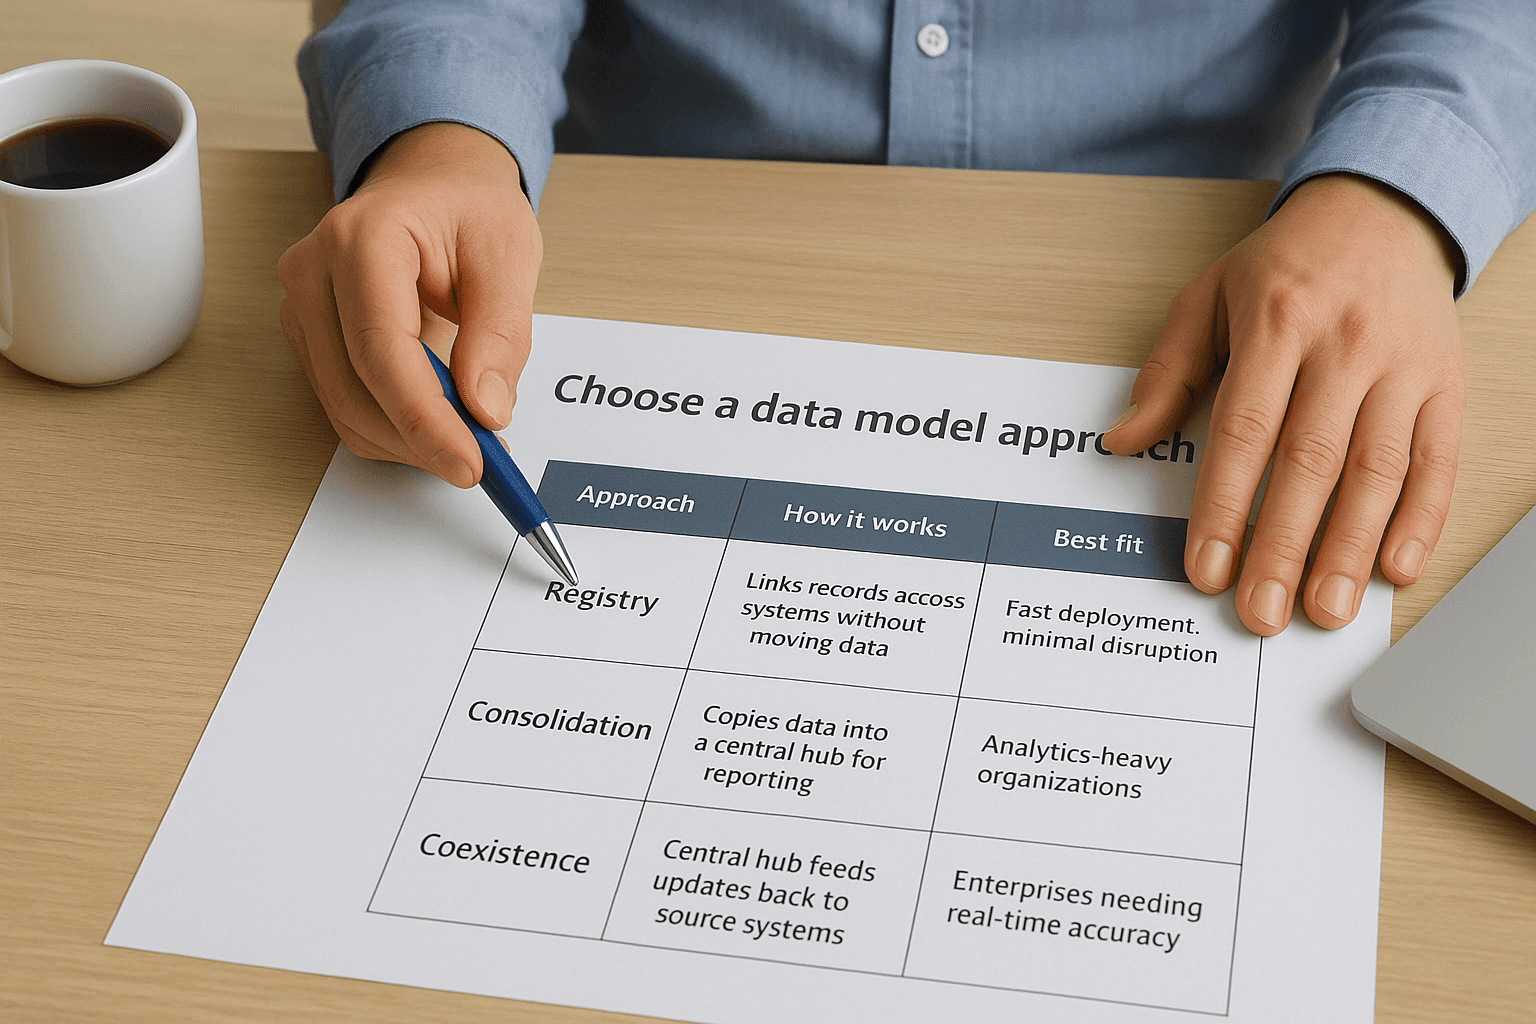
Le aziende scelgono di solito uno tra tre pattern architetturali, e la scelta condiziona tutto ciò che viene dopo, dal costo di integrazione alla rapidità con cui vengono intercettati i record errati.
Approccio | Come funziona | Ideale per |
|---|---|---|
Registry | Collega i record tra i sistemi senza spostare i dati | Deployment rapido, impatto minimo |
Consolidation | Copia i dati in un hub centrale per il reporting | Organizzazioni con un forte uso di analytics |
Coexistence | L'hub centrale rimanda gli aggiornamenti ai sistemi sorgente | Aziende che necessitano di accuratezza in tempo reale |
Nessuno di questi approcci è "migliore" in assoluto. La scelta giusta dipende da quanto la vostra organizzazione può tollerare modifiche ai sistemi sorgente rispetto alla costruzione di un hub parallelo.
Procedete per fasi, non tutto in una volta
Le organizzazioni che cercano di gestire tutti i domini contemporaneamente di solito si bloccano entro un anno. Dimostrate invece il modello su un solo dominio, misurate il miglioramento dei tassi di matching e la riduzione degli errori, quindi estendete le stesse regole di governance e di matching al dominio successivo. I rollout a fasi danno inoltre agli strumenti di data quality il tempo di intercettare il drift strutturale prima che si diffonda in tutta l'architettura.
Sfide comuni nel master data management
Anche l'iniziativa di master data management pianificata meglio incontra attriti una volta passata dalla lavagna alla produzione. Gli ostacoli di solito non sono tecnici in senso stretto: sono abitudini organizzative accumulate negli anni, che non scompaiono solo perché avete acquistato un nuovo software. Conoscere in anticipo queste sfide vi permette di riservare tempo e capitale politico aggiuntivi dove servono davvero.
I silos di dati resistono al consolidamento
Le applicazioni legacy sono state costruite per risolvere il problema di un reparto, non dell'intera azienda. Un team CRM ottimizzato per la conversione dei lead e un team finance ottimizzato per l'accuratezza della fatturazione finiscono per avere due record cliente che non sono mai stati progettati per corrispondere. Abbattere questi silos di dati significa convincere i responsabili dei sistemi a rendere disponibili i propri dati per il matching, una conversazione spesso più difficile di qualsiasi script di integrazione.
Fare il matching di record in formati incoerenti
Unire i record sembra semplice finché non si vede quanto diversamente la stessa entità viene registrata nei vari sistemi. Un fornitore chiamato "Acme Corp." in un database potrebbe comparire come "ACME Corporation Ltd" in un altro, magari con un errore di battitura nella partita IVA. Le discrepanze più comuni includono:
Ragioni sociali abbreviate rispetto a quelle complete
Formati degli indirizzi incoerenti tra le diverse regioni
ID duplicati creati durante le migrazioni di sistema
Campi di testo libero senza regole di validazione
Gli algoritmi di matching aiutano, ma hanno bisogno di esempi di addestramento puliti, e qualcuno deve comunque risolvere a mano i casi limite.
La governance si blocca senza il sostegno del top management
I programmi di stewardship spesso muoiono in silenzio quando la leadership li tratta come una pulizia una tantum anziché come una responsabilità continuativa. Gli steward vengono riassegnati, lo statuto di governance prende polvere e i record duplicati tornano a insinuarsi nel giro di un anno. La data governance regge solo quando una figura senior è responsabile del risultato, non solo del lancio.
Una pulizia dei dati una tantum cura un sintomo; solo una governance continuativa cura la malattia.
I sistemi legacy rallentano l'integrazione
I mainframe più vecchi e le applicazioni sviluppate su misura raramente espongono API pulite, il che costringe i team a fragili estrazioni batch o a riconciliazioni manuali. Ogni soluzione di ripiego aggiunge latenza tra il momento in cui un record cambia e quello in cui il resto dell'azienda vede l'aggiornamento, compromettendo l'accuratezza in tempo reale che l'MDM dovrebbe garantire. Prevedere presto nel budget questo debito di integrazione evita la trappola comune di una strategia che sembra perfetta sulla carta ma si blocca non appena incontra lo schema di un database vecchio di vent'anni.
., sono più comuni. Ai sensi dell'HIPAA, gli istituti finanziari sono soggetti a obblighi simili: record di identità, gerarchie di prodotto e informazioni sui beneficiari hanno strutture riconosciute e punti di controllo normativi propri.I fornitori devono rispettare i requisiti.La tabella seguente mostra come la stessa disciplina di fondo risolva problemi molto diversi a seconda del dominio a cui la si applica..,scrivere in modo conciso.Scriviamo.6 domini cliente prodotto fornitore sede dipendente dati di riferimento/finanza. Restare nel budget di 406 parole al massimo452452.br formato tabella per i domini, esempi di casi d'uso. Poi un caso narrativo, un settore (bancario) con sottotitoli e interazione con il dominio prodotto.descrizione, e un esempio sanitario (dominio paziente). Usare frasi in grassetto, blockquote dopo il punto chiave.Scrivere con sottotitoli H3:
Scegliere gli strumenti di master data management giusti
Una volta definite governance e strategia, la decisione tecnologica diventa molto più semplice, ma resta il punto in cui molti progetti perdono slancio. I fornitori pubblicizzano decine di funzionalità, eppure la valutazione reale si riduce a poche domande: lo strumento è compatibile con i vostri vincoli di deployment, riesce davvero a fare il matching dei vostri record più disordinati e il vostro team sarà ancora in grado di gestirlo tra due anni? Saltare questa disciplina è il modo in cui le organizzazioni finiscono con un software costoso che automatizza il workflow sbagliato.
Adattate il modello di deployment alle vostre esigenze di compliance
Banche, assicurazioni e strutture sanitarie spesso non possono spostare i master data su un cloud di terze parti senza avviare una verifica di compliance, quindi la flessibilità di deployment conta quanto le funzionalità. Cercate piattaforme che supportino il modello che le vostre autorità di vigilanza si aspettano, non solo quello più economico da configurare.
Modello di deployment | Dove risiedono i dati | Ideale per |
|---|---|---|
Cloud pubblico | Infrastruttura gestita dal fornitore | Minori oneri normativi, scalabilità rapida |
Cloud privato | Ambiente dedicato e isolato | Aziende che necessitano di controllo senza gli oneri dell'on-premises |
On-premises | Data center del cliente | Requisiti rigorosi di residenza o sovranità dei dati |
Un'organizzazione vincolata dal GDPR o da regole analoghe sulla residenza dei dati dovrebbe trattare questa tabella come un filtro, non come una preferenza, prima di confrontare qualsiasi altro aspetto.
Valutate le capacità di matching e di survivorship
Il valore reale di uno strumento si vede da come risolve i record in conflitto, non dal design della sua dashboard. Chiedete ai fornitori di eseguire un proof of concept sui vostri dati reali e disordinati, invece che su un dataset dimostrativo pulito.
Gestisce il fuzzy matching su variazioni di nome, indirizzo e ID?
Supporta regole di survivorship configurabili per stabilire quale sorgente prevale quando i record sono in conflitto?
Gli utenti di business possono regolare le soglie di matching senza uno sviluppatore?
Registra ogni unione e modifica ai fini dell'audit?
Uno strumento che non sa mostrare la propria logica di matching non è abbastanza affidabile per gestire i master data.
Non trascurate l'integrazione e il costo totale di proprietà
Il prezzo di listino di una piattaforma di MDM raramente riflette quanto costa gestirla. Considerate lo sforzo necessario per collegarla a CRM, ERP e data warehouse, oltre al lavoro continuo di messa a punto delle regole di matching man mano che si aggiungono nuovi sistemi. Una piattaforma con una solida connettività API e connettori predefiniti verso i sistemi aziendali più diffusi riduce in modo significativo i tempi di implementazione rispetto a una che richiede middleware personalizzato per ogni sorgente.
Infine, valutate come lo strumento si integra con i controlli di data quality eseguiti altrove nel vostro stack. Una piattaforma di MDM che dà per scontato che i dati in ingresso siano puliti erediterà ogni errore a monte, ed è esattamente il divario che gli strumenti di observability sono pensati per colmare.
Come data quality e observability rafforzano l'MDM
Il master data management vi offre una versione governata e condivisa di ciascun record, ma non sorveglia quel record dopo la sua creazione. Gli strumenti di data quality e observability riprendono esattamente da dove si ferma la governance dell'MDM, verificando in modo continuo se i master data che avete costruito si comportano ancora come dovrebbero mentre attraversano decine di sistemi a valle. Senza questo livello continuativo, anche un programma di MDM ben progettato torna lentamente verso il caos che doveva risolvere.
L'MDM fissa la regola, l'observability la fa rispettare
Gli statuti di governance definiscono che aspetto ha un record cliente o prodotto valido, ma non possono intercettare ogni violazione nel momento in cui avviene. Una modifica dello schema in un sistema sorgente, un nuovo campo lasciato senza validazione o un caricamento batch che fallisce in silenzio possono corrompere i master record nel giro di pochi giorni. Le piattaforme di observability risolvono il problema monitorando i dati che scorrono realmente nelle pipeline, non solo le regole scritte sulla carta, e segnalano il momento in cui la realtà smette di corrispondere al modello di governance.
La governance vi dice che aspetto ha ciò che è corretto; l'observability vi dice nell'istante esatto in cui smette di esserlo.
Intercettare il drift prima che raggiunga il business
È qui che una piattaforma come digna aggiunge un valore concreto a una base di MDM. Il suo rilevamento delle anomalie apprende automaticamente i pattern normali dei vostri master data, così un improvviso picco di ID fornitore duplicati o un caricamento giornaliero dei clienti mancante viene segnalato prima che finanza o marketing vedano il numero sbagliato. Alcune funzionalità specifiche contano più di tutte:
Tracciamento dello schema che intercetta le modifiche strutturali, come una colonna rinominata o un tipo di dato modificato, prima che rompano silenziosamente la logica di matching
Monitoraggio della tempestività che conferma che i caricamenti dei master data arrivino nei tempi previsti, così che i record obsoleti non vengano trattati come attuali
Validazione a livello di record rispetto alle regole di business, che intercetta ID malformati o valori fuori intervallo che il solo matching dell'MDM potrebbe non vedere
Mantenere l'analisi all'interno del vostro ambiente
Le aziende regolamentate non sempre possono inviare i master data a un servizio esterno per il monitoraggio, ed è per questo che l'esecuzione in-database conta quanto il rilevamento stesso. digna esegue i propri controlli direttamente all'interno del vostro database esistente o del vostro cloud privato, così i record sensibili di clienti e fornitori non lasciano mai il vostro ambiente pur beneficiando dello stesso rilevamento delle anomalie e tracciamento dello schema. Unita a una solida strategia di MDM, questa combinazione trasforma un progetto di pulizia una tantum in un sistema che continua a intercettare i problemi molto tempo dopo il rollout iniziale, ed è davvero l'unico modo in cui il master data management resta affidabile su scala aziendale.
Mantenere i master data pronti per il futuro
Il master data management non è un progetto che si conclude e si archivia. È una disciplina che deve sopravvivere a nuove acquisizioni, nuove normative e nuovi sistemi per i quali nessuno ha ancora progettato regole di matching. Le organizzazioni che ci riescono trattano governance e monitoraggio come costi operativi permanenti, non come budget di pulizia una tantum, e integrano il ciclo di feedback tra i due nel modo in cui i team lavorano ogni giorno.
Prendete le decisioni giuste su strategia, responsabilità e strumenti sulla base di quanto avete letto qui, poi chiudete il cerchio con controlli continui che intercettino il drift prima che raggiunga una dashboard o un'autorità di vigilanza. È questa combinazione a mantenere davvero vera un'unica fonte di verità anche sei mesi e sei aggiornamenti di sistema dopo.
Se volete vedere come il rilevamento automatico delle anomalie e il tracciamento dello schema possano mantenere affidabili i vostri master data senza aggiungere lavoro di revisione manuale, esplorate la piattaforma di data observability di digna e scoprite che cosa intercetta nel vostro ambiente.
Poiché una colonna rinominata o un tipo di dato modificato possono rompere silenziosamente la logica di matching dell'MDM, vale la pena vedere come digna Schema Tracker segnala le modifiche strutturali nelle tabelle sorgente prima che raggiungano i vostri master record.
Domande frequenti
Che cos'è il master data management?
Il Master Data Management (MDM) è la disciplina che consiste nell'identificare, pulire e governare le entità di business critiche come clienti, prodotti, fornitori e sedi. Il suo obiettivo è un'unica versione coerente e affidabile di ciascun record che circoli in tutti i sistemi, superando la situazione familiare in cui cinque sistemi contengono cinque versioni dello stesso cliente.
Quali sono i tre approcci architetturali dell'MDM?
Le aziende di solito scelgono tra registry, consolidation e coexistence. Il registry collega i record tra i sistemi senza spostare i dati, la consolidation copia i dati in un hub centrale per il reporting e la coexistence prevede che l'hub rimandi gli aggiornamenti ai sistemi sorgente. Nessuno è migliore in assoluto: dipende da quante modifiche ai sistemi sorgente potete tollerare.
Come dovrebbe essere introdotto un programma di MDM?
Per fasi, partendo da un business case anziché da un modello dati. Scegliete un caso d'uso doloroso e misurabile, come i clienti duplicati che sprecano budget di marketing, nominate un responsabile per ogni dominio, dimostrate lì il modello, misurate i tassi di matching e la riduzione degli errori, quindi estendete le stesse regole di governance e di matching al dominio successivo.
Che cosa valutare nella scelta degli strumenti di MDM?
Partite dal deployment, poiché le aziende regolamentate possono avere bisogno di un cloud privato o dell'on-premises. Poi eseguite un proof of concept sui vostri dati disordinati e verificate se lo strumento gestisce il fuzzy matching, supporta regole di survivorship configurabili, consente agli utenti di business di regolare le soglie di matching e registra ogni unione e modifica ai fini dell'audit.
In che modo la data observability supporta il master data management?
L'MDM definisce che aspetto ha un record corretto, ma non lo sorveglia in seguito. L'observability monitora i dati che scorrono realmente nelle pipeline e segnala problemi come un picco di ID fornitore duplicati, un caricamento giornaliero dei clienti mancante o una colonna rinominata che rompe silenziosamente la logica di matching, prima che finanza o marketing vedano numeri errati.


