Responsabilità del data owner: guida ai compiti chiave 2026
|
8
min di lettura

Probabilmente avete già vissuto quel momento. Una dashboard per il management mostra un valore dei ricavi nel documento per il consiglio di amministrazione, un altro in finanza e un terzo nello strumento di BI di cui il vostro team si fida di più. Slack si riempie di messaggi. I data engineer iniziano a controllare le pipeline. Gli analisti confrontano i filtri. Qualcuno chiede se la sincronizzazione del CRM sia fallita. Qualcun altro dà la colpa alle definizioni.
Il più delle volte il problema non è la dashboard. È che nessuno con un'autorità sufficiente ha la responsabilità del dataset sottostante dall'inizio alla fine.
Ecco perché le responsabilità del data owner contano così tanto. Un data owner non è la persona che sistema ogni caricamento fallito o valida ogni riga. Il data owner è la figura senior che decide cosa significano i dati, quale qualità è accettabile, chi vi ha accesso, per quanto tempo vengono conservati e cosa succede quando qualcosa va storto. Negli ambienti moderni, questa responsabilità funziona solo se l'accountability strategica è accompagnata da una visibilità concreta su schemi, tempestività, regole a livello di record e anomalie.
Indice
L'alto costo dei dati senza owner
Un guasto familiare inizia con una semplice domanda del CEO. Perché il churn dei clienti è salito in una dashboard ed è sceso in un'altra?
Nel giro di un'ora l'azienda è in piena emergenza. La BI controlla la logica semantica. L'ingegneria esamina i caricamenti in ritardo. La finanza chiede se i record storici siano stati riclassificati. Nessuno sa rispondere rapidamente alla domanda di base: chi ha l'autorità per dire quale dataset è quello affidabile, e chi è responsabile di garantire che resti tale?
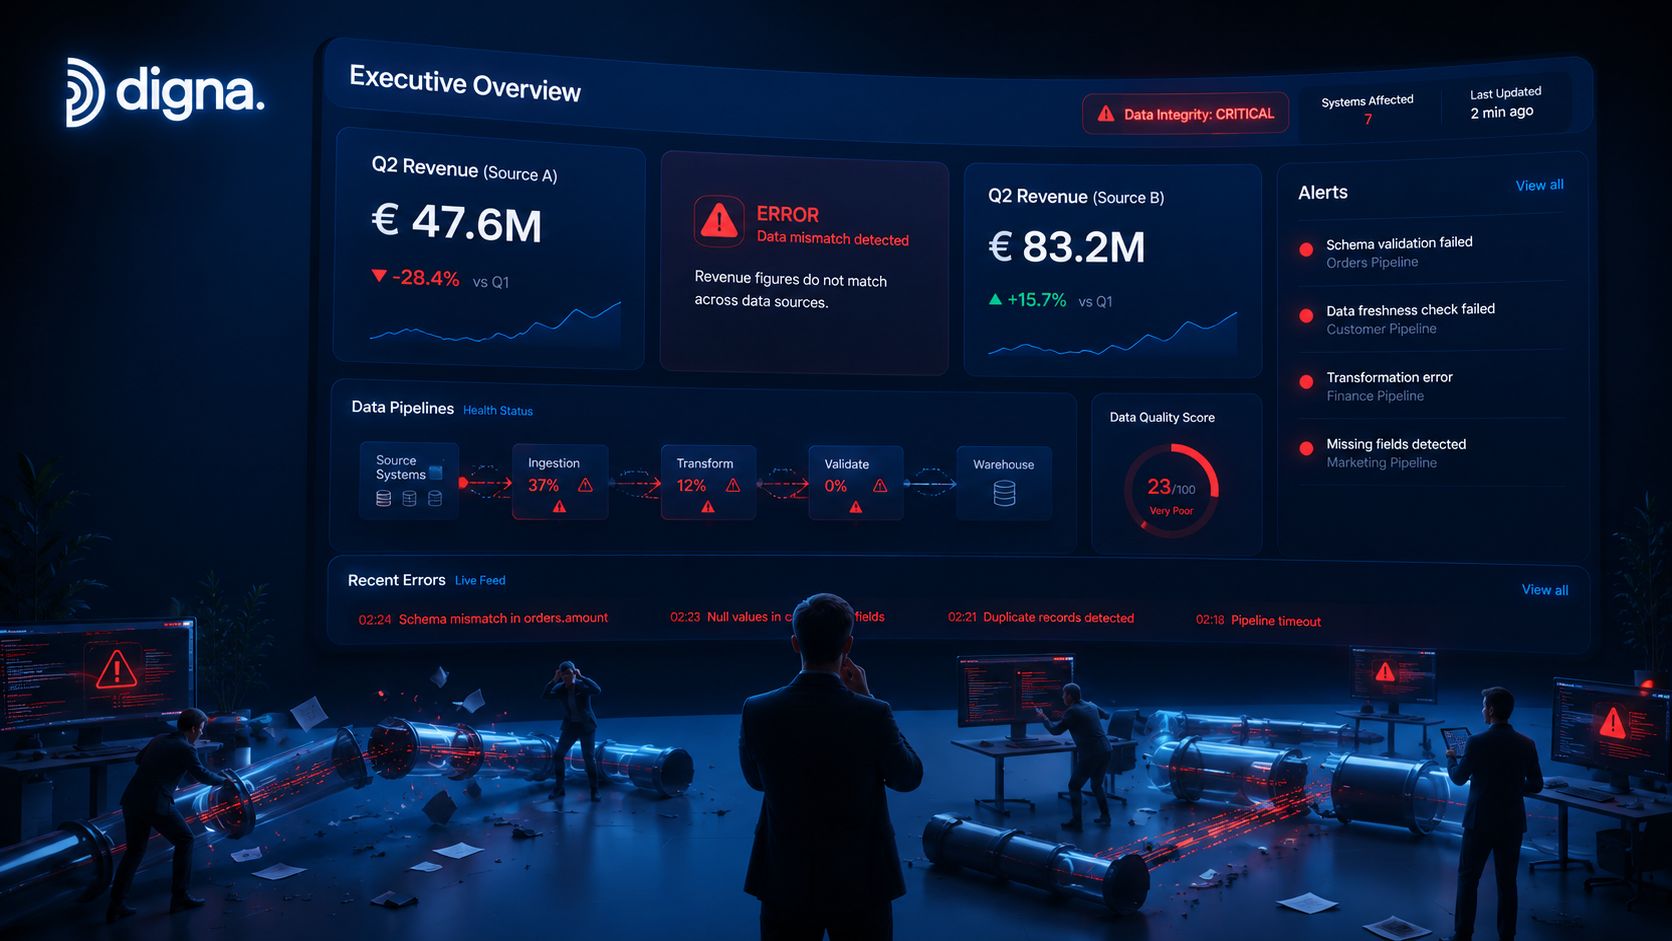
Ecco come appaiono nella pratica i dati senza owner. Non ogni volta un'interruzione clamorosa del sistema, ma un'incertezza ricorrente. I team perdono tempo a riconciliare numeri che dovrebbero già essere governati. Le decisioni rallentano perché ogni metrica importante richiede una nota di cautela. La fiducia si erode un report alla volta.
Dove si trova il vero punto di rottura
Quando la ownership è vaga, i team tecnici ereditano decisioni che non dovrebbero prendere da soli. Gli ingegneri possono dirvi che una colonna è cambiata. Gli analisti possono dirvi che un KPI si è mosso in modo inatteso. I team di sicurezza possono dirvi che gli accessi sembrano rischiosi. Ma questi gruppi non dovrebbero definire il significato di business, la qualità accettabile, le finalità di conservazione e la tolleranza al rischio senza un decisore senior.
Regola pratica: se un dataset può modificare una decisione del consiglio di amministrazione, un budget o la postura di compliance, ha bisogno di un owner designato con un'autorità superiore a quella del team di delivery.
Il divario è più ampio negli stack di dati moderni perché molti guasti non si annunciano. Derive silenziose, modifiche allo schema e distribuzioni insolite possono attraversare le pipeline senza interromperle. Una recente analisi di settore citata da Censinet osserva che il 60% dei problemi di qualità dei dati deriva da derive silenziose e modifiche allo schema che sfuggono al rilevamento manuale, nella discussione sulle lacune dei data owner e sulle realtà dell'observability contenuta in questa analisi di Censinet sui ruoli di ownership.
È questo il problema operativo che molti modelli di governance continuano a sottovalutare. Definiscono l'accountability ad alto livello, ma non dicono agli owner come supervisionare giorno per giorno condizioni dei dati in rapida evoluzione. Se volete stimare l'effetto di questi guasti sul business, un calcolatore del costo del data downtime è un modo utile per impostare la discussione in termini comprensibili al management.
Cosa cambia con la ownership
Un data owner solido riduce la confusione prima che si verifichino gli incidenti. È l'owner a decidere a cosa serve il dataset, quali controlli contano di più e quali team eseguono il lavoro. Questo trasforma la governance da un ideale vago in un modello operativo di business.
I dati senza owner generano riunioni. I dati con un owner generano decisioni.
Chi è un data owner e chi non lo è
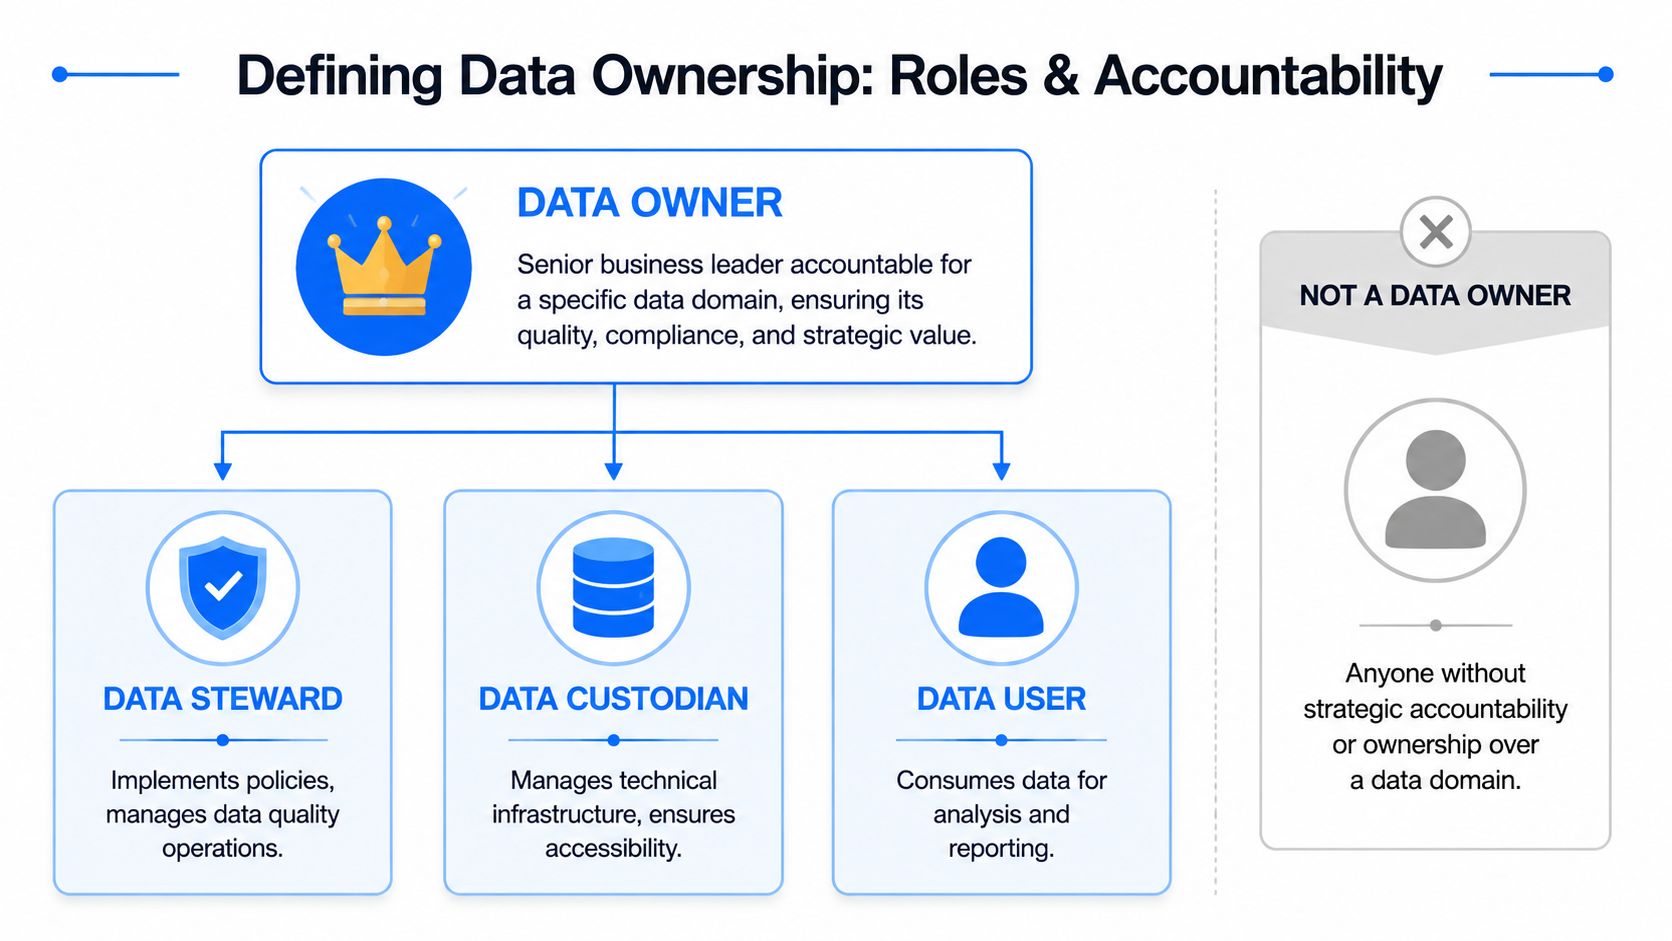
Un data owner è un leader senior del business che detiene la responsabilità ultima per un dominio di dati o un dataset definito. Non ci si aspetta che questa persona scriva SQL, ottimizzi pipeline o amministri lo storage. Ci si aspetta che prenda decisioni vincolanti su significato, aspettative di qualità, accessi, conservazione e rischio.
Nel modello di data ownership del governo britannico, il ruolo è definito esplicitamente come una figura senior con responsabilità specifiche. Lo stesso modello collega la ownership a obblighi legali e operativi e osserva che, ai sensi del GDPR, la non conformità può comportare sanzioni fino a 20 milioni di euro o al 4% del fatturato annuo globale nei casi pertinenti, come illustrato nel modello di data ownership del governo britannico.
Il modo più semplice per distinguere i ruoli
L'analogia più chiara è quella con un immobile.
Il data owner è il proprietario della casa. Decide come viene usato l'immobile, chi può entrare, quale livello di manutenzione è accettabile e quando finanziare le riparazioni importanti.
Il data steward è l'amministratore dell'immobile. Si occupa del lavoro quotidiano sulla qualità, coordina le attività successive e mantiene in funzione i processi operativi.
Il data custodian è la squadra di manutenzione. Gestisce l'infrastruttura, lo storage, i backup, l'implementazione dei permessi e le operazioni della piattaforma.
Il data user è l'inquilino o il visitatore. Utilizza lo spazio, ma non lo governa.
Questa distinzione è importante perché le organizzazioni spesso assegnano la «ownership» alla persona più vicina al sistema. Di solito è un errore. L'ingegnere può gestire la pipeline. L'analista può conoscere il report. Nessuno dei due è automaticamente responsabile delle conseguenze di business di definizioni sbagliate, decisioni di accesso inadeguate o regole di conservazione mancanti.
Chi non è un data owner
Una persona non è un data owner solo perché lavora spesso con i dati.
Ecco alcuni falsi positivi comuni:
L'analista più impegnato: conosce il KPI, ma potrebbe non avere l'autorità per definire le policy o accettare il rischio.
Il lead engineer: gestisce la piattaforma, ma non dovrebbe definire l'uso da parte del business o le finalità normative.
L'amministratore dell'applicazione: può concedere permessi in uno strumento, ma questo non significa che debba decidere chi dovrebbe avere accesso.
Un dirigente senza legame con il dominio: l'anzianità da sola non basta. Gli owner devono avere la responsabilità di business sull'uso dei dati.
Il test è semplice. Questa persona può approvare soglie di qualità, risolvere controversie sul significato, finanziare le correzioni e accettare le conseguenze di un errore?
Se la risposta è no, non è l'owner.
Come si riconosce una buona ownership
I buoni owner sono abbastanza vicini al business da capire perché i dati esistono, e abbastanza senior da intervenire quando emergono dei compromessi. Non si nascondono dietro la frase «è un problema del team dati». Sostengono i controlli, approvano gli standard e rendono concreti i percorsi di escalation.
Ecco perché le responsabilità del data owner più solide spettano a leader di finanza, operations, funzioni cliniche, risk, revenue o prodotto. Il ruolo è strategico, ma deve comunque collegarsi a evidenze operative.
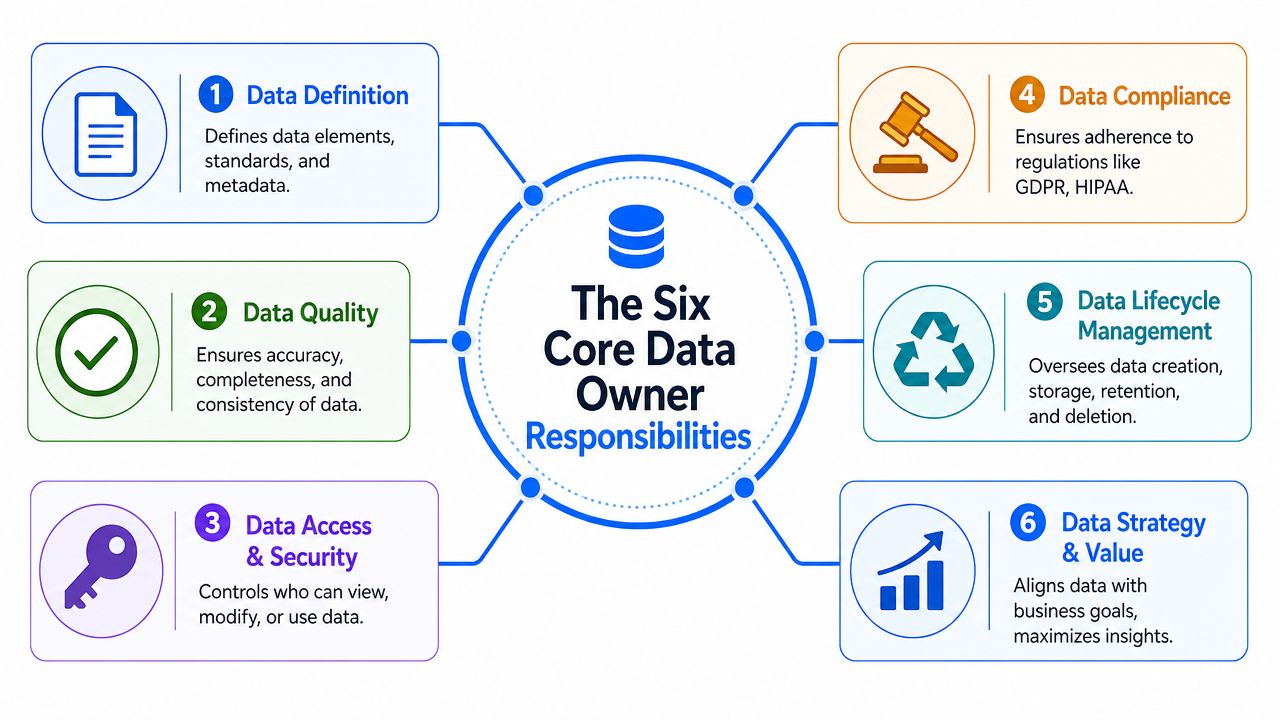
Le sei responsabilità fondamentali del data owner
Il ruolo diventa gestibile quando lo si scompone in pochi obblighi chiari. Queste sono le responsabilità del data owner fondamentali che contano di più nella pratica.
La data ownership si colloca inoltre in un contesto più ampio di sicurezza e compliance. Se volete una panoramica concreta dei controlli correlati, questa guida DFW alla sicurezza dei dati e alla compliance è un complemento pratico per i dirigenti che devono allineare la governance al rischio aziendale.
Qualità dei dati
Gli owner non puliscono i record personalmente. Definiscono cosa significa «abbastanza buono» e garantiscono che i team possano farlo rispettare.
Ciò include la definizione delle aspettative in termini di accuratezza, completezza, coerenza e tempestività. DataSunrise descrive gli owner come responsabili della classificazione dei dataset, della definizione degli standard di qualità dei dati e delle policy di accesso, con i leader senior del settore sanitario che detengono la responsabilità ultima su come i dataset vengono protetti e utilizzati nell'ambito di framework come HIPAA e GDPR, nella sua panoramica sul ruolo del data owner nella governance.
In pratica, una buona ownership significa che il business non dice «migliorate i dati». Dice cose come:
lo stato del cliente deve corrispondere agli stati di business approvati
i record finanziari chiave non possono essere registrati con campi obbligatori mancanti
le relazioni di riferimento devono restare valide tra le tabelle sorgente e quelle di reporting
le aspettative di consegna per i feed critici devono essere esplicite
Gestione degli accessi
L'owner decide chi deve avere accesso, a quale livello e per quale scopo.
Ciò non significa cliccare manualmente le impostazioni dei permessi in ogni piattaforma. Significa approvare regole di accesso basate sui ruoli, decidere quando un accesso più ampio è giustificato e garantire che i dati sensibili restino riservati agli utenti autorizzati. Un errore comune è lasciare queste decisioni al team tecnico che riesce a implementarle più in fretta.
Un modello di accesso pratico pone tre domande:
Ambito decisionale | Cosa decide l'owner | Cosa eseguono i team |
|---|---|---|
Esigenza di business | Chi ha bisogno di accesso e perché | Lo steward convalida il contesto della richiesta |
Ambito dei permessi | Lettura, scrittura, cancellazione, esportazione, amministrazione | Il custodian o l'amministratore applica i controlli |
Ciclo di revisione | Quando gli accessi devono essere rivisti | Governance e sicurezza verificano il completamento |
Compliance e sicurezza
La responsabilità della compliance non può essere delegata solo perché esistono controlli tecnici. L'owner deve garantire che il dataset sia gestito in conformità alle leggi, agli obblighi contrattuali e alle policy interne che lo riguardano.
Ciò significa sapere se i dati contengono informazioni regolamentate, garantire l'esistenza di tutele adeguate ed esigere evidenze del funzionamento dei controlli. Nei settori regolamentati è uno degli aspetti più visibili del ruolo, perché gli errori sono costosi e pubblici.
Un framework di controllo debole nasce di solito da una decisione di ownership debole, non da una dashboard mancante.
Gestione del ciclo di vita dei dati
Ogni dataset importante ha bisogno di un ciclo di vita. Come viene creato, archiviato, conservato ed eliminato? Chi approva le eccezioni? Quando i record storici dovrebbero smettere di essere disponibili per l'uso ordinario?
Gli owner dovrebbero definire le policy di conservazione ed eliminazione in base alle esigenze legali e di business. Senza di esse, i team o conservano tutto per sempre o cancellano in modo troppo aggressivo. Entrambe le cose creano rischi.
Le decisioni più comuni sul ciclo di vita includono:
Periodi di conservazione: per quanto tempo i record devono restare disponibili per motivi di business o legali.
Regole di archiviazione: quando i dati più vecchi passano ad ambienti a costo o accessibilità inferiori.
Standard di eliminazione: come i dati vengono cancellati o dismessi quando non servono più.
Gestione delle eccezioni: quali casi giustificano l'estensione della conservazione o la limitazione della cancellazione.
Una breve spiegazione può aiutare a inquadrare il lato operativo di queste decisioni:
Data lineage e documentazione
Molti fallimenti della ownership si verificano perché l'owner ha la responsabilità ma non la visibilità. Se non potete ricostruire da dove provengono i dati, come sono cambiati e dove vengono utilizzati, non potete governarli bene.
Gli owner dovrebbero esigere una documentazione aggiornata su:
definizioni di business
campi critici e loro significato
sorgenti upstream
report, modelli e applicazioni a valle
limiti noti e punti di controllo
Non si tratta di documentazione fine a se stessa. È ciò che permette all'owner di valutare l'impatto quando qualcosa cambia.
Risposta agli incidenti
L'owner svolge un ruolo decisivo quando si verificano incidenti sui dati. Potrebbe non diagnosticare personalmente la causa principale, ma deve far parte della catena decisionale quando un dataset è inaffidabile, esposto, in ritardo o modificato nella struttura.
Una buona gestione degli incidenti da parte dell'owner include:
Confermare l'impatto sul business, così che l'organizzazione sappia quali decisioni o report sono interessati.
Approvare le priorità di correzione quando i team hanno diverse soluzioni possibili.
Dirigere la comunicazione verso gli stakeholder che dipendono dal dataset.
Esigere controlli successivi, così da impedire che lo stesso problema si ripeta.
L'owner è la persona che chiude il cerchio tra il ripristino tecnico e l'accountability di business. Senza questa figura, gli incidenti vengono risolti in modo circoscritto e poi si ripresentano in una forma leggermente diversa.
Una matrice RACI pratica per la data governance
Se la ownership è chiara in teoria ma confusa nella pratica, usate una matrice RACI. Obbliga il team a decidere chi è Responsible (esegue), Accountable (risponde del risultato), Consulted (consultato) e Informed (informato) per ogni attività di governance ricorrente.
Questa distinzione è importante. Responsible significa svolgere il lavoro. Accountable significa rispondere del risultato. Nei modelli di governance sani, il data owner è molto spesso la A, anche quando qualcun altro si occupa dell'esecuzione quotidiana.
Come leggere la matrice
Una RACI utile previene due errori comuni. Primo, la stessa attività non finisce in mano a tre team che presumono tutti che se ne occupi qualcun altro. Secondo, l'owner non viene trascinato in un'esecuzione di routine che dovrebbe restare agli steward o ai team tecnici.
Tacto osserva che i data owner devono stabilire soglie quantificabili per accuratezza, completezza e tempestività e che, quando gli owner approvano esplicitamente regole di validazione a livello di record allineate alla logica di business, le organizzazioni registrano una riduzione del 30-40% dei tempi di risposta agli incidenti sui dati nel contesto di quel modello di ownership, come descritto in questa voce di glossario di Tacto sul data owner. Se volete un contesto operativo più ampio per questo tipo di chiarezza sui ruoli, questa panoramica su che cos'è la data governance è un riferimento utile.
Consiglio operativo: se il data owner risulta Responsible per troppe attività tecniche, la matrice è sbagliata. Se l'owner manca come Accountable nelle attività ad alto rischio, la matrice è altrettanto sbagliata.
Esempio di RACI per le attività di governance più comuni
Attività di governance | Data owner | Data steward | Data custodian | Data engineer |
|---|---|---|---|---|
Definire il significato di business dei campi critici | A | R | I | C |
Definire le soglie di qualità dei dati | A | R | I | C |
Approvare le regole di validazione a livello di record | A | C | I | R |
Approvare le policy di accesso | A | C | R | I |
Implementare i controlli tecnici degli accessi | I | C | A/R | I |
Monitorare i guasti delle pipeline | I | C | C | A/R |
Valutare l'impatto sul business dei dati errati | A | R | I | C |
Approvare le policy di conservazione ed eliminazione | A | C | R | I |
Archiviare o cancellare i dati secondo le policy | I | C | A/R | C |
Coordinare le comunicazioni sugli incidenti | A | R | I | C |
Vale la pena tenere a mente alcuni schemi.
L'owner detiene l'accountability sulle regole di business. La sua presenza non dovrebbe essere facoltativa nelle decisioni su qualità, accessi, conservazione o impatto degli incidenti.
Lo steward garantisce la continuità operativa. Questo ruolo mantiene vivi gli standard giorno per giorno.
Il custodian è responsabile dell'applicazione tecnica nell'ambiente. Storage, permessi di sistema e controlli della piattaforma rientrano qui.
L'ingegnere gestisce i meccanismi di delivery. Pipeline, test e correzioni a runtime spettano all'ingegneria.
Se la vostra matrice attuale assegna l'accountability al primo team che viene chiamato in reperibilità, non avete una governance. Avete un'escalation per sfinimento.
Come l'observability moderna supporta i data owner
Un data owner appena nominato si scontra di solito con lo stesso muro nel giro di poche settimane. La policy è firmata, il dominio è assegnato e il primo problema serio arriva comunque come una sorpresa. Una metrica per il consiglio di amministrazione è sbagliata, un estratto normativo è in ritardo o un team di prodotto sta usando un campo il cui significato è cambiato tre release fa. L'accountability resta all'owner, anche quando i segnali d'allarme erano sepolti nei log delle pipeline e in dashboard sparse tra i team.
È questo il divario operativo che l'observability moderna colma. Offre ai data owner un modo concreto per verificare se i controlli che hanno approvato reggono ancora in produzione, su sistemi che non ispezioneranno mai a mano.
Perché le sole dashboard non risolvono l'accountability degli owner
Le dashboard riportano i risultati. La data ownership richiede segnali più precoci.
Una dashboard può mostrare che il KPI di ieri si è caricato correttamente e non accorgersi comunque che record chiave sono arrivati con sei ore di ritardo, che un join ha iniziato a perdere righe dopo una modifica allo schema o che uno spostamento nella distribuzione ha reso il numero tecnicamente completo ma operativamente fuorviante. Quando il problema compare in un report per il management, l'owner è già in modalità incidente.
Gli owner hanno bisogno di un monitoraggio che rifletta gli impegni di business, non solo lo stato di salute dei sistemi. Hanno bisogno di evidenze legate alle policy che approvano, come standard di freschezza, tolleranze di qualità, aspettative sugli accessi e modifiche strutturali ad alto rischio. Negli ambienti private cloud e on-premises questo requisito diventa più difficile, perché i team di governance spesso non possono contare su un ampio accesso del fornitore ai dati di produzione. Egnyte affronta questi problemi di perimetro dei controlli nella sua guida alla data ownership. L'implicazione pratica è semplice. L'observability deve funzionare nell'ambiente in cui l'azienda opera davvero, non in quello che un fornitore di strumenti vorrebbe che esistesse.
Cosa cambia con un'observability efficace
Una buona observability fornisce all'owner evidenze utilizzabili proprio nei punti in cui la governance di solito cede.
Rilevamento delle anomalie: gli owner hanno bisogno di un rilevamento automatico di volumi insoliti, tassi di null, distribuzioni dei valori e altri cambiamenti rilevanti per l'uso da parte del business. La calibrazione manuale delle soglie non scala su un ampio portafoglio di dataset, soprattutto quando il comportamento normale cambia nel tempo. Questo tipo di monitoraggio è rappresentato dalla funzionalità Data Anomalies di digna.
Monitoraggio della tempestività: i dati possono essere accurati e creare comunque un rischio per il business se arrivano troppo tardi per l'uso in finanza, nelle operations o nella compliance. I controlli di tempestività dovrebbero confrontare il comportamento effettivo delle consegne con le schedulazioni attese e i pattern appresi, come descritto nella panoramica di digna sul monitoraggio della tempestività.
Tracciamento dello schema: una colonna aggiunta, rimossa, rinominata o modificata nel tipo può rompere la logica a valle molto prima che un utente di business riesca a spiegare cosa è andato storto. Il tracciamento strutturale continuo aiuta gli owner a individuare le modifiche che richiedono una decisione di policy, un'eccezione o un piano di comunicazione. Questa funzionalità è descritta nell'estensione di digna per il tracciamento dello schema e la validazione.
Validazione a livello di record: molti fallimenti della governance si trovano al di sotto del livello delle dashboard. Unicità su più colonne, integrità referenziale, regole condizionali e controlli a livello di riga sono spesso ciò che separa un dataset affidabile da uno che genera rilievi di audit e rilavorazioni operative. Questi controlli sono stati messi in evidenza nella release della piattaforma digna con le funzionalità di validazione.
Il valore pratico non sta in un numero maggiore di alert. Sta in un triage migliore.
Una configurazione di observability solida aiuta l'owner a rispondere rapidamente a quattro domande. Che cosa è cambiato? Quale processo di business è esposto? È stata superata una soglia di policy? Chi è responsabile della prossima azione? Senza queste risposte, l'accountability si trasforma in escalation di routine e decisioni rimandate.
Aiuta anche separare due concetti che spesso vengono confusi. La qualità definisce gli standard. L'observability mostra se quegli standard reggono in condizioni operative reali, comprese le modalità di guasto per cui nessuno aveva scritto una regola in anticipo. Questo confronto tra data observability e data quality è un breve riferimento utile per chiarire questa distinzione.
Per i data owner, questa differenza conta. La strategia fissa l'aspettativa. L'observability mostra se l'aspettativa sopravvive al contatto con i sistemi in produzione.
Una checklist enterprise per implementare la data ownership
Un nuovo data owner viene nominato dopo un fallimento nel reporting, un problema di audit o un incidente sui dati con impatto sui clienti. È normale. La parte più difficile inizia il giorno dopo, quando il titolo esiste ma i diritti decisionali, i controlli e il monitoraggio ancora no.
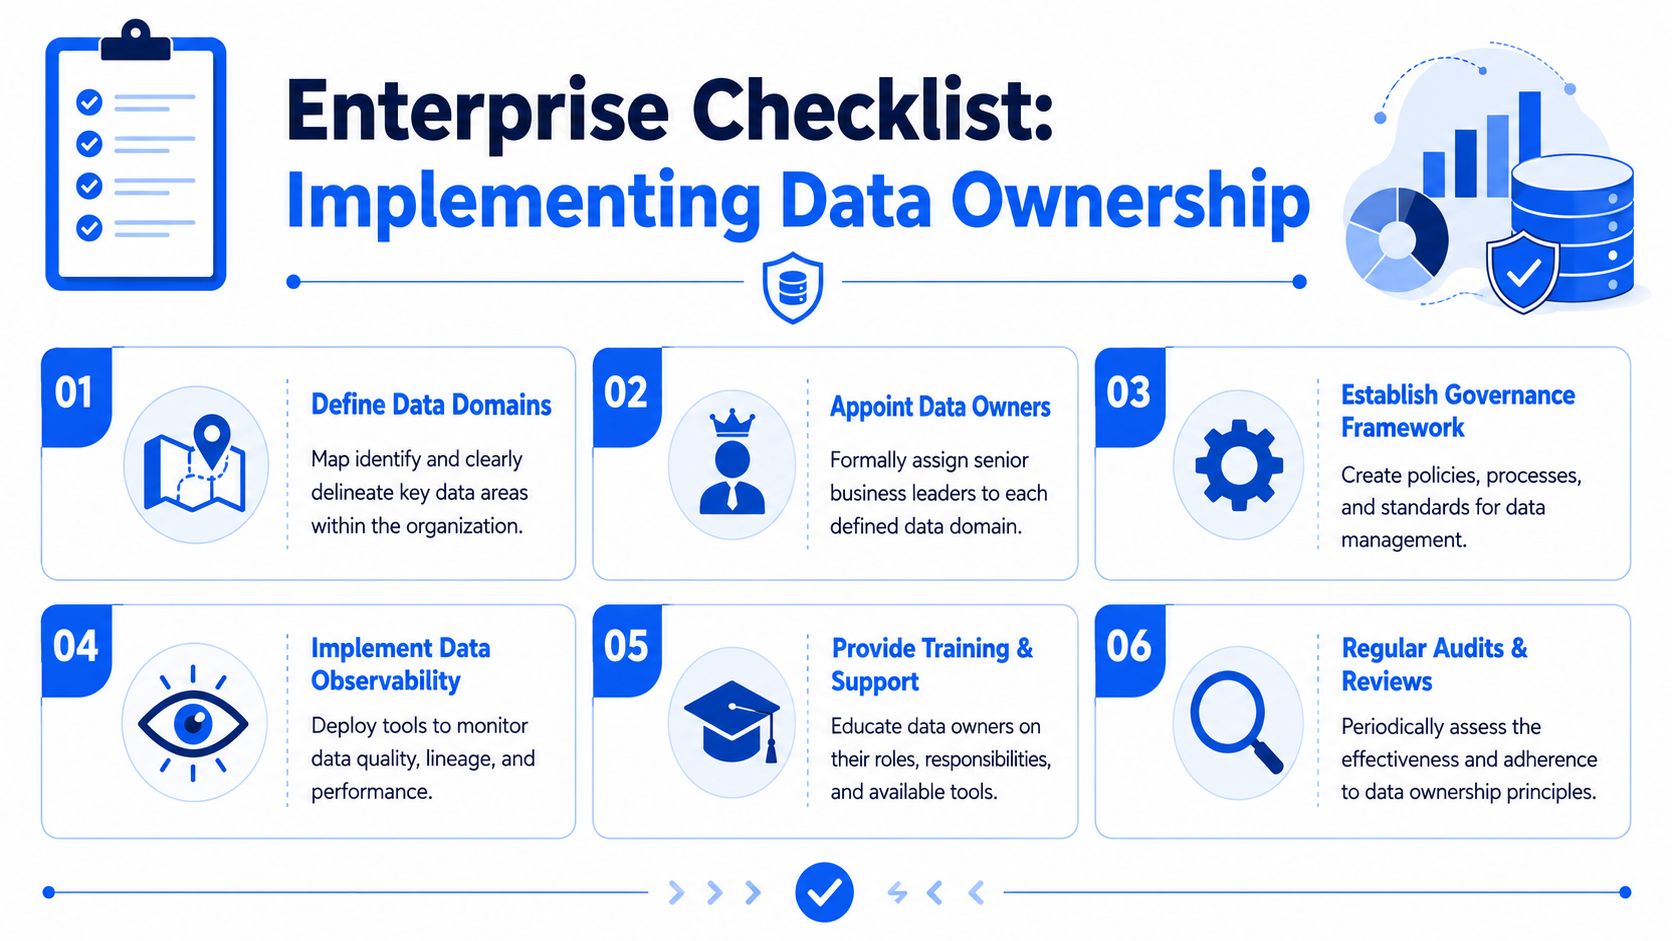
La ownership diventa reale solo quando l'organizzazione fornisce all'owner un perimetro definito, un'autorità chiara ed evidenze su cui agire. Senza tutto questo, il ruolo si riduce a un nome su una slide mentre i team operativi continuano a prendere decisioni frammentate.
Cosa mettere in atto per primo
Usate questa checklist per costruire un modello di ownership che regga la pressione operativa quotidiana.
Definite chiaramente i domini di dati. Partite dai dataset legati al reporting per il management, ai processi regolamentati, alle operazioni con i clienti o alla generazione di ricavi. Mantenete confini abbastanza specifici da permettere a un solo owner di prendere decisioni senza sovrapposizioni o arbitrati continui.
Nominate formalmente owner senior del business. Assegnate il ruolo al dirigente o al leader di business in grado di approvare i compromessi, finanziare le correzioni e accettare le conseguenze di decisioni sbagliate sui dati. Technical lead, steward e team di piattaforma supportano il ruolo, ma non dovrebbero farsi carico per impostazione predefinita dell'accountability di business.
Documentate le policy che l'owner deve approvare. Concentratevi su soglie di qualità, regole di accesso, aspettative di conservazione ed escalation degli incidenti. Lo scopo non è la burocrazia. Lo scopo è dare all'owner uno standard chiaro su cui basare la governance quando un team chiede un'eccezione o quando serve un audit trail.
Create una RACI operativa. Mantenetela pratica. Chi approva gli accessi? Chi definisce le soglie di qualità? Chi indaga sui guasti? Chi comunica l'impatto sul business? Se queste risposte dipendono ancora da chi partecipa alla riunione, la ownership non è ancora in atto.
Introducete l'observability prima nei domini a rischio più alto. I data owner rispondono dei risultati, ma hanno comunque bisogno di evidenze operative. Partite dai punti in cui pipeline in ritardo, schema drift, validazioni fallite o anomalie silenziose inciderebbero su compliance, reporting finanziario o esperienza del cliente. È questo il collegamento tra accountability strategica e controllo operativo.
Stabilite un ciclo di revisione delle assegnazioni di ownership. Riorganizzazioni, migrazioni di sistemi, acquisizioni e nuove normative possono rompere un modello di ownership che un tempo aveva senso. Rivedete il perimetro dei domini, gli owner designati e i percorsi di escalation con una cadenza prestabilita invece di aspettare un guasto.
Il compromesso è semplice. Un modello leggero si avvia più in fretta, ma di solito lascia gli owner al buio quando gli incidenti attraversano sistemi o team. Un modello più rigoroso richiede più configurazione, ma offre al business una catena di accountability chiara e un modo concreto per verificare se i controlli reggono.
Un programma maturo non si aspetta che i data owner ispezionino le pipeline o scrivano personalmente le regole di validazione. Fornisce loro autorità sulle policy, un reporting affidabile sullo stato di salute dei loro domini e un percorso chiaro per avviare un'azione quando il rischio supera una soglia.
Se state costruendo un modello di ownership concreto e avete bisogno di un'observability che funzioni in ambienti private cloud o on-premises senza accesso del fornitore ai dati di produzione, vale la pena valutare digna. Supporta rilevamento delle anomalie, validazione a livello di record, tracciamento dello schema e monitoraggio della tempestività in ambienti controllati dal cliente, il che rende più semplice per i data owner mantenere l'accountability senza doversi occupare in prima persona del monitoraggio tecnico quotidiano.
Per trasformare le soglie di qualità approvate da un data owner in controlli eseguiti in modo continuo su tutto il suo dominio, guardate la gestione della qualità dei dati con digna.
Domande frequenti
Che cosa fa un data owner?
Un data owner è un leader senior del business con la responsabilità ultima per un dominio di dati o un dataset definito. Invece di scrivere SQL o sistemare i caricamenti, l'owner decide cosa significano i dati, quale qualità è accettabile, chi vi ha accesso, per quanto tempo vengono conservati e cosa succede quando qualcosa va storto.
Qual è la differenza tra data owner, data steward e data custodian?
L'articolo usa l'analogia con un immobile. L'owner è il proprietario della casa che decide uso, accessi e livello di manutenzione accettabile. Lo steward è l'amministratore dell'immobile che si occupa del lavoro quotidiano sulla qualità. Il custodian è la squadra di manutenzione che gestisce infrastruttura, storage, backup e permessi, mentre gli utenti dei dati sono gli inquilini o i visitatori.
Quali sono le responsabilità fondamentali di un data owner?
Sono sei: qualità dei dati, gestione degli accessi, compliance e sicurezza, gestione del ciclo di vita dei dati, data lineage e documentazione, e risposta agli incidenti. In ciascun ambito l'owner definisce le policy e approva le decisioni, come i periodi di conservazione o le priorità di correzione, mentre steward, custodian e ingegneri svolgono il lavoro operativo.
Come funziona una matrice RACI per la data governance?
Una matrice RACI stabilisce chi è Responsible, Accountable, Consulted e Informed per ogni attività di governance. Nell'esempio dell'articolo, il data owner è Accountable per la definizione delle soglie di qualità e l'approvazione delle policy di conservazione, mentre il data engineer è Accountable e Responsible per il monitoraggio dei guasti delle pipeline. Un owner con molte voci R segnala una matrice difettosa.
Come possono i data owner mantenere l'accountability senza monitorare personalmente le pipeline?
Grazie a un'observability legata alle policy che approvano. L'articolo indica quattro funzionalità: rilevamento delle anomalie, monitoraggio della tempestività, tracciamento dello schema e validazione a livello di record. Insieme aiutano un owner a capire rapidamente che cosa è cambiato, quale processo di business è esposto, se è stata superata una soglia di policy e chi è responsabile della prossima azione.


