Che cos'è la gestione della qualità dei dati in sanità
|
8
min di lettura

Un medico apre una dashboard prima del giro visite mattutino e vede un andamento rassicurante. L'ultimo risultato di laboratorio appare nella norma, ma il flusso è arrivato dopo la finestra di reporting. Altrove, un codice diagnostico è in conflitto con l'anamnesi del paziente perché un sistema sorgente ha mappato il valore in modo diverso durante lo scambio. Il record esiste, ma non è adatto alla decisione che si sta prendendo.
Questo è il significato operativo della gestione della qualità dei dati in sanità. Si tratta della disciplina continua che verifica se i dati clinici, operativi, di sanità pubblica, di ricerca e regolatori sono completi, accurati, coerenti, significativi e disponibili quando servono. Il lavoro si estende dai controlli nel punto di raccolta alla validazione degli scambi, al rilevamento delle anomalie, alla correzione, alla lineage e alla governance.
Indice
La posta in gioco dell'integrità dei dati clinici
Dove l'errore diventa visibile
Le dimensioni fondamentali della qualità dei dati sanitari
Quattro domande per lo stesso dataset
Trasformare le dimensioni in controlli
Errori comuni nella validazione dei dati sanitari
Tre modalità di errore da distinguere
Perché i punteggi aggregati nascondono il rischio
Dagli audit statici all'osservabilità continua
Controlli di audit e osservabilità a confronto
Cosa dovrebbe far emergere il monitoraggio continuo
Garantire interoperabilità e conformità normativa
La conformità strutturale non è accordo semantico
Anche dati puliti possono produrre un'IA non sicura
Implementare un framework di data quality scalabile
Costruire il piano di controllo a livelli
Ridurre lo spostamento dei dati e il rumore degli alert
Strategie per i dati sanitari a prova di futuro
La posta in gioco dell'integrità dei dati clinici
Un risultato in ritardo può essere dannoso quanto un risultato errato. Se un data warehouse clinico riceve un valore di laboratorio dopo che l'équipe di cura ha già valutato lo stato del paziente, il dato può essere tecnicamente corretto ma operativamente non sicuro. Lo stesso vale per un'allergia mancante, un'identità del paziente duplicata, una lista farmacologica non aggiornata o una diagnosi il cui significato è cambiato tra un sistema e l'altro.
I team sanitari prendono decisioni attraverso sistemi interconnessi. Cartelle cliniche elettroniche, piattaforme di laboratorio, sistemi di imaging, registri, ambienti di gestione dei rimborsi e data warehouse di reporting contribuiscono ciascuno a una parte della storia del paziente. Quando un componente si guasta, il personale può ripetere esami, riconciliare manualmente i record, ritardare il reporting o agire su un quadro incompleto.
La portata degli scambi rende la disponibilità un requisito di qualità, non una comodità. Nel 2021, l'88% degli ospedali statunitensi ha inviato o ottenuto elettronicamente informazioni sanitarie dei pazienti tramite interrogazioni o ricezione elettronica di documenti di sintesi delle cure, secondo il data brief sull'interoperabilità dell'Office of the National Coordinator for Health IT. Un dato che non può essere trovato, interpretato o usato nel punto di cura manca il suo scopo, anche se resta archiviato da qualche parte.
Dove l'errore diventa visibile
Una scarsa qualità dei dati crea diversi tipi di esposizione operativa:
Rischio clinico: informazioni mancanti o contraddittorie possono distorcere diagnosi, riconciliazione terapeutica e decisioni di trattamento.
Rischio di reporting: eventi incompleti o denominatori instabili possono far apparire gli indicatori di qualità migliori o peggiori della realtà.
Rischio per la ricerca: codifiche e provenienza incoerenti indeboliscono la riproducibilità e rendono più difficile difendere la definizione delle coorti.
Rischio di conformità: i team possono non essere in grado di dimostrare quali record sono stati controllati, quale regola è fallita e come è avvenuta la correzione.
Rischio di fiducia: medici e analisti smettono di affidarsi alle dashboard quando trovano ripetutamente discrepanze.
Un progetto periodico di pulizia non risolve queste condizioni. Quando un audit individua un'interfaccia in ritardo, una mappatura errata o il caricamento mancante di una struttura, report e modelli a valle potrebbero aver già consumato i dati. La domanda pratica non è se un'organizzazione abbia errori: ogni ambiente sanitario complesso ne ha. La domanda è se sia in grado di individuare tempestivamente i problemi rilevanti, determinarne la causa e conservare le prove della risposta.
Per una visione concreta di come questi errori incidono sulle cure, consultate cinque gravi incidenti causati dalla scarsa qualità dei dati sanitari. La lezione principale è semplice: l'integrità dei dati fa parte della sicurezza clinica e del controllo operativo, non è una questione isolata nel backlog del data engineering.
Le dimensioni fondamentali della qualità dei dati sanitari
Il framework Data Quality Review dell'Organizzazione Mondiale della Sanità offre ai team sanitari una base utile. Definisce la qualità attraverso completezza, coerenza interna, confronto esterno e coerenza esterna dei dati di popolazione, come descritto nella guida dell'OMS su framework e metriche.
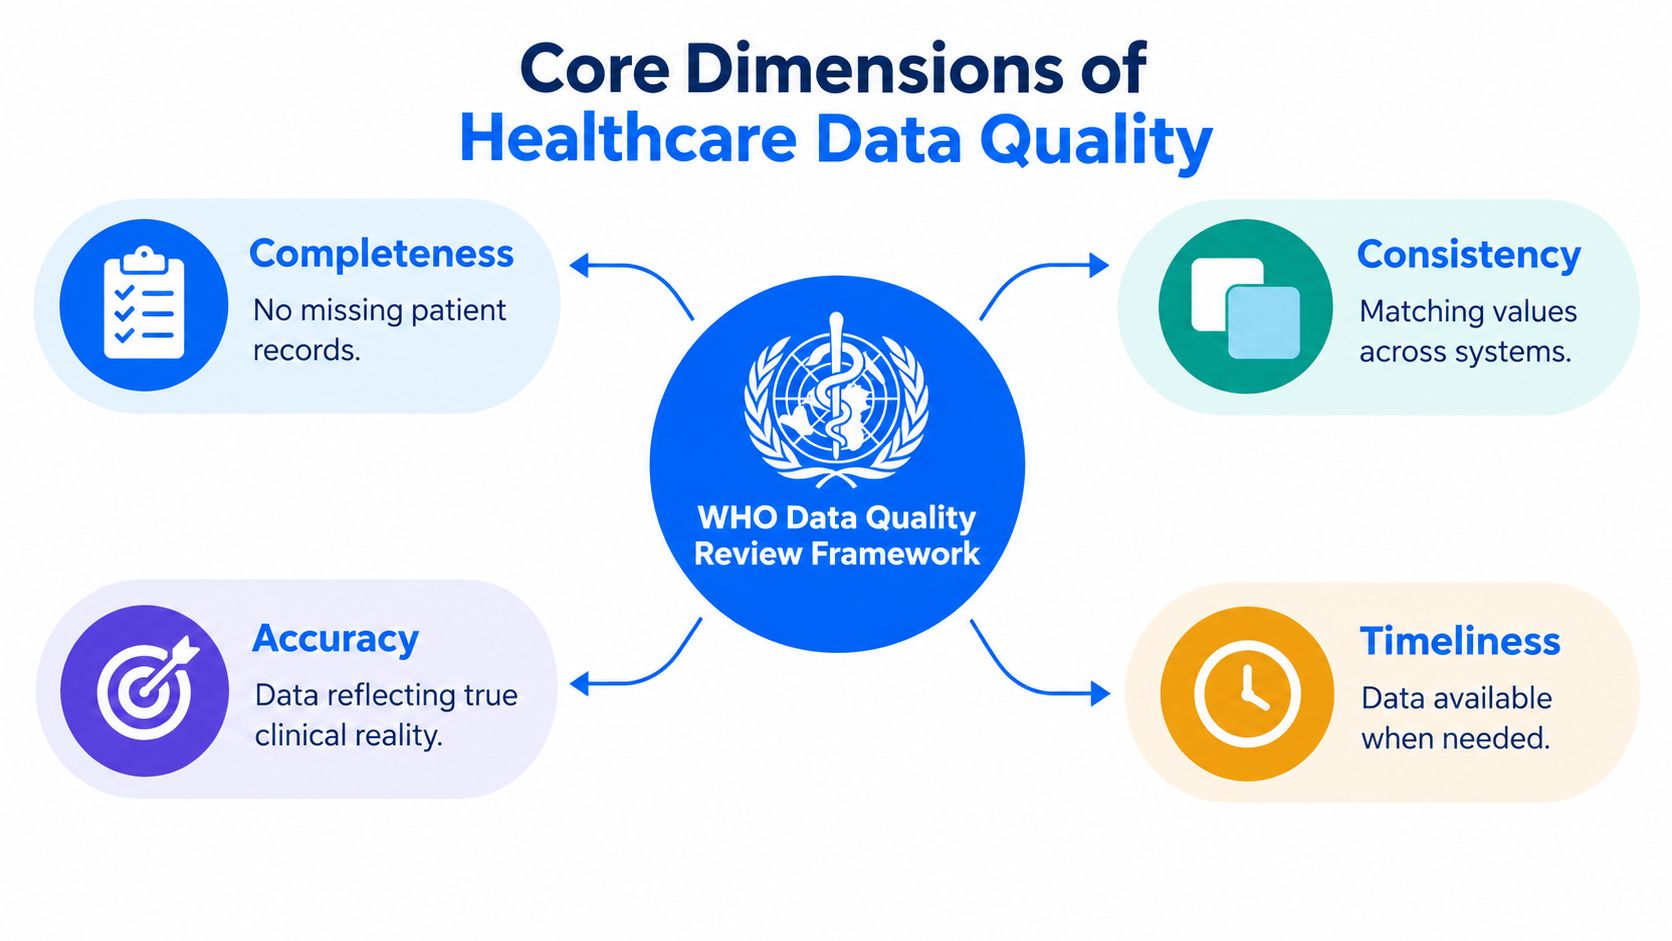
Queste dimensioni forniscono un vocabolario per valutare se i dati sono adatti a un uso definito. Non dovrebbero diventare una checklist slegata dal contesto dei flussi di lavoro.
Quattro domande per lo stesso dataset
La completezza verifica se record, campi, eventi e unità di reporting richiesti sono presenti. Una struttura può inviare gli accessi ma omettere gli eventi di dimissione, oppure compilare i dati anagrafici lasciando vuoti campi clinicamente importanti. La completezza riguarda anche le modalità di consegna: un file completo che arriva dopo una scadenza di reporting può comunque essere inutilizzabile per quello scopo.
La coerenza interna verifica se i valori correlati concordano. Le date devono seguire sequenze valide, i record collegati devono fare riferimento a entità esistenti e i valori devono rispettare le regole cliniche o di business. Età del paziente, data dell'accesso, diagnosi e storico delle procedure possono sembrare validi singolarmente e formare insieme una combinazione impossibile.
Il confronto esterno verifica i totali rispetto a una fonte indipendente. L'attività di una struttura può essere confrontata con un registro, un'applicazione sorgente, un sistema di laboratorio o un registro contabile di reporting. Questo aiuta a individuare sottonotifiche sistematiche che i controlli a livello di record possono non rilevare.
La coerenza esterna dei dati di popolazione esamina se denominatori e stime della popolazione rendono significativi i tassi riportati. Un tasso di vaccinazione, un tasso di ricovero o un indicatore di malattia può essere calcolato correttamente e tuttavia fuorviare i decisori se la stima della popolazione sottostante è obsoleta o non corrispondente.
Il framework supporta anche aspettative pratiche in termini di accuratezza, affidabilità e tempestività. L'accuratezza riguarda quanto un valore rispecchia l'effettiva erogazione del servizio o la realtà clinica. L'affidabilità riguarda la stabilità e l'attendibilità di misurazioni ripetute. La tempestività riguarda la disponibilità delle informazioni entro la finestra richiesta dall'uso previsto.
Trasformare le dimensioni in controlli
Un programma di qualità dovrebbe definire soglie per dataset e flusso di lavoro, non pubblicare un unico punteggio per tutta l'organizzazione. Tra i controlli utili:
Controlli di copertura di campi obbligatori ed eventi.
Validazione di intervalli, set di codici e regole condizionali.
Riconciliazione tra sistemi di totali e identificativi.
Monitoraggio di caricamenti in ritardo, mancanti o insolitamente piccoli.
Documentazione di eccezioni, responsabilità, correzioni e prove.
Le dimensioni della qualità dei dati contano perché un dataset può essere completo ma inaccurato, coerente ma obsoleto, oppure strutturalmente valido ma semanticamente fuorviante. La gestione della qualità inizia quando i team collegano ogni dimensione alla decisione che i dati devono supportare.
Errori comuni nella validazione dei dati sanitari
L'errore di validazione più comune è considerare i campi compilati come prova di qualità. Un valore può essere presente, del tipo corretto e comunque sbagliato per il paziente, per l'episodio di cura o nel significato dopo lo scambio. I team sanitari hanno bisogno di controlli distinti per completezza, accuratezza, validità, coerenza, unicità e tempestività.
La distinzione è operativa. La metodologia di qualità del governo britannico per le infezioni correlate all'assistenza definisce l'accuratezza come vicinanza alla realtà, la completezza come presenza dei record attesi e dei valori essenziali, e la tempestività come attualità e disponibilità per il periodo rappresentato. Sottolinea inoltre un punto cruciale: completezza non significa accuratezza.
Tre modalità di errore da distinguere
Dati mancanti: l'accesso, l'osservazione, il denominatore o il campo obbligatorio atteso non arriva mai. La risposta consiste nell'analizzare raccolta, consegna tramite interfaccia e ingestion.
Dati errati: il record arriva, ma il suo valore è in conflitto con una fonte autorevole, un intervallo o una regola clinica. La risposta richiede confronto, validazione e correzione.
Dati in ritardo o obsoleti: il valore è corretto ma non disponibile quando il flusso di lavoro ne ha bisogno. La risposta richiede baseline di consegna e monitoraggio della tempestività.
Una quarta categoria merita pari attenzione: il fallimento semantico. Due sistemi possono scambiarsi un codice sintatticamente valido attribuendogli significati diversi. Una trasformazione può preservare il formato ma perdere contesto, unità di misura, provenienza o relazione con un'altra risorsa.
Perché i punteggi aggregati nascondono il rischio
Uno studio multicentrico del 2025 condotto in 19 ospedali ha rilevato che il 17,7% dei problemi di qualità dei dati individuati aveva un impatto elevato, interessando almeno la metà dei record pertinenti, e che un'analisi incompleta delle cause degli errori lasciava sfuggire difetti sistemici critici, come riportato nello studio pubblicato sul Journal of the American Medical Informatics Association. Lo studio ha identificato errori di astrazione dalle cartelle cliniche, differenze tra sistemi sorgente ed errori di estrazione dei dati, dimostrando perché i team devono indagare le cause anziché fermarsi a una percentuale di accuratezza.
Una sequenza di validazione utile è:
Validare la struttura: controllate tipi di dati, elementi obbligatori, valori ammessi e integrità referenziale.
Validare il significato: applicate regole cliniche, operative e tra campi.
Validare la consegna: confrontate orario di arrivo, volume, tassi di valori nulli e distribuzioni con il comportamento atteso.
Validare l'impatto: identificate report, indicatori, modelli, strutture e gruppi di pazienti interessati.
Registrare la correzione: conservate regola, fonte, timestamp, numero di record interessati, responsabile e stato.
Questo approccio tratta la validazione come un sistema di controllo anziché come un esercizio di pulizia una tantum. La validazione dei dati sanitari su larga scala dovrebbe aiutare i team a individuare il livello che fallisce e a dare priorità ai difetti che possono cambiare un esito clinico o regolatorio.
Dagli audit statici all'osservabilità continua
Gli audit periodici hanno ancora un ruolo. Forniscono garanzie indipendenti, mettono alla prova la governance e verificano se i controlli funzionano come previsto. Non bastano però come meccanismo principale di rilevamento per dati clinici in rapido movimento.
Una revisione di documenti clinici elettronici ha rilevato che l'86,3% dei documenti campionati conteneva errori, con una media di 4,9 errori per documento, secondo la revisione peer-reviewed dei documenti clinici elettronici. La stessa revisione ha distinto gli alert di completezza da quelli di sintassi, mostrando perché un file arrivato correttamente può comunque contenere difetti che ne compromettono l'uso a valle.
Controlli di audit e osservabilità a confronto
Modello operativo | Punti di forza | Limiti |
|---|---|---|
Audit manuale periodico | Offre profondità di analisi e prove di governance | Rileva gli errori dopo che i dati si sono propagati |
Libreria di regole fisse | Applica requisiti clinici e di business espliciti | Richiede manutenzione e può generare rumore negli alert |
Osservabilità continua | Rileva cambiamenti di comportamento, caricamenti mancanti e derive nella consegna | Richiede la definizione di baseline, responsabilità chiare e un'escalation sensata |
Indagine umana | Interpreta il contesto e conferma la causa principale | Non scala come primo filtro per ogni record |
Un ampio insieme di regole costruito a mano può sembrare rigoroso pur diventando difficile da mantenere. I team possono ignorare gli alert quando le soglie sono fragili, i duplicati sono frequenti o ogni minima variazione di distribuzione riceve la stessa priorità. Al contrario, un sistema privo di regole deterministiche può rilevare comportamenti insoliti senza capire se il cambiamento viola un requisito clinico.
Il modello pratico combina entrambi gli approcci. La validazione deterministica gestisce i vincoli noti, come campi obbligatori, codici validi, relazioni di riferimento e logica clinica condizionale. Il monitoraggio comportamentale apprende i pattern attesi per volumi di record, tassi di valori nulli, orari di consegna, distribuzioni dei valori e attività operativa, quindi segnala le deviazioni che meritano un'indagine.
Cosa dovrebbe far emergere il monitoraggio continuo
Un livello di osservabilità efficace può identificare:
Un caricamento mancante di una struttura o una riduzione inattesa dei record.
Una modifica dello schema che aggiunge, rimuove o altera una colonna.
Uno spostamento improvviso nelle distribuzioni dei codici o nei tassi di valori nulli.
Un flusso che arriva più tardi rispetto al pattern di consegna appreso.
Una metrica di business che esce dal suo intervallo normale.
Un errore di validazione ripetuto e concentrato in una sola fonte o interfaccia.
Il valore non è l'alert in sé. Il valore è il contesto: quale dataset è cambiato, quando, quale fonte lo ha prodotto, quanti record sono interessati e quali prodotti a valle ne dipendono. La data quality observability esprime questo passaggio dalla pulizia reattiva al monitoraggio continuo dell'affidabilità.
Garantire interoperabilità e conformità normativa
L'interoperabilità viene spesso ridotta alla capacità dei sistemi di scambiarsi payload. Questa definizione è troppo debole per il lavoro clinico. Un sistema ricevente deve essere in grado di analizzare, interpretare, mettere in relazione e utilizzare le informazioni entro la finestra temporale richiesta.
Lo United States Core Data for Interoperability, o USCDI, definisce le classi di dati e gli elementi fondamentali che i sistemi di health IT certificati devono supportare. Tra le specifiche applicabili figurano HL7 FHIR US Core e la Consolidated Clinical Document Architecture. Anche i requisiti HL7 Patient Information Quality Improvement descrivono meccanismi per valutare i dati strutturati, tra cui campi obbligatori, binding terminologici, struttura dei documenti e relazioni tra le risorse scambiate.
La conformità strutturale non è accordo semantico
La validazione FHIR può controllare tipi di dati, cardinalità, espressioni, terminologia e riferimenti. Questi controlli sono necessari, ma non garantiscono che due organizzazioni usino un concetto nello stesso contesto operativo. Il disallineamento semantico tra standard come HL7 FHIR e SNOMED CT può lasciare dati tecnicamente interoperabili con un significato incoerente.
Anche gli standard evolvono. USCDI e le relative specifiche di scambio vengono aggiornati ogni anno, per cui le organizzazioni hanno bisogno di tracciare i cambiamenti anziché di un progetto di conformità una tantum. Un elemento, un binding terminologico, un profilo o una struttura documentale modificati possono influire su ingestion, reporting, analytics e modelli a valle.
Regola pratica: trattate ogni confine di scambio come un confine di qualità. Validate cosa è arrivato, cosa significa, quando è arrivato e come si relaziona ai dati sorgente autorevoli.
Anche dati puliti possono produrre un'IA non sicura
Un dataset può superare i controlli di schema e completezza pur restando non rappresentativo. I dati mancanti possono concentrarsi in una popolazione, le pratiche di codifica possono variare da struttura a struttura e le patologie rare possono essere sottoregistrate. Questi pattern influiscono non solo sull'analisi descrittiva, ma anche sullo sviluppo e sul monitoraggio dei modelli.
Una revisione del 2025 delle National Academies ha evidenziato che disponibilità, qualità e bias dei dati sono strettamente collegati nell'IA sanitaria, avvertendo che i sistemi automatizzati possono amplificare le debolezze semantiche e di qualità dei dati anziché correggerle, come sintetizzato nella revisione delle National Academies. Questo sposta la domanda sulla qualità da «La tabella è pulita?» a «Chi è rappresentato, di chi mancano i dati e come cambiano le prestazioni tra contesti e gruppi?»
Un programma difendibile collega i controlli tecnici alla governance:
Preservate la lineage dalla raccolta alla trasformazione.
Registrate la provenienza e le mappature semantiche.
Monitorate la completezza per sottogruppi e le variazioni delle distribuzioni.
Tracciate le modifiche alle codifiche e il comportamento specifico delle fonti.
Esaminate gli esiti a valle, non solo i tassi di superamento delle validazioni.
Fate risalire i peggioramenti inspiegati ai responsabili clinici e di governance.
La conformità dei dati sanitari richiede quindi più di semplici controlli di formato. Richiede prove che i dati restino comprensibili, tracciabili, tempestivi e appropriati per la decisione o l'uso regolamentato.
Implementare un framework di data quality scalabile
Un framework scalabile parte dall'uso, non dagli strumenti. Identificate le decisioni cliniche, operative e regolatorie che dipendono da ciascun dataset, poi definite che aspetto ha un errore per quell'uso. Un flusso di laboratorio può richiedere un monitoraggio rigoroso della consegna, mentre un dataset storico di ricerca può tollerare ritardi ma richiedere una documentazione più solida su provenienza e completezza.
Costruire il piano di controllo a livelli
Iniziate con un inventario dei dati che colleghi fonti, tabelle, pipeline, responsabili, prodotti a valle e usi previsti. Date priorità ai dataset ad alto impatto invece di tentare di monitorare tutto in una volta.
Stabilite poi quattro livelli di controllo complementari:
Validazione dei record: applicate controlli sui campi obbligatori, validazione dei set di codici, controlli di intervallo, integrità referenziale e regole di business condizionali.
Monitoraggio dei dataset: tracciate volumi, tassi di valori nulli, duplicati, distribuzioni e volatilità inattesa per fonte e struttura.
Monitoraggio della consegna: apprendete il comportamento di arrivo atteso e segnalate caricamenti mancanti, ritardi e tempistiche di consegna insolite.
Monitoraggio strutturale: rilevate colonne aggiunte o rimosse, tipi di dati modificati e altre derive dello schema prima che i consumatori smettano di funzionare in modo imprevisto.
Tenete le prove vicino al controllo. Ogni incidente dovrebbe conservare dataset, regola o segnale, timestamp, fonte, numero di record interessati, gravità, responsabile, stato della correzione e note di risoluzione. Questa registrazione supporta la governance e aiuta gli ingegneri a distinguere un problema di documentazione locale da un guasto di un'interfaccia a monte.
Ridurre lo spostamento dei dati e il rumore degli alert
Gli ambienti sanitari impongono limiti rigorosi allo spostamento dei dati sensibili. L'esecuzione in-database consente ai team di calcolare metriche ed eseguire analisi all'interno del data warehouse o della piattaforma del cliente, riducendo le copie non necessarie e preservando i controlli di accesso esistenti. Il deployment in private cloud e on-premises può supportare ambienti in cui i dati di produzione devono restare all'interno del cloud, della rete privata virtuale o del data center dell'organizzazione.
La progettazione degli alert conta quanto il rilevamento. Inoltrate solo le deviazioni su cui si può agire, raggruppate gli errori correlati, mostrate l'impatto probabile e consentite ai team di sopprimere gli eventi di manutenzione noti senza nascondere comportamenti nuovi. Una piattaforma modulare come digna può combinare rilevamento delle anomalie, validazione a livello di record, monitoraggio della tempestività, tracciamento dello schema e revisione condivisa degli incidenti, mantenendo l'elaborazione nell'ambiente del cliente.
L'obiettivo dell'implementazione non è un punteggio perfetto. È un ciclo operativo ripetibile: rilevare, classificare, indagare, correggere, verificare e imparare.
Strategie per i dati sanitari a prova di futuro
I dati sanitari continueranno ad arrivare da sempre più contesti, dispositivi, applicazioni e percorsi di scambio. Telemedicina, dispositivi indossabili, ricerca genomica e informazioni generate dai pazienti aggiungono segnali utili, ma introducono anche modalità di raccolta, unità di misura, pattern di dati mancanti e requisiti di provenienza diversi. Una strategia resiliente presuppone che la qualità cambierà al cambiare dell'ambiente.
L'approccio più duraturo integra i controlli nel ciclo di vita:
Alla raccolta: rendete esplicito il contesto richiesto e, dove possibile, impedite inserimenti ambigui.
All'ingestion: validate struttura, terminologia, relazioni e identità della fonte.
Durante la trasformazione: preservate lineage, unità di misura, provenienza e decisioni semantiche.
In produzione: monitorate consegna, distribuzioni, comportamento dello schema e impatto sul business.
Dopo gli incidenti: documentate la causa principale e trasformate gli errori ricorrenti in controlli preventivi.
I software development kit programmatici possono inserire i controlli di qualità direttamente nelle pipeline di dati e nelle applicazioni. Ciò riduce il divario tra un ingegnere che modifica una trasformazione e un team di governance che ne scopre le conseguenze in seguito. I controlli dovrebbero comunque essere osservabili, versionati, testabili e collegati a un responsabile.
La data quality diventa duratura quando i team la trattano come una proprietà operativa di ogni pipeline, non come un'ispezione finale prima della pubblicazione.
I programmi sanitari più solidi resistono anche a una definizione ristretta di «pulito». Monitorano la completezza per sottogruppo e contesto, distinguono i valori validi da quelli significativi, verificano la tempestività rispetto alle scadenze cliniche ed esaminano se modelli o report si comportano diversamente dopo modifiche alle fonti. Miglioramento continuo significa affinare le soglie, eliminare i controlli rumorosi, estendere la lineage e coinvolgere gli stakeholder clinici quando anomalie tecniche potrebbero influire sulle cure.
Che cos'è, dunque, la gestione della qualità dei dati in sanità? È la pratica continua di mantenere le informazioni adatte all'uso clinico, operativo, di ricerca, di sanità pubblica e regolatorio a cui sono destinate. Le organizzazioni che integrano questa disciplina nella raccolta, negli scambi, nelle pipeline e nei sistemi decisionali possono trasformare i dati in un asset controllato anziché in una fonte ricorrente di incertezza.
digna offre data quality e osservabilità in-database per i dataset sanitari, con rilevamento delle anomalie, validazione a livello di record, monitoraggio della tempestività e tracciamento dello schema all'interno del vostro ambiente. Visitate digna per valutare un approccio modulare che renda più affidabili i dati clinici, operativi e regolatori.
Identità dei pazienti duplicate e accessi che puntano a record non più esistenti sono errori di relazione tanto quanto errori di valore. Per sapere come verificare questi collegamenti tra cartella clinica elettronica, laboratorio e sistemi di reporting, consultate l'integrità referenziale nei dati sanitari.
Domande frequenti
Che cos'è la gestione della qualità dei dati in sanità?
È la disciplina continua che verifica che i dati clinici, operativi, di ricerca, di sanità pubblica e regolatori siano completi, accurati, coerenti, significativi e disponibili quando servono. Il lavoro va dai controlli nel punto di raccolta alla validazione degli scambi, al rilevamento delle anomalie e alla correzione, fino a lineage e governance, anziché essere un progetto di pulizia una tantum.
Quali dimensioni usa l'OMS per valutare la qualità dei dati sanitari?
Il framework Data Quality Review dell'OMS utilizza completezza, coerenza interna, confronto esterno con una fonte indipendente e coerenza esterna dei dati di popolazione, come i denominatori. Supporta inoltre aspettative di accuratezza, affidabilità e tempestività. I team dovrebbero tradurre ogni dimensione in soglie per uno specifico dataset e flusso di lavoro, invece di un unico punteggio per tutta l'organizzazione.
Perché un record completo non è una prova di dati sanitari di qualità?
Completezza non significa accuratezza. Un valore può essere presente e del tipo corretto, ma sbagliato per il paziente, per l'episodio di cura o nel significato dopo lo scambio. Dati mancanti, errati, in ritardo e semanticamente disallineati sono modalità di errore distinte, e ciascuna richiede un proprio controllo, dai controlli sulle interfacce alle baseline di consegna fino alla mappatura terminologica.
Perché gli audit periodici non bastano per i dati clinici?
Gli audit rilevano gli errori solo dopo che i dati hanno già raggiunto report e modelli. Una revisione ha riscontrato errori nell'86,3% dei documenti clinici elettronici campionati. L'osservabilità continua integra gli audit segnalando caricamenti mancanti delle strutture, flussi in ritardo, modifiche dello schema e variazioni nei tassi di valori nulli o nelle distribuzioni dei codici quando c'è ancora tempo per intervenire.
Come si costruisce un framework scalabile per la qualità dei dati sanitari?
Partite dalle decisioni che ciascun dataset supporta, poi stratificate i controlli: validazione dei record, monitoraggio dei dataset su volumi e distribuzioni, monitoraggio della consegna rispetto ai pattern di arrivo appresi e monitoraggio strutturale delle derive dello schema. Eseguire i controlli in-database limita lo spostamento dei dati sensibili, e ogni incidente dovrebbe registrare responsabile, record interessati e stato della correzione.


