Gestione dei dati nei servizi finanziari: una guida pratica
|
8
min di lettura

Una richiesta di stress test dell'autorità di vigilanza arriva prima di pranzo. A metà pomeriggio il chief risk officer non dispone ancora di una vista affidabile delle esposizioni per entità giuridica, regione, prodotto e asset class. Un team sta riconciliando fogli di calcolo, un altro attende un file sorgente in ritardo e la dashboard su cui tutti fanno affidamento si basa sui dati del giorno prima.
Questa situazione non è insolita perché alle istituzioni finanziarie mancano i dati. Il problema è che i dati non riescono a muoversi nell'organizzazione con sufficiente controllo, contesto e velocità. La disciplina pratica della gestione dei dati nei servizi finanziari esiste proprio per risolvere questo problema, dall'origine nei sistemi core fino ad aggregazione, validazione, reporting, utilizzo nei modelli ed evidenze per l'audit.
Indice
Quando i dati di rischio non riuscivano a muoversi abbastanza in fretta
Che cosa comprende davvero la gestione dei dati finanziari
I quattro pilastri del modello operativo
Trasformare BCBS 239 in controlli ingegneristici
Dal principio alla pipeline
Le sei dimensioni della qualità dei dati a cui le banche non possono rinunciare
Le dimensioni in termini operativi
Controlli deterministici e rilevamento adattivo
Lineage, Schema Tracking e Timeliness come un unico sistema
Che cosa deve registrare il control plane
Modernizzare senza centralizzare tutto
Usare un control plane, non solo una piattaforma di destinazione
La qualità dei dati come controllo runtime per AI e modelli
Un modello operativo di 90 giorni per la gestione dei dati finanziari
Quando i dati di rischio non riuscivano a muoversi abbastanza in fretta
Il problema è diventato impossibile da ignorare durante la crisi finanziaria globale del 2007-2009. Le autorità di vigilanza hanno constatato che molte grandi banche non riuscivano ad aggregare rapidamente le esposizioni tra linee di business, entità giuridiche, regioni e prodotti, soprattutto in condizioni di stress. Una banca poteva possedere i record necessari, ma i suoi sistemi non erano in grado di produrre una vista affidabile a livello di gruppo quando i decisori ne avevano bisogno.
Una richiesta di stress test mette rapidamente in luce la debolezza. Il team rischi chiede l'esposizione verso una controparte su tutte le controllate. Il primo estratto arriva senza identificativi di entità. Una seconda fonte utilizza una tassonomia di prodotto diversa. La tesoreria ha un saldo più aggiornato, ma l'area finance ha il dato approvato per il reporting. Le operations sanno che un feed è arrivato in ritardo, eppure la dashboard presenta il risultato come completo.
Regola pratica: se un report sui rischi dipende da riconciliazioni manuali durante una crisi, l'istituzione non ha un processo di reporting. Ha una dipendenza operativa non gestita.
Il Comitato di Basilea ha risposto pubblicando nel gennaio 2013 i “Principles for effective risk data aggregation and risk reporting”. Il framework comprende 14 principi, di cui 11 si applicano direttamente alle banche e tre riguardano revisione prudenziale, strumenti e cooperazione delle autorità di vigilanza. Le sue aspettative vanno oltre la tecnologia di reporting. Le banche hanno bisogno di governance, di un'architettura adeguata, di dati affidabili e completi, di un'aggregazione tempestiva, di adattabilità alle richieste ad hoc e di un reporting chiaro. Questa capacità deve funzionare sia in condizioni ordinarie sia durante una crisi, con un'aggregazione eseguita in larga parte tramite processi automatizzati per ridurre gli errori. Il framework di Basilea resta un riferimento fondamentale per la gestione dei dati e dei rischi in ambito bancario.
La lezione è operativa. Qualità dei dati, lineage, riconciliazione, tempestività e coerenza strutturale non sono miglioramenti separati che possono attendere una futura migrazione di piattaforma. Determinano se il senior management è in grado di individuare concentrazioni, spiegare variazioni, rispondere alle autorità di vigilanza e agire prima che un rischio si trasformi in una perdita. I team che desiderano una visione pratica delle conseguenze possono approfondire anche come la scarsa qualità dei dati genera costi per le istituzioni finanziarie.
Il resto della disciplina discende da questo punto. La governance definisce le responsabilità, l'architettura sposta i dati preservandone il contesto, la qualità verifica l'idoneità all'uso e il reporting dimostra che il risultato è affidabile.
Che cosa comprende davvero la gestione dei dati finanziari
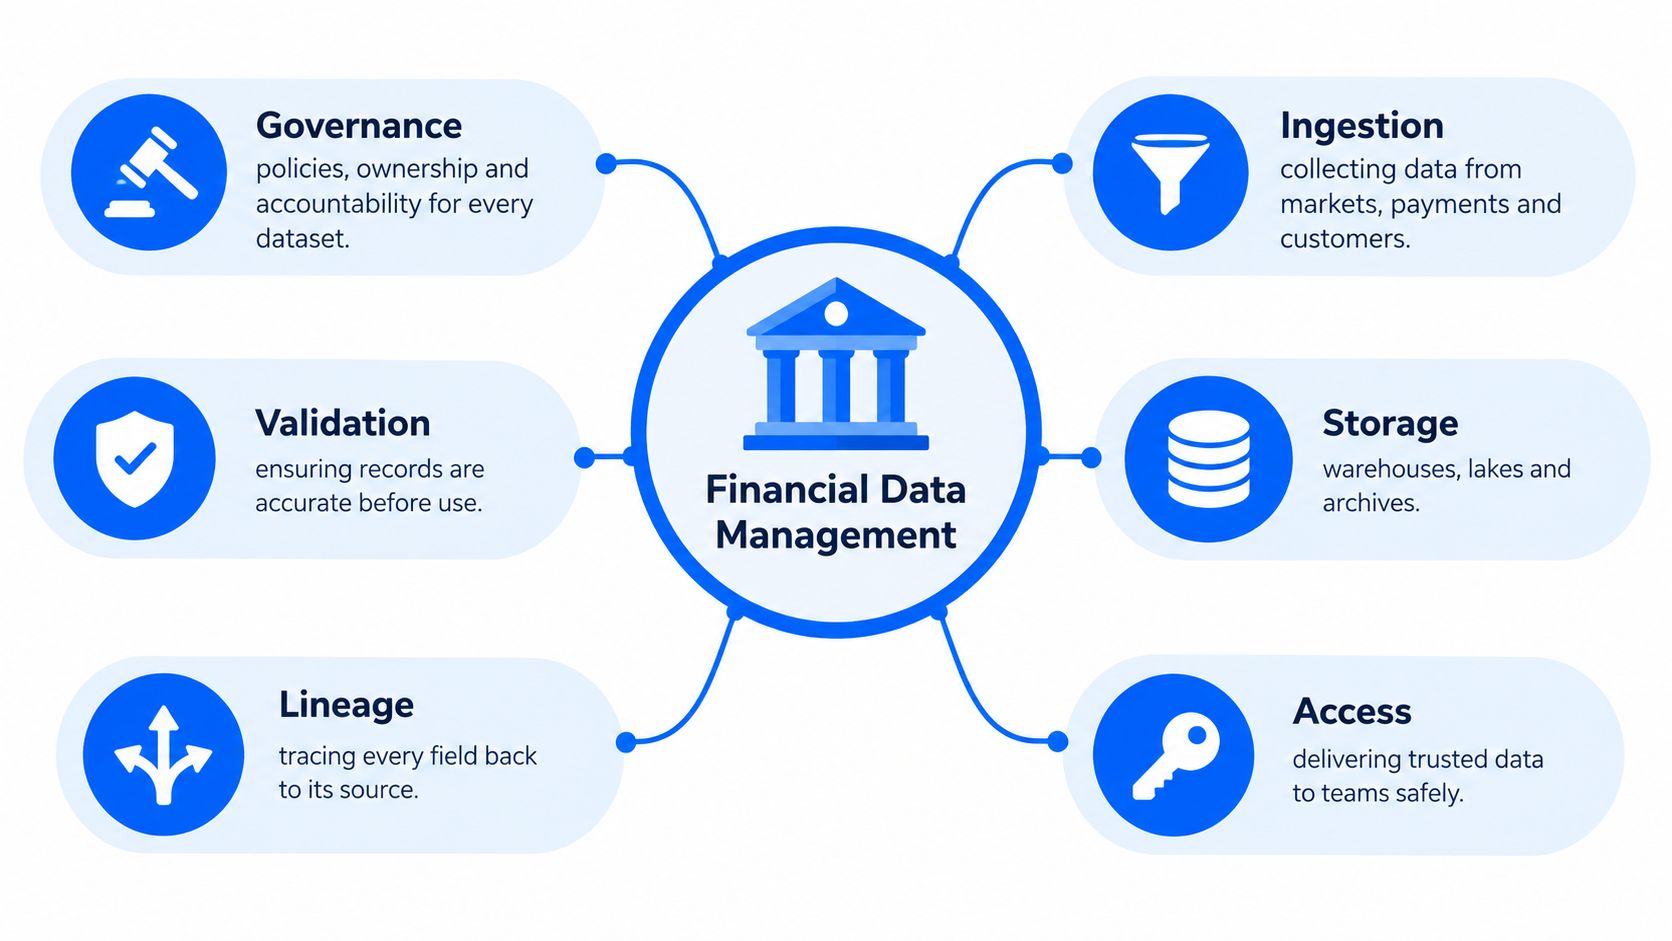
La gestione dei dati nei servizi finanziari è la disciplina end-to-end che governa, sposta, valida, archivia, rende accessibili e rendiconta i dati in tutta l'istituzione. Inizia quando un evento relativo a un cliente, un pagamento, un'operazione di trading, un prestito o il mercato entra in un sistema sorgente. Prosegue attraverso data warehouse, data lake, motori regolamentari, calcoli del rischio, report direzionali, modelli ed evidenze conservate.
Un'analogia utile è quella della strumentazione. Prodotti e processi della banca sono il motore, mentre la gestione dei dati fornisce indicatori, sensori, allarmi e registri di manutenzione. La strumentazione non crea l'attività di business, ma senza di essa il conducente non può capire se il motore funziona normalmente o si sta avvicinando a un guasto.
I quattro pilastri del modello operativo
Governance: assegna ai dati critici owner responsabili, steward, definizioni, soglie, percorsi di escalation e utilizzi consentiti.
Architettura: collega core banking, pagamenti, trading, finance, rischio, data warehouse, data lake e servizi di reporting senza perdere significato né controllo.
Qualità dei dati: verifica se i record sono completi, accurati, tempestivi, validi, univoci e coerenti per un caso d'uso definito.
Reporting: fornisce informazioni chiare, esaustive e riconciliate con la frequenza richiesta da consiglio di amministrazione, management, autorità di vigilanza e team operativi.
Questi pilastri dipendono l'uno dall'altro. Una regola di qualità senza owner non ha un percorso di risposta duraturo. Un report senza lineage non può spiegare da dove proviene un numero. Un archivio centralizzato senza validazione si limita a concentrare record inaffidabili. Una policy di governance senza controlli leggibili dalle macchine resta difficile da verificare e facile da interpretare in modo diverso tra i reparti.
Partite dal caso d'uso, non dal repository. Un report sulla liquidità, un calcolo dell'esposizione creditizia, una decisione sul rischio cliente e una segnalazione regolamentare possono utilizzare dati in parte sovrapposti, ma ciascuno ha requisiti diversi di aggiornamento, completezza e riconciliazione. L'architettura deve preservare queste differenze, offrendo al tempo stesso ai team definizioni condivise ed evidenze di controllo visibili.
Trasformare BCBS 239 in controlli ingegneristici
BCBS 239 viene spesso citato nei comitati direttivi come requisito di governance e poi implementato come l'ennesimo progetto di reporting. Questo approccio ne manca l'intento operativo. I principi rivolti alle banche definiscono aspettative su come un'istituzione identifica i dati rilevanti, li aggrega a livello di gruppo, ne valida il risultato e fornisce informazioni che restano utili sia in condizioni ordinarie sia in condizioni di stress.
Il Comitato di Basilea ha organizzato gli 11 principi rivolti alle banche in tre aree operative: governance e infrastruttura complessive, capacità di aggregazione dei dati di rischio e pratiche di reporting dei rischi. I team di ingegneria possono tradurre queste aree in controlli che producono evidenze anziché dichiarazioni di policy. La pubblicazione originale di BCBS 239 è il riferimento normativo del framework.
Pilastro BCBS 239 | Cosa si aspettano le autorità di vigilanza | Controllo ingegneristico | Evidenze da conservare |
|---|---|---|---|
Governance e infrastruttura | Responsabilità chiare, architettura adeguata, tecnologia affidabile e controlli su tutti i dati di rischio rilevanti | Registro degli elementi di dati critici con owner, steward, definizione, fonte, destinazione, soglia e percorso di escalation | Metadati approvati, storico delle responsabilità, specifiche dei controlli, documentazione dell'architettura |
Aggregazione dei dati di rischio | Aggregazione accurata, completa, tempestiva e adattabile su tutte le dimensioni rilevanti | Riconciliazioni source-to-target, controlli referenziali, rilevamento dei duplicati, monitoraggio dell'aggiornamento, lineage e percorsi di aggregazione on demand | Risultati delle regole, totali di riconciliazione, snapshot di lineage, timestamp di caricamento, registri degli incidenti |
Reporting dei rischi | Reporting accurato, esaustivo, chiaro, utile e con frequenza adeguata | Validazione a livello di report, controlli sulla distribuzione, collegamenti di drill-down, viste specifiche per destinatario e certificazione dei report | Estratti dei report, risultati di validazione, approvazioni, log di distribuzione, decisioni sulle eccezioni |
Dal principio alla pipeline
La governance diventa metadati che i sistemi possono applicare. Per ogni dataset critico registrate chi è responsabile del significato di business, chi gestisce il controllo, che cosa costituisce un errore e chi deve intervenire. La responsabilità deve seguire i dati attraverso i livelli di origine, trasformazione, aggregazione e report, senza fermarsi ai confini dell'applicazione.
La capacità di aggregazione richiede più di un job completato con successo. Confrontate i totali di origine e destinazione, riconciliate i saldi tra i sistemi, verificate le dimensioni obbligatorie come entità giuridica e linea di business e conservate il risultato per ogni ciclo di reporting. Una pipeline che termina senza errori può comunque omettere una partizione, duplicare record o applicare la mappatura di riferimento sbagliata.
I controlli di reporting devono verificare l'output come un prodotto decisionale. Un senior manager riesce a comprendere l'esposizione? Un analista può scendere nel dettaglio fino all'entità o al tipo di asset che vi contribuisce? La banca è in grado di fornire una risposta utile a una richiesta ad hoc senza ricostruire manualmente il report?
L'allineamento a BCBS 239 resta una sfida tecnica considerevole. La valutazione del 2023 del Comitato di Basilea ha riguardato 31 G-SIB e ha rilevato che le banche si trovavano ancora a stadi diversi di allineamento, quasi dieci anni dopo la pubblicazione dei principi e sette anni dopo la data prevista per la conformità. L'implicazione pratica è diretta: una piattaforma di rischio deve essere una pipeline controllata e ripetibile per aggregazione, riconciliazione, lineage e consegna, non un repository di reporting passivo. La valutazione di Basilea fornisce il contesto di vigilanza. I team che valutano le opzioni di implementazione possono anche esaminare un approccio basato sull'AI per rispettare i principi BCBS 239.
Le sei dimensioni della qualità dei dati a cui le banche non possono rinunciare
Un dataset non è “di alta qualità” in astratto. È idoneo, o non idoneo, per una specifica decisione, un report, un modello o un controllo. Un portafoglio prestiti può essere completo ma non aggiornato. Un feed clienti può essere attuale ma inaccurato. Un estratto regolamentare può superare i controlli di formato pur applicando un trattamento valutario incoerente tra le entità.

Le dimensioni in termini operativi
Completezza: verifica se i record e i campi obbligatori sono presenti. La mancanza degli attributi di identificazione del cliente in un feed KYC, o l'assenza del codice dell'entità giuridica in un estratto dei prestiti, può rendere inutilizzabile un dataset per il resto popolato.
Accuratezza: verifica se il valore rappresenta la situazione reale. Il saldo di un prestito che non corrisponde al record autorevole del sistema di gestione deve avviare un'indagine prima di arrivare in un report patrimoniale o direzionale.
Tempestività: verifica se l'informazione arriva quando può ancora supportare la decisione. Un file di operazioni in ritardo può essere tecnicamente valido ma operativamente errato per una vista dei rischi infragiornaliera.
Validità: verifica se i valori rispettano le regole di business e strutturali definite. Date, identificativi di conto, valute, classificazioni e codici prodotto richiedono formati accettati e valori consentiti.
Univocità: impedisce che lo stesso cliente, controparte, conto o transazione compaia più di una volta dove è atteso un solo record. Controparti duplicate possono distorcere l'aggregazione delle esposizioni e le viste di relazione.
Coerenza: verifica se lo stesso fatto concorda tra i sistemi. Un saldo, la normalizzazione valutaria, la gerarchia delle entità o una classificazione di rischio non devono cambiare senza preavviso tra piattaforma core e data warehouse.
Queste dimensioni funzionano insieme, ma non vanno ridotte a un unico punteggio. Un singolo punteggio composito può nascondere un errore rilevante. Riportate invece la dimensione non superata, l'elemento di dati interessato, l'impatto sul business, l'owner e lo stato della remediation. Un comitato rischi deve sapere che un feed è in ritardo o che una riconciliazione dei saldi non è andata a buon fine, non soltanto che un punteggio di qualità è sceso.
Controlli deterministici e rilevamento adattivo
La validazione deterministica è più efficace quando la regola è esplicita. Verificate che ogni prestito abbia un'entità giuridica, che ogni operazione faccia riferimento a uno strumento noto, che ogni conto utilizzi una valuta accettata e che i totali source-to-target si riconcilino. Questi controlli sono spiegabili e facili da collegare alle evidenze di audit.
Il rilevamento delle anomalie aggiunge una capacità diversa. Può individuare una variazione insolita dei volumi, un cambiamento nella distribuzione o un movimento dei saldi rispetto al comportamento normale di un determinato dataset. Non deve sostituire le regole di business. Deve aiutare a capire se un movimento è un evento reale del portafoglio, un caricamento parziale della fonte o una trasformazione non funzionante.
Per una trattazione pratica delle dimensioni e della loro applicazione, consultate le sei dimensioni della qualità dei dati. Il cambiamento operativo più importante è monitorare la qualità in modo continuo. Profilare una tabella durante un progetto di remediation vi dice che cosa è successo in quel momento. I controlli runtime vi dicono se il dataset è ancora sicuro da usare oggi.
Lineage, Schema Tracking e Timeliness come un unico sistema
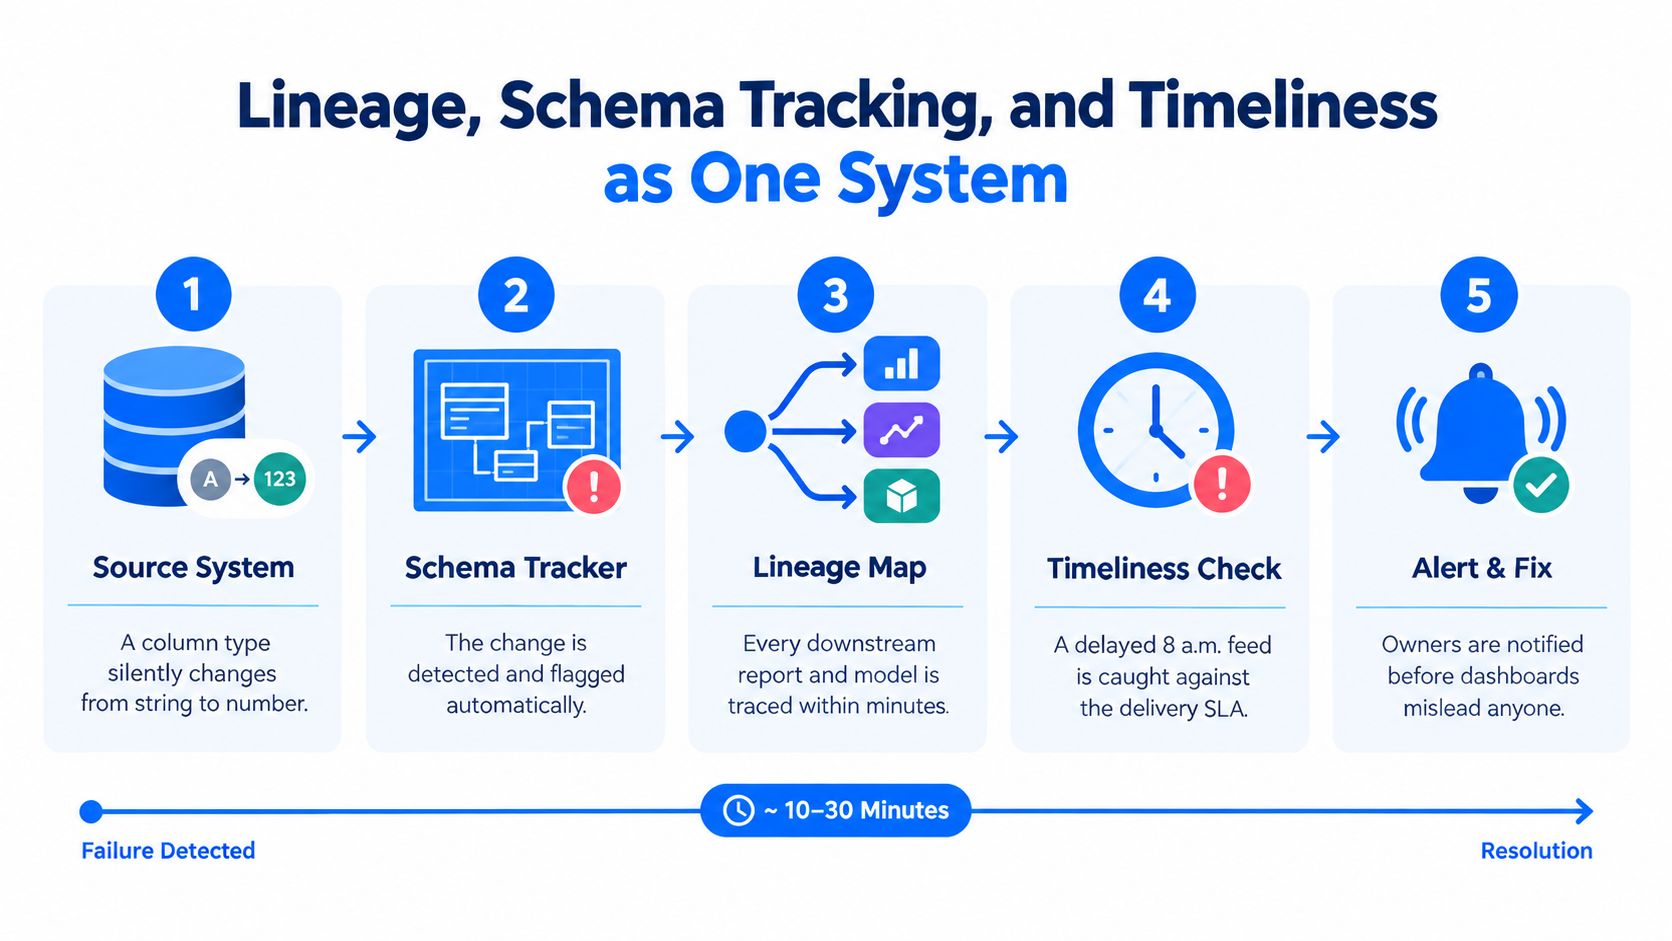
Il lineage viene spesso trattato come un esercizio di diagrammi. La tempestività viene delegata alle operations. Lo schema tracking viene aggiunto dopo che un job a valle si è interrotto. Nei servizi finanziari questi tre controlli vanno insieme, perché una modifica strutturale o un ritardo di consegna possono alterare il significato di un report anche quando ogni job pianificato segnala un esito positivo.
Pensate a un sistema sorgente che trasforma un campo numerico di esposizione in una stringa. Il processo di ingestion accetta il nuovo tipo, una trasformazione converte forzatamente alcuni valori e il job di reporting si completa. L'esposizione risultante può contenere valori null, valori troncati o join non riusciti. Senza schema tracking, l'organizzazione scopre il difetto solo quando qualcuno mette in dubbio il numero.
Una partizione mancante crea un problema simile. La pipeline viene eseguita, ma una regione o un'entità giuridica risulta assente. Un feed di mercato o di transazioni in ritardo può essere altrettanto dannoso quando un report utilizza l'ultimo valore valido precedente e lo presenta come attuale.
Che cosa deve registrare il control plane
Il lineage end-to-end deve identificare la tabella sorgente, il campo, la trasformazione, i dati di riferimento, il dataset di destinazione, il report e il modello che dipendono da un elemento critico. Servono inoltre lo storico delle versioni, le responsabilità, l'ultima consegna riuscita e i risultati dei controlli associati a ogni esecuzione.
Lo schema tracking deve rilevare:
Colonne aggiunte o rimosse: un nuovo campo può essere innocuo, mentre un identificativo rimosso può compromettere i join o la classificazione regolamentare.
Modifiche ai tipi di dati: un importo, una data o una chiave con un tipo diverso può alterare i calcoli senza fermare la pipeline.
Modifiche alle definizioni: un campo può mantenere il nome mentre cambiano il suo significato di business o la logica di popolamento.
Deriva strutturale a valle: un data warehouse o un livello di reporting può discostarsi dal contratto approvato anche quando la fonte resta stabile.
Il monitoraggio della tempestività deve apprendere il comportamento di consegna atteso, anziché applicare un'unica pianificazione fissa a ogni feed. Fonti di mercato, transazionali e batch funzionano in modo diverso. Un feed che di solito arriva in anticipo può risultare anomalo se manca la sua finestra attesa, mentre un orario rigido può generare rumore per una fonte con variazioni legittime.
La valutazione del 2023 del Comitato di Basilea ha riguardato 31 G-SIB e ha rilevato istituzioni a stadi diversi di allineamento a BCBS 239, rafforzando la necessità di pipeline controllate che supportino aggregazione, riconciliazione, lineage e consegna in condizioni normali e di stress. I dettagli della valutazione rendono chiara l'implicazione ingegneristica.
Una distinzione utile è quella tra provenance e lineage. La provenance indica che cosa è successo ai dati e con quale processo. Il lineage mappa come un campo si muove attraverso sistemi e dipendenze. I team che vogliono confrontare i due concetti possono consultare questa guida su data provenance e data lineage. Nessuno dei due è sufficiente da solo. Un lineage privo di controlli strutturali e di aggiornamento è solo un control plane parziale.
Modernizzare senza centralizzare tutto
Una banca può centralizzare i dati di reporting e non superare comunque una revisione BCBS 239. La copia centrale può essere incompleta, in ritardo o scollegata dal sistema responsabile del processo di business. La centralizzazione cambia il luogo in cui risiedono i dati. Da sola non stabilisce responsabilità, validazione, tempestività né evidenze.
Anche i dati di produzione sensibili generano costi quando vengono copiati in una nuova piattaforma. La banca deve proteggere, classificare, riconciliare, governare e spiegare un ulteriore repository. Un archivio centrale può semplificare l'accesso per alcuni utenti, aumentando però duplicazioni, esposizione della privacy, latenza e lavoro di integrazione.
La realtà operativa è distribuita. I record dei clienti possono restare nei sistemi core, le transazioni nei data warehouse, i dati di mercato in piattaforme specializzate e le copie specifiche per giurisdizione sotto controlli separati. La domanda pratica è se la banca sia in grado di dimostrare che i dati critici sono idonei all'uso ovunque si trovino.
Usare un control plane, non solo una piattaforma di destinazione
Un control plane distribuito esegue i controlli vicino ai sistemi sorgente o all'interno del database del cliente, quindi centralizza metadati ed evidenze anziché record sensibili. I suoi controlli operativi dovrebbero comprendere:
Validazione in loco: applicare regole di business alle tabelle sorgente senza creare un'ulteriore copia di produzione.
Responsabilità: assegnare ogni dataset critico, regola, eccezione e azione di remediation a un team responsabile.
Monitoraggio strutturale: rilevare le modifiche di schema all'origine e identificare i consumatori interessati tramite il lineage.
Controlli di aggiornamento: confrontare la consegna effettiva con il comportamento atteso di ciascun feed.
Conservazione delle evidenze: mantenere risultati delle regole, eccezioni, approvazioni, escalation e storico delle remediation.
Priorità basate sul rischio: iniziare dai dataset che supportano reporting su capitale, liquidità, credito, finance e regolamentare.
Questo design trasforma le aspettative di vigilanza di BCBS 239, delle revisioni BCE e di SR 11-7 in evidenze operative. I team possono dimostrare chi è responsabile di un controllo, quale validazione è stata eseguita, se un feed è arrivato entro la finestra attesa, quale schema è cambiato e come sono state risolte le eccezioni.
Il compromesso resta reale. I controlli in loco richiedono metadati, connettori e disciplina sulle responsabilità più solidi. Le piattaforme centralizzate possono semplificare l'analisi, ma una copia centrale può nascondere i difetti della fonte o diventare autorevole senza la prova che resti sincronizzata. Le banche che devono scegliere tra questi modelli possono consultare questo confronto tra data mesh e piattaforme dati centralizzate. La decisione deve basarsi su copertura dei controlli, sensibilità dei dati, prestazioni, giurisdizione e vincoli legacy, non sulla preferenza per un'architettura.
La qualità dei dati come controllo runtime per AI e modelli
Nei servizi finanziari la AI readiness è anzitutto un problema di comportamento dei dati, non di scelta del modello. Un modello validato può comunque comportarsi in modo non sicuro quando il suo feed di input arriva in ritardo, cambia schema, perde una classe, sviluppa una nuova distribuzione o si allontana dalla baseline utilizzata durante la validazione.
Un sondaggio IIF-EY del 2025 ha rilevato che il 79% delle società di servizi finanziari nel complesso e il 100% delle G-SIB e degli assicuratori di rilevanza sistemica globale indicano la qualità dei dati come una delle principali sfide nello sviluppo dell'AI. Tra queste società, il 96% ha segnalato dati rumorosi, non tempestivi, inaccurati o poco adattabili come il principale ostacolo alla messa in produzione. Il sondaggio IIF-EY fornisce le evidenze alla base di questa preoccupazione operativa.
SR 11-7 aggiunge la prospettiva della governance del rischio di modello. Le banche necessitano di controlli documentati su sviluppo, implementazione, validazione, monitoraggio continuo e governance dei modelli. In base alla Supervisory Letter SR 11-7 della Federal Reserve, un'anomalia nei dati può diventare un evento di rischio di modello quando modifica un input senza una spiegazione approvata.
Conservate le evidenze relative al periodo successivo alla validazione, non solo il pacchetto di validazione in sé:
Variazione della baseline: che cosa è cambiato, quando è cambiato e se il movimento era atteso.
Comportamento del feed: se il dataset è arrivato in ritardo, in modo parziale o con partizioni mancanti.
Stato dello schema: quali campi, tipi o definizioni sono cambiati.
Comportamento delle distribuzioni: se le distribuzioni delle classi o dei valori hanno superato la soglia accettata.
Registro delle decisioni: chi ha valutato l'incidente e se la risposta è stata proseguire, effettuare un rollback o rivalidare.
I team che esplorano soluzioni di AI per la finanza dovrebbero considerare questo ciclo di evidenze parte dell'implementazione, non un'appendice di governance da aggiungere in seguito. Un model owner ha bisogno di soglie specifiche per dataset e di trigger espliciti per indagine, rollback o rivalidazione.
Il sondaggio IIF-EY del 2025 ha inoltre rilevato che il 72% delle società disponeva di meccanismi di feedback o controlli per correggere i modelli di AI, mentre un ulteriore 25% ci stava lavorando. Questa direzione rafforza il concetto: la governance dei modelli sta diventando correttiva e operativa. La data observability deve collegarsi direttamente a questo ciclo.
Un modello operativo di 90 giorni per la gestione dei dati finanziari
Iniziate dai dati che possono cambiare una decisione sul rischio, una segnalazione regolamentare, un calcolo del capitale o l'input di un modello. Definite gli elementi di dati critici per dominio di rischio, entità giuridica, linea di business, asset class, area geografica e caso d'uso di reporting.
Assegnate un owner responsabile e uno steward sotto forma di metadati leggibili dalle macchine. Associate a ogni elemento controlli di completezza, tempestività, riconciliazione, integrità referenziale, duplicati e schema. Eseguite i controlli il più vicino possibile alla fonte, conservate le evidenze per ogni ciclo di reporting e indirizzate le eccezioni a persone specifiche.
Usate la validazione deterministica per le regole note e il rilevamento delle anomalie basato su baseline per i comportamenti inattesi. Testate il modello operativo sia con una consegna normale sia con uno scenario di stress prima di estendere la copertura. Un piccolo insieme di dataset controllati e documentati con evidenze è più difendibile di un ampio catalogo privo di un percorso di risposta affidabile.
digna offre data quality e observability direttamente nel vostro ambiente per i team dei servizi finanziari, con validazione nel database, monitoraggio della tempestività, rilevamento delle anomalie, schema tracking ed evidenze per pipeline di dati distribuite. Visitate digna per scoprire come il suo approccio basato sul control plane può aiutarvi a monitorare i dati critici senza dare per scontato che la centralizzazione sia la risposta.
Controparti duplicate e prestiti senza un'entità giuridica valida sono, in fondo, relazioni interrotte tra sistemi. Per i controlli che mantengono allineate queste chiavi dal core banking al risk data warehouse, consultate l'integrità referenziale nei dati bancari.
Domande frequenti
Che cosa comprende la gestione dei dati nei servizi finanziari?
Comprende la governance, lo spostamento, la validazione, l'archiviazione e il reporting dei dati dal momento in cui un pagamento, un'operazione, un prestito o un evento relativo a un cliente entra in un sistema sorgente fino a quando raggiunge i calcoli del rischio, le segnalazioni regolamentari e i modelli. Governance, architettura, qualità dei dati e reporting formano quattro pilastri che funzionano solo se dipendono l'uno dall'altro.
Come si trasforma BCBS 239 in controlli ingegneristici?
Traducete ogni area di principi in controlli che producono evidenze: un registro degli elementi di dati critici con owner e soglie per la governance, riconciliazioni source-to-target e monitoraggio dell'aggiornamento per l'aggregazione, validazione e certificazione a livello di report per il reporting. Conservate risultati delle regole, snapshot di lineage e registri degli incidenti per ogni ciclo di reporting.
Quali dimensioni della qualità dei dati contano di più per le banche?
Completezza, accuratezza, tempestività, validità, univocità e coerenza. Ognuna risponde a una domanda diversa, ad esempio se un prestito riporta il codice dell'entità giuridica o se un saldo concorda tra piattaforma core e data warehouse. Riportate separatamente la dimensione non superata, l'owner e l'impatto, invece di ridurli a un unico punteggio composito che può nascondere un errore rilevante.
Le banche devono centralizzare tutti i dati per rispettare BCBS 239?
No. Una copia centrale può comunque essere incompleta, in ritardo o scollegata dal sistema responsabile del processo. Un control plane distribuito esegue i controlli in loco, vicino ai sistemi sorgente, e centralizza solo metadati ed evidenze: in questo modo evita ulteriori copie di dati sensibili e dimostra comunque che i dati critici sono idonei all'uso.
Perché la qualità dei dati è un controllo runtime per i modelli di AI in ambito finanziario?
Un modello validato può comportarsi in modo non sicuro quando il suo input arriva in ritardo, cambia schema o si discosta dalla baseline. In un sondaggio IIF-EY del 2025, il 79% delle società di servizi finanziari ha indicato la qualità dei dati come una delle principali sfide per l'AI. Ai sensi di SR 11-7, una modifica inspiegata di un input può diventare un evento di rischio di modello che richiede un'indagine o una rivalidazione.


