Integrità dei dati sanitari: quando le dosi di farmaco non puntano a nulla
|
6
min di lettura
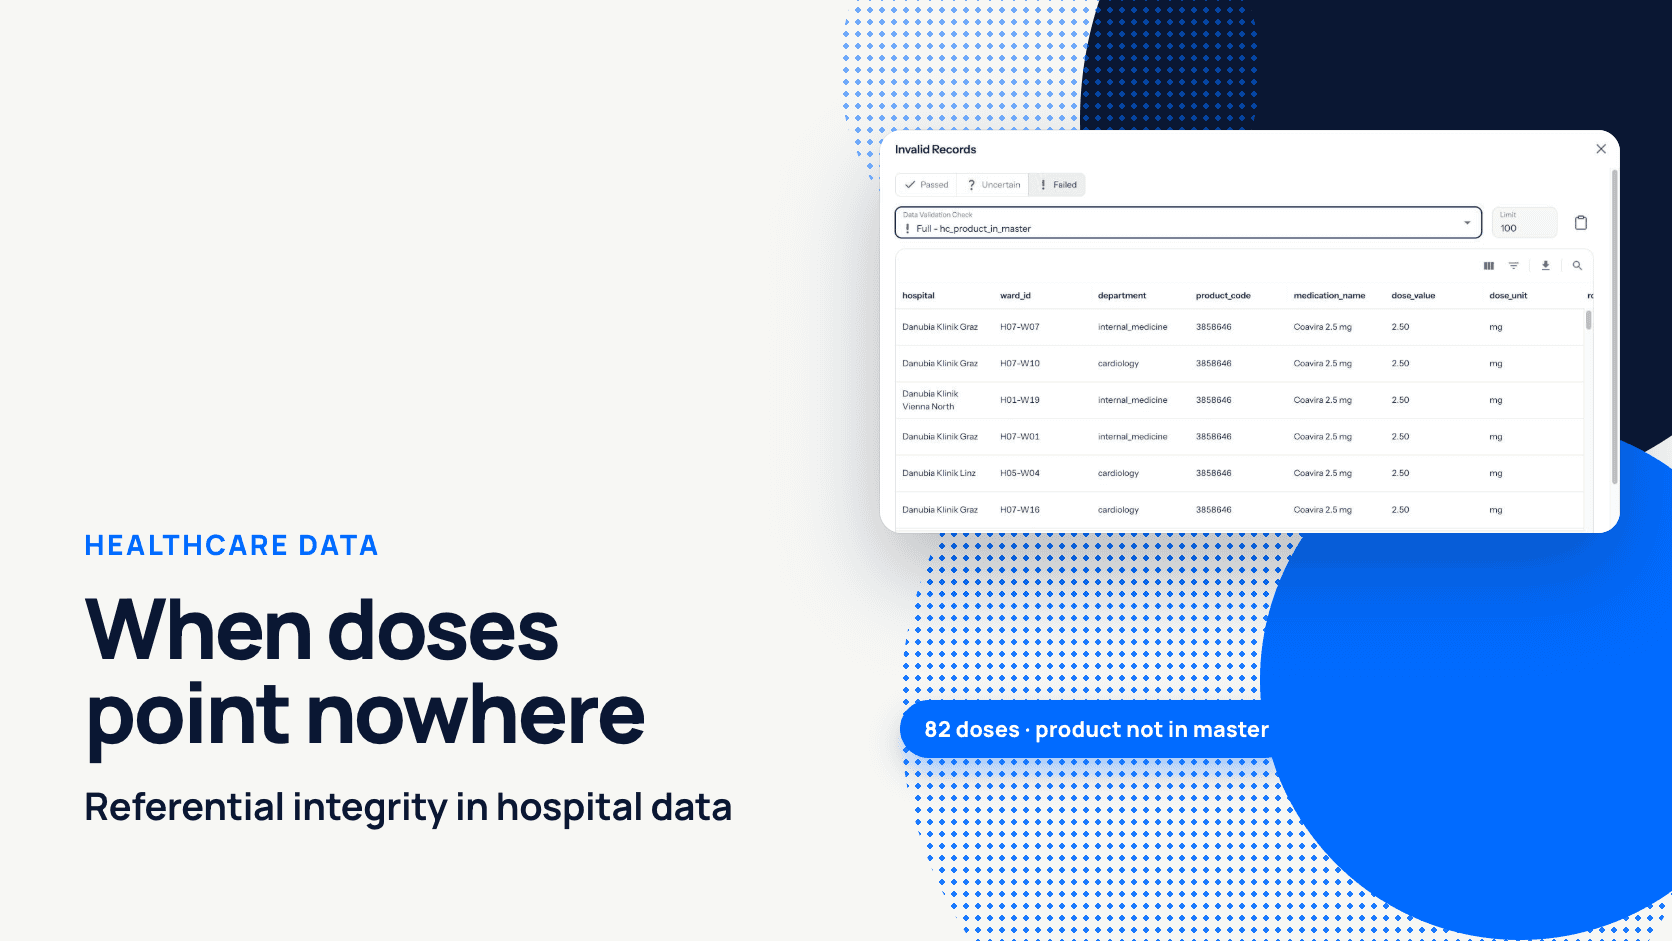
Nei dati della demo ospedaliera di digna, il 22 aprile 2026 gli infermieri di un gruppo ospedaliero hanno somministrato 82 dosi di un nuovo farmaco. Il report della farmacia per quel giorno riportava zero. Nulla era andato in errore. Le dosi erano state registrate, ma il prodotto non era ancora presente nell'anagrafica dei prodotti della farmacia, quindi ogni report che collegava le dosi ai prodotti le scartava. Integrità referenziale nei dati sanitari significa che ogni record che punta a un altro record, come una dose a un prodotto, un risultato di laboratorio a una richiesta o un ricovero a un paziente, punta a una riga che esiste davvero.
Questo articolo segue quel caso: come si è creata la lacuna, come un controllo di integrità referenziale in digna l'ha intercettata e che cosa ha fatto il team in seguito. Poi allarga lo sguardo alle relazioni nei dati ospedalieri e degli enti pagatori che meritano lo stesso controllo.
Per il concetto generale di record orfani, consultate l'articolo di riferimento I vostri dati trovano ancora i loro genitori? Capire l'integrità referenziale. Questo resta in ospedale.
Punti chiave
Una dose orfana non è sbagliata ma invisibile: l'inner join la rimuove, quindi i report sottostimano i valori senza generare alcun errore.
Nella demo di Danubia Kliniken, 82 delle 4.326 somministrazioni di farmaci del 22 aprile facevano riferimento a un prodotto assente dall'anagrafica dei prodotti della farmacia.
Una regola di integrità referenziale in digna Data Validation richiede una manciata di campi e nessuna riga di SQL, e restituisce i record non validi con ospedale, reparto e codice prodotto.
La correzione di solito riguarda i master data: si aggiunge il prodotto, si riesegue l'inspection e il report si corregge da solo.
I controlli vengono eseguiti all'interno del database dell'ospedale. I dati dei pazienti non lasciano mai la sua infrastruttura.
Indice
Che cosa è successo a Danubia Kliniken il 22 aprile?
Perché tecnicamente non è fallito nulla?
Come ha fatto digna a individuare il prodotto mancante?
Che cosa fa il team a questo punto?
Quali relazioni referenziali contano nei dati ospedalieri e degli enti pagatori?
Perché l'integrità referenziale si rompe così spesso in sanità?
Dove vengono eseguiti i controlli, e i dati dei pazienti escono dall'ospedale?
Come si inizia?
Che cosa è successo a Danubia Kliniken il 22 aprile?
Un nuovo prodotto, Coavira 2.5 mg con codice prodotto 3858646, è arrivato nei reparti prima di arrivare nell'anagrafica dei prodotti della farmacia. Il 22 aprile 2026 gli infermieri ne hanno documentato 82 somministrazioni. Poiché l'anagrafica non conteneva una riga corrispondente, ogni report che collegava le somministrazioni ai prodotti contava zero dosi di Coavira, mentre i record delle somministrazioni ne riportavano 82.
Danubia Kliniken è un gruppo ospedaliero austriaco fittizio e tutti i dati di questo articolo provengono dai dati demo di digna. Gli screenshot sono schermate reali di digna.
La sequenza è ordinaria. Un prodotto viene ordinato, consegnato e somministrato. Il record anagrafico che lo denomina e ne definisce il prezzo è gestito da un altro team, con un'altra tempistica. Nella demo, la tabella delle somministrazioni hospital_medication_administrations viene caricata dai sistemi di reparto, mentre l'anagrafica dei prodotti hospital_medications è gestita dalla farmacia. Per un giorno o una settimana, le due non concordano.
Chi se ne accorge? Di solito non il team dati. Una coordinatrice di reparto confronta un report sui consumi con ciò che sa essere stato somministrato, oppure un farmacista vede calare le scorte senza un consumo corrispondente. A quel punto i numeri sbagliati circolano già da giorni.
Perché tecnicamente non è fallito nulla?
Non è fallito nulla perché nessun singolo caricamento era errato. Le somministrazioni sono state caricate, l'anagrafica è stata caricata e la query del report è stata eseguita. Il guasto sta nella relazione tra due tabelle, e un inner join risolve una relazione interrotta rimuovendo silenziosamente la riga invece di generare un errore.
Una versione semplificata del report giornaliero sui consumi si presenta così:
Coavira 2.5 mg non compare affatto nel risultato. Una dashboard filtrata su questo prodotto mostra 0. Le 82 righe sono ancora nella tabella delle somministrazioni, ma nessuna query che passi per l'anagrafica le vedrà mai.
I vincoli di database raramente lo intercettano. I sistemi clinici di origine possono applicare le proprie chiavi, ma in un data warehouse ospedaliero l'estrazione eMAR e l'anagrafica della farmacia provengono di solito da sistemi diversi, e le foreign key dichiarate spesso non vengono riportate o non vengono applicate. Il controllo deve quindi essere eseguito sui dati man mano che arrivano. Trovare gli orfani a mano richiede una sola query:
La query è semplice. La parte difficile è eseguirla per ogni relazione, a ogni caricamento, e vederne il risultato prima che il report venga distribuito. L'articolo correlato Record orfani: trovarli con SQL e tenerli fuori tratta più in dettaglio i pattern SQL, comprese le chiavi composte e la gestione dei NULL.
Come ha fatto digna a individuare il prodotto mancante?
Una regola di integrità referenziale sulla data source delle somministrazioni verificava a ogni inspection ciascun product_code rispetto all'anagrafica dei prodotti della farmacia. Il 22 aprile, 4.244 righe su 4.326 hanno superato il controllo e 82 no, quindi lo stato della regola è diventato Failed nella dashboard e le dosi non valide erano a un clic di distanza.
La regola
La regola si trova in digna Data Validation, che prevede tre tipi di regola: Rule, Uniqueness e Referential Integrity. Configurare questa ha richiesto sei passaggi:
In Configuration, selezionate la data source
hospital_medication_administrations, aprite la scheda Data Validation e fate clic su Add Rule. Si apre la finestra di dialogo Add Data Validation Rule.Inserite Name e Description:
hc_product_in_master, "Ogni prodotto somministrato esiste nell'anagrafica dei prodotti della farmacia".Impostate Type su Referential Integrity.
In Attributes, selezionate
product_codesu questa data source.In must exist in, selezionate la Data Source
hospital_medicationse i relativi Attributesproduct_code.Impostate Threshold Mode su Absolute, Info threshold a 0 e Warn threshold a 1, così una sola dose orfana genera già uno stato Uncertain e due o più fanno fallire il controllo. Salvate.
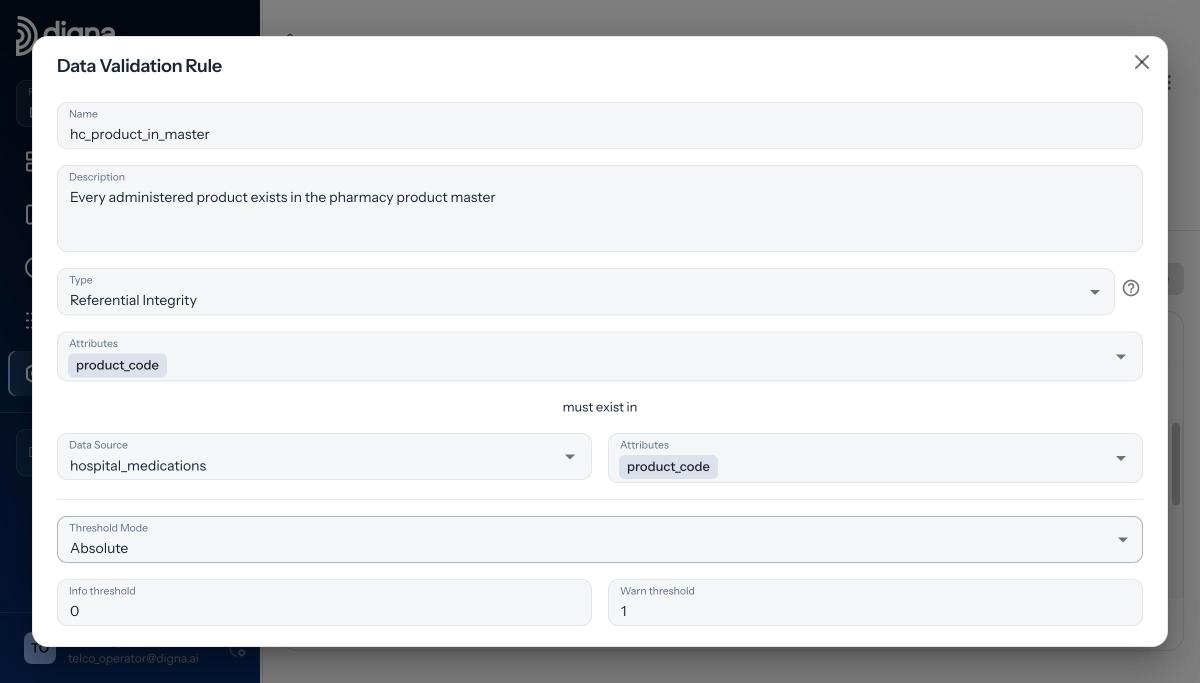
La regola: product_code nelle somministrazioni deve esistere in hospital_medications.product_code.
Nessun SQL da scrivere. Da quel momento la regola viene eseguita a ogni inspection della data source, pianificata o su richiesta. Il video Referential Integrity in digna: Set Up in Under a Minute mostra la stessa configurazione in tempo reale, e Come configurare un controllo di integrità referenziale illustra ogni campo, comprese le chiavi composte.
Il risultato
L'inspection del 22 aprile ha valutato 4.326 somministrazioni. 4.244 hanno trovato il proprio prodotto nell'anagrafica; 82 no. Con un Warn threshold pari a 1, ne risulta uno stato Failed nella dashboard, accanto agli altri controlli del giorno.
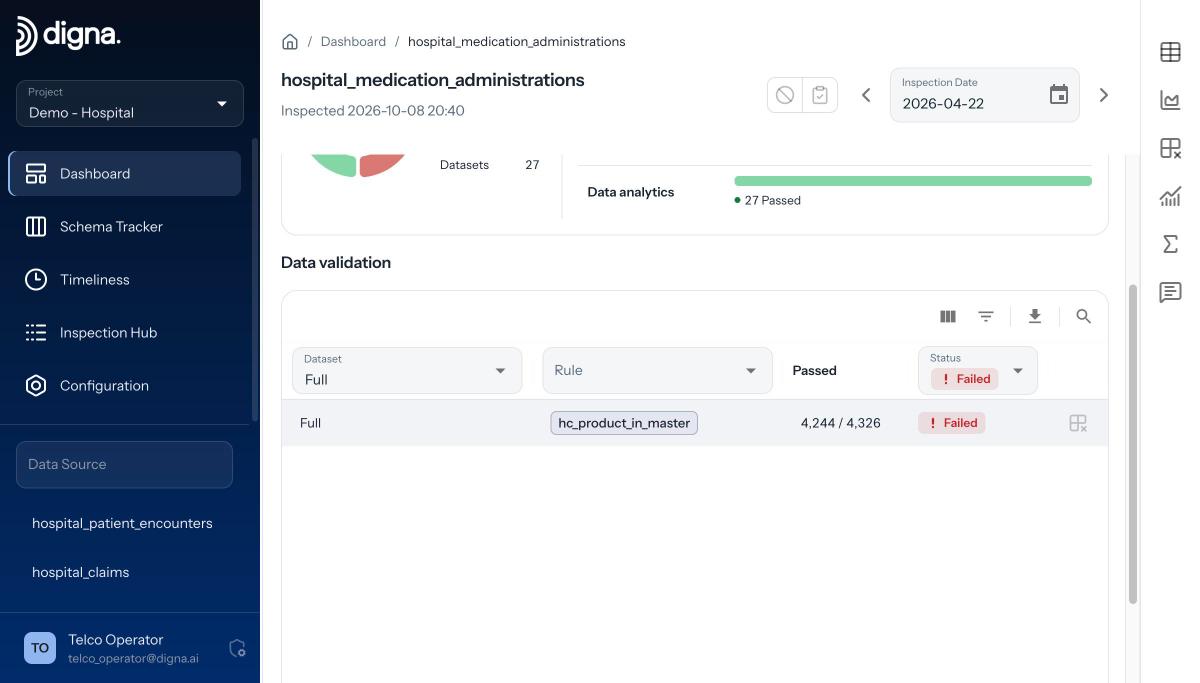
La dashboard del 22 aprile: hc_product_in_master, 4.244 su 4.326 superate, stato Failed.
Un conteggio basta per sapere che qualcosa non va. Non basta per sapere che cosa fare. Per questo servono le righe.
I record non validi
digna restituisce gli stessi record non validi: lo stesso controllo con la condizione di superamento negata, eseguito all'interno del database di origine. Nella vista Invalid Records, filtrate su Failed e selezionate il controllo Full - hc_product_in_master. Ogni riga è una dose che non punta a nulla, con ospedale, reparto, dipartimento, product_code 3858646 e medication_name Coavira 2.5 mg.

Invalid Records: ogni dose non valida con ospedale, reparto, dipartimento e codice prodotto.
Quell'elenco risponde alle domande che altrimenti girerebbero per email per una settimana: quale prodotto, quali reparti, quante dosi. Può essere esportato per chi è responsabile della correzione.
Che cosa fa il team a questo punto?
Il team corregge i master data, non le dosi. Le somministrazioni sono corrette: gli infermieri hanno somministrato Coavira 2.5 mg e lo hanno documentato. Ciò che mancava è la riga del prodotto, quindi il rimedio consiste nell'aggiungerla all'anagrafica dei prodotti della farmacia, rieseguire l'inspection e lasciare che i report recuperino le dosi.
Leggete i record non validi e confermate il pattern. Lo stesso codice prodotto, 3858646, su ogni riga non valida indica una voce mancante nell'anagrafica, non un errore di battitura in un sistema di reparto.
Avvisate il team responsabile dell'anagrafica dei prodotti, in questo caso la farmacia, e allegate i record esportati.
La farmacia aggiunge Coavira 2.5 mg a
hospital_medications.Rieseguite su richiesta l'inspection della data source delle somministrazioni. Una volta che ogni codice prodotto trova corrispondenza, la regola torna a essere superata e le dosi compaiono nei report.
Aggiornate il report sui consumi. Le 82 dosi compaiono, attribuite agli ospedali e ai reparti corretti.
Se i record non validi avessero mostrato decine di codici diversi in un singolo reparto, la causa sarebbe stata diversa, forse un problema di mappatura in un'interfaccia, e così anche il responsabile. Sono i record a dirvi in quale caso vi trovate. È questo il motivo principale per guardare le righe anziché i conteggi.
I team che accettano un breve ritardo tra il primo utilizzo e l'inserimento in anagrafica possono alzare le soglie o impostare Threshold Mode su Relative. Per i dati sui farmaci, Danubia le mantiene rigorose.
Quali relazioni referenziali contano nei dati ospedalieri e degli enti pagatori?
Le relazioni da verificare sono quelle da cui dipendono report e fatturazione: dosi verso prodotti, ricoveri verso pazienti, risultati di laboratorio verso richieste e ricoveri, occupazione dei posti letto verso reparti, e richieste di rimborso verso assicuratori e polizze. Ognuna, quando si interrompe, rimuove righe da un join senza errori, e ognuna ha un responsabile diverso.
Record figlio | Deve esistere in | Che cosa si rompe se è orfano |
|---|---|---|
Somministrazione di farmaco (dose) | Anagrafica dei prodotti della farmacia | I report su consumi, scorte e costi sottostimano i valori; un nuovo prodotto sembra inutilizzato |
Ordine di farmacia | Anagrafica prodotti; reparto | Gli ordini non possono essere raggruppati per prodotto né imputati a un centro di costo |
Ricovero del paziente | Anagrafica pazienti | I conteggi dei casi e le analisi sulle riammissioni perdono degenze; le viste a livello di paziente sono incomplete |
Risultato di laboratorio | Richiesta di laboratorio; ricovero | I risultati non possono essere attribuiti al reparto richiedente o alla degenza; i report sui tempi di refertazione li escludono |
Occupazione dei posti letto | Reparto (ospedale + codice reparto) | L'occupazione per reparto e dipartimento è sottostimata; le dashboard sulla capacità sono errate |
Richiesta di rimborso | Assicuratore; polizza | Le richieste non possono essere assegnate a un ente pagatore; crediti e riconciliazione per assicuratore non tornano |
Riga della richiesta di rimborso | Ricovero | Prestazioni fatturate senza una degenza corrispondente; domande dell'ente pagatore a cui nessuno sa rispondere rapidamente |
Nei dati ospedalieri contano due dettagli. Primo, le chiavi composte: un codice reparto è spesso univoco solo all'interno di un ospedale, quindi l'occupazione dei posti letto va verificata su ospedale e reparto insieme. In digna selezionate più colonne su entrambi i lati, nello stesso ordine, e il controllo avviene sulla combinazione. Secondo, i NULL: i controlli referenziali ignorano le foreign key nulle, quindi una dose senza alcun codice prodotto non fallisce. Se ogni somministrazione deve avere un codice prodotto, aggiungete una Rule separata, product_code IS NOT NULL.
L'integrità referenziale è un livello della validazione dei dati clinici. Intervalli di valori, controlli di plausibilità e regole di codifica ne sono un altro; Validazione dei dati sanitari: regole cliniche e regolamentari su larga scala tratta questi aspetti.
Perché l'integrità referenziale si rompe così spesso in sanità?
In sanità l'integrità referenziale si rompe spesso perché i record padre e figlio appartengono a dipartimenti diversi, risiedono in sistemi diversi e vengono caricati con tempistiche diverse. La farmacia gestisce i prodotti, l'accettazione gestisce i pazienti, il sistema di laboratorio contiene le richieste, i servizi tecnici gestiscono i reparti e l'amministrazione gestisce gli assicuratori. Ognuno è corretto nel proprio ambito; i join tra loro non sono compito di nessuno.
I master data hanno molti responsabili. Un prodotto, un reparto o un assicuratore vengono creati dal dipartimento che se ne occupa, attraverso il proprio processo. I sistemi che vi fanno riferimento lo vengono a sapere più tardi.
I sistemi vengono caricati con tempistiche diverse. La documentazione di reparto può arrivare più volte al giorno, mentre un'anagrafica viene aggiornata di notte o dopo una richiesta di modifica. Qualsiasi scarto tra le due produce orfani, anche se alla fine entrambi i lati sono corretti.
I codici cambiano. I prodotti vengono sostituiti, i reparti accorpati o rinominati, gli assicuratori cambiano codice, i cataloghi di laboratorio vengono rivisti. I record storici continuano a riportare i vecchi codici, e un'anagrafica che conserva solo i codici attuali li rende orfani.
Le strutture si fondono. Quando un gruppo ospedaliero integra nuove strutture nel reporting condiviso, elenchi di codici mai pensati per essere compatibili si incontrano nello stesso join.
Il record padre si trova in un altro database. L'anagrafica dei prodotti può risiedere nel sistema della farmacia e le somministrazioni nel data warehouse clinico. Dalla Release 2026.01, digna verifica l'integrità referenziale tra connessioni di database diverse all'interno dello stesso progetto, senza replicare nessuna delle due tabelle.
Niente di tutto questo indica un ospedale gestito male. È la condizione normale di un data warehouse ospedaliero alimentato da molti sistemi. La differenza sta nello scoprire la lacuna il giorno in cui si apre o la settimana in cui qualcuno si lamenta.
Dove vengono eseguiti i controlli, e i dati dei pazienti escono dall'ospedale?
I controlli vengono eseguiti all'interno del database dell'ospedale e i dati dei pazienti non lasciano mai la sua infrastruttura. digna viene eseguito on-premises o nel private cloud dell'ospedale. Invia SQL alla fonte, riceve conteggi e recupera le righe non valide solo quando le richiedete. Nessuna tabella viene copiata all'esterno e il team di digna non vede mai i vostri dati.
Per i dati clinici questo è un prerequisito, non un dettaglio. I dati su farmaci, laboratorio e ricoveri restano dove i vostri team di sicurezza e protezione dei dati li governano già.
Dalla Release 2026.06, le regole possono anche essere gestite come codice: il Python SDK (pip install digna-sdk) gestisce progetti, inspection e regole dalla pipeline CI/CD, e le regole di validazione possono essere esportate dall'ambiente di test e importate in produzione.
Come si inizia?
Scegliete la relazione il cui fallimento farebbe più danni, di solito dosi verso prodotti o richieste di rimborso verso assicuratori, e aggiungete una regola di integrità referenziale. Richiede una manciata di campi. Poi aggiungete la successiva. Dopo alcune inspection saprete di quali join potete fidarvi e quali perdono righe senza farsi notare.
Se volete vedere in azione i controlli di Danubia Kliniken e discutere dei dati del vostro ospedale o del vostro ente pagatore, prenotate una demo con il team di digna.
Domande frequenti
Che cos'è l'integrità referenziale nei dati sanitari?
Significa che ogni record che fa riferimento a un altro record punta a una riga esistente: una dose a un prodotto nell'anagrafica della farmacia, un risultato di laboratorio alla sua richiesta, un ricovero a un paziente. Quando il record padre manca, i join scartano la riga figlia e i report sottostimano i valori senza alcun errore.
Perché le dosi di farmaco scompaiono dai report ospedalieri?
Di solito perché il prodotto manca dall'anagrafica dei prodotti della farmacia. I report collegano le somministrazioni ai prodotti, e un inner join rimuove silenziosamente le dosi senza un prodotto corrispondente. Nella demo di Danubia Kliniken, 82 dosi di un nuovo prodotto risultavano pari a zero in ogni report che passava per l'anagrafica.
Come si verificano i dati eMAR rispetto all'anagrafica dei prodotti della farmacia?
Aggiungete una regola Referential Integrity sulla data source delle somministrazioni in digna Data Validation: selezionate product_code come attributo, poi in must exist in scegliete l'anagrafica dei prodotti e il relativo product_code. Ogni inspection riporta le righe che superano e che non superano il controllo ed elenca tutte le dosi orfane.
I dati dei pazienti escono dall'ospedale quando digna esegue questi controlli?
No. digna viene eseguito on-premises o nel private cloud dell'ospedale, e ogni controllo viene eseguito all'interno del database di origine. digna invia SQL e riceve conteggi, più le righe non valide quando le aprite. Nessuna tabella viene copiata all'esterno e il team di digna non vede mai i vostri dati.
Quali tabelle di un data warehouse ospedaliero richiedono controlli di integrità referenziale?
Iniziate dai join su cui si basano report e fatturazione: somministrazioni di farmaci verso l'anagrafica prodotti, ricoveri verso pazienti, risultati di laboratorio verso richieste e ricoveri, occupazione dei posti letto verso i reparti su codice ospedale e codice reparto, e richieste di rimborso verso assicuratori e polizze. Ognuno ha un responsabile diverso da avvisare.


