Dashboard di monitoraggio dei KPI: progettazione e implementazione
|
6
min di lettura

La maggior parte dei consigli su una dashboard di monitoraggio dei KPI parte dal punto sbagliato. I team si concentrano ossessivamente su stili dei grafici, palette di colori e griglie di layout, per poi sorprendersi quando gli stakeholder smettono di fidarsi dei numeri. Negli ambienti enterprise, le dashboard di solito non falliscono perché sono brutte da vedere: falliscono perché i dati sottostanti cambiano forma, diventano obsoleti o si allontanano dalla definizione di business che tutti credevano di usare.
Una dashboard può essere visivamente pulita e operativamente pericolosa allo stesso tempo. Se un team finance, un flusso CRM e un modello di marketing calcolano lo stesso KPI in modo diverso, il grafico può apparire curato mentre la decisione che supporta è già compromessa. Ecco perché un monitoraggio affidabile parte dalla fiducia, non dall'estetica, e perché le dashboard più solide si comportano meno come scorecard e più come sistemi di controllo.
Indice
Perché la maggior parte delle dashboard di monitoraggio dei KPI fallisce
Mantenere la governance delle metriche e l'integrità semantica
Perché la maggior parte delle dashboard di monitoraggio dei KPI fallisce
La modalità di fallimento più comune è semplice. I team costruiscono una dashboard che sembra completa, poi presumono che la presenza dei grafici significhi che la metrica sottostante è stabile. In realtà, una dashboard di monitoraggio dei KPI diventa spesso fragile nel momento in cui i dati a monte cambiano, una trasformazione viene modificata o una regola di business viene riscritta senza che nessuno aggiorni il livello delle definizioni.
Una bella vista può nascondere profondi problemi operativi. Uno degli esempi più chiari è il divario tra ciò che gli utenti vedono e ciò che la pipeline di dati sta realmente facendo. Se la dashboard è alimentata da un ciclo di ricaricamento notturno con conservazione dello storico, come nella guida pubblica ai KPI della contea di Los Angeles, funziona già come un sistema operativo più che come un report statico, perché il valore deriva da continuità, storico e aggiornamento controllato, non dalla sola presentazione (Los Angeles County KPI Dashboard User Guide).
È la deriva silenziosa a distruggere la fiducia
La deriva silenziosa è peggio di un grafico rotto perché non si annuncia. Un grafico con dati mancanti sembra sospetto, ma un grafico con una logica leggermente sbagliata appare spesso abbastanza normale da superare la revisione. È questo il pericolo negli ambienti enterprise, soprattutto quando team diversi calcolano lo stesso KPI da sistemi sorgente diversi.
La fiducia muore molto prima che il grafico sembri rotto.
La risposta pratica è trattare la dashboard come un prodotto monitorato, non come un artefatto statico. Ciò significa osservare insieme gli input, la definizione e il modello di utilizzo. L'utilizzo conta perché il valore di una dashboard si misura spesso in base a quanto gli utenti a cui è destinata la aprono in un periodo definito, e le linee guida sull'adozione tracciano comunemente gli utenti attivi settimanali, il tasso di ritorno nelle settimane, il volume di esportazioni e il numero di citazioni nelle business review (linee guida sull'adozione delle dashboard).
Una dashboard a cui nessuno ritorna di solito vi sta dicendo qualcosa. O i dati sono obsoleti, o le definizioni creano confusione, oppure il layout nasconde il segnale dietro troppo rumore. Per una prospettiva pratica sulla qualità, un utile riferimento interno è perché i problemi nei dati continuano a creare conflitti e come migliorare la qualità dei dati, perché i conflitti sui dati sono spesso, in realtà, conflitti su fiducia, ownership o lineage.
Scegliere metriche che generano vere azioni di business
Una dashboard piena di vanity metric è peggio di uno schermo vuoto. Crea l'illusione del controllo lasciando gli operatori senza nulla da cambiare. Scegliete KPI associati a una conseguenza di business, a una soglia e a un responsabile con nome e cognome.
Partite dalla decisione, non dal grafico. Chiedetevi quale azione dovrebbe seguire se il KPI si muove, chi dovrebbe intraprenderla e quanto deve essere ampia la variazione prima di meritare attenzione. Se queste tre risposte non sono chiare, la metrica appartiene a un report, non a una dashboard di monitoraggio.

Costruite la metrica attorno alla decisione
Un KPI utile fa tre cose. Riflette un risultato di business anziché un'attività grezza. Ha una zona di attenzione e una zona critica. E ha un responsabile umano che può intervenire quando la metrica supera una soglia.
Questa struttura corrisponde alle indicazioni pratiche per la gestione per eccezioni, in cui ogni KPI ha un target, una soglia di attenzione e una soglia critica. Supporta inoltre il limitare la vista principale a circa 5-10 KPI, così che la dashboard non si trasformi in un backlog visivo (best practice di Domo per le dashboard KPI). Lo scopo non è ridurre al minimo le informazioni. Lo scopo è mantenere l'attenzione disponibile per le anomalie che meritano un'azione.
Regola pratica: se una metrica non innesca una risposta, non è un KPI di monitoraggio, è un valore di riferimento.
OKR e KPI svolgono compiti diversi. Un OKR descrive una direzione o un obiettivo. Un KPI verifica se il sistema si comporta come previsto. La guida per i leader su OKR e KPI aiuta i team a tenere separate le aspirazioni dal controllo operativo.
La ownership conta quanto la metrica stessa. Le linee guida sulle dashboard KPI in tempo reale raccomandano limiti statici legati all'impatto sul business, oltre a un responsabile, affinché un calo porti a un'escalation anziché a un'osservazione passiva (linee guida sulle dashboard KPI in tempo reale). Se una soglia viene superata e nessuno sa chi è responsabile della risposta, la dashboard si limita a documentare il fallimento.
Per i team che costruiscono il reporting sulla qualità insieme al monitoraggio, l'approccio di digna al reporting sulla qualità dei dati è utile perché privilegia evidenze strutturate rispetto a interpretazioni approssimative. Questo è importante quando il KPI incide su audit, finanza o attività regolamentate.
Progettare layout per la gestione per eccezioni
Le dashboard più solide restano silenziose finché qualcosa non cambia. Le metriche stabili dovrebbero restare sullo sfondo e il layout dovrebbe concentrare l'attenzione sui pochi segnali che richiedono un'azione. Questo approccio rispecchia il modo di lavorare dei team operativi: sessioni brevi, sotto pressione, con poca tolleranza per il rumore.
La gestione per eccezioni funziona perché nessuno è in grado di scorrere cinquanta indicatori attribuendo loro lo stesso peso. Il layout deve ordinare i segnali prima che l'utente li veda. Soglie chiare, metriche stabili attenuate e un unico stato di errore evidente fanno questo lavoro per chi legge.

Progettate per l'attenzione selettiva
Inserite nella vista principale solo gli indicatori più importanti dal punto di vista operativo, poi spostate la diagnostica di supporto più in profondità. In questo modo la dashboard non diventa un muro di riquadri dello stesso peso in cui nulla risalta.
L'alert fatigue è il compromesso da tenere d'occhio. Se ogni metrica viene trattata come un'emergenza, nessuna viene ascoltata. Le soglie di attenzione e di paging danno significato al segnale quando un avviso finalmente scatta, e il team risponde con più cura perché l'escalation è specifica.
Un buon layout rende visibile anche la stabilità. Quando un KPI resta all'interno della sua fascia target, si tratta di un'informazione utile, perché indica al team dove non spendere tempo. Le linee guida enterprise esprimono lo stesso concetto in modo diverso, poiché definizioni nascoste, aggiornamenti obsoleti e ownership mancante sono modalità di fallimento comuni in una vista principale sovraffollata (best practice di Domo per le dashboard KPI).
Una struttura pratica suddivide la vista in base all'urgenza.
Livello superiore: i KPI che richiedono una revisione immediata quando superano una soglia.
Livello intermedio: contesto dei trend e confronti di supporto.
Livello inferiore: drill-down, lineage e diagnosi.
Questa gerarchia funziona bene con i flussi di lavoro interni sulla qualità, soprattutto quando un team usa le dashboard di qualità dei dati di digna come livello diagnostico sotto le metriche rivolte al business. La dashboard diventa così un percorso verso l'indagine anziché un vicolo cieco.
Implementare alerting e controlli di data observability
Un KPI è affidabile solo quanto la pipeline che lo alimenta. Ecco perché l'alerting deve partire al di sotto del livello di business, dove freschezza, schema, volume e percentuali di null possono essere verificati prima che dati errati raggiungano una dashboard del management. Quando questi controlli sono in atto, lo stack di monitoraggio smette di essere una messinscena reattiva e inizia a funzionare come un sistema di gestione degli incidenti.
Il modello più efficace che ho visto è una catena di controlli che segue i dati attraverso ogni fase. Prima elencate le fasi della pipeline. Poi definite le modalità di errore, come file mancanti, duplicati, schema drift o caricamenti obsoleti. Successivamente, codificate i controlli come query eseguibili e conservatene i risultati, così che ogni esecuzione lasci una traccia storica.
Trasformate i controlli in evidenze sugli incidenti
Lo storico delle righe di controllo è importante perché permette ai team di vedere le linee di tendenza, non solo gli errori. Un avviso isolato vi dice che oggi qualcosa si è rotto. Uno storico conservato vi dice se il problema è ricorrente, si sta allargando o si sta spostando tra le fasi. È una base molto più utile per l'escalation.
Il livello di observability dovrebbe inoltre corrispondere direttamente a pilastri di controllo noti. La data observability è comunemente organizzata attorno a freschezza, distribuzione, volume, schema e lineage, che corrispondono a controlli di tempestività, rilevamento delle anomalie, controlli di completezza, rilevamento delle modifiche strutturali e tracciamento della provenienza (pilastri della data observability). Nella pratica, questi pilastri sono più facili da gestire quando i controlli sono espliciti e associati a dei responsabili.
Un buon insieme di controlli è specifico. Le linee guida sul monitoraggio della qualità dei dati raccomandano controlli su freschezza, volume delle righe, schema drift, null nelle colonne obbligatorie, unicità della chiave primaria e valori o intervalli ammessi, eseguiti in fase di ingestion, dopo la trasformazione e di nuovo sulla tabella di serving, con controlli bloccanti a ogni esecuzione e job di riconciliazione giornalieri (best practice per la qualità dei dati). È l'approccio giusto anche per i sistemi di KPI, perché la dashboard non dovrebbe mai essere il primo luogo in cui i dati errati diventano visibili.
Inoltrate ogni rilevazione a un responsabile con nome e cognome. Se nessuno ne risponde, l'avviso diventa rumore.
Il monitoraggio dello schema merita un trattamento a parte, perché le modifiche strutturali possono compromettere la logica downstream anche quando il numero di righe sembra corretto. La ricerca sui sistemi di observability descrive avvisi che scattano quando cambiano i metadati delle tabelle sorgente, così che strutture aggiunte, rimosse o modificate vengano rilevate prima che le ipotesi del reporting vengano meno (ricerca sul monitoraggio delle modifiche allo schema). Questo controllo è particolarmente importante negli ambienti di finanza, sanità, telecomunicazioni e settore pubblico, dove il costo di un errore di reporting silenzioso è molto più alto di quello di un controllo rumoroso.
Un riferimento interno pratico per questo livello è la data observability di digna, poiché questa categoria include tempestività, convalida, rilevamento delle anomalie e tracciamento dello schema in un'unica vista operativa.
Adattare le viste ai diversi team di stakeholder
Una sola dashboard raramente va bene per tutti gli stakeholder. I data engineer hanno bisogno di segnali di errore, gli analisti di contesto e i dirigenti di una vista sintetica che supporti le decisioni senza costringerli a vagliare il rumore delle pipeline. Se date a tutti e tre i gruppi la stessa schermata, gli utenti tecnici perdono i dettagli di cui hanno bisogno e gli utenti di business restano sommersi dal disordine.
Il modello migliore è un unico livello di metriche governato con viste specifiche per ruolo sopra di esso. In questo modo le definizioni dei KPI restano allineate, mentre ogni team vede il livello di dettaglio su cui può agire.
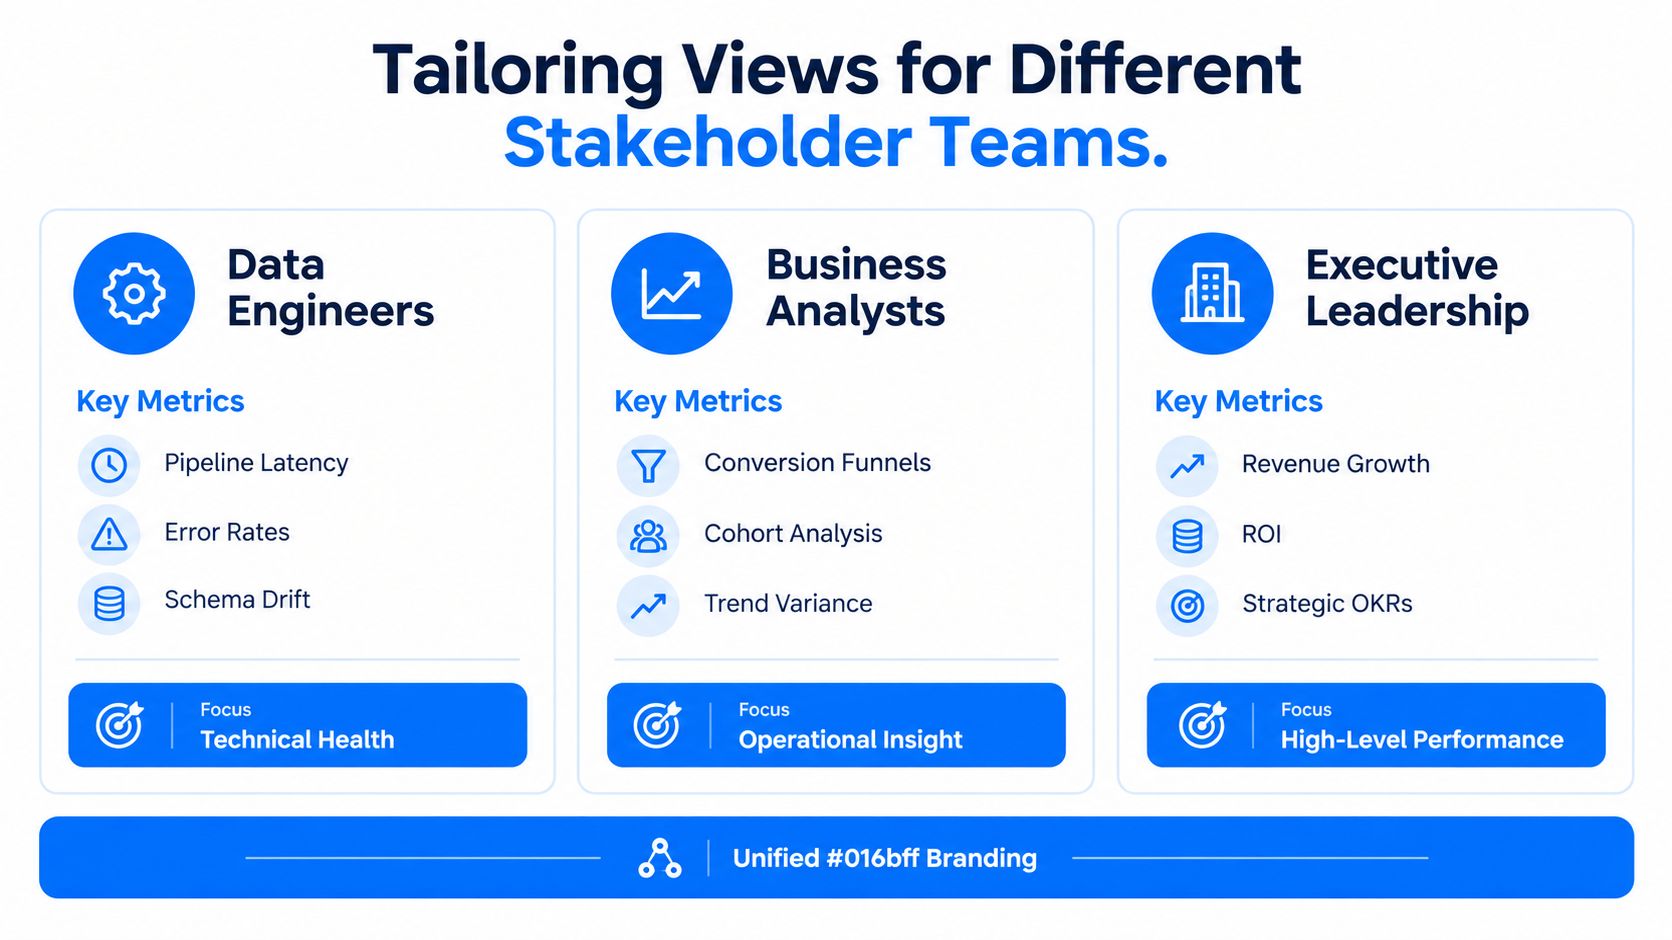
Ingegnere, analista, dirigente
I data engineer hanno bisogno di segnali sullo stato tecnico. Devono vedere se i caricamenti sono in ritardo, se gli schemi sono cambiati, se i controlli falliscono o se un'ipotesi di lineage è venuta meno. La loro vista dovrebbe esporre la pipeline, non solo l'output di business. Se la metrica servita è errata, hanno bisogno di un percorso rapido per risalire alla fonte.
I business analyst hanno bisogno di un contesto che possano spiegare. Trend, scostamenti e pattern operativi sono importanti, ma non un muro di rumore infrastrutturale. Hanno bisogno di dettagli su lineage e definizioni sufficienti a spiegare perché il KPI si è mosso, senza dover ricostruire la metrica da zero.
I dirigenti hanno bisogno di un quadro compatto delle performance. Vogliono un piccolo insieme di indicatori che mostri se il business è sulla buona strada, sta deviando o è sotto pressione. Se esportano la sintesi in slide e la ricostruiscono altrove, la vista per i dirigenti non sta supportando la decisione.
L'utilizzo per ruolo è un segnale migliore dei conteggi generici di traffico. Se la vista per l'engineering viene ignorata durante gli incidenti, se gli analisti continuano a esportare una metrica ripulita in fogli di calcolo o se i dirigenti scavalcano la dashboard per una sintesi separata, la vista non corrisponde al compito che dovrebbe svolgere.
Un modo utile per strutturare le viste è semplice.
Ingegneri: latenza delle pipeline, schema drift, controlli falliti, interruzioni del lineage.
Analisti: scostamenti dei trend, pattern per coorte, contesto delle metriche, spiegazione delle eccezioni.
Dirigenti: una sintesi mirata dello stato di salute del business, con uno stato chiaro delle soglie.
Un riferimento pratico per costruire questo tipo di configurazione basata sui ruoli è la self-service analytics di digna. Il self-service funziona solo quando il livello governato sottostante è abbastanza affidabile da permettere a utenti diversi di attingervi senza ricreare la metrica nel proprio foglio di calcolo.
Mantenere la governance delle metriche e l'integrità semantica
La dashboard più pericolosa è quella che sembra corretta mentre calcola la cosa sbagliata. Succede quando le definizioni dei KPI divergono tra finanza, marketing, CRM o sistemi operativi, e nessuno verifica costantemente se la stessa etichetta corrisponde ancora allo stesso calcolo. A quel punto il grafico non è una fonte di verità, è una fonte di confusione.
La governance delle metriche è il livello mancante in molti programmi di dashboard. I team spesso dedicano tutto il loro impegno a layout e soglie, lasciando poi il livello semantico senza monitoraggio. Si crea così un vuoto in cui un KPI può restare visivamente stabile mentre la logica sottostante cambia, ed è esattamente così che si insinuano il rischio di audit e il rischio decisionale.
Governate la definizione, non solo la visualizzazione
Una strategia di monitoraggio seria ha bisogno di un modo per rilevare la deriva delle definizioni. Ciò significa tracciare le controversie sulla fonte di verità, i dati obsoleti, le modifiche alle trasformazioni a monte e le discrepanze nella logica di business prima che si diffondano nei report. Questo è particolarmente importante negli ambienti regolamentati, dove una logica dei KPI incoerente può creare problemi di compliance molto prima che un trend visivo appaia sospetto.
La mossa pratica è trattare le definizioni delle metriche come asset di produzione. Versionatele, documentatele e accorgetevi di quando un consumatore downstream non corrisponde più al calcolo ufficiale. Non è un problema di visualizzazione, è un problema di integrità semantica.
Indicazioni indipendenti hanno già messo in guardia da metriche contrastanti, controversie sulla fonte di verità, dati obsoleti e mancanza di contesto operativo, il che porta alla stessa conclusione: il problema più profondo è la governance, non la cornice della dashboard. Per le aziende il rischio è maggiore, perché team diversi possono attingere lo stesso KPI da sistemi diversi senza rendersi conto di essere in disaccordo finché una business review o un audit non lo fa emergere. Un utile riferimento interno su questo tema è il dbt semantic layer di digna, perché è nel livello semantico che le definizioni coerenti reggono o crollano.
Lo standard pratico è semplice.
Definite il KPI una sola volta.
Tracciate dove viene riutilizzato.
Generate un avviso quando il suo significato cambia.
Documentate il responsabile che approva la modifica.
Quando questa disciplina è in atto, la dashboard diventa abbastanza credibile per l'uso operativo. Senza di essa, anche l'interfaccia più pulita è solo un modo molto curato per diffondere ambiguità.
Se volete costruire una dashboard di monitoraggio dei KPI che intercetti la deriva silenziosa, e non solo grafici gradevoli, lavorate con digna. Le sue funzionalità di data quality e observability aiutano i team a monitorare freschezza, convalida, modifiche allo schema e metriche di business all'interno del proprio ambiente. Visitate digna per scoprire come si inserisce in uno stack di monitoraggio governato.
Quando i KPI della dashboard sono metriche di business come ricavi, ordini o numero di transazioni, la stessa logica per eccezioni può essere applicata alle metriche stesse: il business monitoring di digna apprende il pattern normale di ogni metrica e segnala uno scostamento prima che raggiunga la vista dei dirigenti.
Domande frequenti
Quanti KPI dovrebbe mostrare una dashboard di monitoraggio dei KPI?
Limitate la vista principale a circa 5-10 KPI. Ciascuno dovrebbe avere un target, una soglia di attenzione, una soglia critica e un responsabile con nome e cognome. Trend e diagnostica di supporto vanno nei livelli più profondi, così che i pochi segnali che richiedono un'azione non restino sepolti tra riquadri dello stesso peso.
Perché le persone smettono di fidarsi delle dashboard KPI?
Di solito non perché i grafici siano brutti. La fiducia si erode quando i dati diventano obsoleti, gli schemi cambiano a monte o i team calcolano lo stesso KPI in modo diverso tra sistemi finance, CRM e marketing. La deriva silenziosa è il vero pericolo, perché un numero leggermente sbagliato sembra comunque abbastanza normale da superare la revisione.
Che cos'è la gestione per eccezioni nella progettazione delle dashboard?
È un approccio al layout in cui le metriche stabili restano visivamente discrete e solo i KPI che superano una soglia attirano l'attenzione. Un livello superiore contiene le metriche che richiedono una revisione immediata, un livello intermedio aggiunge il contesto dei trend e un livello inferiore offre drill-down e lineage per la diagnosi.
Quali controlli sui dati dovrebbero essere eseguiti prima che un KPI raggiunga la dashboard?
Verificate freschezza, volume delle righe, schema drift, null nelle colonne obbligatorie, unicità della chiave primaria e intervalli di valori ammessi. Eseguite i controlli in fase di ingestion, dopo la trasformazione e di nuovo sulla tabella di serving, e conservate ogni risultato così che i problemi ricorrenti o in espansione diventino visibili nel tempo.
Come si evita che la definizione di un KPI diverga tra i team?
Trattate le definizioni delle metriche come asset di produzione. Definite ogni KPI una sola volta, versionatelo e documentatelo, tracciate ogni punto in cui viene riutilizzato e generate un avviso quando un calcolo downstream non corrisponde più a quello ufficiale. Un responsabile con nome e cognome dovrebbe approvare ogni modifica alla definizione.


