Controllo qualità dei KPI: una guida pratica alla governance
|
8
min di lettura

Una dashboard può caricarsi alla perfezione e raccontare comunque la storia sbagliata. È questa la scomoda debolezza della maggior parte dei programmi di controllo qualità dei KPI: i team verificano se i dati sono arrivati, se le colonne corrispondono a uno schema e se i report si sono aggiornati, poi considerano questi controlli tecnici superati come la prova che la metrica è sicura da usare.
Non lo sono. Un KPI può essere completo, aggiornato e correttamente tipizzato e diventare comunque strategicamente fuorviante dopo un'acquisizione, una variazione di prezzo, un movimento valutario, un cambiamento nel mix di clienti o una modifica del denominatore. Un monitoraggio affidabile deve verificare l'idoneità alla decisione, non solo lo stato di salute della pipeline. Significa chiedersi se la metrica ha ancora il significato che i manager le attribuiscono, se resta confrontabile con i periodi precedenti e se supporta la decisione a cui è legata.
Indice
Comprendere il controllo qualità dei KPI nelle moderne piattaforme dati
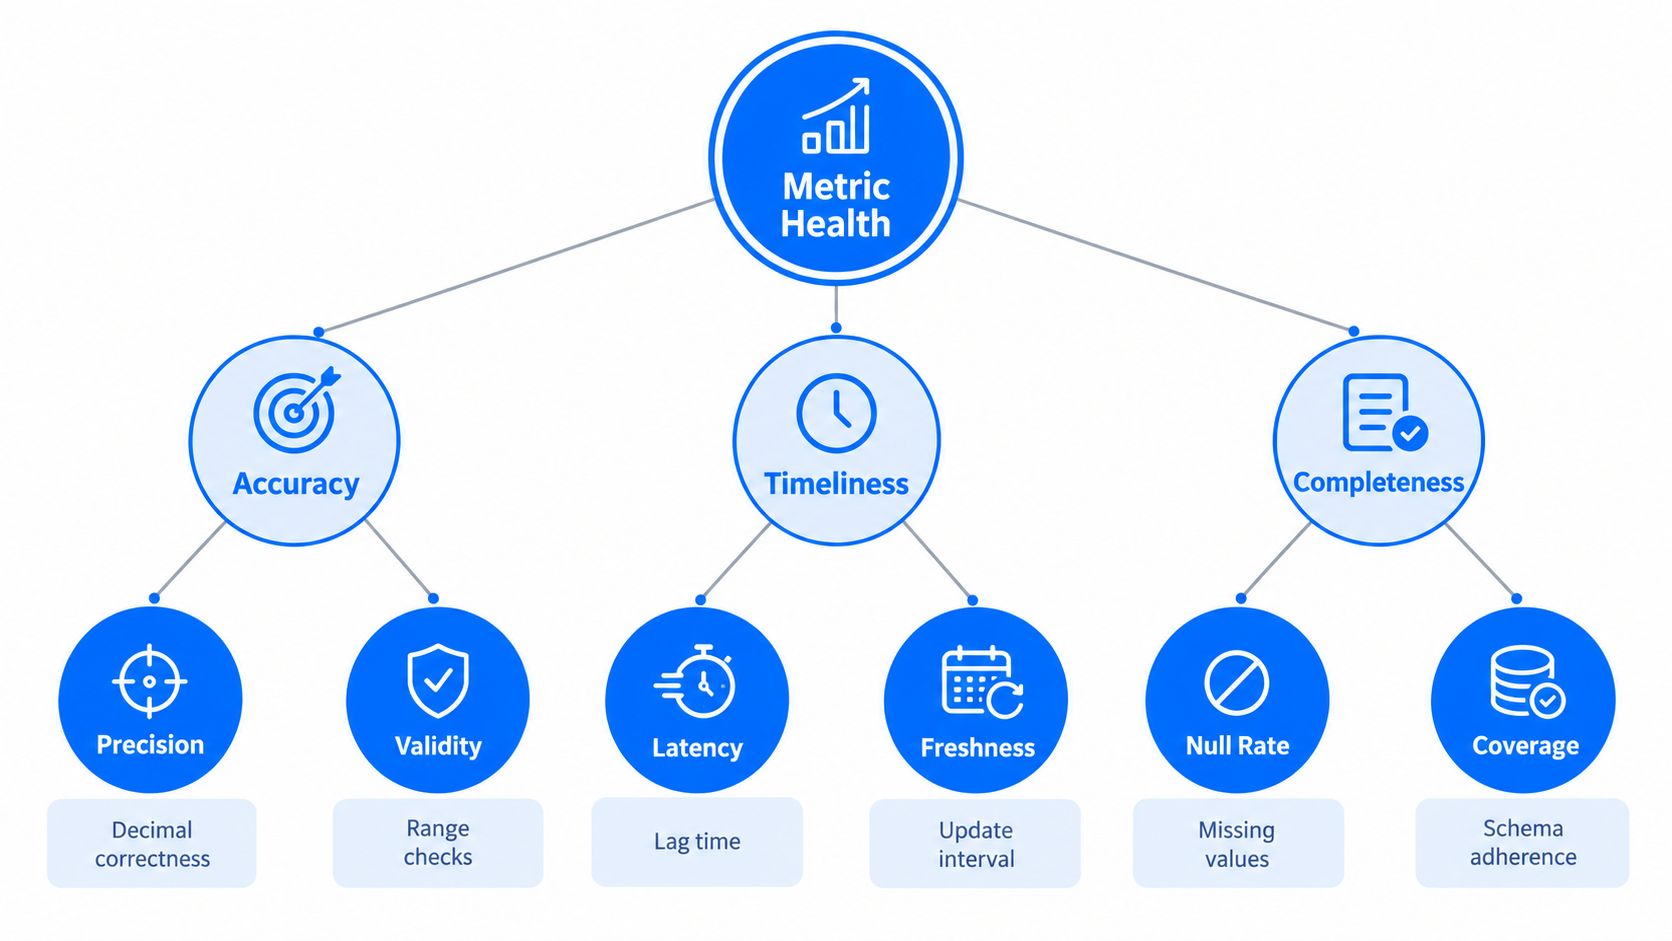
Le dimensioni fondamentali di metriche di business affidabili
Comprendere il controllo qualità dei KPI nelle moderne piattaforme dati
La maggior parte dei team dati parte da domande operative: il job è stato eseguito? La tabella si è aggiornata? La query della dashboard è andata a buon fine? Questi controlli contano, ma descrivono lo stato della piattaforma dati più che l'affidabilità della conclusione di business.
Un calcolo della crescita dei ricavi tecnicamente valido può comunque trarre in inganno se un'acquisizione cambia la popolazione, se gli aumenti di prezzo spiegano la variazione o se il denominatore esclude una coorte diventata rilevante. Anche un KPI di fidelizzazione dei clienti può sembrare stabile mentre la definizione di cliente sottostante è cambiata. A livello di schema non si rompe necessariamente nulla. Il problema si verifica nel rapporto tra la metrica e la decisione che dovrebbe supportare.
La pulizia tecnica è solo il primo filtro
Un sistema di controllo dei KPI utile separa tre domande:
La pipeline è in grado di produrre il valore? Verificate consegna, schema, tipi, valori nulli, volumi e stato di elaborazione.
Il valore significa ciò che dice la definizione? Verificate filtri, coorti, join, denominatori, finestre temporali, dati di riferimento e riconciliazione con il sistema di riferimento.
La metrica è ancora utile per la decisione prevista? Verificate comparabilità, materialità, contesto di business e le ipotesi che i manager usano per interpretare le variazioni.
La terza domanda è quella su cui molti programmi si fermano. I team possono generare alert su valori insoliti senza decidere se la variazione riflette un difetto o un evento operativo legittimo. Questo crea due rischi opposti: un KPI silenziosamente distorto passa inosservato, mentre un cambiamento stagionale o strategico valido genera rumore che gli utenti imparano a ignorare.
Un approccio pratico di data observability dovrebbe quindi collegare i segnali tecnici alla responsabilità semantica. Ogni KPI critico richiede una definizione approvata, un business owner designato, un rapporto con il sistema di riferimento e una spiegazione delle decisioni che ne dipendono.
Regola pratica: una pipeline che supera i controlli è la prova che i dati si sono spostati. Non è la prova che la metrica di business sia rimasta idonea alla decisione.
Rendere la comparabilità un controllo esplicito
Iniziate documentando popolazione, numeratore, denominatore, filtri, granularità, finestra temporale, trattamento della valuta ed esclusioni della metrica. Poi registrate gli eventi che possono cambiarne l'interpretazione, inclusi lanci di prodotto, acquisizioni, variazioni di prezzo, riorganizzazioni territoriali e aggiornamenti delle policy.
Il controllo dovrebbe distinguere una modifica del calcolo da un cambiamento del business. Se la formula è cambiata, il responsabile deve valutare la comparabilità storica e versionare la definizione. Se è cambiato il business, il responsabile può approvare l'anomalia documentando perché il KPI resta utile, oppure spiegare perché servono una serie rideterminata, una nuova coorte o una metrica sostitutiva.
In questo modo il controllo qualità dei KPI passa da una raccolta di test sui dati a un sistema di protezione delle decisioni. Gli ingegneri continuano a monitorare il meccanismo, ma sono i business owner a validarne il significato.
Il vero costo di ignorare la qualità dei dati dei KPI
Una validazione debole delle metriche raramente provoca un'interruzione clamorosa. Più spesso un valore errato finisce in una presentazione di pianificazione, una valutazione delle performance, una previsione, un report di compliance o un flusso di lavoro di AI. L'organizzazione spende poi tempo a discutere il risultato, correggere il materiale a valle, rieseguire le analisi e ricostruire la fiducia nel processo di reporting.
Secondo Gartner, la scarsa qualità dei dati costa alle organizzazioni in media almeno 12,9 milioni di dollari all'anno, sulla base di una ricerca del 2020, mentre il 59% delle organizzazioni non misura la qualità dei dati, come riassunto nella rassegna di Docsumo sui costi dei dati errati. La stima deriva da un sondaggio condotto su 154 clienti di riferimento di 16 fornitori di soluzioni per la qualità dei dati, quindi non va considerata un costo universale per ogni azienda. Mostra però perché le organizzazioni devono collegare i difetti alle conseguenze di business, invece di trattare la qualità come un punteggio tecnico astratto.
Costruire una catena di evidenze dal difetto alla decisione
Un programma di controllo maturo registra più di un semplice alert. Dovrebbe conservare:
Il difetto, come un caricamento mancante, un valore non valido, una join modificata, un record obsoleto o una definizione non corrispondente.
Il KPI interessato, inclusi il responsabile, i consumatori, le superfici di reporting e i modelli dipendenti.
L'impatto sul business, come una previsione distorta, un'azione ritardata, un report inesatto o un'indagine non necessaria.
La remediation, inclusi la modifica tecnica, l'approvazione del business, le evidenze di validazione e la data di chiusura.
La misura di prevenzione, come una nuova regola, una definizione rivista, un aggiornamento del lineage o una modifica della soglia.
Questa catena offre agli stakeholder finanziari e al management una motivazione difendibile per finanziare i controlli. Aiuta anche l'ingegneria a stabilire le priorità. Un difetto in una tabella esplorativa poco utilizzata non dovrebbe ricevere la stessa risposta di un difetto che incide sul reporting regolamentare, sulla gestione dei ricavi o su un KPI del vertice aziendale.
La questione finanziaria va oltre i team dati. Un report del 2025 dell'IBM Institute for Business Value ha rilevato che il 43% dei chief operating officer considera i problemi di qualità dei dati la propria priorità più importante in materia di dati, e che oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di dollari dovute alla scarsa qualità dei dati. I dati sono riportati in un'analisi di IBM sulla scarsa qualità dei dati, che inquadra il tema come una questione operativa e non come un problema circoscritto alla piattaforma.
I team che valutano l'impatto commerciale possono anche usare la correzione dei dati errati per i ricavi come riferimento pratico per collegare i dati inaffidabili ai processi di generazione dei ricavi. La domanda utile non è “Quanti record non hanno superato i controlli?”, ma “Quali decisioni hanno influenzato quei record e che cosa ha fatto l'organizzazione perché il KPI era sbagliato?”
Misurare insieme qualità e conseguenze
Monitorate dimensioni come accuratezza, completezza, coerenza, validità, tempestività, unicità e pertinenza. Poi abbinatele a misure operative come la gravità degli incidenti, i report interessati, la latenza della remediation, la ricorrenza e le decisioni sulle anomalie accettate rispetto a quelle difettose.
Un unico punteggio composito nasconde i compromessi. Un'elevata completezza può coesistere con una bassa accuratezza. Un'ottima freschezza può coesistere con una definizione di business errata. Dimensioni separate rendono il problema diagnosticabile e permettono ai responsabili di scegliere i controlli in base alla materialità.
Per i dirigenti che hanno bisogno di un business case conciso, le indicazioni di digna sul business case della qualità dei dati possono supportare la discussione. L'argomento più convincente è di solito un collegamento verificabile tra un difetto nei dati, un KPI distorto, una decisione ritardata o errata e un controllo che riduce la probabilità che il problema si ripeta.
Le dimensioni fondamentali di metriche di business affidabili
Un KPI non dovrebbe ricevere un'unica etichetta di superato o non superato per poi sparire in una dashboard. La qualità è multidimensionale e ogni dimensione richiede un test diverso. Una colonna può essere conforme al tipo dichiarato pur avendo il significato di business sbagliato. Un dataset completo può comunque contenere valori errati.
Separare sintassi, significato e utilità
La norma ISO 8000-1:2022 definisce concetti di qualità che possono essere resi operativi tramite controlli: la qualità sintattica riguarda la conformità a un formato approvato, la qualità semantica riguarda se i valori rappresentano il significato previsto e la qualità pragmatica riguarda se i dati sono adatti agli utenti e alle decisioni previsti. Il framework è riassunto nella panoramica della norma ISO 8000.
Applicate questi concetti direttamente:
Livello di qualità | Che cosa verifica | Controllo pratico del KPI |
|---|---|---|
Sintattica | Se i dati seguono la struttura approvata | Controlli su schema, tipo, formato e valori ammessi |
Semantica | Se i valori rappresentano il concetto previsto | Validazione di definizione, join, coorte, denominatore e dati di riferimento |
Pragmatica | Se il KPI supporta la decisione prevista | Accettazione del responsabile, revisione della comparabilità, materialità e test sull'uso decisionale |
I controlli sintattici sono di solito i più facili da automatizzare. Verificate che le date siano date, che gli identificativi seguano lo schema previsto, che i campi numerici rispettino formati accettabili e che le colonne obbligatorie esistano. Questi controlli intercettano presto i guasti strutturali, ma non possono stabilire se “cliente attivo” utilizzi ancora la definizione di business approvata.
I controlli semantici richiedono una documentazione più solida. Riconciliate i totali dei KPI con il sistema di riferimento pertinente, testate in modo indipendente le popolazioni di numeratore e denominatore e confrontate i risultati tra coorti e finestre temporali approvate. Se una metrica usa dati di riferimento, monitorate le modifiche a quei dati con la stessa attenzione riservata alle modifiche della tabella dei fatti.
I controlli pragmatici spettano alle persone che usano la metrica. Il business owner dovrebbe confermare se il KPI resta adatto alle decisioni di pianificazione, pricing, rischio, operations o compliance. È anche qui che le anomalie legittime ricevono un contesto invece di essere soppresse automaticamente.
Trattare completezza e validità come controlli distinti
Il UK Government Data Quality Framework distingue la completezza dalla validità. La completezza chiede se i record richiesti e i campi essenziali sono presenti. La validità chiede se i valori rientrano negli intervalli e nei formati previsti. Il framework avverte esplicitamente che dati completi non sono necessariamente accurati.
Questa distinzione cambia il modo in cui i team progettano i test:
I controlli di copertura individuano record, periodi, entità o flussi sorgente mancanti.
I controlli sui campi obbligatori individuano valori assenti nei campi necessari al calcolo.
I controlli di validità impongono formati, intervalli, valori ammessi e tipi previsti.
I controlli di accuratezza riconciliano i valori con una fonte o un processo di business affidabile.
I controlli di coerenza confrontano lo stesso concetto tra sistemi, prodotti e livelli di reporting.
I controlli di tempestività confrontano gli arrivi con il comportamento di consegna previsto, non solo con un orario fisso.
Usate le dimensioni della qualità dei dati di digna come riferimento per tradurre queste categorie in un inventario di monitoraggio. La scelta progettuale importante è mantenere visibili le dimensioni. Un unico badge “sano” può nascondere proprio la debolezza che invalida una decisione.
Definire governance e responsabilità chiare
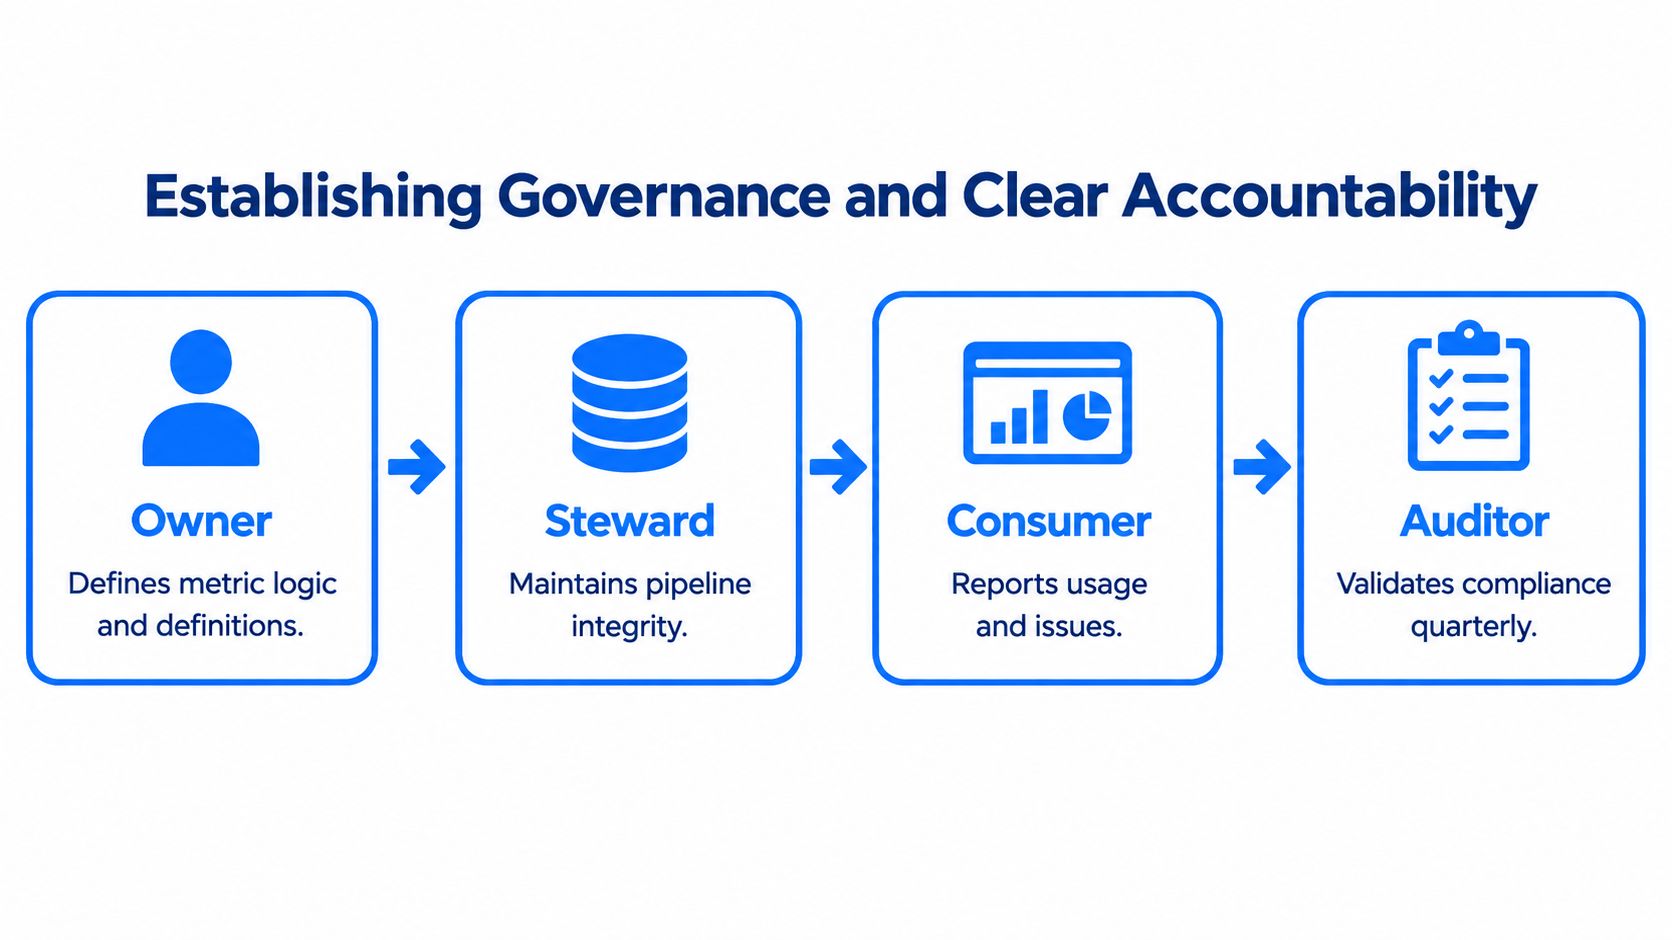
La parte più difficile del controllo qualità dei KPI non è scrivere una regola di validazione. È decidere chi interviene quando la regola scatta, chi può accettare un'anomalia come legittima e chi deve dimostrare che la metrica è di nuovo sicura da pubblicare.
Il sondaggio 2025 di Actian condotto su oltre 600 professionisti dei dati in ambito enterprise ha rilevato che l'83% ha affrontato sfide di governance e compliance, nonostante le organizzazioni valutassero la propria maturità di governance 4,13 su 5, con i dirigenti che giudicavano la maturità dei dati superiore del 12% rispetto ai professionisti operativi. Questi risultati sono riportati nel sondaggio di Actian sulla maturità della governance. Il divario evidenzia un problema pratico: la fiducia del management può crescere più rapidamente della chiarezza operativa.
Inserire la responsabilità nel contratto della metrica
Per ogni KPI critico, registrate:
Business owner: definisce il significato della metrica, ne approva l'interpretazione e decide se resta adatta allo scopo.
Responsabile tecnico: gestisce pipeline, trasformazioni, test e dipendenze.
Data steward: gestisce definizioni, dati di riferimento, lineage e documentazione.
Consumatore: segnala comportamenti inattesi e spiega come viene usato il KPI.
Auditor o revisore dei controlli: verifica evidenze, approvazioni e storico delle remediation.
Il responsabile deve anche approvare una soglia di materialità. Una variazione minima può richiedere solo osservazione, mentre un movimento brusco in un KPI regolamentare, finanziario od operativo può richiedere la sospensione della pubblicazione e l'escalation al management. Le soglie dovrebbero riflettere l'impatto sulle decisioni, non solo l'anomalia statistica.
Progettare il registro degli incidenti prima dell'incidente
Un registro degli incidenti utile documenta la condizione rilevata, il periodo interessato, la versione attuale della definizione, le modifiche alle sorgenti, la gravità, il responsabile, l'impatto sulle decisioni, l'esito, la remediation e le evidenze di nuova validazione. Dovrebbe distinguere tre esiti:
Difetto tecnico, quando la sorgente o la trasformazione è errata.
Difetto semantico, quando il calcolo non corrisponde più al significato approvato.
Evento legittimo, quando il business è cambiato e il KPI riflette correttamente quel cambiamento.
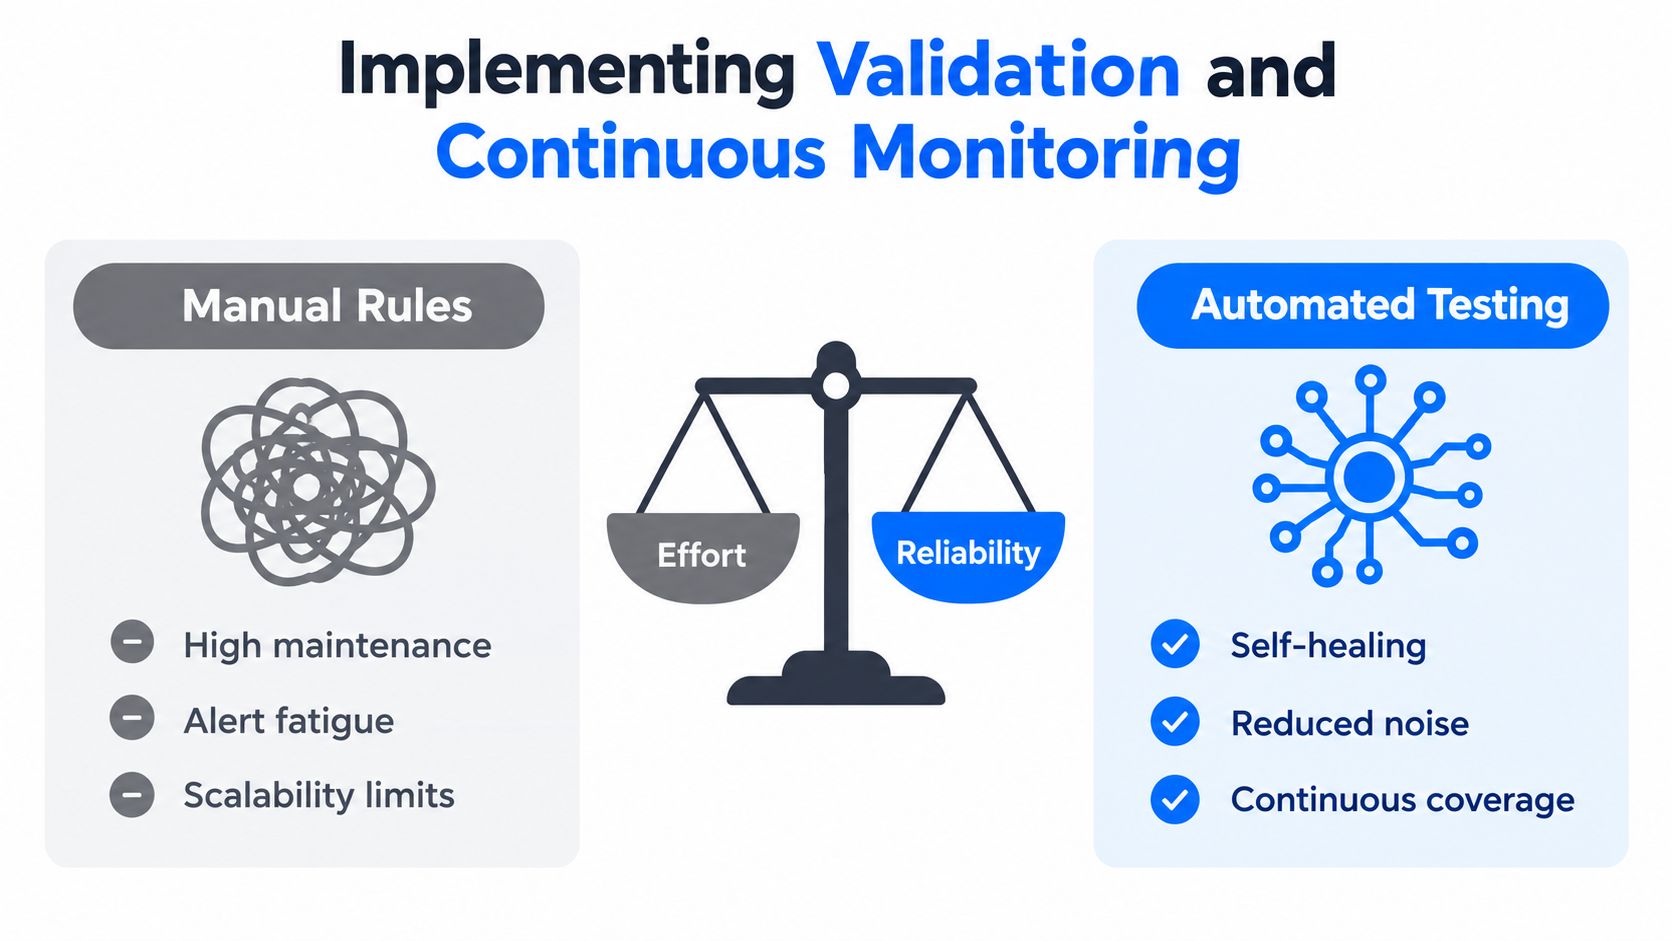
Le regole manuali restano preziose per asserzioni stabili e ad alto impatto. Diventano costose quando i team scrivono soglie separate per ogni tabella, coorte e contesto di reporting, per poi ritararle dopo ogni normale cambiamento del business. Le baseline automatiche possono ridurre la manutenzione e far emergere derive sconosciute, ma non sostituiscono l'approvazione del business. Un sistema di rilevamento delle anomalie può dire “insolito”. Non può decidere se una nuova politica di prezzo renda corretta la variazione.
Usate la risorsa di digna sulla governance della qualità dei dati per definire il modello operativo. Il risultato essenziale è una responsabilità misurabile, che includa tempo di triage, tempo di remediation, evidenze di chiusura, ricorrenza e quota di alert che i responsabili classificano come eventi di business validi.
Un programma di governance efficace rende visibile il disaccordo. Se i dirigenti vedono la maturità in un punteggio mentre agli operatori mancano responsabili e percorsi di escalation, l'ambiente di controllo non è ancora maturo. È documentato, ma non operativo.
Implementare validazione e monitoraggio continuo
Le regole scritte a mano sono precise, ma non scalano all'infinito. Funzionano bene per condizioni contrattuali, requisiti normativi e logiche di business note. Funzionano male come unico metodo per scoprire comportamenti inattesi in un patrimonio di pipeline ampio e in continua evoluzione.
Combinare controlli deterministici e comportamentali
La validazione deterministica chiede se un valore o un record soddisfa una condizione esplicita. Alcuni esempi:
Un ordine deve fare riferimento a un cliente esistente.
La data di una transazione deve rientrare in un periodo di reporting consentito.
Il denominatore di un KPI non deve essere zero.
Un campo regolamentato deve usare un codice approvato.
Un evento di business richiesto deve arrivare prima dell'esecuzione dell'aggregazione dipendente.
Queste regole sono spiegabili e verificabili. Richiedono però manutenzione. Le definizioni di business cambiano, i sistemi sorgente evolvono e le eccezioni si moltiplicano. Senza responsabili, le raccolte di regole diventano fragili e il volume degli alert cresce finché gli ingegneri smettono di fidarsene.
Il monitoraggio comportamentale adotta un approccio diverso. Apprende l'andamento normale di un dataset, di una pianificazione delle consegne, di un profilo di volume o di un KPI di business, quindi evidenzia le variazioni insolite. È utile per guasti sconosciuti, derive graduali, volatilità insolita, caricamenti mancanti e cambiamenti che nessuno aveva previsto quando sono state scritte le regole originali.
Il compromesso è l'interpretabilità. Una regola fissa può spiegare esattamente perché una riga non ha superato il controllo. Un alert comportamentale può individuare uno scostamento significativo senza identificarne la causa. Per questo l'architettura più solida combina entrambi i metodi invece di trattarli come alternativi.
Mantenere i dati sensibili dove si trovano
Negli ambienti enterprise, l'architettura di monitoraggio conta quanto la logica di rilevamento. Eseguire il calcolo delle metriche e i controlli a livello di record all'interno dei database del cliente può ridurre lo spostamento dei dati e supportare i requisiti di sicurezza. Consente inoltre ai team di validare i dati del data warehouse e del data lake dove già risiedono, invece di costruire ulteriori percorsi di estrazione per l'osservabilità.
Una sequenza di implementazione pratica è la seguente:
Iniziate dai KPI critici, con le relative tabelle sorgente, definizioni, responsabili e decisioni di business.
Aggiungete controlli deterministici per le condizioni note di correttezza, compliance e riconciliazione.
Definite baseline comportamentali per volume, freschezza, distribuzioni e variazioni dei KPI.
Instradate gli alert in base alla responsabilità, non verso un canale condiviso privo di un referente responsabile.
Analizzate gli esiti degli alert, poi regolate soglie, definizioni e gravità in base alle decisioni effettive.
La guida su validazione dei dati, regole, controlli e qualità continua è utile per organizzare questa combinazione di validazione a livello di record e monitoraggio continuo. La scelta della piattaforma conta meno della disciplina operativa. Ogni alert ha bisogno di un destinatario, di un percorso decisionale e di una traccia di ciò che è successo dopo.
Gestire la sensibilità degli alert come un budget operativo
Un'elevata sensibilità intercetta più guasti potenziali, ma genera anche più rumore. Una bassa sensibilità protegge l'attenzione, ma può non rilevare difetti graduali o di basso volume. Impostate la gravità in base all'impatto sul business, quindi analizzate falsi positivi e incidenti non rilevati come parte del programma di controllo.
Non sopprimete automaticamente le variazioni insolite. Chiedetevi prima se l'evento è reale, se la definizione è ancora valida e se la decisione interessata richiede una metrica rideterminata. Il rilevamento statistico dovrebbe avviare un'indagine, non sostituirsi alla responsabilità.
Progettare flussi di remediation efficaci
Il rilevamento senza risposta è telemetria costosa. Un flusso di lavoro utile trasforma un controllo fallito in una decisione con un responsabile, con evidenze sufficienti perché un'altra persona capisca che cosa è successo senza dover ricostruire l'intera indagine.
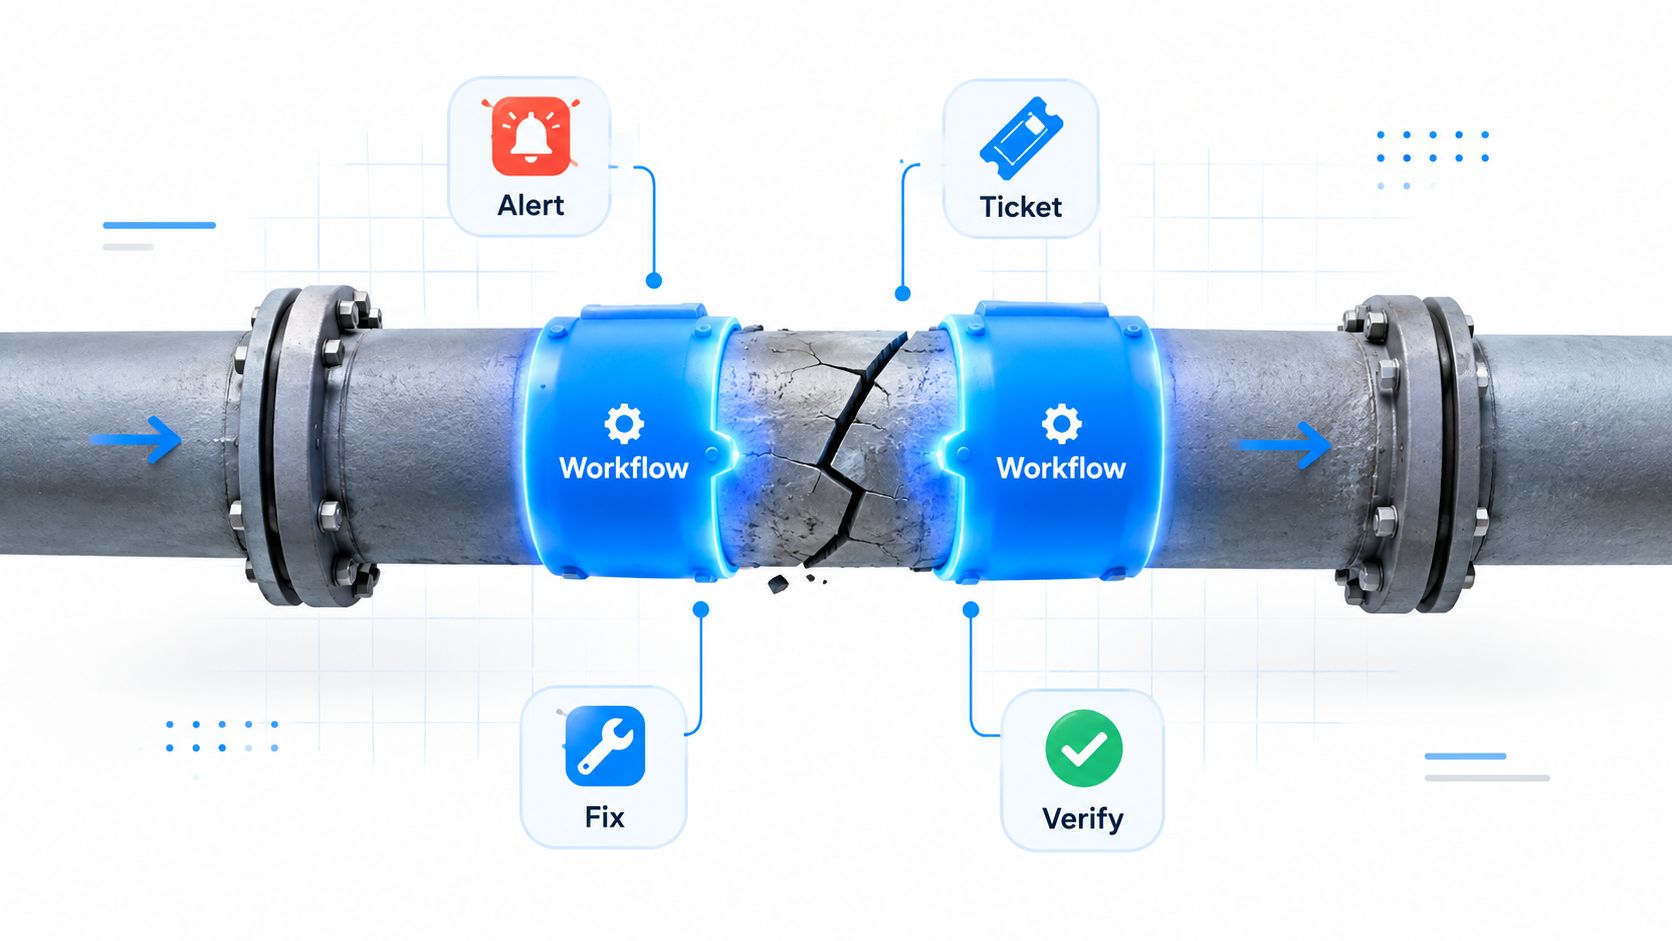
Separare la riparazione tecnica dalla revisione semantica
Una pipeline guasta e un significato di business cambiato richiedono referenti diversi. Un ingegnere può riparare una trasformazione fallita, ma è il business owner a dover decidere se un nuovo segmento di clienti rientra nella popolazione del KPI. Instradare entrambi gli incidenti nella stessa coda rallenta il ripristino e rende opaca la responsabilità.
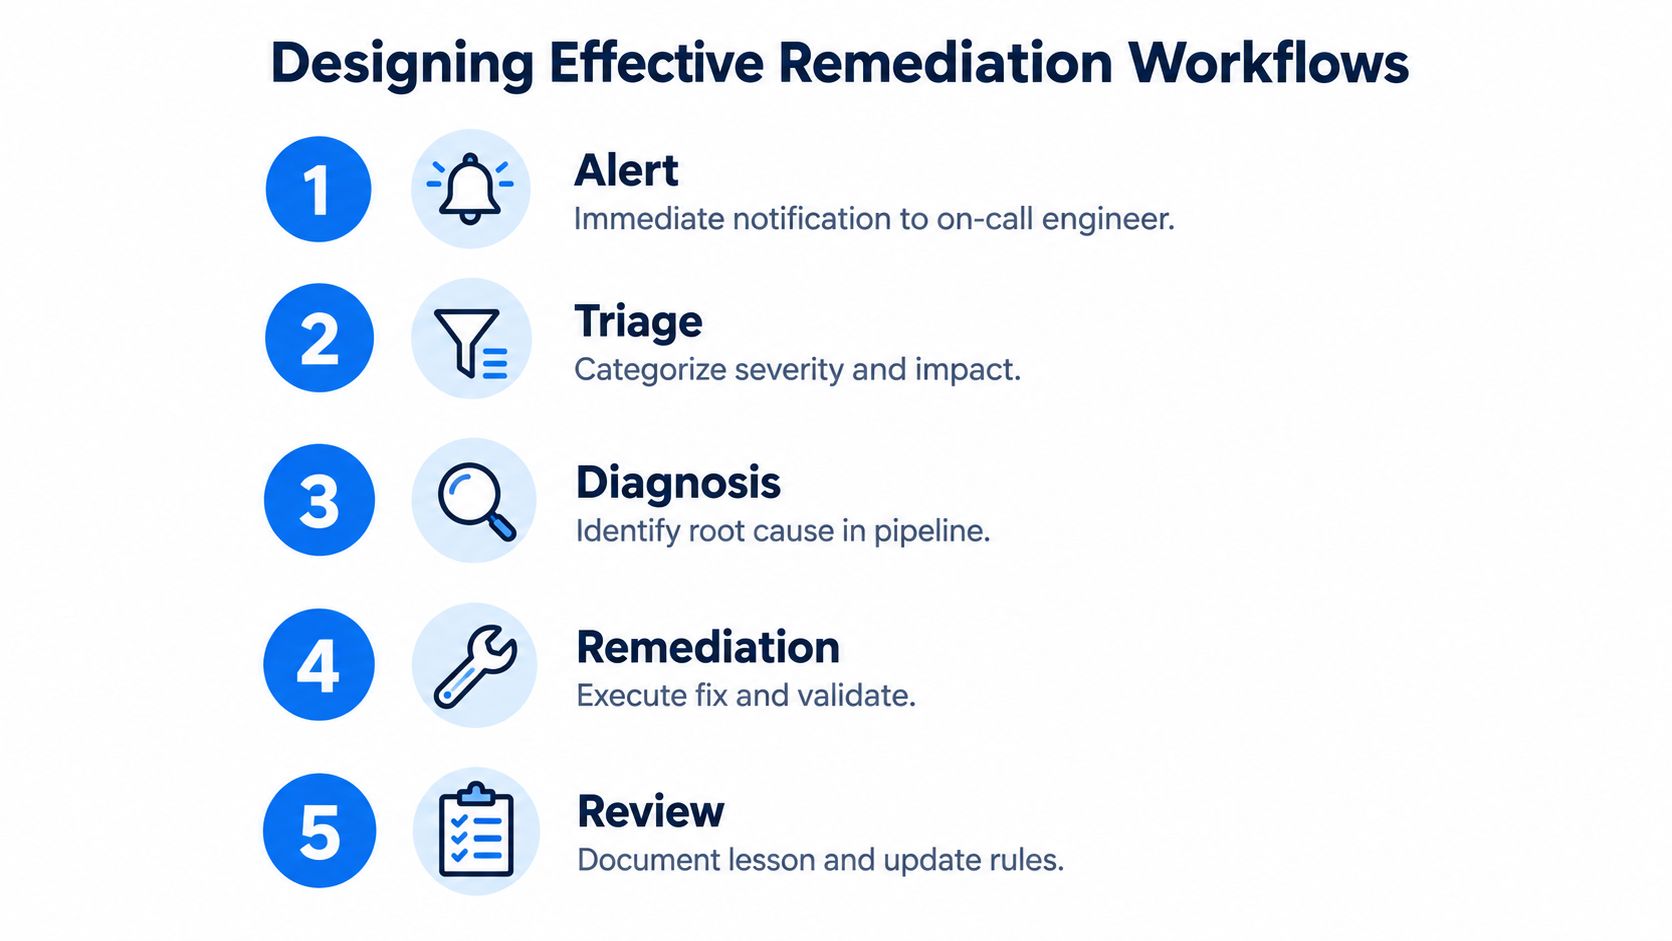
Usate un flusso di lavoro comune con rami decisionali diversi:
Alert: registrate il controllo fallito, il KPI interessato, l'intervallo di dati e il contesto del rilevamento.
Triage: classificate gravità, consumatori interessati, impatto sulle decisioni ed eventuale necessità di sospendere la pubblicazione.
Diagnosi: ricostruite il problema attraverso sistemi sorgente, trasformazioni, dati di riferimento, definizioni e recenti cambiamenti del business.
Remediation: correggete la sorgente o la logica, rideterminate la metrica se necessario e validate gli output a valle.
Revisione: registrate causa principale, decisione del responsabile, evidenze, prevenzione della ricorrenza e chiusura.
Il responsabile dovrebbe registrare esplicitamente quando un'anomalia viene accettata come legittima. Questa approvazione evita all'organizzazione di riaprire ripetutamente un evento di business noto e conserva il ragionamento per gli auditor e per gli analisti futuri.
Monitorare gli obblighi di correzione come obiettivi di servizio
I dati personali introducono un requisito operativo concreto. Ai sensi dell'articolo 5 del GDPR, i dati personali devono essere esatti e, se necessario, aggiornati. Le organizzazioni devono adottare misure ragionevoli per rettificare o cancellare tempestivamente i dati inesatti, limitando al contempo i dati a quanto necessario per la finalità e conservandoli solo per il tempo necessario. Il regolamento è disponibile nel testo del GDPR su EUR-Lex.
Le indicazioni della Commissione europea sulle richieste degli interessati stabiliscono che, quando una persona chiede a un'organizzazione di correggere dati personali inesatti, l'organizzazione deve agire senza ingiustificato ritardo, in linea di principio entro un mese, oppure fornire una spiegazione scritta del rifiuto. Per la governance dei KPI, ciò crea un obiettivo misurabile per gli incidenti che coinvolgono dati personali.
Monitorate l'intero ciclo di vita:
Campo del flusso di lavoro | Domanda operativa |
|---|---|
Presa in carico | Quando è stata ricevuta la segnalazione del difetto o la richiesta di correzione? |
Responsabilità | Chi è responsabile della decisione e della correzione? |
Ambito | Quali record, KPI, report e output di AI sono interessati? |
Remediation | Che cosa è cambiato, ed è stata corretta la sorgente o solo il report? |
Verifica | Quali evidenze dimostrano che la correzione ha funzionato? |
Chiusura | L'incidente è stato risolto entro i tempi previsti? |
Un flusso di lavoro solido non promette che ogni incidente sia semplice. Garantisce che la complessità non cancelli la responsabilità.
Costruire una strategia resiliente per la qualità dei KPI
Una strategia resiliente per la qualità dei KPI cresce insieme all'organizzazione invece di cercare di modellare ogni possibile guasto fin dal primo giorno. Iniziate dalle metriche che guidano decisioni rilevanti, poi amplia la copertura man mano che responsabili, definizioni e routine di gestione degli incidenti maturano.
La piattaforma dovrebbe supportare diversi tipi di controllo senza costringere i team a ricostruire il proprio modello operativo per ciascuno. Monitoraggio del business, tempestività, tracciamento dello schema, validazione a livello di record, rilevamento delle anomalie e analisi storica affrontano modalità di guasto diverse. Dovrebbero comunque produrre un registro degli incidenti comune e un modello di responsabilità condiviso.
Scalare per livelli
Una progressione pratica è:
Fondamenta: definite KPI critici, responsabili, sistemi sorgente, popolazioni, denominatori e uso decisionale.
Affidabilità: monitorate freschezza, volume, completezza, validità, modifiche allo schema e riconciliazione con le sorgenti.
Significato: versionate le definizioni, testate coorti e filtri, documentate gli eventi di business e richiedete l'accettazione del responsabile.
Risposta: aggiungete gravità, instradamento, scadenze di remediation, conservazione delle evidenze e reporting sulla chiusura.
Ottimizzazione: analizzate incidenti ricorrenti, precisione degli alert, impatto sulle decisioni e copertura dei controlli.
L'esecuzione all'interno del database può aiutare i team a monitorare i dati sensibili senza creare spostamenti superflui. Un'implementazione modulare consente inoltre a un'organizzazione di partire da una funzionalità mirata, come il rilevamento delle anomalie o la tempestività, per poi estendersi alle regole di business e al monitoraggio dello schema man mano che il programma di controllo dimostra il proprio valore.
La giusta misura della maturità non è il numero di controlli configurati. È la capacità dei team di rispondere, rapidamente e con evidenze, a quattro domande: che cosa è cambiato? Il KPI significa ancora ciò che pensiamo? Chi decide che cosa succede dopo? Come sappiamo che il problema è chiuso?
Considerate il controllo qualità dei KPI un controllo di business permanente, non una funzionalità della dashboard. Gli ingegneri proteggono il percorso dei dati, i business owner proteggono il significato e i team di governance rendono le evidenze riutilizzabili per reporting, compliance e AI. È questa divisione delle responsabilità che impedisce a una metrica dall'aspetto pulito di trasformarsi in una decisione sbagliata e costosa.
digna offre data observability modulare per rilevamento delle anomalie, tempestività, validazione a livello di record, modifiche allo schema e monitoraggio dei KPI di business all'interno del vostro ambiente. Usate digna per collegare i controlli tecnici alla validazione dell'idoneità alle decisioni, a flussi di gestione degli incidenti con responsabili chiari e a evidenze su cui i vostri team dati e di business possono agire.
Se i vostri KPI critici richiedono una supervisione continua accanto ai dati che li alimentano, scoprite come il monitoraggio del business con digna osserva le variazioni delle metriche e instrada i cambiamenti insoliti ai responsabili.
Domande frequenti
Che cos'è il controllo qualità dei KPI?
Il controllo qualità dei KPI è la pratica di verificare che una metrica di business non sia solo tecnicamente corretta, ma ancora adatta alla decisione che supporta. Combina controlli sulla pipeline come schema, valori nulli e volumi con test semantici su definizioni, denominatori e coorti, oltre alla revisione della comparabilità da parte del responsabile.
Perché un KPI può essere fuorviante anche quando la pipeline dei dati supera tutti i controlli?
Perché una pipeline che supera i controlli dimostra solo che i dati si sono spostati. Un KPI di crescita dei ricavi può essere completo, aggiornato e correttamente tipizzato, ma risultare fuorviante dopo un'acquisizione che cambia la popolazione, un aumento dei prezzi che determina la variazione o un denominatore che esclude silenziosamente una coorte diventata rilevante. A livello di schema non si rompe nulla.
Chi dovrebbe essere responsabile della qualità di un KPI?
La responsabilità è condivisa, ma l'ultima parola sul significato spetta al business owner. La guida raccomanda di registrare cinque ruoli per ogni KPI critico: un business owner che approva l'interpretazione, un responsabile tecnico per pipeline e test, un data steward per definizioni e lineage, i consumatori che segnalano i problemi e un auditor.
Qual è la differenza tra qualità dei dati sintattica, semantica e pragmatica?
La norma ISO 8000-1:2022 distingue le tre. La qualità sintattica verifica la conformità a un formato approvato, come schema e valori ammessi. La qualità semantica chiede se i valori rappresentano il concetto previsto, ed è testata tramite join, coorti e denominatori. La qualità pragmatica chiede se il KPI supporta ancora la decisione prevista, come confermato dal business owner.
Le anomalie dei KPI dovrebbero essere soppresse automaticamente?
No. Un sistema di rilevamento delle anomalie può segnalare una variazione come insolita, ma non può stabilire se una nuova politica di prezzo la renda corretta. Prima occorre indagare: l'evento è reale, la definizione è ancora valida e la decisione richiede una metrica rideterminata? I responsabili dovrebbero poi registrare le anomalie accettate come eventi di business legittimi.


