Come eseguire una query in modo efficiente nel 2026
|
6
min di lettura

Potete mettere in produzione una query che restituisce righe, supera i test e crea comunque problemi. Il guasto di solito emerge più tardi, quando una dashboard è lenta, un numero di riconciliazione non torna o un job a valle consuma dati alla granularità sbagliata senza che nessuno se ne accorga. Se eseguite query abbastanza spesso, imparate che «è terminata» è l'asticella più bassa, non quella che rende affidabile un data warehouse.
Indice
Perché eseguire una query significa molto più che lanciare SQL
Ottimizzare le query analitiche con statistiche e progettazione dei predicati
Oltre la sintassi Il divario di convalida semantica nel monitoraggio delle query
Gestire dati in ritardo, modificati o parziali nelle operazioni di query
Indicazioni pratiche per un'esecuzione affidabile delle query
Perché eseguire una query significa molto più che lanciare SQL
Un tempo una query veniva considerata una riga di testo inviata a un database. Per i sistemi moderni questa visione è troppo limitata, perché il database sceglie i percorsi di accesso, l'ordine dei join e l'uso delle risorse mentre costruisce il risultato. Il modello relazionale di Edgar F. Codd del 1970 ha spostato l'idea verso le richieste dichiarative, in cui l'utente indica il risultato desiderato e il sistema decide come ottenerlo, e System R di IBM ha trasformato questa idea in un sistema concreto con un ottimizzatore di query basato sui costi che confrontava piani alternativi prima dell'esecuzione (la storia di IBM su Patricia Selinger).
Questo cambiamento conta ancora ogni volta che un team esegue una query in un data warehouse, in un database operativo o in un workflow di observability. Il risultato dipende dal volume dei dati, dai risultati intermedi, dal volume di scansione e dalle risorse disponibili in quel momento, non solo dal fatto che l'SQL venga interpretato correttamente. Per i team che lavorano con observability e data quality, la query è l'operazione che si misura, non solo il testo che si rivede. Per questo le piattaforme costruite attorno al comportamento di esecuzione, come la data observability di digna, si concentrano su ciò che la query fa all'interno del database anziché sulla sola sintassi.
Regola pratica: considerate il piano di esecuzione parte della query, perché è lì che costi, pressione sulle risorse e deriva del piano emergono per primi.
Perché i controlli di sintassi non bastano
Un controllo di sintassi vi dice che l'istruzione è valida. Non vi dice se ha letto troppi dati, se ha eseguito i join nell'ordine sbagliato o se ha prodotto un risultato abbastanza plausibile da superare la revisione. È la lacuna in cui i team di produzione continuano a imbattersi, soprattutto quando il successo di una query viene giudicato solo dal suo completamento.
L'altro punto cieco è il comportamento storico. Lo stesso SQL può comportarsi diversamente quando i dati crescono, le statistiche cambiano o un percorso di join diventa meno selettivo. La storia della standardizzazione spiega anche perché i team non possono affidarsi per sempre al comportamento di un unico fornitore: l'SQL si è evoluto nel corso di decenni attraverso revisioni ANSI e ISO, restando il linguaggio comune dei sistemi relazionali (la storia dello standard SQL secondo ANSI).
Il workflow standard per eseguire una query
Il workflow di produzione più affidabile inizia prima che il database svolga il lavoro pesante. Definite prima l'output richiesto, poi chiedete solo le colonne minime necessarie per ottenerlo. In questo modo la query resta mirata ed evita di trascinare dati superflui attraverso i join e le aggregazioni successive.
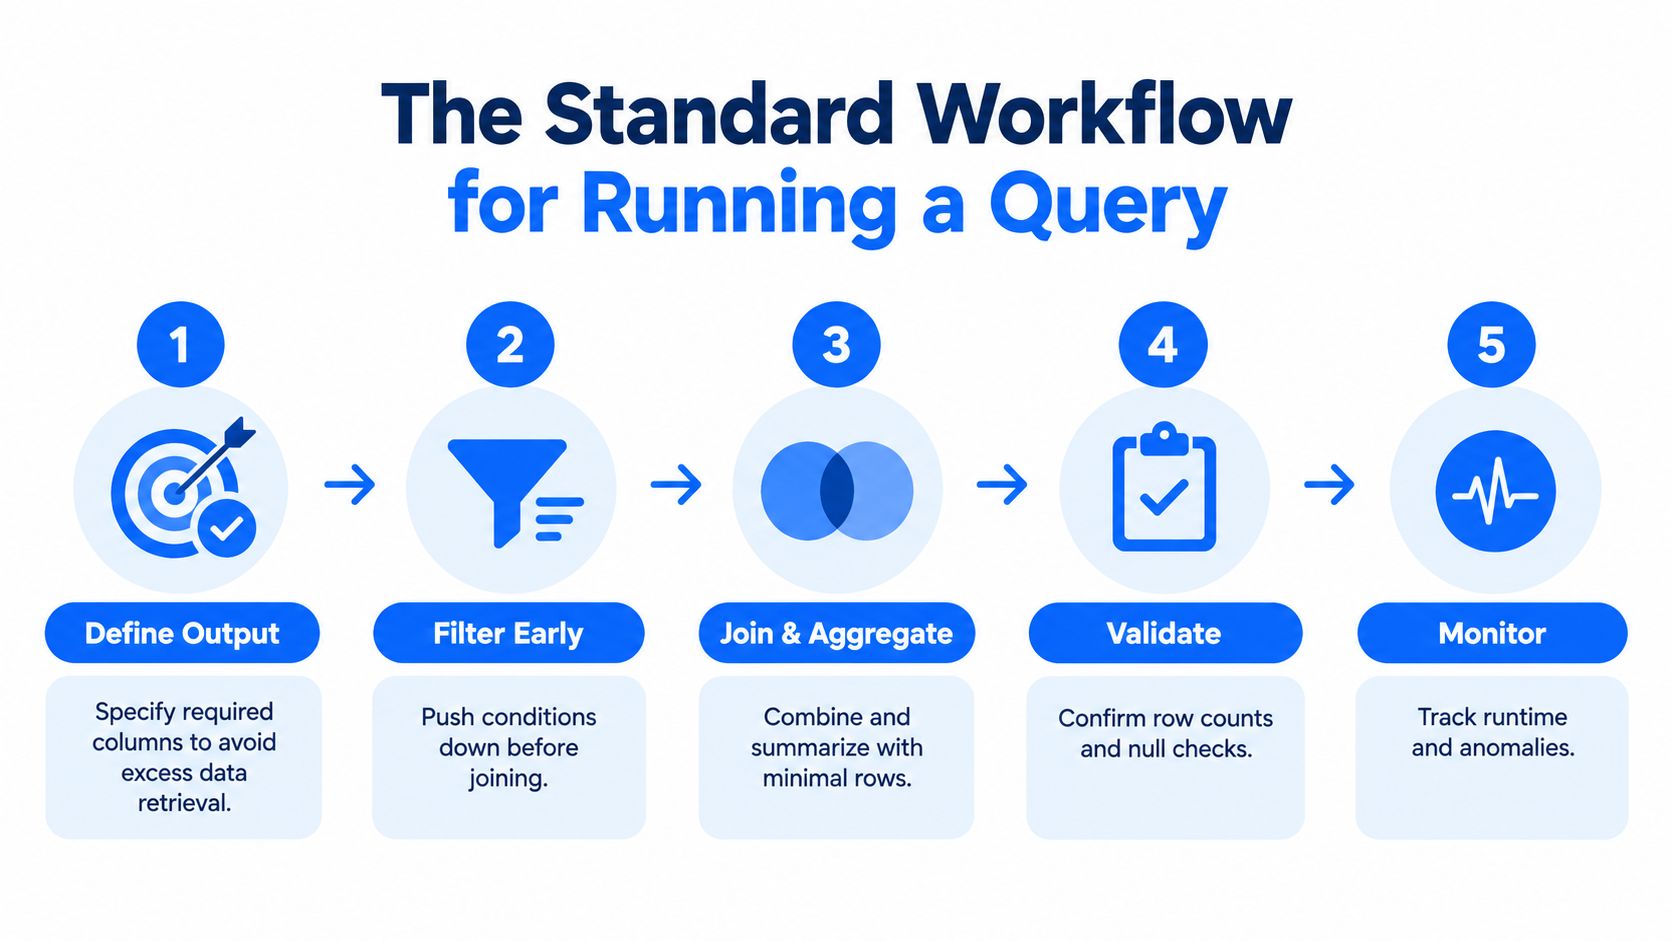
Passo 1 Definire l'output
La definizione dell'output dovrebbe includere la granularità desiderata, la popolazione di righe attesa e le colonne necessarie. Se la domanda di business riguarda l'attività giornaliera dei clienti, non interrogate i dati alla granularità conto-mese sperando che i numeri tornino in seguito. Una query che chiede meno è più facile da capire, più economica da eseguire e molto meno incline a riservare sorprese.
Passo 2 Filtrare prima del join
Applicate le condizioni il prima possibile, così il database lavora su meno righe. Questo schema è in linea con le indicazioni di Microsoft di interrogare solo le colonne necessarie e ridurre i dati prima delle operazioni di JOIN, ed è ancora più importante quando le tabelle di origine sono grandi o sbilanciate (best practice di performance di Google BigQuery).
Passo 3 Esaminare il piano di esecuzione
La revisione del piano dovrebbe coprire l'ordine dei join, il volume di scansione, le stime di cardinalità e qualsiasi fase di ordinamento o aggregazione che possa diventare un collo di bottiglia. Non fidatevi di un «sembra a posto» nell'editor SQL. Verificate cosa prevede l'ottimizzatore e confrontatelo con il carico di lavoro che vi aspettate.
Passo 4 Misurare su dati rappresentativi
Eseguite la query rivista su partizioni realistiche, non su campioni giocattolo. Una query veloce su una porzione ristretta può crollare sul mese corrente, sul cliente più grande o con la cache fredda. Misurate il risultato rispetto al budget di latenza e di risorse che avete fissato in partenza.
Mantenete la query noiosa in produzione. Noiosa significa delimitata, misurabile e stabile sulle partizioni che il vostro team interroga davvero.
Passo 5 Convalidare il comportamento a runtime
Usate i metadati del piano e del job per capire dove si perde tempo, poi rieseguite dopo ogni modifica significativa. In pratica, una query è «finita» solo quando restituisce il risultato corretto, resta entro il budget e si comporta in modo coerente su dati rappresentativi.
Per i team che desiderano un modello operativo più approfondito, l'orchestrazione delle pipeline per i carichi di query aiuta a collegare la query al resto del flusso di dati invece di trattarla come un comando isolato.
Ottimizzare le query analitiche con statistiche e progettazione dei predicati
I carichi analitici spesso passano inosservati finché non falliscono in modo eclatante. L'SQL è valido, ma l'ottimizzatore riceve un segnale sbagliato perché le chiavi di join non combaciano bene, le statistiche del catalogo sono obsolete o un predicato impone una scansione più ampia del necessario. Le linee guida di tuning di IBM indicano come rischi ricorrenti i tipi di dati non corrispondenti, le espressioni nei predicati di join, i join non di uguaglianza, gli outer join superflui, le restrizioni ridondanti e le statistiche di catalogo imprecise, e questo elenco corrisponde a ciò che i team vedono nei sistemi reali (linee guida IBM DB2 sul tuning delle query).
Cosa compromette le performance analitiche
Le espressioni su colonne indicizzate o di partizionamento sono una trappola comune. Non appena racchiudete la colonna in una funzione, il predicato può diventare non sargable: il database non può usare il percorso di accesso previsto e finisce per scansionare più dati del necessario. La convalida dei tipi di dati conta altrettanto, perché una chiave di join non corrispondente può spingere l'ottimizzatore verso un piano meno efficiente.
Qui sono utili anche risorse di apprendimento pratiche. Se state sviluppando le vostre competenze sui database e volete affinare la parte di tuning, build database projects without a degree è una lettura esterna utile, perché imposta la crescita delle competenze sul lavoro reale anziché sulla teoria.
Un ciclo di convalida disciplinato
Eseguite la query una volta per verificarne la correttezza, poi confrontate le righe stimate con quelle effettive in ogni fase. Successivamente testate il comportamento con cache fredda e calda, misurate il tempo trascorso e l'uso delle risorse e cambiate una sola cosa alla volta. Questa sequenza è più lenta del ritoccare l'SQL alla cieca, ma è l'unico modo per sapere se una modifica ha migliorato il piano o ha solo spostato il costo altrove.
Una routine solida dovrebbe includere:
Convalidate prima le chiavi di join. Assicuratevi che i tipi di dati corrispondano prima di intervenire su indici o hint.
Controllate gli errori di stima. Se le stime delle righe del piano sono sbagliate, intervenite sulle statistiche o sulla forma del predicato prima di dare la colpa all'hardware.
Misurate il consumo di risorse. CPU, memoria, byte scansionati e volume di spill o shuffle vi dicono se la query è in salute.
Ripetete dopo ogni singola modifica. Più modifiche contemporanee nascondono la causa del miglioramento o della regressione.
Per i team che standardizzano il tuning delle query, la guida all'ottimizzazione delle query SQL è utile perché collega la progettazione dei predicati al percorso di esecuzione reale invece di trattare l'ottimizzazione come un esercizio di formattazione.
Oltre la sintassi Il divario di convalida semantica nel monitoraggio delle query
Una query può essere eseguita correttamente ed essere comunque sbagliata in modi che contano. Può duplicare righe attraverso un join, perdere record arrivati in ritardo, spostare per errore un limite di date o aggregare alla granularità sbagliata restituendo un set di risultati perfettamente pulito. Per questo sintassi e stato di esecuzione, da soli, sono segnali deboli.
La ricerca indipendente sui database mostra che gli errori di stima della cardinalità sono diffusi e spesso sono la causa principale di piani di query scadenti (ricerca VLDB sul comportamento delle query e sulla stima della cardinalità). Questo è importante perché le ipotesi dell'ottimizzatore danno forma al piano, e il piano determina le performance e talvolta la qualità del risultato su cui contate.
Successo di esecuzione e successo semantico
Il successo di esecuzione significa che il motore ha completato l'istruzione. Il successo semantico significa che la query ha restituito la popolazione corretta, alla granularità corretta e con il significato di business corretto. Sono test diversi, e i team di produzione hanno bisogno di entrambi.
Un monitoraggio delle query che si ferma al runtime non vede i guasti più pericolosi. La query può essere veloce, economica e comunque sbagliata. Nei settori finanziario, sanitario, delle telecomunicazioni e pubblico, questo tipo di errore può contaminare report, decisioni operative o input dei modelli senza far scattare alcun incidente evidente.
Un modello di produzione più solido consiste nell'associare delle aspettative a ogni query critica:
Granularità attesa. Sappiate se l'output deve essere a livello cliente-giorno, conto-mese o altro.
Totali di riconciliazione. Confrontate i totali dell'output con un totale di controllo affidabile, quando esiste.
Casi limite rappresentativi. Verificate esplicitamente arrivi in ritardo, chiavi duplicate e date di confine.
Baseline comportamentale. Confrontate la forma attuale del risultato con le esecuzioni precedenti e tenete d'occhio la deriva.
L'approccio in-database di digna si adatta a questo modello perché i controlli vengono eseguiti dove risiedono i dati, così i team possono convalidare il comportamento senza spostare record sensibili fuori dal data warehouse o dall'archivio operativo. È un vantaggio concreto quando l'obiettivo è l'observability e non l'ennesima copia dei dati.
Gestire dati in ritardo, modificati o parziali nelle operazioni di query
Una query può terminare senza errori ed essere comunque inadatta all'uso in produzione. Un file può arrivare dopo l'orario limite, una fonte può ricaricare righe a posteriori o un produttore può cambiare struttura senza preavviso. L'SQL continua a funzionare, ma il risultato potrebbe non corrispondere più alla porzione di business che intendevate. I team che si affidano solo a controlli superato o fallito di solito se ne accorgono quando una dashboard cambia o un job a valle consuma l'output errato.
Le linee guida della Commissione europea sulla qualità dei dati trattano la qualità come dipendente dallo scopo e indicano accuratezza, completezza, coerenza, unicità, integrità, tempestività, provenienza e metodi di raccolta dei dati come attributi di qualità. Questa impostazione si adatta al lavoro operativo sulle query meglio di un indicatore binario di successo.
Il monitoraggio ha bisogno di un modello di gravità
I controlli su freschezza, copertura dei periodi, modifiche di schema e completezza non dovrebbero tutti generare la stessa risposta. Un caricamento in ritardo ma valido può meritare un avviso. Un file di origine mancante dovrebbe bloccare l'uso a valle. Se ogni problema è bloccante, i team smettono di fidarsi degli alert. Se ogni problema è solo informativo, nessuno reagisce abbastanza in fretta.
Un controllo efficace nasce da soglie consapevoli del contesto, non da un'unica regola superato o fallito per ogni dataset.
La scelta più difficile è distinguere i dati in ritardo ma validi da quelli mancanti. Gli schemi storici di arrivo aiutano. Anche le baseline stagionali. E così un responsabile chiaro per ogni controllo. Conservate le evidenze per la revisione, perché le domande dopo un incidente sono di solito semplici: cosa è cambiato, quando è cambiato e il risultato era ancora sicuro da usare?
Dove il contesto batte la rigidità
Se una fonte di norma arriva presto ma una volta alla settimana arriva in ritardo, la policy dovrebbe riflettere questo schema. Se un dataset viene corretto più tardi nella giornata, il monitoraggio deve consentire incoerenze temporanee senza mascherare guasti reali. È questo il confine tra un controllo duraturo e un'automazione fragile.
Per i team che hanno bisogno di una definizione concreta di freschezza, metriche e monitoraggio della tempestività dei dati offre un modo pratico per definire il set di regole e il modello di gravità degli alert.
Anche gli input in ritardo o modificati richiedono controlli semantici. Granularità, popolazione e significato di business possono andare alla deriva anche quando la freschezza sembra accettabile. È qui che un approccio in-database aiuta, perché consente ai team di convalidare queste condizioni dove risiedono i dati invece di copiare i record solo per ispezionarli.
Indicazioni pratiche per un'esecuzione affidabile delle query
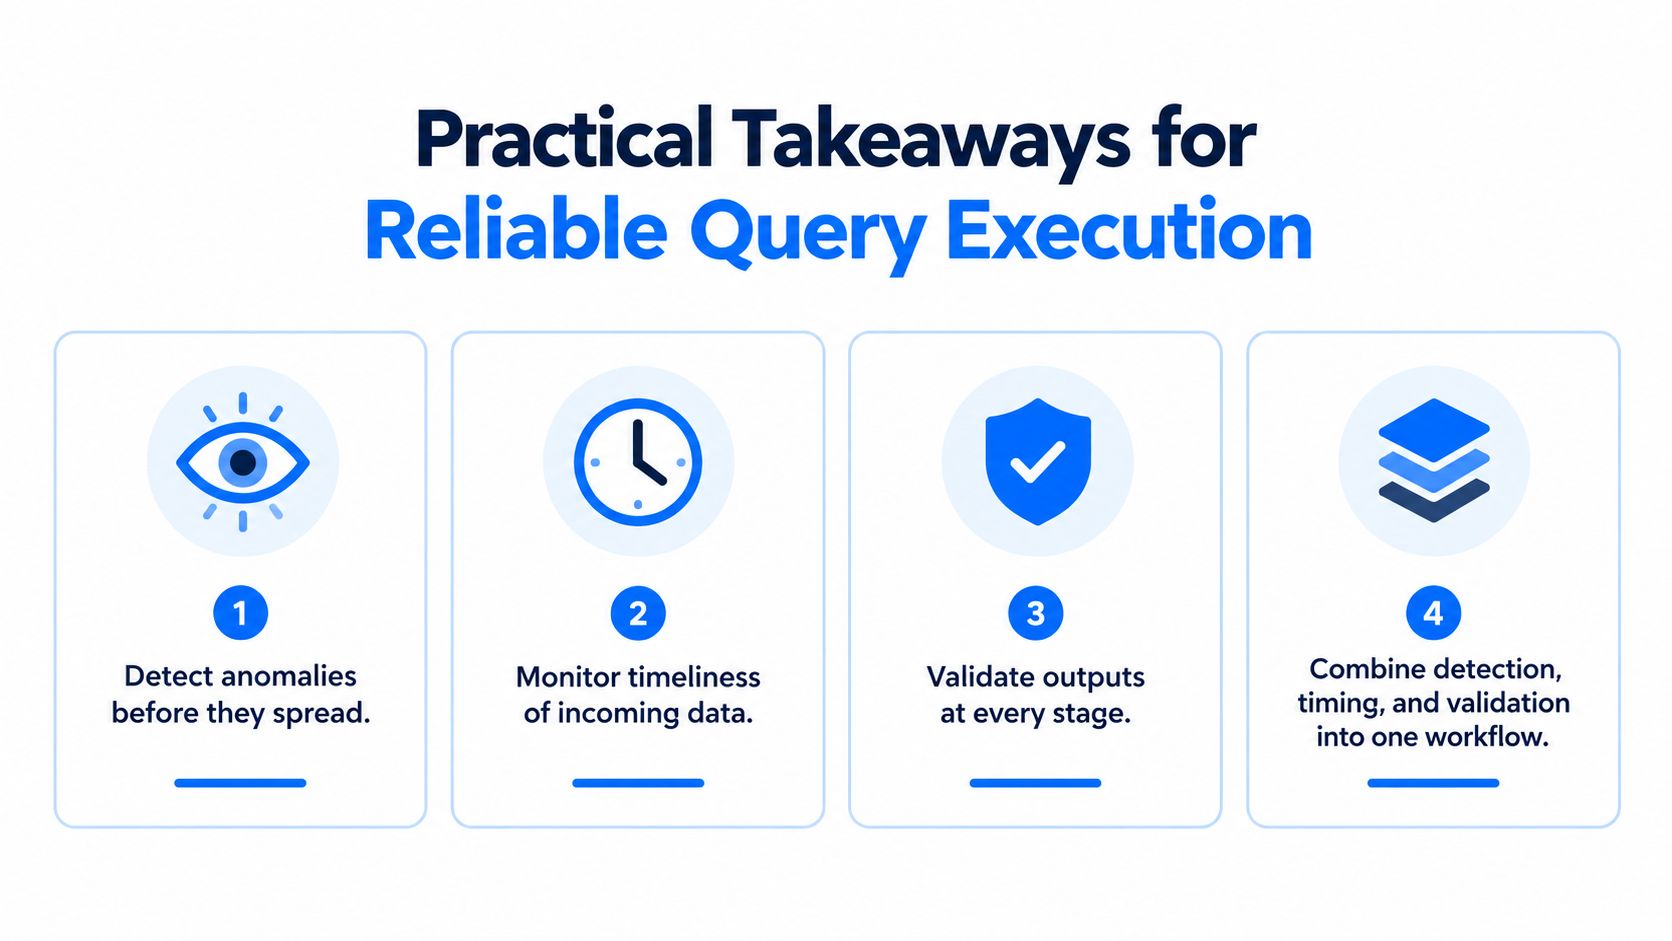
Una query che restituisce un risultato senza errori può comunque essere sbagliata. In produzione, un'esecuzione affidabile dipende dal lavoro congiunto di controllo delle performance, controllo della tempestività e convalida semantica, perché un risultato veloce con la granularità o la popolazione sbagliata resta un fallimento.
Cosa standardizzare
Partite dalla granularità attesa e dalla finestra di latenza accettabile per ogni query importante. Registrate una baseline per tempo di esecuzione, righe scansionate e forma dell'output, così le regressioni diventano visibili quando il comportamento cambia. Se verificate solo che l'istruzione sia terminata, vi sfugge la deriva che conta.
Mantenete la policy abbastanza semplice da poter essere applicata sotto pressione. Definite quali guasti bloccano l'uso, quali avviano una revisione e quali sono tollerabili per un breve periodo. Questo approccio allinea rilevamento, convalida e governance senza trasformare ogni alert in una crisi.
Cosa funziona in produzione
Usate il rilevamento delle anomalie per la deriva, i controlli di tempestività per gli arrivi e la convalida per le regole di business. Quando possibile, eseguite questi controlli in-database, perché copiare i dati altrove solo per ispezionarli aggiunge costi e rischi. Se il data warehouse può testare il comportamento dove i dati già risiedono, la diagnosi è più rapida ed è più facile fidarsi degli alert.
Per le performance delle query, mantenete revisione del piano e confronto con la baseline nello stesso ciclo. Se il piano cambia, esaminatelo. Se le stime delle righe vanno alla deriva, confrontatele con i valori effettivi. Se il tempo di esecuzione resta nel budget ma la forma dell'output non torna, trattatelo come un problema di dati e non come un'esecuzione riuscita.
Per i team che confrontano diversi approcci, il tuning delle performance dei database per query affidabili è un complemento pratico, perché collega il comportamento delle query alla stabilità del carico di lavoro invece che a correzioni isolate.
Se dovete monitorare il comportamento delle query, individuare presto la deriva e convalidare gli output senza spostare dati sensibili, visitate digna. digna esegue i controlli all'interno del vostro data warehouse, così convalidate granularità, tempestività e deriva senza spostare un solo record.
Per capire meglio perché i controlli eseguiti dove risiedono i dati sono più sicuri e più veloci dell'esportazione dei record verso uno strumento esterno, leggete il nostro articolo sull'esecuzione in-database dei controlli di data quality.
Domande frequenti
Cosa significa eseguire una query in modo efficiente?
Eseguire una query in modo efficiente significa che restituisce il risultato corretto, resta entro il budget di latenza e risorse e si comporta in modo coerente su dati rappresentativi. Terminare senza errori è solo l'asticella più bassa. Una query può essere veloce ed economica ma sbagliata, se aggrega alla granularità errata o perde righe in ritardo.
Perché conviene filtrare prima del join in SQL?
Filtrare prima del join consente al database di lavorare su meno righe, riducendo il volume di scansione e la dimensione dei risultati intermedi. Applicate le condizioni il prima possibile e selezionate solo le colonne necessarie. L'effetto è più forte con tabelle di origine grandi o sbilanciate, come raccomandano anche le best practice di BigQuery.
Cosa bisogna controllare in un piano di esecuzione?
Esaminate l'ordine dei join, il volume di scansione, le stime di cardinalità e qualsiasi fase di ordinamento o aggregazione che possa diventare un collo di bottiglia. Confrontate poi le righe stimate con quelle effettive in ogni fase, perché la ricerca indica gli errori di stima della cardinalità come causa principale di piani scadenti.
Perché una query eseguita con successo può restituire risultati sbagliati?
Il successo di esecuzione indica solo che il motore ha completato l'istruzione. Il risultato può comunque duplicare righe attraverso un join, tralasciare record in ritardo, spostare un limite di date o aggregare alla granularità sbagliata. Associare aspettative come granularità, totali di riconciliazione e una baseline comportamentale permette di intercettare questi errori semantici.
Come dovrebbero incidere i dati in ritardo o parziali sul monitoraggio delle query?
I dati in ritardo o parziali richiedono un modello di gravità anziché un'unica regola superato o fallito. Un caricamento in ritardo ma valido può meritare solo un avviso, mentre un file di origine mancante dovrebbe bloccare l'uso a valle. Schemi storici di arrivo e baseline stagionali vi aiutano a distinguere i dati in ritardo da quelli mancanti.


