Che cos'è Parquet: il formato colonnare spiegato
|
8
min di lettura

Probabilmente avete già incontrato Parquet senza rendervene conto. Una query di una dashboard viene eseguita su file in un object storage, l'SQL sembra innocuo, eppure un'aggregazione apparentemente semplice passa la maggior parte del tempo a leggere dati di cui la query non ha mai bisogno. Lo stesso dataset può funzionare senza problemi in DuckDB o Spark e poi comportarsi diversamente in un altro motore, perché un tipo logico, una statistica o una funzionalità più recente non vengono interpretati allo stesso modo.
Quindi, che cos'è Parquet? Apache Parquet è un formato di file dati open source e orientato alle colonne, progettato per l'archiviazione e il recupero efficienti, in particolare per i carichi di lavoro analitici. Non è un database e non sostituisce un formato di tabella come Iceberg o Delta Lake. È il livello fisico dei file che sta alla base di molti data lake, data warehouse, export analitici e pipeline di machine learning.
Indice
Perché esiste Parquet e dove si colloca
Dove si colloca Parquet in uno stack dati moderno
Come è nato Parquet
All'interno di un file Parquet
I row group sono i piani
I column chunk sono gli scaffali
Le pagine sono la più piccola unità di lettura pratica
Encoding e compressione che lavorano insieme
Encoding e codec Parquet più comuni in sintesi
Predicate pushdown e perché le query diventano più veloci
Cosa controlla il lettore
Parquet vs CSV, JSON e ORC
Parquet vs CSV vs JSON vs ORC
Interoperabilità, sicurezza e compromessi reali
Il supporto dei motori è una questione di compatibilità
I costi dietro la comodità
Consigli pratici per i carichi di lavoro analitici
Una checklist pratica per il layout
Considerazioni su governance e AI
Perché esiste Parquet e dove si colloca
Un analista esegue:
Su un CSV di grandi dimensioni, il motore di query in genere analizza le righe dell'intero file e ispeziona campi che il calcolo non usa mai. Letture dallo storage e tempo di CPU vengono spesi per colonne non pertinenti. Parquet raggruppa i valori per colonna, consentendo al lettore di concentrarsi invece su region e revenue.
L'idea chiave è l'organizzazione fisica. Un file orientato alle righe tiene insieme i campi di ciascun record, mentre un file colonnare raggruppa i valori della stessa colonna. Le colonne contengono comunemente tipi di dati simili e valori ripetuti, offrendo ai metodi di encoding e compressione uno schema più prevedibile. Apache descrive Parquet come un formato di file dati open source e orientato alle colonne per l'archiviazione e il recupero efficienti nella sua documentazione ufficiale.
Questo design si adatta a diversi carichi di lavoro comuni:
Data lake in cloud: i file in Amazon S3 e in object store simili possono essere interrogati senza caricare ogni campo in un database.
Tabelle dei fatti analitiche: Spark, Trino e Presto possono leggere le colonne selezionate da grandi dataset di eventi o transazioni.
Export operativi: i team possono estrarre i dati applicativi e pubblicarne una copia analitica senza mantenere un formato di interscambio testuale e pesante.
Feature di machine learning: le pipeline di training e i feature store possono scambiarsi file tipizzati e compressi invece di analizzare ripetutamente CSV o JSON.
Parquet ha anche un posto specifico nello stack di un data lake. Un data lake contiene file e metadati. I formati di tabella aggiungono transazioni, snapshot, tracciamento delle partizioni e gestione dello schema. Questo confronto tra data lake e data mart colloca Parquet all'interno di questa architettura più ampia.
Dove si colloca Parquet in uno stack dati moderno
Livello | Ruolo tipico | Ruolo di Parquet |
|---|---|---|
Sistemi sorgente | Applicazioni, API e database operativi | Di solito una destinazione di export, non il sistema sorgente |
Ingestion | Sposta e deposita dati grezzi o trasformati | Formato di atterraggio efficiente per batch analitici |
Storage | Object storage e file del data lake | Formato di file fisico principale |
Gestione delle tabelle | Transazioni, snapshot e coordinamento dello schema | Livello fisico dei file alla base di formati come Iceberg o Delta Lake |
Motore di query | Elaborazione SQL e dataframe | Letto direttamente da molti motori analitici |
BI e ML | Dashboard, modelli e pipeline di feature | Formato compatto di interscambio e scansione |
Parquet si trova al di sotto di formati di tabella come Iceberg e Delta Lake, fornendo il livello fisico dei file anziché gestire transazioni o snapshot. Questa separazione spiega perché un file Parquet può funzionare su diversi motori, mentre il comportamento a livello di tabella dipende comunque dai metadati e dal sistema di query circostanti.
Il modello mentale pratico è semplice: Parquet rende le scansioni analitiche dei file selettive ed economiche. I suoi vantaggi dipendono da come sono organizzati i file, da come i valori attraversano encoding e compressione, da come i filtri arrivano al lettore e dal fatto che il motore scelto supporti le funzionalità rilevanti in modo coerente.
Come è nato Parquet
Parquet è nato da un problema pratico di Hadoop: le query analitiche spesso avevano bisogno di pochi campi da record molto ampi. Twitter e Cloudera lo hanno sviluppato come progetto open source, influenzati dal lavoro di Google su Dremel per l'elaborazione colonnare dei dati annidati. La prima release è arrivata il 13 marzo 2013, seguita da Parquet 1.0 nel luglio 2013, come riportato nella storia di Apache Parquet.

L'obiettivo del design era la lettura selettiva. Se una query richiedeva customer_id e revenue da un record di evento molto ampio, il lettore poteva evitare di analizzare i campi non pertinenti. L'influenza di Dremel ha inoltre orientato Parquet verso i dati analitici annidati, e non solo verso tabelle piatte simili a fogli di calcolo.
ORC si è sviluppato nell'ecosistema Hive con obiettivi simili, offrendo agli utenti Hadoop un'altra valida scelta colonnare. Il ruolo di Parquet è cresciuto man mano che più strumenti adottavano lettori e scrittori compatibili. Il formato ha anche continuato a evolversi. Un esempio è BYTE_STREAM_SPLIT, approvato nella linea di release 2.8.0 nel 2019, che ha aggiunto una funzionalità standardizzata invece di lasciare il formato invariato.
Il progetto è diventato un progetto di primo livello della Apache Software Foundation il 27 aprile 2015. Questa governance sostiene un ecosistema con molte implementazioni indipendenti invece di un unico lettore controllato da un fornitore. Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena e Redshift sono tra i motori e i servizi elencati nella documentazione dell'ecosistema del formato. La compatibilità dipende comunque da quali funzionalità implementa ciascun motore e da come gestisce schemi, encoding e metadati.
Questo conta al momento dell'ingestion. Una pipeline di data ingestion può scrivere batch analitici in Parquet, mentre un formato di tabella aggiunge transazioni e snapshot e un motore di query decide come scansionare i file.
Lezione storica: Parquet ha avuto successo adattandosi a un modello di accesso analitico comune, per poi diffondersi tra motori in grado di leggere in modo efficiente le colonne selezionate.
La sua storia spiega la divisione delle responsabilità: Parquet gestisce i livelli di file fisico, encoding e compressione, mentre i sistemi circostanti forniscono la gestione delle tabelle e il comportamento delle query.
All'interno di un file Parquet
Una query ha bisogno solo di pochi campi di una grande tabella, eppure un file orientato alle righe può costringerla a leggerli tutti. Parquet evita questo spreco grazie a un layout fisico annidato. Un'analogia utile è l'edificio di una biblioteca: il file Parquet è l'edificio, un row group è un piano, un column chunk è uno scaffale e una pagina è una pila di libri su quello scaffale. Ogni livello ha un compito specifico.
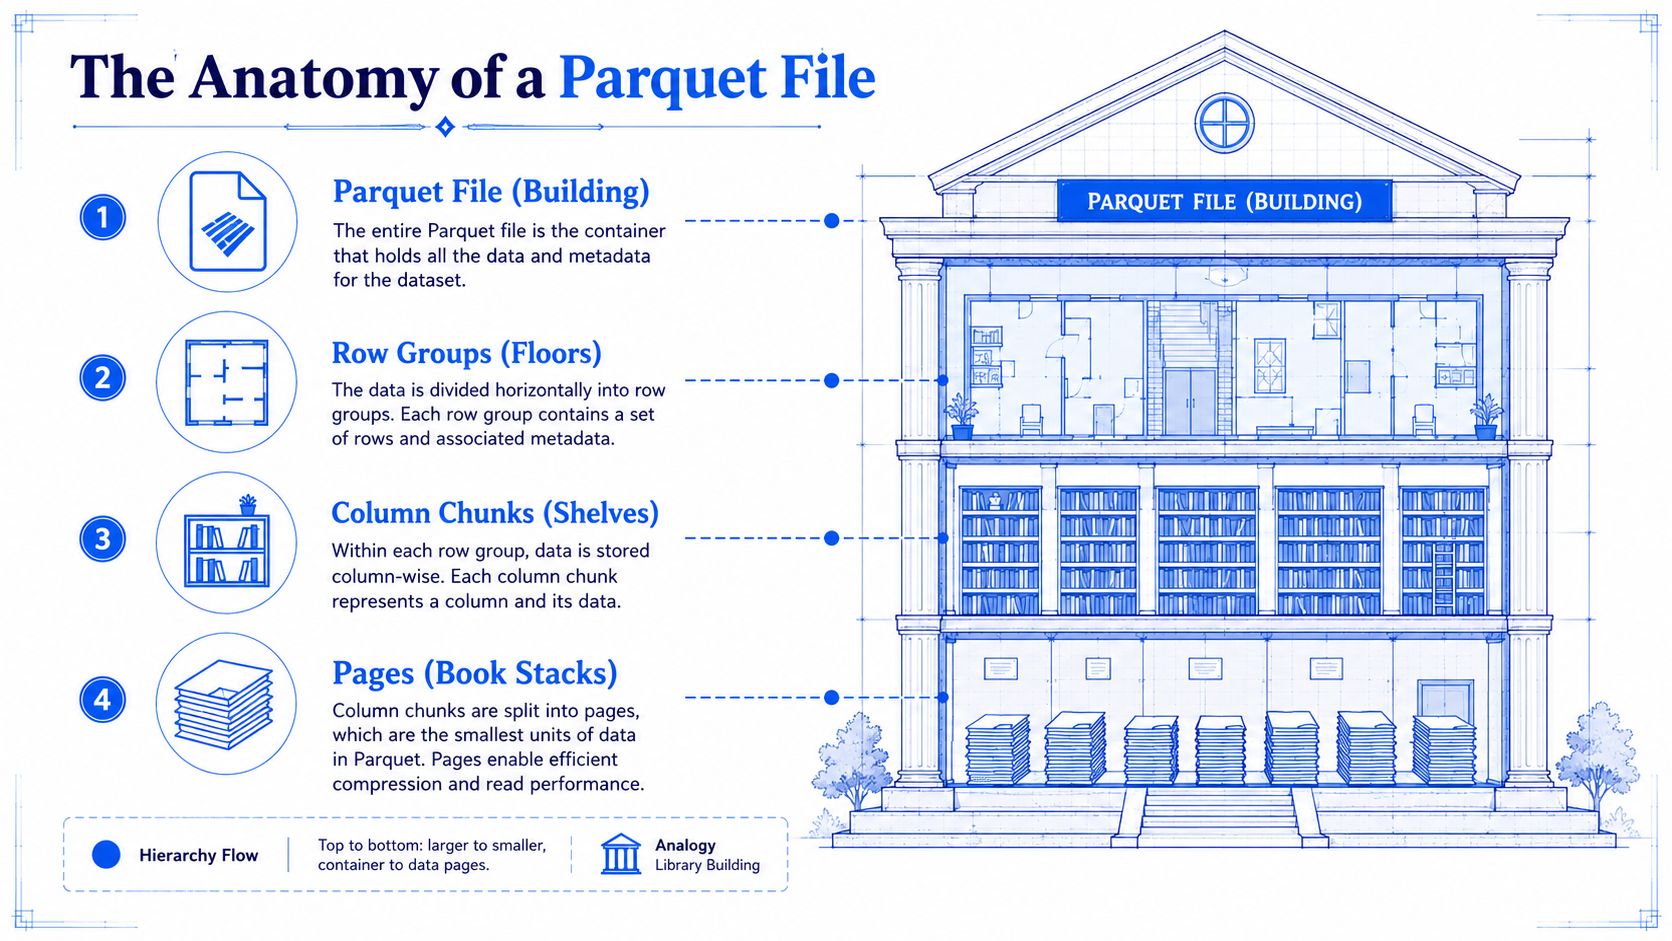
Un file Parquet inizia con un magic header di 4 byte, PAR1. I suoi dati sono organizzati in row group. Ogni row group ha esattamente un column chunk per colonna e ogni column chunk contiene una o più pagine. Questa gerarchia fornisce ai lettori la struttura necessaria per selezionare le colonne e saltare i dati non pertinenti, come descritto nella documentazione Apache sui concetti di Parquet.
I row group sono i piani
Un row group contiene una porzione orizzontale delle righe della tabella. Per colonne come event_date, region e revenue, un row group contiene una parte di tutte e tre. I rispettivi intervalli di righe restano allineati, quindi un motore può valutare gli stessi record leggendo solo le colonne richieste da una query.
Gli scrittori puntano comunemente a row group nell'ampio intervallo tra 128 MB e 1 GB. L'impostazione appropriata dipende dal motore, dal sistema di storage, dal carico di lavoro e dal numero di colonne. Gruppi più grandi possono ridurre l'overhead dei metadati, mentre gruppi più piccoli consentono di saltare i dati con maggiore granularità. Considerate il dimensionamento dei row group una decisione legata al carico di lavoro, non una costante universale.
I column chunk sono gli scaffali
All'interno di un row group, ogni colonna ha il proprio column chunk. Il chunk region memorizza i valori di regione codificati, mentre il chunk revenue memorizza i valori di ricavo codificati. Una query che ha bisogno di quei campi può evitare di leggere un chunk customer_notes non pertinente.
Il footer registra la posizione e i metadati di ciascun chunk. Descrive inoltre lo schema e i percorsi dei metadati delle colonne, consentendo a un lettore di interpretare i campi annidati e di individuare i byte rilevanti senza scansionare il file dall'inizio.
Le pagine sono la più piccola unità di lettura pratica
I column chunk sono suddivisi in pagine che contengono valori codificati e metadati di pagina. Una dimensione di pagina predefinita comune è 1 MB, anche se scrittori e motori possono scegliere altre impostazioni. Le pagine forniscono un confine più fine per statistiche, compressione e letture selettive.
Il file termina con un footer che contiene le informazioni necessarie per decodificare i dati, seguito da un marcatore finale PAR1. Un lettore può posizionarsi alla fine, leggere il footer, identificare lo schema e la posizione dei row group, quindi eseguire letture mirate sui chunk e sulle pagine selezionati. Questa struttura rende Parquet binario, autodescrittivo e suddivisibile per l'elaborazione distribuita.
Il modello mentale del lettore: partire dal footer, identificare i row group e le colonne utili, quindi leggere chunk e pagine mirati.
Parquet contiene le informazioni strutturali necessarie per leggere sé stesso, quindi non è richiesto un catalogo separato. Un catalogo può comunque semplificare la ricerca. Una solida gestione dei metadati aiuta su scala di tabella, soprattutto quando occorre tracciare molti file e versioni di schema. La portabilità dei file dipende inoltre dal fatto che i lettori supportino le funzionalità usate dallo scrittore, non semplicemente dal fatto che entrambi gli strumenti si dichiarino compatibili con Parquet.
Encoding e compressione che lavorano insieme
Spesso si usano “encoding” e “compressione” come se significassero la stessa cosa. In Parquet sono fasi separate di una pipeline:
L'encoding rimodella i valori per far emergere degli schemi.
La compressione riduce il flusso di byte risultante.
Considerate una colonna country che contiene stringhe ripetute. Il dictionary encoding può assegnare a ciascun valore distinto un piccolo identificatore intero e memorizzare questi identificatori invece di ripetere le stringhe complete in tutta la pagina. Il run-length encoding può rappresentare in modo compatto una sequenza di valori identici. Il delta encoding memorizza le differenze tra valori consecutivi, il che può essere efficace quando i numeri sono ordinati o cambiano gradualmente. Il bit-packing memorizza piccoli interi usando solo i bit necessari.
Queste tecniche non sono adatte a ogni colonna. Il dictionary encoding è naturale per valori categoriali ripetuti, mentre il delta encoding richiede una sequenza con uno schema utile. Lo scrittore sceglie un encoding per la colonna e la pagina, e i metadati registrano tale scelta.
Solo dopo questo rimodellamento un codec a livello di pagina comprime i byte. La documentazione Apache descrive codec come Snappy, GZIP, LZ4 e ZSTD, mentre PyArrow supporta anche Brotli e l'output non compresso nella sua documentazione di configurazione di Parquet. La documentazione del formato spiega che il contenuto delle pagine viene compresso così com'è, senza framing o padding aggiuntivi, il che mantiene semplice il comportamento della decompressione.
Encoding e codec Parquet più comuni in sintesi
Tecnica | Ideale per | Compromesso |
|---|---|---|
Dictionary encoding | Stringhe ripetute e valori categoriali | Meno utile quando i valori sono per lo più distinti |
Run-length encoding | Lunghe sequenze dello stesso valore | Rende poco quando i valori cambiano di continuo |
Delta encoding | Valori numerici ordinati o che cambiano gradualmente | Dipende dall'ordine e dalla forma dei dati |
Bit-packing | Piccoli interi e indici compatti | Richiede intervalli di valori adatti |
Snappy | Letture e scritture veloci | Di solito privilegia la velocità rispetto alla massima riduzione delle dimensioni |
ZSTD | Maggiore riduzione dello spazio di archiviazione | Può richiedere più CPU rispetto ai codec più veloci |
GZIP | Compatibilità con strumenti meno recenti | Spesso più lento per i carichi di lavoro interattivi |
LZ4 | Compressione e decompressione a bassa latenza | Il rapporto di compressione dipende dai dati |
Le impostazioni di encoding e codec risiedono in parti diverse dei metadati del file. La scelta dell'encoding appartiene alle informazioni di pagina e di colonna, mentre il codec di compressione è registrato nei metadati di pagina pertinenti. Scrittori come Apache Spark, DuckDB e PyArrow possono adottare impostazioni predefinite diverse, quindi due file Parquet validi possono avere profili di performance differenti.
Un errore di tuning comune è selezionare un livello di compressione aggressivo senza misurare il carico di lavoro. Una volta che una colonna è già stata resa molto regolare tramite l'encoding, un'impostazione più lenta come ZSTD livello 19 può aggiungere costo di CPU senza produrre una riduzione utile delle dimensioni. La scelta giusta dipende dal fatto che il collo di bottiglia sia lo storage, il trasferimento di rete, la CPU o la latenza.
Predicate pushdown e perché le query diventano più veloci
Una query di una dashboard filtra le vendite di gennaio, raggruppa i risultati per regione e somma i ricavi. Un lettore Parquet può rispondere senza decodificare la maggior parte del file. Il meccanismo si chiama predicate pushdown o, più precisamente, filtraggio e pruning a livello di storage.
Il motore controlla innanzitutto il valore minimo e massimo di event_date registrato per ciascun row group. Se un row group si trova interamente al di fuori di gennaio, il lettore può saltarlo senza aprirne le pagine di dati. Per un row group che si sovrappone all'intervallo di date, le statistiche a livello di pagina possono escludere le pagine i cui intervalli non possono comunque corrispondere.
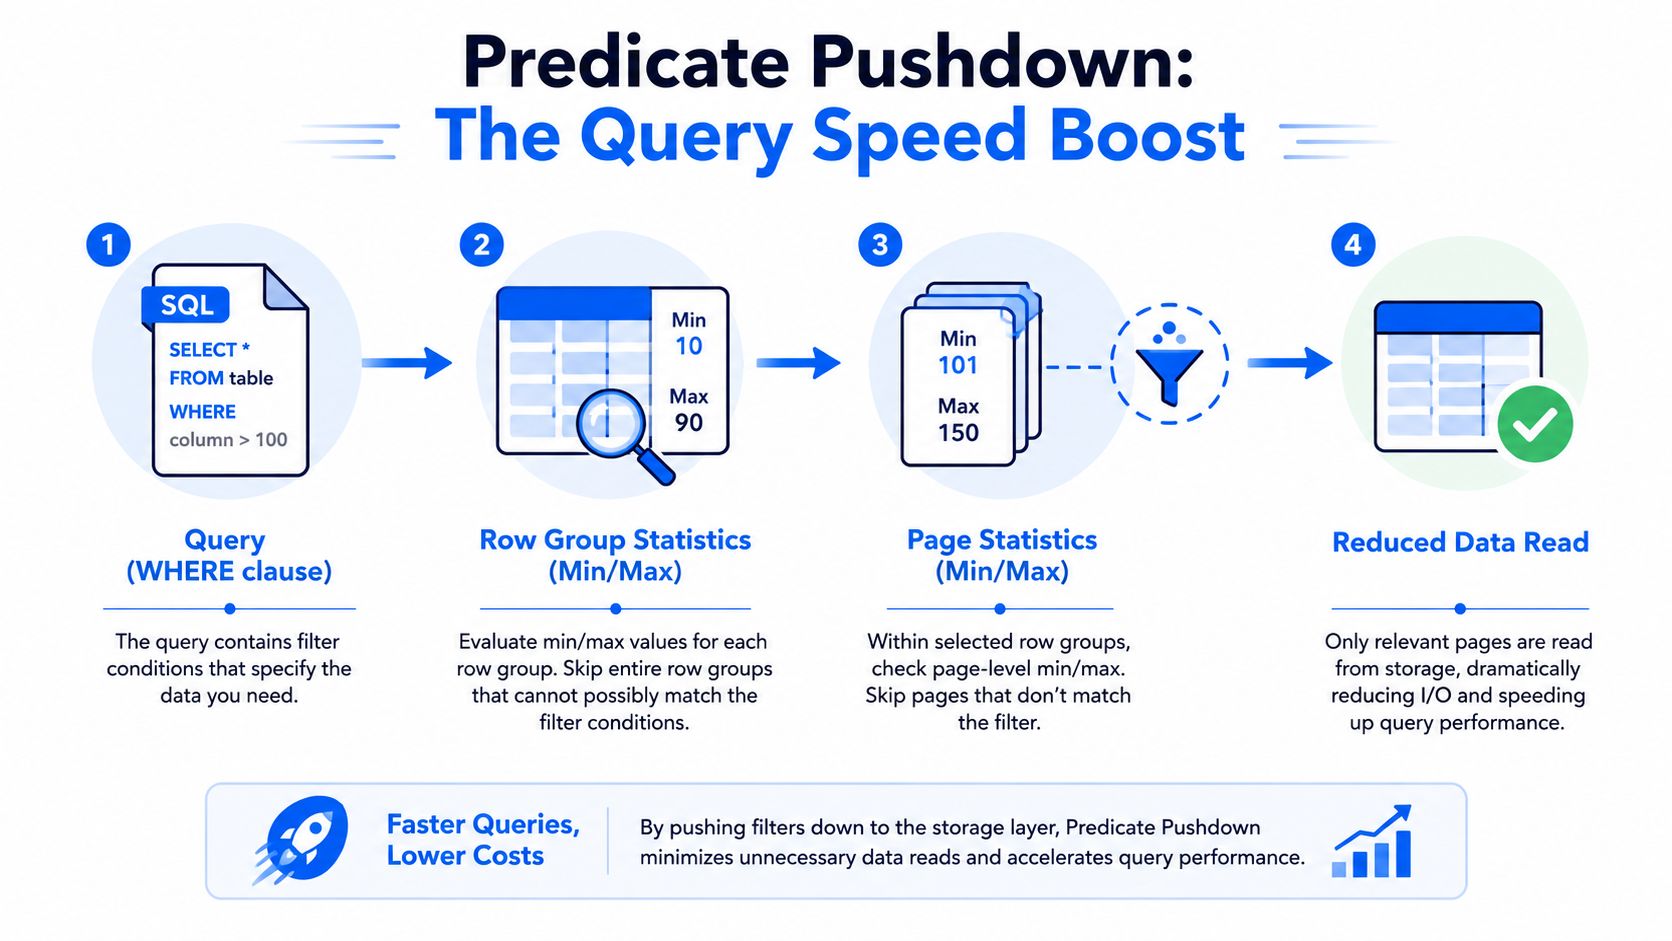
Il lettore richiede quindi solo le pagine di event_date, region e revenue necessarie per la query. Le altre colonne condividono le stesse righe, ma non devono essere decodificate. La struttura a livello di file e di colonna di Parquet fornisce il layout dei metadati che rende possibile questo accesso selettivo.
Cosa controlla il lettore
Una tipica sequenza di pruning comprende:
Statistiche dei row group: confrontare il filtro con l'intervallo registrato di ciascun column chunk.
Statistiche di pagina: esaminare valori minimi e massimi più granulari all'interno dei row group candidati.
Informazioni del dizionario: risolvere alcuni filtri categoriali a partire dai valori della pagina dizionario.
Bloom filter: verificare le informazioni probabilistiche di appartenenza quando il file le contiene e il lettore le supporta.
Selezione delle colonne: decodificare solo le colonne proiettate necessarie per il risultato.
Il layout dei file determina quanto lavoro il pruning può evitare. Se i valori sono sparsi in ogni pagina, gli intervalli min/max si sovrappongono e il motore ha poco da saltare. Ordinare per una colonna filtrata di frequente può raggruppare valori simili, anche se la disposizione utile dipende dallo scrittore e dal design della tabella.
Il pushdown è inoltre un comportamento del motore, non una promessa che ogni predicato venga gestito in modo identico. I lettori possono limitare il pruning per i tipi annidati o interpretare i tipi logici in modo diverso. Anche il supporto per dizionari e Bloom filter può variare. Per indicazioni più ampie su come ottimizzare le query SQL, collegate il comportamento dello storage al piano di esecuzione della query.
La regola operativa è semplice: Parquet non rende veloce ogni query. Rende più economiche le query selettive quando il layout dei file e i metadati supportano il pruning.
Parquet vs CSV, JSON e ORC
Il formato giusto dipende dal compito. CSV e JSON funzionano bene come formati di interscambio perché le persone possono esaminarli, le applicazioni possono produrli facilmente e le API li accettano comunemente. Le scansioni analitiche ripetute ne evidenziano i limiti: i valori sono memorizzati come testo e i lettori di solito analizzano i record uno per uno.
Parquet fa un compromesso diverso. Memorizza dati tipizzati in un layout binario, compresso e orientato alle colonne, così un motore può leggere solo le colonne necessarie per una query. Questo lo rende un'ottima scelta predefinita per lo storage analitico, ma lo rende scomodo da aprire in un editor di testo o da inviare direttamente a un consumatore che si aspetta JSON.
Qui conta la pipeline di encoding. Parquet può codificare insieme valori simili, applicare tecniche di dizionario o run-length dove opportuno e quindi comprimere le pagine risultanti. CSV e JSON di solito lasciano al lettore una parte maggiore di parsing e di inferenza dei tipi. ORC segue un modello colonnare simile ed è il confronto più vicino, soprattutto negli ambienti orientati a Hive.
Parquet è supportato direttamente da strumenti come Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena e Redshift, come descritto nella documentazione Apache del formato. Il nucleo condiviso migliora la portabilità, anche se non garantisce un comportamento identico per ogni tipo logico, struttura annidata o funzionalità dei metadati.
Parquet vs CSV vs JSON vs ORC
Formato | Archiviazione | Velocità delle query | Evoluzione dello schema | Uso ideale |
|---|---|---|---|---|
Parquet | Binario compatto e orientato alle colonne | Ottima per scansioni analitiche selettive | Supporta schemi tipizzati e modifiche strutturali compatibili | Data lake moderni e analytics |
CSV | Testuale e orientato alle righe | Onerosa per scansioni ampie o ripetute | Informale e definita esternamente | Export semplici e landing zone |
JSON | Testuale, annidato e flessibile | Il parsing può essere costoso su larga scala | Flessibile ma applicata in modo blando | API, eventi e interscambio |
ORC | Binario compatto e orientato alle colonne | Ottima, soprattutto nei carichi di lavoro orientati a Hive | Supporto per schemi tipizzati | Ambienti Hadoop incentrati su Hive |
L'evoluzione dello schema richiede comunque coordinamento. Parquet registra le informazioni sullo schema in ogni file, mentre un sistema di tabelle o un catalogo di solito riconcilia le versioni su un insieme di file. Aggiungere un campo nullable è generalmente più semplice che cambiare il significato o la rappresentazione fisica di un campo esistente. Anche i tipi logici possono produrre risultati diversi quando i lettori li supportano in modo disomogeneo.
Usate CSV o JSON quando l'output serve a persone, API o semplici strumenti di ingestion. Scegliete ORC quando la compatibilità con Hive e uno stack incentrato su ORC determinano il formato. Scegliete Parquet per i data lake analitici moderni e lo scambio di dati tra motori, quindi testate i lettori, gli scrittori e i tipi logici specifici nel vostro ambiente.
Interoperabilità, sicurezza e compromessi reali
L'ampia adozione di Parquet può creare l'impressione fuorviante che ogni motore legga ogni file in modo identico. Spark, DuckDB, Trino, BigQuery, Athena e Polars concordano in genere sul layout di base, ma possono divergere su tipi annidati, tipi logici come UUID e JSON, precisione decimale, page index e significato delle statistiche nel footer.
Questo crea una modalità di guasto concreta: uno scrittore produce un file valido, mentre un altro lettore non supporta la particolare funzionalità utilizzata. Il file può aprirsi correttamente in uno strumento e fallire, degradare un tipo o ignorare un'ottimizzazione in un altro. La pagina sullo stato delle implementazioni di Apache rende esplicita questa disomogeneità. Mostra set di funzionalità diversi tra le implementazioni, con Parquet Java arrivato alla 1.16.0 nel settembre 2025, mentre Arrow Rust, Hyparquet, DuckDB e Polars seguono versioni di funzionalità differenti.
Il supporto dei motori è una questione di compatibilità
Motore | Tipi annidati | Uso delle statistiche | Patch CVE-2025-30065 |
|---|---|---|---|
Spark | Supporto ampio, dipendente dalle funzionalità | Usa le statistiche e i percorsi di pruning supportati | Verificate la dipendenza Parquet distribuita |
DuckDB | Ottimo supporto analitico, dipendente dalle funzionalità | Usa i metadati di file supportati | Verificate la build distribuita e le dipendenze |
Trino | Ampio supporto tramite connettori | Il comportamento dipende dal connettore e dalla versione del lettore | Verificate la dipendenza distribuita |
BigQuery | Legge Parquet direttamente | Comportamento gestito dal servizio | Verificate le indicazioni attuali del servizio |
Athena | Legge Parquet direttamente | Supporta le funzionalità di pruning previste nelle configurazioni di tabella applicabili | Verificate le indicazioni attuali del servizio |
Polars | Legge Parquet tramite la propria implementazione | Il supporto delle funzionalità varia in base alla versione | Verificate la dipendenza distribuita |
La sicurezza merita la stessa attenzione dell'interoperabilità. Ad aprile 2025, la vulnerabilità critica di deserializzazione CVE-2025-30065 ha interessato la libreria parquet-java. Le indicazioni di sicurezza invitavano i team ad aggiornare a Parquet 1.15.1 e a evitare file non attendibili, come riportato nelle indicazioni Apache su implementazione e sicurezza.
Questo cambia la risposta alla domanda “Posso leggere in sicurezza qualsiasi file Parquet con qualsiasi strumento?”. No. Trattate i file provenienti da upload non attendibili o da terze parti come input ostili. Applicate le patch alla libreria pertinente, isolate i lettori dove opportuno, evitate di accettare ciecamente schemi remoti e verificate i metadati opzionali e il comportamento dei page index prima di abilitare funzionalità aggressive. Un lettore in sandbox può ridurre il raggio d'impatto, ma non sostituisce la gestione delle dipendenze.
I costi dietro la comodità
Parquet comporta anche compromessi non legati alla sicurezza:
Aggiornamenti frequenti: i file analitici immutabili possono generare write amplification quando i record cambiano spesso.
File piccoli: molti oggetti minuscoli aumentano l'overhead di listing, apertura e metadati nell'object storage.
Schemi ampi: i metadati del footer possono crescere in modo significativo quando i file contengono molte colonne e row group.
Debugging: i file binari corrotti sono più difficili da esaminare rispetto a un CSV malformato.
Lacune dei motori: una funzionalità supportata da un'implementazione può essere ignorata o rifiutata da un'altra.
I team devono inoltre tenere conto dei requisiti di residenza dei dati nella scelta di posizioni di storage, lettori e percorsi di elaborazione. Parquet migliora lo storage fisico e i modelli di accesso, ma da solo non risolve governance, isolamento o controllo normativo.
Consigli pratici per i carichi di lavoro analitici
Una configurazione Parquet affidabile parte dal layout dei file anziché dalla regolazione dei codec. Per molti carichi di lavoro analitici in cloud, puntate a row group di circa 128-256 MB e a pagine vicine a 1 MB, come mostrato in questo playbook di ottimizzazione di Parquet. Sono punti di partenza, non garanzie. Fate dei test con il motore, l'object store e le tipologie di query che il vostro team utilizza.
Una checklist pratica per il layout
Scegliete i row group con cognizione di causa: bilanciate le letture mirate con l'overhead dei metadati e il comportamento delle richieste all'object store.
Mantenete pagine di dimensioni moderate: una dimensione di pagina vicina a 1 MB è una baseline sensata per la compressione e il filtraggio a livello di pagina.
Ordinate le colonne di filtro utili:
event_timeeuser_idpossono trarne vantaggio quando le query filtrano in modo selettivo e i valori si raggruppano all'interno delle pagine.Evitate ordinamenti indiscriminati: l'ordinamento aggiunge lavoro in scrittura, quindi date priorità alle colonne che compaiono nei predicati importanti.
Partizionate a grana grossa: le partizioni per data o categoria sono spesso più facili da gestire rispetto a chiavi ad alta cardinalità che creano un numero eccessivo di directory.
Compattate i file piccoli: una tabella con molti oggetti Parquet minuscoli può avere prestazioni scadenti anche quando ogni file è di per sé ben formato.
La compressione deve seguire il carico di lavoro. Snappy è una scelta ragionevole orientata alla velocità. ZSTD è utile quando conta la riduzione dello spazio di archiviazione e c'è capacità di CPU disponibile. GZIP può restare appropriato per la compatibilità con sistemi legacy, ma raramente è la prima scelta per l'analytics interattiva quando sono supportati codec più veloci.
Parquet non è la risposta giusta per ogni dataset. Una piccola tabella di riferimento di pochi megabyte può essere più facile da distribuire come CSV o da archiviare in un piccolo database. Il formato si ripaga quando scansioni analitiche ripetute, selezione delle colonne, compressione ed elaborazione distribuita superano il costo degli strumenti binari e della gestione dei file.
Considerazioni su governance e AI
Applicate gli schemi in fase di scrittura, registrate le versioni di scrittori e lettori e testate file rappresentativi su tutti i motori usati dai vostri consumatori. Usate Iceberg o Delta Lake quando vi servono transazioni a livello di tabella, snapshot ed evoluzione gestita dello schema. Parquet resta un utile livello fisico di interscambio tra pipeline di training e feature store, ma non deve essere scambiato per un sistema di governance completo.
Per i team che gestiscono molti dataset Parquet, l'osservabilità dovrebbe coprire più della semplice esistenza dei file. Monitorate modifiche dello schema, tempi di consegna, validazione dei record e metriche di business, affinché un file tecnicamente leggibile non diventi inaffidabile dal punto di vista analitico. digna offre funzionalità in-database di qualità dei dati, tempestività, anomalie, validazione, schema tracking e osservabilità della piattaforma, applicabili mentre i dati restano nell'ambiente del cliente.
Regola di lavoro: ottimizzate il layout dei file per i filtri che i vostri utenti eseguono, quindi validate il risultato in ogni motore che conta.
Se il vostro lake contiene file Parquet ma non riuscite a tracciare facilmente la deriva dello schema, gli arrivi in ritardo o i cambiamenti nel comportamento dei dati, visitate digna per vedere come l'osservabilità in-database può monitorare questi rischi all'interno del vostro ambiente. Iniziate con il modulo che corrisponde al vostro problema di affidabilità più immediato, quindi espandete man mano che crescono i vostri carichi di lavoro di analytics e AI.
Domande frequenti
Che cos'è Parquet?
Un formato di file colonnare per i dati analitici. L'idea chiave è l'organizzazione fisica: i valori della stessa colonna sono memorizzati insieme, così un motore di query può leggere solo le colonne toccate da un calcolo invece di analizzare intere righe in tutto il file.
Perché Parquet è più veloce del CSV per l'analytics?
Per ciò che riesce a saltare. Calcolare una media raggruppata su un grande CSV costringe il motore ad analizzare righe e a esaminare campi che il calcolo non usa mai, mentre il layout colonnare consente di leggere solo le colonne coinvolte, e l'archiviazione tipizzata e compressa riduce anche i byte trasferiti.
Dove si colloca Parquet in uno stack moderno?
Come livello fisico dei file. È un formato di atterraggio efficiente durante l'ingestion, il formato di file principale nell'object storage e il livello alla base di formati di tabella come Iceberg o Delta Lake, pur restando direttamente leggibile da molti motori di query analitici.
Quali carichi di lavoro sono più adatti a Parquet?
Quattro ricorrono spesso: data lake in cloud in cui i file negli object store vengono interrogati senza caricare ogni campo, tabelle dei fatti analitiche lette da Spark, Trino o Presto, export operativi che pubblicano una copia analitica e feature di machine learning scambiate come file tipizzati e compressi invece di CSV o JSON analizzati ripetutamente.
Parquet è un formato da sistema sorgente?
No, di solito è una destinazione di export più che il luogo in cui i dati hanno origine. Applicazioni, API e database operativi restano i sistemi sorgente, e Parquet diventa la copia analitica che questi sistemi pubblicano perché motori di query, BI e ML a valle la utilizzino.



