8 casi d'uso della data observability per dati affidabili
|
9
min di lettura

Il primo guasto in un ambiente dati spesso non è una pipeline andata in crash. È una dashboard che si aggiorna correttamente con dati incompleti, un modello che riceve input strutturalmente validi ma con un comportamento cambiato, oppure un KPI che esce dal suo andamento normale senza che nessuno sia incaricato di indagare. Un sondaggio ampiamente citato ha rilevato che gli incidenti sui dati mensili sono passati da 59 nel 2022 a 67 nel 2023, mentre il 68% degli intervistati ha dichiarato che nel 2023 servivano almeno quattro ore per rilevare un incidente sui dati, rispetto al 62% del 2022. Lo stesso sondaggio ha riportato un aumento del 166% del tempo medio di risoluzione, arrivato a 15 ore per incidente (resoconto di Business Wire sul sondaggio di Monte Carlo).
Questi dati chiariscono lo scopo della data observability. I team devono monitorare comportamento, consegna, struttura, significato di business e operatività della piattaforma dei dati, e poi collegare ogni segnale a un responsabile designato e a un percorso di risposta. Gli otto casi d'uso della data observability che seguono organizzano il lavoro sull'affidabilità in base al guasto che un team deve prevenire. Per ciascuno vengono indicati il ruolo responsabile, il segnale, un incidente tipico, i moduli digna pertinenti e l'azione successiva. digna gira all'interno dell'ambiente del cliente e combina rilevamento delle anomalie, tempestività, validazione, tracciamento degli schemi, monitoraggio del business e osservabilità della piattaforma senza spostare i dati di produzione.
Indice
3. Monitoraggio dei ritardi di consegna delle pipeline e degli SLA
4. Rilevamento delle modifiche di schema e prevenzione delle breaking change
6. Applicazione delle regole di business e validazione della conformità
7. Osservabilità della piattaforma dati e monitoraggio dei consumi
8. Conformità normativa e data governance pronta per l'audit
Trasformate gli alert in un modello operativo per l'affidabilità
1. Rilevamento di dashboard obsolete e non funzionanti
Una dashboard può essere disponibile mentre le decisioni che ne derivano sono già a rischio. Il livello visivo può caricarsi, ma una tabella a monte potrebbe contenere una partizione mancante, una consegna in ritardo o una distribuzione di una metrica che non riflette più l'operatività attuale. Per questo il rilevamento delle dashboard obsolete è uno dei casi d'uso della data observability più diretti per i team di analytics e di business.
Il responsabile principale è di solito l'analytics engineer o lo sviluppatore BI, mentre il data engineer risponde della pipeline a monte. Il segnale combina freschezza, volume, completezza e distribuzione. Un alert su una dashboard dovrebbe indicare quale dataset è in ritardo o incompleto, quale metrica è cambiata e quali report a valle ne dipendono.
Un istituto finanziario potrebbe rilevare che una dashboard giornaliera del rischio non si è aggiornata perché un processo ETL a monte ha consegnato in ritardo. Un team operativo in ambito sanitario potrebbe individuare dati mancanti sui volumi di pazienti prima che le decisioni sul personale si basino su una visione incompleta. Un team di analytics nel retail potrebbe intercettare dati di vendita parziali prima che i dirigenti esaminino i KPI giornalieri.

Il rilevamento deve portare alla diagnosi
I moduli Data Anomalies e Timeliness di digna possono apprendere gli schemi di arrivo attesi e il comportamento delle metriche, segnalando poi caricamenti mancanti, consegne in ritardo e valori insoliti. L'esecuzione in-database mantiene l'analisi all'interno dei database del cliente, mentre la dashboard condivisa offre a ingegneri e stakeholder una vista comune dell'incidente. I team possono usare la guida di digna alla tempestività dei dati per definire i segnali di consegna più importanti.
Iniziate dalle dashboard che influenzano rischio, operatività sanitaria, ricavi o decisioni del management. Inviate gli alert ai responsabili delle pipeline invece di mandare ogni notifica a un gruppo dati generico. Esaminate il comportamento di baseline durante il deployment iniziale, perché un alert utile riflette la cadenza effettiva del dataset e non una pianificazione arbitraria.
Regola pratica: un alert su una dashboard dovrebbe indicare se il guasto riguarda una consegna in ritardo, un volume incompleto o un comportamento cambiato della metrica. Sono condizioni che richiedono indagini diverse.
2. Prevenzione di data shift non rilevati e model drift
Una pipeline può girare senza errori e consegnare comunque dati che non rappresentano più il comportamento atteso da un modello o da un processo decisionale. I cambiamenti di distribuzione sono particolarmente difficili da intercettare con il monitoraggio dello stato dei job, perché l'infrastruttura segnala un successo mentre il contenuto è cambiato.
I ruoli responsabili sono il data scientist, l'ML engineer e il data engineer. Dovrebbero monitorare distribuzioni delle feature, frequenze delle categorie, comportamento dei valori nulli, schemi delle transazioni e altri segnali che descrivono la popolazione in input. L'incidente potrebbe essere una piattaforma e-commerce che osserva un cambiamento nel comportamento d'acquisto che indebolisce le previsioni della domanda, oppure un operatore telecom che nota uno spostamento negli schemi di churn prima che un modello diventi inaffidabile.
I team sanitari potrebbero osservare una variazione inattesa dei tassi di ricovero che richiede un'indagine operativa. I team dei servizi finanziari potrebbero rilevare schemi di transazione insoliti che potrebbero riflettere un problema di pipeline, un vero evento di business o un segnale di frode. L'osservabilità non decide quale spiegazione sia corretta. Accorcia il percorso dal comportamento insolito alla persona in grado di verificare la spiegazione.
Apprendimento della baseline prima delle soglie manuali
Il modulo Data Anomalies di digna applica un apprendimento continuo della baseline al comportamento dei dataset, mentre Data Analytics aiuta i team a esaminare andamenti storici, volatilità e cambiamenti ricorrenti. La risorsa di digna sul rilevamento del model drift è utile quando i team devono collegare le variazioni dei dati al monitoraggio dei modelli invece di trattarle come incidenti separati.
Un alert pratico dovrebbe includere il dataset interessato, il modello o processo decisionale che lo utilizza, il segnale cambiato e il responsabile dell'escalation. Gli ingegneri possono quindi confrontare l'anomalia con le prestazioni del modello, la cronologia dei deployment, le modifiche ai sistemi sorgente o la stagionalità. Se gli alert vengono inviati a una piattaforma di monitoraggio ML, il team può indagare sul drift degli input e sul degrado degli output attraverso un unico percorso di gestione dell'incidente.
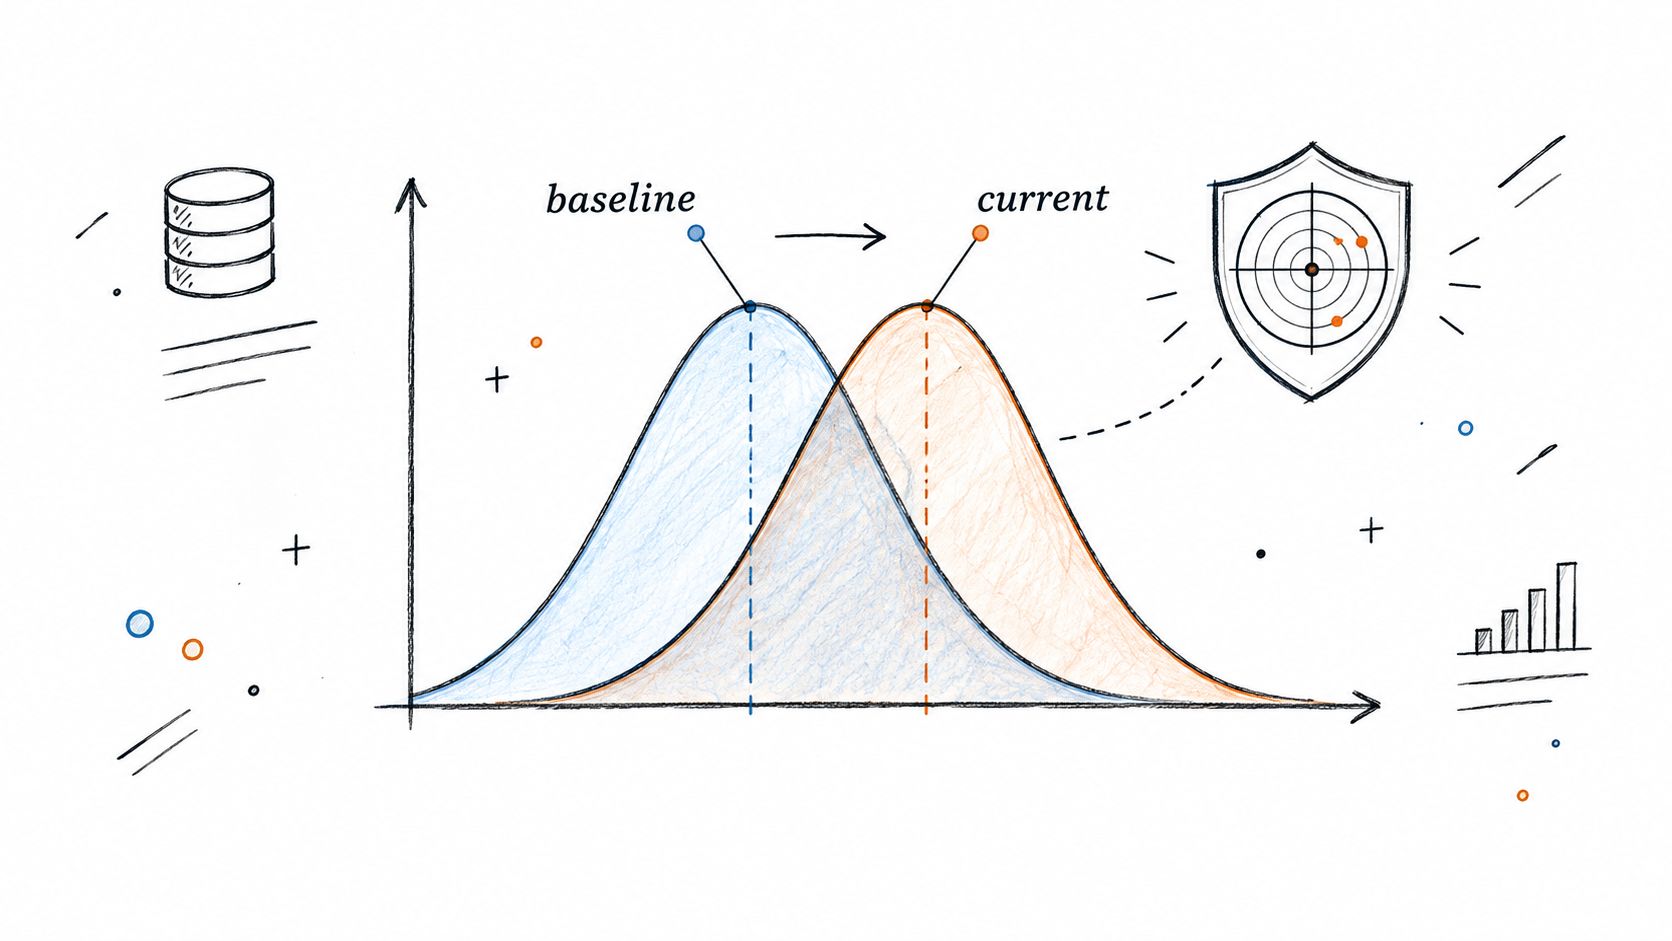
Il rischio strategico non riguarda solo l'accuratezza del modello. Un input cambiato può alterare previsioni, priorità, revisioni antifrode, pianificazione delle cure o trattamento dei clienti prima che qualcuno classifichi l'evento come incidente di modello.
3. Monitoraggio dei ritardi di consegna delle pipeline e degli SLA
I dati in ritardo generano un guasto diverso dai dati errati. Una trasformazione può essere corretta e la sorgente disponibile, ma la tabella arriva dopo il momento in cui il processo di business ne ha bisogno. Questo rende la tempestività un controllo di business, non solo una metrica di ingegneria.
Il responsabile è il data platform engineer o il proprietario della pipeline. Il segnale è l'orario di consegna atteso confrontato con l'arrivo effettivo, supportato da presenza del caricamento, durata dell'esecuzione e cadenza storica. Ad esempio, una tabella che dovrebbe aggiornarsi ogni ora può far scattare un alert quando non si aggiorna da più di 2 ore, trasformando un vago reclamo sui dati in ritardo in una soglia di incidente definita (spiegazione della data observability di DataDriven).
Una banca potrebbe aver bisogno dei dati di rischio notturni prima di una riunione del comitato rischi. Un operatore sanitario può dipendere dai dati giornalieri sui pazienti per le dashboard operative. Un'azienda telecom potrebbe monitorare caricamenti di clienti ad alto volume che supportano il provisioning, mentre un retailer può aver bisogno dei dati di vendita prima della reportistica del mattino.
Trattate la consegna come un contratto operativo
Il modulo Timeliness di digna apprende le pianificazioni e le finestre di consegna attese, quindi segnala ritardi, caricamenti mancanti e consegne anticipate. I team possono usare la risorsa di digna sul monitoraggio delle pipeline dati su AWS quando devono allineare il monitoraggio della tempestività con l'operatività delle pipeline in cloud.
L'azione successiva dovrebbe essere esplicita. Configurate un'escalation quando l'orario di consegna atteso viene superato, inviate l'incidente al proprietario della pipeline e integrate l'alert con la gestione degli incidenti. Analizzate l'andamento degli orari di consegna attesi oltre ai singoli mancati rispetti. Un deterioramento graduale può rivelare problemi di capacità o di dipendenze prima che si verifichi un guasto completo.
Uno SLA di consegna è utile solo quando qualcuno è responsabile della violazione, ne comprende l'impatto a valle e sa quando scalarla.
Il rilevamento individua la finestra mancata. La diagnosi verifica l'orchestratore, il sistema sorgente, la catena di dipendenze e lo stato del caricamento. La risposta può consistere nel rieseguire un job, contattare il responsabile di una sorgente o contrassegnare temporaneamente gli output a valle come non affidabili.
4. Rilevamento delle modifiche di schema e prevenzione delle breaking change
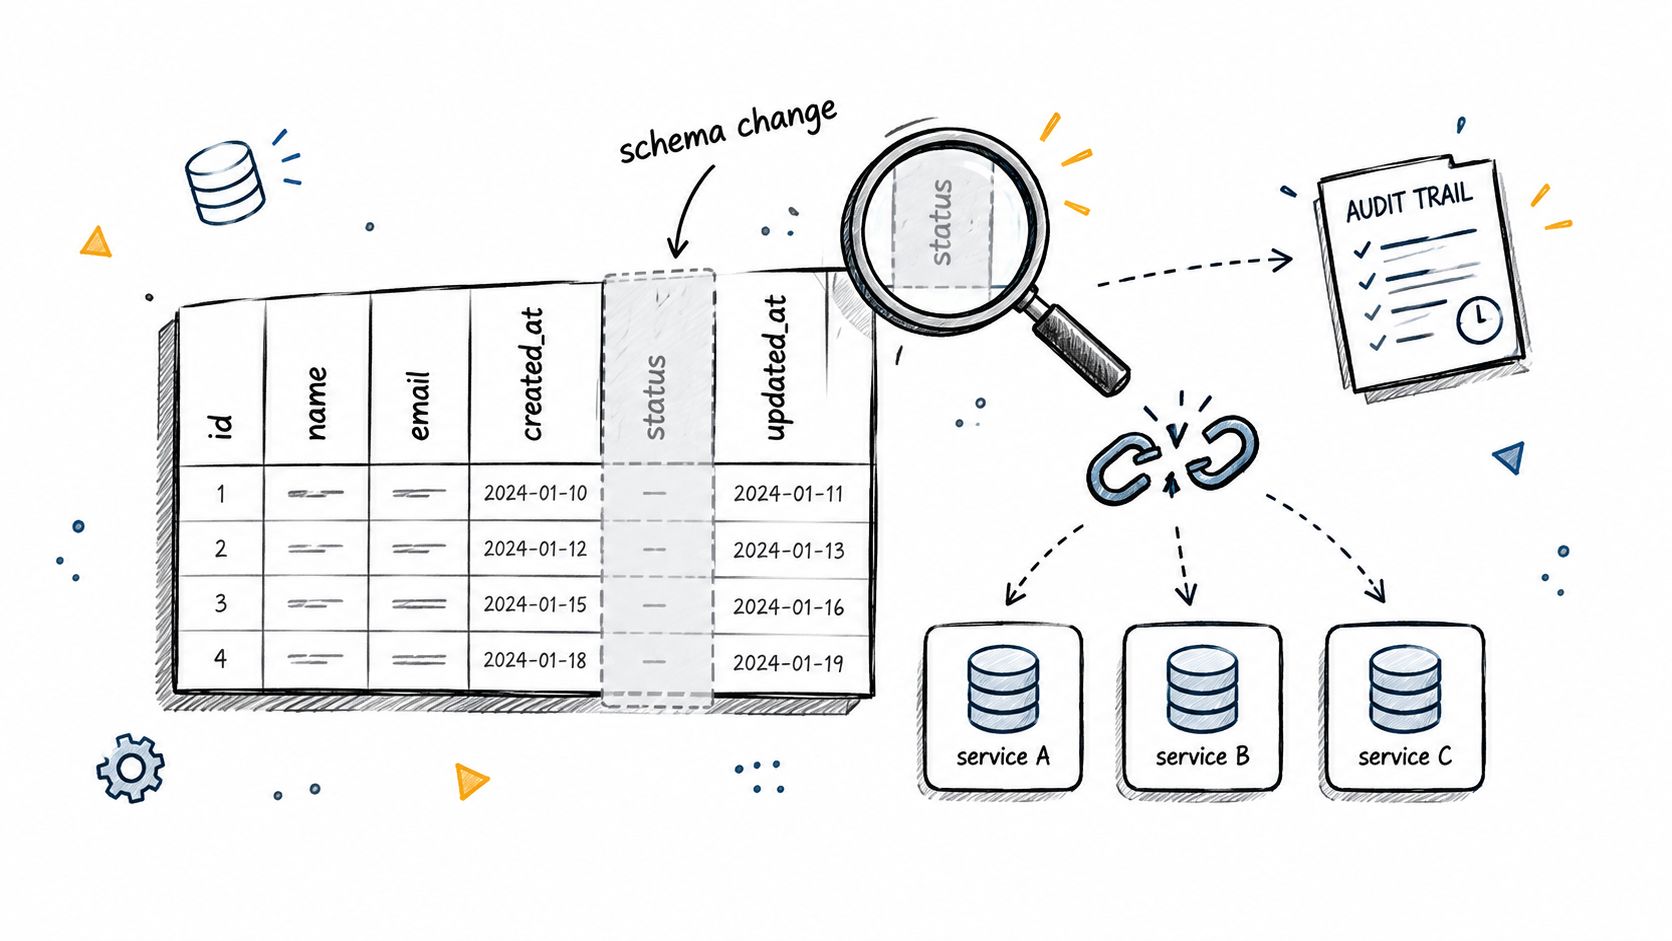
Le modifiche strutturali sono pericolose perché possono rompere i consumatori senza sembrare guasti operativi. Colonne aggiunte, colonne eliminate, campi rinominati, cambi di tipo e passaggi da nullable a non nullable possono causare valori mancanti, conversioni di tipo implicite, trasformazioni fallite o join errati anche quando una pipeline segnala un'esecuzione riuscita (spiegazione di Ataccama su schema e data observability).
Il data engineer o l'analytics engineer è responsabile della risposta, mentre i responsabili dei sistemi sorgente dovrebbero approvare le modifiche intenzionali. Il segnale è il confronto tra lo schema attuale e la struttura attesa. Un incidente tipico potrebbe riguardare un'applicazione sorgente che aggiunge una colonna senza preavviso, cambia un identificativo cliente da stringa a intero o rimuove un campo usato in un calcolo del rischio.
I team IT in ambito sanitario affrontano un ulteriore problema di controllo quando le strutture dei dati clinici evolvono senza una comunicazione chiara. Il problema tecnico immediato può essere una trasformazione fallita, ma il rischio più ampio è la perdita di tracciabilità su quale versione dei dati abbia supportato un report.
Rilevate la modifica prima che la scoprano i consumatori
Schema Tracker di digna monitora continuamente le proprietà strutturali e avvisa i team quando gli schemi cambiano. Il modulo Schema Tracker di digna può supportare un flusso di lavoro in cui i team documentano gli schemi attesi, inoltrano gli alert ai responsabili a valle e verificano se una modifica fosse intenzionale.
La diagnosi richiede più della semplice conferma che una colonna sia cambiata. Gli ingegneri dovrebbero individuare tabelle, trasformazioni, dashboard, modelli e output regolamentari interessati. L'azione successiva può essere aggiornare un contratto, ripristinare la compatibilità, rivedere una trasformazione o approvare formalmente la modifica. Collegate gli alert sugli schemi ai processi di catalogo e di governance, così che le decisioni strutturali non restino in messaggi privati o ticket non documentati.
Un alert sullo schema è quindi un segnale di controllo dell'impatto. Dice al team non solo che una struttura è cambiata, ma che una dipendenza a valle potrebbe ora richiedere una revisione.
5. Monitoraggio dei KPI di business e alert sulle anomalie
I controlli tecnici possono essere superati mentre il risultato di business appare sbagliato. Un data warehouse può ricevere i dati in tempo, mantenere il proprio schema e completare ogni trasformazione, eppure ricavi, valore degli ordini, volume di clienti, churn o esiti dei trattamenti possono uscire dal comportamento atteso.
Il responsabile è il business analyst o lo stakeholder operativo, supportato dall'analytics engineering. Il segnale è una metrica di business confrontata con il suo comportamento storico, la stagionalità, la volatilità e le condizioni rilevanti dei dati. Un'organizzazione retail potrebbe rilevare un calo insolito dei ricavi e avviare un'indagine prima che il problema arrivi a una revisione formale delle performance. Un team telecom potrebbe notare un churn anomalo, mentre un gruppo di servizi finanziari indaga su una variazione del volume delle transazioni che potrebbe riflettere una frode o un problema di sistema.
Affiancate il significato di business al contesto tecnico
La soluzione Business Monitoring di digna applica il rilevamento delle anomalie alle metriche archiviate nel warehouse o nel lake. Il modulo Data Analytics aiuta i team a comprendere andamenti storici, trend e volatilità dei KPI, mentre il sistema di business monitoring di digna offre un percorso mirato per monitorare il comportamento del business.
Iniziate dai KPI che hanno un chiaro responsabile delle decisioni. Definite quale azione segue un alert, ad esempio verificare la completezza della sorgente, convalidare una promozione, rivedere i controlli sulle transazioni o contattare un team operativo. Evitate di trattare ogni variazione come un incidente. La sensibilità dovrebbe riflettere la variazione normale della metrica e la conseguenza di un'anomalia non rilevata.
Test di responsabilità: se nessuno sa indicare la decisione che cambia dopo un alert su un KPI, probabilmente la metrica non è pronta per il monitoraggio continuo.
La diagnosi collega la variazione di business alla qualità dei dati, a eventi nelle sorgenti, a modifiche di prodotto o a un reale comportamento del mercato. La risposta spetta poi al team in grado di correggere la condizione sottostante, non necessariamente a quello che gestisce la dashboard.
6. Applicazione delle regole di business e validazione della conformità
Il rilevamento delle anomalie si chiede se i dati si comportino in modo diverso dalla loro baseline. La validazione si chiede se ogni record soddisfi una regola di business, logica o di conformità nota. Entrambi sono necessari, perché un dataset può apparire statisticamente normale pur violando una condizione obbligatoria.
Il responsabile è di solito il responsabile della data quality, il data steward, il team compliance o l'esperto di dominio. I segnali includono presenza dei campi obbligatori, segmenti validi, intervalli di valori, sequenze di date, integrità referenziale e altri vincoli deterministici. Un team dei servizi finanziari potrebbe verificare che le transazioni contengano i campi obbligatori e restino entro le soglie di conformità. I team sanitari possono controllare che i record soddisfino i requisiti di reportistica prima dell'invio. Gli operatori telecom possono validare i record di fatturazione rispetto alle regole dei piani tariffari, mentre gli enti pubblici possono verificare le condizioni di audit e tracciabilità.
Rendete operative le evidenze di validazione
Il modulo Data Validation di digna esegue controlli a livello di record rispetto a regole di business documentate. I team dovrebbero iniziare dai domini regolamentati o ad alto rischio, coinvolgere gli esperti di dominio nella progettazione delle regole e registrare quali dataset hanno superato o meno i controlli. Il data catalog può offrire una vista condivisa dello stato di validazione e aiutare gli analisti a distinguere i dati idonei all'uso da quelli che richiedono una revisione.
Il rilevamento individua i record che violano una regola. La diagnosi determina se il guasto sia stato causato dalla regola, dalla sorgente, dalla trasformazione o dal processo di business. La risposta può consistere nel mettere in quarantena i record interessati, correggere la sorgente, approvare un'eccezione o documentare la correzione per la revisione di audit.
Le linee guida indipendenti sull'osservabilità delle pipeline sottolineano che il monitoraggio deve valutare la qualità dell'output, inclusi conteggi dei record, variazioni nella distribuzione dei campi e modifiche di schema, invece di basarsi solo sul successo dei job (linee guida sul monitoraggio e sui controlli delle pipeline a livello di dati). Questa distinzione conta negli ambienti sensibili alla conformità, dove un job completato non è una prova sufficiente che l'output sia affidabile o verificabile.
7. Osservabilità della piattaforma dati e monitoraggio dei consumi
I team della piattaforma dati possono ereditare problemi di affidabilità dal comportamento delle risorse più che dal contenuto dei dati. Un picco di carico, una query inefficiente, una pipeline fuori controllo, una tabella inutilizzata o un andamento inatteso dello storage possono ridurre la disponibilità e rendere meno prevedibile la consegna a valle.
Il ruolo responsabile è il data platform engineer. I segnali includono schemi di carico, volume delle query, capacità di elaborazione, tempo di esecuzione delle pipeline, disponibilità, crescita dello storage e variazioni dei consumi. Un team che gestisce un warehouse in cloud potrebbe trovare tabelle inutilizzate che complicano la gestione dello storage. Un analytics engineer potrebbe individuare query che consumano risorse eccessive e ottimizzarne l'SQL. Un team di piattaforma potrebbe rilevare un consumo anomalo causato da una pipeline fuori controllo.
Monitorate l'infrastruttura dietro i dati
La soluzione Data Platform Observability di digna si concentra su salute, comportamento, consumi e modifiche operative della piattaforma. Il modulo Data Analytics può aiutare i team ad analizzare l'andamento delle metriche di piattaforma e a distinguere un picco isolato da un problema di capacità in via di sviluppo. Condividete le dashboard della piattaforma con i consumatori dei dati, così che gli ingegneri non siano gli unici a vedere le conseguenze di un uso inefficiente.
L'azione successiva dipende dal segnale. Un'anomalia in una query può richiedere un'ottimizzazione dell'SQL. Un andamento dello storage può richiedere una gestione del ciclo di vita o una revisione delle responsabilità. Una variazione nell'esecuzione di una pipeline può richiedere un'analisi della capacità, un'indagine sulle dipendenze o una modifica della pianificazione. Stabilite baseline di carico normali, inviate gli alert gravi ai responsabili della piattaforma e usate i trend di consumo per orientare la pianificazione dell'infrastruttura.
Questo caso d'uso mette in luce anche un problema di priorità. Un sondaggio sull'osservabilità del 2025 ha rilevato che solo il 13% della telemetria raccolta veniva usato attivamente per monitoraggio, alerting o troubleshooting, mentre l'84% delle aziende usava meno di un quarto di ciò che raccoglieva (report sull'osservabilità di Sawmills AI). Più telemetria non crea automaticamente più affidabilità. I team devono selezionare segnali che portino a una decisione.
8. Conformità normativa e data governance pronta per l'audit
Le organizzazioni regolamentate hanno bisogno di qualcosa di più di una dashboard pulita il giorno in cui un auditor chiede delle evidenze. Hanno bisogno di una supervisione continua su qualità dei dati critici, validazione, tempestività, modifiche strutturali, responsabilità e storico dei controlli.
I ruoli responsabili sono il responsabile della data governance, il compliance officer, l'internal auditor e il data owner di dominio. I segnali combinano esiti della validazione, stato delle consegne, storico degli schemi, anomalie di qualità dei dati ed evidenze che i controlli abbiano funzionato come previsto. Una banca potrebbe dover dimostrare che i dati per il reporting regolamentare rispettavano i requisiti definiti e sono arrivati in tempo. Un'organizzazione sanitaria potrebbe aver bisogno della tracciabilità dei dati clinici sensibili. Un ente pubblico potrebbe dover dimostrare che i dati critici sono rimasti soggetti a controlli documentati all'interno dell'ambiente richiesto.
Collegate il monitoraggio dei controlli alle evidenze
A questo scopo digna combina Data Validation, Schema Tracker, Timeliness ed esecuzione in-database. Le opzioni di deployment in private cloud o on-premises mantengono i dati sensibili all'interno del cloud, della VPC o del data center del cliente. Questa architettura supporta i requisiti di governance nei casi in cui non è accettabile spostare i dati di produzione verso un servizio di monitoraggio esterno.
I team compliance dovrebbero individuare i domini di dati che richiedono una supervisione continua, documentare le regole nella piattaforma di governance e stabilire cicli di revisione ricorrenti. L'azione successiva per ogni alert dovrebbe specificare se il problema richiede una correzione, l'approvazione di un'eccezione, la conservazione delle evidenze o un'escalation. Il registro che ne risulta dovrebbe aiutare un auditor a capire cosa è stato controllato, quando, cosa non ha superato il controllo, chi ha indagato e come ha risposto l'organizzazione.
Il contesto di mercato mostra perché questo sia diventato un tema di piattaforma e non più un compito di qualità circoscritto. Le ricerche stimano il mercato della data observability a 2,94 miliardi di USD nel 2025 e prevedono 6,02 miliardi di USD entro il 2030, pari a un CAGR del 15,4%, con il Nord America generalmente indicato come mercato più grande e l'Asia-Pacifico come regione in più rapida crescita (report di mercato di The Business Research Company). L'adozione si diffonde perché governance, affidabilità e responsabilità operativa si sovrappongono sempre di più.
Per un'ulteriore prospettiva sulla costruzione di controlli di privacy e conformità, consultate gli approfondimenti di Nexus IT Group.
Data observability: 8 casi d'uso a confronto
Caso d'uso | 🔄 Complessità di implementazione | ⚡ Risorse e velocità | ⭐ Efficacia attesa | 📊 Risultati chiave / impatto | 💡 Casi d'uso ideali |
|---|---|---|---|---|---|
Rilevamento di dashboard obsolete e non funzionanti | Moderata, richiede un periodo di taratura della baseline AI | Risorse moderate; esecuzione in-database; alert in tempo reale | ⭐⭐⭐⭐ | Meno interruzioni delle dashboard; tempi di risoluzione più brevi per i dati obsoleti | Dashboard critiche, report per il management, finanza, retail, sanità |
Prevenzione di data shift non rilevati e model drift | Alta, richiede dati storici e taratura della sensibilità | Calcolo da moderato ad alto per l'analisi delle distribuzioni; monitoraggio continuo | ⭐⭐⭐⭐ | Rilevamento precoce del drift; protegge le prestazioni dei modelli ML | Previsioni, rilevamento frodi, modelli di churn, pipeline ML |
Monitoraggio dei ritardi di consegna delle pipeline e degli SLA | Moderata, apprende pianificazioni e orari di consegna attesi (EDT) | Risorse da basse a moderate; rilevamento rapido; riduce l'MTTD ⚡ | ⭐⭐⭐⭐ | Rispetto degli SLA; alert tempestivi sulle consegne; meno caricamenti mancati | Job notturni, reportistica con vincoli di tempo, scadenze regolamentari |
Rilevamento delle modifiche di schema e prevenzione delle breaking change | Da bassa a moderata, si definisce uno schema di baseline e poi si eseguono controlli continui | Risorse ridotte; rilevamento immediato delle modifiche strutturali | ⭐⭐⭐⭐⭐ | Prevenzione dei guasti silenziosi; meno tempo di debug; audit trail degli schemi | Sorgenti dinamiche, pipeline ETL, analytics engineering |
Monitoraggio dei KPI di business e alert sulle anomalie | Moderata, richiede la definizione dei KPI e baseline stagionali | Risorse moderate; dashboard per gli utenti; alert tempestivi | ⭐⭐⭐⭐ | Rilevamento delle anomalie con impatto sul business; meno alert fatigue | Monitoraggio dei ricavi, metriche di prodotto, KPI operativi |
Applicazione delle regole di business e validazione della conformità | Alta, definizione iniziale delle regole e manutenzione continua | Risorse da moderate ad alte per i controlli a livello di record; log di audit | ⭐⭐⭐⭐⭐ | Applicazione continua delle regole; evidenze pronte per l'audit; meno errori a valle | Domini regolamentati (finanza, sanità), fatturazione, reporting di conformità |
Osservabilità della piattaforma dati e monitoraggio dei consumi | Alta, integra metriche di piattaforma e baseline di carico | Risorse moderate; telemetria continua; consente l'ottimizzazione dei costi | ⭐⭐⭐⭐ | Pianificazione della capacità; risparmi sui costi; individuazione dei colli di bottiglia | Warehouse in cloud, team di piattaforma, modelli di chargeback |
Conformità normativa e data governance pronta per l'audit | Molto alta, integrazione tra moduli e allineamento con la governance | Elevato impegno di risorse e processi; deployment in-database e privati | ⭐⭐⭐⭐⭐ | Evidenze pronte per l'audit; minore rischio di non conformità; sovranità dei dati | Banche, sanità, settore pubblico, flussi di reporting regolamentare |
Trasformate gli alert in un modello operativo per l'affidabilità
Gli otto casi d'uso della data observability diventano utili quando un team li adotta in un ordine che rispecchia il rischio di business. Iniziate da dataset critici e segnali di consegna. Se i team non sanno se le tabelle essenziali sono arrivate o se le dashboard sono complete, il monitoraggio delle anomalie e dei KPI produrrà sintomi confusi invece di incidenti gestibili.
Aggiungete poi il rilevamento delle anomalie comportamentali e il monitoraggio degli schemi. Questi controlli affrontano i guasti che i controlli sullo stato dei job non vedono, tra cui cambiamenti di distribuzione, valori mancanti e modifiche strutturali. Negli ambienti che dipendono dall'AI questa base è sempre più importante. Nel 2025 l'adozione del monitoraggio dell'AI è passata dal 42% al 54% delle organizzazioni, mentre il 73% non disponeva ancora di un'osservabilità full-stack e il numero medio di strumenti di osservabilità è sceso da 6 a 4,4 man mano che i team consolidavano le piattaforme (risultati del sondaggio sull'osservabilità di Databahn). L'implicazione pratica è chiara. I team hanno bisogno di un unico flusso di indagine che metta in relazione salute dei dataset, comportamento delle feature, segnali dei modelli e risultati di business.
Estendete quindi la copertura a validazione, KPI di business, consumi della piattaforma ed evidenze regolamentari. La validazione protegge le regole note. Il business monitoring protegge le decisioni. L'osservabilità della piattaforma protegge l'infrastruttura che consegna e serve i dati. Il monitoraggio della governance trasforma l'attività operativa in evidenze che i team di compliance e audit possono esaminare.
Ogni alert dovrebbe avere cinque attributi:
Responsabile designato: individuate la persona o il team responsabile dell'indagine.
Gravità: collegate la priorità all'impatto sul business, non solo allo scostamento tecnico.
Segnale di rilevamento: indicate se l'attivazione riguarda freschezza, volume, distribuzione, schema, validazione, comportamento dei KPI o consumi della piattaforma.
Percorso di indagine: collegate l'alert alla sorgente, alla pipeline, alla tabella, alla metrica, al modello o al consumatore a valle da esaminare.
Percorso di escalation: definite quando il responsabile deve coinvolgere i team di piattaforma, business, compliance o incident response.
digna supporta questo modello operativo con un licensing modulare, che consente alle organizzazioni di partire da un solo modulo ed espandersi in base alle tabelle attive e alle esigenze di monitoraggio. L'esecuzione in-database e le opzioni di deployment in private cloud o on-premises mantengono i dati di produzione nell'ambiente del cliente. La piattaforma include scheduler, data catalog, integrazioni e funzionalità di collaborazione fin dalla scelta del primo modulo, offrendo ai team di ingegneria e di governance un luogo condiviso in cui esaminare incidenti e trend.
Scegliete i primi asset ponendovi domande pratiche. Quali tabelle alimentano le dashboard o i modelli con le conseguenze più rilevanti? Quali consegne hanno la dipendenza temporale più forte? Quali schemi cambiano senza una comunicazione affidabile? Quali record comportano un rischio regolamentare o finanziario? Quali KPI attivano decisioni operative? Quali carichi di lavoro della piattaforma minacciano la disponibilità o il controllo delle risorse?
Monitorate prima quelle tabelle e metriche. Assegnate il responsabile prima di attivare l'alert. Definite la risposta prima di misurare la copertura. L'affidabilità migliora quando i segnali di osservabilità diventano lavoro gestito, e non l'ennesimo flusso di telemetria che nessuno ha il tempo di usare.
digna offre data observability all'interno del vostro ambiente con rilevamento delle anomalie, monitoraggio della tempestività, tracciamento degli schemi, validazione a livello di record, business monitoring e osservabilità della piattaforma. Visitate digna per valutare come la sua piattaforma modulare e in-database possa collegare questi casi d'uso della data observability a responsabili designati e a percorsi di risposta concreti.
Per il livello di misurazione alla base di questi casi d'uso (freschezza, completezza, stabilità degli schemi, validità e drift delle distribuzioni, e le soglie da inserire in un contratto di consegna) consultate affidabilità della qualità dei dati.
Domande frequenti
Quali sono i principali casi d'uso della data observability?
Otto casi coprono la maggior parte del lavoro sull'affidabilità: rilevamento delle dashboard obsolete, data shift e model drift, ritardi di consegna delle pipeline, rilevamento delle modifiche di schema, anomalie nei KPI di business, validazione delle regole di business, monitoraggio della piattaforma e dei consumi, e governance pronta per l'audit. Ciascuno abbina un segnale a un responsabile designato e a un percorso di risposta definito.
In che cosa la data observability è diversa dal monitoraggio delle pipeline?
Il monitoraggio dello stato dei job segnala che una pipeline è stata eseguita; l'osservabilità si chiede che cosa abbia consegnato. Una trasformazione può riuscire con tre partizioni mancanti, e una colonna rinominata può passare attraverso un percorso di compatibilità mentre il suo tasso di valori nulli cresce. In entrambi i casi la dashboard si aggiorna correttamente.
Da quale caso d'uso della data observability dovrebbe iniziare un team?
Iniziate da dataset critici e segnali di consegna. Se nessuno sa se le tabelle essenziali sono arrivate o se le dashboard sono complete, il monitoraggio delle anomalie e dei KPI produce sintomi confusi invece di incidenti gestibili. Seguono il rilevamento delle anomalie comportamentali e il monitoraggio degli schemi, poi validazione, KPI, consumi della piattaforma ed evidenze regolamentari.
Perché le modifiche di schema causano guasti silenziosi?
Colonne aggiunte, eliminate, rinominate o con un tipo cambiato raramente bloccano una pipeline. Causano valori mancanti, conversioni di tipo implicite e join errati mentre l'esecuzione continua a segnalare un successo. Un alert sullo schema è un segnale di controllo dell'impatto, quindi dovrebbe indicare tabelle, trasformazioni, dashboard, modelli e output regolamentari interessati, non solo la colonna.
Che cosa rende gestibile un alert di data observability?
Cinque attributi: un responsabile designato, una gravità legata all'impatto sul business, il segnale di rilevamento, un percorso di indagine verso la sorgente o il consumatore e un percorso di escalation. Il volume da solo non aiuta. Un sondaggio del 2025 ha rilevato che solo il 13% della telemetria raccolta veniva usato attivamente per il monitoraggio o il troubleshooting.


