10 applicazioni della simulazione Monte Carlo nella data strategy
|
9
min di lettura

La simulazione Monte Carlo non prevede un futuro garantito. Converte input incerti in distribuzioni di probabilità, quindi campiona ripetutamente quegli input per mostrare come i risultati potrebbero comportarsi in condizioni diverse. Il metodo è stato sviluppato negli anni '40 da Stanislaw Ulam ed è poi diventato uno standard in finanza, ingegneria, fisica, logistica, sanità, scienze del clima, manifattura e project management. Un articolo fondamentale del 1964 sulla Harvard Business Review firmato da David Hertz ne ha consolidato il ruolo nella finanza aziendale, e i modelli moderni eseguono comunemente migliaia o milioni di prove casuali per applicazioni come il pricing delle opzioni su azioni, il project finance e l'analisi delle opzioni reali (Corporate Finance Institute).
Questo rende il metodo potente, ma anche facile da usare in modo improprio. Una simulazione può elaborare l'incertezza su larga scala e allo stesso tempo produrre indicazioni fuorvianti se i suoi input sono in ritardo, incompleti, anomali, distribuiti in modo errato, correlati nel modo sbagliato o strutturalmente modificati. Le dieci applicazioni della simulazione Monte Carlo che seguono, quindi, non si concentrano solo sul modello. Ciascuna collega la decisione alle condizioni dei dati che determinano se l'output merita fiducia.
Ponetevi quattro domande prima di considerare un risultato pronto per una decisione: Quali variabili richiedono distribuzioni di probabilità? Quali dati storici o in tempo reale supportano tali distribuzioni? Dove potrebbero cedere le ipotesi? In che modo l'osservabilità rileverà input non validi, in ritardo, anomali o strutturalmente modificati prima che distorcano il risultato?
Indice
1. Valutazione del rischio finanziario e modellazione del portafoglio
4. Previsione dei sinistri assicurativi e modelli di pricing
6. Pianificazione della capacità delle reti di telecomunicazione
7. Modellazione dell'impatto ambientale e dei cambiamenti climatici
8. Controllo qualità nella manifattura e previsione del tasso di difettosità
9. Pianificazione del bilancio nel settore pubblico e analisi dell'impatto fiscale
10. Monitoraggio del business e rilevamento delle anomalie nei KPI
1. Valutazione del rischio finanziario e modellazione del portafoglio
In finanza la simulazione Monte Carlo è più utile quando la decisione dipende da molti possibili percorsi di mercato. Gli analisti modellano rendimenti di mercato, tassi di interesse, inflazione e flussi di cassa incerti per l'ottimizzazione del portafoglio, il Value at Risk, l'expected shortfall, la pianificazione del reddito pensionistico, gli stress test, il pricing dei derivati e l'analisi asset-liability (applicazioni finanziarie della simulazione Monte Carlo). I derivati path-dependent richiedono particolare attenzione, perché il loro valore dipende da come evolvono le condizioni e non solo dal risultato finale.
La fiducia nel risultato parte dagli input. Prezzi in ritardo possono creare scenari obsoleti, correlazioni instabili possono rappresentare in modo errato la diversificazione e un tipo di campo modificato può alterare i calcoli senza fermare il modello. Anche i dati storici devono avere sufficiente continuità e coerenza strutturale per supportare le distribuzioni e le relazioni scelte.
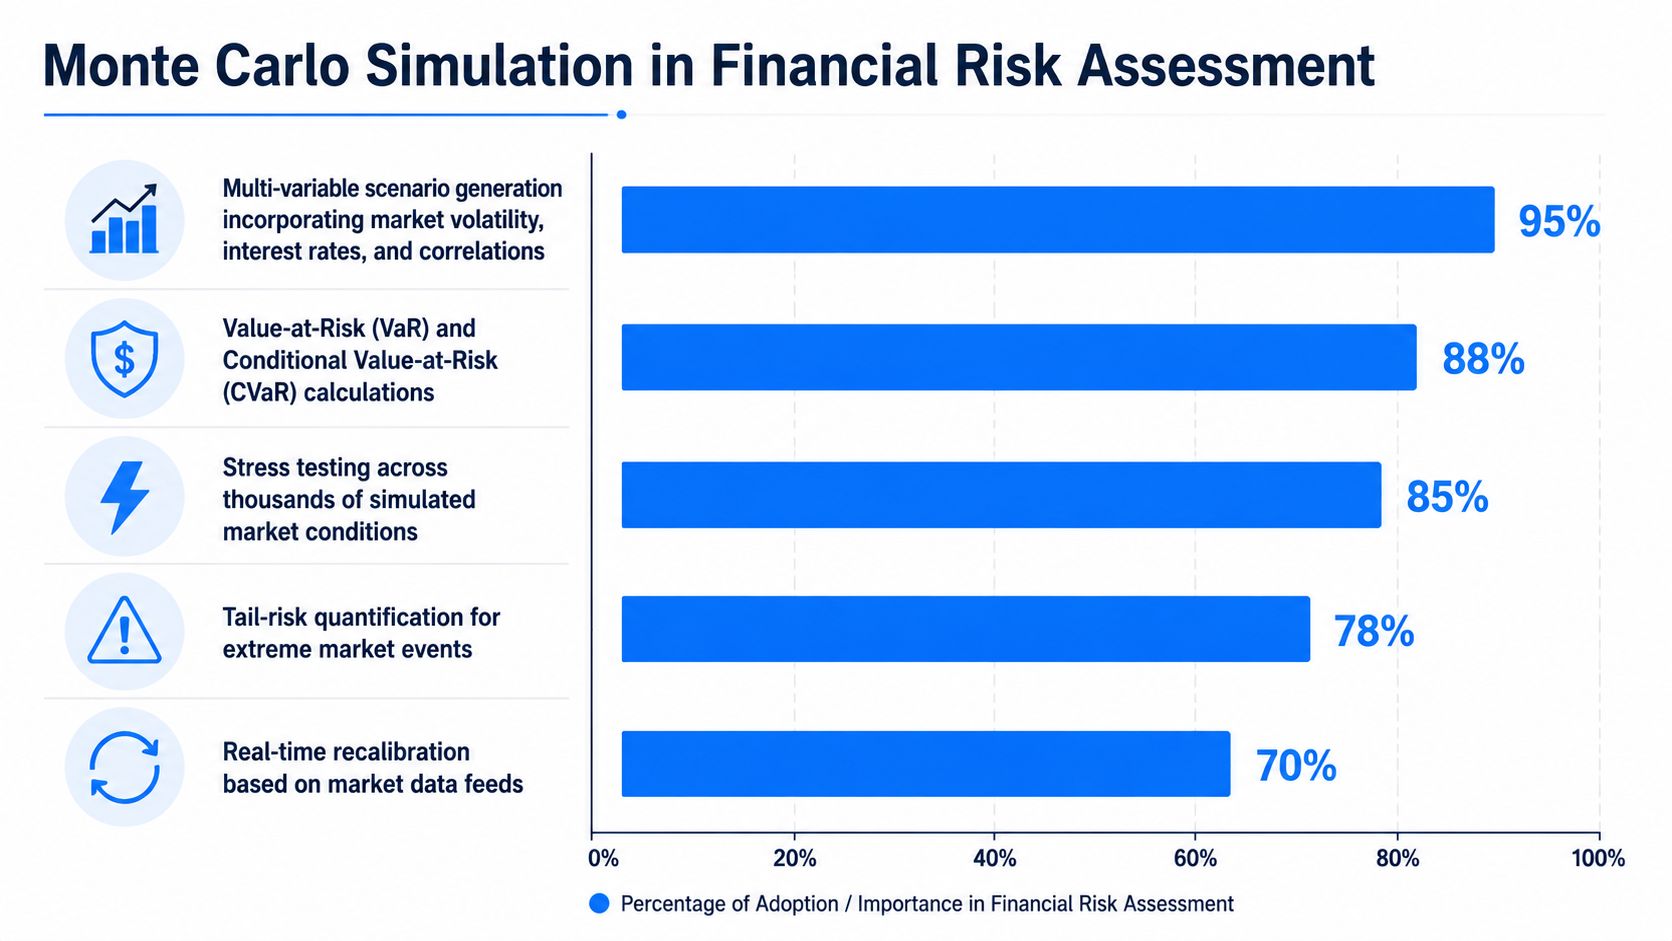
Controlli sui dati che proteggono gli output di rischio
Un workflow pratico di osservabilità dovrebbe:
Validare i record di origine: controllare prezzi, posizioni, esposizioni e classificazioni prima di ogni esecuzione della simulazione.
Monitorare la consegna dei feed di mercato: segnalare osservazioni mancanti o in ritardo prima che valori obsoleti entrino negli scenari correnti.
Confrontare il comportamento atteso con quello osservato: stabilire baseline per le metriche di rischio e indagare movimenti insoliti negli output, incluse variazioni non spiegate dalle condizioni di mercato.
Tracciare la deriva strutturale: rilevare colonne aggiunte, rimosse o con tipo modificato prima che cambino i calcoli a valle.
Per le banche e le altre istituzioni regolamentate, la gestione della qualità dei dati finanziari per le banche collega accuratezza, tracciabilità e controlli di reporting. Lo stesso principio vale per l'analisi AI nella equity research, dove le conclusioni dipendono da dati che restano tempestivi e adatti allo scopo.
L'osservabilità dovrebbe coprire sia gli input del modello sia i segnali di business, come i totali di esposizione, le violazioni dei limiti di rischio e le variazioni nella concentrazione del portafoglio. Questi segnali aiutano gli analisti a distinguere un reale movimento di mercato da un guasto della pipeline o da una deriva delle ipotesi.
Regola pratica: un motore di simulazione stabile non può compensare dati di mercato instabili o ipotesi non documentate.
2. Sviluppo di farmaci e simulazione di studi clinici
La sanità utilizza i metodi Monte Carlo per propagare l'incertezza attraverso percorsi dei pazienti, esiti dei trattamenti, valutazioni economiche e decisioni rischio-beneficio. Una revisione sistematica ha individuato quattro grandi finalità in ambito sanitario: valutazione del rischio per la salute e della relazione dose-risposta, valutazione economica, confronto tra tecnologie o strategie alternative e lavori vari di fattibilità o di revisione della letteratura. Nella revisione queste categorie comprendevano rispettivamente 60, 18, 41 e 23 articoli (revisione sistematica delle applicazioni Monte Carlo in sanità).
I ricercatori clinici possono usare coorti simulate per esaminare come la risposta al trattamento varia in base alle caratteristiche dei pazienti, come un arruolamento incompleto influisce sulle conclusioni di uno studio o come si comportano terapie concorrenti lungo un percorso prolungato. I metodi Monte Carlo sono particolarmente preziosi per l'ottimizzazione delle terapie oncologiche, la medicina personalizzata, la previsione degli esiti delle malattie e la valutazione del rapporto beneficio-rischio. Una revisione in ambito sanitario osserva inoltre che le curve terapeutiche simulate degli antibiotici possono corrispondere strettamente ai risultati sperimentali, mentre la regressione Monte Carlo bayesiana può adattarsi a dataset epidemiologici limitati ma complessi (Monte Carlo nella modellazione delle decisioni sanitarie).
Il rischio legato ai dati ha conseguenze insolitamente gravi. Record dei pazienti mancanti, codifica incoerente degli eventi avversi, segnalazione ritardata degli esiti o una modifica dello schema della cartella clinica elettronica possono cambiare la forma apparente di una distribuzione senza che cambi il codice della simulazione.
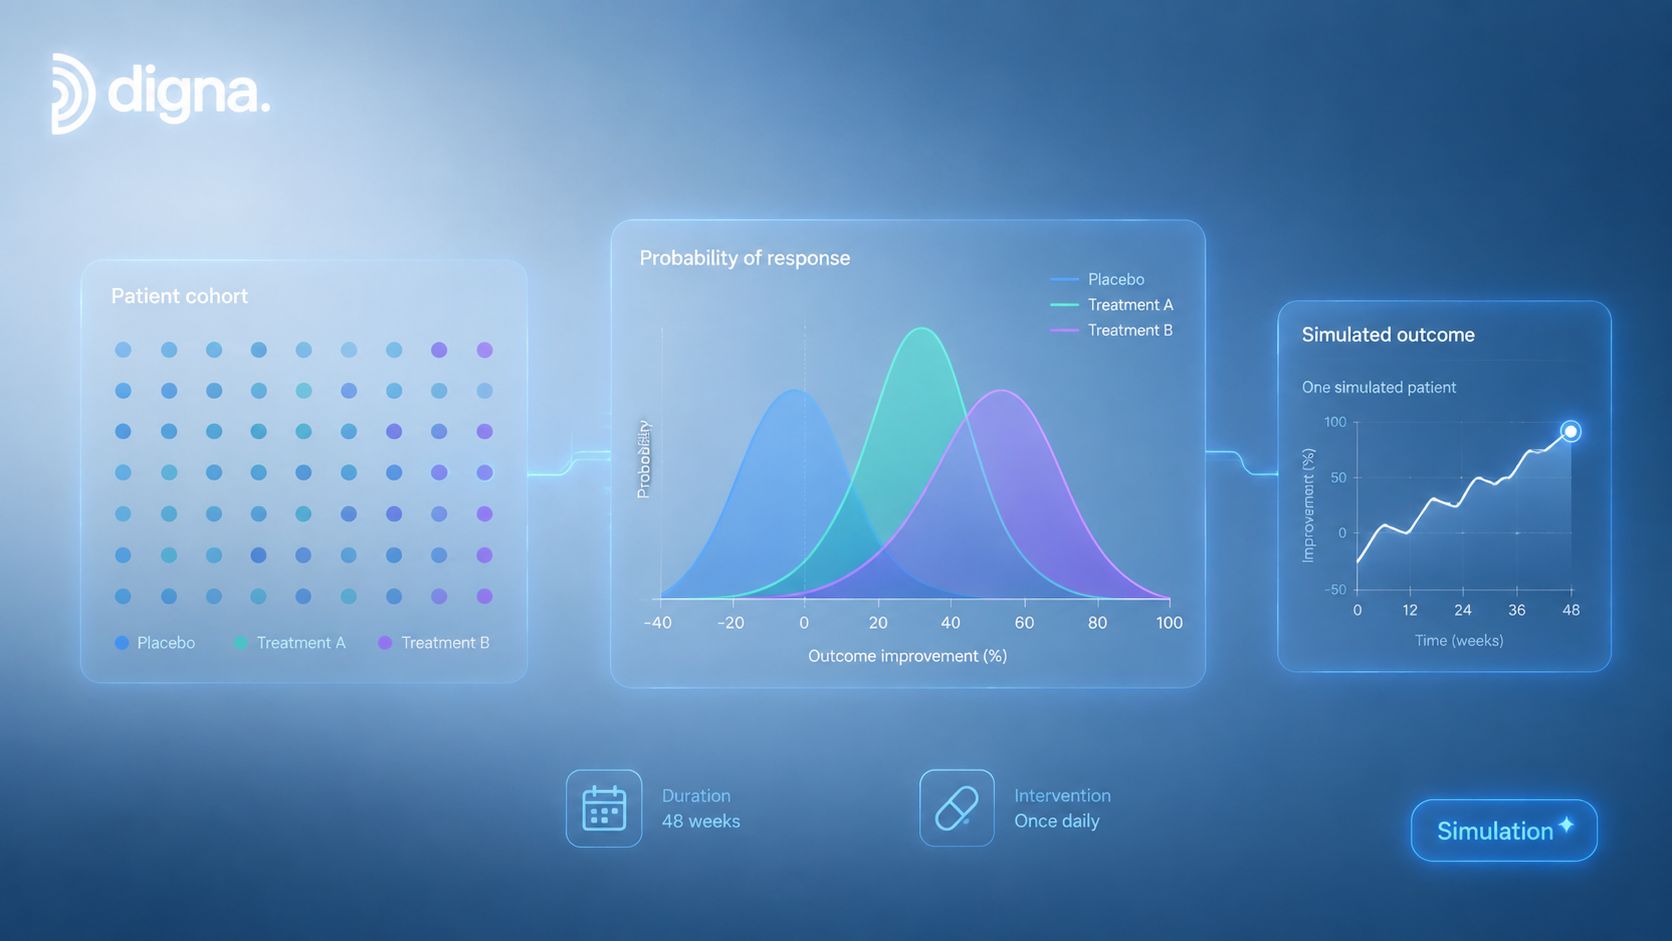
L'affidabilità dipende dalla lineage dei dati clinici
I team sanitari dovrebbero collegare ogni input del modello a controlli che rispondano a queste domande:
I campi obbligatori sono completi? Le regole di validazione possono verificare i record relativi a pazienti, trattamenti, arruolamento ed esiti.
Gli eventi avversi si comportano in modo plausibile? Il rilevamento delle anomalie può far emergere schemi di segnalazione insoliti da approfondire.
Gli esiti arrivano nei tempi previsti? Il monitoraggio della tempestività distingue un cambiamento reale da un ritardo nella segnalazione.
La struttura della sorgente è cambiata? Il tracciamento dello schema può individuare modifiche nei record elettronici prima che le pipeline si interrompano.
È questo lo scopo della validazione dei dati clinici e delle regole normative su larga scala. In questo contesto l'osservabilità non è solo una comodità ingegneristica. Aiuta a preservare la traccia di audit tra i record di origine, l'incertezza modellata e una decisione che può avere effetti sui pazienti o sulle domande regolatorie.
3. Ottimizzazione della supply chain e della logistica
I modelli di supply chain raramente falliscono perché i pianificatori hanno dimenticato che la domanda è incerta. Falliscono perché l'incertezza è stata rappresentata con dati che non descrivono più le operazioni attuali. La simulazione Monte Carlo può combinare domanda variabile, lead time dei fornitori, ritardi nei trasporti, giacenze di magazzino e costi logistici per valutare politiche di scorta e scelte distributive in molte condizioni possibili.
Un team di magazzino potrebbe usare il modello per confrontare strategie di riapprovvigionamento. Un pianificatore logistico potrebbe esaminare come le spedizioni in ritardo dei fornitori interagiscono con picchi di domanda e interruzioni dei trasporti. L'output utile non è un singolo obiettivo di scorta, ma una visione del compromesso tra disponibilità, capitale circolante, rischio di servizio e resilienza operativa.
Monitorate gli input che definiscono la gamma di scenari
I dati di supply chain richiedono controlli in diversi punti:
Validazione dei lead time: verificare che i record di fornitori e vettori contengano valori plausibili e unità coerenti.
Analisi delle anomalie della domanda: indagare variazioni improvvise di previsioni o ordini prima di adattarvi delle distribuzioni.
Tempestività delle consegne: rilevare eventi di spedizione mancanti e conferme tardive che possono far apparire le giacenze attuali più sane di quanto siano.
Tracciamento delle modifiche di schema: monitorare i sistemi logistici e di magazzino per individuare modifiche strutturali che potrebbero rimuovere o reinterpretare campi.
La pipeline nel suo complesso conta quanto il notebook di simulazione. Un'architettura di data pipeline pensata per uno spostamento e una trasformazione affidabili dei dati offre ai team un punto più chiaro in cui monitorare ingestione, trasformazioni e consumo a valle.
Amazon, Walmart e Unilever vengono spesso citate nelle discussioni di settore sulla pianificazione di scorte, stabilimenti e reti basata sulla simulazione, ma la lezione operativa è più generale. Un modello non può dedurre se un aumento del lead time riflette un problema reale del fornitore, una convenzione modificata per i timestamp o un feed in ritardo. L'osservabilità deve rendere visibile questa distinzione prima che i pianificatori agiscano sull'output.
4. Previsione dei sinistri assicurativi e modelli di pricing
La simulazione assicurativa è affidabile solo quanto i dati sui sinistri su cui si basa. I modelli di pricing e di riservazione rappresentano l'incertezza nella frequenza dei sinistri e nella gravità dei sinistri. La simulazione Monte Carlo consente agli attuari di stimare le perdite possibili, verificare l'adeguatezza delle riserve, confrontare ipotesi di pricing ed esaminare l'esposizione in termini di solvibilità in condizioni diverse. Supporta inoltre le analisi catastrofali e asset-liability, dove le medie possono nascondere il rischio di coda (usi del Monte Carlo in finanza e assicurazioni).
La classificazione dei sinistri determina se uno spostamento simulato riflette l'esposizione o un movimento nei dati. Un aumento delle perdite gravi può derivare da un rischio reale, da una modifica nella gestione dei sinistri, da record duplicati o da una codifica rivista. Se gli analisti trattano ogni variazione come un evento di business, l'assicuratore rischia di fissare i prezzi su un difetto dei propri dati di origine.
Distinguete le variazioni attuariali dalle variazioni dei dati
Prima di eseguire simulazioni di pricing o di riservazione, i team dovrebbero:
Validare la completezza dei sinistri: controllare campi obbligatori, relazioni con le polizze, regole di copertura e logica di classificazione.
Indagare gravità insolite: confrontare gli andamenti dei sinistri con l'esposizione e con i dati storici per individuare possibili problemi di qualità dei dati.
Monitorare le scadenze di elaborazione: verificare che le registrazioni dei sinistri e gli adeguamenti delle riserve arrivino in tempo.
Registrare le modifiche di schema: individuare modifiche al sistema sinistri che potrebbero alterare le estrazioni attuariali o le formule a valle.
L'osservabilità dovrebbe collegare questi controlli sugli input ai segnali di business. Un campo di copertura mancante può influire sulla segmentazione, mentre aggiornamenti delle riserve in ritardo possono far apparire le passività correnti più basse di quanto siano. Il monitoraggio dovrebbe quindi mostrare sia la condizione dei dati sia la variazione risultante in pricing, riserve o misure di rischio.
State Farm, Lloyd's of London e Berkshire Hathaway sono associate alla modellazione assicurativa, incluse attività su riserve, catastrofi e pricing. I loro esempi non sostituiscono la validazione locale. Definizioni di esposizione, procedure di gestione dei sinistri e comportamento dei sistemi di origine differiscono da un assicuratore all'altro, quindi una distribuzione adatta a un portafoglio potrebbe non adattarsi a un altro.
Per la soluzione Financial Services di digna il collegamento operativo è diretto. La validazione protegge le regole di business, il rilevamento delle anomalie mette in discussione andamenti imprevisti dei sinistri, il monitoraggio della tempestività fa emergere riserve obsolete e il tracciamento dello schema aiuta a preservare la continuità del modello.
5. Esplorazione petrolifera e del gas e stima delle riserve
Le decisioni sul sottosuolo si basano su una conoscenza incompleta. Geologi e ingegneri usano la simulazione Monte Carlo per rappresentare l'incertezza su dimensioni del giacimento, fattori di recupero, costi di perforazione, comportamento produttivo ed economia del progetto. La distribuzione risultante aiuta i team a valutare stime delle riserve, fattibilità delle perforazioni, scelte di portafoglio e le conseguenze di diverse interpretazioni geologiche.
Un modello delle riserve può essere matematicamente corretto e tuttavia fuorviante dal punto di vista operativo. I dati di interpretazione sismica possono essere rivisti, le misurazioni dei pozzi possono arrivare in ritardo o le letture di produzione possono cambiare perché le apparecchiature si sono deteriorate. Se queste variazioni non vengono distinte dalla variabilità ordinaria, la simulazione può attribuire una probabilità a un problema di misurazione anziché a una possibilità geologica.
Preservate il significato dei dati di campo
Tra i controlli utili:
Validazione delle interpretazioni: verificare gli input sismici e i campi di confidenza rispetto a soglie di qualità definite.
Tempestività dei dati di produzione: segnalare report di pozzo in ritardo o mancanti prima che i modelli di aggiornamento delle riserve utilizzino uno storico incompleto.
Rilevamento delle anomalie di misurazione: indagare andamenti produttivi insoliti che potrebbero indicare problemi alle apparecchiature o errori dei sensori.
Tracciamento dello schema dei log di pozzo: rilevare modifiche strutturali nei sistemi di logging prima che gli strumenti di interpretazione o le estrazioni si interrompano.
Shell, ExxonMobil e Saudi Aramco sono esempi associati all'uso della simulazione nella stima delle riserve, nella valutazione dei progetti e nella pianificazione dello sviluppo dei giacimenti. La loro scala mostra anche perché l'osservabilità debba stare vicino alla piattaforma dati. Gli ambienti operativi di grandi dimensioni producono revisioni frequenti, e un modello ha bisogno di ipotesi versionate e di una lineage degli input visibile se si chiede ai decisori di difenderne gli output.
Il compromesso centrale è tra velocità e rigore. Aggiornamenti più rapidi del modello possono supportare una pianificazione più reattiva, ma solo se i team possono vedere se i nuovi dati sono completi, tempestivi e strutturalmente confrontabili con l'esecuzione precedente.
6. Pianificazione della capacità delle reti di telecomunicazione
Gli operatori di telecomunicazioni usano la simulazione Monte Carlo per esplorare l'incertezza su crescita del traffico, nuovi abbonati, tassi di consumo dati, adozione delle tecnologie e domanda di infrastruttura. Il modello aiuta i pianificatori a confrontare le scelte di investimento nella rete con una gamma di carichi possibili, invece di vincolarsi a un unico percorso di crescita.
Questa applicazione mette in luce una condizione dei dati particolarmente difficile: il comportamento della rete cambia nel tempo. Un andamento del traffico che era normale prima del lancio di un prodotto, di un'interruzione del servizio, di un attacco DDoS o di una migrazione tecnologica potrebbe non costituire più una base stabile per il campionamento futuro. Trattare tutte le osservazioni storiche come intercambiabili può rendere una simulazione precisa ma mal calibrata.
Rendete visibile il cambiamento del comportamento della rete
Un workflow di capacity planning dovrebbe combinare:
Validazione delle misurazioni: verificare le metriche di traffico regionali per completezza, coerenza delle unità e intervalli plausibili.
Tempestività dei feed: rilevare caricamenti analitici in ritardo prima che i pianificatori si affidino a proiezioni di traffico obsolete.
Rilevamento delle anomalie di utilizzo: separare una domanda insolita dei clienti da guasti di rete, attacchi ed errori di misurazione.
Monitoraggio degli schemi di gestione: tracciare le modifiche nei sistemi di rete che potrebbero compromettere le metriche o alterarne il significato.
Verizon, Deutsche Telekom e China Mobile sono esempi associati alla simulazione per la pianificazione di rollout, capacità e crescita degli abbonati. I loro ambienti operativi sono diversi, quindi la domanda di implementazione più importante non è se il Monte Carlo possa essere eseguito, ma se i dati riflettano le stesse definizioni di servizio, la stessa geografia e la stessa logica di misurazione nei periodi messi a confronto.
La soluzione Telecommunications di digna può collegare questi controlli su dati operativi e di clientela ad alto volume. Questo supporta un workflow più difendibile, in cui un alert di capacità include non solo il rischio simulato, ma anche evidenze sulla freschezza e sull'integrità dei record su cui si basa.
Una distribuzione del traffico è utile solo se il team sa quale regime operativo l'ha prodotta.
7. Modellazione dell'impatto ambientale e dei cambiamenti climatici
Le simulazioni climatiche sono credibili solo quanto le condizioni dei dati alla base dei loro intervalli di incertezza. I modelli ambientali combinano osservazioni, parametri, scenari di emissione, risposte fisiche e ipotesi di policy. I metodi Monte Carlo propagano la variabilità attraverso questi input, consentendo ai ricercatori di esaminare una distribuzione di impatti possibili anziché riportare un unico futuro deterministico. Sono utilizzati nelle scienze del clima e in altri campi scientifici per valutare come input incerti influenzino i risultati dei modelli.
Il principale rischio legato ai dati è l'incoerenza strutturale. Sensori ambientali, prodotti satellitari, registrazioni delle stazioni e dataset modellati possono differire per risoluzione, calibrazione, timestamp e definizioni. Se queste differenze non sono documentate, una simulazione può interpretare un cambiamento nel sistema di osservazione come un segnale climatico. Output stabili richiedono quindi sia l'analisi statistica sia controlli su provenienza, versionamento e pre-elaborazione.
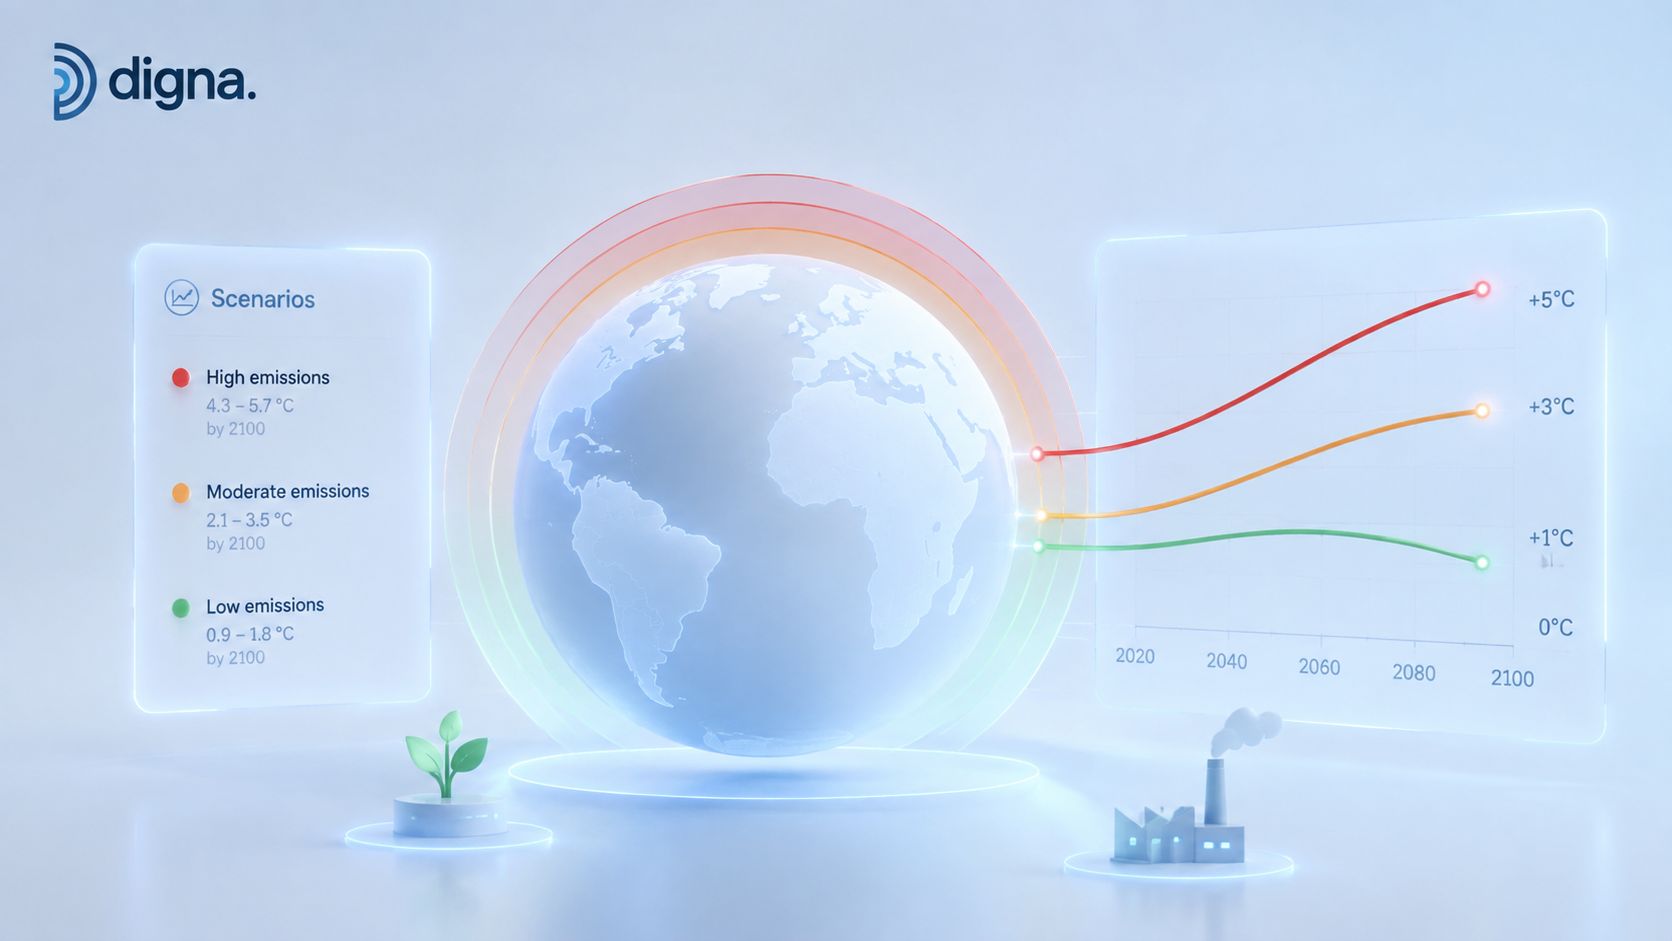
Trattate la provenienza come parte del modello
I team ambientali possono monitorare gli input e le decisioni di business collegate a ogni esecuzione in questi modi:
Validare le osservazioni: verificare la coerenza tra stazioni, periodi, unità e metodi di raccolta.
Monitorare i tempi di arrivo: segnalare feed dei sensori mancanti o in ritardo prima che una finestra temporale incompleta entri in un'esecuzione del modello.
Rilevare anomalie di misurazione: indagare picchi che potrebbero derivare da strumenti, pre-elaborazione o trasmissione anziché da un cambiamento ambientale.
Tracciare la struttura delle pipeline: registrare le modifiche di schema, sorgente e trasformazione nei workflow di dati satellitari e climatici.
I metodi statistici per l'analisi dei dati utilizzati in questi workflow dovrebbero esaminare la volatilità degli input, individuare comportamenti insoliti e conservare le evidenze sui record alla base di ogni risultato. Il monitoraggio dovrebbe anche collegare gli output della simulazione a decisioni come ipotesi di investimento, priorità di adattamento e scenari di policy.
Il lavoro di valutazione dell'IPCC, le analisi del rischio climatico della Banca Mondiale e l'analisi degli scenari climatici utilizzata nelle decisioni di investimento coinvolgono stakeholder diversi, ma condividono un requisito di governance: gli analisti devono separare l'incertezza delle condizioni ambientali dall'incertezza introdotta dalla pipeline dei dati.
8. Controllo qualità nella manifattura e previsione del tasso di difettosità
I team di produzione usano la simulazione Monte Carlo per stimare come la variabilità nelle prestazioni delle macchine, nelle caratteristiche dei materiali, nelle tolleranze, nelle impostazioni di processo e negli esiti delle ispezioni influisca sui tassi di difettosità. Propagare queste distribuzioni attraverso un modello di produzione aiuta gli ingegneri a confrontare strategie di controllo qualità e a verificare l'affidabilità in condizioni operative mutevoli.
Le applicazioni ingegneristiche includono analisi delle tolleranze, progettazione per l'affidabilità, incertezza di misura, analisi degli errori robotici e ottimizzazione della progettazione (applicazioni ingegneristiche dei metodi Monte Carlo). Il metodo è utile perché i difetti possono nascere dalle interazioni tra variabili. Un componente può soddisfare la propria specifica individuale mentre le tolleranze combinate causano un guasto del prodotto finito.
Rilevate la deriva di processo prima che diventi un'ipotesi del modello
I risultati della simulazione dipendono da definizioni stabili e misurazioni tempestive. L'osservabilità della produzione dovrebbe includere:
Validazione dei sensori: confrontare le letture con gli intervalli consentiti e con le relazioni di processo note.
Tempestività delle ispezioni: segnalare report di qualità in ritardo prima che record mancanti nascondano un andamento ricorrente dei difetti.
Rilevamento delle anomalie nei difetti: indagare concentrazioni insolite per linea, turno, macchina, materiale o prodotto.
Tracciamento dello schema: rilevare modifiche nei record di gestione della qualità prima che gli strumenti di analisi interpretino male i campi di ispezione.
Toyota, Intel e Siemens sono associate alla simulazione per l'ottimizzazione della produzione, la resa dei semiconduttori e l'assicurazione della qualità industriale. Questi esempi indicano lo stesso requisito di implementazione: una distribuzione storica dei difetti non basta quando il sistema di misurazione, il processo di ispezione o la definizione del prodotto sono cambiati.
Monitorate insieme gli input del modello e gli output di business. Le anomalie negli input possono spiegare uno spostamento nell'intervallo di difettosità simulato, mentre il monitoraggio degli output può mostrare se i segnali di scarti, rilavorazioni, resa o garanzia si sono discostati dal comportamento consolidato. Questo collegamento aiuta i team qualità a distinguere un reale cambiamento di processo da un problema di dati o di pipeline prima di modificare i controlli di produzione.
9. Pianificazione del bilancio nel settore pubblico e analisi dell'impatto fiscale
I bilanci pubblici combinano entrate, spese, partecipazione, condizioni economiche ed effetti delle politiche, tutti incerti. La simulazione Monte Carlo aiuta le amministrazioni a esaminare come queste variabili interagiscono nei possibili scenari fiscali futuri. Invece di affidarsi a un'unica stima delle entrate o a un'unica ipotesi di partecipazione, i pianificatori possono valutare la gamma dei risultati e i compromessi associati alle scelte politiche.
Questo lavoro comporta un requisito di accountability particolare. I dati su imposte, prestazioni sociali, pensioni e indicatori economici alimentano spesso analisi formali, rendicontazione pubblica e processi di audit. Un periodo di rendicontazione mancante o un campo di ammissibilità modificato possono alterare la distribuzione fiscale apparente lasciando il calcolo tecnicamente eseguibile.
Integrate la verificabilità in ogni input modellato
Le amministrazioni dovrebbero utilizzare:
Validazione basata su regole: applicare la logica di ammissibilità, fiscale, delle prestazioni e di riconciliazione prima di accettare gli input della simulazione.
Monitoraggio della tempestività: tracciare la consegna prevista dei dati su riscossioni, partecipazione ed economia.
Analisi delle anomalie: indagare andamenti insoliti di imposte o pagamenti che potrebbero indicare problemi operativi o di qualità dei dati.
Storico degli schemi: conservare le evidenze quando i sistemi fiscali e delle prestazioni cambiano struttura.
Il Congressional Budget Office, il FMI e la pianificazione pensionistica della California sono esempi associati ad analisi fiscali, del debito o degli obblighi basate sul Monte Carlo. La lezione di fondo non è che ogni amministrazione debba copiare il modello di un'altra istituzione, ma che le decisioni pubbliche richiedono una catena visibile dal record di origine all'ipotesi fino al risultato simulato.
La soluzione Public Sector di digna può supportare questa catena attraverso validazione, monitoraggio della tempestività, rilevamento delle anomalie e monitoraggio degli schemi. Questi controlli non decidono quale politica sia la migliore. Aiutano i decisori a capire se le evidenze a sostegno di ciascuna opzione sono complete, aggiornate e strutturalmente stabili.
10. Monitoraggio del business e rilevamento delle anomalie nei KPI
La simulazione Monte Carlo può supportare il monitoraggio del business trasformando domanda, efficienza operativa, comportamento dei clienti e condizioni di mercato incerti in intervalli attesi per gli indicatori chiave di prestazione. I team possono quindi confrontare i risultati effettivi con il comportamento modellato e indagare gli esiti che cadono fuori dall'intervallo ritenuto plausibile.
Questa applicazione sposta il Monte Carlo dalla pianificazione periodica all'osservabilità operativa. Un team e-commerce può monitorare ordini e resi. Un team di servizi finanziari può esaminare volumi di negoziazione e spread. Un team SaaS può tenere sotto controllo churn e utilizzo. In ogni caso, l'alert è utile solo se il calcolo del KPI sottostante è corretto e aggiornato.
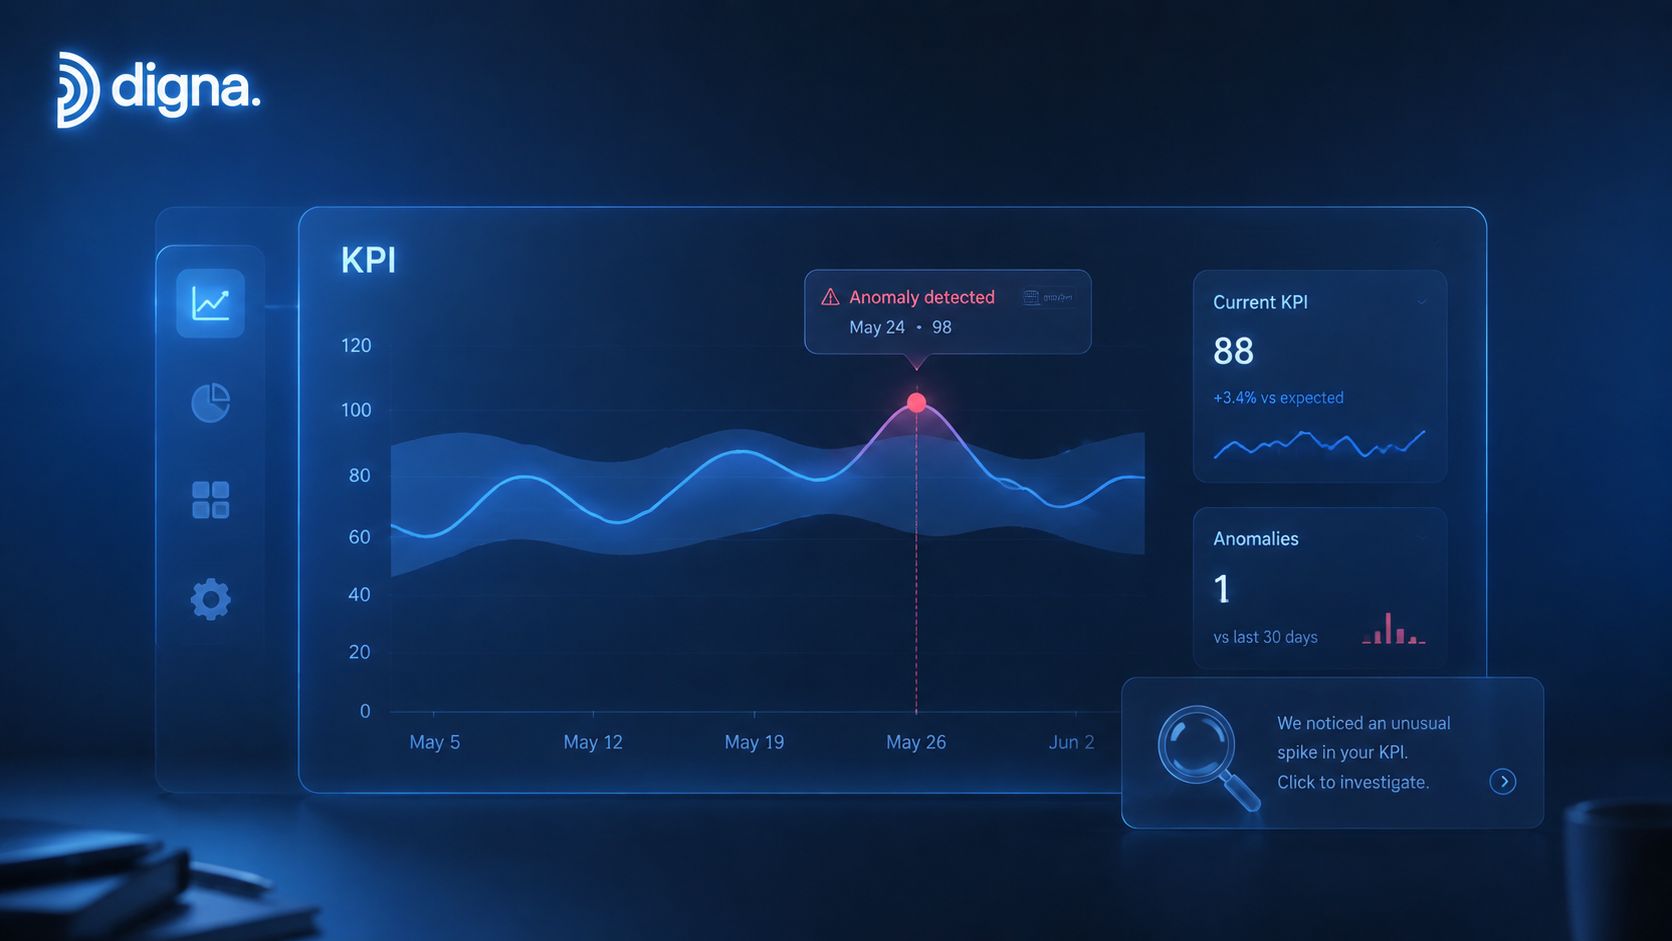
Monitorate sia la metrica sia la sua spiegazione
Un workflow affidabile dovrebbe:
Validare le transazioni: controllare i record usati per calcolare ricavi, ordini, resi, churn o utilizzo.
Monitorare la tempestività dei KPI: inviare un alert quando una metrica arriva in ritardo o un calcolo pianificato non rispetta il suo schema di consegna previsto.
Confrontare i tipi di anomalia: esaminare le anomalie statistiche dei dati insieme alle anomalie dei KPI di business.
Verificare l'impatto strutturale: usare lo storico degli schemi per stabilire se un campo modificato ha alterato la definizione del KPI.
Il rilevamento delle anomalie nelle serie temporali di digna è rilevante per questo modello operativo, perché i team devono distinguere un reale movimento del business da un comportamento dei dati che solo sembra un movimento. Una guida condivisa al reporting delle operazioni di flotta mostra inoltre perché il reporting operativo dipende da processi affidabili di origine e di consegna dei dati.
L'alert più utile non si limita a dire che un KPI è insolito. Aiuta a capire se è cambiato il business, se sono cambiati i dati o se le ipotesi del modello non sono più adeguate.
Simulazione Monte Carlo: confronto tra 10 applicazioni
Applicazione | 🔄 Complessità di implementazione | ⚡ Risorse necessarie | 📊 Risultati attesi | Casi d'uso ideali | ⭐ Vantaggi principali & 💡 consiglio |
|---|---|---|---|---|---|
Valutazione del rischio finanziario e modellazione del portafoglio | Alta, modelli stocastici avanzati e calibrazione | Alte, grande capacità di calcolo, dati di mercato ad alta frequenza, competenze quantitative | VaR/CVaR probabilistici, stress test, stime del rischio di coda | Banche, asset manager, valutazione dei derivati, reporting regolamentare | ⭐ Coglie i rischi non lineari e di coda; supporta la compliance. 💡 Validate la qualità e la tempestività dei dati di input. |
Sviluppo di farmaci e simulazione di studi clinici | Alta, modelli complessi di popolazione e farmacodinamici | Alte, grandi dataset clinici, controlli sulla privacy, capacità di calcolo | Probabilità di successo degli studi, ottimizzazione della dimensione campionaria, riduzione di costi e tempi | R&S farmaceutica, disegno degli studi, giustificazione regolatoria | ⭐ Prevede gli esiti degli studi; abilita disegni adattivi. 💡 Garantite la completezza dei dati clinici e la conformità in materia di privacy. |
Ottimizzazione della supply chain e della logistica | Media–alta, reti multi-nodo e integrazioni | Medie, storico della domanda, feed dei fornitori, impegno di integrazione | Livelli di scorta ottimizzati, costi ridotti, livelli di servizio migliori | Retail, manifattura, 3PL, pianificazione della rete distributiva | ⭐ Riduce i costi di mantenimento delle scorte e individua le vulnerabilità della rete. 💡 Monitorate la qualità dei dati sui lead time dei fornitori. |
Previsione dei sinistri assicurativi e modelli di pricing | Alta, modelli attuariali e controlli regolamentari | Medie–alte, storico dei sinistri, database delle esposizioni, competenze attuariali | Adeguatezza dei premi, stime delle riserve, probabilità di solvibilità | Assicuratori, riassicuratori, pricing delle catastrofi, determinazione delle riserve | ⭐ Allinea il pricing al rischio; convalida le riserve per le autorità di vigilanza. 💡 Validate la completezza dei sinistri e monitorate i picchi anomali. |
Esplorazione petrolifera e del gas e stima delle riserve | Alta, modellazione dell'incertezza geoscientifica e ingegneristica | Alte, dati sismici e di produzione, esperti di dominio, capacità di calcolo | Stime delle riserve P10/P50/P90, distribuzioni del VAN, rischio di portafoglio | Valutazione del portafoglio esplorativo, reporting delle riserve, screening dei progetti | ⭐ Quantifica il rischio esplorativo per l'allocazione del capitale. 💡 Verificate la tempestività e la qualità dei dati sismici e di produzione. |
Pianificazione della capacità delle reti di telecomunicazione | Media, modelli di traffico variabili nel tempo e granularità geografica | Medie, telemetria di rete, dati sugli abbonati, integrazione | Previsioni di capacità, probabilità di congestione, indicazioni sul CAPEX | Operatori mobili e fissi che pianificano rollout 5G e in fibra | ⭐ Ottimizza il CAPEX; individua i colli di bottiglia prima dei disservizi. 💡 Validate le misurazioni del traffico e monitorate la tempestività dei feed. |
Modellazione dell'impatto ambientale e dei cambiamenti climatici | Alta, incertezza multi-modello su orizzonti lunghi | Alte, dataset satellitari e da sensori, ensemble di modelli, capacità di calcolo | Scenari climatici probabilistici, confronti sull'efficacia delle politiche | Scienze del clima, agenzie pubbliche, analisi di finanza sostenibile | ⭐ Quantifica il rischio climatico e i compromessi delle politiche. 💡 Garantite la coerenza dei dati di osservazione tra stazioni e fonti. |
Controllo qualità nella manifattura e previsione del tasso di difettosità | Media, capacità di processo e modellazione di scenari sulle cause radice | Medie, sensori di produzione, dati storici delle lavorazioni, analytics | Previsioni del tasso di difettosità, campionamento ottimizzato, scarti ridotti | Automotive, fab di semiconduttori, linee di produzione discreta | ⭐ Riduce gli scarti e ottimizza i piani di ispezione. 💡 Validate le letture dei sensori e monitorate la tempestività delle ispezioni. |
Pianificazione del bilancio nel settore pubblico e analisi dell'impatto fiscale | Media–alta, progettazione di scenari macroeconomici e ipotesi | Medie, dataset fiscali, di programma e di indicatori economici | Distribuzioni del rischio fiscale, sostenibilità del debito, probabilità di impatto delle politiche | Uffici di bilancio pubblici, analisi di politica fiscale, previsioni pensionistiche | ⭐ Quantifica in modo trasparente i rischi fiscali per le decisioni politiche. 💡 Validate i dati di programma e monitorate le scadenze di rendicontazione. |
Monitoraggio del business e rilevamento delle anomalie nei KPI | Media, baseline di serie temporali e scenari multidimensionali | Medie, dati transazionali e operativi, infrastruttura di monitoraggio | Baseline dinamiche dei KPI, rilevamento più precoce delle anomalie, meno falsi positivi | Operations trasversali ai settori, e-commerce, SaaS, monitoraggio finanziario | ⭐ Rileva prima le anomalie e riduce i falsi alert. 💡 Combinate i modelli di baseline con la validazione dei dati e il tracciamento degli schemi. |
Dagli scenari simulati a decisioni affidabili
In tutte e dieci queste applicazioni della simulazione Monte Carlo emerge lo stesso schema di implementazione. Il modello parte definendo gli input incerti come distribuzioni, collega tali input attraverso una struttura matematica e interpreta gli output come probabilità anziché come garanzie. Ma questo è solo il livello analitico. È il livello operativo a determinare se le distribuzioni descrivono ancora il sistema che si sta gestendo.
Partite dai record di origine. La validazione dei dati dovrebbe confermare campi obbligatori, valori ammessi, relazioni, unità e regole di business prima che gli input raggiungano il modello. Questo vale per posizioni finanziarie, cartelle cliniche, lead time dei fornitori, classificazioni dei sinistri, produzione dei pozzi, traffico di rete, osservazioni climatiche, sensori di fabbrica, dati fiscali e transazioni alla base dei KPI. Una simulazione non ripara un record difettoso: ne propaga l'influenza in ogni scenario risultante.
Verificate poi i tempi di consegna. Un dataset può essere accurato al suo arrivo e tuttavia inutilizzabile per una decisione urgente se arriva dopo l'esecuzione del modello. Il monitoraggio della tempestività dovrebbe apprendere il comportamento di consegna atteso, segnalare caricamenti mancanti o in ritardo e distinguere un ritardo operativo da una normale variazione di calendario. Questo è particolarmente importante quando le simulazioni vengono aggiornate di frequente o quando le decisioni dipendono dalle condizioni attuali.
Monitorate quindi le anomalie sia negli input sia negli output. Un input insolito può rappresentare un evento reale, un errore di misurazione, un duplicato, un difetto di trasformazione o un cambio di regime. Un output insolito può riflettere un reale segnale di business o un calcolo a monte corrotto. Esaminare entrambi i lati offre agli analisti maggiori probabilità di individuare la causa invece di reagire al sintomo.
Infine, tracciate i cambiamenti strutturali. Colonne aggiunte o rimosse, modifiche ai tipi di dato, definizioni cambiate e logiche dei sistemi di origine alterate possono invalidare una pipeline senza produrre un errore software evidente. Il monitoraggio strutturale dovrebbe quindi affiancare il monitoraggio statistico, non seguirlo.
Anche la ricerca evidenzia perché questa disciplina sia importante. Un caso di studio del MIT sulla valutazione del ciclo di vita ha usato la varianza come proxy dell'incertezza e ha rilevato che il suo False Signal/False Error Rate è sceso dal 21% iniziale al 6,1% dopo la risoluzione di 20 parametri, per poi stabilizzarsi al 5,8% dopo la risoluzione di 39 parametri (caso di studio del MIT sulla valutazione del ciclo di vita). Il risultato supporta una conclusione pratica: il perfezionamento iterativo dei parametri incerti può migliorare in modo sostanziale l'affidabilità delle decisioni. Non significa che ogni modello otterrà lo stesso miglioramento.
Conta anche la capacità di calcolo. In un benchmark di Monte Carlo cinetico distribuito, la parallelizzazione ha ridotto il tempo reale normalizzato da 19,7 ore per unità di tempo KMC in un'esecuzione seriale a 1,3 ore su 625 unità di elaborazione, un'accelerazione di circa 15 volte. Un carico di lavoro che in seriale avrebbe richiesto poco più di 1,5 anni è stato completato in 38 giorni (benchmark di Monte Carlo cinetico distribuito). Un'esecuzione più rapida può rendere un modello operativo, ma la velocità non risolve strutture di dipendenza errate o regimi che cambiano.
È questo il problema irrisolto in molte implementazioni moderne. Alcune revisioni segnalano complessità del codice, lunghi tempi di calcolo e dati di tuning limitati nella terapia con particelle (revisione dei vincoli all'adozione del Monte Carlo). Un articolo del 2025 sul rischio di progetto descrive inoltre lacune nell'analisi integrata di costi e tempi, nell'evoluzione giornaliera del rischio e nelle dipendenze esplicite, in cui un evento modifica la tempistica e la probabilità degli eventi successivi (ricerca del 2025 sul rischio di progetto). La lezione controcorrente è importante: spesso la parte più difficile non è eseguire più prove, ma rappresentare correttamente correlazione, dipendenza temporale, evoluzione e cambi di regime.
digna può supportare questo workflow all'interno dell'ambiente del cliente grazie all'esecuzione in-database, al deployment in private cloud o on-premises, a funzionalità di osservabilità modulari e a una dashboard condivisa per ingegneri, analisti e stakeholder. I suoi moduli coprono rilevamento delle anomalie, validazione, tempestività, tracciamento degli schemi, monitoraggio del business e osservabilità della piattaforma, così i team possono partire dal controllo più vicino a un modello critico ed estenderlo man mano che l'utilizzo cresce.
Iniziate da un dataset o da un KPI critico. Documentatene il comportamento atteso, le dipendenze dalle sorgenti, il calendario di consegna, le regole di validazione e le ipotesi strutturali. Poi monitorate insieme input e output prima di estendere lo stesso schema ad altri modelli Monte Carlo.
digna offre data observability all'interno del vostro ambiente, con validazione, monitoraggio della tempestività, rilevamento delle anomalie, tracciamento degli schemi e monitoraggio del business per i dati che alimentano i modelli di simulazione. Iniziate da un dataset o da un KPI critico, poi visitate digna per vedere come la piattaforma può aiutarvi a collegare gli output della simulazione a evidenze operative affidabili.
Domande frequenti
Dove viene effettivamente utilizzata la simulazione Monte Carlo?
In finanza, ingegneria, fisica, logistica, sanità, scienze del clima, manifattura e project management, dopo il suo sviluppo negli anni '40 da parte di Stanislaw Ulam. Questa ampiezza rende il metodo potente ma anche facile da usare in modo improprio, perché lo stesso meccanismo si applica a realtà di qualità dei dati molto diverse.
Che cosa dovreste chiedervi prima di considerare il risultato di una simulazione pronto per una decisione?
Quattro domande, a partire da quali variabili richiedano davvero distribuzioni di probabilità. Le altre riguardano la qualità degli input che le alimentano, le ipotesi incorporate nel modello e quale decisione l'output dovrà effettivamente supportare.
Come si usa il Monte Carlo nel rischio finanziario?
Gli analisti modellano rendimenti di mercato, tassi di interesse, inflazione e flussi di cassa incerti per l'ottimizzazione del portafoglio, il Value at Risk, l'expected shortfall, la pianificazione del reddito pensionistico, gli stress test, il pricing dei derivati e l'analisi asset-liability. La fiducia nel risultato parte dagli input, non dal motore.
Quali controlli sui dati proteggono gli output della simulazione?
Quattro, validi in tutti i settori: validare i record di origine prima di ogni esecuzione, monitorare la consegna dei feed di mercato o di origine affinché valori obsoleti non entrino negli scenari correnti, confrontare il comportamento atteso con quello osservato per le stesse metriche di rischio e tracciare la deriva strutturale prima che colonne aggiunte, rimosse o con tipo modificato cambino il calcolo.
Quanto è diffuso in ambito sanitario?
Abbastanza da essere catalogato. Una revisione sistematica ha raggruppato le applicazioni Monte Carlo in sanità in categorie contenenti rispettivamente 60, 18, 41 e 23 articoli, relativi a percorsi dei pazienti, esiti dei trattamenti, valutazioni economiche e decisioni rischio-beneficio.


