10 alternative a Bigeye per la data observability
|
7
min di lettura

Scegliere un'alternativa a Bigeye basandosi solo sull'anomaly detection ripropone il problema che gli acquirenti cercano di risolvere. La maggior parte delle piattaforme affermate è in grado di individuare comportamenti insoliti in termini di volume, freschezza, schema o distribuzione. Si differenziano molto di più per dove vengono eseguiti i controlli, come i team validano i record, come vengono coperte lineage e pipeline, come gli alert entrano nei workflow operativi, come scalano i prezzi e quanto controllo sull'infrastruttura mantiene il cliente.
Questa distinzione conta perché i team di observability passano ancora molto tempo a reagire dopo che gli utenti si sono imbattuti in dati errati. Un sondaggio tra i responsabili del data management ha rilevato che solo il 7% risolve i problemi dei dati prima che gli utenti ne siano colpiti, mentre il 39% dedica il 20–40% del proprio tempo a correggere problemi nelle pipeline. La stessa ricerca ha rilevato che il 51% impiega alcune ore e il 36% alcuni giorni o più per risolvere un singolo incidente, il che rende prevenzione, velocità di indagine e adeguatezza del deployment più importanti di un lungo elenco di funzionalità. (Sintesi del report Kensu di CDO Magazine)
Il confronto che segue valuta dieci alternative a Bigeye rispetto a criteri enterprise concreti: ubicazione dei dati, copertura delle anomalie, validazione, tempestività, monitoraggio dello schema, deployment, indicazioni sui prezzi e sforzo di migrazione. Associa inoltre ogni opzione alle funzionalità modulari di digna, così i team possono distinguere una suite di observability SaaS ad ampio raggio da una piattaforma in-database progettata per funzionare in private cloud, VPC o on-premises.
Indice
Le 10 migliori alternative a Bigeye: confronto delle funzionalità
Trasformare la shortlist in una decisione di migrazione sicura
1. digna
digna è la scelta più solida quando il controllo del deployment e la residenza dei dati contano quanto la copertura di observability. Funziona all'interno dell'ambiente del cliente, che si tratti di un private cloud, di una VPC o di un data center on-premises, ed esegue il calcolo delle metriche e i controlli all'interno dei database del cliente. Questa architettura mantiene i dati di produzione dove sono, riduce gli spostamenti non necessari e supporta i requisiti di governance per dati sensibili in ambito finanziario, sanitario, delle telecomunicazioni e del settore pubblico. Le indicazioni sul monitoraggio in-database supportano questo modello, perché i controlli possono essere eseguiti dove risiedono i dati invece di copiare altrove record sensibili. (Indicazioni di digna sul monitoraggio della qualità dei dati)
La piattaforma combina il rilevamento automatico con controlli deterministici. Data Anomalies apprende il comportamento normale e individua continuamente i cambiamenti insoliti senza che i team debbano scrivere ogni regola di monitoraggio. Timeliness apprende i pattern di consegna attesi e segnala arrivi mancanti, in ritardo o in anticipo. Data Validation applica regole di business a livello di record, mentre Schema Tracker rileva modifiche strutturali come colonne aggiunte o rimosse e tipi di dati modificati. Data Analytics aggiunge l'analisi storica di trend e volatilità, che aiuta i team a distinguere un evento isolato da un peggioramento dell'affidabilità.
Dove digna è la scelta migliore
Il design modulare di digna permette a un team di iniziare con una funzionalità ed espandersi man mano che il proprio modello operativo matura. Scheduler, data catalog, integrazioni e funzioni di collaborazione sono disponibili fin dalla scelta del primo modulo, e una dashboard condivisa offre a data engineer, analisti e stakeholder una visione comune di incidenti, trend e stato. Il fornitore dichiara che dall'installazione ai primi insight passano meno di due ore, un'affermazione che va comunque verificata rispetto ai permessi, alla topologia dei database e alla revisione di sicurezza dell'acquirente.
Il prezzo prevede un canone base più un costo per tabella attiva e per modulo. Il modello non prevede costi per API, volume di scansione o volume di alert, il che offre al procurement un'indicazione d'uso più chiara rispetto a prezzi che cambiano a ogni query o notifica. Il compromesso è che un numero molto elevato di tabelle può richiedere un dimensionamento accurato, e il deployment privato affida al cliente le responsabilità di infrastruttura, permessi e manutenzione.
Regola pratica: scegliete digna quando mantenere i dati all'interno del vostro ambiente è un requisito prioritario, poi verificate il costo totale in base alle tabelle attive e ai moduli selezionati prima di firmare.
Consultate la piattaforma di data observability di digna per l'architettura e il modello a moduli.
Pro: esecuzione in-database, deployment privato, monitoraggio di anomalie e tempestività basato sull'AI, validazione a livello di record, schema tracking, workflow condivisi e licensing modulare.
Contro: il prezzo per tabella attiva e per modulo richiede un dimensionamento per i grandi patrimoni dati, e il deployment privato richiede una responsabilità operativa interna.
2. Monte Carlo Data
Monte Carlo Data è un'ampia suite di observability per organizzazioni che monitorano warehouse, data lake, sistemi ETL, asset di BI e pipeline di AI o di agenti. I suoi monitor automatici coprono freschezza, volume, schema e distribuzione, mentre l'anomaly detection basata sul machine learning individua gli scostamenti dal comportamento atteso. La lineage a livello di colonna e di dashboard collega gli incidenti agli asset a valle, aiutando i team a valutare l'impatto oltre la tabella interessata.
La piattaforma supporta anche la risposta operativa. Il triage degli incidenti e l'instradamento degli alert verso Slack, Jira e strumenti simili collegano il rilevamento a responsabilità e remediation. Questo rende Monte Carlo un candidato per grandi data stack moderni con molti connettori e workflow consolidati. Gli acquirenti dovrebbero verificare che la lineage raggiunga le colonne, le dashboard e le fasi di pipeline specifiche utilizzate dai loro team.

Il compromesso rispetto al controllo in-database
L'elemento distintivo di Monte Carlo è l'ampiezza operativa. digna adotta un approccio diverso, eseguendo i controlli all'interno dei database del cliente e combinando l'anomaly detection con tempestività, validazione, schema tracking e analisi storiche attraverso un'interfaccia modulare. La decisione dipende quindi dal modello operativo: Monte Carlo è adatto ai team che danno priorità a lineage e copertura dell'ecosistema, mentre digna è adatto ai team che hanno bisogno che i dati restino nel proprio ambiente.
Deployment e migrazione richiedono un proprio proof of concept. I team dovrebbero testare la copertura dei connettori, l'accuratezza della lineage, la responsabilità degli alert, le regole di validazione e lo sforzo necessario per tradurre i monitor Bigeye esistenti. I prezzi di Monte Carlo non sono pubblici, quindi il procurement dovrebbe richiedere un preventivo basato sul perimetro monitorato e sui requisiti di integrazione.
Pro: ampia copertura di connettori, lineage end-to-end, workflow per gli incidenti e perimetro su scala enterprise.
Contro: i prezzi sono su preventivo e l'ampiezza della suite può superare le esigenze immediate di un team più piccolo.
Consultate questa alternativa a Monte Carlo per la data observability enterprise per confrontarne l'architettura e l'approccio modulare con il modello operativo più ampio di Monte Carlo.
3. Acceldata
Acceldata si rivolge ad ambienti eterogenei in cui la qualità dei dati è solo una parte dell'affidabilità. Il suo perimetro comprende piattaforme dati, pipeline, job, costi e prestazioni, inclusi ambienti cloud, on-premises, ibridi, Hadoop e più ampi patrimoni big data. Questo la rende particolarmente rilevante per i team di piattaforma che modernizzano un'infrastruttura legacy senza dover migrare ogni carico di lavoro prima di poter avviare l'observability.
La piattaforma organizza le operazioni attorno a un modello osservare, rilevare, diagnosticare e agire. Nella pratica, gli acquirenti dovrebbero valutare quanto bene questo workflow colleghi i segnali di qualità all'esecuzione delle pipeline, al comportamento della piattaforma, alla governance e all'ottimizzazione. La Data Observability Cloud di Acceldata aggiunge workflow e documentazione strutturati come prodotto, mentre il suo posizionamento ibrido affronta un punto cieco comune negli strumenti cloud-first.
Copertura ampia contro adozione mirata
Acceldata può essere molto adatta a grandi patrimoni dati con più generazioni di tecnologia, ma la sua ampiezza può superare ciò di cui ha bisogno un piccolo team di analytics. I prezzi passano dal team commerciale e non sono pubblici, quindi un proof of concept dovrebbe includere lo sforzo di deployment, i confini di responsabilità e il costo di attivare funzionalità che il team potrebbe non usare subito.
digna affronta la stessa esigenza enterprise attraverso la modularità e l'esecuzione in-database. I suoi moduli Data Anomalies, Timeliness, Data Validation, Schema Tracker e Data Analytics si concentrano sul comportamento e sull'affidabilità dei dati mantenendo i calcoli all'interno dei database del cliente. Acceldata è il candidato più naturale per la shortlist quando prestazioni della piattaforma, infrastruttura e governance devono stare nella stessa vista operativa. digna è più convincente quando il deployment controllato e l'adozione incrementale dei moduli sono i vincoli principali.
Usate gli strumenti di data observability di digna come riferimento quando confrontate l'ampiezza di una piattaforma con un monitoraggio mirato che resta dove risiedono i dati.
Pro: supporto ibrido e on-premises, ampia visibilità sulla piattaforma e combinazione di observability, governance e ottimizzazione.
Contro: il perimetro può essere eccessivo per i team più piccoli e i prezzi richiedono il contatto con il team commerciale.
4. Anomalo
Anomalo è una piattaforma di qualità dei dati AI-native costruita attorno al rilevamento automatico dei problemi con una scrittura minima di regole. Il suo approccio non supervisionato è progettato per individuare comportamenti anomali su dati strutturati, semi-strutturati e non strutturati, per poi supportare l'analisi delle cause alla radice. Questo la rende interessante per i team che vogliono una copertura delle anomalie in tempi rapidi senza mantenere un'ampia libreria di controlli scritti manualmente.
L'attenzione all'ecosistema è evidente. Integrazioni profonde con Databricks, Snowflake e partner di catalogo possono ridurre gli attriti di configurazione quando questi sistemi sono già il fulcro del patrimonio dati. Sono disponibili opzioni di deployment enterprise e accordi sui livelli di servizio, ma l'acquirente deve comunque distinguere l'anomaly detection dal controllo deterministico. Un modello può rilevare che un dataset è cambiato in modo inatteso, mentre una regola critica per il business richiede comunque una condizione di validazione esplicita.
L'anomaly detection non è l'intero livello di controllo
digna copre lo stesso caso d'uso di anomaly detection a bassa configurazione tramite Data Anomalies, ma aggiunge moduli separati per Data Validation, Timeliness e Schema Tracker. Questa separazione è importante per i team che hanno bisogno sia di baseline apprese sia di regole di business verificabili. Un controllo dello schema drift, ad esempio, confronta una struttura in ingresso con uno schema di riferimento o di destinazione e genera un alert quando colonne o tipi di dati cambiano. (Indicazioni pratiche sul rilevamento dello schema drift)
I prezzi di Anomalo non sono pubblici e richiedono il contatto con il team commerciale. Anche le informazioni self-service pubblicate sono più limitate di quelle di alcuni concorrenti SaaS, quindi la pianificazione della migrazione dovrebbe includere una valutazione tecnica, una revisione di sicurezza e un'analisi commerciale, invece di basarsi su una demo del prodotto.
Pro: scrittura minima di regole, onboarding rapido incentrato sulle anomalie, opzioni di deployment enterprise e solide integrazioni con i warehouse.
Contro: i prezzi non sono pubblici e i team potrebbero aver bisogno di controlli aggiuntivi per l'applicazione esplicita delle regole di business e per i requisiti di deployment in-database.
5. Soda
Soda combina un punto di ingresso open source con un prodotto di observability gestito. Soda Core supporta controlli e data contract as code, incluse definizioni basate su YAML e controlli predefiniti, così gli engineer possono inserire la validazione nello sviluppo delle pipeline e nei workflow CI/CD. Soda Cloud aggiunge monitoraggio delle metriche, baseline storiche, anomaly detection, collaborazione e workflow di governance.
Questo doppio modello cambia la domanda sulla migrazione. Un team può iniziare con una CLI e un workflow open source, per poi passare alle funzionalità gestite quando ha bisogno di monitoraggio centralizzato e collaborazione. Questo percorso può ridurre il lock-in, ma l'observability avanzata e la governance restano legate al prodotto gestito Cloud, non al solo livello open source.
Quando conta la titolarità delle regole
Soda è adatta ai team che vogliono che gli engineer esprimano le aspettative di qualità dei dati vicino al codice e all'orchestrazione. È meno direttamente allineata alle organizzazioni che desiderano un monitoraggio appreso di anomalie e consegne senza mantenere ampie definizioni di test. digna offre entrambi gli aspetti con i moduli automatici Data Anomalies e Timeliness, oltre ai moduli espliciti Data Validation e Schema Tracker.
Freschezza e tempestività andrebbero testate separatamente durante la migrazione. La freschezza verifica se i record sono arrivati entro una finestra attesa, mentre la tempestività chiede se i dati sono diventati utilizzabili entro la finestra decisionale. (Indicazioni sui controlli di qualità dei dati enterprise) Questa distinzione può far emergere lacune nascoste da un generico monitor di “freschezza”.
Il listino prezzi pubblico di Soda Cloud non è disponibile, quindi gli acquirenti devono richiedere un preventivo basato su sorgenti, controlli, utenti e perimetro gestito.
Pro: ingresso open source, controlli as code, integrazione nelle pipeline e un percorso chiaro verso l'observability gestita.
Contro: collaborazione e governance avanzate richiedono Soda Cloud, i cui prezzi passano dal team commerciale.
Confrontate i modelli operativi in questa alternativa a Soda per la qualità dei dati enterprise.
6. Metaplane, ora parte di Datadog
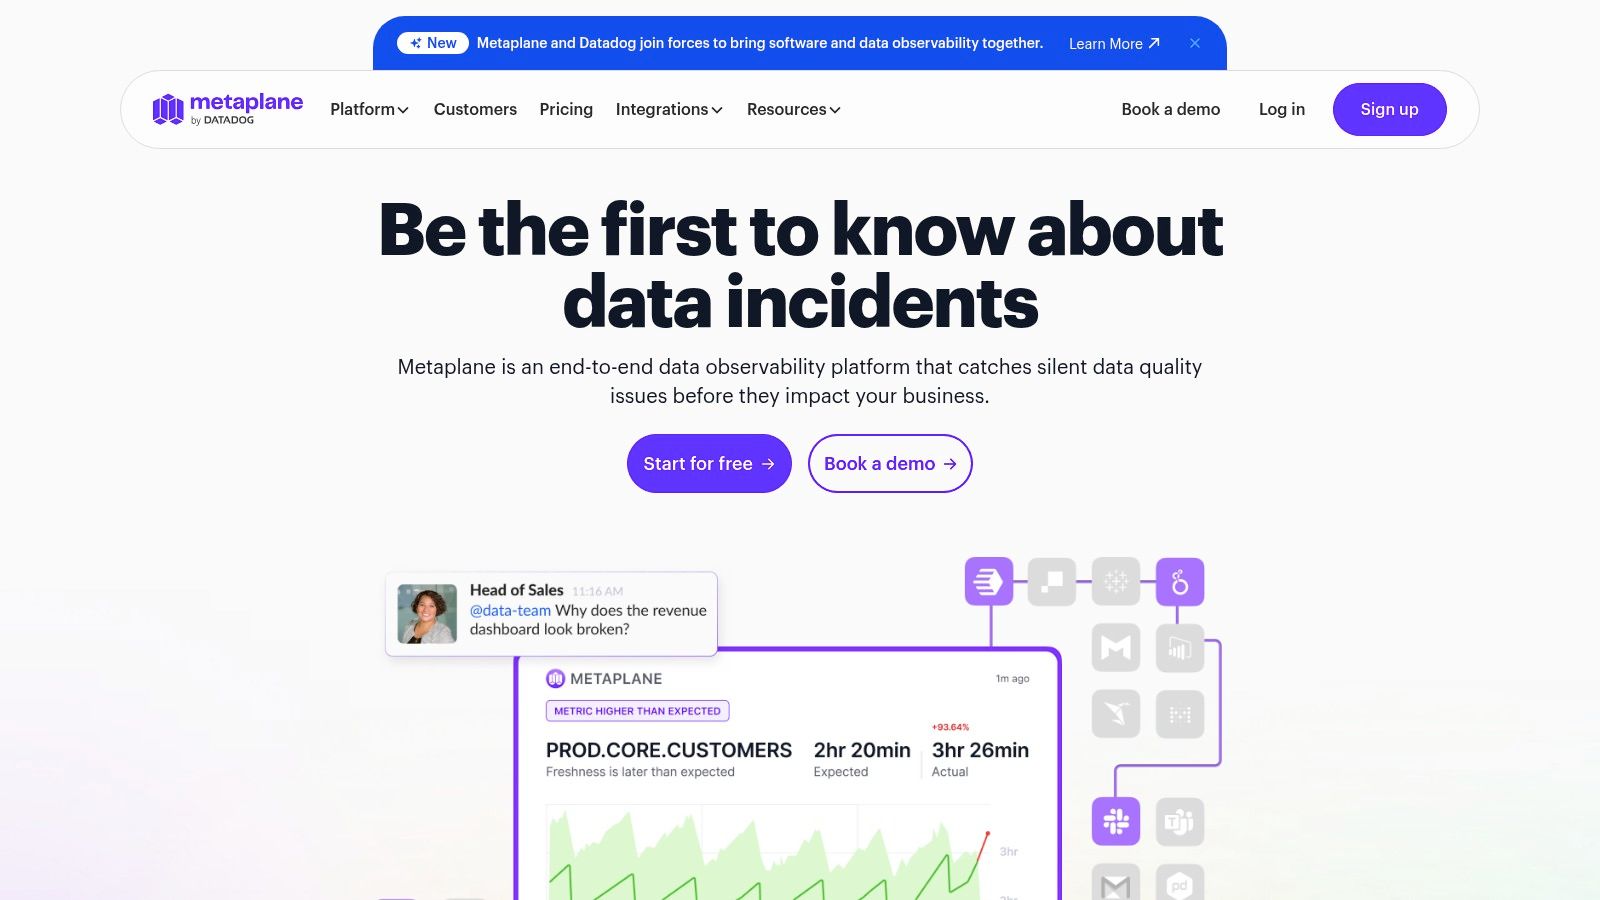
Metaplane punta su un onboarding SaaS rapido per i moderni data stack. La sua anomaly detection basata sul machine learning tiene conto di stagionalità e trend, mentre lineage a livello di colonna e analisi d'impatto aiutano i team a comprendere le conseguenze a valle. La Data CI/CD intercetta le regressioni nelle pull request, e gli alert su Slack o Microsoft Teams collegano il rilevamento ai canali di comunicazione già usati dall'engineering.
L'opzione Snowflake Native App è una distinzione architetturale significativa. Mantiene i dati nel warehouse e consente il pagamento tramite crediti Snowflake, il che può semplificare revisione di sicurezza e procurement per i team incentrati su Snowflake. Tuttavia non equivale a un controllo ampio in private cloud o on-premises. Gli acquirenti con ambienti eterogenei o regolamentati dovrebbero verificare come cambia la profondità delle funzionalità al di fuori del percorso Snowflake.
Avvio rapido, perimetro enterprise più ristretto
Il piano di ingresso gratuito per sempre di Metaplane favorisce la sperimentazione, e il suo modello di accesso in sola lettura può facilitare le prime discussioni sulla sicurezza. Il compromesso è l'ampiezza delle funzionalità. Potrebbe non sostituire una suite enterprise più ampia quando i team hanno bisogno di una governance estesa, di più modelli di deployment o di una copertura approfondita su piattaforme meno recenti.
Il termine di paragone di digna non è solo la velocità di onboarding. Offre esecuzione in-database, deployment in private cloud o on-premises, una dashboard condivisa e moduli che coprono anomalie, tempestività, validazione, modifiche dello schema e analisi storiche. I team dovrebbero confrontare il tempo necessario per collegare una sorgente rappresentativa, configurare i permessi, analizzare un alert e produrre evidenze per la governance.
Un utile punto di partenza è questa spiegazione di cosa fa una piattaforma di observability; poi verificate i dettagli sul vostro warehouse e sul vostro stack di orchestrazione.
Pro: onboarding rapido, ingresso gratuito, accesso in sola lettura, lineage, controlli CI/CD e un'opzione di deployment nativa per Snowflake.
Contro: la suite è più ristretta rispetto alle maggiori piattaforme enterprise e le funzionalità variano tra i diversi sistemi di dati.
7. IBM Data Observability by Databand
IBM Data Observability by Databand è incentrato sull'affidabilità di pipeline e job. Monitora i job, traccia gli accordi sui livelli di servizio e avvisa i team di errori o rischi di consegna lungo gli strumenti di orchestrazione e di warehouse. Il quadro di supporto, procurement, documentazione e contrattualistica di IBM può essere decisivo per le aziende regolamentate che hanno già standardizzato sui servizi IBM.
Questa opzione riguarda meno il self-service leggero e più l'inserimento dell'observability in un modello operativo enterprise consolidato. I team dovrebbero aspettarsi un processo di procurement e implementazione modellato su standard interni, requisiti di supporto e governance delle integrazioni. L'esperienza può essere appropriata per le organizzazioni che danno più valore alla responsabilità del fornitore e alla continuità contrattuale che a un'attivazione rapida di una prova.
L'adeguatezza dipende da responsabilità e procurement
I prezzi sono definiti per contratto e in alcuni SKU possono basarsi su licenze a resource unit. Questo rende difficile un confronto alla pari, a meno che l'acquirente non definisca job monitorati, ambienti, utenti, aspettative di supporto e ipotesi di rinnovo prima di richiedere un preventivo.
digna offre una strada diversa. Il suo licensing modulare parte da un solo modulo e si espande per tabella attiva e per modulo, mentre la sua architettura in-database mantiene l'analisi all'interno dell'ambiente del cliente. Il confronto pratico è quindi tra un modello di affidabilità delle pipeline incentrato su IBM e un modello modulare di qualità dei dati e observability che include Data Anomalies, Data Analytics, Timeliness, Data Validation e Schema Tracker.
IBM è un candidato sensato per la shortlist quando i canali di supporto e procurement IBM esistenti hanno un peso sostanziale. digna merita una valutazione più approfondita quando data engineer e team di governance hanno bisogno di un'unica interfaccia condivisa sia per il comportamento appreso sia per i controlli di qualità espliciti.
Pro: supporto IBM, contrattualistica enterprise, documentazione, allineamento alla governance e monitoraggio degli SLA delle pipeline.
Contro: l'esperienza può essere meno self-service e i prezzi passano dal team commerciale, con possibili licenze a resource unit in alcune offerte.
8. Lightup
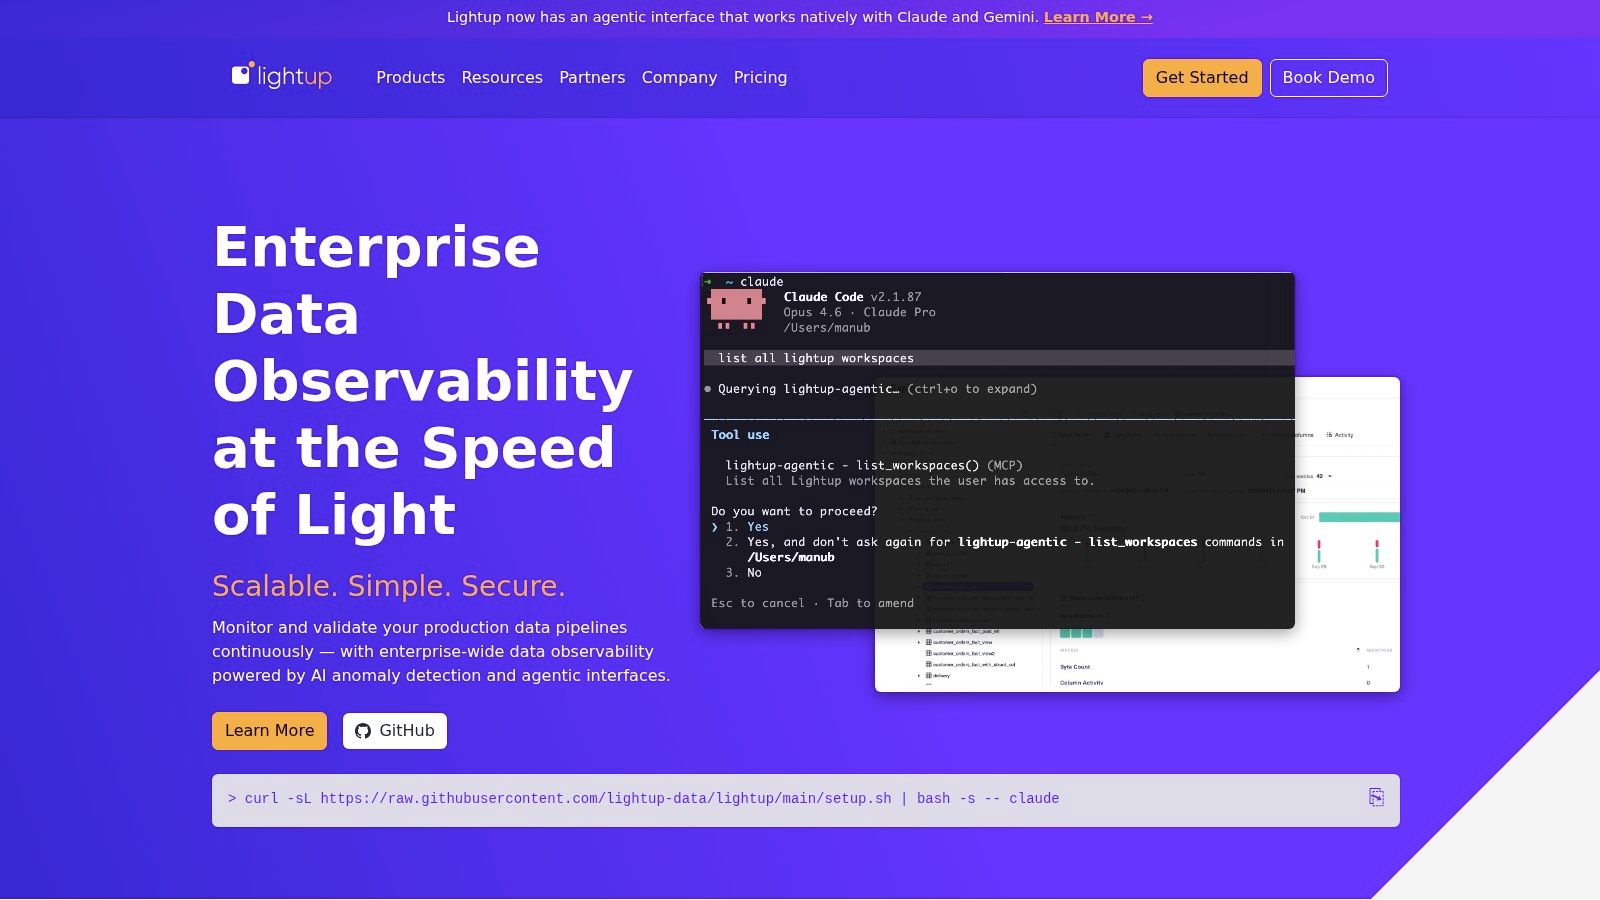
Lightup combina controlli basati su regole con anomaly detection basata sull'AI, lineage, riconciliazione e gestione degli incidenti. Il suo approccio Zero-Config Auto Metrics ha lo scopo di creare rapidamente una copertura di base, mentre le raccomandazioni dell'AI aiutano i team a individuare dove un monitoraggio aggiuntivo può essere utile. Le integrazioni con Collibra, Alation, sistemi di ticketing e strumenti di alerting estendono la piattaforma ai workflow di governance e di gestione degli incidenti.
La struttura dei piani Cloud ed Enterprise pone agli acquirenti un'utile domanda sul deployment, anziché una semplice domanda sulle funzionalità. Un deployment cloud può ridurre la responsabilità operativa, mentre le opzioni enterprise o ibride possono adattarsi meglio ai vincoli di residenza dei dati e di accesso. La valutazione dovrebbe confermare dove avviene il calcolo delle metriche, quali dati di produzione lasciano l'ambiente e come vengono amministrati i permessi.
Attivazione automatica contro rollout modulare controllato
L'attivazione rapida di Lightup può ridurre il tempo necessario per ottenere una prima copertura. digna offre un'idea simile di adozione incrementale attraverso il licensing modulare, ma il suo elemento distintivo è che controlli e calcolo delle metriche vengono eseguiti all'interno dei database del cliente. Per i team che gestiscono dati di produzione sensibili, questo può contare più della velocità di configurazione iniziale.
Non sono disponibili prezzi pubblici in dollari, quindi il preventivo dovrebbe separare canoni della piattaforma, perimetro monitorato, livello di deployment, integrazioni e supporto. Gli acquirenti dovrebbero anche verificare se le metriche generate automaticamente producono incidenti utili o si limitano ad ampliare la superficie degli alert. L'obiettivo non è attivare ogni monitor possibile. È individuare i problemi presto senza costringere gli engineer a esaminare eventi di scarso valore.
Pro: configurazione rapida della baseline, anomaly detection basata sull'AI, lineage, riconciliazione, integrazioni di governance e percorsi di deployment cloud o enterprise.
Contro: i prezzi richiedono un preventivo e la visibilità del suo ecosistema è inferiore a quella dei maggiori leader di mercato.
9. Telmai
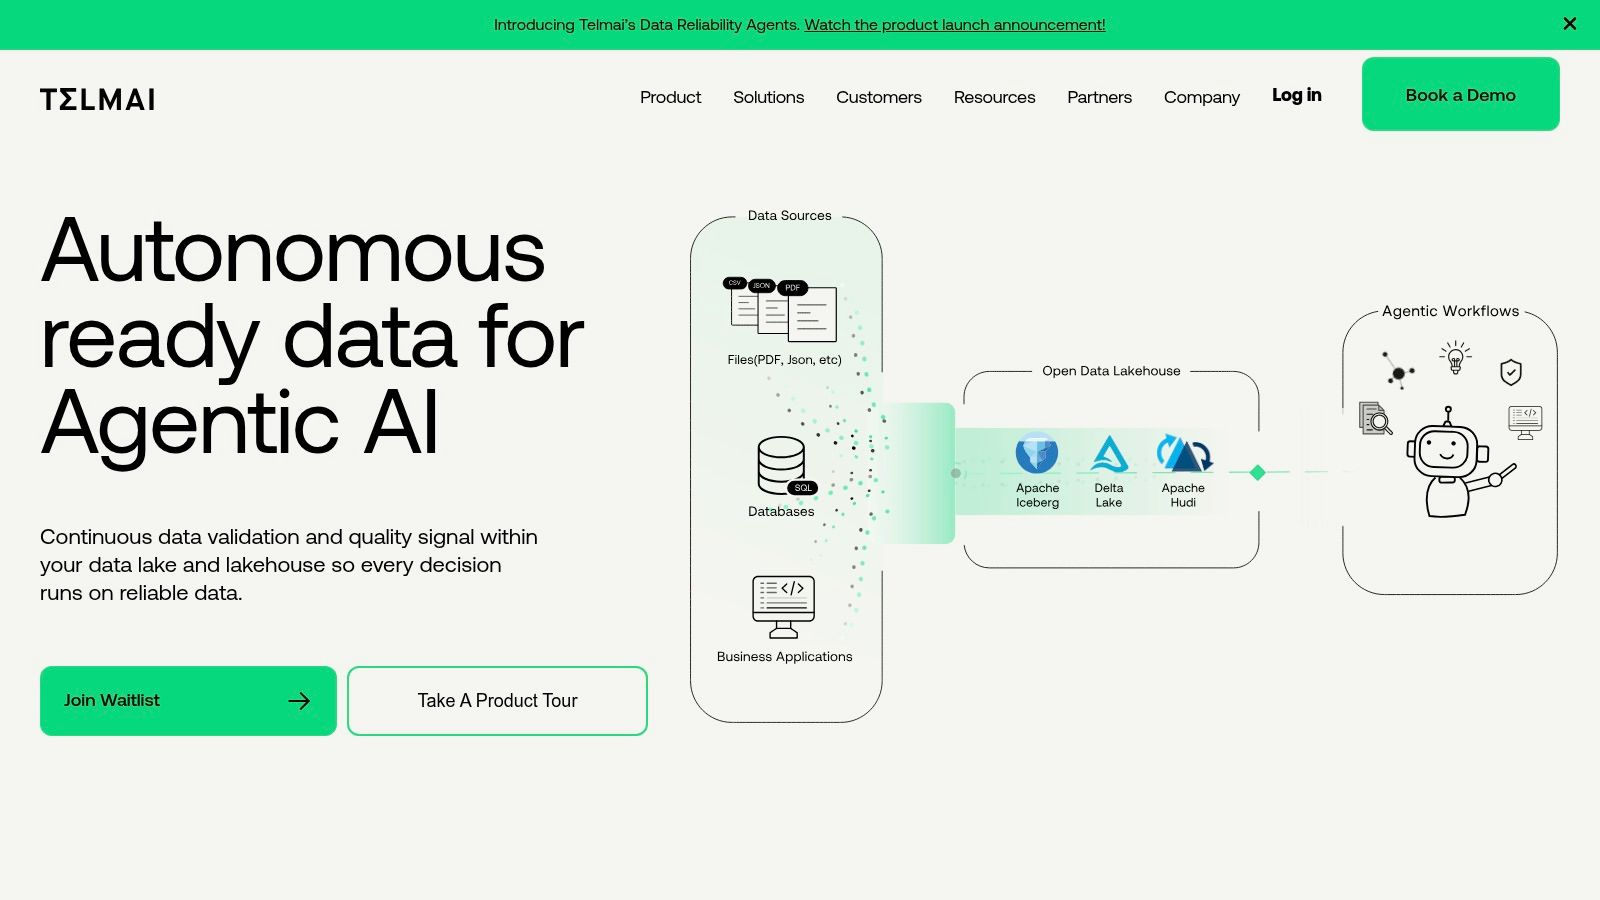
Telmai è progettata per architetture aperte e ambienti lakehouse basati su Iceberg, Hudi o Delta. Il suo posizionamento no-code e low-code, l'anomaly detection senza regole, il monitoraggio della deriva, i controlli di tempestività, il monitoraggio dello schema e le interrogazioni sui problemi in linguaggio naturale si rivolgono ai team che vogliono un'ampia copertura senza costruire manualmente ogni rilevatore.
Il Root-cause Investigator della piattaforma mira ad andare oltre il primo alert verso una spiegazione. La disponibilità su AWS Marketplace può inoltre semplificare una prima prova o il percorso di procurement per i team che già operano tramite AWS. Questa comodità non elimina la necessità di definire il perimetro monitorato, le responsabilità di deployment e il modo in cui la piattaforma interagisce con i formati di tabella aperti.
I formati aperti cambiano il test di migrazione
Telmai è un candidato forte quando l'apertura del lakehouse è il principale requisito architetturale. digna è più adatta quando il team ha bisogno anche di esecuzione in-database, deployment privato, validazione a livello di record, tempestività appresa tramite AI e un'interfaccia condivisa tra engineer, analisti e stakeholder della governance.
La pratica della data observability raggruppa generalmente qualità, freschezza, lineage e modifiche dello schema come segnali di monitoraggio fondamentali, con controlli in tempo reale che aiutano a prevenire guasti a valle in analytics e AI. (Ricerca sui segnali di data observability) Durante un POC, confrontate non solo se entrambe le piattaforme rilevano la stessa deriva, ma anche se ciascuna sa spiegare il problema nel linguaggio operativo preferito dal team.
I prezzi di Telmai non sono pubblici e dipendono dal perimetro monitorato e dal deployment. Anche la sua community è più piccola di quella dei fornitori presenti sul mercato da più tempo, quindi gli acquirenti dovrebbero valutare documentazione, supporto all'implementazione e responsabilità interna.
Pro: ottima adattabilità a lakehouse e formati aperti, copertura delle anomalie senza regole, indagine in linguaggio naturale e disponibilità su AWS Marketplace.
Contro: i prezzi dipendono dal preventivo e la community è più piccola di quella dei fornitori affermati.
10. Kensu
Kensu utilizza agenti distribuibili per osservare i dati in movimento e a riposo. Il suo approccio strumenta le pipeline nel punto in cui i dati vengono utilizzati, raccogliendo in tempo reale metriche di lineage, schema e qualità su strumenti come dbt, Databricks o Spark, Azure Data Factory e Snowflake. Questo può ridurre i punti ciechi negli ambienti distribuiti, dove un monitor limitato al warehouse vede la destinazione ma non il percorso di trasformazione che l'ha prodotta.
Controlli in stile circuit breaker e workflow per gli incidenti estendono Kensu oltre la semplice notifica passiva. Una Community Edition e opzioni di proof of concept possono aiutare gli sviluppatori a valutare il modello di strumentazione prima di impegnarsi in un rollout più ampio. La domanda chiave per la migrazione è se il team voglia agenti integrati in tutte le pipeline o preferisca controlli eseguiti direttamente nel database.
Profondità di strumentazione contro esecuzione dove risiedono i dati
Il modello di Kensu, che osserva i dati dove vengono utilizzati, può rivelare un contesto che il monitoraggio limitato alle tabelle non coglie. digna segue una strada diversa con l'esecuzione in-database, mantenendo calcolo delle metriche e analisi all'interno dei database del cliente e coprendo anomalie, analytics, tempestività, validazione e modifiche dello schema attraverso moduli separati.
I prezzi di Kensu non sono pubblicati e di norma passano dal team commerciale. Anche le informazioni sul sito sono meno dettagliate rispetto a quelle dei fornitori più grandi, con parte del materiale fornita tramite documentazione o canali professionali. La valutazione dovrebbe quindi includere una sessione guidata sull'implementazione, i permessi degli agenti, il comportamento in caso di guasto, la responsabilità degli aggiornamenti e la conservazione delle evidenze.
Pro: strumentazione delle pipeline in tempo reale, monitoraggio di lineage e schema, visibilità distribuita e opzioni di valutazione community.
Contro: i prezzi non sono pubblici e i team devono valutare l'onere operativo di distribuire e mantenere gli agenti.
Le 10 migliori alternative a Bigeye: confronto delle funzionalità
Fornitore | Funzionalità principali | Punti di forza distintivi | Pubblico di riferimento | Deployment e sicurezza | Prezzi e valore |
|---|---|---|---|---|---|
🏆 digna | Anomaly detection, tempestività, validazione dei record, schema tracker, metriche e analytics in‑DB | ✨ Esecuzione in‑DB, apprendimento delle baseline tramite AI, rollout modulare, time-to-value rapido ★★★★★ | 👥 Data engineer, BI/analytics, governance; finanza/sanità/telecomunicazioni/settore pubblico | Funziona nell'infrastruttura del cliente (private cloud/VPC/on‑prem); il fornitore non accede ai dati di produzione | 💰 Prezzi modulari trasparenti: canone base + costo per tabella attiva/modulo; prevedibili ma dipendenti dalla scala |
Monte Carlo Data | Monitor di freschezza, volume, schema e distribuzione; lineage a livello di colonna/dashboard; workflow per gli incidenti | ✨ Ampia copertura di connettori/stack; solide referenze enterprise ★★★★ | 👥 Grandi aziende con stack eterogenei e team di analytics | Connettori cloud/SaaS per warehouse, data lake, ETL, BI | 💰 Prezzi enterprise su preventivo; può risultare troppo pesante per i team piccoli |
Acceldata | Observability di piattaforme/pipeline/job, costi, prestazioni, workflow strutturati come prodotto | ✨ Supporto ibrido/on‑prem + focus su governance e ottimizzazione ★★★★ | 👥 Ambienti grandi ed eterogenei; aziende che modernizzano i big‑data | Opzioni di deployment cloud, on‑prem e ibride; controlli enterprise | 💰 Prezzi tramite team commerciale; adatto a grandi patrimoni dati |
Anomalo | Anomaly detection non supervisionata, analisi delle cause alla radice, integrazioni (Databricks/Snowflake) | ✨ Rilevamento senza regole, time‑to‑value rapido ★★★★ | 👥 Team che necessitano di anomaly detection rapida senza regole complesse | SaaS con opzioni di deployment enterprise; solide integrazioni cloud | 💰 Su preventivo; SLA enterprise disponibili |
Soda | Controlli/contratti as code (Soda Core OSS); Soda Cloud per baseline e alert | ✨ Ingresso OSS (oltre 50 controlli) → percorso di migrazione verso il Cloud gestito ★★★ | 👥 Sviluppatori/engineer che vogliono un percorso OSS-first e l'integrazione nelle pipeline | OSS (CLI) + Cloud gestito; si integra con warehouse e orchestratori | 💰 OSS gratuito; Soda Cloud = contatto commerciale per i prezzi |
Metaplane (Datadog) | Anomaly detection con ML, lineage a livello di colonna, Data CI/CD, Snowflake Native App | ✨ Onboarding rapido, piano gratuito per sempre, opzione nativa Snowflake ★★★★ | 👥 Team piccoli→medi, organizzazioni Snowflake-first, POC rapidi | SaaS + Snowflake Native App (i dati restano nel warehouse) | 💰 Piano gratuito disponibile; piani a pagamento / prezzi Datadog |
IBM Data Observability (Databand) | Observability di pipeline/job, monitoraggio degli SLA, integrazioni con orchestrazione e warehouse | ✨ Supporto IBM, procurement e adeguatezza enterprise/normativa ★★★ | 👥 Aziende regolamentate e acquirenti standardizzati su IBM | Deployment enterprise, framework di supporto/prodotto IBM | 💰 Prezzi su contratto/tramite team commerciale; modello di procurement enterprise |
Lightup | Controlli basati su regole + anomaly detection con AI, lineage, riconciliazione, gestione degli incidenti | ✨ Zero‑config Auto Metrics per una copertura rapida ★★★ | 👥 Team che vogliono una copertura automatica rapida e collaborazione | Piani Cloud ed Enterprise; opzioni ibride | 💰 Su preventivo; distinzione chiara tra piano Cloud ed Enterprise |
Telmai | Observability per data lake/lakehouse (Iceberg/Hudi/Delta), deriva/tempestività/schema, interrogazioni in linguaggio naturale | ✨ Focus sui formati aperti, interrogazioni sui problemi in linguaggio naturale, disponibilità su AWS Marketplace ★★★ | 👥 Team lakehouse, ambienti con formati aperti, preparazione per la GenAI | Deployment cloud; opzione di procurement tramite marketplace (AWS) | 💰 Prezzi in base al perimetro; necessario il contatto commerciale |
Kensu | Lineage basata su agenti, metriche di schema e qualità, osservazioni e profiler in tempo reale | ✨ Osservazione dove i dati vengono usati; edizione community/POC ★★★ | 👥 Team che necessitano di strumentazione in tempo reale e di valutazione da parte degli sviluppatori | Deployment di agenti nelle pipeline; telemetria in tempo reale | 💰 Prezzi tramite team commerciale; Community Edition per la valutazione |
Trasformare la shortlist in una decisione di migrazione sicura
L'alternativa giusta a Bigeye dipende meno dal numero di monitor mostrati in una demo che dal comportamento della piattaforma rispetto all'ubicazione reale dei vostri dati, al vostro modello di responsabilità e al vostro processo di gestione degli incidenti. La domanda di mercato si sta muovendo in questa direzione. Uno studio di mercato prevede che la categoria della data observability passi da 3,51 miliardi di USD nel 2026 a 6,03 miliardi di USD entro il 2031, con un tasso di crescita annuo composto dell'11,42% previsto nel periodo. (Studio di mercato 2026 sulla data observability) La crescita da sola non indica il prodotto giusto, ma mostra che i team stanno prendendo una decisione infrastrutturale di lungo periodo anziché acquistare un livello di alerting temporaneo.
Partite da un inventario, non da una scorecard dei fornitori. Elencate tabelle, pipeline, dashboard, modelli e consumatori operativi critici. Indicate quali asset contengono dati sensibili, quali sistemi funzionano in reti private o on-premises e quali carichi di lavoro non possono tollerare copie dei dati di produzione. Poi classificate i controlli necessari:
Copertura delle anomalie: individuate i comportamenti che richiedono baseline apprese, tra cui volume, distribuzione, metriche di business e segnali della piattaforma.
Requisiti di tempestività: definite separatamente le finestre di arrivo attese e le finestre decisionali. Un dataset può arrivare entro un intervallo di freschezza nominale e mancare comunque il momento in cui un processo di business ne ha bisogno.
Regole di validazione: documentate la logica di business a livello di record, i controlli normativi, le condizioni di riconciliazione e i controlli che devono restare espliciti anziché dedotti.
Monitoraggio dello schema: specificate come colonne aggiunte, campi rimossi e cambi di tipo debbano influire sui consumatori a valle.
Workflow di indagine: misurate se un engineer riesce a passare dall'alert all'asset interessato, alla causa probabile, al responsabile e alla remediation senza saltare tra strumenti scollegati.
Mettete alla prova i finalisti su carichi di lavoro rappresentativi, non su un campione pulito. Includete una tabella di alto valore, una pipeline in ritardo, una modifica dello schema pianificata, uno spostamento inatteso della distribuzione e una violazione di regola. Confrontate qualità degli alert, tempi di indagine, utilità della lineage e sforzo necessario per mettere a punto i monitor. Non contate gli alert come successo. Contate gli alert che portano a un'azione chiara.
La modellazione dei costi richiede lo stesso realismo. Alcuni fornitori fanno preventivi in base al perimetro monitorato, altri usano indicatori di risorse o di utilizzo, e digna applica un canone base più un prezzo per tabella attiva e per modulo, senza costi per API, volume di scansione o volume di alert. Chiedete a ciascun fornitore di modellare la crescita sulla base delle vostre tabelle attive, dei moduli selezionati, degli ambienti, delle integrazioni e dei requisiti di supporto. Qui le evidenze sulla proliferazione degli strumenti sono importanti: il 46,7% delle organizzazioni utilizza da due a tre strumenti di observability in parallelo, mentre solo il 7,4% si affida a un'unica piattaforma unificata. (Sintesi di un sondaggio indipendente sull'observability) Il consolidamento può rendere più chiari i workflow, ma solo se la soluzione sostitutiva copre i controlli che avevano costretto i team ad aggiungere strumenti supplementari.
La mappatura dei moduli di digna offre una base di confronto pratica:
Data Anomalies: apprendimento delle baseline tramite AI e anomaly detection continua senza configurazione manuale delle regole.
Data Analytics: analisi storica di trend, volatilità e statistiche per comprendere l'affidabilità nel tempo.
Timeliness: calendari di consegna appresi tramite AI, orari di consegna attesi, caricamenti in ritardo, dati mancanti e arrivi anticipati.
Data Validation: applicazione di regole di business a livello di record per controlli di qualità, audit e compliance.
Schema Tracker: rilevamento continuo di colonne aggiunte o rimosse e di cambi di tipo di dato.
Esecuzione in-database: calcolo delle metriche e analisi all'interno dei database del cliente, mantenendo i dati dove sono.
Opzioni di deployment: installazione in private cloud o on-premises all'interno del cloud, della VPC o del data center del cliente.
Dashboard condivisa: un'unica interfaccia per engineer, analisti, team di governance e altri stakeholder.
Componenti inclusi: scheduler, data catalog, integrazioni e funzioni di collaborazione fin dalla scelta del primo modulo.
Licensing modulare: si parte da un modulo e ci si espande per tabella attiva e per modulo.
Disciplina di migrazione: mantenete Bigeye e l'alternativa scelta in esecuzione sugli stessi carichi di lavoro rappresentativi abbastanza a lungo da confrontare rilevamento, indagine, andamento dei costi e impegno richiesto ai responsabili.
Documentate i criteri di rollback prima dell'inizio della migrazione. Stabilite cosa costituisce un rumore di alert inaccettabile, incidenti non rilevati, consumi di calcolo imprevisti, integrazioni fallite o evidenze insufficienti per la governance. Procedete per fasi, partendo da un insieme circoscritto di asset critici ed espandendovi solo dopo che i responsabili hanno confermato che il nuovo workflow funziona. Dismettete Bigeye dopo che la soluzione sostitutiva ha dimostrato in produzione copertura, gestione degli incidenti, controlli di accesso e andamento dei costi, non semplicemente dopo che il procurement ha approvato il contratto.
La scelta migliore potrebbe essere Monte Carlo per una lineage ampia, Acceldata per ambienti ibridi full-stack, Soda per i controlli as code, Metaplane per un onboarding rapido sui moderni data stack, Telmai per i formati lakehouse aperti, Kensu per la strumentazione delle pipeline basata su agenti o IBM Data Observability by Databand per operazioni enterprise incentrate su IBM. Potrebbe essere digna quando i requisiti decisivi sono deployment privato, esecuzione dove risiedono i dati, adozione modulare, monitoraggio appreso di anomalie e tempestività, validazione esplicita e controllo dello schema. L'adeguatezza dipende dall'architettura e dal modello operativo, quindi la shortlist dovrebbe concludersi con un test sui carichi di lavoro e una decisione sulle responsabilità, non con una classifica generica.
digna combina anomaly detection basata sull'AI, monitoraggio della tempestività, validazione a livello di record, schema tracking, analisi storiche ed esecuzione in-database all'interno del vostro ambiente. Visitate digna per valutare un'alternativa modulare a Bigeye per i requisiti della vostra piattaforma dati, di governance e di affidabilità.
Domande frequenti
Come confrontare le alternative a Bigeye?
Non solo in base all'anomaly detection, che ripropone il problema che gli acquirenti cercano di risolvere. Valutatele invece rispetto a criteri enterprise concreti: ubicazione dei dati, copertura delle anomalie, validazione, tempestività, monitoraggio dello schema, modello di deployment, indicazioni sui prezzi e sforzo di migrazione.
Quale alternativa è adatta ai team con requisiti di residenza dei dati?
digna è la scelta più solida quando il controllo del deployment e la residenza dei dati contano quanto la copertura di observability, perché combina il rilevamento automatico con controlli deterministici e funziona in-database. Il compromesso è che il deployment privato richiede una responsabilità operativa interna.
Come si confronta Monte Carlo con una piattaforma in-database?
L'elemento distintivo di Monte Carlo è l'ampiezza operativa, con un'ampia copertura di connettori, lineage end-to-end e workflow per gli incidenti adatti a grandi stack moderni. La decisione dipende dal modello operativo: Monte Carlo è adatto ai team che danno priorità a lineage e copertura dell'ecosistema, una piattaforma in-database è adatta ai team che devono mantenere i dati nel proprio ambiente.
Come sono strutturati di solito i prezzi dell'observability?
Variano al punto che il procurement dovrebbe modellarli. digna applica un canone base più un costo per tabella attiva e per modulo, che richiede un dimensionamento per i grandi patrimoni dati, mentre diversi concorrenti, tra cui Monte Carlo, non pubblicano i prezzi e richiedono un preventivo basato sul perimetro monitorato e sui requisiti di integrazione.
Quanto tempo perdono ancora i team a causa dei problemi nei dati?
Un sondaggio tra i responsabili del data management ha rilevato che solo il 7% risolve i problemi dei dati prima che gli utenti ne siano colpiti, mentre il 39% dedica dal 20 al 40% del proprio tempo a correggere problemi nelle pipeline. Questa quota reattiva è il vero parametro che una piattaforma sostitutiva deve migliorare.


