Affidabilità e validità dei dati: cosa le distingue
|
10
min di lettura

Il consiglio più diffuso su affidabilità e validità dei dati è incompleto: rendere coerente la pipeline, aggiungere controlli di freschezza e fidarsi della dashboard finché resta verde. Questo approccio intercetta una consegna instabile, ma può non vedere un guasto più pericoloso. Una pipeline può ripetere all'infinito la stessa interpretazione sbagliata, fornendo al management un report pulito e ai modelli un segnale di addestramento coerente che non rappresenta più il business.
Affidabilità e validità sono livelli di controllo distinti. L'affidabilità chiede se una misurazione è coerente e disponibile in condizioni ripetibili. La validità chiede se misura la realtà, il costrutto o la regola di business previsti. Una piattaforma dati affidabile ha bisogno di entrambe, con moduli di observability assegnati al tipo di guasto che ciascuno è in grado di rilevare.
Indice
Perché pipeline stabili possono comunque produrre decisioni sbagliate
Come i moduli di observability si associano a ciascuna proprietà
Perché pipeline stabili possono comunque produrre decisioni sbagliate
Immaginate una dashboard mensile dei ricavi che mostra totali identici in tre esecuzioni consecutive. Ogni controllo di freschezza viene superato. Non scatta alcun alert di anomalia. La pipeline termina nei tempi previsti, il numero di righe resta entro l'andamento atteso e la dashboard appare operativamente sana.
Il problema sta nella tassonomia. Un'unione silenziosa ha fatto confluire due linee di prodotto in un'unica categoria. La pipeline è stabile, ma il significato di business è cambiato. Nulla in un semplice monitor della consegna sa necessariamente che la definizione della categoria ora è sbagliata, soprattutto se i totali risultanti restano numericamente plausibili.
Questa distinzione è centrale nella scienza della misurazione. L'affidabilità riguarda la coerenza tra misurazioni ripetute, mentre la validità riguarda la capacità della misura di cogliere ciò che intende misurare (Statistics Solutions spiega la distinzione tra affidabilità e validità). Una pipeline stabile può quindi consegnare un errore ripetibile. La dashboard non mente perché il calcolo è fallito. È fuorviante perché il calcolo continua a essere eseguito su un'interpretazione non valida.
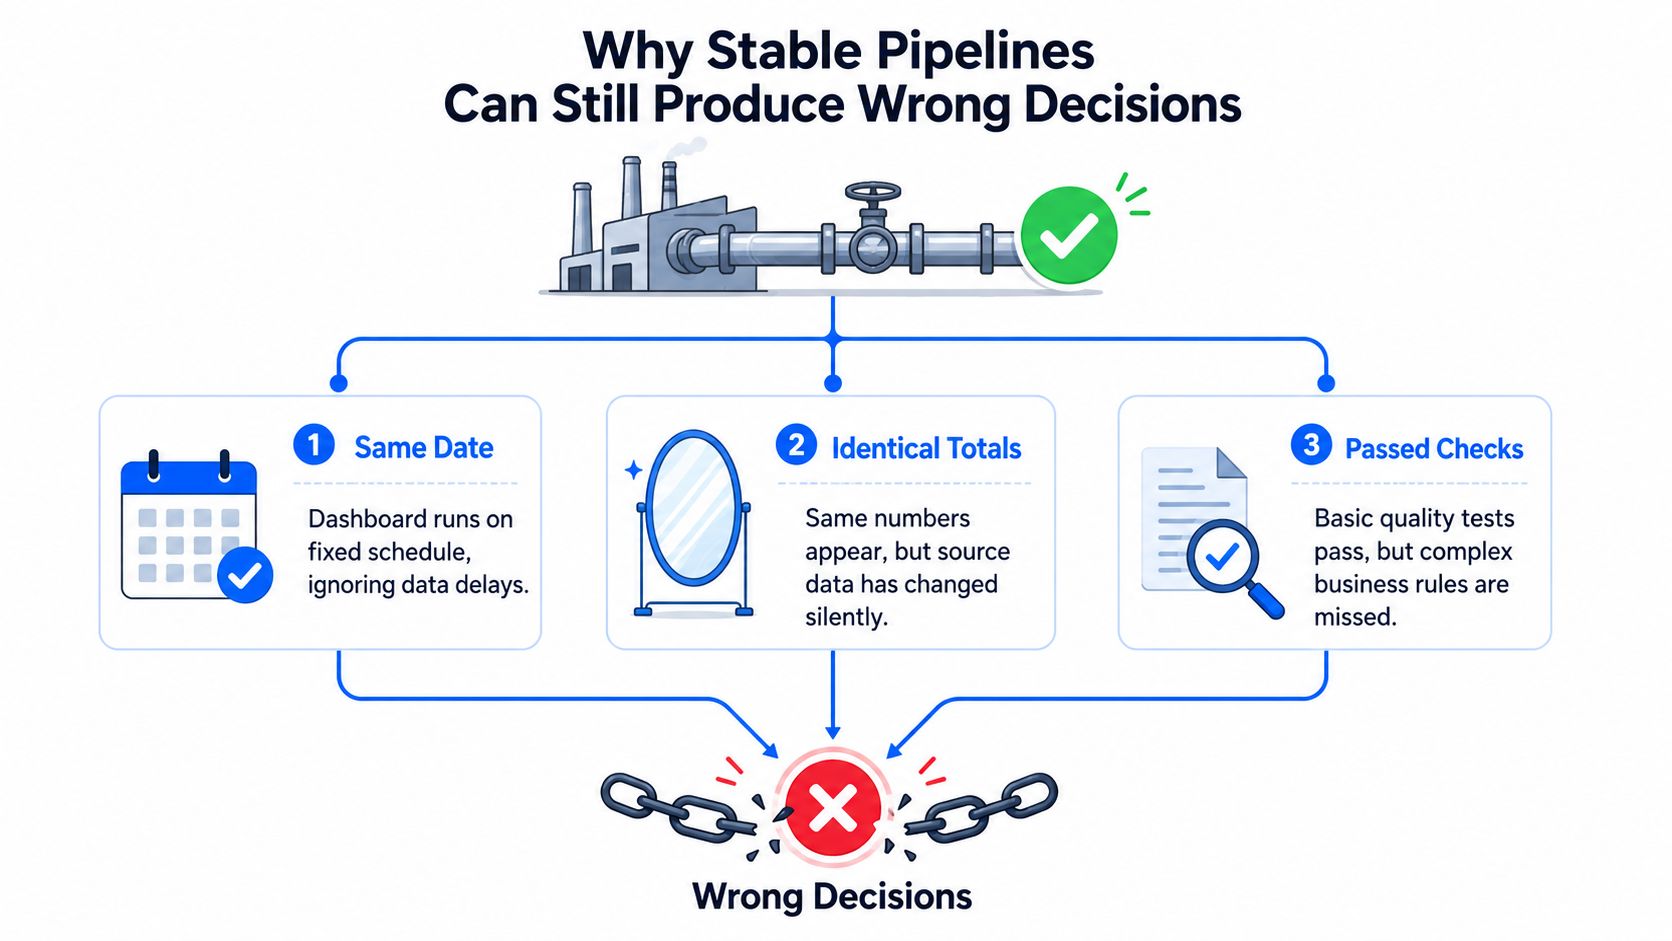
Due diverse modalità di guasto
L'errore casuale crea variazione. Una partizione arriva in ritardo, una sorgente invia meno record, i valori nulli aumentano di colpo o un osservatore classifica lo stesso record in modo diverso tra un'esecuzione e l'altra. I controlli di affidabilità sono progettati per far emergere questa instabilità attraverso controlli di ripetibilità, freschezza, anomalie e coerenza.
L'errore sistematico crea una distorsione stabile. Un'unità di misura passa dai dollari ai centesimi, una tabella dei tassi di cambio inverte una conversione o un denominatore esclude una popolazione rilevante. L'output può restare regolare e riproducibile pur non rappresentando il costrutto previsto. Per farlo emergere servono controlli di validità, come test semantici e riconciliazione con un riferimento autorevole.
I team operativi possono usare una pratica guida al monitoraggio della qualità dei dati per organizzare i controlli attorno a freschezza, completezza, coerenza e applicazione delle regole. Ma monitorare il meccanismo di consegna non equivale a dimostrare che una metrica significa ancora ciò che gli stakeholder pensano.
Un utile riferimento interno è la spiegazione di digna sull'affidabilità dei dati, in particolare quando i team devono separare la consegna affidabile dalla correttezza dell'interpretazione. La lezione dalla produzione è semplice: lo stato verde della pipeline dimostra che il meccanismo è stato eseguito. Non dimostra che la metrica decisionale sia rimasta valida.
Definire affidabilità e validità dei dati
L'affidabilità dei dati è coerenza in condizioni ripetibili. Se la stessa sorgente, lo stesso metodo e le stesse condizioni producono risultati simili in misurazioni ripetute, la misurazione dimostra affidabilità. Nelle piattaforme dati, ciò significa che un job consegna i record attesi, le trasformazioni si comportano in modo coerente, gli osservatori concordano sulle classificazioni e le metriche ricorrenti non variano senza un corrispondente cambiamento nel processo sottostante.
L'affidabilità è strettamente legata all'errore casuale. La stabilità test-retest verifica se i risultati persistono in esecuzioni ripetute. La coerenza interna verifica se elementi correlati si comportano in modo coerente. I metodi split-half dividono uno strumento in parti per confrontarne la coerenza, mentre i metodi inter-rater esaminano l'accordo tra osservatori. Nel lavoro di ripetibilità di tipo laboratoriale si usano spesso osservazioni replicate, con circa 10 repliche come riferimento pratico in alcuni contesti (la discussione metodologica su affidabilità e validità).
La validità è la correttezza dell'oggetto della misurazione. Un campo, una metrica o un dataset validi rappresentano la realtà o il costrutto che dichiarano di rappresentare. Il valore può essere formattato perfettamente e prodotto in modo ripetuto, ma risultare non valido se il campo ha l'unità di misura sbagliata, la popolazione sbagliata, l'etichetta sbagliata o la definizione di business sbagliata. La validità dei dati include anche la conformità a regole, formati e standard predefiniti (definizione di validità dei dati di Acceldata).
Quattro prospettive utili sulla validità
Validità di contenuto: la metrica include l'intero insieme di componenti di business che dichiara di coprire? Un punteggio di salute del cliente che esclude gli incidenti di supporto può essere affidabile, ma incompleto come misura della salute del cliente.
Validità di costrutto: la metrica coglie il concetto previsto anziché un comodo indicatore sostitutivo? Una misura di “retention” basata solo sugli accessi potrebbe non rappresentare il valore commerciale effettivamente trattenuto.
Validità di criterio: il risultato concorda con uno standard noto o con un riferimento affidabile? Una conversione di valuta dovrebbe riconciliarsi con la fonte autorevole dei tassi e con la relativa unità definita.
Validità di facciata: il campo sembra misurare ciò che il suo nome suggerisce? Una colonna chiamata
active_customerpuò superare una revisione superficiale mentre la sua implementazione conta le sessioni recenti invece dei contratti attivi.
Un evento di schema drift può compromettere la validità di facciata quando la struttura di un campo non corrisponde più al significato documentato. Un cambio di unità di misura può compromettere la validità di criterio quando i valori non sono più allineati allo standard di riferimento. Questi guasti possono superare i controlli di ripetibilità perché la stessa logica difettosa viene eseguita in modo coerente.
Il classico esempio della misurazione chiarisce la relazione. Un termometro che produce sempre la stessa lettura nell'acqua bollente è affidabile, ma se è calibrato per il contesto sbagliato, la lettura non è valida. L'affidabilità è necessaria per ottenere evidenze significative di validità, ma da sola non garantisce la validità. Per una trattazione operativa più dettagliata, consultate la guida di digna alla validità dei dati.
Confronto diretto tra i due concetti
Le definizioni diventano utili solo quando cambiano il modo in cui un team progetta i controlli. Affidabilità e validità vanno valutate in base all'errore che affrontano, alle evidenze che supportano la conclusione, all'alert che compare in produzione e al livello in cui ha origine il guasto.
Criterio | Affidabilità dei dati | Validità dei dati |
|---|---|---|
Domanda centrale | La misurazione resta coerente in condizioni ripetute? | La misurazione rappresenta la realtà o il costrutto previsti? |
Errore principale affrontato | Errore casuale e varianza inspiegata | Errore sistematico, distorsione e interpretazione semantica errata |
Evidenze di misurazione | Stabilità test-retest, ripetibilità, riproducibilità, coerenza interna, controlli split-half e accordo inter-rater | Confronto con un gold standard, un benchmark di criterio, una verità nota, una regola di business o una relazione teorica attesa |
Segnale nella pipeline | Alert di anomalia, freschezza mancata, variazione di volume, picco di nulli, mancata consegna o risultato incoerente tra osservatori | Test semantico fallito, mancata riconciliazione, conflitto di unità di misura, relazione non valida o cambiamento di distribuzione con significato di business |
Livello dello stack | Trasporto, ingestion, orchestrazione, storage ed esecuzione ricorrente | Modello semantico, logica di trasformazione, definizione delle metriche, dati di riferimento e livello di business |
Responsabile tipico | Team di data platform o di infrastruttura | Analytics engineering, domain steward e data product owner |
Cosa significa successo | Il sistema si comporta in modo prevedibile e consegna dati utilizzabili nei tempi previsti | I dati rispondono correttamente alla domanda prevista |
I metodi statistici non sono intercambiabili. L'affidabilità può essere valutata con ripetibilità, riproducibilità, stabilità test-retest, coerenza interna o accordo inter-rater. La validità viene più spesso giudicata tramite sensibilità e specificità, dove esiste un gold standard, oppure tramite il confronto con una verità nota e con relazioni attese (Statistics by Jim distingue precisione e coerenza da accuratezza e correttezza).
Compromessi in produzione
I controlli possono anche interferire tra loro. Una trasformazione può diventare semanticamente più precisa dopo un'ulteriore normalizzazione, ma introdurre più ramificazioni e rendere più difficile riprodurre le esecuzioni ripetute. Una deduplicazione aggressiva può rendere più stabile il numero di record eliminando però eventi ripetuti legittimi. Un miglioramento dell'affidabilità può quindi ridurre la validità se elimina casi limite significativi.
Ecco perché i team dovrebbero trattare le dimensioni della qualità dei dati come categorie di evidenza distinte, non come etichette intercambiabili. L'observability deve strumentare in modo indipendente il comportamento del trasporto e il significato di business. Un segnale sulla salute della pipeline può confermare che i dati sono arrivati. Non può, da solo, confermare che i dati arrivati rappresentino ancora l'entità, l'unità di misura, il denominatore o il processo corretti.
Come i moduli di observability si associano a ciascuna proprietà
I moduli di observability non sono versioni ridondanti dello stesso radar. Ciascuno vede una diversa superficie di guasto. Il rilevamento delle anomalie e il monitoraggio della freschezza di solito difendono l'affidabilità, perché individuano comportamenti inattesi nella consegna e nei pattern ricorrenti dei dati. I controlli di validazione e di schema forniscono evidenze più solide di validità quando codificano ciò che i dati dovrebbero significare e come possono cambiare.
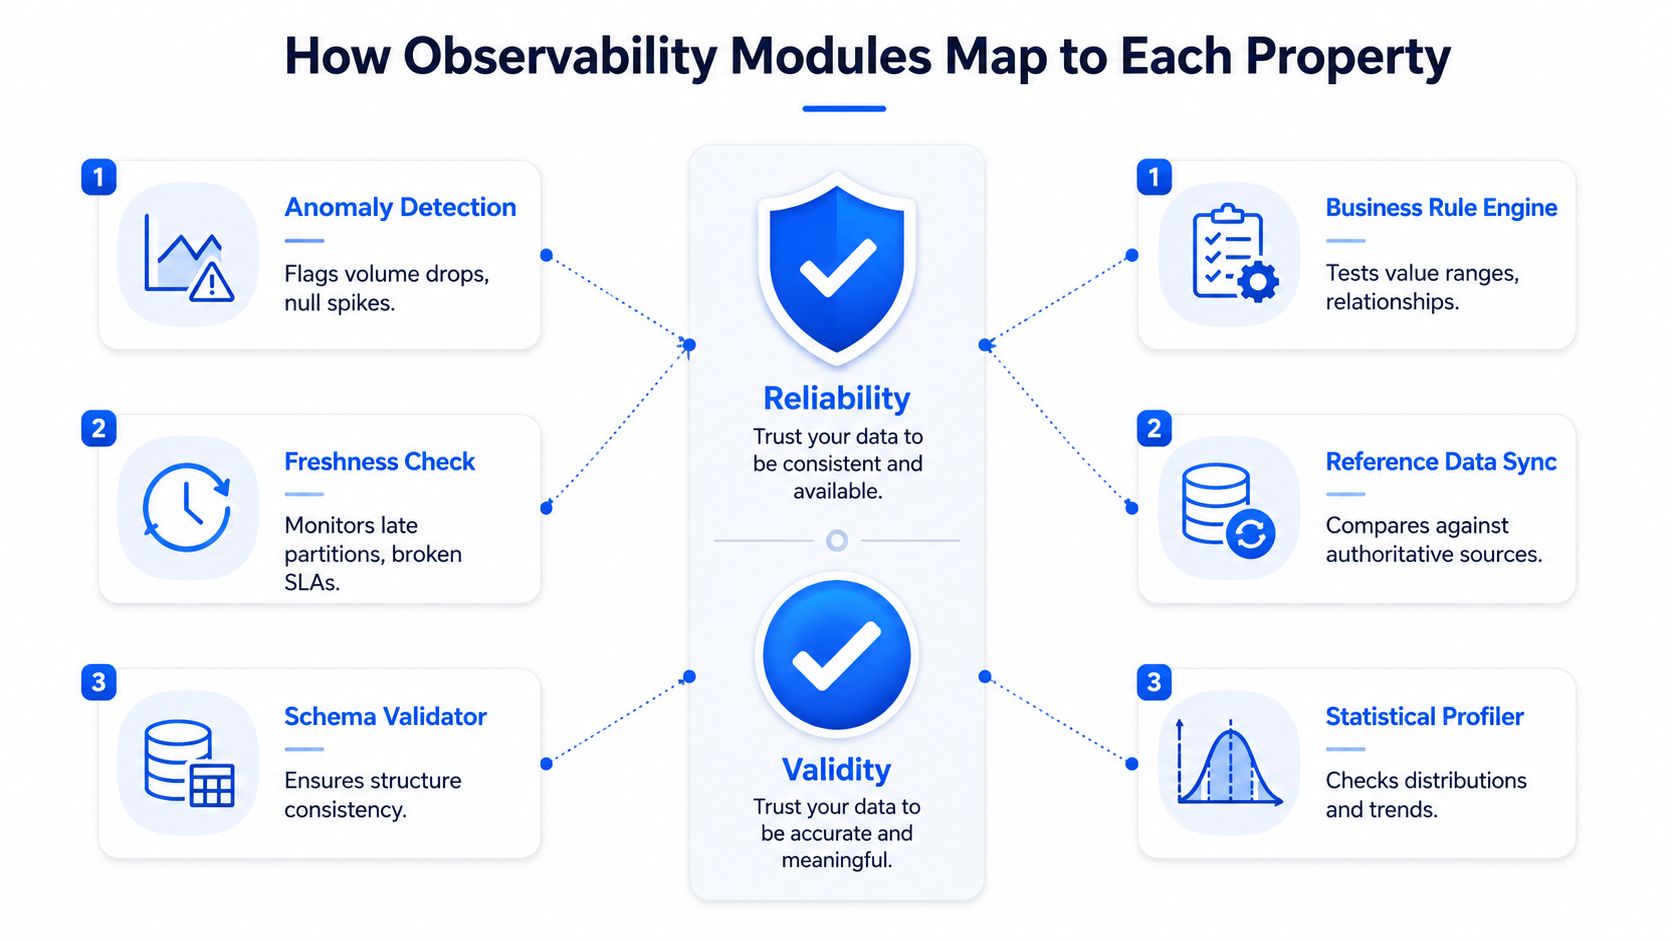
Rilevamento delle anomalie e freschezza
Il rilevamento delle anomalie può segnalare un calo improvviso di volume, un picco inatteso di valori nulli o un cambiamento insolito nella distribuzione. I controlli di freschezza monitorano partizioni in ritardo, caricamenti mancanti e aspettative di consegna non rispettate. Questi controlli rispondono a una domanda di affidabilità: i dati sono arrivati e si sono comportati come al solito?
Un'interfaccia di stato, come una UI di monitoraggio dell'affidabilità, può rendere visibili queste condizioni operative a ingegneri e stakeholder. Tuttavia, uno stato di freschezza pulito non rileverà un valore che arriva puntuale ma con un'unità di misura errata. Un rilevatore di anomalie potrebbe non accorgersi di un drift semantico graduale quando il nuovo comportamento diventa la nuova baseline.
Validazione e schema
I controlli di validazione codificano il significato di business. Possono verificare intervalli di valori, relazioni referenziali, condizioni obbligatorie, riconciliazioni e regole a livello di record. Questi controlli sono controlli di validità quando riflettono una definizione approvata del processo.
Il monitoraggio dello schema si colloca tra i due livelli. Protegge l'affidabilità rilevando le modifiche strutturali che possono rompere i consumatori e supporta la validità segnalando un cambio di tipo di campo o di colonna che può alterarne l'interpretazione. Il monitoraggio automatico dello schema può individuare colonne aggiunte o rimosse e tipi di dati modificati prima che i sistemi a valle falliscano (Monte Carlo descrive i meccanismi di monitoraggio delle modifiche di schema).
Cosa resta invisibile
Il lineage e le metriche a livello di colonna forniscono contesto sia sull'affidabilità sia sulla validità, ma non sempre generano lo stesso alert. Il lineage può mostrare quale trasformazione ha modificato un campo. Non sa necessariamente che una join ha introdotto una popolazione distorta. Un profilo di colonna può mostrare uno spostamento della distribuzione. Non stabilisce se tale spostamento riflette un evento di business reale o una definizione di metrica non valida.
Un approccio di data observability più ampio dovrebbe quindi combinare quattro coni sovrapposti:
Il monitoraggio delle anomalie rileva comportamenti inattesi.
Il monitoraggio della freschezza rileva problemi nei tempi di consegna.
Il monitoraggio dello schema rileva i cambiamenti strutturali.
Il monitoraggio della validazione verifica la correttezza semantica e di business.
È negli spazi tra questi coni che sopravvivono le decisioni stabili ma sbagliate.
Scenari reali in cui una fallisce senza l'altra
Un team finance può riconciliare i saldi di chiusura ogni notte e pubblicare comunque ricavi regionali errati. Supponiamo che una nuova tabella dei tassi di cambio inverta la direzione della conversione. La pipeline viene eseguita nei tempi previsti, i saldi si riconciliano all'interno della stessa logica difettosa e la freschezza resta verde. Il segnale di validità non viene messo in discussione perché nessun controllo confronta i valori convertiti con l'interpretazione autorevole del tasso.
Nel settore sanitario si crea una separazione simile tra consegna e significato. I conteggi degli accessi dei pazienti arrivano puntuali, con volumi stabili e i campi previsti, ma una modifica della codifica riclassifica le visite per patologie croniche come acute. I controlli di affidabilità vedono un feed affidabile. Una regola di validazione semantica legata allo standard di codifica o alla definizione del KPI avrebbe maggiori probabilità di far emergere il cambiamento. Senza di essa, l'organizzazione potrebbe interpretare un cambiamento di classificazione come una variazione delle performance sulle riammissioni.
I sistemi di telecomunicazione mostrano come un'aggregazione tecnicamente riuscita possa comunque rappresentare male l'attività. Le pipeline dei call detail record vengono eseguite secondo la pianificazione, ma un offset di fuso orario nel job di aggregazione fa sì che le chiamate serali vengano contate due volte. I controlli di freschezza, di schema e di volume di base possono restare nella norma perché i record sono presenti e strutturalmente corretti. Il controllo che colpisce il difetto è un controllo di validità sui confini delle finestre temporali, sull'unicità degli eventi o sulla riconciliazione con un totale di utilizzo affidabile.
I dati del settore pubblico possono superare i controlli strutturali pur fallendo quelli di rappresentatività. Un estratto del censimento corrisponde allo schema, ai tipi di colonna e alla pianificazione di consegna previsti, ma un aggiornamento della lista di campionamento sottostima le famiglie rurali. I record sono validi nel formato e affidabili nell'arrivo, ma la popolazione rappresentata dall'estratto non corrisponde più alla copertura prevista. Una regola di completezza limitata ai campi non nulli non dimostrerà che la lista di campionamento sottostante resta adatta allo scopo.
Cosa nasconde la dashboard verde
Scenario | Segnale di affidabilità | Segnale di validità | Conseguenza |
|---|---|---|---|
Finance | Consegna e riconciliazione stabili | Interpretazione errata dei tassi di cambio | Ricavi regionali distorti |
Sanità | Conteggi degli accessi puntuali | Significato della codifica cambiato | KPI sulle riammissioni distorto |
Telecomunicazioni | Elaborazione dei CDR nei tempi previsti | Errore di aggregazione dovuto al fuso orario | Chiamate serali contate due volte |
Settore pubblico | Schema e pianificazione corrispondenti | La lista di campionamento sottorappresenta le famiglie rurali | Stima della popolazione fuorviante |
Questi non sono esempi di pipeline guaste nel senso ristretto dell'engineering. Sono esempi di esecuzione corretta di una definizione errata. La dashboard è verde perché la piattaforma misura la salute operativa, mentre il business ha bisogno di evidenze sull'accuratezza della rappresentazione.
Scegliere quale livello privilegiare per primo
Quando affidabilità e validità si contendono il budget, i team non dovrebbero seguire automaticamente una sequenza da manuale. Dovrebbero dare priorità al livello in base a costo del guasto, rilevabilità e disagio per gli stakeholder. Un dataset in ritardo che blocca ogni report a valle richiede un primo investimento diverso rispetto a un dataset apparentemente valido che alimenta comunicazioni regolamentate o feature di machine learning.
Iniziate dall'affidabilità quando un problema di consegna crea danni operativi immediati. Ciò include SLA violati, partizioni mancanti, riavvii manuali ricorrenti e dashboard a cui i consumatori non riescono ad accedere quando ne hanno bisogno. In questi ambienti, i team di piattaforma hanno bisogno di un'orchestrazione affidabile, di aspettative di freschezza, di monitoraggio dei volumi e di una chiara responsabilità sugli incidenti prima di poter interpretare con sicurezza evidenze semantiche più approfondite.
Iniziate dalla validità quando un significato errato può restare nascosto. I KPI critici per i ricavi, il reporting esterno, i carichi di lavoro regolamentati e i dataset di addestramento dei modelli meritano controlli semantici fin da subito, perché i consumatori potrebbero non accorgersi del difetto. Un numero sbagliato ma stabile può arrivare molto più lontano di un job visibilmente fallito.
Criterio | Privilegiare prima l'affidabilità | Privilegiare prima la validità |
|---|---|---|
Raggio d'impatto | Un caricamento fallito blocca molti consumatori a valle | Una definizione errata contamina report, modelli o decisioni |
Esposizione all'audit | La preoccupazione immediata sono le evidenze di uptime operativo e di consegna | Comunicazioni regolamentari, finanziarie, cliniche o pubbliche dipendono dalla correttezza |
Tempo di rilevamento | I guasti sono visibili rapidamente tramite dati mancanti o pianificazioni interrotte | Gli errori possono restare plausibili e sfuggire al monitoraggio di routine |
Costo dei falsi positivi | I team possono tollerare alert operativi mentre stabilizzano la consegna | Troppi alert semantici possono interrompere flussi di lavoro consolidati senza una chiara responsabilità |
Disagio per i consumatori | Gli analisti aspettano i dati o eseguono recuperi manuali | Gli stakeholder agiscono su un risultato che sembra normale ma è sbagliato |
Una regola decisionale pratica
I team che eseguono analytics batch per dashboard interne spesso risolvono prima l'affidabilità, perché le interruzioni nella consegna dominano il lavoro quotidiano. I team che rilasciano feature per i modelli o pubblicano metriche esterne spesso risolvono prima la validità, perché il rischio principale è una rappresentazione errata silenziosa.
Non è una classifica di maturità. È una decisione di allocazione del rischio. Il primo livello di controllo dovrebbe colpire il guasto che gli stakeholder sono meno in grado di rilevare da soli. Una volta che quel livello è abbastanza stabile da produrre segnali interpretabili, aggiungete l'altro livello invece di considerare il primo investimento come un suo sostituto.
Costruire un programma combinato di affidabilità e validità
Il modello operativo più solido tratta affidabilità e validità come due cicli di controllo all'interno di un'unica piattaforma dati, non come un unico ampio progetto di qualità. Costruite prima il ciclo dell'affidabilità dove la consegna è instabile. Dovrebbe coprire la salute delle pipeline, le aspettative di freschezza, il comportamento del numero di righe e le modifiche strutturali. I segnali di validità provenienti da una pipeline guasta sono difficili da interpretare, quindi i team hanno bisogno di una baseline operativa affidabile.
Poi aggiungete il ciclo della validità. Definite regole di business a livello di record, documentate la semantica delle metriche, riconciliate gli output critici con i sistemi di riferimento e usate audit a campione mirati dove le regole automatiche non riescono a cogliere l'intero costrutto. Le indicazioni su regole di validazione dei dati e qualità dei dati continua sono utili per trasformare requisiti astratti di correttezza in controlli ripetibili.
Assegnare le responsabilità per tipo di guasto
Il team di piattaforma dovrebbe essere responsabile dei segnali di affidabilità, come job falliti, consegne mancanti, comportamenti di volume inattesi ed eventi di schema. L'analytics engineering e i domain steward dovrebbero essere responsabili della validità, perché comprendono le definizioni delle metriche, gli standard di codifica, i dati di riferimento e le conseguenze di business del drift semantico.
L'instradamento degli incidenti dovrebbe riflettere questa suddivisione. Una violazione di affidabilità può allertare l'ingegnere reperibile quando un caricamento è in ritardo o un contratto a valle è violato. Una violazione di validità dovrebbe essere instradata al data product owner e al domain steward quando una regola di business fallisce, una riconciliazione esce dalla sua interpretazione accettata o la definizione di una metrica cambia.
Livello di controllo | Cosa copre | Team responsabile | Segnale principale | Metrica di successo |
|---|---|---|---|---|
Affidabilità | Consegna, freschezza, ripetibilità, volume e stabilità strutturale | Team di data platform | Alert su pipeline, SLA, anomalie e schema | MTTR degli incidenti e rispetto degli SLA |
Validità | Significato di business, regole, unità di misura, relazioni e allineamento ai riferimenti | Analytics engineering e domain steward | Alert di validazione, riconciliazione e semantici | Tasso mensile di difetti di validità per dataset critico |
Contesto condiviso | Lineage, responsabilità, documentazione ed evidenze sugli incidenti | Team di piattaforma e di governance | Tracciabilità e registrazioni di audit | Diagnosi più rapida e responsabilità più chiare |
Una piattaforma come digna può eseguire rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema all'interno dell'ambiente del cliente, con controlli eseguiti nel database, così i dati restano dove sono. Questo modello si adatta alle organizzazioni che hanno bisogno di monitoraggio operativo e controlli semantici su data warehouse, data lake e pipeline senza trattare privacy, verificabilità e salute della consegna come prodotti separati.
Il programma dovrebbe dimostrare il proprio valore attraverso evidenze operative, non attraverso il numero di dashboard. Monitorate il tempo medio di risoluzione degli incidenti, il rispetto dei livelli di servizio e un tasso mensile di difetti di validità per ogni dataset critico. Esaminate queste misure insieme a ingegneri e responsabili di dominio, perché una pipeline può essere operativamente sana mentre una metrica di business non è più adatta allo scopo.
digna aiuta i team a monitorare il comportamento dei dati, la tempestività, le modifiche di schema, le anomalie e le regole di business a livello di record all'interno del proprio ambiente. Visitate digna per valutare come controlli separati di affidabilità e validità possano adattarsi ai vostri dataset critici.
Domande frequenti
Qual è la differenza tra affidabilità e validità dei dati?
L'affidabilità è coerenza in condizioni ripetibili; la validità è correttezza dell'oggetto della misurazione. Sono livelli di controllo distinti, ed è per questo che una pipeline può essere perfettamente stabile e produrre comunque decisioni sbagliate, mostrando totali identici in tre esecuzioni consecutive, tutti sbagliati allo stesso modo.
Quale errore affronta ciascuna?
L'affidabilità è legata all'errore casuale, che crea variazione tra un'esecuzione e l'altra. La validità affronta l'errore sistematico, che crea una distorsione stabile. È per questo che un numero coerente sembra affidabile: la coerenza nasconde la distorsione anziché rivelarla.
Quali sono le quattro prospettive sulla validità?
La validità di contenuto chiede se la metrica copre l'intero insieme di componenti di business che dichiara di coprire. La validità di costrutto chiede se coglie il concetto previsto anziché un comodo indicatore sostitutivo. La validità di criterio chiede se concorda con un riferimento affidabile. La validità di facciata chiede se il campo misura ciò che il suo nome suggerisce.
In che modo lo schema drift influisce sulla validità?
Compromette la validità di facciata, perché la struttura di un campo non corrisponde più al suo significato documentato. La colonna esiste ancora e continua a essere popolata, quindi i controlli di affidabilità restano verdi mentre il nome del campo ha smesso silenziosamente di descrivere ciò che ora contiene.
Come si verifica l'affidabilità nella pratica?
Ripetendo la misurazione in condizioni che non dovrebbero cambiare il risultato. Nel lavoro di ripetibilità di tipo laboratoriale, circa 10 repliche costituiscono un riferimento pratico, e l'equivalente per i dati è confrontare esecuzioni ripetute dello stesso calcolo prima di fidarsi del fatto che la stabilità significhi correttezza.


