Surveillance de l'intégrité des données : guide pratique pour 2026
|
7
minute de lecture

Vos tableaux de bord tombent rarement en panne de manière spectaculaire. Le plus souvent, quelqu'un de la finance ouvre une vue du chiffre d'affaires le lundi, voit les chiffres de la veille et en conclut que tout va bien. Sous la surface, pourtant, une table source a cessé de se rafraîchir, un job du week-end a manqué un chargement, et un modèle d'IA déjà entraîné sur les données de la semaine dernière prend désormais des décisions assurées à partir d'entrées obsolètes.
C'est pourquoi la surveillance de l'intégrité des données est aujourd'hui essentielle. Il ne s'agit ni d'une tâche de nettoyage en arrière-plan, ni de tests ponctuels. C'est une couche de contrôle continue qui détecte les ruptures de fraîcheur, de volume, de distribution, de schéma et de lignage, afin que les équipes repèrent les défaillances silencieuses avant les parties prenantes. Une revue académique présente ces cinq piliers comme le cadre de référence pour déterminer si les données arrivent à temps, conservent leurs propriétés statistiques attendues, restent complètes, préservent leur structure et gardent une provenance traçable, soit exactement le type de visibilité dont les pipelines modernes ont besoin revue académique.
Un modèle mental utile consiste à considérer la surveillance de l'intégrité comme le filet de sécurité entre les tests. Les tests vous indiquent si une règle connue est toujours respectée. La surveillance vous indique si le système a dérivé vers un état qui finira par casser le reporting, les modèles ou l'automatisation en aval. Si vous vous intéressez déjà à la détection d'anomalies, le guide d'ELECTE pour découvrir des schémas cachés dans les données constitue une lecture complémentaire pertinente, car les mêmes réflexes s'appliquent lorsque le schéma qui vous intéresse est la dégradation silencieuse d'un pipeline.
Si vous transposez cela à votre propre stack, la couche de tableaux de bord compte également. Une vue partagée des incidents, des tendances et des statuts devient bien plus utile lorsqu'elle s'appuie sur des contrôles continus et non sur de simples audits ponctuels. Les tableaux de bord de qualité des données de digna constituent une implémentation de référence pour ce type de visibilité et reflètent la même idée opérationnelle sous un autre angle.
Table des matières
Le moment où un tableau de bord tombe en panne sans que personne ne s'en aperçoive
Les cinq prismes de la surveillance de l'intégrité des données
Pourquoi la surveillance de l'intégrité est désormais une couche stratégique
Comparer les approches de surveillance qui fonctionnent vraiment
Les écueils courants qui minent la confiance dans la surveillance
Le moment où un tableau de bord tombe en panne sans que personne ne s'en aperçoive
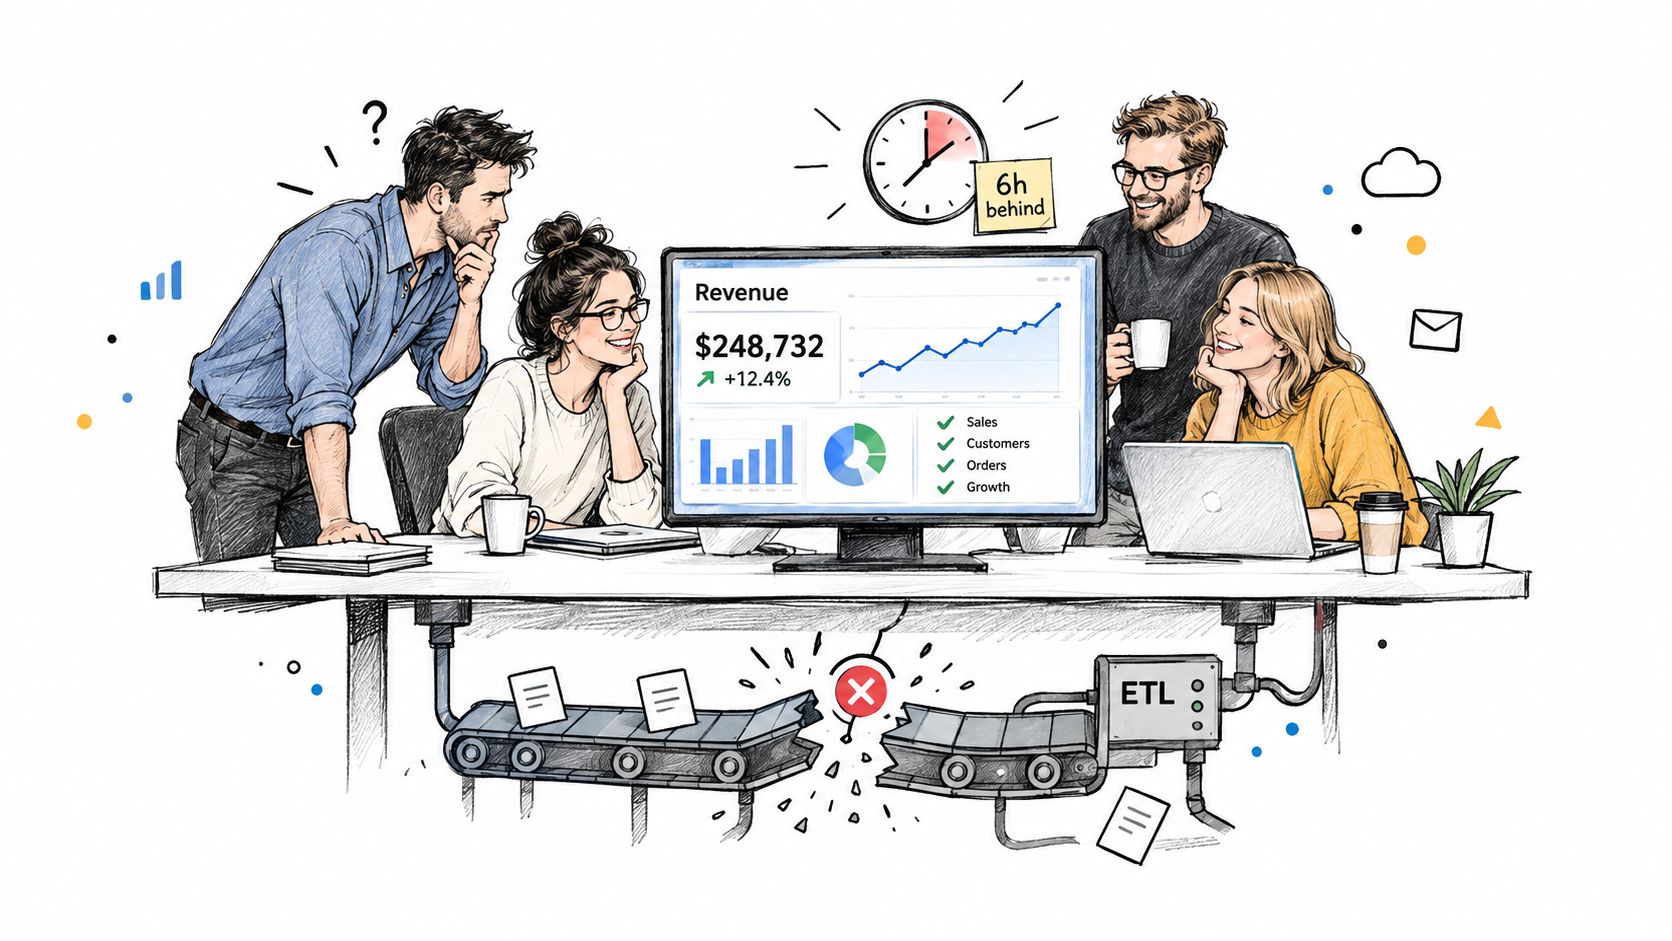
Le lundi commence par un message que personne n'aime recevoir. Le chargement de l'entrepôt de données qui devait aboutir pendant la nuit ne s'est pas terminé correctement, la table source a six heures de retard, et le tableau de bord de la direction affiche toujours le chiffre d'affaires de la veille sans le moindre bandeau d'erreur. L'équipe produit ne s'en aperçoit pas non plus, car le modèle de recommandation livré la semaine dernière continue de tourner sur l'ancienne cohorte.
C'est précisément le mode de défaillance pour lequel la surveillance de l'intégrité des données a été conçue. L'objectif est d'observer les données elles-mêmes, en continu, afin que les chargements obsolètes, les enregistrements manquants, les changements de schéma et les chaînes de dépendances rompues apparaissent tant qu'il est encore temps d'agir.
Une défaillance bruyante est facile à repérer. Le pipeline casse, une alerte se déclenche et quelqu'un est appelé. Une défaillance silencieuse est plus difficile à détecter, car les chiffres paraissent toujours crédibles alors que les données sous-jacentes ont suffisamment dérivé pour fausser une décision.
Règle pratique : si un contrôle ne se déclenche qu'après la plainte d'une partie prenante, il est trop tard pour parler de surveillance.
C'est aussi pourquoi cette couche diffère des tests ponctuels. Les tests interviennent généralement autour des points de déploiement ou de validation. La surveillance de l'intégrité des données se situe au cœur du cycle de vie et observe l'état réel du pipeline à mesure qu'il évolue, comme une salle de contrôle qui continue de vérifier les jauges pendant que la machine tourne déjà.
Cette distinction est importante pour les équipes qui gèrent à la fois l'analytique et le ML. Un modèle peut continuer à produire des prédictions alors que la table d'entrée est obsolète, que le schéma a changé ou qu'un flux source a cessé d'envoyer des lignes. Rien ne plante, mais la logique métier se dégrade malgré tout. C'est pourquoi la couche de surveillance doit vérifier à la fois si le job s'est exécuté et si les données restent fiables.
Les dispositifs les plus solides corrèlent également plusieurs signaux à la fois. La fraîcheur seule peut passer à côté d'une duplication. Le volume seul peut manquer un changement de schéma qui supprime une colonne sans modifier le nombre de lignes. Les contrôles de schéma seuls peuvent manquer un fichier arrivé intact mais trop tard pour alimenter le reporting. Les tableaux de bord de qualité des données de digna constituent une implémentation de référence pour ce type de visibilité et montrent comment des vues d'incidents peuvent côtoyer des contrôles continus. Pour examiner de plus près comment l'observabilité et les vues d'incidents s'articulent, un tableau de bord d'incidents partagé est utile, car il reflète le type de visibilité opérationnelle dont les équipes ont besoin dès qu'elles dépassent les vérifications manuelles ponctuelles.
Les cinq prismes de la surveillance de l'intégrité des données
Pensez au service de triage d'un hôpital. Un médecin ne pose pas de diagnostic à partir d'un seul signal. Il prend le pouls, pose des questions, examine les analyses sanguines, consulte l'imagerie et compare l'état actuel avec les antécédents et l'historique familial. Les pipelines de données méritent la même rigueur.

Fraîcheur, volume, distribution, schéma et lignage
La fraîcheur indique si les données sont arrivées à temps. Si votre flux de ventes arrive habituellement avant 6 h et qu'il n'est toujours pas là à 8 h, ce n'est pas un problème théorique : c'est un reporting obsolète. Il en va de même pour les jobs batch en retard, les chargements incrémentiels manqués et les flux partenaires retardés. Un guide sur l'observabilité des données regroupe la fraîcheur avec la disponibilité, le volume et les changements de schéma parmi les contrôles essentiels de la surveillance des jeux de données guide dasca.
Le volume porte sur le nombre de lignes, la taille des fichiers et d'autres signaux de comptage. Une chute soudaine peut signifier qu'un extracteur en amont a échoué. Un pic soudain peut indiquer des doublons ou un retraitement accidentel. Le chiffre en lui-même n'explique pas la cause, mais il vous signale que quelque chose a changé.
La distribution couvre les plages de valeurs, les taux de valeurs nulles, la cardinalité et les motifs de valeurs. Les pics soudains de valeurs nulles, les déséquilibres entre catégories et les valeurs hors norme apparaissent ici. C'est la différence entre « la table s'est chargée » et « les données ressemblent toujours au même type de données ».
Le schéma détecte les colonnes ajoutées, supprimées, renommées ou dont le type a changé. Ces modifications sont souvent la raison pour laquelle le SQL en aval casse ou pour laquelle les modèles dbt commencent à renvoyer des résultats incomplets. Un changement structurel passe facilement inaperçu si vous ne vérifiez que la réussite des jobs.
Le lignage retrace la provenance des données et ce qui en dépend. C'est essentiel lorsque vous devez savoir si un défaut est apparu dans une extraction source, une transformation ou un consommateur en aval. C'est aussi ce qui permet aux équipes de comprendre pourquoi un seul champ défectueux peut affecter plusieurs tableaux de bord à la fois.
Un signal isolé peut révéler un symptôme. Des signaux corrélés révèlent la cause.
C'est la leçon essentielle. Une surveillance mature ne se contente pas de réagir à une seule anomalie. Elle corrèle plusieurs prismes afin que les équipes puissent distinguer une table obsolète, une variation saisonnière de l'activité et une véritable rupture de pipeline. Si vous souhaitez un exemple pratique de la façon dont ces signaux s'articulent dans une vue de surveillance, la page observabilité des données de digna correspond étroitement à ce modèle à cinq prismes.
Pourquoi la surveillance de l'intégrité est désormais une couche stratégique
Il y a quelques années, de nombreuses équipes considéraient la qualité des données comme un travail de nettoyage. On corrigeait les lignes erronées, on rafistolait le tableau de bord et on passait à autre chose. Cet état d'esprit ne tient plus dès lors que l'analytique et l'IA pilotent des décisions à grande échelle.
L'évolution du secteur se voit dans les chiffres d'adoption. Une enquête de 2026 a montré que seules 35 à 36 pour cent environ des organisations surveillent ou optimisent activement leurs programmes d'intégrité des données, tandis qu'environ 15 à 16 pour cent en sont encore au stade de la pré-planification enquête. La pratique est donc entrée dans les opérations courantes, mais elle est encore loin d'être universelle.
Pourquoi l'IA accroît les enjeux
Les systèmes d'IA ne se contentent pas de consommer des données, ils les amplifient. Si l'entrée est obsolète, incomplète ou structurellement modifiée, le modèle peut tout de même produire un résultat d'apparence impeccable. Ce résultat peut être faux, mais il paraîtra souvent assuré, et c'est précisément ce qui rend le problème dangereux.
C'est pourquoi la surveillance de l'intégrité n'est plus une simple question d'hygiène technique. Elle sert de plan de contrôle pour la préparation à l'IA, car les équipes ont besoin de preuves que les données qui alimentent l'analytique et les modèles sont à jour, complètes et traçables. Elle facilite également la gouvernance et l'auditabilité, car le lignage et les changements structurels deviennent visibles au lieu d'être enfouis dans des journaux ad hoc.
Qui est concerné, et pourquoi
Moteur | Partie prenante | Ce qui casse sans surveillance |
|---|---|---|
Préparation à l'IA | Équipes data et ML | Les modèles s'entraînent ou calculent des scores sur des données obsolètes, incomplètes ou structurellement modifiées |
Gouvernance | Équipes risques et conformité | Les équipes ne peuvent pas prouver ce qui a changé, quand, ni ce qui a été affecté |
Fiabilité opérationnelle | Équipes plateforme et analytique | Les tableaux de bord, les transformations et les consommateurs en aval dérivent avant que quiconque ne s'en aperçoive |
L'enjeu stratégique est simple. Sans surveillance de l'intégrité des données, le coût ne se limite pas à un tableau de bord erroné. C'est une chaîne de mauvaises décisions, prises plus vite grâce à l'automatisation. Pour les équipes qui évaluent leurs contrôles opérationnels, l'approche présentée dans la surveillance de la qualité des données de digna est utile, car elle traite l'intégrité comme un contrôle permanent plutôt que comme un nettoyage ponctuel.
Comparer les approches de surveillance qui fonctionnent vraiment
Toutes les approches de surveillance ne conviennent pas partout. La bonne conception dépend de l'emplacement des données, de la vitesse à laquelle elles évoluent et du volume de bruit que votre équipe peut absorber. Les meilleurs programmes combinent généralement plusieurs méthodes au lieu de tout miser sur une seule.
Points forts et limites de chaque approche
L'exécution en base de données maintient les contrôles au plus près des données. Cela réduit les déplacements de données, ce qui est important dans les environnements sécurisés ou à fort volume, et convient aux équipes qui souhaitent que la logique de validation s'exécute là où se trouve déjà l'entrepôt ou le lac de données. Le compromis est toutefois évident : vous héritez des contraintes de la plateforme utilisée, de sorte que la portabilité peut être plus limitée qu'avec des outils externes.
Les scanners externes offrent davantage de flexibilité entre les systèmes. Ils peuvent inspecter des fichiers, des API, des entrepôts de données et des applications en aval depuis l'extérieur de la base de données. Cette flexibilité a un coût, en particulier lorsque les environnements prennent de l'ampleur ou que vous cherchez à limiter la latence.
Les seuils basés sur des règles sont faciles à comprendre. Ils détectent les ruptures évidentes, comme une table qui ne devrait jamais descendre sous un nombre minimal de lignes ou un flux qui doit arriver à une heure fixe. Ils sont en difficulté lorsque l'activité est saisonnière, car une limite statique peut signaler un changement normal comme un problème.
Les références apprises par l'IA s'adaptent mieux à ce type de variation. Elles sont utiles lorsqu'un jeu de données présente des cycles hebdomadaires, une dérive progressive ou un historique désordonné. Elles nécessitent toutefois une période d'apprentissage, et l'équipe doit accepter que la confiance initiale soit plus faible qu'avec une règle fixe.
Utilisez des règles statiques pour les invariants connus, des références apprises pour les comportements changeants et la corrélation multi-signaux lorsqu'un seul symptôme ne suffit pas.
Ce dernier point est le plus important. Une alerte isolée sur la fraîcheur peut n'être que du bruit. La fraîcheur combinée au volume et à la dérive de schéma raconte une histoire plus crédible. Une équipe qui souhaite garder les contrôles au plus près de l'entrepôt tout en assurant une large couverture peut consulter le vérificateur d'intégrité des données de digna, un exemple de la manière dont ces éléments peuvent être combinés sans traiter tous les signaux de la même façon.
Approche | Point fort | Limite | Cas d'usage idéal |
|---|---|---|---|
Exécution en base de données | Faible déplacement des données, très adaptée aux environnements gouvernés | Moins portable d'une plateforme à l'autre | Contrôles d'entrepôt à fort volume |
Scanners externes | Large couverture entre les systèmes | Surcharge plus importante à grande échelle | Environnements multisystèmes et multi-outils |
Seuils basés sur des règles | Clairs et faciles à expliquer | Fragiles lors des variations saisonnières | Règles métier fixes et limites strictes |
Références apprises par l'IA | S'adaptent à la variation normale | Nécessitent une période d'apprentissage et des ajustements | Jeux de données volatils ou changeants |
Corrélation multi-signaux | Réduit les faux signaux et améliore le diagnostic | Davantage de travail de conception en amont | Programmes de surveillance matures |
Modèles de mise en œuvre et bonnes pratiques
La plupart des programmes de surveillance échouent parce qu'ils veulent en faire trop, trop tôt. Un meilleur déploiement commence par apprendre la forme normale du pipeline, puis n'ajoute des alertes qu'une fois que l'équipe a compris à quoi ressemble réellement la « normalité ».
Le repère à garder à l'esprit est l'échelle. Un jeu de données de surveillance cité a relevé une moyenne de 42 métriques distinctes par pipeline, dont la fraîcheur, la variance de volume, la dérive de schéma et la latence de traitement querysurge. Cela ne signifie pas que chaque équipe doive déclencher des alertes sur les 42 en même temps. Cela signifie que les programmes matures observent plusieurs signaux et les exploitent ensemble.

Un déploiement qui ne submerge pas l'équipe
Apprenez d'abord la référence. Exécutez les contrôles en mode observation avant d'alerter qui que ce soit. Les équipes doivent connaître le rythme quotidien ordinaire avant de pouvoir juger si un changement est réel.
Priorisez selon l'impact métier. Commencez par la fraîcheur, le volume, le schéma et les contrôles de distribution qui protègent les jeux de données les plus visibles. Ne dispersez pas l'équipe sur toutes les tables simplement parce que l'outillage le permet facilement.
Utilisez des seuils dynamiques. Définissez des limites par actif plutôt qu'un seuil global unique. Un flux de ventes, un flux clinique et un flux d'utilisation télécom n'ont pas le même comportement normal.
Affinez grâce aux retours. Chaque incident résolu doit améliorer l'alerte suivante. Si une notification était trop bruyante, ajustez-la. Si elle a détecté tôt une véritable rupture, conservez le modèle et élargissez-le éventuellement.
La responsabilité compte tout autant que la logique d'alerte. Chaque actif surveillé doit avoir un responsable désigné, car les alertes sans propriétaire deviennent des tickets abandonnés. Une revue trimestrielle de la couverture est également utile, car les pipelines évoluent plus vite que les cartographies de surveillance statiques.
La version opérationnelle de cette réflexion apparaît clairement dans la mise en œuvre de la qualité des données de digna, où la rigueur du déploiement compte autant que les contrôles eux-mêmes.
Les écueils courants qui minent la confiance dans la surveillance
La surveillance perd rapidement sa crédibilité lorsqu'elle se comporte comme une alarme trop bruyante. Les équipes ne cessent pas de lui faire confiance parce que l'idée est mauvaise, mais parce que l'implémentation est agaçante, fragile ou aveugle aux véritables modes de défaillance.
Les défaillances observées dans les programmes réels
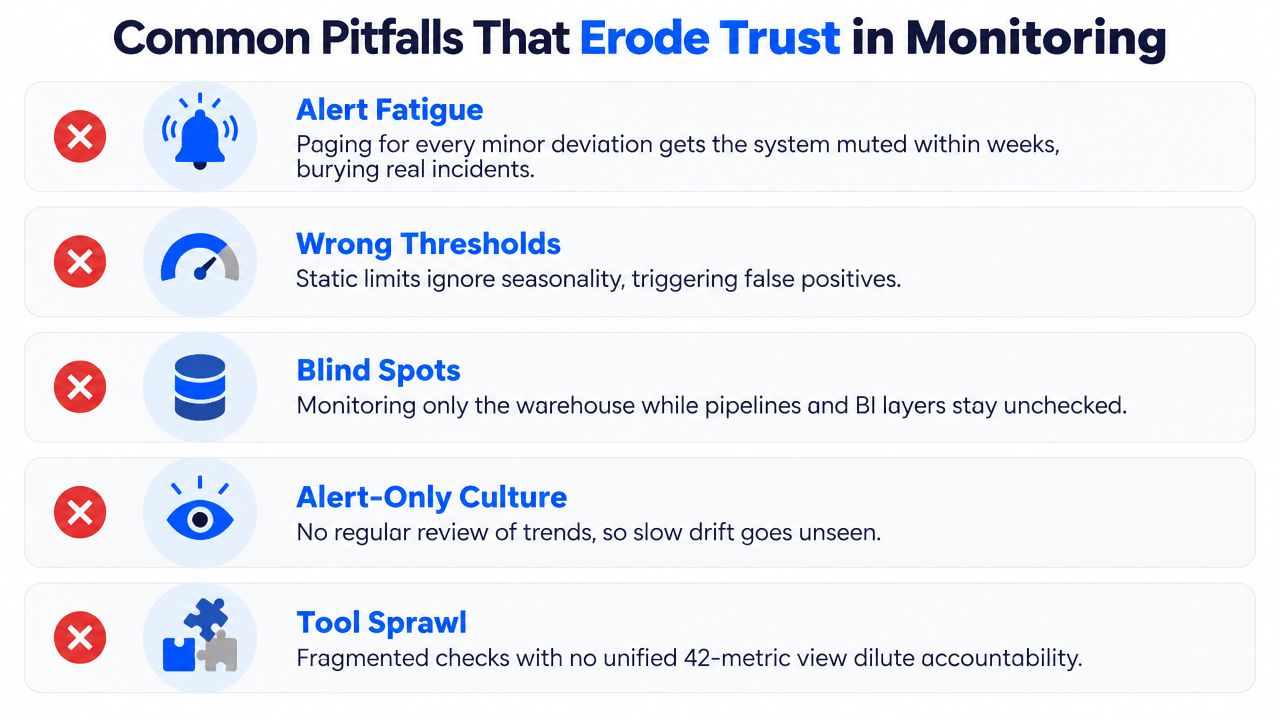
La fatigue d'alerte est le moyen le plus rapide de perdre l'adhésion des équipes. Si le système alerte pour chaque écart mineur, les gens le mettent en sourdine, et la véritable panne passe alors inaperçue.
Les seuils inadaptés engendrent une autre forme de méfiance. Les limites statiques ignorent la saisonnalité, les promotions, les pics de fin de mois et les autres rythmes de l'activité, si bien que des variations parfaitement normales ressemblent à des incidents.
Les angles morts apparaissent lorsque les équipes ne surveillent que l'entrepôt de données et ignorent les étapes du pipeline et la couche BI qui le consomment. Il en résulte un faux sentiment de couverture.
La culture du tout-alerte est une autre défaillance silencieuse. Si personne n'examine les tendances, le système passe à côté des dérives lentes qui ne franchissent jamais le seuil strict avant d'être déjà visibles pour les utilisateurs.
La prolifération des outils rend les responsabilités floues. Des contrôles fragmentés et dispersés entre plusieurs systèmes forment rarement une vision opérationnelle unique, d'où l'importance d'une vue unifiée.
La confiance naît d'alertes moins nombreuses et plus pertinentes, pas d'un surcroît de bruit.
Les contre-mesures sont simples, mais pas facultatives. Utilisez des niveaux de gravité, rattachez les seuils au comportement de référence, ajoutez des abonnements aux changements de schéma et inscrivez une cadence de revue au calendrier. Surtout, traitez la surveillance comme un contrôle vivant, et non comme un projet déclaré terminé après son lancement.
Enjeux sectoriels pour les données réglementées
La même logique de surveillance s'applique différemment selon le secteur. Une équipe financière, un groupe d'analytique hospitalière, un opérateur télécom et un organisme public se soucient tous de l'intégrité, mais ils ne redoutent pas les mêmes points de rupture.
Quatre exemples, quatre schémas de défaillance différents
Dans les services financiers, la défaillance la plus dangereuse est souvent un flux de risque obsolète ou décalé. Un modèle peut continuer à évaluer des transactions alors que le signal de fraude sous-jacent est ancien, ce qui peut fausser à la fois les décisions et les pistes d'audit.
Dans le secteur de la santé, le point critique est le changement structurel. Une colonne de diagnostic renommée peut faire basculer silencieusement des cas graves dans la mauvaise catégorie, si bien que le problème apparaît dans le reporting clinique bien avant que quiconque ne remarque le problème de schéma.
Dans les télécommunications, la difficulté tient généralement à l'échelle et à la volatilité. Un tableau de bord d'attrition peut passer à côté d'une panne régionale si les tables de revenus ou d'utilisation continuent de se charger normalement tandis qu'un autre flux prend du retard.
Dans le secteur public, les ruptures de dépendances apparaissent souvent dans les processus d'éligibilité ou de prestations. Un changement de schéma chez un fournisseur peut empêcher une jointure de faire correspondre correctement les enregistrements, ce qui crée en aval des problèmes de service difficiles à démêler après coup.
Secteur | Principal risque pour l'intégrité | Signal le plus utile | Enjeux réglementaires |
|---|---|---|---|
Services financiers | Données de risque obsolètes ou décalées | Fraîcheur et lignage | Auditabilité et contrôles du reporting |
Santé | Changement structurel silencieux | Schéma et distribution | Fiabilité clinique et traçabilité |
Télécommunications | Dérive des pipelines à fort volume | Volume et fraîcheur | Continuité opérationnelle et exactitude du service |
Secteur public | Jointures rompues après des changements chez un fournisseur | Schéma et lignage | Éligibilité aux services, redevabilité et intégrité des registres |
L'erreur consiste à supposer qu'une configuration unique convient à tous. Le cadre est le même, mais la pondération change. Un environnement réglementé a besoin de signaux ajustés à la défaillance qu'il peut le moins se permettre de manquer, et non d'une liste de contrôle générique copiée sur la stack d'une autre équipe.
Tout réunir avec digna
La panne de tableau de bord évoquée en introduction, le cadre à cinq prismes, le repère des 42 métriques et les exemples sectoriels mènent tous à la même conclusion. La surveillance de l'intégrité des données fonctionne lorsqu'elle devient une couche de contrôle continue, et non une tâche d'inspection occasionnelle.

Un point de référence pratique
digna est un moyen de mettre en œuvre ce modèle dans l'environnement même du client, avec des contrôles exécutés en base de données qui couvrent la fraîcheur, le volume, la distribution, le schéma et le lignage dans une configuration modulaire. Il s'inscrit également dans le schéma de déploiement décrit plus haut, où les références sont établies en premier et où les alertes ne se resserrent qu'une fois que le système a compris le comportement normal.
Quelques points sont ici essentiels :
Cinq prismes appliqués. La même suite peut surveiller conjointement la ponctualité, les changements structurels, le contexte des dépendances et les écarts par rapport à la référence.
Une approche à 42 métriques. Une surveillance mature ne se résume pas à un contrôle par table : c'est un ensemble de signaux dimensionné selon le jeu de données et le risque.
Déploiement progressif. L'observation précède les alertes, ce qui maintient l'utilité du programme au lieu de le rendre bruyant.
Préservation de la confiance. Des seuils ajustés permettent de s'assurer que l'équipe n'est réveillée que lorsqu'une intervention est réellement nécessaire.
La prochaine étape concrète est simple. Choisissez un pipeline critique, configurez les cinq prismes, apprenez la référence et laissez les anomalies apparaître avant que les utilisateurs ne les découvrent. Si vous souhaitez une référence concrète pour ce type de configuration, rendez-vous sur digna et évaluez dans quelle mesure son approche de surveillance convient au pipeline sur lequel vous ne pouvez pas vous permettre d'erreur.
Pour les références apprises par l'IA décrites plus haut, qui s'adaptent aux cycles hebdomadaires et aux dérives progressives au lieu de reposer sur des seuils statiques, découvrez comment digna Data Anomalies apprend le comportement normal de chaque jeu de données.
Questions fréquentes
Qu'est-ce que la surveillance de l'intégrité des données ?
La surveillance de l'intégrité des données est une couche de contrôle continue qui observe les données en production pour détecter les ruptures de fraîcheur, de volume, de distribution, de schéma et de lignage. Contrairement aux tests ponctuels exécutés lors du déploiement, elle se situe au cœur du cycle de vie du pipeline, afin que les chargements obsolètes, les enregistrements manquants et les changements de schéma apparaissent avant que les parties prenantes ne les remarquent.
Quels sont les cinq piliers de la surveillance de l'intégrité des données ?
Les cinq prismes sont la fraîcheur, le volume, la distribution, le schéma et le lignage. La fraîcheur vérifie si les données sont arrivées à temps, le volume suit le nombre de lignes et la taille des fichiers, la distribution couvre les taux de valeurs nulles et les motifs de valeurs, le schéma détecte les colonnes ajoutées ou renommées, et le lignage montre où un défaut est apparu et ce qui en dépend.
En quoi la surveillance de l'intégrité des données diffère-t-elle des tests de données ?
Les tests vérifient si une règle connue est toujours respectée, généralement autour des points de déploiement ou de validation. La surveillance observe l'état réel du pipeline et détecte les dérives qui casseront plus tard les rapports ou les modèles. La règle empirique de l'article : si un contrôle ne se déclenche qu'après la plainte d'une partie prenante, ce n'est pas de la surveillance.
Combien de métriques faut-il surveiller par pipeline de données ?
Un jeu de données de surveillance cité a relevé une moyenne de 42 métriques distinctes par pipeline, couvrant la fraîcheur, la variance de volume, la dérive de schéma et la latence de traitement. Cela ne signifie pas qu'il faille déclencher des alertes sur les 42 à la fois : les programmes matures observent de nombreux signaux et les corrèlent, en commençant par les jeux de données qui ont le plus d'impact métier.
Comment déployer la surveillance de l'intégrité des données sans fatigue d'alerte ?
Commencez en mode observation pour apprendre la référence avant d'alerter qui que ce soit, puis priorisez les jeux de données les plus visibles. Définissez des seuils dynamiques par actif plutôt qu'un seuil global unique, ajustez chaque alerte bruyante après un incident, attribuez un responsable désigné à chaque actif surveillé et révisez la couverture chaque trimestre.


