Traitement en base de données
|
7
minute de lecture

Le traitement en base de données exécute l'analytique et la surveillance directement dans le moteur de base de données du client : les données restent en place et la surcharge liée aux transferts disparaît. C'est d'autant plus important lorsque votre entrepôt de données est volumineux, sensible, ou les deux, car le choix ne porte pas seulement sur la vitesse, mais sur le fait que le contrôle s'effectue là où les données résident déjà.
C'est généralement le lundi matin que la faiblesse apparaît en premier. Un tableau de bord n'est plus à jour, un rapport financier perd des lignes ou une alerte de fraîcheur se déclenche alors que les utilisateurs métier ont déjà remarqué le problème, et la cause profonde est souvent la même : les données ont dû quitter un système avant de pouvoir être analysées dans un autre.
Table des matières
Évolution et fonctionnement du traitement en base de données
Exécution en base de données ou processus d'extraction-analyse
Comment digna exécute l'observabilité dans votre entrepôt de données
Quand le traitement en base de données n'est pas le bon choix
Cas d'usage sectoriels exigeant la fiabilité du traitement en base de données
Prendre la décision : le traitement en base de données convient-il à votre stack ?
Quand le déplacement des données casse vos tableaux de bord
La défaillance commence généralement sans prévenir. Un flux de l'entrepôt de données arrive à l'heure, le job d'extraction s'exécute et le moteur externe reçoit ce qui ressemble à une copie propre. Puis un retard en amont, une colonne mal formée ou un lot trop volumineux fait dériver les chiffres juste assez pour que le tableau de bord ne corresponde plus à ce qu'attend l'activité.
C'est tout l'intérêt du traitement en base de données. Le moteur de base de données effectue le travail là où les données se trouvent déjà, ce qui permet aux équipes d'éviter l'étape d'extraction qui ajoute de la latence, crée des copies supplémentaires et élargit la surface d'exposition. Les arguments historiques en faveur de ce modèle sont constants depuis le milieu des années 1990, mais son adoption à plus grande échelle n'est intervenue qu'au milieu des années 2000, lorsque l'analytique est passée des postes de travail externes aux entrepôts de données d'entreprise et que les bases de données orientées colonnes ont rendu possibles l'analyse et l'agrégation côté entrepôt. L'historique du traitement en base de données illustre clairement cette trajectoire.

Un bon exemple de tableau de bord permet de cerner le problème. Si la métrique que vous suivez est déjà dérivée de tables de l'entrepôt, extraire ces tables vers un autre moteur simplement pour vérifier leur fraîcheur ou une dérive de schéma crée un second point de défaillance. Pour un aperçu rapide de la façon dont les surfaces de reporting sont généralement conçues, parcourez les exemples de tableaux de bord GTM de Yalc et observez comment les métriques opérationnelles dépendent de données sources propres et à jour.
Règle pratique : si un contrôle peut échouer parce que les données ont dû être déplacées, l'architecture fait déjà plus de travail que ce que l'utilisateur a demandé.
C'est pourquoi les plateformes d'observabilité modernes considèrent de plus en plus l'entrepôt de données lui-même comme le lieu d'exécution. Un moteur distinct peut rester utile, mais le coût du déplacement de données réglementées et volumineuses l'emporte souvent sur la commodité d'un processus externe. Les équipes qui maintiennent les calculs à proximité des données obtiennent généralement un meilleur contrôle de la gouvernance et évitent le décalage gênant entre « la source est correcte » et « la copie de reporting est erronée ».
Si vous constatez déjà des tables en double, des tableaux de bord en retard ou un travail de rapprochement qui se répète chaque matin, le problème ne vient probablement pas de la définition de vos métriques. Il vient de l'étape supplémentaire.
Pour un mode de défaillance connexe, découvrez comment la redondance des données crée des anomalies dans les systèmes d'analytique et de reporting, car les copies en double expliquent souvent pourquoi une équipe fait confiance aux chiffres et une autre non.
Évolution et fonctionnement du traitement en base de données
Cette architecture n'est pas apparue du jour au lendemain. Les systèmes d'analytique en base de données sont devenus commercialement pertinents au milieu des années 1990, puis se sont plus largement imposés au milieu des années 2000, lorsque les équipes en charge des entrepôts de données ont cessé de considérer que l'analytique devait se dérouler sur un poste de travail distinct. L'idée clé était simple : garder les données en place, limiter leurs déplacements et effectuer le travail statistique là où elles résidaient déjà.
Un jalon souvent cité de cette évolution est la conférence Teradata Partners d'Orlando, du 18 au 22 septembre 2005, lors de laquelle Thomas Tileston a présenté l'idée d'accélérer l'exploration de données en combinant SAS et Teradata au sein de l'entrepôt. Ce moment a compté, car il a transformé une optimisation de niche en modèle d'entreprise. Les bases de données orientées colonnes, conçues pour l'analytique, l'entreposage et le reporting, ont rendu l'approche praticable en améliorant la manière dont les systèmes parcourent et agrègent de grands jeux de données.

De l'accélération des entrepôts de données à l'analytique native en base de données
Les systèmes modernes s'exécutent désormais directement dans le moteur de base de données au lieu d'extraire les données en mémoire de travail. La documentation d'IBM indique que travailler sur les données dans la base évite les problèmes de sécurité liés à leur extraction, et le projet MADlib se présente comme une bibliothèque SQL d'apprentissage automatique, d'exploration de données et de statistiques qui s'exécute à grande échelle dans le moteur de base de données, sans import ni export vers d'autres outils. Sur le plan architectural, l'analytique devient une préoccupation de la base de données, et non un composant annexe.
Les fonctions analytiques en base de données de Teradata ont poussé cette logique plus loin avec un modèle de bibliothèque étendu, et une source citée fait état de plus de 200 fonctions analytiques dans une architecture shared-nothing, notamment pour le profilage, les statistiques descriptives et l'échantillonnage. C'est cette étendue qui explique pourquoi le modèle a survécu au-delà des premiers réglages d'entrepôts et est devenu utile pour les opérations à forte exigence de gouvernance.
Le compromis pratique demeure. À mesure que la base de données prend en charge davantage de logique, les performances dépendent de la planification des requêtes, de l'indexation, de la localité mémoire et de l'exécution vectorisée. Un moteur bien réglé peut en faire un atout, mais un moteur mal réglé transforme le traitement en base de données en goulet d'étranglement.
L'historique est important, car il explique pourquoi cette approche n'a plus rien d'expérimental. Les équipes n'adoptent pas une astuce ingénieuse : elles utilisent un modèle d'exécution mature, déjà façonné par les contraintes des entrepôts de données à grande échelle.
Si vous comparez les modèles modernes de stockage et d'exécution, l'article qu'est-ce qu'un format de table ouvert est une lecture connexe utile, car la question du stockage ouvert recoupe souvent celle de l'endroit où l'analytique doit s'exécuter.
Exécution en base de données ou processus d'extraction-analyse
La question essentielle est de savoir où le travail doit être effectué, et quelles sont les conséquences de ce choix sur la sécurité, la latence et la complexité opérationnelle.
Dimension | Traitement en base de données | Processus d'extraction-analyse |
|---|---|---|
Déplacement des données | Les calculs restent là où résident les données, ce qui réduit les déplacements au minimum | Les données sont copiées ou exportées avant l'analyse, ce qui ajoute une surcharge de transfert |
Posture de sécurité | Les données peuvent rester dans l'environnement du client, ce qui facilite la gestion des jeux de données réglementés | Davantage de copies et de transferts externes élargissent la surface d'exposition |
Profil de performance | Dépend de la planification des requêtes, de l'indexation, de la localité mémoire et du comportement de pushdown | Dépend de la vitesse de transfert, de la zone de transit et du profil de calcul du moteur externe |
Cas d'usage idéal | Charges de travail d'entrepôt volumineuses, sensibles ou sensibles à la latence | Analyses légères, exploration ad hoc ou systèmes qui prévoient déjà des exports |
Risque opérationnel | Peut surcharger la production si le moteur est trop sollicité | Peut s'écarter de la source et créer une vérité obsolète ou dupliquée |
L'exécution en base de données maintient les jeux de données volumineux ou sensibles dans le système de référence, si bien qu'aucun autre moteur n'a besoin de les lire via le réseau. C'est important dans les environnements d'entreprise où l'entrepôt source porte déjà des exigences de gouvernance, de contrôle d'accès et d'audit. Le compromis n'a rien de théorique. Le moteur de base de données a désormais davantage de travail, de sorte que de mauvais plans d'exécution, une indexation insuffisante ou une forte charge concurrente peuvent ralentir à la fois les jobs de production et les contrôles d'observabilité.
Les recommandations d'IBM sur l'analytique en base de données indiquent clairement que garder les données dans la base évite les problèmes de sécurité liés à leur extraction, ce qui explique pourquoi ce modèle est fréquent dans les environnements réglementés. Pour une comparaison pratique entre l'exécution en base de données, plus sûre, et les pipelines externes, consultez la comparaison entre traitement en base de données et pipelines externes.
La dérive de schéma accentue la différence. L'article comment la redondance crée des anomalies dans les systèmes d'analytique et de reporting explique pourquoi les copies supplémentaires créent souvent des versions contradictoires d'un même fait. Lorsque l'observabilité, les contrôles qualité ou la détection d'anomalies s'exécutent en dehors de l'entrepôt de données, les équipes passent souvent plus de temps à rapprocher des copies qu'à corriger le problème sous-jacent.
Dans quels cas chaque approche s'impose
Le traitement en base de données s'impose lorsque les données sont trop sensibles pour être déplacées, trop volumineuses pour être copiées fréquemment ou trop importantes pour ne pas être inspectées au plus près de leur arrivée.
L'extraction-analyse s'impose lorsque le jeu de données est petit, que la logique est expérimentale ou que l'entrepôt ne doit pas supporter de charge analytique supplémentaire.
Les modèles hybrides s'imposent lorsque la gouvernance doit rester proche de l'entrepôt, mais que le travail exploratoire nécessite un environnement distinct.
Les études de type benchmark sur les charges de travail d'entrepôt mesurent le temps de réponse, le débit et le coût total. Les benchmarks temps réel vérifient si un système peut absorber des flux entrants sans délai. C'est important, car les contrôles d'observabilité se comportent comme des charges de travail d'entrepôt sensibles à la latence, et non comme des jobs de reporting hors ligne.
Comment digna exécute l'observabilité dans votre entrepôt de données
digna effectue le calcul des métriques dans les propres bases de données du client : les données restent en place pendant que la plateforme les évalue. C'est le modèle adapté aux équipes qui placent la gouvernance au premier plan, car la couche d'observabilité n'a pas besoin de copier les données de production ailleurs avant de pouvoir en inspecter la fraîcheur, le schéma ou le comportement.
Le modèle opérationnel repose sur cinq dimensions : fraîcheur, volume, schéma, distribution et lignage. Ce sont les mécanismes concrets de la surveillance du comportement des données, et pas seulement de la vérification ponctuelle du respect d'une règle. Un entrepôt peut paraître sain sur un lot et dériver sur un autre ; les contrôles doivent donc suivre les données dans le temps.
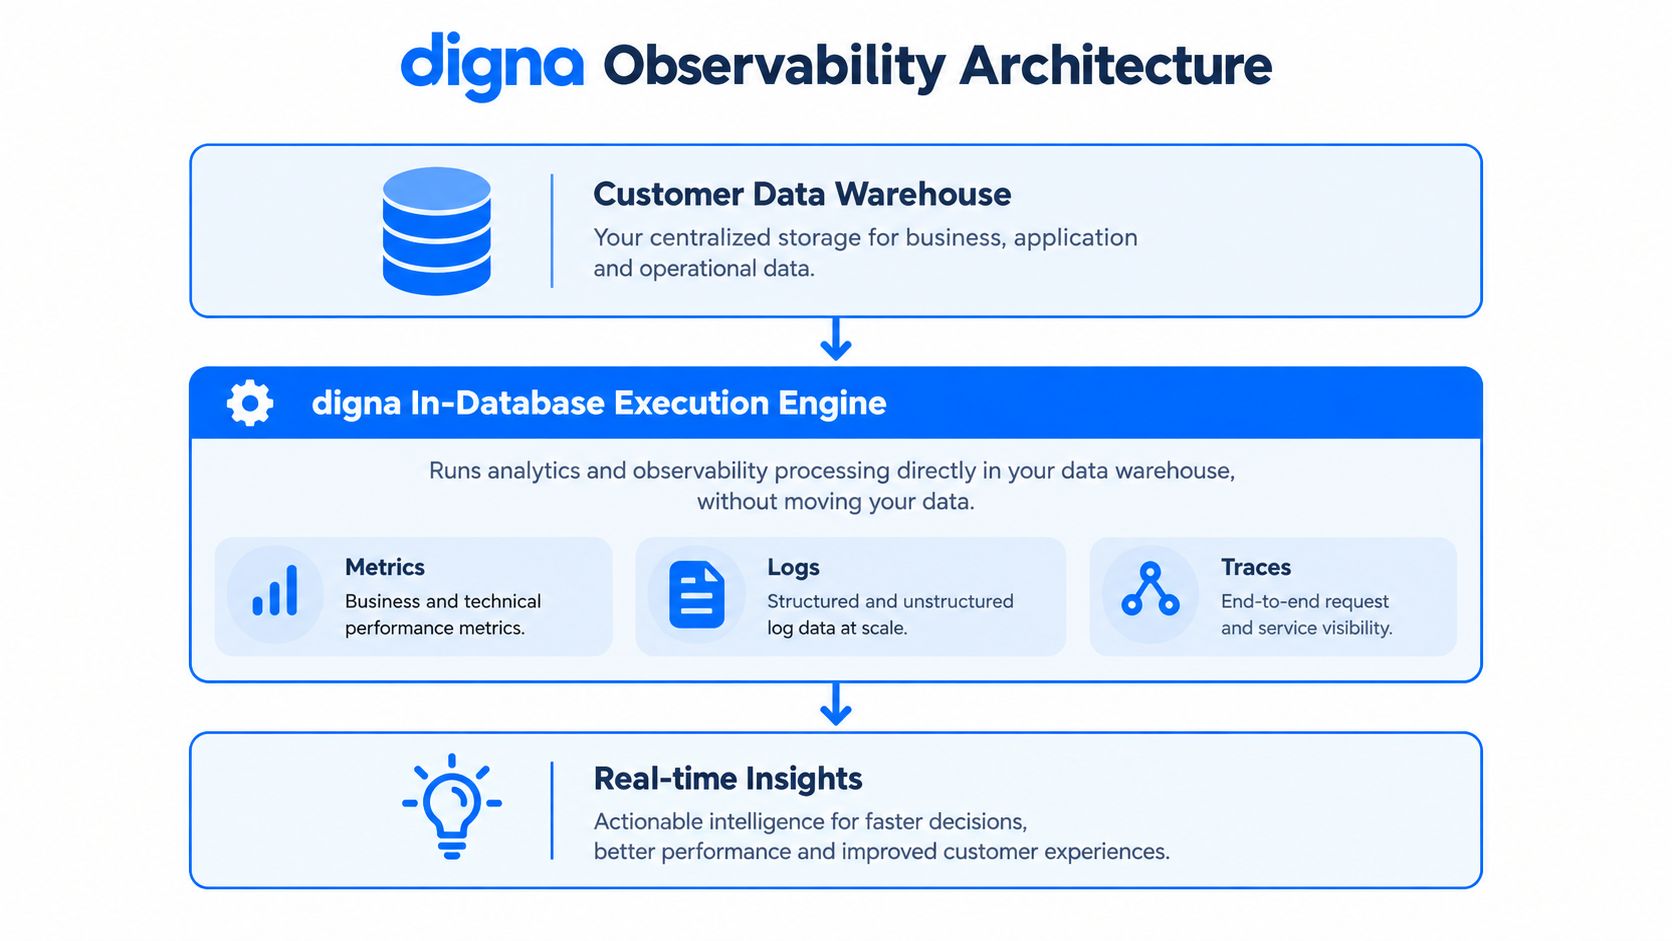
Ce qui se passe dans l'entrepôt de données
La surveillance de la dérive de schéma compare le schéma entrant ou déduit à une référence attendue ou à un schéma contractuel, puis classe les ajouts, suppressions, renommages et changements de type de données pour un traitement selon leur gravité. Ce détail est important, car une colonne manquante et une colonne renommée ne méritent généralement pas la même réponse. Une alerte stricte à chaque changement génère du bruit, tandis que l'absence totale d'alerte laisse les systèmes en aval exposés.
La surveillance de la ponctualité vérifie si les données sont arrivées à l'heure, en avance ou en retard, et la détection d'anomalies apprend le comportement des jeux de données sans nécessiter de configuration manuelle de règles pour chaque cas. Ce passage de règles rigides à l'apprentissage de références est ce qui rend le système praticable à l'échelle de l'entreprise, en particulier lorsque les flux varient selon le jour, la source ou le cycle d'activité.
L'exécution en base de données de la plateforme répond également bien à une question courante en entreprise : comment surveiller la fraîcheur et les violations de règles métier sans transformer chaque incident en projet de maintenance artisanal ? La réponse consiste généralement à laisser l'entrepôt effectuer les calculs, puis à laisser la couche d'observabilité interpréter les tendances.
Règle opérationnelle : si un moniteur nécessite des réglages manuels constants simplement pour rester silencieux, ce n'est pas de l'observabilité, c'est de la fatigue d'alerte avec des étapes supplémentaires.
La documentation de digna décrit également une licence modulaire, composée d'un forfait de base et d'un tarif par table active et par module. Ce type de structure compte sur le plan opérationnel, car les équipes ont rarement besoin de toutes les fonctionnalités dès le premier jour : elles commencent généralement par un problème, puis élargissent le périmètre une fois que le modèle a fait ses preuves.
Pour les équipes qui comparent les styles de mise en œuvre, les contrôles relatifs à la suppression d'OpenDatabase constituent un exemple connexe utile montrant comment l'inspection côté entrepôt peut être présentée comme une activité d'audit maîtrisée plutôt que comme un export de données externe.
Le bénéfice pratique est simple. Vous conservez les données dans l'environnement du client, calculez les métriques là où résident déjà les données et réduisez le nombre d'endroits où une copie obsolète peut devenir « la vérité ».
Quand le traitement en base de données n'est pas le bon choix
Même la configuration en base de données la plus solide a ses limites. Si le moteur ne parvient pas à bien planifier la requête, à exploiter la localité mémoire ou à tirer parti de l'exécution vectorisée, le travail d'observabilité devient une charge pour la production au lieu d'un garde-fou.
Des modes de défaillance concrets, pas théoriques
Le premier est la compatibilité. Toutes les bases de données n'exposent pas les mêmes fonctions analytiques, et tous les environnements n'autorisent pas le même niveau de pushdown. Si la plateforme ne peut pas exécuter les contrôles nécessaires dans le moteur, les équipes finissent généralement par réintroduire des exports par la petite porte.
Le deuxième est la concurrence entre charges de travail. Un entrepôt qui sert déjà la BI et les analyses ad hoc peut être bridé si les jobs d'observabilité sont mal planifiés ou trop coûteux à exécuter en ligne. La planification des requêtes et l'indexation jouent ici un rôle important, et « garder le traitement dans la base de données » ne signifie jamais « tout exécuter immédiatement ».
Le troisième est l'excès d'ambition. Les analyses légères, les investigations de courte durée ou les jeux de données à faible risque ne justifient souvent pas le coût de mise en place. Dans ces cas, un processus externe plus simple peut être plus facile à maintenir et à retirer ensuite, surtout lorsque les équipes disposent déjà d'un pipeline de données ETL qui supporte la charge opérationnelle.
Ne maintenez les contrôles là où résident les données que si le moteur peut absorber le travail sans devenir lui-même le problème.
Le compromis pour l'entreprise est clair. L'exécution en base de données peut réduire les déplacements et aider les données réglementées à rester dans l'environnement du client, mais elle sollicite davantage la pile de base de données. Si l'équipe ne maîtrise pas la forme des requêtes, la conception des index ou l'isolation des charges de travail, le modèle peut encore échouer à grande échelle.
Ce choix n'a rien d'idéologique. Il dépend de la capacité de l'entrepôt à absorber la charge de surveillance sans créer de nouveaux goulets d'étranglement, de nouveaux travaux de réglage ou une nouvelle pression sur les coûts. Comme indiqué plus haut, certaines charges de travail sont mieux traitées dans l'entrepôt, tandis que d'autres le sont plus proprement à l'extérieur.
Cas d'usage sectoriels exigeant la fiabilité du traitement en base de données
Les secteurs réglementés s'intéressent à ce modèle pour la même raison : ils ne peuvent pas se permettre une seconde copie de la vérité qui dérive. Les équipes des services financiers, de la santé, des télécommunications et du secteur public manipulent toutes des données sensibles, traçables ou critiques sur le plan opérationnel, si bien que le contrôle doit s'effectuer sans déplacement inutile.
Les équipes financières doivent généralement inspecter sur place les données transactionnelles, de risque et réglementaires. Si le processus de surveillance exporte les données vers un autre environnement, il peut entrer en conflit avec les exigences de résidence des données, les attentes des auditeurs ou les contrôles internes. Les équipes de santé font face à une pression différente : des chargements tardifs ou des changements de schéma peuvent fausser le reporting clinique et opérationnel, et ce n'est pas un problème que l'on souhaite découvrir après coup.
Les équipes des télécommunications gèrent en permanence des flux à fort volume ; la détection continue d'anomalies doit donc s'exécuter sans goulet d'étranglement lié à des exports lourds. Les équipes du secteur public doivent prouver que les contrôles eux-mêmes sont auditables, ce qui rend l'exécution en base de données attrayante, car la trace de surveillance reste proche de l'environnement gouverné.
La contrainte commune à ces secteurs
Le point commun n'est pas le secteur, mais la nature opérationnelle des données. Chacun de ces environnements a besoin d'une surveillance suffisamment rapide pour être utile, suffisamment stricte pour satisfaire aux exigences de gouvernance et suffisamment confinée pour éviter de créer de nouvelles copies qui s'écartent de la source.
C'est pourquoi la question de la sécurité face à la complexité compte davantage que la définition. Si la charge de travail est sensible, volumineuse et étroitement liée à la conformité, l'exécution en base de données devient souvent le choix pragmatique plutôt qu'une simple préférence architecturale. Si la charge de travail est occasionnelle ou exploratoire, la même approche peut poser plus de problèmes qu'elle n'en résout.
La tendance récente de l'observabilité va dans le même sens : traiter la qualité des données et l'observabilité comme un seul problème analytique centré sur la base de données, plutôt que comme deux tâches distinctes. C'est utile, car la question centrale en entreprise est rarement « Pouvons-nous détecter un problème ? ». C'est plutôt « Pouvons-nous le détecter sans casser le système que nous cherchons à protéger ? »
Prendre la décision : le traitement en base de données convient-il à votre stack ?
Commencez par les données, pas par l'outil. Si le jeu de données est trop sensible pour quitter l'environnement, trop volumineux pour être déplacé efficacement ou trop proche de la source de vérité pour tolérer un délai, le traitement en base de données mérite un examen sérieux.
Examinez ensuite la charge de travail. La détection d'anomalies en temps réel, les contrôles de fraîcheur, la surveillance de la dérive de schéma et la validation des règles métier tirent tous profit d'une exécution à proximité de la source de données. Si ces mêmes contrôles ne s'exécutent qu'occasionnellement, ou s'ils sont exploratoires plutôt qu'opérationnels, la simplicité d'un moteur externe peut suffire.
Testez ensuite le moteur lui-même. Prend-il en charge les fonctions analytiques dont vous avez besoin ? Peut-il exécuter proprement le pushdown ? Peut-il gérer l'observabilité sans priver de ressources les requêtes de production ? Ces questions comptent davantage que l'étiquette marketing, car une base de données incapable de bien planifier ses requêtes vous pénalisera plus vite qu'un job externe lent.
Une courte liste de contrôle pour décider
Choisissez le traitement en base de données lorsque les données sont réglementées, que le volume est élevé ou que la latence compte.
Privilégiez l'analyse externe lorsque la charge de travail est légère, temporaire ou encore en évolution.
Validez le comportement du moteur avant le déploiement, en particulier les plans de requête, l'indexation et l'isolation des charges de travail.
Conservez les outils de BI existants lorsqu'ils fonctionnent déjà, car l'exécution en base de données n'impose pas de remplacer le reste de la stack.
La plus grande idée reçue est que l'exécution en base de données remplace tout le reste. Ce n'est pas le cas. Elle change l'endroit où les contrôles s'effectuent, mais pas l'existence des analystes, des tableaux de bord ou des applications en aval. En pratique, les meilleurs déploiements conservent l'entrepôt de données comme source de vérité, utilisent le moteur de base de données pour les inspections à forte exigence de gouvernance et évitent de reconstruire toute une stack analytique simplement pour résoudre un problème de fraîcheur.
Si votre configuration actuelle passe plus de temps à copier les données qu'à les contrôler, l'architecture joue probablement contre vous. Si vous recherchez une plateforme qui calcule la qualité et l'observabilité dans l'environnement du client, conserve les données en place et prend en charge une surveillance modulaire couvrant les anomalies, la ponctualité, la validation, les changements de schéma et les métriques métier, rendez-vous sur digna pour découvrir comment le modèle en base de données s'adapte à votre entrepôt de données et à vos exigences de gouvernance.
Puisque la compatibilité du moteur détermine si les contrôles peuvent rester dans la base de données, la liste des bases de données et entrepôts de données avec lesquels digna s'intègre est le premier élément à vérifier pour votre stack.
Questions fréquentes
Qu'est-ce que le traitement en base de données ?
Le traitement en base de données exécute l'analytique et la surveillance directement dans le moteur de base de données, de sorte que les données restent en place au lieu d'être extraites vers un outil externe. Cela supprime la surcharge liée aux transferts, évite les copies supplémentaires et réduit la surface d'exposition, ce qui est d'autant plus important lorsqu'un entrepôt de données est volumineux, sensible, ou les deux.
Quand le traitement en base de données s'est-il généralisé ?
L'analytique en base de données est devenue commercialement pertinente au milieu des années 1990 et s'est largement imposée au milieu des années 2000. Un jalon souvent cité est la conférence Teradata Partners de septembre 2005, où a été présentée la combinaison de SAS et de Teradata au sein de l'entrepôt, tandis que les bases de données orientées colonnes ont rendu possibles l'analyse et l'agrégation côté entrepôt.
Quelle est la différence entre le traitement en base de données et les processus d'extraction-analyse ?
Le traitement en base de données effectue les calculs là où résident les données, tandis que les processus d'extraction-analyse copient ou exportent d'abord les données vers un autre moteur. Le premier convient aux charges de travail volumineuses, sensibles ou sensibles à la latence, mais peut surcharger la production ; le second convient aux analyses légères ou ad hoc, mais peut s'écarter de la source et créer une vérité dupliquée.
Quand le traitement en base de données n'est-il pas le bon choix ?
Il montre ses limites dans trois situations citées dans l'article : les problèmes de compatibilité, lorsque la base de données ne dispose pas des fonctions analytiques ou du pushdown nécessaires ; la concurrence entre charges de travail, lorsque les jobs d'observabilité brident les requêtes BI ; et l'excès d'ambition, lorsqu'une analyse légère, de courte durée ou à faible risque ne justifie pas le coût de mise en place d'une exécution dans le moteur.
Comment digna utilise-t-il le traitement en base de données pour l'observabilité des données ?
digna effectue le calcul des métriques dans les propres bases de données du client et y surveille la fraîcheur, le volume, le schéma, la distribution et le lignage. Ses contrôles de dérive de schéma comparent la structure entrante à une référence attendue et classent les ajouts, suppressions, renommages et changements de type selon leur gravité, tandis que la détection d'anomalies apprend le comportement des jeux de données sans règles manuelles.


