Comment créer un fichier de configuration qui fonctionne
|
5
minute de lecture

Pour savoir comment créer un fichier de configuration, définissez les paramètres dont votre application a besoin, choisissez un format lisible, enregistrez le fichier avec la bonne extension et validez-le avant toute mise en production. L’objectif est de séparer le comportement à l’exécution du code applicatif, afin que les équipes puissent ajuster les environnements sans modifier la base de code.
Table des matières
Comprendre les fichiers de configuration et la mise en place rapide
Un fichier de configuration fait le lien entre votre code et l’environnement d’exécution. Au lieu de coder en dur les chaînes de connexion aux bases de données, les points de terminaison d’API, les niveaux de journalisation ou les feature flags directement dans le code source, vous les stockez à l’extérieur afin que les membres autorisés de l’équipe puissent les modifier indépendamment.
Cette séparation est essentielle dans la finance, la santé et le secteur public, où les modifications doivent être contrôlées, soumises à des restrictions d’accès et auditables. Elle réduit aussi les erreurs de déploiement, car le développement, la préproduction et la production peuvent utiliser des valeurs différentes tout en partageant le même code applicatif.
Commencez par lister les paramètres sans lesquels l’application ne peut pas fonctionner :
Informations de connexion, comme les noms de bases de données et les références de services
Feature flags qui activent ou désactivent un comportement optionnel
Paramètres de journalisation, y compris le niveau de verbosité et la destination des journaux
Libellés d’environnement, pour que l’application charge le bon profil au démarrage
Choisissez le format adapté à votre chaîne d’outils. YAML est lisible et gère bien la hiérarchie. JSON est strict et s’intègre facilement aux API. INI convient aux paires clé-valeur simples. TOML offre une structure explicite sans formalisme excessif.
Le graphique ci-dessous compare ces quatre formats selon la lisibilité, la hiérarchie, la prise en charge des commentaires et les cas d’usage courants.
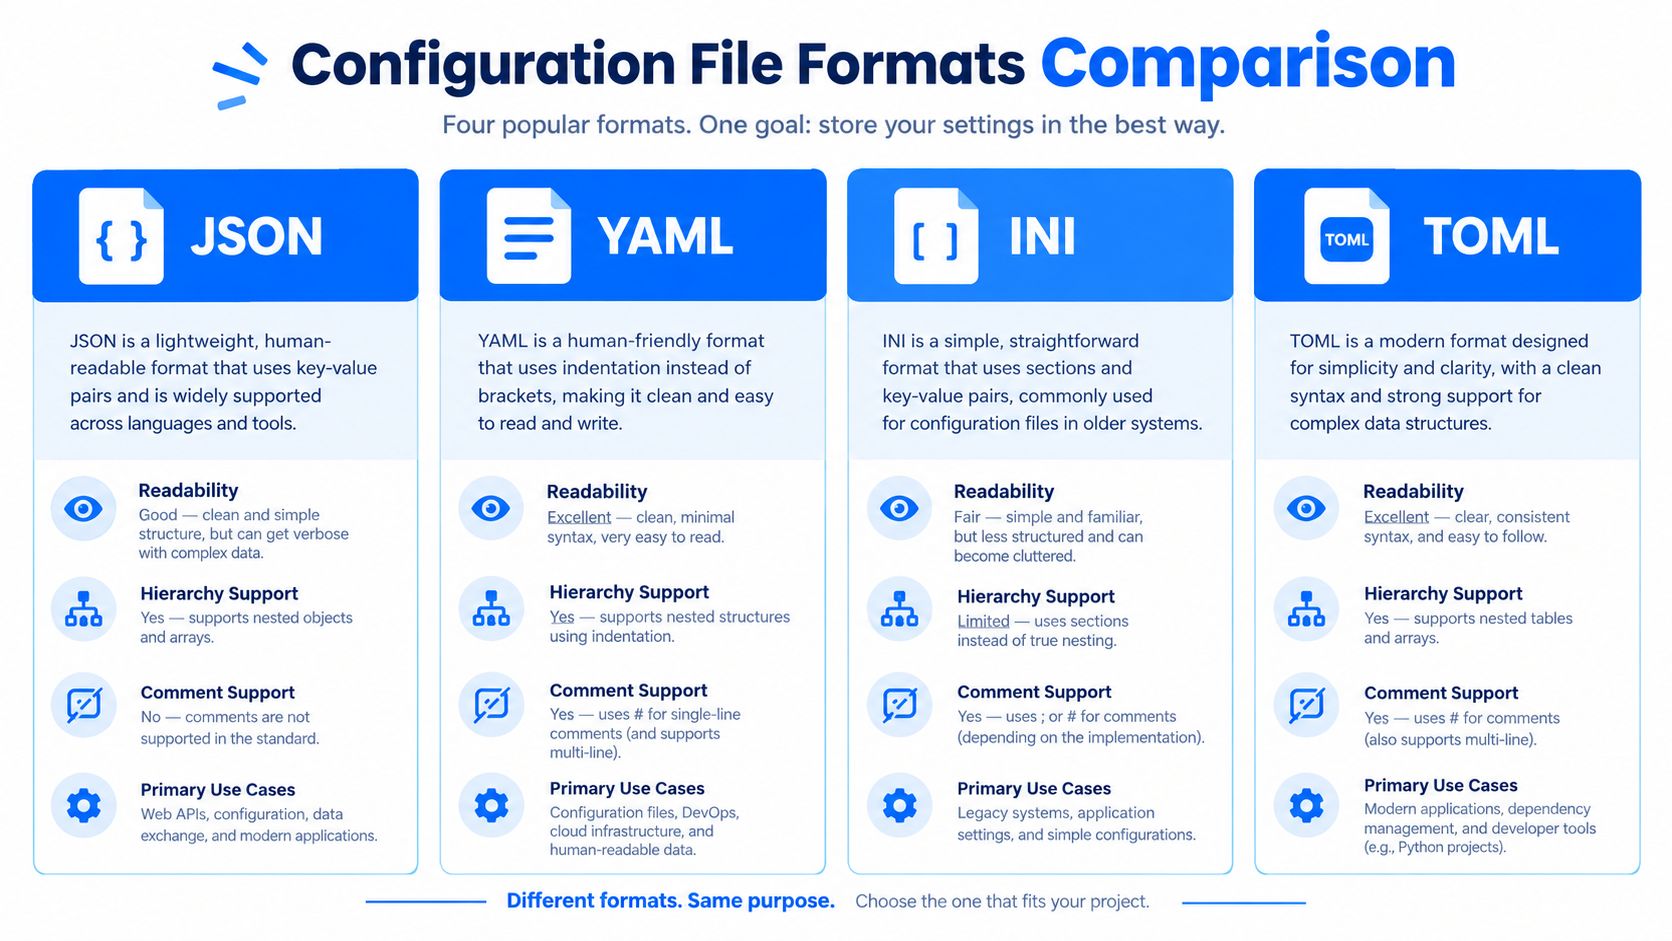
Vous remarquerez que YAML et TOML privilégient l’édition humaine, tandis que JSON est conçu pour une analyse stricte par les machines et qu’INI reste utile pour des paramètres plus plats et plus simples.
Conseil : traitez chaque fichier de configuration comme une entrée susceptible d’échouer. Analysez-le et validez-le toujours avant le démarrage de l’application, sans jamais supposer qu’il se chargera correctement.
Si vous travaillez en Python et devez relier des workflows de surveillance au code applicatif, consultez la documentation du SDK Python de digna pour un exemple concret de la manière dont la configuration soutient l’observabilité en conditions réelles.
Le bon format de configuration dépend de trois facteurs : ce qu’attend votre application, ce que votre pipeline de déploiement exécute déjà et qui maintiendra le fichier dans six mois. Ne choisissez pas uniquement selon vos préférences personnelles. Choisissez le format que votre chaîne d’outils prend en charge de manière fiable.

Adapter le format au flux de travail
YAML est populaire, et pour cause. On le trouve dans les manifestes Kubernetes, les configurations Docker Compose et les définitions de pipelines CI/CD, car sa structure fondée sur l’indentation est facile à lire. Cependant, un seul espace mal placé peut casser tout le fichier. Une tabulation en trop peut empêcher un conteneur de démarrer. La cohérence des éditeurs et l’utilisation d’un linter sont indispensables.
JSON fonctionne bien lorsque ce sont des machines qui génèrent le fichier. Les contrats d’API, les charges utiles sérialisées et les paramètres générés automatiquement tirent parti de sa syntaxe stricte. L’inconvénient : éditer à la main un gros fichier JSON devient fastidieux, et une virgule manquante peut provoquer une erreur d’analyse obscure.
INI se situe à l’autre extrémité du spectre. Il utilise des sections plates avec de simples paires clé-valeur. Pour un petit utilitaire de bureau ou un outil de développement léger, cette simplicité est un atout plutôt qu’une limite.
TOML améliore la lisibilité sans dépendre de l’indentation. Les en-têtes de section, les valeurs typées et une structure prévisible le rendent attrayant pour l’outillage moderne. La contrepartie tient à son adoption : tous les langages et toutes les plateformes n’offrent pas une prise en charge native de TOML.
Format | Usage idéal | Point d’attention principal |
|---|---|---|
YAML | Infrastructure et pipelines | Erreurs d’indentation |
JSON | API et données générées | Édition verbeuse |
INI | Paramètres d’application plats | Imbrication limitée |
TOML | Outillage moderne explicite | Prise en charge moins universelle |
Règle pratique : choisissez le format que votre parseur, votre plateforme de déploiement et votre équipe de maintenance maîtrisent déjà.
Dans les environnements analytiques d’entreprise, YAML et JSON sont des choix courants. Ils concilient lisibilité humaine et automatisation fiable. Ces deux formats sont des compétences précieuses pour les ingénieurs data et plateforme. Si vos pipelines utilisent aussi des formats de stockage en colonnes, découvrez les fichiers Parquet et leur structure avant de connecter ces jeux de données à votre pile de surveillance ou de traitement.
Validez toujours votre configuration avec le parseur réellement utilisé avant de l’envoyer vers un environnement réel. Un fichier qui vous semble correct peut tout de même échouer lorsque l’application rencontre un cas limite non pris en charge.
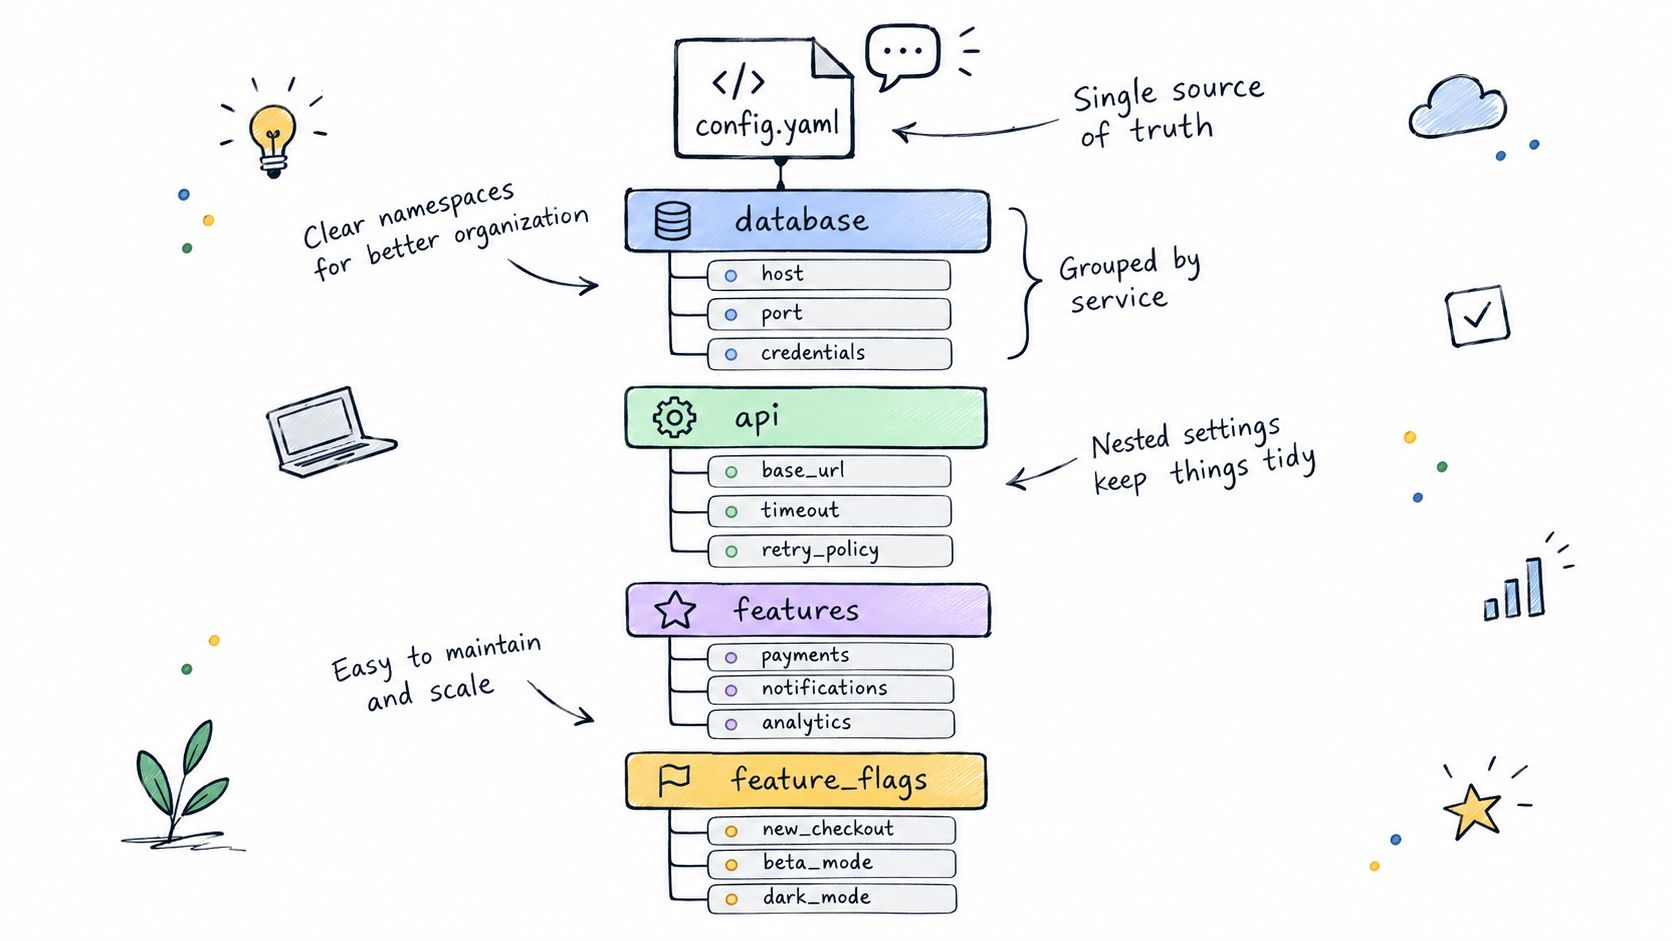
Tout fichier de configuration fiable commence par un inventaire honnête. N’incluez que ce dont l’application a réellement besoin pour fonctionner : références de bases de données, points de terminaison de services, niveaux de journalisation, feature flags et paramètres similaires. Regroupez ensuite les valeurs liées sous des espaces de noms explicites au lieu de les disperser dans tout le fichier.

Organiser les paramètres selon les besoins de l’application
Supposons que vous configuriez un service de reporting en YAML. Le fichier pourrait ressembler à ceci :
Lorsqu’un incident survient à 2 heures du matin, cette structure prouve toute sa valeur. La personne d’astreinte trouve rapidement le paramètre concerné au lieu de parcourir un mur de clés. JSON fonctionne de manière similaire : imbriquez les objets correspondants et utilisez une indentation cohérente de deux espaces. INI est différent : gardez une conception plate et appuyez-vous sur des sections clairement nommées, comme [database] et [logging].
Utilisez les commentaires avec parcimonie. Ajoutez-les pour expliquer un délai d’expiration inhabituel, un interrupteur de fonctionnalité temporaire ou une valeur qui doit rester synchronisée avec un autre système. Un commentaire qui ne fait que répéter le nom du paramètre ajoute du bruit. Les lecteurs ont besoin de la raison d’une décision, pas de son écho.
À retenir : un fichier de configuration doit expliquer les choix de fonctionnement de l’application, et non obliger les lecteurs à les reconstituer par rétro-ingénierie.
Avant d’enregistrer le fichier, effectuez trois vérifications rapides :
Utilisez l’extension attendue, comme
.yaml,.jsonou.ini, pour que les outils reconnaissent le fichier.Gardez des noms cohérents en choisissant une convention, comme
timeout_seconds, et en l’appliquant partout.Séparez les environnements, afin que le développement et la production puissent utiliser des valeurs différentes sans modifier la logique applicative.
Si vos paramètres décrivent des jeux de données ou des métadonnées, découvrez les descriptions de schémas de bases de données pour aligner la terminologie de configuration sur les données qu’elle pilote.
Testez immédiatement le fichier avec le véritable parseur de l’application. Un fichier peut sembler valide tout en contenant une clé non prise en charge, un type incorrect ou une valeur obligatoire manquante. Détecter ces problèmes avant le déploiement rend les modifications de configuration prévisibles et réduit le travail de rétablissement.
Gérer la configuration à grande échelle ne se limite pas au choix du bon format. Tout fichier de configuration non secret doit être stocké dans Git. Le contrôle de version offre aux équipes une visibilité sur les modifications, un moyen simple de revenir en arrière et une piste d’audit pour la conformité.
La discipline des commits compte. De petits commits ciblés, avec des messages comme Increase reporting timeout, sont plus utiles qu’un gros commit miscellaneous fixes. Pour les modifications en production, la revue par pull request doit être obligatoire. Lorsque vous déployez une mise à jour de configuration sur plusieurs services, étiquetez la release afin de pouvoir la retrouver plus tard.
Protéger les secrets et valider les modifications
Les mots de passe, jetons, clés privées et chaînes de connexion n’ont pas leur place dans des fichiers versionnés. Faites plutôt référence à des variables d’environnement ou récupérez les secrets depuis un système de gestion dédié qui assure le contrôle d’accès et la rotation sans nécessiter de modification du code applicatif.
Avant de fusionner toute modification de configuration, combinez contrôles automatisés et revue humaine :
Analysez le fichier avec la même bibliothèque que votre application pour détecter tôt les problèmes d’analyse à l’exécution.
Validez le schéma pour repérer les clés manquantes, les types incorrects ou les valeurs inattendues.
Exécutez un linter pour détecter les incohérences de mise en forme et les erreurs de syntaxe.
Analysez les commits à la recherche de secrets avant qu’ils n’atteignent le dépôt partagé ; supprimer une fuite de l’historique est bien plus difficile que de l’empêcher.
Testez les surcharges par environnement pour que la préproduction et la production se résolvent vers les valeurs attendues plutôt que vers des valeurs par défaut oubliées.
À retenir : traitez la configuration comme du code de production, et les secrets comme une frontière de sécurité distincte.
Les conventions de nommage posent problème à plus d’équipes qu’on ne le pense. Choisissez un style, comme timeout_seconds ou TIMEOUT_SECONDS, et appliquez-le de manière cohérente dans tous les services. Documentez les variables obligatoires et gardez des surcharges d’environnement prévisibles. Un fichier de base avec des valeurs par défaut pertinentes fonctionne bien, les fichiers de préproduction et de production ne surchargeant que les valeurs qui diffèrent réellement.
Mettre en place des contrôles de déploiement fiables
Mettez en place une étape de contrôle dans le pipeline qui empêche toute configuration invalide d’atteindre le déploiement. Pour les services critiques, déployez les modifications progressivement, surveillez de près les métriques de démarrage et de santé, et conservez un chemin de retour arrière testé.
Si vous avez besoin d’un rappel de l’importance de ces mesures, le post-mortem de Cloudflare sur sa panne de novembre 2025 mérite d’être lu. Il montre pourquoi une configuration générée a besoin de sa propre validation, de limites de taille, d’une propagation contrôlée et d’une version de récupération réputée fiable.
Pour les équipes qui traitent des données clients, digna propose des conseils sur la protection des données clients dans les environnements d’entreprise. Le principe est simple : gardez des configurations vérifiables, auditables et récupérables à mesure que vos services et votre équipe grandissent.
Même une configuration bien structurée peut échouer lors de l’analyse, du chargement ou de l’exécution. L’essentiel est de déterminer s’il s’agit d’un problème de syntaxe ou d’un véritable échec à l’exécution, puis de tester d’abord la couche appropriée.
Repérer d’abord les problèmes d’analyse syntaxique
YAML casse souvent à cause d’une indentation incohérente, notamment lorsque tabulations et espaces coexistent dans le même fichier. JSON échoue généralement à cause de guillemets manquants, d’une virgule superflue avant une accolade fermante ou d’un crochet non fermé.
Faites passer la configuration par le parseur exact qu’utilise votre application. Ajoutez ensuite un linter ou un validateur de schéma à votre flux de développement pour que ces contrôles s’exécutent automatiquement. Une structure invalide doit être détectée bien avant d’atteindre la production.
Vérifiez l’indentation et l’imbrication dans les fichiers YAML.
Contrôlez les guillemets, les virgules et les crochets dans JSON.
Vérifiez que les clés obligatoires et les types de valeurs attendus sont présents.
Assurez-vous que l’extension du fichier correspond à ce qu’attend votre chargeur.
À retenir : un fichier qui paraît parfait dans votre éditeur doit encore passer une analyse automatisée et une validation de schéma pour être digne de confiance.
Analyser les échecs à l’exécution
Il arrive qu’une configuration soit analysée sans erreur mais échoue lorsque l’application utilise ses valeurs. Un numéro de port invalide, une option non prise en charge, une variable d’environnement manquante ou un point de terminaison injoignable peuvent bloquer le démarrage ou provoquer des erreurs qui n’apparaissent que des heures plus tard.
Commencez par comparer le fichier défaillant avec une configuration dont le bon fonctionnement est connu, en modifiant une valeur à la fois jusqu’à ce que le problème apparaisse. Consultez ensuite les journaux de l’application ; le message d’erreur identifie souvent la clé ou la valeur à l’origine de l’échec.
Avant de pousser en production, vérifiez les points suivants :
Les services référencés sont disponibles dans l’environnement cible.
Les surcharges de variables d’environnement se résolvent vers les valeurs attendues.
Aucun identifiant ni jeton n’est codé en dur en texte clair.
Les limites de ressources acceptent les valeurs configurées sans les plafonner.
Une version antérieure testée est disponible pour un retour arrière.
Le rapport de Cloudflare sur la panne du 18 novembre 2025 confirme qu’une configuration générée a besoin de limites de taille, d’une propagation contrôlée et d’une version de récupération réputée fiable. Traiter ces détails avant le déploiement rend les mises en production plus prévisibles et aide à préserver la disponibilité en cas de problème.
Les fichiers de configuration donnent aux outils de qualité des données un plan de fonctionnement clair et cohérent. Lors de la mise en place de digna, définissez les références de connexion aux bases de données, les planifications de surveillance, les règles de validation et les seuils d’alerte dans une couche de configuration dédiée, plutôt que de les disperser dans plusieurs scripts.
Par exemple, une équipe financière peut contrôler les tables de transactions à l’arrivée de nouveaux chargements, signaler les variations de volume inhabituelles et vérifier que les jeux de données réglementaires sont livrés dans les délais. Dans la santé, la même structure peut prendre en charge la validation des enregistrements, la détection des changements de schéma et les alertes lorsque la livraison des données cliniques prend du retard.
Une configuration pratique rend chaque décision de surveillance facile à retrouver :
Les paramètres de connexion pointent vers la source de données approuvée sans exposer les identifiants.
Les planifications précisent quand les contrôles de ponctualité et les autres tâches de surveillance doivent s’exécuter.
Les seuils définissent quand une dérive, un retard ou un échec de validation exige une attention.
Les paramètres de module activent ou désactivent la détection d’anomalies, la validation, la ponctualité ou le suivi des schémas.
À retenir : votre configuration doit décrire ce que digna surveille et la manière dont il réagit. Conservez les secrets dans des variables d’environnement ou un gestionnaire de secrets approuvé, pas dans des fichiers de configuration.
Garder les paramètres de surveillance sûrs et testables
digna s’exécute dans votre propre cloud, VPC ou centre de données et calcule les métriques directement dans vos bases de données. Cette architecture permet aux équipes de laisser les données en place tout en appliquant des contrôles cohérents à l’ensemble des entrepôts, lacs de données et pipelines.
Séparez les fichiers de configuration par environnement : développement, préproduction et production. Avant de déployer une nouvelle planification ou un nouveau seuil d’alerte, testez-le sur des données représentatives et examinez les incidents qui en résultent. Versionnez chaque modification afin que les ingénieurs data puissent savoir qui a modifié une règle et revenir sans précipitation à une version réputée fiable.
Pour voir de plus près comment cela s’inscrit dans une stratégie de surveillance plus large, découvrez les capacités d’intégration de la qualité des données de digna. Cette approche aide les équipes de la finance, de la santé et des télécommunications à garder des systèmes analytiques et d’IA fiables sans compromettre les exigences de sécurité ou d’audit.
Répondre aux questions de format et de sécurité
Pour choisir comment créer un fichier de configuration, utilisez JSON pour des paramètres stricts générés par des machines et YAML pour des fichiers d’infrastructure lisibles. En pratique, le meilleur choix est généralement le format que votre parseur et vos outils de déploiement prennent déjà en charge.
Pour effectuer la rotation des secrets sans interruption de service, stockez-les dans un gestionnaire de secrets, publiez une nouvelle version et laissez les applications recharger les identifiants avant de révoquer les anciens.
À retenir : ne versionnez jamais d’identifiants. En cas d’exposition, révoquez immédiatement le secret, retirez-le des fichiers actifs et considérez votre historique Git comme compromis.
Garder la validation et les environnements prévisibles
Exécutez les parseurs de format, les contrôles de schéma et les linters dans votre CI/CD. Des outils comme yamllint, les validateurs JSON Schema et les contrôles natifs des plateformes peuvent bloquer les modifications invalides avant qu’elles n’atteignent la production.
Documentez clairement l’ordre de priorité : les valeurs passées en ligne de commande priment généralement sur les variables d’environnement, qui priment à leur tour sur les valeurs par défaut du fichier. Pour les microservices, détectez les dérives en comparant les configurations résolues à une référence versionnée.
Conservez toujours une configuration réputée fiable pour pouvoir revenir en arrière. digna aide les équipes à surveiller le comportement des données et les changements de schéma directement dans leur propre environnement.
Découvrez digna sur digna.ai pour fiabiliser vos opérations sur les données.
Questions fréquentes
À quoi sert un fichier de configuration ?
Un fichier de configuration stocke les paramètres d’exécution en dehors du code source, afin que les membres autorisés de l’équipe puissent les modifier sans toucher à la base de code. Il contient généralement les informations de connexion aux bases de données, les feature flags, le niveau de verbosité et la destination des journaux, ainsi que les libellés d’environnement qui indiquent à l’application quel profil charger au démarrage.
Faut-il utiliser YAML, JSON, INI ou TOML pour un fichier de configuration ?
Choisissez le format que votre parseur, votre plateforme de déploiement et votre équipe de maintenance maîtrisent déjà. YAML convient aux manifestes Kubernetes et aux pipelines CI/CD mais casse au moindre espace mal placé, JSON est adapté aux API et aux données générées, INI gère des paramètres clé-valeur plats, et TOML offre une structure explicite avec une prise en charge moins universelle selon les langages.
Comment valider un fichier de configuration avant le déploiement ?
Faites-le passer par le parseur exact qu’utilise votre application, puis ajoutez une validation de schéma et un linter, comme yamllint ou un validateur JSON Schema, dans votre CI/CD. L’article recommande aussi d’analyser les commits à la recherche de secrets et de tester les surcharges par environnement, afin que la préproduction et la production se résolvent vers les valeurs attendues et non vers des valeurs par défaut oubliées.
Les mots de passe et les clés d’API doivent-ils figurer dans un fichier de configuration ?
Non. Les mots de passe, jetons, clés privées et chaînes de connexion doivent se trouver dans des variables d’environnement ou un gestionnaire de secrets dédié, jamais dans des fichiers versionnés. Pour effectuer la rotation d’un secret sans interruption, publiez une nouvelle version, laissez les applications la recharger, puis révoquez l’ancienne. En cas de fuite d’un secret, révoquez-le immédiatement et considérez l’historique Git comme compromis.
Pourquoi mon fichier de configuration est-il analysé correctement alors que l’application échoue quand même ?
Les échecs à l’exécution proviennent des valeurs, pas de la syntaxe : un numéro de port invalide, une option non prise en charge, une variable d’environnement manquante ou un point de terminaison injoignable. Comparez le fichier défaillant à une configuration dont le bon fonctionnement est connu, modifiez une valeur à la fois jusqu’à ce que l’erreur apparaisse et consultez les journaux de l’application, qui indiquent souvent la clé en cause.


