Qu'est-ce qu'un plan de remédiation ?
|
6
minute de lecture

Vous avez sous les yeux un dashboard qui semble faux, et le moment ne pourrait pas être plus mal choisi. Peut-être qu'une table de chiffre d'affaires a dérivé après un changement de source, qu'un flux réglementaire est arrivé en retard ou que le score d'un modèle a suffisamment dérivé pour que le responsable métier perde confiance. À cet instant, la question n'est pas seulement de savoir ce qui a cassé, mais quelle réponse tiendra lorsque quelqu'un demandera si le problème est corrigé, maîtrisé et peu susceptible de revenir.
Une relance ou un correctif rapide peut faire taire le bruit pour aujourd'hui. Un plan de remédiation transforme cette réaction en un processus maîtrisé, avec un responsable, des preuves et un critère de clôture clair. Si vous avez déjà vu un ticket marqué comme terminé alors que le rapport en aval paraissait toujours suspect, ce sujet est sans doute déjà sur votre bureau.
Table des matières
Quand un incident de données impose un vrai plan
Le lundi commence par un message sur Slack, pas par un rapport d'incident bien rangé. Le dashboard financier est de nouveau faux, le chargement de l'entrepôt s'est terminé, et pourtant les chiffres ne se rapprochent toujours pas du système source. Quelqu'un propose de relancer la pipeline, un autre veut corriger la transformation, et le responsable métier veut simplement que le rapport cesse de changer toutes les heures.
C'est là que les workflows de tickets informels échouent généralement. Une relance peut être le bon premier geste, mais elle ne fait que contenir le symptôme. Elle ne vous dit pas si la cause racine était un changement de schéma, un mapping erroné, une dépendance manquante ou une règle de validation qui n'a jamais existé.
Un vrai plan commence par séparer la réponse temporaire de la correction permanente. Il traite l'incident comme un workflow avec des preuves, et non comme une tâche ponctuelle dotée d'un champ de statut. Pour les équipes qui tiennent déjà des pages d'incidents comme digna data quality issues, le changement est simple en théorie et difficile en pratique : l'enregistrement doit passer de « quelque chose a échoué » à « cette défaillance est comprise, attribuée, corrigée et vérifiée ».
Un ticket peut consigner une activité. Un plan de remédiation doit prouver que le risque a diminué.
Cette distinction compte, car la confiance repose sur une clôture que l'on peut défendre. Si la pipeline est réparée mais que personne ne vérifie le rafraîchissement en aval, le plan n'est pas terminé, il est seulement plus silencieux. La suite de l'article applique un critère plus strict, adapté à la manière dont travaillent les équipes data expérimentées lorsque la pression est réelle.
La définition au cœur de tout plan de remédiation
Un plan de remédiation est un ensemble contrôlé d'actions fondées sur des preuves qui élimine la cause racine d'une non-conformité détectée, rétablit le processus ou les données concernés, empêche la récidive et prouve que la correction a fonctionné. Cette définition compte, car elle vous oblige à poser quatre questions différentes, et non une seule. Que s'est-il passé, quelle en était la cause, qu'avons-nous changé et comment savons-nous que le problème reste résolu ?
Pensez à un tuyau qui fuit. Vous pouvez éponger le sol, resserrer le raccord, inspecter la conduite, puis surveiller pendant un certain temps qu'aucune eau ne s'écoule. L'éponge, c'est le confinement ; le raccord resserré, la correction ; l'inspection, la vérification ; et la surveillance, une clôture en toute confiance. Dans le travail sur les données, la même séquence s'applique lorsqu'un chargement mal formé, une partition obsolète ou un schéma cassé commence à affecter le reporting.

Les quatre phases qui gardent le travail honnête
Le confinement limite les dégâts supplémentaires. Cela peut consister à geler une table corrompue, à suspendre la publication vers les consommateurs BI ou à rediriger les utilisateurs vers le dernier instantané fiable connu pendant que l'équipe enquête.
La correction permanente supprime la cause sous-jacente. Dans une plateforme de données, il peut s'agir d'un correctif SQL, d'une modification du mapping de la source, d'une mise à jour du contrat de schéma ou d'une dépendance d'orchestration manquante.
La vérification prouve que la correction tient. Vous contrôlez ici les volumes de lignes, les règles métier, la compatibilité de schéma et les rafraîchissements en aval, au lieu de supposer que la modification suffisait à elle seule.
La clôture n'intervient qu'une fois les preuves réunies et la validation du responsable obtenue. Toute clôture antérieure relève de la simple commodité administrative.
Cette séparation nette compte, car la remédiation n'est ni la réponse aux incidents ni la maintenance courante. La réponse aux incidents arrête l'hémorragie. La maintenance garde les systèmes en bonne santé. La remédiation se situe entre les deux : quelque chose a déjà échoué, et l'équipe doit montrer que la défaillance a été résolue.
Pour des modèles opérationnels de qualité des données plus larges, digna data quality management s'articule naturellement avec cette idée, car la gestion de la qualité fournit le contexte de détection et de contrôle, tandis que le plan de remédiation prend en charge le workflow correctif.
Les éléments clés d'un plan qui fonctionne
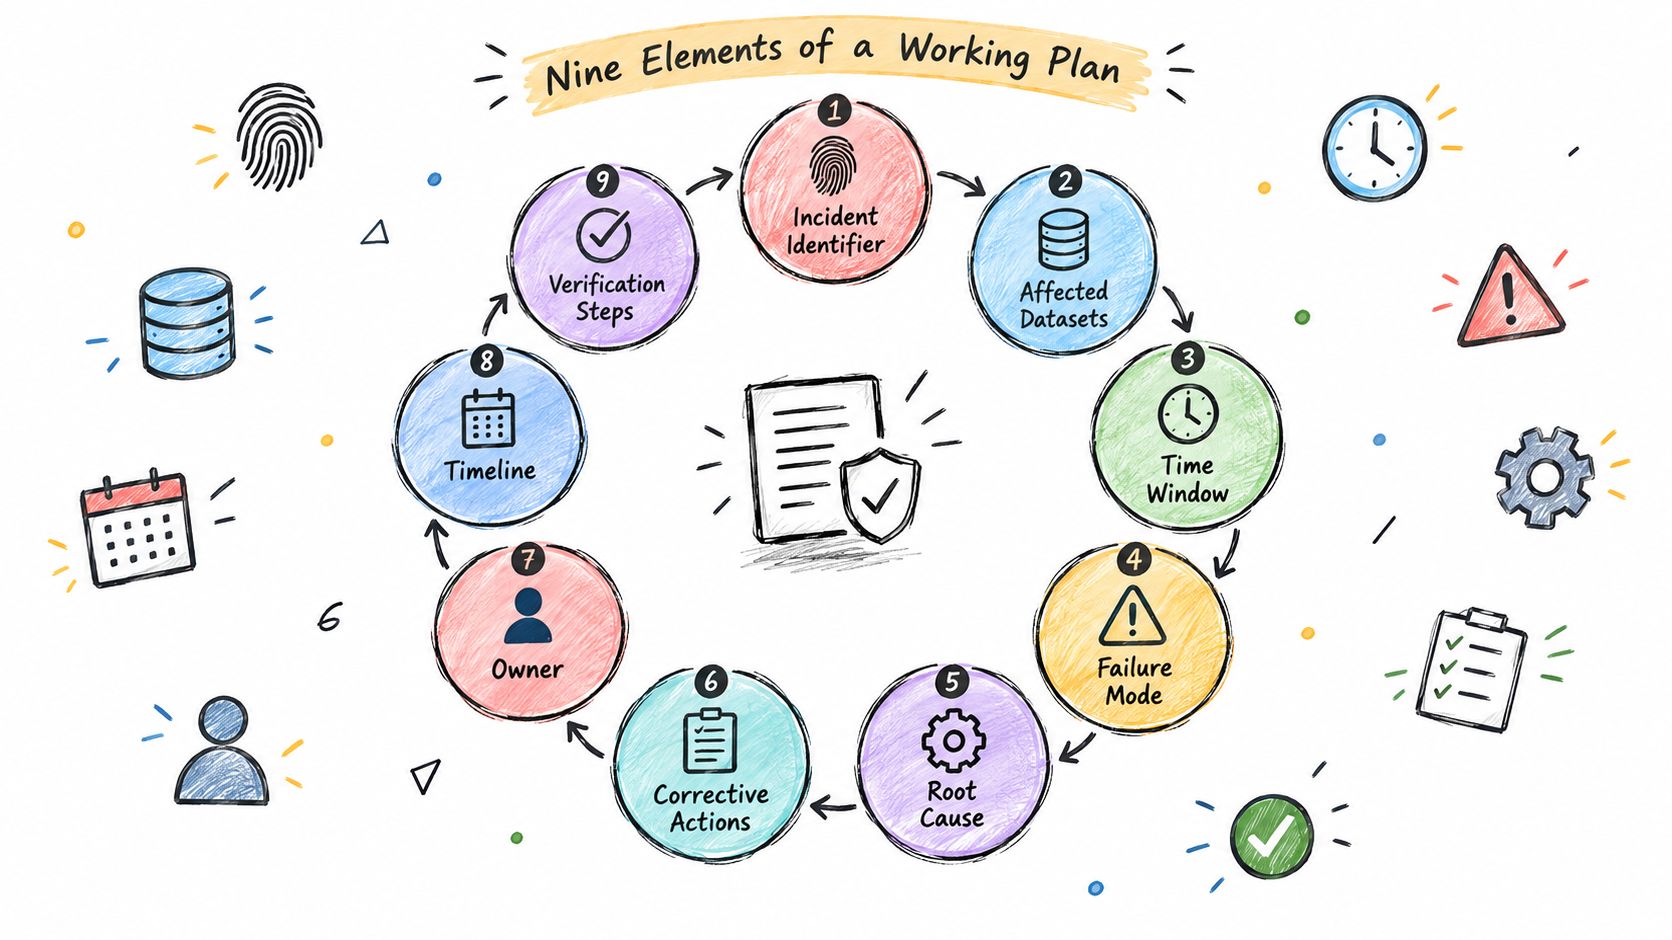
Un plan s'effondre vite lorsqu'il est trop vague pour être exécuté. « Réparer la table » donne une impression d'action, mais personne ne sait qui en est responsable, ce qui a changé ni quand la correction doit être considérée comme terminée. Un plan qui fonctionne doit contenir assez de contexte pour qu'un autre ingénieur puisse le reprendre sans deviner.
Les champs qui évitent toute ambiguïté
Identifiant d'incident. Il donne au problème une référence stable, pour que les logs, les fils de discussion et les tickets pointent tous vers le même événement.
Jeux de données et période concernés. Sans cela, vous corrigerez la mauvaise partition, manquerez une dépendance en aval ou surcorrigerez des données historiques qui n'étaient pas touchées.
Mode de défaillance. Nommez la nature du problème, par exemple une arrivée tardive, un schéma cassé, des valeurs invalides ou une dérive silencieuse d'un indicateur.
Impact métier. Indiquez ce que la défaillance a affecté, car un indicateur interne erroné et un flux réglementaire en retard n'ont pas la même urgence.
Hypothèse de cause racine. Consignez ce que l'équipe pense être à l'origine de la défaillance, même si cette hypothèse est encore en cours de vérification.
Responsable. Une seule personne redevable, pas une file d'attente d'équipes.
Priorité. Elle détermine l'ordre de traitement lorsque plusieurs plans sont ouverts.
Dépendances. Précisez ce qui doit se produire d'abord, comme des corrections en amont, une autorisation d'accès ou la coordination d'un backfill.
Méthode de rollback. Si la correction aggrave la situation, l'équipe a besoin d'un retour arrière sûr.
Date cible d'achèvement. Les échéances obligent à rendre les arbitrages visibles.
Critères d'acceptation. C'est la porte d'entrée. Si vous ne pouvez pas les définir, vous ne pouvez pas prouver la clôture.
Règle pratique : si un plan ne précise pas comment vous vérifierez le succès, ce n'est pas encore un plan de remédiation, c'est une liste de tâches.
Deux éléments manquent souvent en pratique, et tous deux coûtent cher. L'absence de responsable crée une dérive, car chacun suppose que quelqu'un d'autre s'en occupe. L'absence de critère d'acceptation crée de fausses clôtures, car le ticket peut être fermé alors que le problème persiste dans les données.
Pour l'hygiène du workflow, digna's data quality issue management process est pertinent, car le plan doit survivre aux passations, et pas seulement au tri initial.
Prioriser et phaser plusieurs plans ouverts
Les équipes ont rarement une seule remédiation ouverte. Elles en ont plusieurs, et certaines se disputent les mêmes personnes, la même fenêtre de mise en production et la même attention de la direction. Trier par ancienneté du ticket est facile, mais c'est une mauvaise façon de décider ce qui doit être corrigé en premier.
Critères de priorisation des plans de remédiation concurrents | Pourquoi c'est important | Signal d'urgence fort |
|---|---|---|
Impact métier | Affecte le chiffre d'affaires, le reporting, la confiance des clients ou la qualité des décisions | Le reporting clé de la direction est faux ou indisponible |
Exposition réglementaire | Crée un risque d'audit, de conformité ou de déclaration | Un flux ou un contrôle obligatoire est en retard ou peu fiable |
Criticité des données | Certains jeux de données alimentent de nombreux consommateurs en aval | Des données sources largement réutilisées sont touchées |
Probabilité de récidive | Une correction qui ne tient pas crée des incidents à répétition | Le même défaut ne cesse de réapparaître |
Nombre de dépendances | Plus de dépendances signifie généralement un rayon d'impact plus large | Plusieurs pipelines ou équipes dépendent du problème |
Délai avant dommage | Certains problèmes s'aggravent vite | Les données deviendront inutilisables dès le prochain cycle |
Pourquoi les phases comptent quand le correctif rapide ne suffit pas
Un correctif temporaire peut rétablir le service aujourd'hui tout en laissant la cause racine intacte. C'est pourquoi le confinement, la correction permanente et la vérification doivent être traités séparément. Si un flux en retard est redirigé manuellement, l'équipe a peut-être permis au métier de continuer à fonctionner, mais la faille sous-jacente demeure tant que l'automatisation ou la source amont n'est pas réparée.
Le choix est plus difficile lorsque le confinement immédiat entre en conflit avec une correction durable. Vous pourriez peut-être rejouer rapidement les événements, mais le faire avant que le contrat de schéma soit corrigé peut provoquer une seconde défaillance. Dans ce cas, un bon plan dit non au contournement le plus rapide et oui à la séquence qui réduit le risque.
Une clôture administrative ne prouve pas la remédiation. Seules des preuves validées le font.
Cette distinction compte sur les plateformes de données, car le travail peut sembler terminé bien avant que le risque ait disparu. Un dashboard peut se rafraîchir, une pipeline peut cesser d'échouer et un ticket peut être fermé. Si les résultats n'ont pas été rapprochés, le plan reste ouvert en pratique.
Lorsque les parties prenantes demandent pourquoi un problème passe avant un autre, expliquez l'arbitrage en termes métier, pas en nombre de tickets. Priorisez le constat qui peut vous nuire plus tôt, se propager plus loin ou faire échouer un contrôle, avant de vous attaquer au problème cosmétique qui paraît simplement désordonné.
Deux playbooks pour les défaillances courantes de qualité des données
Un bon plan devient concret dès que vous pouvez l'appliquer à une défaillance réelle. Les détails varient, mais la séquence reste la même : détecter, contenir, corriger, valider, puis prouver que la correction a tenu assez longtemps pour qu'on puisse lui faire confiance.
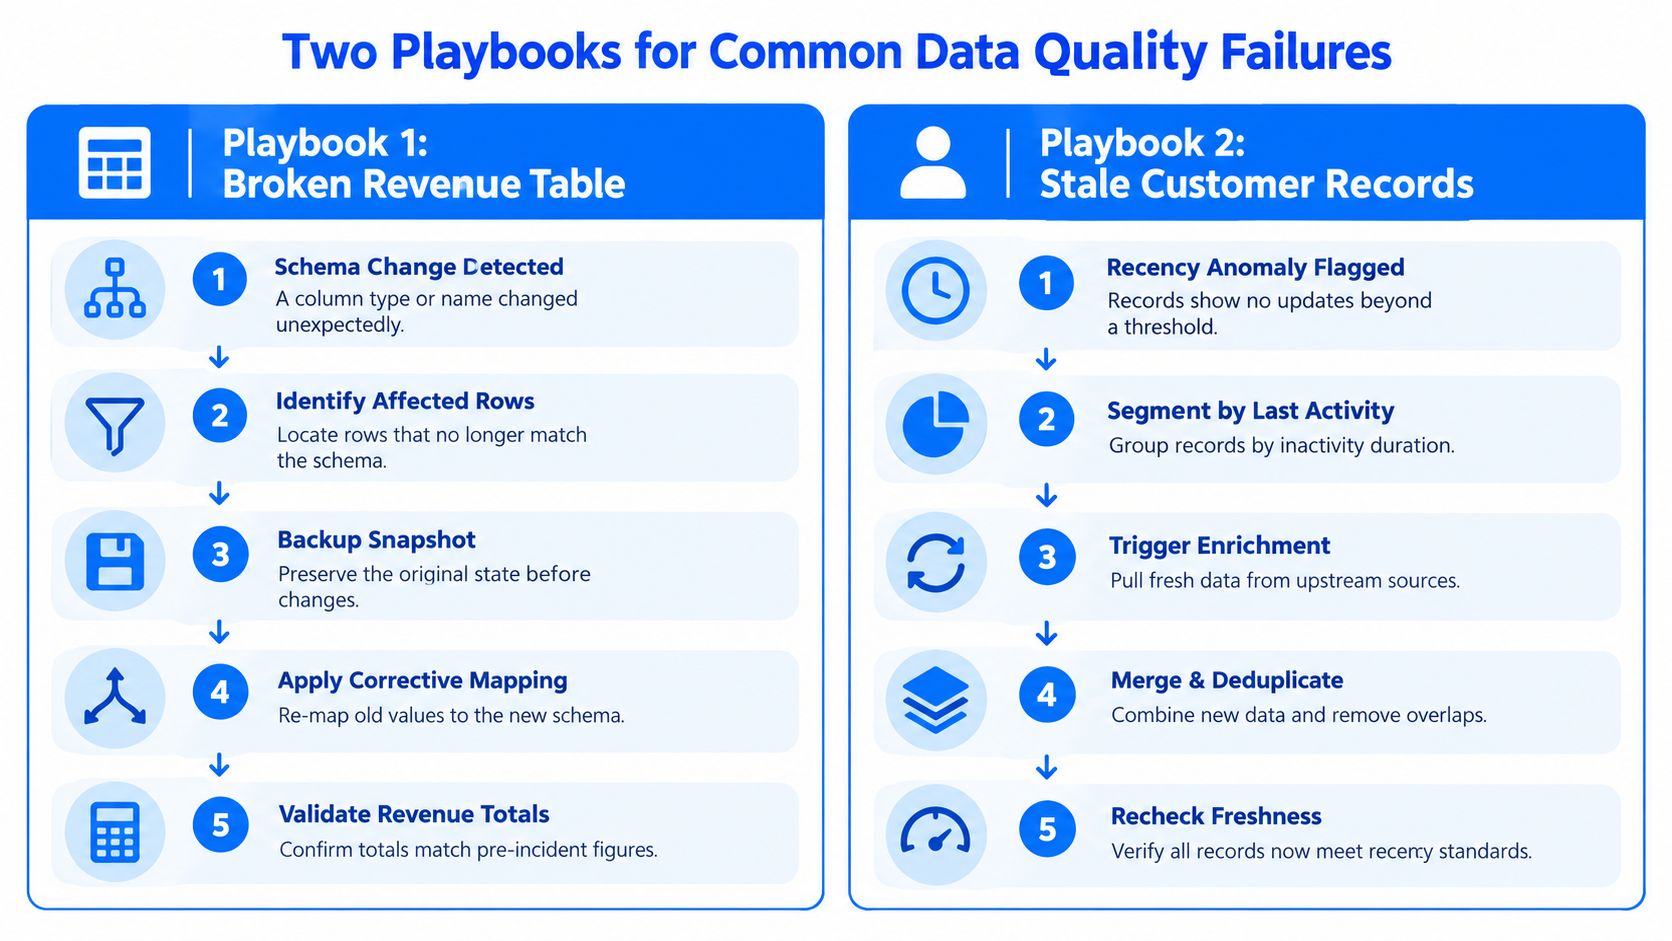
Playbook 1 : table de chiffre d'affaires cassée
Un système source modifie du jour au lendemain le type d'une colonne, et la table de chiffre d'affaires se met à charger des valeurs partielles ou invalides. L'équipe commence par limiter le rayon d'impact en suspendant la publication en aval ou en gelant la partition défectueuse. Elle isole ensuite les lignes concernées, préserve l'état d'origine et corrige le mapping pour que le nouveau schéma soit correctement pris en charge.
Vient ensuite la validation. L'équipe vérifie que les totaux de chiffre d'affaires se rapprochent de la source de référence, que les enregistrements réparés se chargent proprement et que les rafraîchissements en aval aboutissent sans intervention manuelle. La clôture n'intervient qu'une fois ces contrôles réussis et la validation du responsable obtenue.
digna data completeness checks sont utiles ici, car une arrivée incomplète ou un backfill partiel peut donner l'impression qu'une table est réparée alors qu'il lui manque encore des enregistrements.
Playbook 2 : fiches clients obsolètes
Une perte silencieuse de fraîcheur des données clients ne déclenche pas toujours une défaillance visible. Le modèle continue de tourner, mais ses données d'entrée vieillissent et deviennent moins fiables. Dans ce cas, la première étape consiste à signaler l'anomalie de fraîcheur, puis à segmenter les fiches concernées par durée d'inactivité pour que l'équipe mesure l'étendue du problème.
Ensuite, le responsable déclenche un enrichissement depuis les sources amont, fusionne les nouvelles informations et supprime les doublons. La dernière étape n'est pas simplement « le job s'est terminé », mais un nouveau contrôle qui confirme que les fiches respectent désormais le standard de fraîcheur et que le modèle en aval reçoit les données corrigées.
À quoi doivent ressembler les preuves de clôture
Table de chiffre d'affaires cassée : totaux rapprochés, backfills propres, aucune erreur de validation critique et rafraîchissements en aval réussis.
Fiches clients obsolètes : fraîcheur rétablie, dédoublonnage terminé et exécutions surveillées montrant que le problème n'est pas revenu au cycle suivant.
La différence entre un ticket fermé et un plan clôturé est simple. Un ticket dit que quelqu'un a travaillé dessus. Un plan dit que les résultats sont de nouveau fiables.
Comment digna alimente un plan de remédiation en preuves
Un plan de remédiation gagne beaucoup en solidité lorsque le signal d'incident contient déjà des preuves structurées. Cela ne signifie pas que la plateforme clôture le problème à votre place, mais que le plan démarre avec de meilleures données d'entrée et moins de suppositions. Le responsable passe moins de temps à reconstituer ce qui s'est passé et davantage à décider quoi faire.
Quelles données d'entrée vont où
Data Anomalies et Timeliness alimentent les premiers champs du plan. Ils aident à identifier ce qui a changé, quand cela a changé et s'il s'agit d'un retard, d'un chargement manquant ou d'un schéma de comportement inhabituel qui mérite une enquête.
Schema Tracker étaye l'hypothèse de cause racine. Si une colonne a été ajoutée, supprimée ou a changé de type, le plan peut pointer vers la modification structurelle exacte au lieu de la deviner à partir des symptômes en aval.
Data Validation aide à définir les critères d'acceptation. Si une règle métier au niveau de l'enregistrement doit être respectée avant la clôture, le plan peut faire explicitement référence à cette règle au lieu de compter sur un coup d'œil humain à un dashboard.
Business Monitoring et Data Platform Observability font remonter le signal en premier lieu. Ils montrent si l'indicateur métier, le comportement des workloads ou l'état de la plateforme est sorti de la plage attendue, ce qui donne au responsable un point de départ plus net pour l'enregistrement de l'incident.
Pour les équipes qui utilisent digna data quality observability, la valeur pratique réside dans la piste de preuves. Le plan peut inclure les jeux de données concernés, les fenêtres d'arrivée attendues, les écarts de schéma, les résultats de validation et le contexte historique, sans reconstituer ce contexte à la main à partir de logs dispersés.
Ce qui change quand les preuves sont là
Les responsables décident plus vite, car le mode de défaillance est plus clair.
Les critères d'acceptation sont plus précis, car ils sont liés à la validation et au comportement observé.
L'escalade est plus nette, car le plan montre si le problème est local, systémique ou récurrent.
La revue d'audit est plus simple, car l'enregistrement contient les preuves qui justifient la correction, et pas seulement l'action menée.
La remédiation cesse d'être un workflow informel pour devenir un processus auditable. Les preuves ne remplacent pas le jugement, mais elles le rendent défendable.
Clôturer un plan correctement et idées reçues courantes
Un ticket fermé n'est pas la même chose qu'une remédiation clôturée. Les équipes se mettent en difficulté lorsqu'elles prennent l'action pour une preuve, car l'action n'est qu'un début. La vraie question est de savoir si les données, le processus et les consommateurs en aval sont stables après la correction.
Ce qu'exige une vraie clôture
Un plan ne devrait être clôturé que lorsque les critères d'acceptation sont remplis, que les preuves sont conservées et que le responsable a enregistré sa validation. Si l'incident était assez grave pour nécessiter un confinement, une surveillance après clôture doit également être en place. Cette surveillance est le filet de sécurité qui vous indique si le défaut a bel et bien disparu.
Les idées reçues courantes prennent généralement trois formes. D'abord, les relances sont traitées comme des corrections alors qu'elles ne sont qu'une étape de confinement. Ensuite, les correctifs de schéma sont considérés comme des corrections permanentes même lorsque personne n'a vérifié la compatibilité en aval. Enfin, les équipes font l'impasse sur la surveillance de l'efficacité et supposent que l'absence d'alertes signifie que le problème a disparu.
Si vous ne pouvez pas expliquer comment la correction a été vérifiée, vous n'avez pas une clôture, vous avez de l'optimisme.
Une meilleure revue pose quelques questions courtes avant que quiconque ne marque le plan comme terminé. La correction a-t-elle traité la cause racine et pas seulement le symptôme ? Les données se sont-elles rétablies sur la période concernée ? Les consommateurs en aval ont-ils validé avec succès ? Le problème est-il resté silencieux sur les exécutions suivantes, et pas seulement sur la première après la modification ?
Ce critère protège l'équipe contre les clôtures prématurées et donne à la direction une meilleure réponse lorsqu'elle demande si le travail a réduit le risque. Il facilite aussi la passation vers le problème suivant, car le schéma des preuves devient partie intégrante de la manière dont l'organisation apprend. Le prochain sujet utile est celui des critères d'acceptation pour les incidents de qualité des données, car c'est là que de nombreux plans échouent encore à la dernière étape.
digna aide les équipes data à transformer les incidents en travail de remédiation fondé sur des preuves, grâce à la surveillance, à la validation, à Timeliness et au suivi des schémas, qui alimentent des plans plus clairs et des clôtures plus nettes. Si vous souhaitez passer d'une gestion informelle des tickets à un workflow maîtrisé, rendez-vous sur digna et découvrez comment la plateforme soutient ce processus dans votre propre environnement.
Les critères d'acceptation ne verrouillent la clôture que s'ils existent sous forme de contrôles exécutables. Pour les transformer en règles qui réussissent ou échouent sur des enregistrements réels, consultez comment concevoir des règles de validation des données.
Questions fréquentes
Qu'est-ce qu'un plan de remédiation en qualité des données ?
Un plan de remédiation est un ensemble contrôlé d'actions fondées sur des preuves qui élimine la cause racine d'une non-conformité détectée, rétablit les données ou le processus concernés, empêche la récidive et prouve que la correction fonctionne. Contrairement à un ticket, qui ne fait que consigner une activité, il doit démontrer que le risque a réellement baissé.
Quelles sont les phases d'un plan de remédiation ?
Il y en a quatre : confinement, correction permanente, vérification et clôture. Le confinement limite les dégâts, par exemple en gelant une table corrompue. La correction supprime la cause, comme un correctif SQL ou de mapping. La vérification contrôle volumes de lignes, règles et rafraîchissements en aval, et la clôture n'intervient qu'avec des preuves et la validation du responsable.
Que doit contenir un plan de remédiation ?
Au minimum un identifiant d'incident, les jeux de données et la période concernés, le mode de défaillance, l'impact métier, une hypothèse de cause racine, un responsable unique, une priorité, les dépendances, une méthode de rollback, une date cible et des critères d'acceptation. Le responsable et les critères d'acceptation sont les champs le plus souvent oubliés.
Comment prioriser plusieurs plans de remédiation ouverts ?
Selon le risque plutôt que l'ancienneté du ticket. Évaluez l'impact métier, l'exposition réglementaire, la criticité des données, la probabilité de récidive, le nombre de dépendances et le délai avant dommage, puis traitez d'abord ce qui peut nuire plus tôt, se propager plus loin ou faire échouer un contrôle, avant un problème simplement désordonné.
Quand peut-on clôturer un plan de remédiation ?
Seulement lorsque les critères d'acceptation sont remplis, que les preuves sont conservées et que le responsable a enregistré sa validation. Relancer un traitement relève du confinement, pas de la correction, et l'absence d'alertes ne prouve rien à elle seule : les incidents graves exigent donc aussi une surveillance après clôture sur les exécutions suivantes.


