Règles de validation des données : Un guide de conception pratique
|
5
minute de lecture

On sait qu'un pipeline de données est en difficulté lorsque le tableau de bord est techniquement en ligne, que les chiffres sont techniquement présents, mais que les équipes métiers ne peuvent toujours pas faire confiance à une seule ligne à l'écran. Une seule mauvaise valeur de référence, un champ manquant ou un enregistrement qui échappe à un contrôle laxiste suffit à transformer une revue du vendredi en une séance d'archéologie. C'est généralement à ce moment-là que l'on se rend compte que le problème n'est pas le rapport, mais l'absence de règles de validation des données conçues, testées et gouvernées comme du véritable code de production.
La validation fonctionne au mieux lorsque l'on cesse de la traiter comme une tâche administrative pour la traiter comme un contrat. La formulation d'Eurostat est directe : si une combinaison de valeurs ne figure pas dans l'ensemble accepté, elle échoue, et la règle doit être définie et documentée de manière univoque afin que les producteurs et les consommateurs partagent la même compréhension du contrôle appliqué, ce qui constitue une base bien plus propre pour l'auditabilité et la Data Governance qu'un vague filtre basé sur le meilleur effort (Eurostat data validation guidance). Si vous souhaitez transposer cette même idée dans un contexte produit pratique, this overview of data validation rend le cycle de vie plus concret sans masquer la réalité opérationnelle.
Pourquoi vos données vous mentent discrètement
Les pires défaillances de données s'annoncent rarement d'elles-mêmes. Un rapport se charge toujours, le graphique s'affiche, et tout le monde suppose que les chiffres sont « assez proches » jusqu'à ce qu'une anomalie surgisse lors d'une réunion et que quelqu'un doive expliquer pourquoi les chiffres d'hier ne correspondent pas à l'extraction d'aujourd'hui. Les contrôles ponctuels manuels ne sont pas adaptés à ce type de problème, car les mauvaises lignes se cachent généralement au milieu de celles d'apparence normale.
La validation est un pacte, pas un filtre
C'est pourquoi la validation au niveau de l'enregistrement est essentielle. Elle transforme une attente floue en une règle partagée, et donne aux équipes d'ingénierie et métier le même langage pour qualifier les erreurs. Eurostat définit la validation des données comme la vérification de l'appartenance d'une combinaison de valeurs à un ensemble accepté, et son guide précise que les règles doivent être clairement et univoquement définies, documentées et adaptées à leur usage afin que chacun puisse interpréter le résultat de la même manière (Eurostat data validation guidance).
Une validation échouée devrait vous indiquer quelle règle métier a été enfreinte, et non pas simplement que la ligne a déplu à la base de données.
Cette distinction change la façon de travailler des équipes. Un mauvais enregistrement n'est plus seulement une « donnée sale », c'est la preuve qu'une contrainte métier, une hypothèse de schéma ou une obligation de reporting a été violée. C'est la valeur fondamentale des règles de validation des données : elles créent des points de contrôle mesurables au lieu de transformer la qualité en une promesse floue.
Le bénéfice opérationnel est la prévisibilité. Lorsque les règles sont documentées et appliquées de manière cohérente, les producteurs de données savent ce qu'ils doivent envoyer, et les consommateurs savent quel type de données ils peuvent légitimement croire. Si vous avez déjà vu un pipeline « fonctionner à peu près » pendant des mois avant qu'un cas limite masqué ne fasse exploser un tableau de bord, vous savez déjà pourquoi cette discipline s'avère payante.
L'anatomie des règles de validation au niveau de l'enregistrement
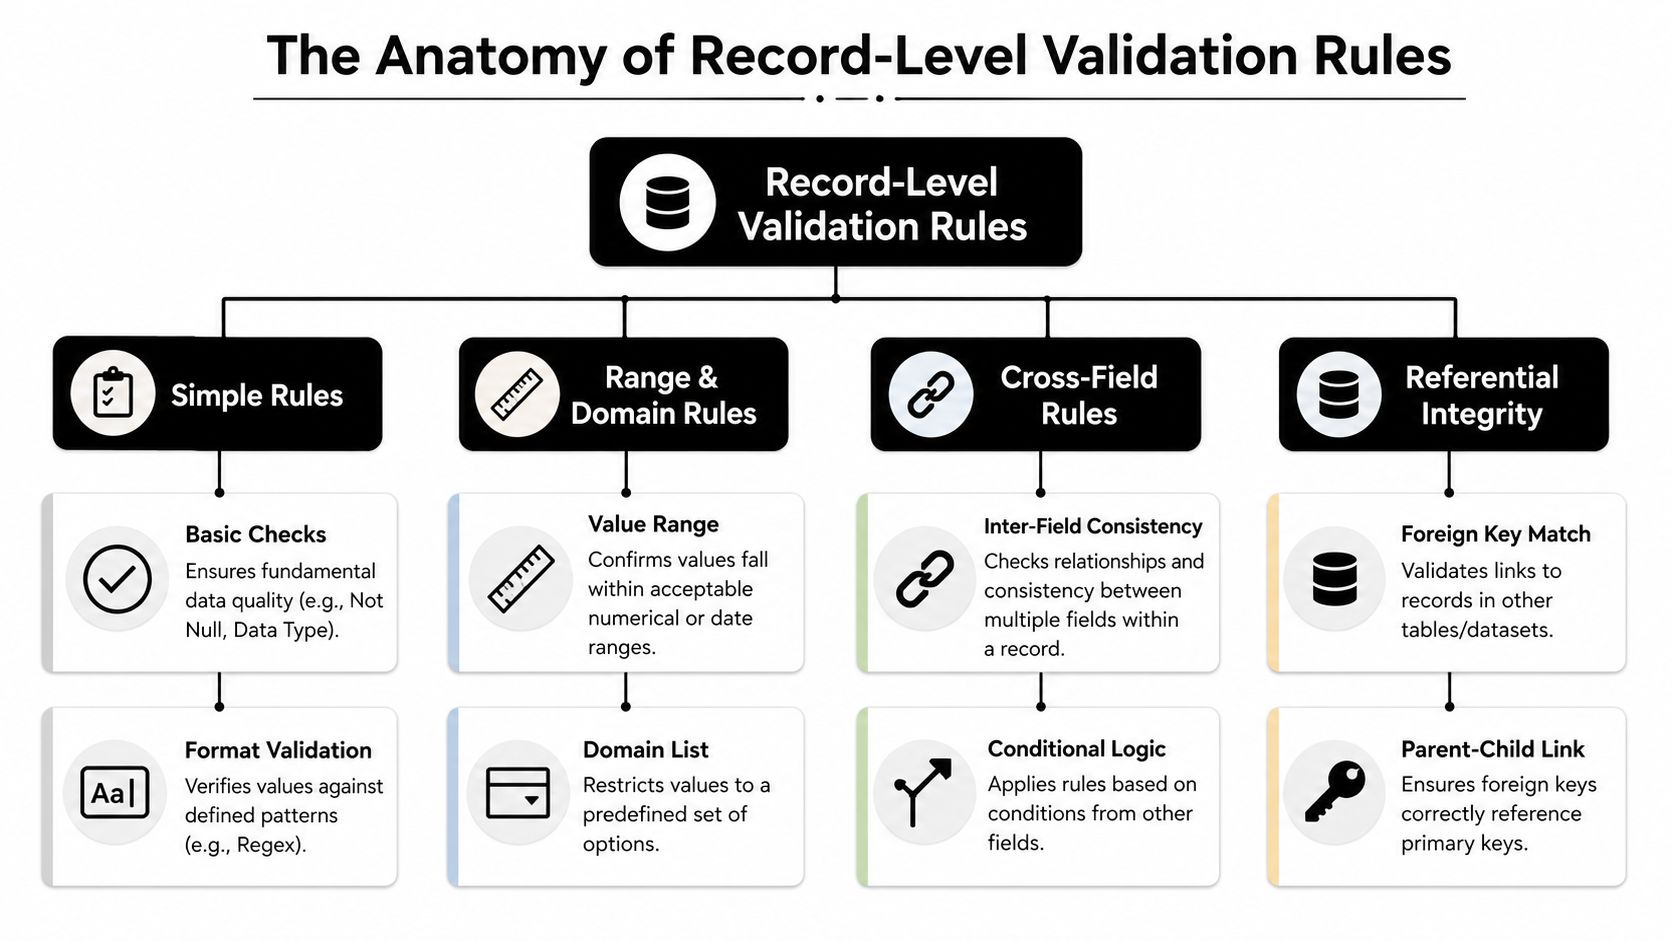
Avant d'écrire du code, vous devez cartographier les familles de règles que vous allez utiliser. Le flux de travail standard regroupe les vérifications en validation de format, contrôles de plage, validation de schéma et validation croisée de champs, ce qui constitue un point de départ utile car cela vous oblige à séparer les problèmes de syntaxe des problèmes de logique métier (Atlan's data validation workflow). Cette séparation maintient la simplicité de compréhension de votre framework, ce qui importe bien plus que de paraître sophistiqué.
Commencez par les contrôles simples
Les règles les plus simples sont généralement les premières à déployer. La présence de valeurs nulles, le type de données et la validation de format capturent le genre d'erreurs qui sont faciles à rejeter et pénibles à nettoyer plus tard. Si un e-mail ne correspond pas au modèle attendu, ou si une date arrive dans un format erroné, il n'y a aucun intérêt à laisser cet enregistrement dériver en aval simplement parce que le reste de la ligne semble correct.
Ajoutez ensuite des contraintes numériques et de domaine
C'est avec les contrôles de plage que la validation commence à s'apparenter à une politique métier plutôt qu'à une simple hygiène des champs. Un prix doit être positif, une remise ne doit pas dépasser le prix, et un champ d'âge doit s'inscrire dans une limite acceptable si le domaine d'activité l'exige. Pour la gestion des soins pour animaux de compagnie, cette même logique est utile lorsque vous devez ensuring compliant pet health records, car un champ manquant ou mal formé peut briser la chaîne de responsabilité même lorsque l'enregistrement se « charge ».
N'oubliez pas les relations entre les champs
La validation croisée entre champs est l'endroit où l'on commet généralement le plus d'erreurs. Un pays de livraison ne peut être traité de manière isolée si un autre champ est censé comporter un identifiant spécifique à ce pays, et un indicateur de statut n'a de sens que s'il est associé à une date ou à un code correspondant. Ces règles sont plus complexes à écrire que les contrôles sur un seul champ, mais ce sont également elles qui détectent les contradictions subtiles qui, autrement, donneraient au reporting une apparence de cohérence interne tout en restant erroné.
Règle pratique : si un champ n'a de sens que dans un contexte, validez-le dans ce contexte.
L'intégrité référentielle va de pair avec la logique croisée de champs, même si elle semble plus naturelle pour les bases de données que pour les équipes métiers. Une clé étrangère qui ne pointe pas vers une véritable ligne parente reste un échec métier, pas seulement un problème de stockage. C'est pourquoi les ensembles de règles de validation spécifiques à un domaine incluent souvent des contrôles explicites tels que des prix positifs, l'absence d'observations négatives et des observations uniques, le tout rédigé sous forme de conditions vérifiables par machine afin de maintenir l'assurance qualité automatisée compréhensible pour les ingénieurs (SNStatComp Domain Validation Rules).
Vous pouvez également adopter une vision orientée plateforme de cette anatomie si vous avez besoin d'un modèle d'entreprise plus large. Le modèle au niveau de l'enregistrement dans digna's enterprise validation approach est utile précisément parce qu'il transpose ces familles de règles en exécution au sein de la base de données plutôt que de les laisser sous forme de notes politiques abstraites.
De la logique au code
La théorie n'importe que lorsque la règle peut rejeter une mauvaise commande sans compliquer le traitement des bonnes commandes. Supposons que vous validiez un enregistrement dynamique orders contenant order_id, customer_id, price, discount, shipping_country et nif. Vous voulez que le code soit suffisamment lisible pour que le prochain ingénieur n'ait pas à faire de l'ingénierie inverse sur les règles métier à partir d'un tas d'effets de bord.
Rendez la règle évidente en SQL
Une contrainte CHECK propre reste la meilleure première ligne de défense pour la logique simple des champs.
Cela vous donne un mode de défaillance net pour les cas évidents. Cela permet également de garder la règle proche du modèle de données, ce qui est important car une règle de validation masquée et enfouie dans le code de l'application est facile à oublier et difficile à auditer.
Utilisez une logique croisée lorsque une colonne dépend d'une autre
Certaines règles n'ont pas leur place dans un simple CHECK car elles nécessitent un comportement conditionnel. Dans ce cas, une expression CASE ou une logique de type déclencheur (trigger) est plus claire que de tenter d'intégrer toute la règle métier dans un seul prédicat.
Ce modèle rend la règle explicite. Si le pays de livraison est l'Espagne, l'enregistrement a besoin de l'identifiant attendu, et s'il ne l'a pas, vous obtenez un signal de défaillance direct au lieu d'une exception obscure en aval.
Testez l'unicité et l'intégrité référentielle avec des requêtes
Les contrôles d'unicité sont plus faciles à maintenir lorsqu'ils sont écrits sous forme de diagnostics directs plutôt que de code procédural complexe.
Et l'intégrité référentielle est tout aussi directe.
Ces requêtes sont d'une simplicité idéale. Elles vous indiquent exactement ce qui a échoué, c'est pourquoi les règles de validation spécifiques à un domaine sont souvent implémentées sous forme de contrôles explicites au niveau de l'enregistrement tels que des prix positifs, l'absence d'observations négatives et des observations uniques, qui peuvent tous être exécutés à grande échelle tout en restant interprétables pour les ingénieurs (SNStatComp Domain Validation Rules).
Si vous souhaitez un exemple de plateforme illustrant ce style, digna's manual rule maintenance discussion mérite d'être lue en parallèle de vos propres modèles SQL, car la question utile n'est pas de savoir si la règle existe, mais avec quel niveau de sécurité elle peut être maintenue dans le temps.
Conservez un message d'erreur utile
Une mauvaise règle avec un message vague ne fait que créer du travail supplémentaire. « Échec de la validation » n'aide personne, tandis que « shipping_country=ES nécessite nif » donne au consultant métier et à l'ingénieur le même point de départ pour la résolution du problème. En pratique, le message fait partie intégrante de la règle, ce n'est pas un simple élément de décoration.
Au-delà du simple fonctionnement : des stratégies de test plus intelligentes
Une règle de validation qui n'a pas été testée n'est qu'une hypothèse avec un budget de production. Traitez-la comme du code d'application, car c'est ce qu'elle devient dès lors qu'elle peut bloquer des données, émettre des alertes ou alimenter des flux de Compliance. Être dans l'erreur ici coûte cher, car une règle de validation défaillante peut rejeter de bonnes données ou, pire, laisser passer de mauvaises données avec une attestation de conformité parfaite.
Testez la règle par couches
Une approche pratique commence modestement. Les tests unitaires utilisent un volume d'enregistrements très limité, certains valides et d'autres non, afin que chaque règle puisse être vérifiée de manière isolée. C'est là que vous détectez les erreurs évidentes, le seuil décalé d'une unité, le contrôle de nullité inversé ou la règle qui signale accidentellement des cas limites pourtant légitimes.
Les tests d'intégration s'effectuent quant à eux au sein même du pipeline. Ils vous montrent comment les règles se comportent lorsque la préparation, la transformation et le chargement sont tous actifs, ce qui est souvent l'endroit où une logique bien structurée commence à poser problème. Les tests de régression protègent ensuite le comportement existant à chaque fois qu'une règle est modifiée, afin de ne pas « corriger » une validation tout en en cassant par inadvertance trois autres.
Séparez les défaillances au niveau fichier des défaillances au niveau enregistrement
Le modèle opérationnel le plus utile que j'ai vu est celui utilisé dans le reporting des transactions de l'UE, où les règles de syntaxe au niveau du schéma rejettent l'ensemble du fichier et les règles de contenu rejettent uniquement les transactions non valides. Cette division permet de limiter la zone d'impact et d'éviter des resoumissions inutiles (ESMA MiFIR transaction reporting validation rules).
Ne faites pas subir la faute d'une seule mauvaise ligne à tout un lot, à moins que la structure elle-même ne soit cassée.
Ce principe est simple à énoncer mais étonnamment facile à ignorer. Si le fichier est mal formé, arrêtez-vous immédiatement. Si une seule transaction viole la logique métier, mettez en quarantaine ou signalez l'enregistrement et laissez le reste continuer, pour autant que votre processus et vos exigences de Compliance le permettent.
Pour l'analyse des causes profondes, this guide to analysing data issues with AI peut aider les équipes à passer de « quelque chose a échoué » à « ce modèle spécifique en est la cause » sans transformer chaque incident en recherche manuelle.
Une matrice de test simple
Scénario nominal valide : la commande doit passer toutes les règles.
Mauvais enregistrement connu : la commande doit échouer précisément sur une règle nommée.
Cas limite : la règle doit se comporter correctement à la valeur frontière.
Échantillon de régression : un enregistrement précédemment accepté doit le rester après modification d'une règle.
C'est amplement suffisant pour s'assurer de l'exactitude de la règle sans complexifier le dispositif de test. Si vous ne pouvez pas expliquer pourquoi un test existe, c'est que vous n'en avez probablement pas besoin.
Déployer et gérer les règles sans complication
Rédiger des règles est la partie facile. Vivre avec est le véritable travail de conception, car toute modification de la politique métier risque de bousculer les anciennes certitudes. Un framework de validation qui ne peut pas être versionné, expliqué et réexécuté en toute sécurité finira par devenir l'outil auquel personne ne veut toucher.
Choisissez délibérément votre modèle de déploiement
Le Strict Gatekeeper bloque les mauvais enregistrements avant qu'ils ne pénètrent dans les systèmes en aval. C'est le bon choix pour les pipelines hautement sécurisés, le reporting réglementé et tout ce qui créerait des perturbations si des données invalides venaient à se propager.
L'Observant Monitor laisse passer les données mais signale, met en quarantaine ou oriente les échecs vers une révision. C'est utile lorsque la disponibilité importe plus que le rejet immédiat, ou lorsque vous devez observer la nature du problème avant de renforcer le contrôle.
Aucun de ces deux modèles n'est universellement supérieur. Le contrôle d'accès (gatekeeping) vous donne une maîtrise plus étroite, tandis que la surveillance (monitoring) vous apporte résilience et visibilité. La plupart des équipes matures finissent par combiner les deux, car tous les ensembles de données ne justifient pas le même niveau de friction.
Rendez le cycle de vie de la règle explicite
Une règle doit avoir une version, une note modificative et un propriétaire clairement identifié. Elle a également besoin de journaux d'audit montrant quand elle a été exécutée, ce qu'elle a évalué et comment elle a échoué ou réussi, car c'est le seul moyen d'assurer des audits sans transformer chaque incident en enquête policière. Les conseils d'Eurostat sont également pertinents ici, car ils préconisent de documenter les règles et même leurs messages d'erreur afin que chacun interprète les échecs de la même façon (Eurostat principles).
Le défi majeur de maintenance reste la dérive des règles. Les politiques métiers changent, les systèmes sources évoluent, et ce qui était autrefois un seuil judicieux peut devenir une nuisance ou une zone d'ombre. Le workflow de validation d'ArcGIS rappelle opportunément que la validation est un processus opérationnel et non figé, car les règles nécessitent souvent des évaluations, des inspections et des réévaluations après modification, en particulier lorsque les schémas et les conditions de reporting évoluent dans le temps (ArcGIS validation attribute rules).
Là où une plateforme peut simplifier la tâche
Une plateforme peut s'avérer utile lorsque le volume de règles, de systèmes et d'exceptions commence à dépasser la capacité de gestion des tableurs et des scripts ad hoc. Une option est digna, qui utilise une logique de validation métier et technique déterministe avec in-database rule execution et complete audit trails, de sorte que les contrôles s'exécutent là où résident les données et que les preuves soient conservées pour les examens de Compliance et réglementaires (digna platform introduction).
Cela importe car la validation n'est utile que si l'on peut faire confiance à la fois au résultat et au processus. Une bonne interface utilisateur est appréciable, mais le gain le plus profond réside dans la traçabilité : la capacité de savoir qui a modifié quoi, ce qui a échoué et pourquoi l'enregistrement a été traité de cette manière.
Si vous comparez également les options d'Observability et d'application des règles, protecting your research data est une lecture complémentaire utile car elle met l'accent sur l'intégrité plutôt que sur la simple alerte.
L'aboutissement : la validation comme pilier de la confiance dans les données
Une bonne règle naît d'un besoin métier, devient du code, passe par des tests et vit enfin comme un actif de production surveillé, doté d'un propriétaire et d'un journal d'audit. Ce cycle de vie marque la différence entre des contrôles aléatoires et une véritable posture de gouvernance. Une fois que l'organisation envisage la validation comme un système et non comme un correctif ponctuel, la confiance devient plus facile à acquérir et à défendre.
Les équipes les plus performantes cessent de se demander si elles doivent valider les données et commencent à définir à quel endroit chaque règle doit être placée, comment elle est versionnée et que faire lorsqu'elle échoue. C'est ce basculement qui transforme les ingénieurs de données en gardiens de l'intégrité plutôt qu'en équipes de nettoyage. Si vous recherchez un cadre culturel plus large, this guide to building data quality habits relie de façon très utile les contrôles techniques à la responsabilité quotidienne.
L'objectif final n'est pas d'obtenir des données parfaites, car cela n'existe pas. L'objectif est d'obtenir des données prévisibles, des exceptions visibles et un processus qui révèle la vérité assez rapidement pour que les analystes, les auditeurs et les équipes opérationnelles puissent agir. Une fois ces éléments en place, la validation cesse d'être une contrainte pour devenir l'une des raisons discrètes pour lesquelles vos analyses, votre Compliance et vos automatisations tiennent la route.
Un appel à l'action pour digna.
Pour exécuter ces règles au niveau des enregistrements directement dans la base de données, avec une piste d'audit de ce qui a échoué et pourquoi, consultez digna Data Validation.
Questions fréquentes
Quels sont les principaux types de règles de validation des données ?
L'article regroupe les règles en validation de format, contrôles de plage, validation de schéma et validation inter-champs, avec l'intégrité référentielle à côté. Commencez par des contrôles simples de nullité, de type et de format, ajoutez des contraintes numériques et métier comme des prix positifs, puis écrivez des règles inter-champs pour les champs qui n'ont de sens qu'en contexte.
Comment écrire une règle de validation des données en SQL ?
Pour une logique portant sur un seul champ, utilisez une contrainte CHECK dans la définition de la table, comme CHECK (price > 0) ou CHECK (discount <= price). Les règles conditionnelles conviennent mieux à une expression CASE, qui rejette par exemple une commande lorsque shipping_country = 'ES' et nif IS NULL, ce qui rend la règle métier explicite.
Comment tester des règles de validation des données ?
Testez-les comme du code applicatif, par couches : tests unitaires sur de petits jeux sélectionnés d'enregistrements valides et invalides, tests d'intégration dans le pipeline et tests de régression à chaque modification de règle. Une matrice simple couvre un cas nominal, un enregistrement erroné connu, un cas limite et un échantillon de régression.
Un échec de validation doit-il rejeter tout le fichier ?
Seulement si la structure elle-même est défectueuse. Selon la pratique européenne de déclaration des transactions MiFIR, les erreurs de syntaxe au niveau du schéma rejettent tout le fichier, tandis que les violations des règles de contenu ne rejettent que les transactions invalides. Cette séparation limite l'impact et évite des renvois inutiles.
Quelle différence entre une validation de type gatekeeper et une validation de surveillance ?
Le Strict Gatekeeper bloque les enregistrements erronés avant qu'ils n'atteignent les systèmes en aval, ce qui convient aux rapports réglementés et aux pipelines à forte exigence de confiance. L'Observant Monitor laisse passer les données mais signale, met en quarantaine ou oriente les échecs vers une revue. La plupart des équipes matures combinent les deux.



