Définir les données agrégées : méthodes, exemples et points de vigilance
|
7
minute de lecture

Les données agrégées sont des informations obtenues en regroupant des enregistrements individuels par catégories et en combinant leurs valeurs en mesures de synthèse comme des comptages, des sommes, des moyennes ou des taux. Cela paraît simple, mais le conseil « il suffit de faire un dashboard » est celui qui pose le plus de problèmes, car l'agrégation modifie à la fois le sens et le profil de risque des enregistrements sous-jacents.
Table des matières
Où se fait l'agrégation dans les systèmes de données modernes
Pourquoi les données agrégées comptent pour l'analytique et l'observabilité
Risques pour la vie privée et de divulgation dans les résultats agrégés
Un exemple concret : des enregistrements bruts à un agrégat fiable
Ce que recouvrent vraiment les données agrégées
Les données agrégées sont des informations de synthèse dérivées d'enregistrements de niveau inférieur, et non un type de données distinct qui apparaîtrait de lui-même. Le modèle mental comporte deux côtés : d'un côté, des événements, transactions ou observations individuels ; de l'autre, des totaux, moyennes ou taux au niveau du groupe qui condensent de nombreuses lignes en un nombre réduit de résultats.
Un exemple parlant est une base de données contenant 1 million de transactions clients individuelles résumées en 12 totaux mensuels par marché. Vous ne voyez plus chaque achat, mais vous pouvez comparer les marchés, suivre la saisonnalité et repérer les grandes tendances beaucoup plus vite. L'Australian Bureau of Statistics décrit l'agrégation comme le regroupement d'informations en catégories et la combinaison des valeurs au sein de ces catégories, souvent sous forme de tableaux, d'où les termes de données tabulaires ou de macrodonnées ABS glossary.

La définition opérationnelle qui tient la route en pratique
Considérez l'agrégation comme une transformation appliquée à des observations brutes. Une transaction client devient un chiffre d'affaires mensuel, un flux d'événements de télémétrie devient un nombre d'erreurs par heure, et un recensement des ménages devient un tableau de caractéristiques de la population. C'est le geste de base : réduire de nombreux enregistrements à un nombre réduit de synthèses.
Règle pratique : si le résultat peut répondre à une question sur un groupe mais pas sur une personne, il est agrégé. Si vous pouvez encore remonter du résultat à un seul enregistrement sans contexte supplémentaire, traitez-le comme un risque pour la vie privée et un risque de divulgation.
Cette distinction compte, car un même résultat peut être utile pour le reporting tout en restant assez sensible pour exiger des contrôles. Si vous cherchez une seconde source de terminologie pour comprendre comment les fournisseurs décrivent ce domaine, la collection pricing data research de Wine Labs est une référence voisine utile sur la manière dont les synthèses structurées sont présentées dans les études de marché.
Les principales méthodes d'agrégation expliquées
L'agrégation devient plus simple dès que l'on cesse de la voir comme une seule opération. En pratique, les équipes s'appuient sur un petit ensemble de fonctions, et chacune répond à une question différente sur les mêmes lignes sous-jacentes.
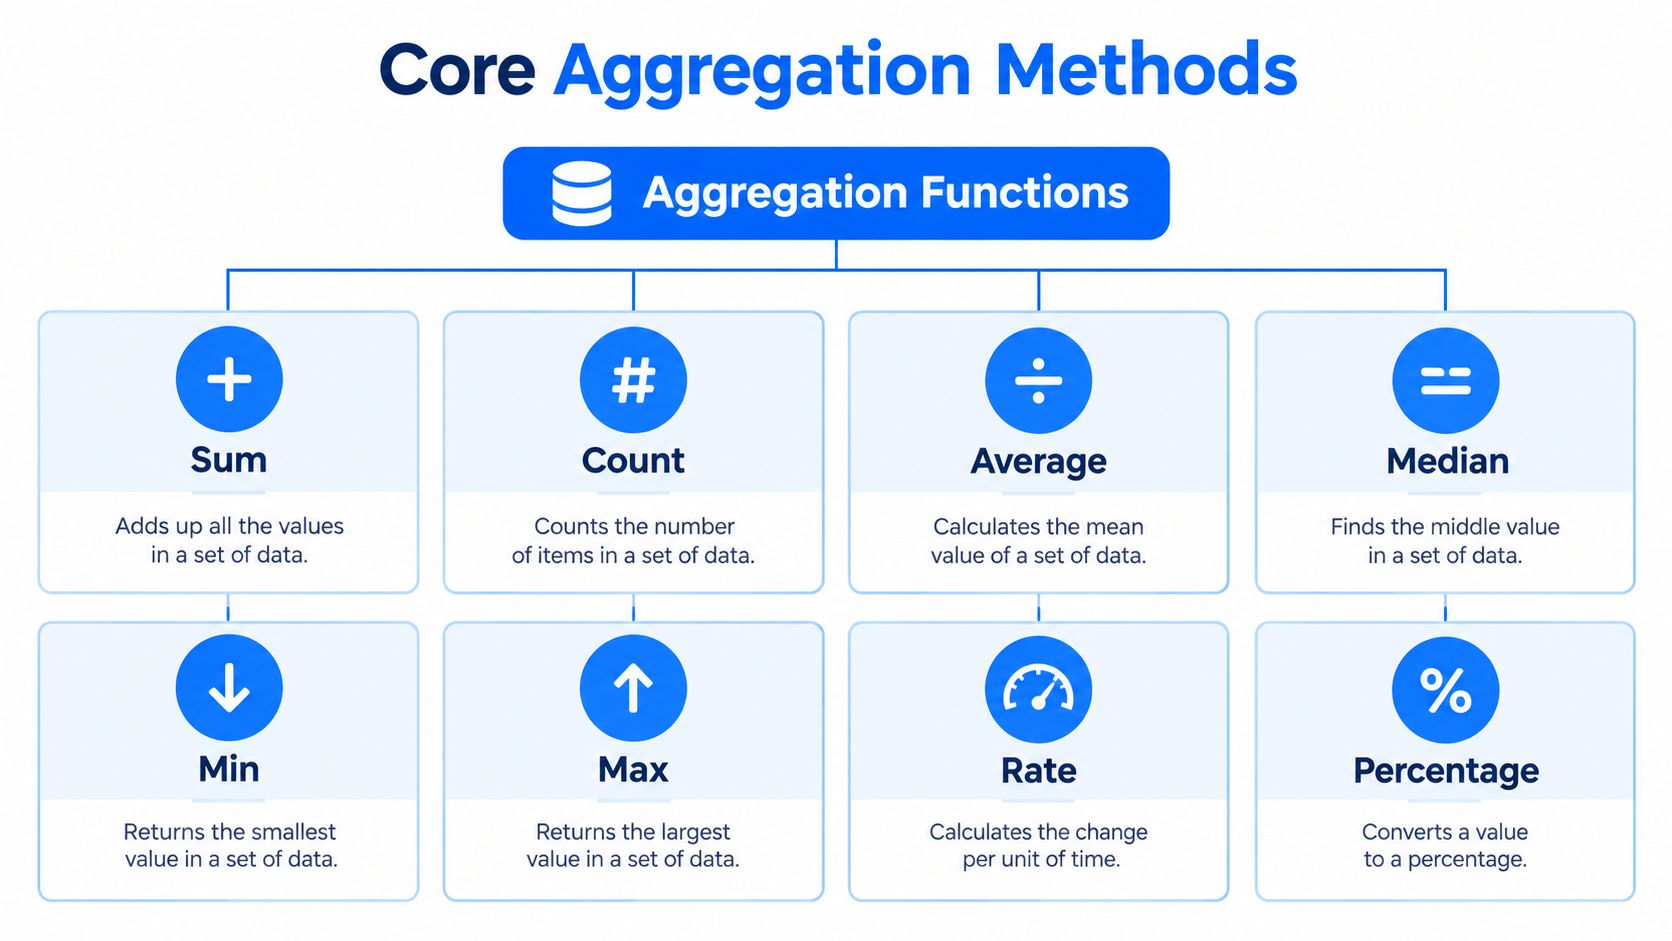
Les fonctions principales et ce qu'elles préservent
La somme additionne les valeurs. Si cinq commandes valent 20, 30, 10, 40 et 50, la somme est de 150. C'est le bon choix lorsque vous vous intéressez au volume, au chiffre d'affaires, aux unités vendues ou au temps total passé.
Le comptage indique combien d'enregistrements contient le groupe. Il préserve le volume d'activité, mais pas l'ampleur des valeurs, et convient donc aux transactions, tickets, utilisateurs ou événements lorsque la question est « combien ? ».
La moyenne donne la moyenne arithmétique. Elle aide à trouver une valeur typique, mais peut induire en erreur si quelques valeurs aberrantes élevées éloignent le résultat de ce à quoi ressemblent la plupart des lignes.
La médiane donne la valeur centrale après tri. Utilisez-la lorsque la distribution est asymétrique, car elle résiste mieux aux valeurs extrêmes que la moyenne.
Le minimum et le maximum conservent la plus petite et la plus grande valeur. Ils sont utiles pour les contrôles de plage, mais écartent tout ce qui se trouve entre les deux.
Les taux et pourcentages exigent de la rigueur sur le dénominateur
Un taux est un ratio, par exemple les conversions divisées par les visiteurs. Un pourcentage exprime la même idée sur une échelle de 100. Les deux n'ont de sens que si le dénominateur est stable et clairement défini.
Une erreur fréquente consiste à faire la moyenne de pourcentages entre des groupes aux dénominateurs inégaux. Un petit groupe pèse alors autant qu'un grand, ce qui fausse le résultat. Si la question est « quelle part de l'ensemble du trafic a converti ? », le dénominateur doit être la totalité du trafic, et non une moyenne des taux de conversion mensuels.
Règle empirique : utilisez la fonction la plus simple qui préserve la décision à prendre, et rien de plus. Si la question métier porte sur l'ampleur, utilisez la somme ou le comptage. Si elle porte sur le comportement typique, préférez la médiane à la moyenne lorsque les données sont asymétriques.
Rollups, fenêtres et agrégations temporelles
Le temps transforme l'agrégation en une décision encadrée, et pas seulement en un calcul. La même table d'achats peut produire un chiffre d'affaires quotidien, des totaux hebdomadaires, des chiffres de clôture mensuelle ou une courbe de tendance glissante, et chaque version répond à une question opérationnelle différente.
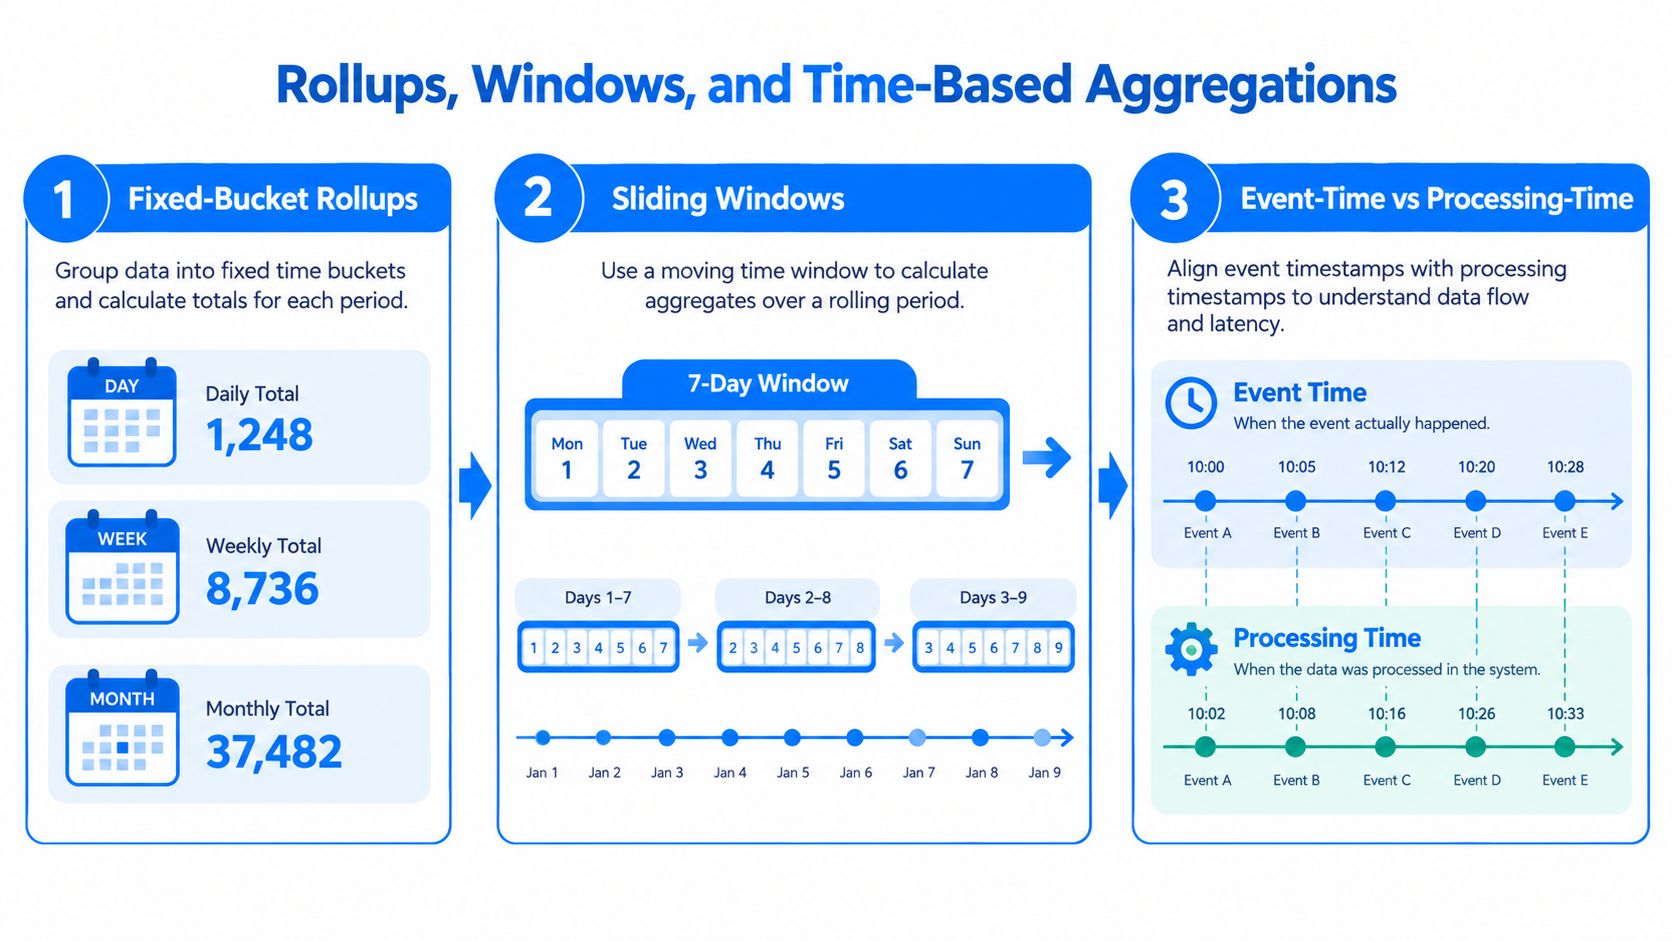
Intervalles fixes et vues glissantes
Un rollup à intervalles fixes regroupe les enregistrements par périodes calendaires comme le jour, la semaine ou le mois. Si une équipe commerciale veut le chiffre d'affaires mensuel par région, la limite de l'intervalle est le mois, et chaque commande tombe dans un intervalle ou un autre selon sa date. Les rapports récurrents deviennent faciles à comparer, mais la règle de coupure doit alors être explicite.
Une fenêtre glissante fait avancer l'intervalle en continu. Une moyenne glissante sur 7 jours lisse le bruit quotidien et révèle la tendance qu'un simple total journalier masquerait. La contrepartie, c'est que chaque nouveau jour modifie le résultat : le chiffre d'hier peut donc évoluer lorsque des enregistrements arrivent en retard.
Le temps de l'événement et le temps de traitement ne sont pas la même chose
Le temps de l'événement correspond au moment où la vente, le clic ou la mesure du capteur a eu lieu. Le temps de traitement correspond au moment où votre système l'a reçu. Si des livraisons arrivent en retard, un dashboard fondé sur le temps de l'événement reste fidèle à la réalité, tandis qu'un dashboard fondé sur le temps de traitement peut sembler complet trop tôt, puis changer ensuite.
C'est pourquoi les données arrivant en retard cassent les dashboards naïfs, et pourquoi les équipes associent les rollups aux types of anomaly detection afin de repérer les agrégats qui s'écartent de leur référence. Les enregistrements bruts peuvent être corrects et l'agrégat malgré tout faux pour la fenêtre de rapport choisie.
Pour les équipes d'ingénierie qui gèrent ces rollups dans des moteurs SQL et des jobs de pipeline, l'in-database processing garde la logique au plus près des données et limite les déplacements inutiles.
Où se fait l'agrégation dans les systèmes de données modernes
L'agrégation intervient partout où un utilisateur en aval a besoin de réponses plus rapides ou plus simples que ce que permettent les enregistrements bruts. La couche de stockage change, mais le schéma reste le même : regrouper les enregistrements, les synthétiser et les servir sous une forme exploitable.

Les emplacements habituels des rollups
Les bases de données opérationnelles alimentent souvent des dashboards en temps réel, notamment lorsqu'une équipe veut suivre les niveaux de service à partir des transactions en cours. Le point faible est la pression sur la fraîcheur, car des rollups lourds peuvent ralentir le système même qui doit servir le trafic applicatif.
Les data warehouses hébergent généralement des modèles dimensionnels et des tables de faits précalculées. C'est souvent là que se trouvent les reportings finance, ventes et direction, mais les rollups du warehouse peuvent se désynchroniser des tables sources si la logique de rafraîchissement est incomplète ou le partitionnement incohérent.
Les data lakes et lakehouses prennent en charge les pipelines batch et streaming, ce qui les rend souples pour des charges de travail mixtes. Le revers est la complexité : les fenêtres de streaming peuvent laisser échapper des événements tardifs et les jobs batch peuvent masquer des problèmes jusqu'à l'exécution suivante.
Choisir l'emplacement en fonction de la question
Les plateformes d'observabilité utilisent des rollups de métriques pour l'alerting et l'analyse de tendances, car les alertes ont besoin de synthèses rapides plutôt que de logs bruts. Si vous cherchez des repères d'architecture pour concevoir une stack moderne, la présentation modern data architecture approaches d'Ekipa est une référence utile sur la façon dont ces couches s'articulent habituellement.
Lorsque l'agrégation s'exécute au plus près des systèmes de production, la forme de la requête compte autant que les mathématiques. Un dashboard rapide construit sur le mauvais regroupement peut être plus dangereux qu'un dashboard lent manifestement incomplet.
Pourquoi les données agrégées comptent pour l'analytique et l'observabilité
Dashboards, reporting de direction, déclarations réglementaires et features de machine learning reposent tous sur des vues agrégées. Un seul agrégat fragile peut donc propager des erreurs partout en aval, même lorsque les données sources brutes sont intactes.
L'angle de l'observabilité est tout aussi important. Un total ou un taux inhabituel est souvent le premier indice qu'un changement s'est produit en amont, qu'il s'agisse d'une jointure cassée, d'une partition manquante, d'un flux en retard ou d'une modification de schéma. Les métriques agrégées rendent ces signaux rapidement visibles, et c'est pourquoi les équipes les surveillent en premier.
Ce que l'agrégation masque si le contexte ne suit pas
Un total peut dissimuler une population qui diminue. Une moyenne peut cacher une longue traîne. Un taux peut paraître stable alors que le dénominateur change. C'est pourquoi les bons agrégats embarquent des métadonnées à côté du chiffre, notamment le nombre d'enregistrements, la couverture et les dimensions de regroupement qui ont façonné le résultat.
Pour les équipes qui construisent des vues de monitoring, la question n'est pas seulement « quelle est la métrique ? », mais aussi « quels enregistrements l'ont alimentée, qu'est-ce qui a été exclu et qu'est-ce qui a changé depuis la dernière fois ? ». La réponse détermine si le chiffre est fiable ou simplement bien présenté.
Si vous travaillez déjà avec des stacks de monitoring, la page what is data observability complète utilement cette idée, car elle présente les métriques comme des éléments à inspecter et pas seulement à afficher.
Risques pour la vie privée et de divulgation dans les résultats agrégés
L'agrégation améliore la confidentialité dans de nombreux cas, mais elle n'est pas synonyme d'anonymat. Le NIST définit l'information agrégée comme des données collectées auprès de plusieurs individus pour établir des comparaisons ou identifier des tendances, et il avertit aussi que la compilation de données peut créer un risque supplémentaire, car l'ensemble des données peut révéler une image plus complète ou permettre une désanonymisation NIST aggregated information.
Pourquoi les petits groupes restent exposés
Les règles de contrôle de la divulgation existent parce que de petites cellules peuvent encore renvoyer à des personnes ou à des organisations. Les lignes directrices de la statistique officielle turque considèrent une cellule de tableau agrégé comme confidentielle lorsqu'elle contient moins de 3 unités statistiques, et signalent aussi les cas de dominance où une unité représente plus de 80 % de la valeur d'une cellule ou deux unités plus de 90 % NIST data aggregation. La Care Quality Commission britannique cite en outre une règle empirique consistant à éviter les groupes de 10 ou moins, les groupes de 5 ou moins n'étant acceptables que dans des situations à risque particulièrement faible CQC anonymisation guidance.
Il ne s'agit pas de règles de sécurité universelles. Le risque dépend toujours de la géographie, de la granularité temporelle, des connaissances extérieures et de ce qu'un observateur déterminé peut déduire en combinant plusieurs vues.
Les contrôles à intégrer au processus de publication
La généralisation élargit une catégorie étroite en une catégorie plus large, par exemple la région au lieu du département. La suppression masque entièrement la valeur lorsqu'une cellule est trop petite. La perturbation modifie la valeur publiée pour réduire le risque de divulgation sans abandonner toute la métrique. En pratique, ces contrôles fonctionnent ensemble, pas isolément.
Une erreur fréquente consiste à croire qu'un dashboard est sûr parce qu'il n'affiche plus de noms. Des filtres étroits peuvent recréer très vite un risque d'identification, notamment par zone géographique, plage de dates ou segment de clientèle. Si vous laissez les utilisateurs descendre trop loin dans le détail, l'agrégat peut cesser de se comporter comme un groupe et commencer à se comporter comme une seule ligne déguisée.
La Customer data protection guidance est pertinente ici, car les contrôles de confidentialité ne fonctionnent que s'ils sont évalués au regard du contexte de publication exact, et non de la seule étiquette « agrégé ».
Validation et qualité des données
Un agrégat peut être mathématiquement correct et pourtant trompeur. C'est pourquoi les résultats agrégés ont besoin de leurs propres contrôles qualité, et pas seulement d'un verdict réussi ou échoué sur les lignes sources.
Les contrôles qui détectent les défaillances les plus courantes
Les moyennes peuvent masquer le paradoxe de Simpson, où une tendance s'inverse dès que l'on ventile selon une dimension pertinente. Un KPI peut sembler sain dans le rollup alors qu'une région ou un segment se dégrade en dessous. Ce n'est pas une erreur de calcul, c'est une erreur de regroupement.
Les garde-fous pratiques sont simples :
Taille minimale des groupes : vérifiez que chaque groupe publié est assez grand pour réduire à la fois le risque de divulgation et les conclusions bruitées.
Stabilité du dénominateur : vérifiez si la population derrière un taux a changé d'une manière qui fausse les comparaisons.
Gestion des valeurs nulles : décidez si les valeurs manquantes sont exclues, imputées ou traitées comme zéro avant l'exécution du rollup.
Gestion des doublons : supprimez ou signalez les enregistrements répétés avant qu'ils ne gonflent les totaux.
Données arrivant en retard : réconciliez le temps de l'événement et le temps de traitement pour que le dashboard ne se présente pas comme définitif trop tôt.
Lignage : conservez le chemin qui mène de l'agrégat aux enregistrements sources et à la logique de regroupement.
Les signaux qui doivent déclencher une investigation
Si la population agrégée diminue soudainement, devient très concentrée ou change de dimensions d'une manière qui accroît le risque de divulgation, quelqu'un doit examiner le pipeline immédiatement. Ce ne sont pas des changements cosmétiques. Ils signifient généralement que la définition, le flux source ou le contexte de publication a changé.
Pour le travail sur la qualité et l'application des règles, data validation rules, checks, and continuous data quality est un sujet complémentaire pertinent, car le but de la validation est de rendre l'agrégat fiable, et pas seulement calculé.
Règle pratique : ne vous demandez pas si la métrique est « juste » avant d'avoir vérifié que le groupe, le dénominateur et le lignage signifient toujours ce que vous pensez.
Un exemple concret : des enregistrements bruts à un agrégat fiable
Partons d'un flux d'événements d'achat clients. Chaque enregistrement comporte un horodatage, une région, un montant de commande et un statut d'expédition. Le premier agrégat est simple : faire la somme des montants et le comptage des commandes par jour et par région pour obtenir le chiffre d'affaires quotidien et le volume de commandes.
Construire la tendance sans perdre le contexte de décision
Ajoutez ensuite une moyenne glissante sur 7 jours par-dessus les totaux quotidiens. Elle lisse les variations du week-end et donne à l'équipe une courbe de tendance plus stable pour la revue opérationnelle. Si une expédition tardive arrive après la clôture quotidienne, la version de l'agrégat fondée sur le temps de l'événement doit être recalculée, tandis que la vue fondée sur le temps de traitement peut rester comme piste d'audit indiquant quand le système en a eu connaissance.
Vient ensuite la décision relative à la vie privée. Si une région compte trop peu de commandes, ou si un seul marchand représente presque tout dans cette région, l'équipe doit regrouper la zone géographique ou supprimer la cellule plutôt que publier un chiffre fragile. Le dashboard reste ainsi utile sans faciliter l'identification d'une personne ou d'un fournisseur.
Traiter l'agrégat comme un actif surveillé
Une fois la métrique en production, elle fait partie de l'observabilité. Si le chiffre d'affaires quotidien chute fortement alors que le nombre de commandes ne bouge pas, c'est le signal qu'il faut examiner les prix, les remboursements ou les valeurs manquantes. Si la population derrière la métrique change soudainement, l'équipe doit examiner la logique de filtrage avant que quiconque ne se fie au graphique.
Le message de l'exemple est simple. L'agrégation n'est pas l'étape finale. C'est le point où se rejoignent l'exactitude, la confidentialité et la confiance opérationnelle.
Aide-mémoire pour travailler avec des données agrégées
Définition : les données agrégées sont des informations au niveau du groupe créées en combinant des enregistrements individuels en synthèses telles que des comptages, des totaux, des moyennes, des taux ou des distributions.
Fonctions courantes :
Somme pour le volume. Comptage pour la fréquence des enregistrements. Moyenne pour la valeur typique. Médiane pour les distributions asymétriques. Minimum et maximum pour les contrôles de plage. Taux et pourcentage pour les ratios, avec un dénominateur soigneusement défini.
Seuils de confidentialité à retenir :
Les petits groupes peuvent encore divulguer des informations. Lors de l'évaluation du risque de publication, surveillez les cellules de moins de 3 unités, les situations de dominance au-delà de 80 % ou 90 % et les groupes à faible effectif, autour de 10 ou moins.
Contrôles de validation à maintenir :
Taille minimale des groupes, stabilité du dénominateur, gestion des valeurs nulles, gestion des doublons, gestion des données arrivant en retard et lignage jusqu'aux enregistrements sources.
État d'esprit opérationnel :
L'agrégation est une transformation encadrée, ni une garantie de confidentialité ni une garantie de qualité.
digna aide les équipes à surveiller les données qui se trouvent derrière ces agrégats, et pas seulement le dashboard qui les affiche. Si vous avez besoin de détection d'anomalies, de validation, de suivi de la ponctualité des données, de surveillance des schémas et d'exécution in-database dans votre propre environnement, rendez-vous sur digna pour voir comment la solution s'intègre à votre stack de données.
Pour un catalogue des métriques de volume, de fraîcheur et de distribution qui maintiennent ce type d'agrégats fiables dans la durée, consultez les métriques de data observability.
Questions fréquentes
Que sont les données agrégées ?
Les données agrégées sont des informations de synthèse au niveau du groupe, créées en combinant des enregistrements individuels en comptages, sommes, moyennes, taux ou distributions. Par exemple, 1 million de transactions clients peut être résumé en 12 totaux mensuels par marché, ce qui permet de comparer les marchés et de repérer la saisonnalité sans examiner chaque achat.
Quelles sont les fonctions d'agrégation les plus courantes ?
Somme, comptage, moyenne, médiane, minimum, maximum, taux et pourcentage couvrent l'essentiel du reporting. Chacune préserve quelque chose de différent : la somme garde le volume, le comptage l'activité, la médiane résiste aux valeurs aberrantes des données asymétriques, et le minimum et le maximum servent aux contrôles de plage. Taux et pourcentages exigent un dénominateur stable et clairement défini.
Les données agrégées sont-elles anonymes ?
Pas automatiquement. L'agrégation réduit le risque pour la vie privée, mais des groupes petits ou dominés par quelques membres peuvent encore renvoyer à des personnes ou des organisations. Certaines lignes directrices de la statistique officielle jugent une cellule confidentielle si elle compte moins de 3 unités ou si une unité fournit plus de 80 % de sa valeur, d'où le recours possible à la suppression ou à la généralisation.
Pourquoi ne faut-il pas faire la moyenne de pourcentages entre groupes ?
Faire la moyenne de pourcentages issus de groupes de tailles inégales donne autant de poids à un petit groupe qu'à un grand, ce qui fausse le résultat. Pour savoir quelle part de l'ensemble du trafic a converti, divisez le total des conversions par le trafic total au lieu de calculer la moyenne des taux de conversion mensuels.
Comment valider des données agrégées ?
En contrôlant l'agrégat lui-même, et pas seulement les lignes sources : taille minimale des groupes, stabilité du dénominateur, gestion des valeurs nulles et des doublons, données arrivant en retard et lignage jusqu'aux enregistrements sources. Il faut ensuite continuer à le surveiller. Si le chiffre d'affaires quotidien chute alors que le nombre de commandes reste stable, examinez les prix, les remboursements ou les valeurs manquantes.


