10 problèmes de données courants et comment les détecter en 2026
|
9
minute de lecture

Vous avez sous les yeux un tableau de bord qui semble calme, les logs des jobs sont au vert et rien dans le data warehouse ne paraît cassé. C'est précisément à ce moment-là que les problèmes de données font le plus de dégâts. Les chiffres peuvent dériver, les définitions évoluer, et un modèle peut continuer à produire des scores pendant que l'entreprise prend ses décisions sur des données obsolètes, incomplètes ou incohérentes.
La plupart des défaillances de données ne se signalent pas. Elles se cachent derrière des statuts de réussite, des colonnes vides, des lignes en double, des flux en retard et une logique de calcul que personne n'a suffisamment documentée. Le vrai problème est rarement « le pipeline est en panne ». C'est que le pipeline affirme que tout va bien, alors que le rapport, le modèle ou la déclaration réglementaire perd peu à peu sa fiabilité.
La liste ci-dessous classe dix problèmes de données courants selon la discrétion avec laquelle ils surviennent, et non selon la fréquence à laquelle on en parle. Pour chacun, vous trouverez à quoi il ressemble en pratique, comment le détecter tôt et quels modules digna conviennent pour la détection ou la correction.
Table des matières
1. Fraîcheur des données, données obsolètes et tableaux de bord faussés
7. Violations des règles métier et failles d'intégrité référentielle
8. Dérive silencieuse des données et changements de distribution
10. Charges de travail incontrôlées et pics de consommation de la plateforme
Faire de ces dix contrôles une routine permanente de qualité des données
1. Fraîcheur des données, données obsolètes et tableaux de bord faussés
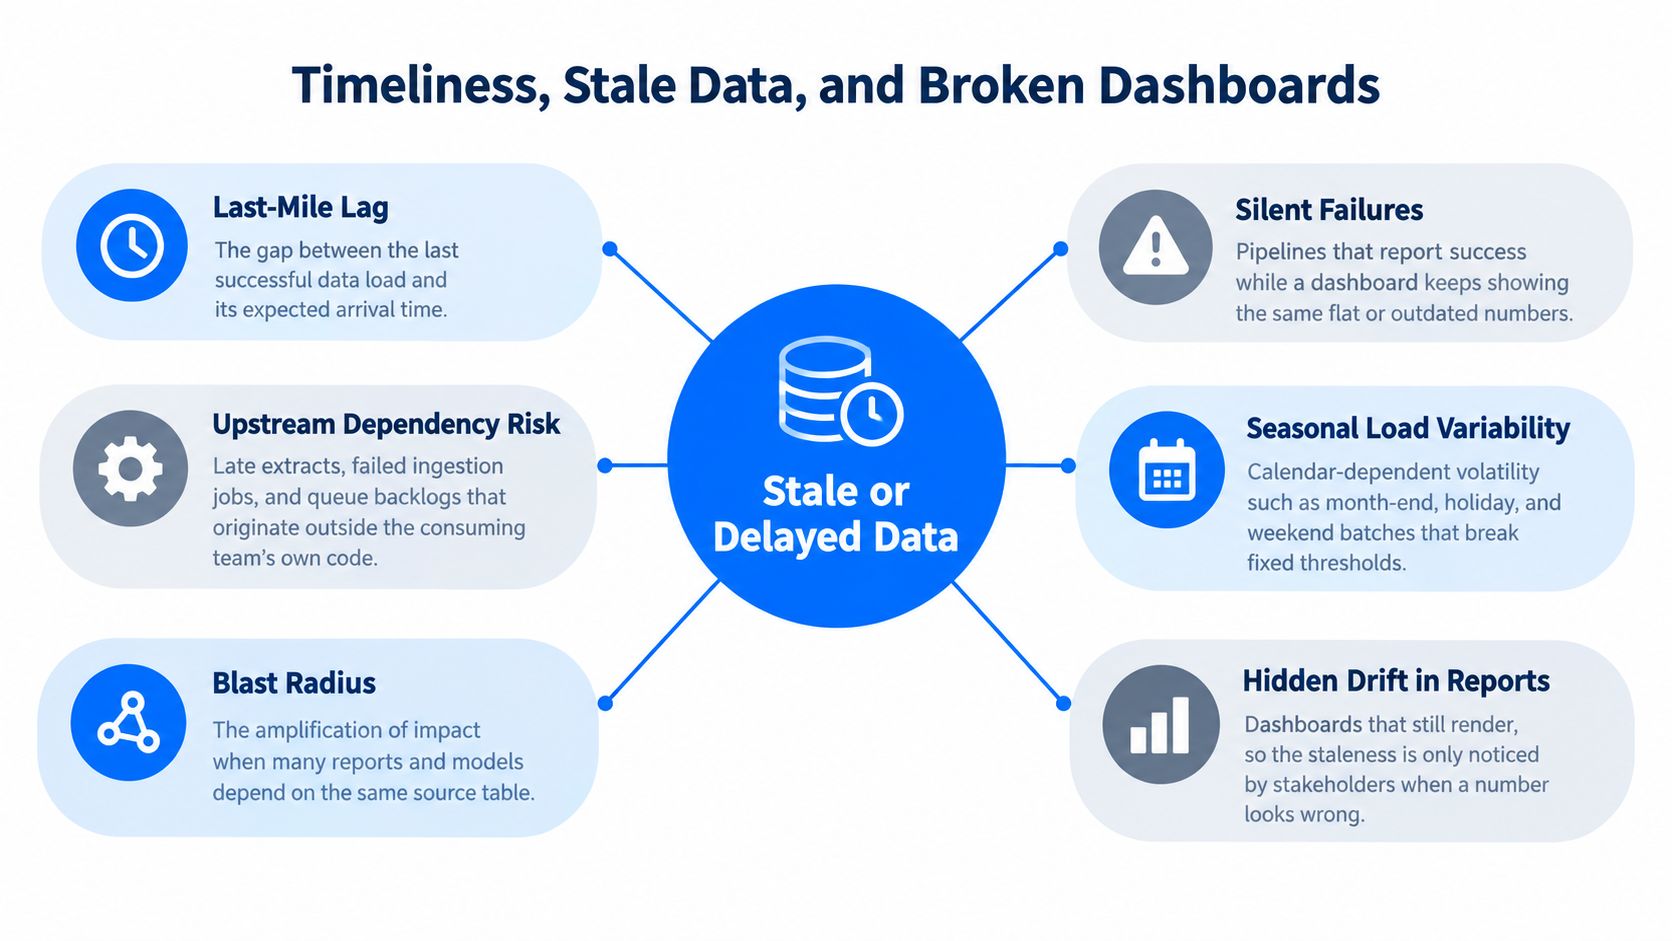
Un tableau de bord peut se charger sans erreur alors que les chiffres qu'il affiche sont déjà dépassés. La finance consulte un rapport, les ventes consultent un rapport, la direction consulte un rapport, et le chiffre obsolète reste invisible jusqu'à ce qu'une personne connaissant bien le métier remarque l'écart.
C'est ainsi que les défauts de fraîcheur passent inaperçus. Un flux source peut se bloquer après une extraction tardive ou un engorgement de file d'attente, tandis qu'une table de dimension se rafraîchit à l'heure prévue avec un mauvais mapping de catégories. Le tableau de bord continue de s'afficher, mais le sens des chiffres dérive. Une découverte tardive coûte cher en pratique, et l'étude d'IBM sur les violations de données montre combien de temps peut s'écouler avant qu'un incident soit identifié et maîtrisé : en moyenne 241 jours pour l'identification et le confinement, et un coût moyen de 1,47 million USD pour la détection et l'escalade (étude IBM Cost of a Data Breach).
Règle pratique : un rapport n'est jamais plus frais que les tables qui l'alimentent.
Ce qu'il faut surveiller
Fenêtres d'arrivée attendues : apprenez les heures de livraison habituelles à partir de l'historique, puis alertez sur les chargements en retard, manquants ou arrivés anormalement tôt.
Cartographie des dépendances : identifiez quels tableaux de bord dépendent de quelles tables, afin que les défaillances en amont apparaissent avant le début de la réunion.
Schéma et délais ensemble : un flux qui arrive à l'heure mais change de structure reste une défaillance.
Utilisez digna Timeliness pour apprendre les schémas de livraison et calculer les heures d'arrivée attendues. Associez-le à digna Data Quality Management pour la détection d'anomalies, la validation et le suivi de schéma sur les tables qui alimentent les tableaux de bord clés. Pour approfondir le modèle opérationnel, consultez le guide digna sur la surveillance de la fraîcheur des données.
2. Chargements manquants ou incomplets
Un chargement peut se terminer sans erreur et être pourtant faux. Les fichiers arrivent, le schéma correspond et le nombre de lignes semble assez proche pour passer un contrôle rapide. Ce qui manque, c'est la région, le système source ou la tranche temporelle qui n'est jamais arrivée.
C'est ainsi que les totaux glissent sans alarme évidente. L'épisode des statistiques COVID-19 de Public Health England en est un exemple frappant : environ 16 000 résultats de tests positifs ont été omis pendant plusieurs jours, parce qu'un fichier tableur dépassait la limite de lignes de l'ancien format Excel utilisé pour consolider les données (How Public Health England's COVID-19 data collection went wrong). La défaillance ressemblait à une variation ordinaire jusqu'à ce que quelqu'un vérifie la source.
La détection doit se faire au niveau des segments. Le nombre total de lignes ne suffit pas, car une panne partielle dans une région ou une gamme de produits peut laisser le chiffre global parfaitement normal. Pour l'aspect mesure, consultez le guide digna sur la mesure de la complétude des données. Utilisez digna Anomalies pour apprendre les volumes habituels de chaque table, puis signaler les chargements partiels même lorsque le job du pipeline indique un succès.
La correction est un travail répétitif, et c'est tout l'intérêt. Comparez les volumes source et cible à chaque étape, consignez les lignes attendues et réelles, et conservez la piste d'audit là où quelqu'un pourra l'examiner plus tard. Si un flux doit contenir chaque magasin, chaque jour, un magasin manquant à une date donnée doit ressortir avant d'atteindre un tableau de bord ou une prévision.
3. Dérive de schéma
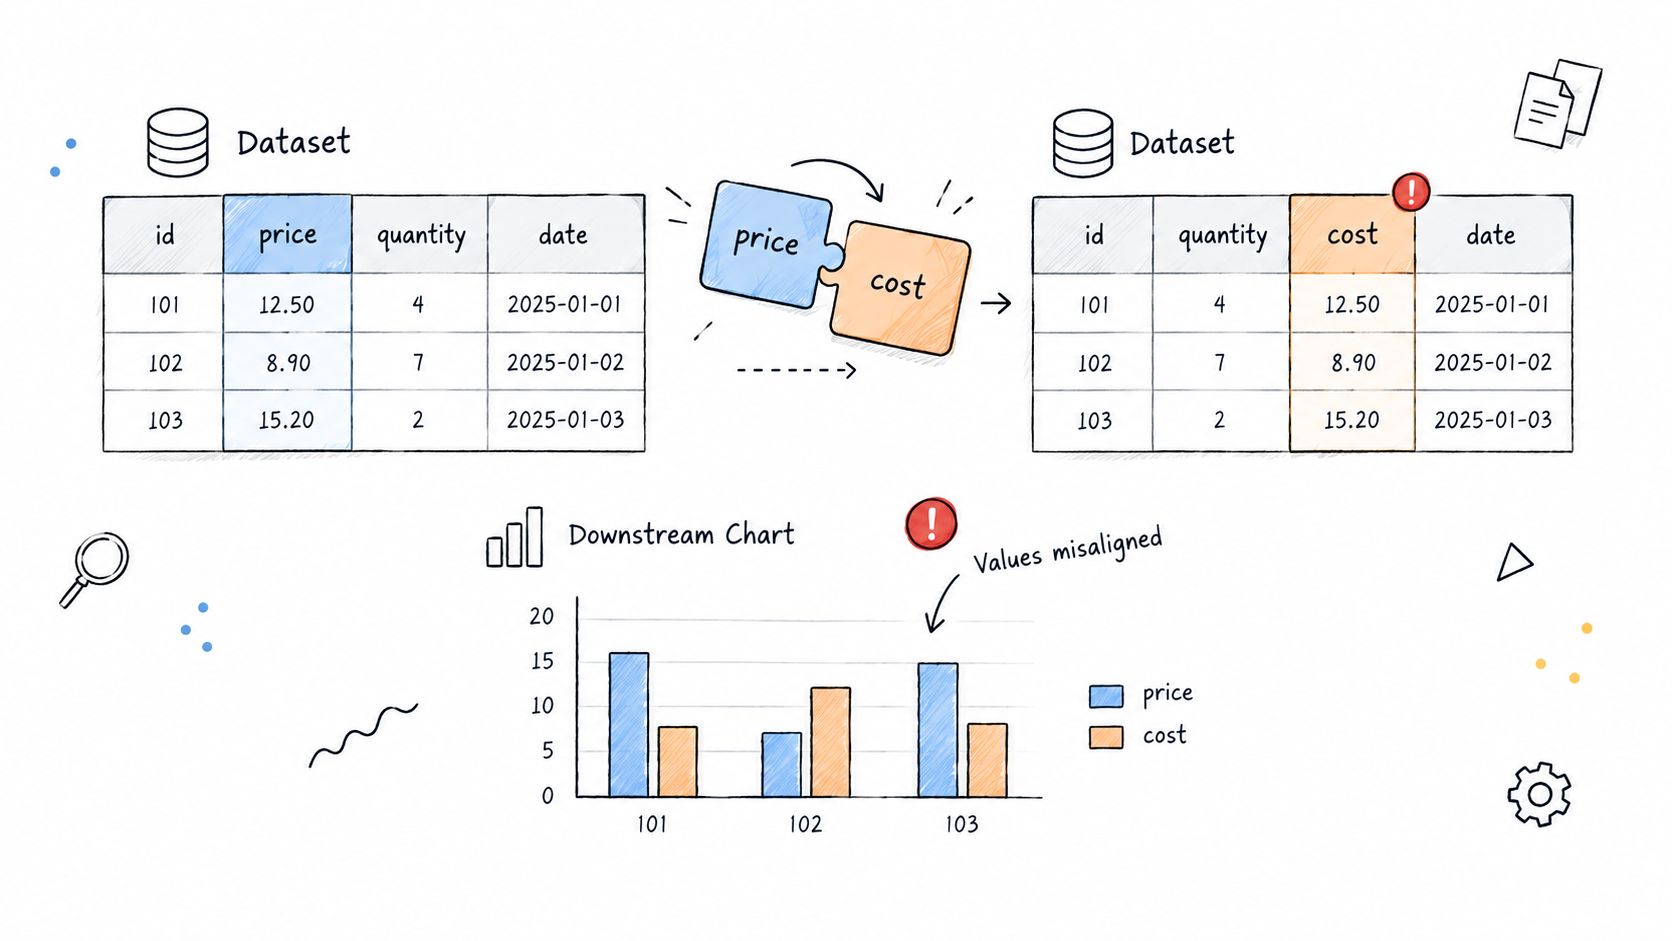
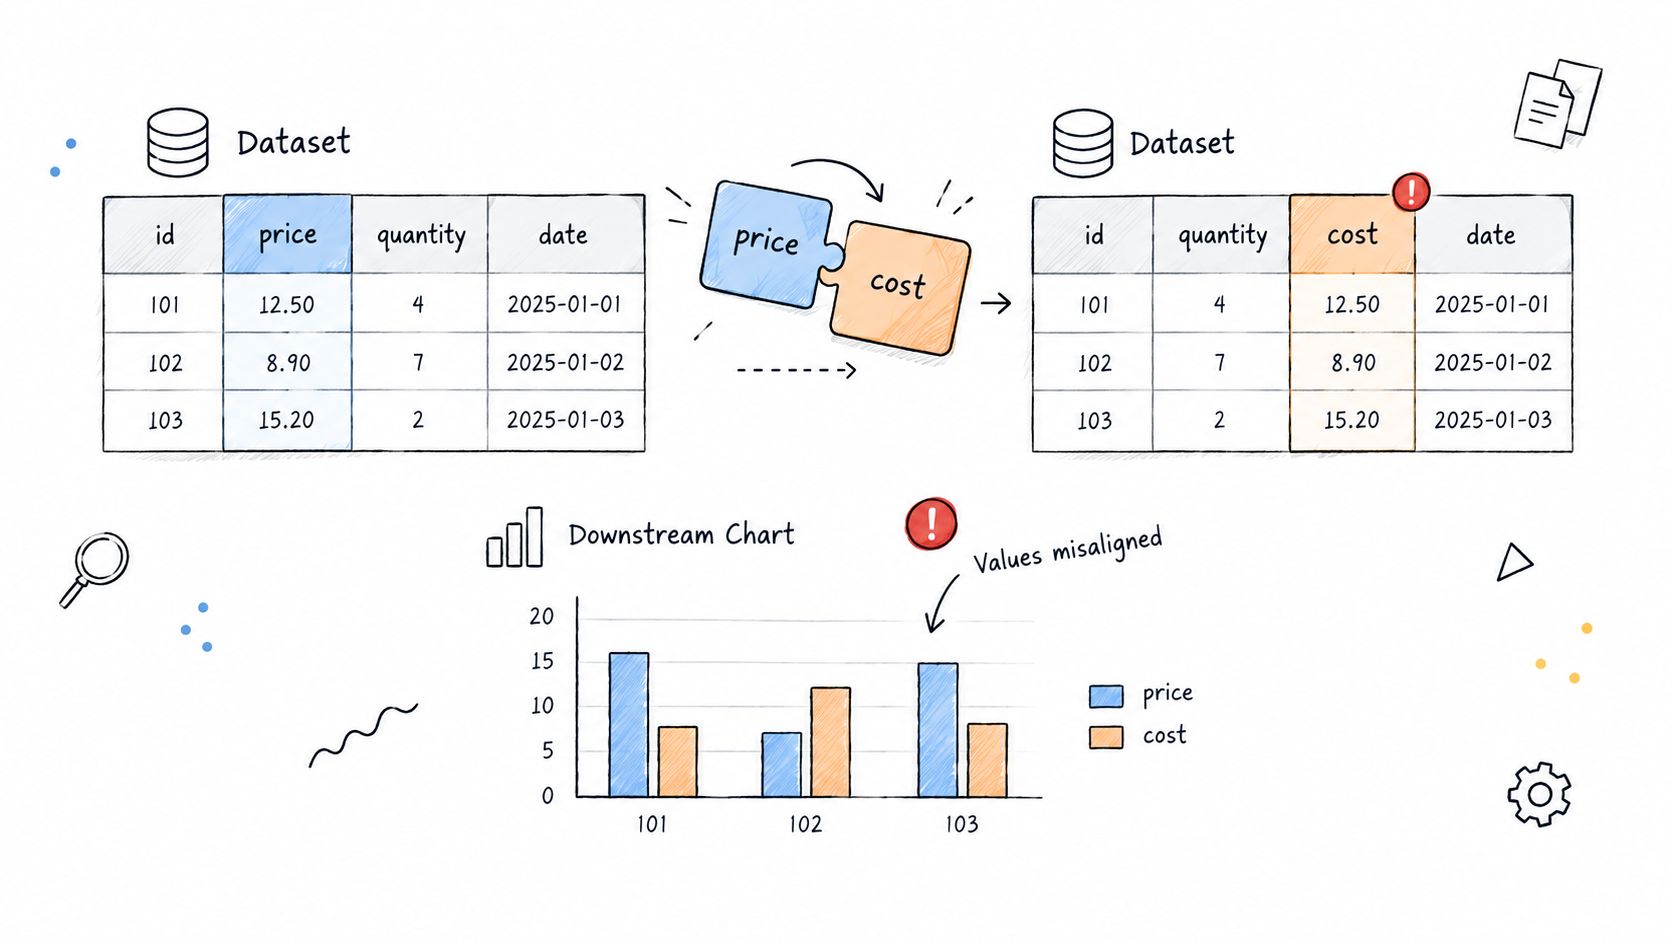
Un champ peut changer de forme alors que le pipeline continue d'afficher un succès. Une colonne est renommée, un type change, ou une source supprime un champ après une mise en production, et la logique en aval continue de tourner sur de mauvaises hypothèses. Cela se manifeste généralement plus tard sous forme de valeurs nulles, de valeurs décalées, de calculs faussés ou d'un modèle qui note des données qu'il ne comprend plus.
Les pires défaillances sont les plus discrètes. Un champ monétaire qui passe du type décimal au type texte peut casser les agrégations dans la couche BI alors que le job en amont semble en parfaite santé. Une colonne supprimée peut aussi être remplacée par une valeur par défaut, ce qui maintient le flux en vie tout en rendant les chiffres moins fidèles, sans erreur visible.
Comment la détecter tôt
Surveillez en continu les colonnes ajoutées, supprimées ou dont le type change, et pas seulement lors des déploiements.
Classez les changements selon leur impact, afin que les changements bloquants ne se retrouvent pas dans la même file que les ajouts inoffensifs.
Reliez chaque changement à sa source en amont et à chaque actif en aval qui en dépend.
Utilisez digna Schema Tracker pour repérer les changements structurels dès qu'ils surviennent et les rattacher aux actifs concernés. L'aperçu digna des types de schémas propose une manière pratique de regrouper ces changements avant qu'ils ne se propagent dans la logique de reporting ou de scoring. Un contrat de schéma n'empêchera pas tous les changements, mais il évite la dérive de schéma qui n'apparaît qu'une fois le rapport déjà faussé.
Un exemple visuel clair aide les équipes à comprendre comment un champ peut être renommé sans que personne ne s'en aperçoive. Un schéma illustrant des désalignements de données où le prix est renommé à tort en coût, ce qui fausse les graphiques en aval.
4. Enregistrements en double
Les doublons sont sournois, car chaque ligne prise isolément semble légitime. Le même client, la même transaction ou le même contrat apparaît deux fois, parfois à cause de nouvelles tentatives, parfois de systèmes sources qui se chevauchent, parfois d'une logique de fusion qui a raté une correspondance de clé. Rien ne plante, mais les totaux sont désormais faux.
Les dégâts opérationnels sautent aux yeux dès qu'on en remonte la trace. La facturation gonfle, le nombre de clients surestime la réalité, et les rapports de conformité décrivent une organisation qui n'a jamais existé. Lors d'une migration, des comptes en double peuvent faire paraître le reporting de gestion plus favorable ou plus important qu'il ne l'est. Dans les systèmes de streaming, la logique de nouvelle tentative peut écrire plusieurs fois la même transaction lors d'un incident réseau, ce qui gonfle le chiffre d'affaires, les volumes ou l'activité.
Un bon dispositif de contrôle commence par des clés métier explicites. Si vous ne définissez pas l'unicité de l'entité, vous laissez la règle de dédoublonnage au hasard. Utilisez digna Data Validation pour imposer l'unicité des clés et identifier les violations au niveau de l'enregistrement, puis rendez l'ingestion idempotente afin que les nouvelles tentatives ne créent pas de lignes supplémentaires. Pour les chevauchements approximatifs où la correspondance exacte ne suffit pas, le guide digna sur le fuzzy matching offre aux équipes une méthode pratique pour repérer les enregistrements suffisamment proches pour mériter un examen.
Le nombre absolu de doublons compte moins que sa tendance. Une hausse soudaine en dit généralement plus qu'un niveau de base stable.
5. Valeurs nulles et manquantes
Les valeurs nulles sont faciles à ignorer, car toute valeur manquante n'est pas forcément problématique. Le problème commence lorsque les taux de valeurs nulles évoluent sans explication, ou lorsqu'un champ qui devrait être renseigné arrive vide sur une part significative des enregistrements. Cela révèle souvent un échec de jointure, un problème d'analyse syntaxique ou un changement de source passé inaperçu.
Un format incompatible dans une clé de jointure peut empêcher les enregistrements de correspondre, et un attribut client essentiel disparaît alors en aval. Une nouvelle version d'application mobile peut cesser complètement de capturer un champ, ce qui fait exploser les taux de valeurs nulles alors que le pipeline semble en bonne santé. Le risque n'est pas seulement analytique : des champs critiques manquants peuvent biaiser les modèles et fausser les décisions opérationnelles.
Le bon contrôle repose ici sur des taux, pas sur des valeurs absolues. Une règle générale « aucune valeur nulle » crée du bruit, alors qu'un niveau de référence mesuré détecte les variations significatives. Suivez séparément les champs facultatifs et obligatoires, et recherchez les valeurs manquantes déguisées, comme des chaînes sentinelles ou des nombres de substitution. Utilisez digna Anomalies pour apprendre le comportement normal du taux de valeurs nulles par colonne, puis alerter sur les écarts significatifs au lieu de débattre de seuils manuels. La note digna sur la complétude comme dimension de la qualité des données est utile lorsque les équipes doivent distinguer la complétude réelle des hypothèses.
6. Formats invalides et valeurs hors plage
Les valeurs invalides passent souvent la validation technique parce que le type est correct, alors que le contenu est faux. Une date peut être lue sans erreur tout en étant impossible. Un prix peut être numérique tout en étant exprimé dans la mauvaise unité. Un code postal peut avoir la longueur attendue tout en violant toutes les contraintes réelles dont l'entreprise dépend.
De nombreuses équipes confondent réussite de l'ingestion et exactitude des données. Un dossier médical avec une date de naissance dans le futur peut résulter d'une inversion jour-mois entre deux systèmes. Un distributeur peut ingérer des prix en centimes depuis une source et en unités monétaires depuis une autre, si bien que le même produit paraît 100 fois trop cher ou trop bon marché. Le pipeline n'a pas cassé, c'est la logique métier qui a cédé.
La réponse passe par un contrôle explicite du domaine de valeurs. Documentez les plages autorisées et les listes de codes pour les champs critiques, puis validez-les au niveau de l'enregistrement en conservant les lignes en échec avec leur motif. Utilisez digna Data Validation pour appliquer ces règles aux colonnes les plus importantes, et combinez les contrôles par règles avec une détection statistique lorsque les valeurs erronées ne se révèlent qu'au regard de l'historique. Les recommandations du NIST sont également utiles ici, car elles définissent la qualité de l'information autour de l'utilité, l'intégrité et l'objectivité, le niveau d'erreur acceptable dépendant du cas d'usage (normes de qualité de l'information du NIST).
7. Violations des règles métier et failles d'intégrité référentielle
Une expédition antérieure à la date de commande, un prêt sans trace d'approbation ou un contrat qui renvoie à un client inexistant cassent rarement le pipeline. Ils cassent la confiance dans les chiffres. Ces défaillances échappent à la validation de base, car les champs sont présents, mais la logique métier est fausse.
Les défaillances les plus discrètes se trouvent généralement dans les relations. Une contrepartie clôturée peut encore apparaître dans le reporting des expositions si les mises à jour de statut n'atteignent pas toutes les tables en aval. Des sinistres peuvent continuer à référencer des numéros de contrat qui n'existent plus dans le référentiel. La finance s'en aperçoit tard, souvent après qu'un rapport a déjà été validé.
Classez-les selon leur manière d'échouer. Une clé étrangère manquante fait du bruit. Un indicateur de statut obsolète, non.
1. Enregistrements parents manquants Un enregistrement enfant ne pointe vers rien, mais la ligne arrive quand même dans le reporting. Détectez-le en vérifiant chaque clé étrangère par rapport à la table de référence, puis examinez les rejets chaque jour. Avec digna Data Validation, conservez les lignes en échec avec leur motif, afin que les équipes opérationnelles et l'audit puissent retracer la rupture.
2. Dates métier qui ne respectent pas l'ordre Un événement arrive avec des dates dont la séquence n'a aucun sens. Détectez-le avec des règles de séquence explicites, comme l'approbation avant le décaissement ou le début du contrat avant la date du sinistre.
3. Statuts incohérents entre systèmes Une table indique « clôturé », une autre indique encore « actif ». Comparez les champs de cycle de vie entre les sources et signalez les enregistrements qui ne s'accordent pas sur l'état actuel.
4. Références opérationnelles orphelines Une facture, un sinistre ou une exposition reste lié à un enregistrement de référence supprimé. Exécutez les contrôles référentiels là où les données sont stockées, et pas seulement après agrégation.
5. Des règles qui n'existent que dans la tête de quelqu'un Documentez la règle, nommez son responsable et rendez la condition de test lisible. Une règle que personne ne sait expliquer ne survivra pas à un audit.
Gardez les contrôles au plus près des données, conservez les preuves et transmettez les défaillances aux personnes capables de corriger la source.
8. Dérive silencieuse des données et changements de distribution
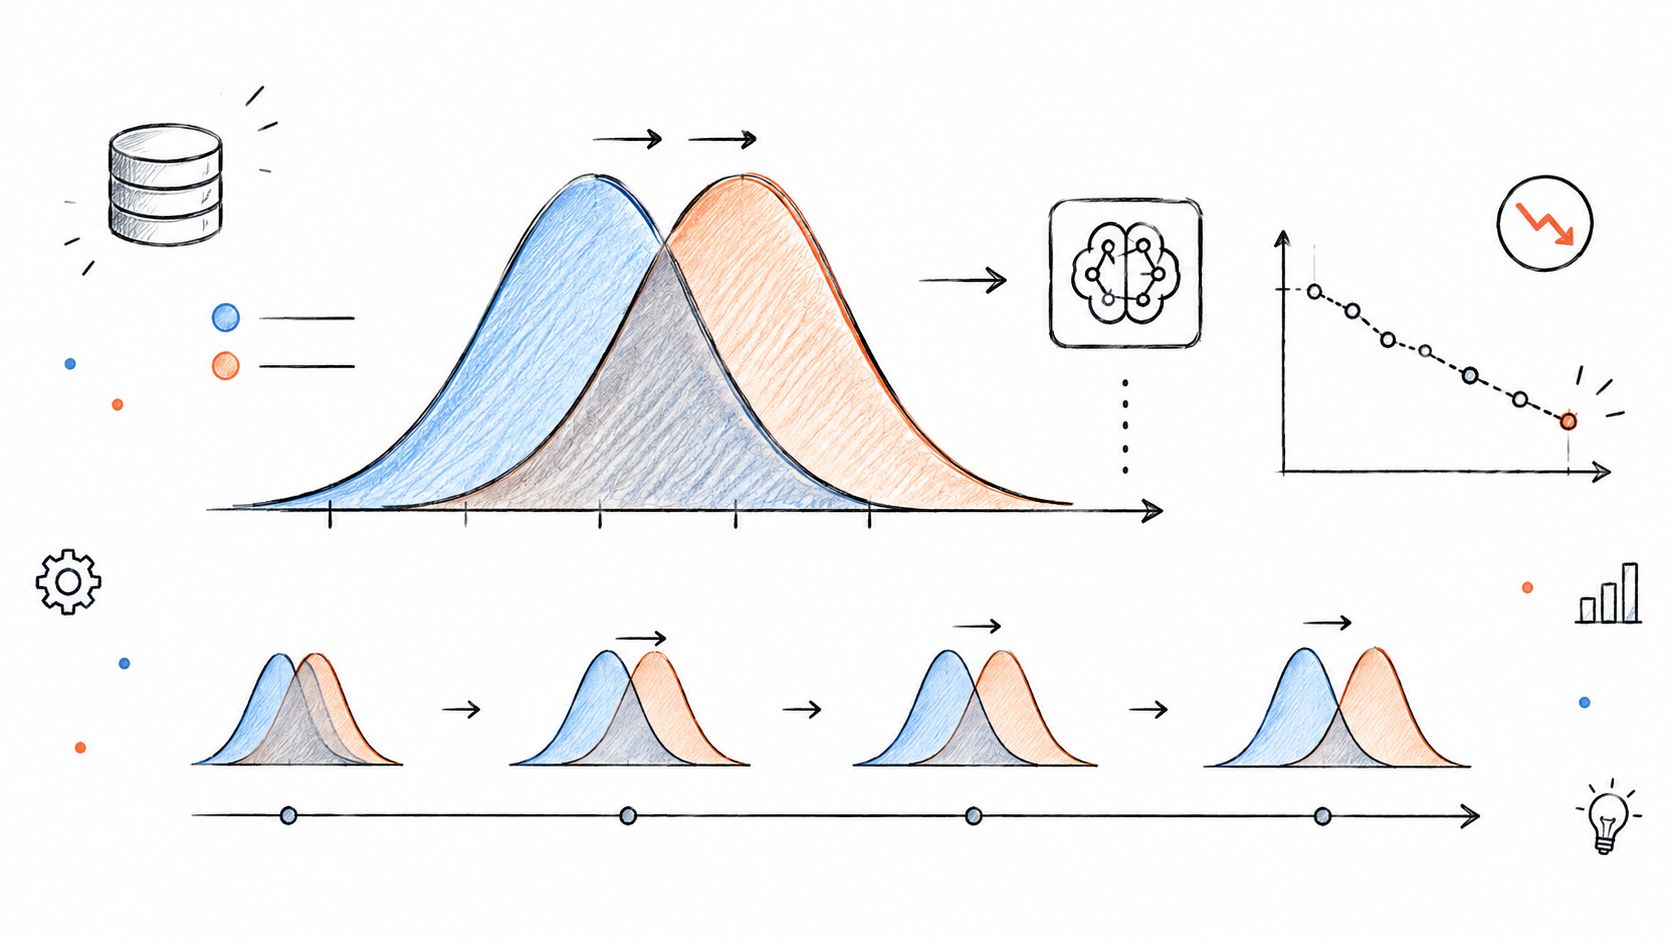
Un pipeline peut rester en bonne santé alors que les données perdent lentement leur signification. Les moyennes bougent, la composition change, les corrélations s'affaiblissent, et les rapports ou les modèles deviennent moins fiables sans job en échec ni schéma cassé. C'est ce qui rend la dérive facile à manquer et difficile à écarter.
Classez ces problèmes selon leur discrétion. Une panne bruyante attire l'attention. Un glissement silencieux du comportement, généralement pas.
1. Dérive de la distribution des variables Une grille de scoring continue de tourner, mais l'une de ses variables provient désormais d'un autre segment de clientèle qu'auparavant. Comparez les distributions glissantes à un niveau de référence connu, puis rapprochez-les des récentes mises en production des sources et des changements de mapping en amont. Avec digna Anomalies, définissez des plages attendues par jeu de données, et utilisez digna Data Analytics pour vérifier si le mouvement est isolé ou s'inscrit dans une tendance plus large.
2. Dérive des labels ou des résultats La cible elle-même change après une modification de politique, de produit ou de routage. Le modèle peut sembler moins performant alors que le pipeline est intact. Suivez les taux de résultats dans le temps et rapprochez-les des événements métier avant de conclure à une dégradation du modèle.
3. Changements silencieux d'unité ou d'encodage Une devise, un code de statut ou un mapping de catégories change en amont, mais le flux passe toujours la validation. Le tableau de bord reste au vert alors que les chiffres ne sont plus comparables. Comparez les déploiements des sources et les logs de transformation, puis vérifiez que les valeurs correspondent toujours au sens attendu par les utilisateurs en aval.
4. Changements de composition des segments Un rapport se retrouve dominé par une nouvelle région, un nouveau canal ou un nouveau type d'appareil, et la moyenne globale bouge avec lui. Ventilez les indicateurs par segment avant de parler de tendance. Si un seul segment explique l'essentiel du mouvement, le problème vient de la composition, pas de la performance.
5. Perte progressive de corrélation Deux champs qui évoluaient ensemble ne le font plus. Cela apparaît souvent après un changement de source, un flux retardé ou une nouvelle règle métier. Surveillez les relations entre paires de champs et alertez sur les écarts durables, pas seulement sur les pics ponctuels.
La bonne habitude est simple. Surveillez les distributions, reliez les alertes aux événements des sources et gardez visibles les lignes en échec et leur contexte, afin que les analystes puissent distinguer une dérive d'un changement réel.
9. Définitions, unités et logiques de calcul incohérentes
Deux tableaux de bord peuvent être tous deux « justes » et pourtant se contredire, et c'est pourquoi cette catégorie nuit autant à la confiance. Une équipe compte les comptes, une autre les clients uniques, une troisième publie le chiffre d'affaires en milliers, et une quatrième convertit les fuseaux horaires différemment. Les chiffres sont cohérents en interne, mais inutilisables dès qu'on les compare.
Ce type d'écart reste caché jusqu'à ce que la direction demande pourquoi le même trimestre n'a pas la même allure dans deux systèmes. L'échec de la sonde Mars Climate Orbiter est l'exemple classique d'incompatibilité d'unités, et il reste pertinent, car l'analytique moderne présente la même faiblesse, à une vitesse bien supérieure. Si la finance, les opérations et le produit définissent chacun différemment un « client actif », chaque réunion se transforme en exercice de rapprochement.
Un glossaire aide, mais seulement si chaque indicateur est assorti d'un responsable, d'une logique de calcul et d'une unité. Standardisez les conversions le plus tôt possible, puis rapprochez régulièrement les indicateurs critiques et analysez les écarts qui dépassent les tolérances convenues. Utilisez digna Business Monitoring pour suivre les KPI sur les données sous-jacentes, afin que les variations inattendues apparaissent avant même que les définitions soient entièrement harmonisées. Pour les équipes qui apprécient une approche fiabilité du comportement des indicateurs, MTBF, MTTR, and OEE metrics explained est une référence connexe utile.
Si deux équipes utilisent le même libellé pour des logiques différentes, c'est le libellé qui pose problème.
10. Charges de travail incontrôlées et pics de consommation de la plateforme
Le déploiement d'un tableau de bord, un backfill ou un nouveau workflow en libre-service peut pousser une plateforme au-delà de sa charge habituelle avant que quiconque ne s'en aperçoive. Le data warehouse répond toujours, mais la latence des requêtes augmente, les coûts grimpent et les jobs planifiés commencent à manquer leurs fenêtres d'exécution.
Les équipes classent souvent ces pics dans la catégorie infrastructure, alors que le volume de requêtes, la croissance du stockage et l'allongement des temps d'exécution sont aussi des problèmes de fiabilité des données. Ils surviennent généralement sans prévenir. Le premier symptôme est rarement une panne : c'est un rafraîchissement de modèle plus lent, un rapport en retard ou une facture que personne n'avait budgétée. Les études sur l'utilisation du cloud pointent toujours le même schéma, où une capacité inutilisée ou mal gérée se transforme en gaspillage et en frein opérationnel. C'est pourquoi la croissance des charges de travail a sa place dans les contrôles de données autant que dans les revues d'infrastructure.
Garder le comportement de la plateforme visible
Suivre par responsable de charge : attribuez les pics à une équipe, un pipeline ou un tableau de bord avant que le phénomène ne se propage.
Établir des références selon le calendrier : comparez le comportement en semaine, le week-end et pendant les fenêtres de mise en production avant de déclencher une alerte.
Analyser avec la finance : la maîtrise des coûts fonctionne mieux lorsque l'ingénierie et la finance lisent les mêmes tendances.
Utilisez digna Data Platform Observability pour surveiller les charges de travail, la consommation, la disponibilité et les indicateurs de performance en un seul endroit. Il devient ainsi plus facile de repérer le mode de défaillance silencieux, où le système reste disponible tandis que les coûts et la latence sortent des tolérances. Pour les équipes plateforme, cette visibilité fait souvent la différence entre une hausse maîtrisée et une mauvaise surprise coûteuse.
Comparatif des 10 principaux problèmes de données
Problème | 🔄 Complexité de mise en œuvre | 💡 Ressources nécessaires | ⚡ Rapidité de détection attendue | 📊 Résultats attendus / Impact | ⭐ Cas d'usage idéaux / Avantage clé |
|---|---|---|---|---|---|
Fraîcheur des données, données obsolètes et tableaux de bord faussés | Moyenne à élevée ; nécessite des fenêtres SLA & une cartographie des dépendances | Modérées : surveillance, lignage, alertes | Lente si l'on s'appuie uniquement sur les tableaux de bord ; ⚡ rapide avec l'apprentissage des fenêtres d'arrivée | Fort impact sur de nombreux rapports ; érode la confiance des parties prenantes | Tableaux de bord critiques & respect des SLA ; communication rapide vers l'amont |
Chargements manquants ou incomplets | Moyenne ; nécessite des références de volume par segment et des rapprochements | Modérées : logs de volumes, contrôles par partition | Moyenne ; les chargements partiels peuvent passer inaperçus sans contrôles par segment | Risque important pour les agrégats et les tendances ; peut fausser les volumes | Pipelines batch/ETL et indicateurs agrégés ; détection des segments manquants |
Dérive de schéma | Moyenne ; nécessite un suivi continu des schémas et des contrats | Faibles à modérées : registre de schémas ou outils de suivi | Moyenne à rapide avec une comparaison automatisée des schémas | Casse les transformations, produit des valeurs nulles ou des erreurs en aval | Systèmes avec de nombreux producteurs ; application de contrats de schéma |
Enregistrements en double | Moyenne ; nécessite la conception de clés métier et l'idempotence | Faibles à modérées : logique de dédoublonnage, outils de rapprochement | Moyenne ; souvent visible après agrégation, sauf surveillance | Volumes et sommes gonflés, erreurs de facturation ou d'analyse client | Pipelines d'ingestion, résolution d'identité client, facturation |
Valeurs nulles et manquantes | Faible à moyenne ; surveillance par colonne et références de taux de valeurs nulles attendus | Faibles : contrôles et alertes par colonne | Rapide avec la surveillance des taux de valeurs nulles | Biais dans l'analytique et le ML, attributs manquants pour les jointures | Variables de ML et champs obligatoires ; détection des pics soudains de valeurs nulles |
Formats invalides et valeurs hors plage | Faible à moyenne ; définir des règles de syntaxe, de sémantique et de plage | Faibles : règles de validation et listes de référence | Rapide grâce aux contrôles déterministes | Valeurs invraisemblables ou non conformes qui faussent les indicateurs | Champs aux domaines connus (dates, codes, prix) ; contrôles réglementaires |
Violations des règles métier & failles référentielles | Élevée ; logique inter-tables et responsabilités clairement attribuées | Élevées : contrôles d'intégrité, responsables, pistes d'audit | Moyenne ; peut être coûteuse, donc souvent échantillonnée | Non-conformités, problèmes de rapprochement, risque d'audit | Finance réglementée, risques et processus de rapprochement |
Dérive silencieuse des données & changements de distribution | Moyenne à élevée ; références statistiques et surveillance des relations | Modérées à élevées : outils de détection de dérive, références de long terme | Lente par nature ; ⚡ plus rapide avec des détecteurs de dérive en continu | Dégradation progressive des modèles et tendances trompeuses | Modèles de ML en production et références analytiques de long terme |
Définitions, unités & logiques de calcul incohérentes | Élevée ; gouvernance, glossaire et alignement entre équipes | Élevées : documentation, rapprochements, couches de conversion | Lente, souvent découverte lors de revues ou d'audits | Tableaux de bord contradictoires et perte de confiance dans les KPI | KPI transverses, reporting de direction, indicateurs consolidés |
Charges de travail incontrôlées & pics de consommation de la plateforme | Moyenne ; références par charge de travail et attribution | Élevées : télémétrie de la plateforme, maîtrise des coûts, playbooks de remédiation | Moyenne à rapide grâce aux métriques et alertes de la plateforme | Dépassements de coûts, jobs retardés, dégradation des performances | Data warehouses partagés, FinOps, planification de production et backfills |
Faire de ces dix contrôles une routine permanente de qualité des données
Commencez par les problèmes qui touchent vos tableaux de bord les plus consultés et vos rapports réglementaires. Attribuez à chacun un responsable, une méthode de détection et un circuit d'alerte, car « quelqu'un devrait regarder ça » n'est pas un contrôle. Si les données servent la finance, la santé, le reporting public, les opérations clients ou des pipelines d'IA, la première tâche consiste à rendre les défaillances visibles avant qu'elles n'atteignent une réunion, une déclaration ou un modèle.
Réexaminez cette liste chaque trimestre. De nouvelles sources apparaissent, les schémas changent, les équipes créent de nouveaux tableaux de bord, et l'utilisation de la plateforme croît d'une manière qui exige des contrôles dont vous n'aviez pas besoin il y a six mois. Les systèmes qui vieillissent bien sont ceux où la fraîcheur, la complétude, les changements de schéma, la validation et la détection d'anomalies sont surveillés en routine, et non en réaction à une crise.
Le point de départ le plus pragmatique, ce sont les trois problèmes les plus susceptibles de perturber vos rapports critiques ce mois-ci. Établissez d'abord leurs niveaux de référence, puis étendez la surveillance aux modes de défaillance voisins une fois que les alertes sont fiables. C'est là que digna trouve toute sa place, car ses modules couvrent la fraîcheur des données, les variations de volume, les valeurs nulles, les changements de schéma, les règles au niveau de l'enregistrement, la surveillance des KPI métier et l'observabilité de la plateforme dans un seul modèle opérationnel.
Ce qui compte le plus, c'est la constance. Si vous savez détecter tôt les données obsolètes, les chargements manquants et les changements structurels, vous avez déjà éliminé une grande partie des défaillances silencieuses qui font perdre aux équipes data confiance dans leurs propres résultats. Si vous pouvez prouver la règle métier, la fenêtre de fraîcheur et l'origine du changement, le reste devient gérable.
digna offre aux équipes un moyen concret de surveiller les données qui alimentent le reporting, les opérations et l'IA. Si vous êtes confronté à des flux obsolètes, à de la dérive, à des enregistrements manquants ou à des changements de schéma, rendez-vous sur digna pour découvrir comment ses modules prennent en charge la fraîcheur des données, la validation, la détection d'anomalies, le suivi de schéma et l'observabilité de la plateforme au sein de votre propre environnement.
Dès qu'une alerte se déclenche, la question suivante est de savoir qui la traite et à quelle vitesse le problème est corrigé : le processus de gestion des incidents de qualité des données détaille ces étapes, de la détection jusqu'à la correction validée.
Questions fréquentes
Quels sont les problèmes de données les plus courants ?
Les dix plus courants sont les données obsolètes, les chargements manquants ou incomplets, la dérive de schéma, les doublons, les valeurs nulles, les formats invalides, les violations de règles métier, la dérive silencieuse, les définitions incohérentes et les pics de consommation. Ils sont classés ici selon leur discrétion, pas selon la fréquence à laquelle on en parle.
Comment détecter un chargement partiel lorsque le job indique un succès ?
Contrôlez les volumes par segment plutôt que sur un total unique. Une région ou une gamme de produits manquante peut laisser le nombre global de lignes parfaitement normal. Comparez donc les volumes source et cible à chaque étape et par segment, et alertez dès qu'un magasin ou une date disparaît.
Pourquoi la dérive de schéma est-elle dangereuse si le pipeline continue de tourner ?
Parce que la logique en aval continue de fonctionner sur de mauvaises hypothèses. Une colonne renommée, un champ décimal devenu texte ou un champ supprimé remplacé par une valeur par défaut peuvent produire des valeurs nulles, des agrégations faussées et des chiffres trompeurs sans erreur visible. Suivre en continu les changements de colonnes permet de le détecter avant que les rapports ne soient faussés.
Les règles de qualité des données doivent-elles interdire totalement les valeurs nulles ?
Non. Une règle générale « aucune valeur nulle » crée du bruit, car certains champs sont légitimement facultatifs. Surveillez plutôt les taux de valeurs nulles par rapport à une référence apprise pour chaque colonne, suivez séparément les champs facultatifs et obligatoires, et repérez les valeurs manquantes déguisées, comme les chaînes sentinelles ou les nombres de substitution.
Par où une équipe doit-elle commencer pour mettre en place une routine de qualité des données ?
Commencez par les trois problèmes les plus susceptibles de perturber vos rapports critiques ce mois-ci. Attribuez à chacun un responsable, une méthode de détection et un circuit d'alerte, établissez des références, puis étendez la surveillance aux défaillances voisines une fois les alertes fiables. Réexaminez la liste chaque trimestre, au fil de l'évolution des sources et des schémas.