Gérer les problèmes de qualité des données plus vite
|
10
minute de lecture

Le tableau de bord annonce une baisse du chiffre d'affaires. Le directeur financier demande si la demande a chuté, si les prix ont changé, ou si la finance a encore chargé la mauvaise table. Sur Slack, une analyste a déjà posté une capture avec trois chiffres différents pour le même indicateur. Quelqu'un rapièce un modèle SQL, relance un pipeline et déclare le problème réglé.
Puis le même incident revient deux jours plus tard depuis une autre source en amont.
C'est le motif avec lequel vivent beaucoup d'équipes de données. Non pas un champ cassé isolé, mais une boucle récurrente de chargements périmés, de dérive de schéma silencieuse, d'alertes en double et de propriété floue. Les correctifs improvisés paraissent rapides sur le moment, mais ils s'arrêtent en général au soulagement du symptôme. Ils ne disent pas qui porte le défaut, quel délai de réponse est acceptable, ni comment l'équipe empêche la même classe de problème de rouvrir.
Table des matières
Pourquoi les problèmes de qualité des données exigent un processus géré
Ce qui compte comme problème de qualité des données et comment le mesurer
Le flux de gestion des problèmes de qualité des données, de la détection à la prévention
Ancrer le processus dans les outils, les rôles et l'exploitation quotidienne
Éviter les problèmes récurrents et prouver que le processus fonctionne
Pourquoi les problèmes de qualité des données exigent un processus géré
Un chargement défectueux arrive à 6 h 10. À 8 h, la finance conteste le chiffre d'affaires, une analyste a coupé trois alertes bruyantes, et un ingénieur relance un traitement sans savoir si le défaut est né dans l'ingestion source, dans un changement de transformation ou dans une table de référence cassée. Les équipes appellent souvent cela du triage. En pratique, c'est du travail de file sans modèle d'exploitation.
Cette distinction compte. Un processus géré de gestion des problèmes de qualité des données n'est pas seulement un moyen d'attraper plus vite de mauvais enregistrements. Il fixe propriété, gravité, SLA, chemins d'escalade et travail de prévention, pour que la même classe de défaut ne revienne pas sous un nouveau numéro de ticket.
La recherche sur l'impact en entreprise montre pourquoi le traitement improvisé échoue à l'échelle. Une mauvaise qualité des données a été chiffrée à un coût annuel moyen de 12,9 millions de dollars par organisation, et des travaux du MIT Sloan ont fait état d'une baisse annuelle de chiffre d'affaires de 15 % à 25 % dans certains contextes, comme le résument ces statistiques sur l'amélioration de la qualité des données. Le même résumé cite un constat très repris de la Harvard Business Review selon lequel seuls 3 % des données d'entreprise respectaient des standards de qualité de base, et un constat du MIT Sloan et de Thomas Redman selon lequel 47 % des enregistrements nouvellement créés contenaient au moins une erreur critique.
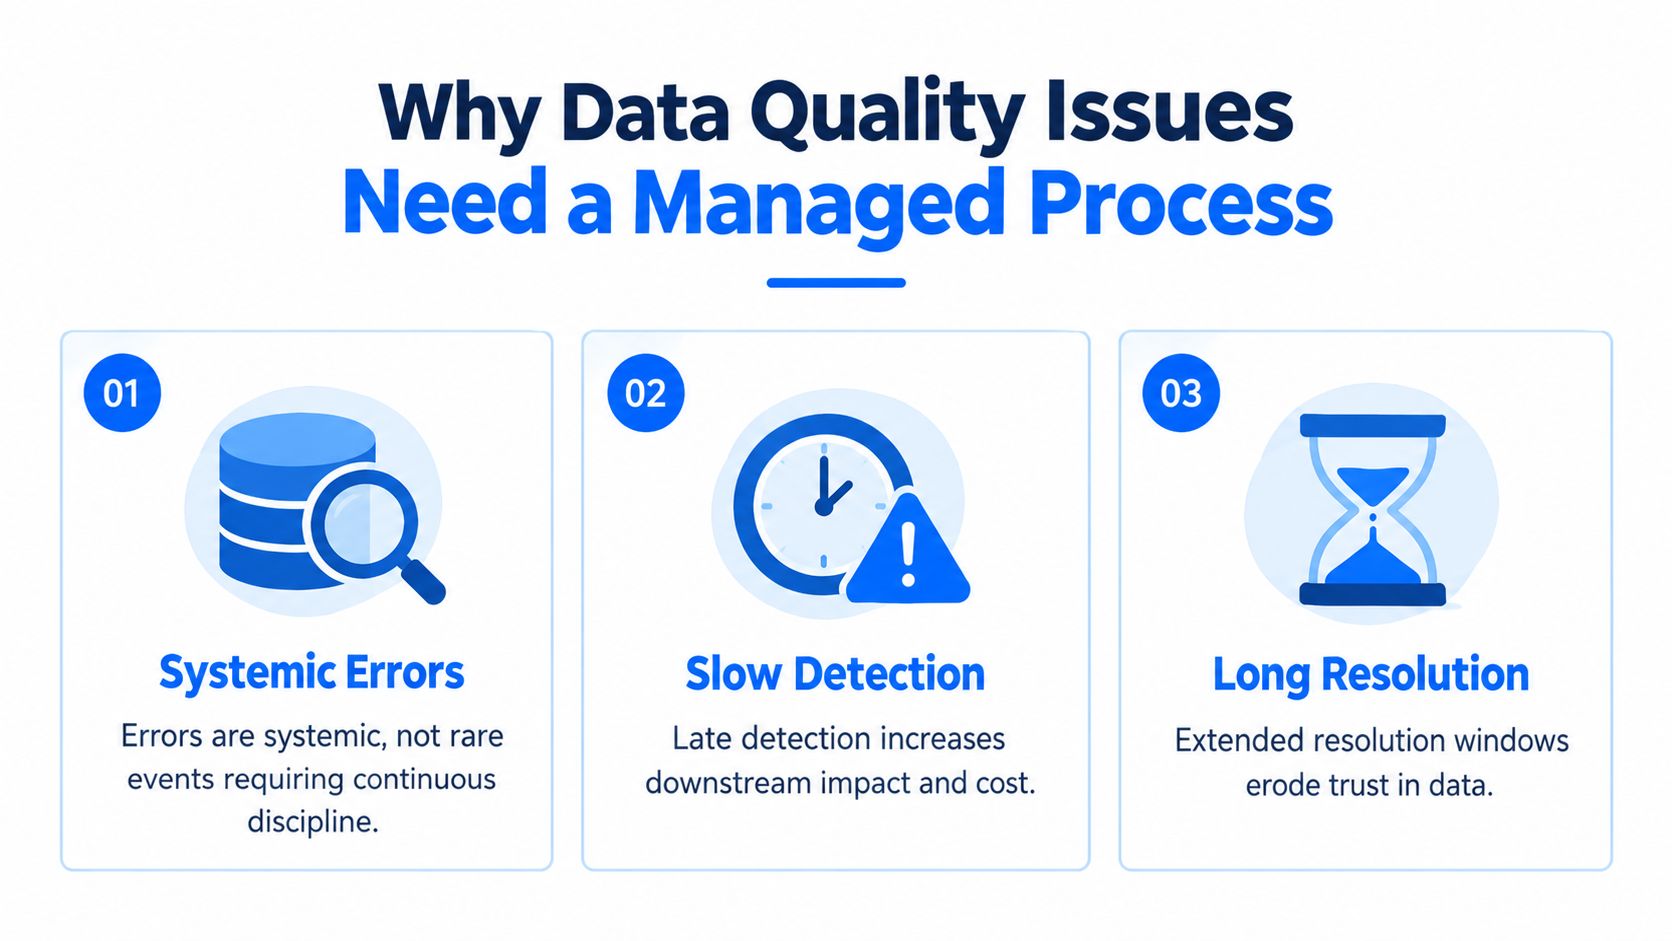
Les correctifs improvisés échouent à la frontière de la propriété
Le premier correctif est souvent la partie facile. Le difficile est de décider qui porte la cause racine, qui porte la communication en aval, quel délai de réponse le métier peut attendre et quel changement empêche la récidive.
Sans ces règles, les équipes optimisent la clôture plutôt que la résolution. Une personne rapièce un modèle. Une autre étouffe l'alerte. Personne ne met à jour le seuil, n'ajoute un test de contrat ni ne nomme un responsable permanent du système source. Le problème disparaît de la file et reste dans le système.
Règle pratique : si un défaut peut se reproduire, nommez un responsable, définissez une cible de réponse et décidez quel contrôle l'aurait attrapé plus tôt.
C'est pourquoi la gestion des problèmes doit être traitée comme un modèle d'exploitation. La détection en est une partie. Le reste est de la discipline de processus : un enregistrement par défaut sous-jacent, des critères de gravité clairs, des horloges de SLA, des passations qui ne s'enlisent pas sur Slack, et une boucle de prévention qui produit des changements dans le code, les tests, les métadonnées ou le comportement du système source.
J'ai vu des équipes passer plus de temps à débattre de savoir si un problème relève « vraiment de la qualité des données » qu'à décider qui doit le corriger. Cela signifie en général qu'il manque au processus une unité de travail commune et une attente de service. Le résultat est familier. La fatigue d'alerte monte, la propriété se brouille, et les utilisateurs métier se mettent à tenir des tableurs parallèles parce qu'ils font plus confiance à leurs vérifications manuelles qu'à la plateforme.
Processus géré veut dire processus mesurable
Une équipe ne peut pas améliorer ce qu'elle ne compte pas de façon cohérente. Si chaque contrôle échoué devient un incident distinct, la file paraît pire qu'elle ne l'est. Si l'on ne consigne que les problèmes visibles par la direction, elle paraît plus saine que la réalité. Les deux faussent la priorisation.
La vue utile est opérationnelle. Mesurez le taux de problèmes par rapport à une unité définie, puis suivez la performance SLA par gravité, domaine source et classe de problème récurrent. Cela montre si le souci vient de la couverture de détection, de la discipline de triage, d'une propriété faible ou de défauts amont répétés. Cela donne aussi aux responsables données de meilleurs arguments d'investissement que de dire que la qualité des données « paraît mauvaise ».
Cet argumentaire part souvent d'une explication plus large de pourquoi la qualité des données importe à une organisation, mais le gain quotidien est plus simple. Moins de tickets en double. Moins de temps avant l'accusé de réception. Un routage plus rapide vers le responsable. Davantage de correctifs qui suppriment le mode de défaillance au lieu de nettoyer ses symptômes.
Ce qui marche est rarement spectaculaire. Des seuils clairs. Des responsables nommés. Des cibles de réponse adossées à des SLA. Des règles d'escalade qui se déclenchent avant que la direction ne le remarque. Des actions post-incident qui changent le système.
Ce qui compte comme problème de qualité des données et comment le mesurer
Les équipes commencent trop tard. Elles se jettent dans le triage avant de s'accorder sur ce qu'est un problème.
C'est une erreur, car vos métriques s'effondrent dès que des équipes différentes comptent des choses différentes. Une équipe traite chaque contrôle échoué comme un problème. Une autre ne consigne que les incidents visibles côté métier. Une troisième ouvre cinq tickets pour un défaut amont parce que cinq modèles en aval ont échoué. Cette file se gère mal, car vous ne mesurez pas la même unité de défaillance.
Définissez le problème avant de définir le flux
Une méthodologie concrète compte un problème de qualité des données comme l'une de trois choses : un contrôle qualité échoué au-delà du seuil, un manquement de fraîcheur ou de SLA, ou un incident confirmé. Elle exclut les faux positifs et les échecs de traitement sans rapport avec la qualité des données, selon cette méthodologie de taux de problèmes.
La partie seuil compte. Une ligne directrice nationale de gestion de la qualité des données indique que chaque métrique doit avoir un seuil d'acceptation exprimé en pourcentage ou en nombre d'enregistrements, et présente la gestion des problèmes comme un processus continu d'identification, de suivi et de résolution à l'échelle de l'entité. En pratique, « il existe des e-mails vides » est descriptif, mais « les e-mails vides ont dépassé le seuil accepté » est opérationnel.
Choisissez le dénominateur qui correspond à votre maturité
Le dénominateur est l'endroit où les équipes créent soit un indicateur utile, soit une métrique de vitrine. Si vous surveillez un grand nombre de contrôles, « contrôles échoués sur contrôles exécutés » peut convenir. Si vous ne suivez qu'un ensemble d'actifs critiques, « problèmes par jeu de données surveillé » est souvent plus net. Si votre environnement est très orienté lots et à fort volume, la densité de problèmes par enregistrements traités peut avoir plus de sens.
Base de mesure | Quand l'utiliser | Indicateur exemple |
|---|---|---|
Fondée sur les contrôles | Vous exécutez de nombreux contrôles automatisés sur pipelines et tables | Taux de contrôles échoués |
Fondée sur les jeux de données | Vous surveillez une liste curatée de jeux de données critiques | Problèmes par jeu de données critique surveillé |
Fondée sur le volume | Vous traitez de grands volumes et voulez suivre une densité | Problèmes par million d'enregistrements traités |
Le but n'est pas de trouver le meilleur dénominateur universel. C'est d'en choisir un qui reflète le fonctionnement de votre plateforme et de le garder stable assez longtemps pour comparer des tendances.
Nettoyez les entrées avant de vous fier aux sorties
Avant de calculer des indicateurs de problèmes, rassemblez les données d'exploitation qui prouvent ce qui s'est passé. Cela comprend en général :
Résultats de contrôles : échecs de validation, sorties d'anomalies, manquements de fraîcheur.
Journaux de pipeline : statut d'exécution, reprises, échecs de dépendances amont.
Données de tickets : ouvert, accusé, atténué, résolu, rouvert.
Métadonnées de lignage : ce qui a cassé en amont et quels consommateurs en ont hérité.
Puis le travail ingrat :
Dédoublonnez les alertes liées pour que cinq défaillances en aval rattachées à un défaut source deviennent un seul problème.
Normalisez les catégories de cause racine pour que « dérive de schéma », « extraction source tardive » et « mauvais mappage de référence » veuillent dire la même chose chaque fois.
Séparez la création du problème de sa confirmation si votre couche d'alerte est bruyante.
Ne suivez les résultats SLA qu'une fois la taxonomie des problèmes stabilisée.
Une métrique que vous ne pouvez pas comparer d'un mois à l'autre n'est pas une métrique de pilotage. C'est un instantané.
Pour les équipes qui affinent dimensions et seuils, il est utile d'aligner les définitions de problème sur les dimensions de la qualité des données, puis d'attacher à chacune des critères d'acceptation clairs. Cela donne à l'ingénierie, à l'analytique et au métier le même langage avant que la file d'incidents ne se mette en mouvement.
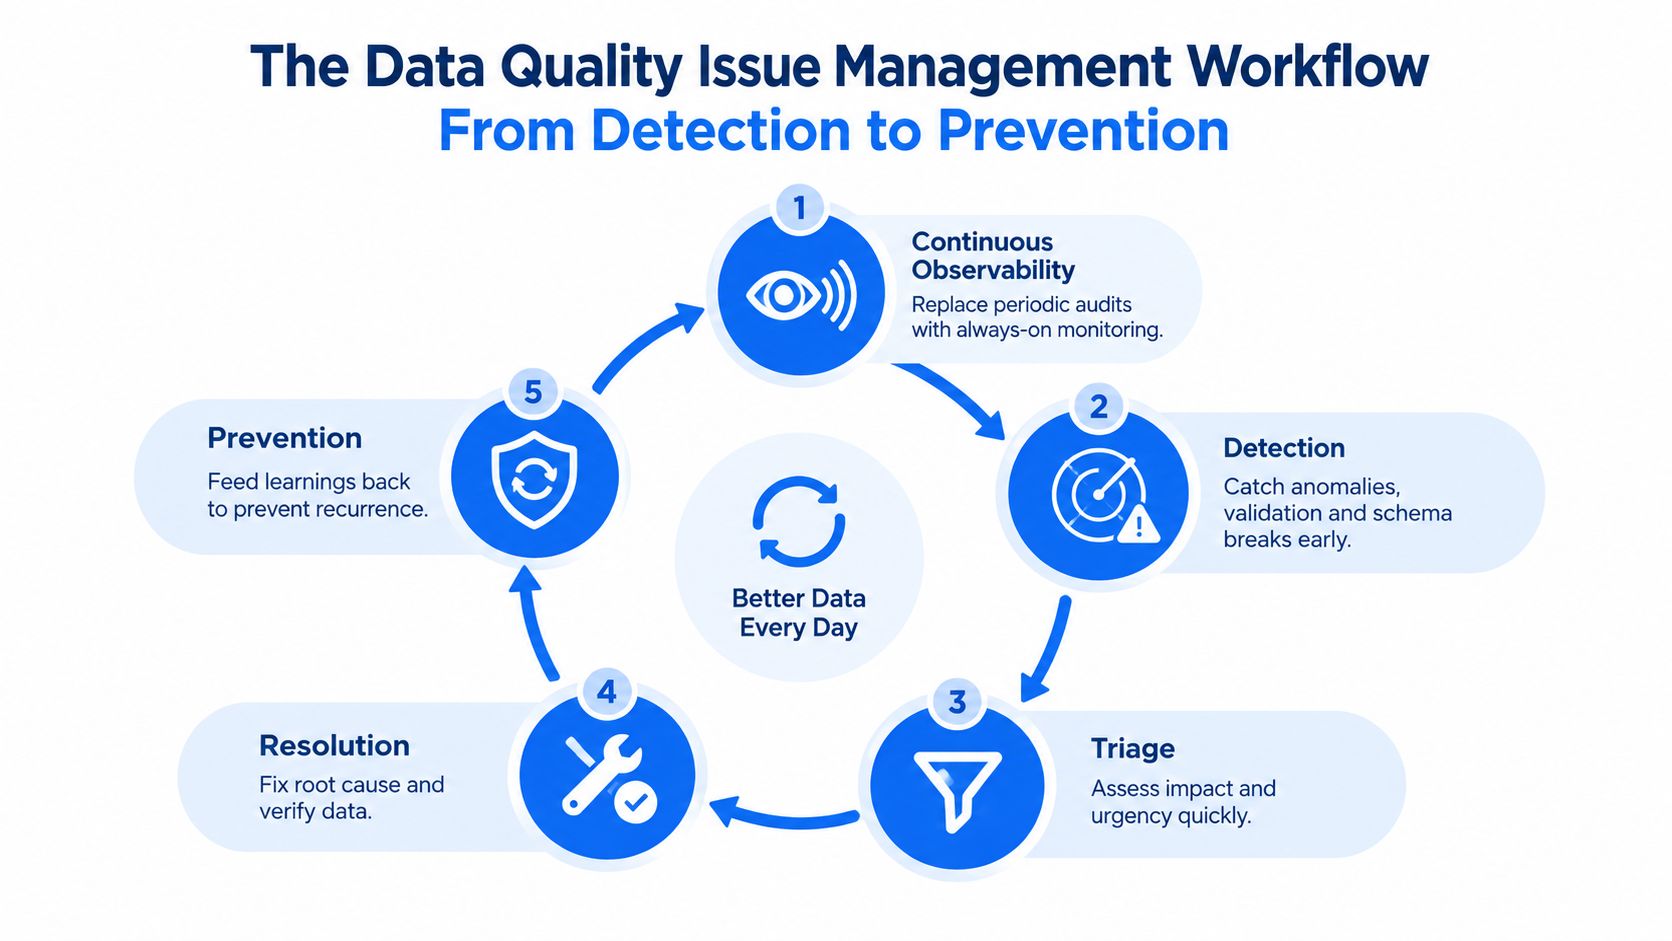
Le flux de gestion des problèmes de qualité des données, de la détection à la prévention
À 8 h 15, la finance ouvre un tableau de bord avant la clôture mensuelle et les chiffres de la veille manquent. Le traitement d'ingestion a techniquement réussi. L'entrepôt fonctionne. La couche BI sert des données périmées parce qu'une extraction amont est arrivée trois heures en retard et que personne ne portait le contrôle de fraîcheur. Voilà à quoi ressemble un flux faible en production. La défaillance n'est pas seulement la détection. C'est l'absence d'un modèle d'exploitation reliant surveillance, propriété, cibles de réponse et prévention.
Commencez par une observabilité qui crée des problèmes actionnables
La gestion des problèmes commence avant qu'un ticket existe. Les équipes ont besoin de signaux disant ce qui a échoué, quand, ce qui a changé et qui est exposé.
Des revues périodiques ne peuvent pas faire ce travail. Les défauts de production apparaissent entre deux cycles de revue et, le temps que quelqu'un le remarque, des tables, tableaux de bord ou modèles en aval ont déjà consommé les mauvaises données. Une bonne surveillance et restitution pour les opérations de qualité des données raccourcit l'écart entre l'apparition du défaut et la réaction humaine.
Les signaux utiles se rangent en général en quatre groupes :
Fraîcheur et Timeliness : chargements manquants, livraisons tardives, arrivée partielle d'un lot
Échecs de validation : champs obligatoires, valeurs acceptées, unicité, règles de rapprochement
Changements structurels : colonnes ajoutées, colonnes supprimées, changements de type, violations de contrat
Décalages de comportement : pics de volume, variations du taux de valeurs nulles, dérive de distribution, mouvement inattendu d'une métrique
Le compromis est simple. Plus de contrôles attrapent plus de défauts, mais créent aussi plus de bruit. Les équipes qui surveillent tout à la même sensibilité entraînent d'ordinaire les intervenants à ignorer les alertes. Le but est de créer des problèmes qui méritent traitement, pas une file pleine de faux positifs.
Séparez la détection de la validation
Un contrôle échoué est un événement. Un problème est un événement validé, avec périmètre, impact et responsable.
Cette distinction compte parce que les flux d'alerte sont bruyants. Un changement de schéma dans une table bac à sable ne doit pas concurrencer un flux de chiffre d'affaires cassé. Si le processus ouvre un ticket pour chaque anomalie sans validation, l'équipe passe sa journée à fermer du bruit et rate l'incident qui touche les échéances de reporting ou les produits clients.
GitLab documente une séquence concrète dans son manuel du programme de qualité des données : Détection → Triage et validation → Investigation → Résolution → Prévention → Clôturé. L'intérêt de ce flux est la porte de décision. Avant qu'un problème n'entre dans la file principale, quelqu'un confirme qu'il est réel, vérifie si des consommateurs sont touchés et décide s'il relève du chemin incident ou du backlog standard.
Cette étape améliore aussi la mesure. Le volume de détection vous dit à quel point le système est bruyant. Le volume de problèmes confirmés vous dit ce que les exploitants doivent traiter. Suivre les deux, c'est ainsi que les équipes repèrent des seuils faibles et des taux gonflés.
L'investigation doit remonter le défaut jusqu'au point de contrôle
La résolution ralentit quand les équipes courent après le symptôme visible plutôt que la source. Je le vois souvent avec les casses en aval. Un tableau de bord tombe, alors on se met à rapiécer la logique BI, alors que la vraie faute est dans une extraction amont, un changement de code du système source ou une dépendance d'ordonnanceur.
Quelques motifs reviennent souvent :
Données tardives : le tableau de bord périmé est le symptôme. La cause racine est en général un retard amont, une tempête de reprises ou un échec de dépendance.
Dérive de schéma : le modèle de l'entrepôt casse après qu'une source change un type ou supprime un champ.
Échec de règle métier : une table de mappage ou un flux de référence accepte une valeur nouvelle qu'aucune règle en aval n'attend.
Le Bureau australien des statistiques expose un processus par étapes dans son manuel de gestion et de signalement des incidents qualité : surveiller la qualité, identifier le problème, l'évaluer, engager la voie de signalement appropriée, puis évaluer et mettre en œuvre l'action corrective. Cette séquence tient en pratique parce que l'évaluation est explicite. Les équipes qui la sautent ont tendance soit à sur-escalader des anomalies anodines, soit à sous-estimer des défauts qui se propagent à plusieurs consommateurs.
La résolution n'est complète qu'une fois la confiance rétablie
Clore la faute technique n'est qu'une partie du travail. La question est de savoir si les consommateurs peuvent de nouveau se fier aux données.
Un flux de résolution viable comprend en général quatre actions :
Confinement. Mettre un consommateur en pause, masquer un tableau de bord cassé, revenir sur une transformation ou isoler des enregistrements défectueux.
Correction. Réparer la défaillance dans la couche qui a introduit le défaut.
Vérification. Relancer les contrôles, rapprocher les sorties clés et confirmer que les données en aval se sont rétablies.
Communication. Dire aux personnes touchées ce qui n'allait pas, ce qui a été corrigé, et à partir de quel horodatage les données sont sûres.
Le manuel de gestion des incidents de GitLab est utile ici parce qu'il traite les incidents de données comme des événements d'exploitation exigeant affectation structurée, documentation et communication. C'est un meilleur schéma que de s'appuyer sur un long fil Slack que personne ne pourra auditer ensuite.
La prévention boucle la boucle et prouve que le processus fonctionne
La prévention appartient au flux, pas à son après. Si la même classe de défaut réapparaît sans cesse, l'équipe n'a pas un problème de détection. Elle a un problème de conception des contrôles.
Le remède peut être une règle de validation plus stricte à l'ingestion, un contrat de données pour une source instable, un SLO de fraîcheur avec un responsable explicite, ou une mise à jour de runbook qui lève l'ambiguïté lors de la passation. Le bon choix dépend de l'endroit où le problème est entré dans le système et du coût pour l'attraper plus tôt.
C'est aussi là que la gestion des problèmes devient un modèle d'exploitation. Mesurez le taux de récidive par catégorie de cause racine. Mesurez combien de problèmes respectent le SLA d'accusé, d'atténuation et de résolution. Mesurez le taux de réouverture après clôture. Ces chiffres disent où investir. Une file avec des clôtures rapides mais une forte récidive a en général besoin de contrôles préventifs plus solides. Une file avec peu de récidive mais une mauvaise performance SLA a souvent des soucis de propriété ou de routage.
Comment trier, prioriser et attribuer la propriété sous SLA
À 9 h 07, la finance signale que le tableau de bord de chiffre d'affaires de la veille a chuté de 18 pour cent. La personne responsable du tableau voit le symptôme, mais le défaut se situe trois sauts en amont dans une extraction source arrivée tardivement, et la règle d'exclusion des transactions de test reste non documentée. Sans modèle de triage, trois équipes commencent à enquêter, personne ne porte l'horloge, et le métier reçoit des points de situation sans délai de rétablissement.
C'est le rôle de cette étape. Fixez la gravité vite, nommez un responsable direct, et posez des cibles de réponse et de résolution sur le problème pour qu'il ne dérive pas dans une file partagée.
Utilisez la gravité pour rendre les arbitrages explicites
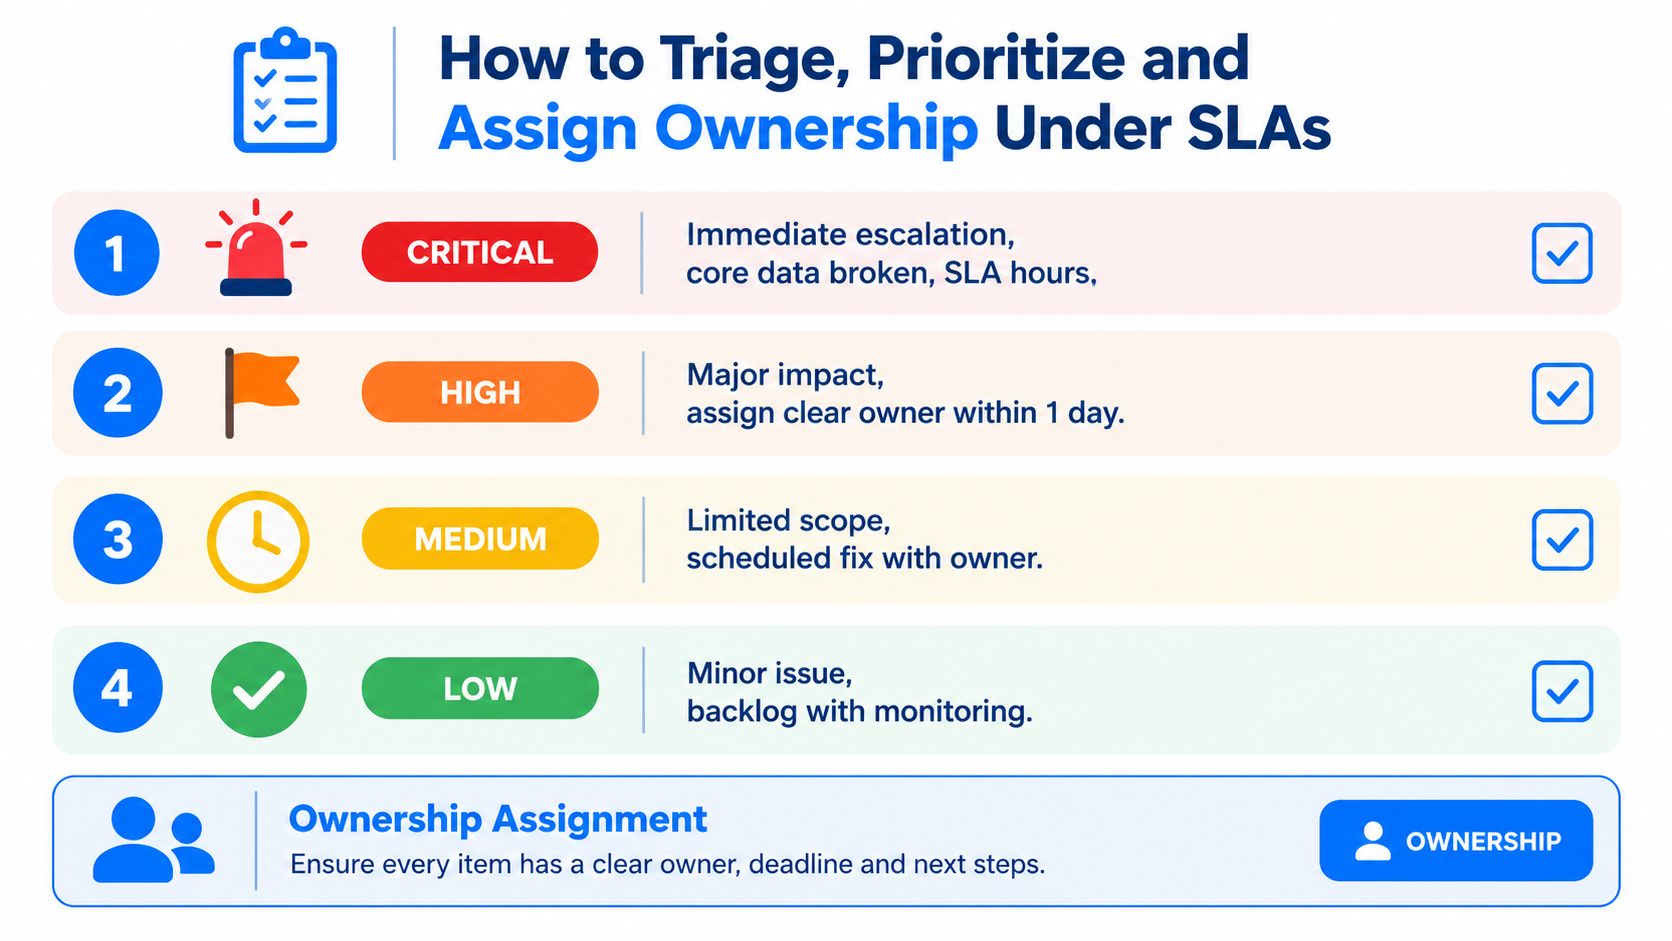
La gravité doit répondre à une question : quel risque métier acceptons-nous de porter avant que ce soit corrigé ?
Un modèle concret utilise des cibles distinctes pour l'accusé, l'atténuation et la résolution finale. Les équipes travaillent souvent avec des fenêtres de réponse en heures pour les incidents les plus graves, une atténuation en jours et une résolution complète sur une horloge plus longue quand le correctif durable exige des changements de code, une coordination avec l'équipe source ou des reprises de charge. Les cibles exactes comptent moins que la cohérence. Si « priorité haute » veut dire le jour même pour une équipe et le sprint suivant pour une autre, le SLA n'est que du bruit.
Fixez la gravité à partir de trois facteurs :
Impact métier : quelles décisions, rapports, modèles ou parcours clients sont touchés ?
Rayon de propagation : jusqu'où le problème s'est-il diffusé dans les tables et tableaux de bord en aval ?
Risque de contrôle : touche-t-il des sorties réglementées, du reporting de direction, la facturation ou des métriques visibles à l'extérieur ?
Gardez le modèle petit. Quatre niveaux suffisent en général. Davantage crée du débat sans améliorer le routage.
Attribuez la propriété au domaine qui corrige
La première équipe qui remarque le problème est rarement le bon responsable. Le bon est celle qui peut changer le contrôle, le chemin de code ou le comportement source défaillant.
Utilisez un modèle de routage comme celui-ci :
Niveau de gravité | Condition typique | Responsable principal | Chemin d'escalade |
|---|---|---|---|
Critique | Produit de données central cassé ou impact métier immédiat | Plateforme de données ou personne responsable de l'ingénierie du domaine | Canal d'incident et information de la direction |
Élevée | Fort impact en aval mais rayon de propagation limité | Responsable du jeu de données avec appui de l'ingénierie | Revue formelle d'incident si l'atténuation stagne |
Moyenne | Problème circonscrit avec contournement disponible | Ingénierie analytique ou intendant des données | Remédiation planifiée avec suivi |
Faible | Défaut cosmétique, à faible impact ou isolé | Responsable du backlog | Surveiller la tendance et réexaminer en cas de répétition |
Cela lève un manque de propriété fréquent. Les équipes plateforme portent pipelines et contrôles. Les équipes applicatives portent le comportement du système source. Les responsables métier portent l'intention des règles et les critères d'acceptation. Les trois peuvent être impliqués, mais une seule personne doit porter l'horloge du SLA, les points de situation et l'action suivante.
Si l'intention d'une règle n'a pas de responsable, les ingénieurs en inventeront un sous pression.
Priorisez en tenant compte de la capacité
Les files d'incidents échouent quand chaque alerte rouge est traitée comme aussi urgente. La capacité est limitée. Certains défauts méritent une interruption immédiate. D'autres coûtent moins cher à contenir, documenter et corriger en travail planifié.
La recherche sur la pratique de la qualité des données a pointé une responsabilité fragmentée et une gestion incohérente comme causes récurrentes de mauvais résultats dans cette étude sur les problèmes systémiques. La recherche en santé a aussi identifié des plans d'action flous, des ressources limitées et une formation faible comme obstacles dans la discussion de l'enquête publiée. Ces constats rejoignent ce que l'on voit dans les files de production. Il ne manque en général pas d'alertes aux équipes. Il leur manque une façon cohérente de décider ce qui interrompt le travail en cours.
Utilisez quatre questions de triage :
Qu'est-ce qui casse si cela attend demain ou la semaine prochaine ?
Qui consomme ensuite les données touchées, et quelle décision en tirera-t-il ?
Pouvons-nous contenir le problème par un retour arrière, une quarantaine, une annotation ou un filtre temporaire ?
La récidive est-elle assez fréquente pour que le travail de prévention l'emporte sur un énième correctif ponctuel ?
Cette dernière question compte. Un problème de gravité moyenne qui revient chaque semaine mérite en général plus d'attention qu'un défaut unique très visible et peu susceptible de se reproduire.
Pilotez la file au regard de SLA mesurables
Une entrée unique aide, mais l'hygiène de la file n'est qu'une partie du modèle d'exploitation. Suivez si l'équipe atteint les cibles d'accusé, d'atténuation et de résolution par gravité. Suivez le taux de réouverture. Suivez le taux de problèmes par jeu de données, domaine et catégorie de cause racine. Ces métriques montrent si le souci vient d'un mauvais routage, de contrôles faibles ou d'un sous-investissement chronique dans une zone source.
Utilisez ces chiffres pour ajuster les priorités. Une file aux délais de résolution corrects mais au mauvais accusé a en général des soucis d'alerte ou de couverture d'astreinte. Une file qui respecte les SLA de réponse mais rate la résolution finale connaît souvent des frictions de propriété entre équipes. Les équipes qui veulent fixer et revoir ces cibles de service plus clairement devraient les définir aux côtés de pratiques de mesure de la fiabilité, afin de revoir ensemble taux de problèmes et performance SLA plutôt que dans des tableaux séparés.
Une file. Une décision de gravité. Une personne responsable sur l'horloge. Voilà ce qui transforme la gestion des problèmes de qualité des données en modèle d'exploitation plutôt qu'en triage réactif.
Ancrer le processus dans les outils, les rôles et l'exploitation quotidienne
Un flux documenté ne survivra pas au contact de la production s'il n'est pas ancré dans les outils que les gens utilisent déjà.
Cela veut dire que votre processus qualité doit vivre là où tournent les traitements de l'entrepôt, là où les analystes valident les sorties, et là où la gouvernance peut voir tendance et historique d'incidents. Si vous boulonnez un silo qualité séparé avec ses propres tableaux, taxonomies et liste d'utilisateurs, la propriété se fragmente en général en un trimestre.
Construisez autour d'une seule vue opérationnelle
Le schéma concret est simple. Faites tourner détection d'anomalies, validation, surveillance de la Timeliness et suivi de schéma sur les mêmes jeux de données critiques. Alimentez un tableau de bord partagé avec ces signaux. Reliez ce tableau au contexte d'ordonnancement, aux métadonnées, au lignage et au ticketing pour que les intervenants passent de l'alerte à l'action sans recoudre les preuves à la main.
Le choix de conception clé est le modèle d'exécution. Des contrôles dans la base réduisent les déplacements de données et facilitent la revue de sécurité, surtout en environnement réglementé. Ils gardent aussi la logique de surveillance plus près des tables et transformations à vérifier.
Les rôles ont besoin d'un contexte partagé, pas d'outils séparés
Chaque rôle s'intéresse à des signaux de défaillance différents :
Les ingénieurs de données veulent l'état des pipelines, la fraîcheur, les reprises et les ruptures de schéma.
Les ingénieurs analytiques et développeurs BI s'intéressent aux échecs de règles métier, aux symptômes de dérive de modèle et aux sorties sémantiques cassées.
Les responsables gouvernance et qualité ont besoin de seuils, de tendances, de statut d'acceptation et de preuves prêtes pour l'audit.
Si chacun de ces groupes travaille depuis un système différent, le triage ralentit parce que chaque problème commence par un rapprochement. Un meilleur schéma est une visibilité partagée avec des vues par rôle. La plateforme peut exposer le même incident via des journaux techniques pour l'ingénierie et des synthèses d'impact métier pour les responsables non techniques.
L'adoption modulaire vaut mieux qu'un déploiement d'un seul coup
La plupart des organisations n'ont pas besoin de déployer toutes les capacités de surveillance dès le premier jour. Elles ont besoin de commencer par le mode de défaillance qui fait le plus mal, puis d'ajouter de la couverture autour.
C'est là que les choix d'outillage comptent. Certaines équipes commencent par la fraîcheur et le schéma, parce que ces défauts sont les plus faciles à détecter et à router. D'autres démarrent par la validation déterministe, parce que la conformité ou la finance exige des preuves de contrôle explicites. En environnement mixte, une option modulaire aide. Par exemple, des schémas de mise en œuvre de la qualité des données fonctionnent souvent mieux quand la pile peut s'étendre d'un domaine surveillé à plusieurs sans imposer un nouveau modèle d'exploitation.
Une option de cette catégorie est digna, qui s'exécute dans l'environnement du client et combine détection d'anomalies, validation, surveillance de la Timeliness, suivi de schéma, prise en charge d'ordonnanceur, fonctions de catalogue, intégrations et tableau de bord partagé. Ce montage est utile quand les équipes veulent une exécution dans la base et ne souhaitent pas sortir les données de production de leur propre infrastructure.
Ce qui tient dans la durée est rarement le détecteur le plus sophistiqué. C'est le montage qui garde le processus visible, la propriété attachée, et qui convient à l'environnement dont les équipes disposent déjà.
Éviter les problèmes récurrents et prouver que le processus fonctionne
Une file qui clôt des tickets mais rouvre sans cesse les mêmes motifs de défaillance n'est pas mature. Elle est occupée.
La preuve que votre processus fonctionne est simple. La détection s'accélère. La résolution devient plus nette. Les défauts répétés reculent. Les parties prenantes cessent de se disputer sur la fiabilité d'un rapport, parce que l'historique d'incidents, le registre de remédiation et les seuils d'acceptation sont visibles.
La prévention exige des changements après incident
Chaque incident significatif devrait laisser une amélioration durable. Peut-être un nouveau seuil, une règle de validation manquante, un contrat de schéma ou une passation de responsabilité plus nette. Si la clôture ne consigne que ce qui a cassé, le système n'a rien appris.
Les revues post-incident les plus utiles se concentrent sur l'identification des causes racines avec assez de précision pour changer les contrôles, pas seulement décrire les symptômes. Si votre équipe cherche une référence pratique sur cette discipline, cette collection sur l'identification des causes racines mérite sa place dans le runbook.
La bonne question après la résolution n'est pas « qui l'a corrigé ? ». C'est « qu'est-ce qui a changé pour que nous ne rencontrions pas ce problème la semaine prochaine ? ».
Suivez les métriques qui changent les comportements
Les métriques qui méritent de rester sous les yeux des équipes sont celles qui influent sur la qualité de la réponse :
Temps de détection : combien de temps le défaut a existé avant que l'équipe le sache.
Temps de résolution : combien de temps le métier est resté exposé.
Respect des SLA : si réponse, atténuation et clôture ont atteint la cible.
Taux de problèmes répétés : si la même catégorie de cause racine continue de revenir.
Exposition métier : quels rapports, processus ou décisions critiques ont été touchés.
Vous n'avez pas besoin d'un immense tableau de bord. Vous avez besoin d'un tableau stable. Si les équipes voient qu'un domaine rate régulièrement ses cibles de fraîcheur ou qu'une classe de changements de schéma rouvre souvent, le travail de prévention devient plus facile à justifier.
Un court test de maturité
Utilisez ceci comme auto-évaluation brute :
Une définition du problème existe : les équipes s'accordent sur ce qui compte comme problème et ce qui n'en est pas un.
Les seuils sont documentés : les métriques ne deviennent actionnables qu'au franchissement de limites acceptées.
La gravité est normalisée : la priorité ne dépend pas de qui est d'astreinte.
La propriété est explicite : chaque problème a un responsable et un chemin d'escalade.
La clôture inclut la prévention : les correctifs mettent à jour règles, lignes de base, contrats ou runbooks.
Les preuves sont conservées : vous pouvez montrer ce qui s'est passé, qui est intervenu, ce qui a changé et si les SLA ont été tenus.
Si ne serait-ce que deux de ces points sont faibles, le processus reste fragile. C'est normal. Les équipes n'ont pas besoin d'une nouvelle philosophie. Elles ont besoin de moins de passations ambiguës et de plus de discipline d'exploitation autour des défauts qu'elles connaissent déjà.
Si votre équipe cherche à transformer des contrôles éparpillés en véritable modèle d'exploitation, digna est conçue pour ce type de travail. Elle aide les équipes à surveiller anomalies, Timeliness, validation et changements de schéma dans leur propre environnement, pour que détection, propriété et prévention tournent comme un seul processus plutôt que quatre outils déconnectés.
Un processus n'est mesurable que par les chiffres qui le portent — associez ce flux à un jeu opérationnel de métriques de qualité des données pour qu'une clôture veuille dire quelque chose.
Questions fréquentes
Pourquoi les correctifs improvisés échouent-ils ?
Ils échouent à la frontière de la propriété. Quelqu'un rapièce un modèle SQL, relance un pipeline et déclare l'affaire réglée, mais personne ne porte la question de savoir si la confiance a été rétablie ni si le même défaut reviendra. Un processus géré se mesure ; un processus improvisé, non.
Qu'est-ce qui compte comme problème de qualité des données ?
Définissez le problème avant le flux. Tout contrôle échoué n'est pas un problème, et tout problème ne commence pas par un contrôle échoué — un mouvement inexpliqué d'indicateur compte aussi. Choisissez un dénominateur adapté à votre maturité, et nettoyez les entrées avant de croire au moindre taux calculé à partir d'elles.
À quoi ressemble le flux de bout en bout ?
Détection, validation, investigation, résolution et prévention. Détection et validation restent séparées à dessein, car une alerte n'est pas encore un incident. L'investigation remonte le défaut à son point de contrôle, et la résolution reste incomplète tant que la confiance n'est pas rétablie, pas seulement tant que les données n'ont pas changé.
Comment trier et attribuer les problèmes ?
Utilisez la gravité pour rendre les arbitrages explicites plutôt que de traiter chaque problème comme urgent. Attribuez la propriété au domaine qui corrige — l'équipe capable de changer réellement le contrôle — et non à celui qui a remarqué. Puis priorisez en tenant compte de la capacité et pilotez la file au regard de SLA mesurables.
Comment empêcher les mêmes problèmes de revenir ?
La prévention exige des changements de contrôles après incident, pas seulement un ticket clos. Suivez les métriques qui changent les comportements, comme le taux de récidive et le temps jusqu'au rétablissement de la confiance, plutôt que des comptages bruts, qui baissent dès que les gens cessent de signaler.