10 méthodes de contrôle de la qualité des données qui fonctionnent
|
9
minute de lecture

Un seul jeu de règles ne suffit pas à protéger un environnement de données moderne. Les contrôles déterministes détectent les enregistrements invalides, mais ils ne repèrent pas forcément un effondrement de volume qui a l'air parfaitement légitime. Un seuil statique peut signaler un pic saisonnier comme un incident, tandis qu'un moniteur de livraison peut identifier un chargement manquant sans dire si les enregistrements arrivés sont valides. Contrôles structurels, signaux comportementaux, indicateurs métier, télémétrie de la plateforme et collaboration humaine révèlent chacun un mode de défaillance différent.
La bonne réponse n'est pas de choisir entre tests et observabilité. Les équipes ont besoin de couches de contrôle complémentaires qui fonctionnent ensemble à l'ingestion, à la transformation, au stockage et à la consommation. Ce principe suit l'évolution plus large du contrôle qualité, des cartes de contrôle de Walter A. Shewhart en 1924, conçues pour distinguer la variation normale de la variation due à des causes spéciales, jusqu'aux méthodes modernes qui mesurent des dimensions comme la complétude, la fraîcheur et la cohérence. L'histoire du contrôle statistique de la qualité montre pourquoi un comportement anormal mérite une investigation, tandis que les dimensions de la qualité des données offrent un vocabulaire pour décrire ce que « bon » veut dire.
Les 10 méthodes de contrôle de la qualité des données ci-dessous sont organisées comme une pile de contrôles. Commencez par des règles explicites, ajoutez des signaux appris et statistiques, surveillez la livraison et la structure, protégez les données sensibles avec la bonne architecture, puis reliez les incidents techniques à l'impact métier et aux processus des équipes. Pour une application concrète, consultez ce guide de validation des données de pipelines issues des réseaux sociaux.
Table des matières
1. Détection d'anomalies par IA avec apprentissage d'une référence
2. Validation des données au niveau de l'enregistrement selon les règles métier
4. Détection des changements de schéma et surveillance structurelle
5. Analyse statistique et analyse des tendances des métriques de données
6. Calcul et analyse des métriques directement dans la base de données
7. Surveillance des KPI métier et des métriques opérationnelles
8. Observabilité de la plateforme de données et des workloads
9. Tableaux de bord complets d'observabilité des données et surveillance collaborative
10. Architecture modulaire de contrôle qualité avec déploiement rapide
Comparatif en 10 points : méthodes de contrôle de la qualité des données
1. Détection d'anomalies par IA avec apprentissage d'une référence
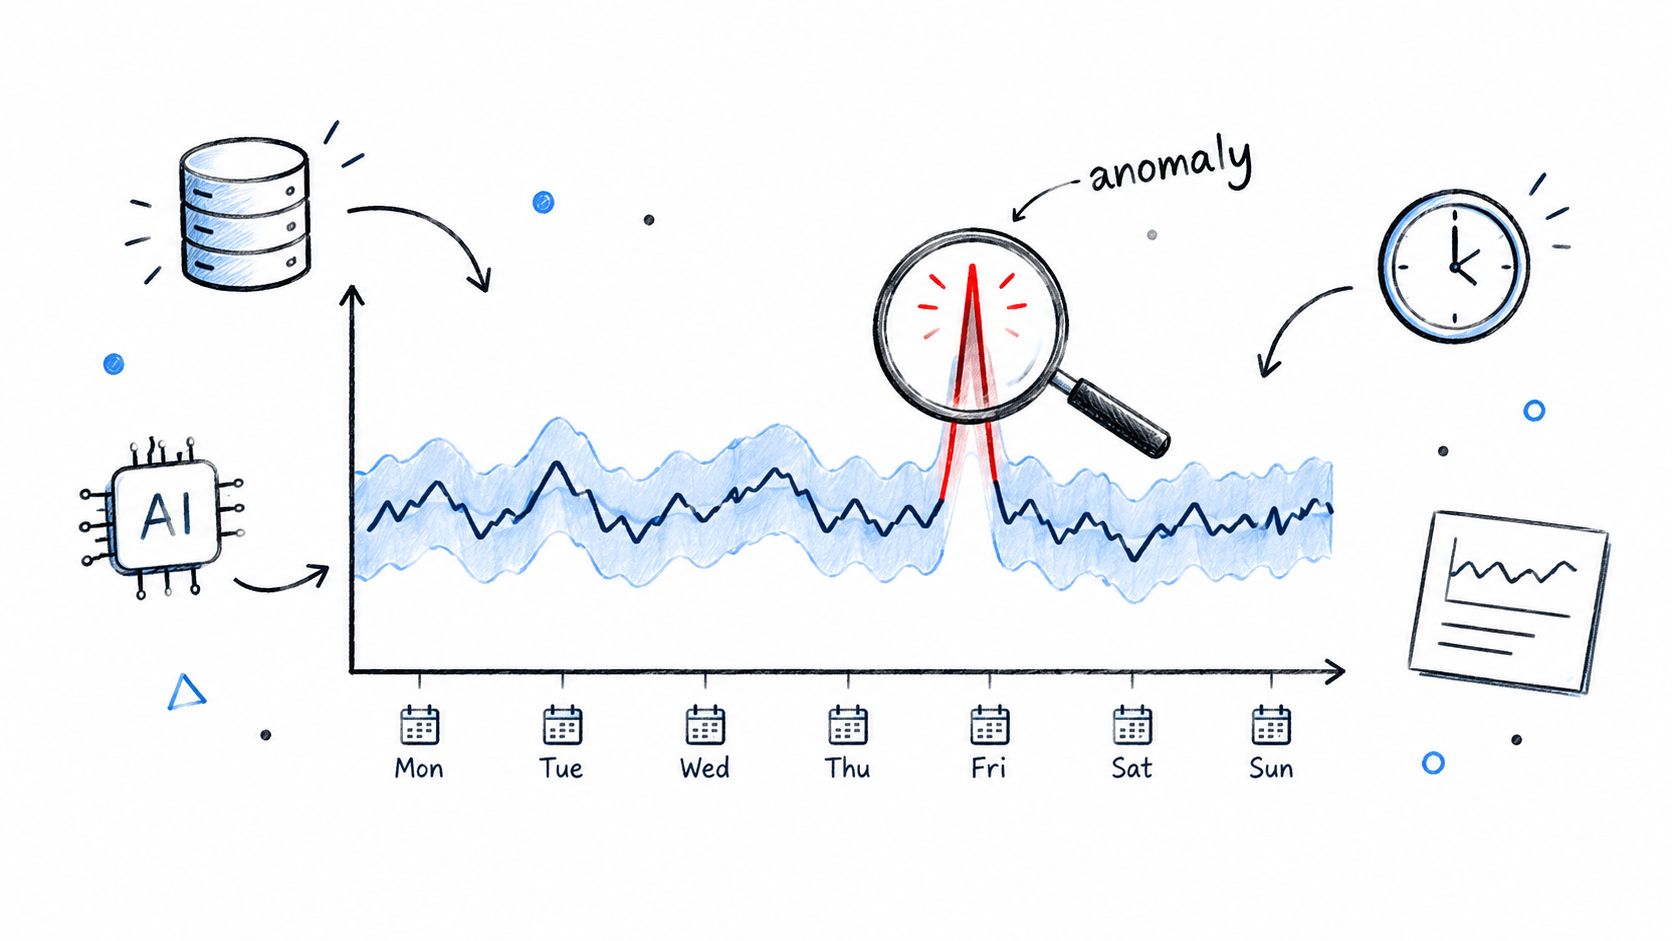
La détection d'anomalies par IA recherche les comportements qui s'écartent du schéma normal d'un dataset. Au lieu d'obliger les ingénieurs à écrire un seuil pour chaque table, le système apprend une référence à partir de l'historique des volumes, des distributions, des catégories ou d'autres métriques d'observabilité. Elle est donc utile pour les datasets marqués par la saisonnalité, la croissance, une demande irrégulière ou des relations trop complexes pour une règle fixe.
Le module Data Anomalies de digna est conçu pour ce type de surveillance. Dans un environnement financier, une baisse inattendue du volume de transactions peut apparaître avant un échec de rapprochement. Dans la santé, un schéma inhabituel d'admissions de patients ou une distribution atypique de résultats de laboratoire peut justifier une investigation. Dans les télécommunications, une variation du trafic réseau peut signaler une dégradation du service ou un usage inhabituel. Ce sont des signaux de détection, pas une preuve automatique d'un problème métier : un responsable doit encore valider la cause.
Rendre la référence explicable
Collectez suffisamment d'historique représentatif avant de considérer les alertes comme exploitables. Un nouveau dataset, une acquisition, un lancement de produit ou une migration de source peut rendre une ancienne référence trompeuse. Ajoutez du contexte métier, comme les événements calendaires, les campagnes prévues et les responsables des sources, puis passez en revue les premières alertes avec des experts métier pour ajuster la sensibilité.
Règle pratique : utilisez la détection d'anomalies pour trouver ce que les règles n'avaient pas prévu, puis la validation déterministe pour prouver ce qui a échoué.
La détection d'anomalies pour les données catégorielles de digna est particulièrement pertinente lorsqu'un changement dans la répartition des catégories compte davantage qu'un simple nombre de lignes. Les équipes peuvent combiner cette approche avec les solutions IA de Wisely lorsqu'elles ont besoin d'un accompagnement plus large pour la mise en œuvre de l'IA.
2. Validation des données au niveau de l'enregistrement selon les règles métier
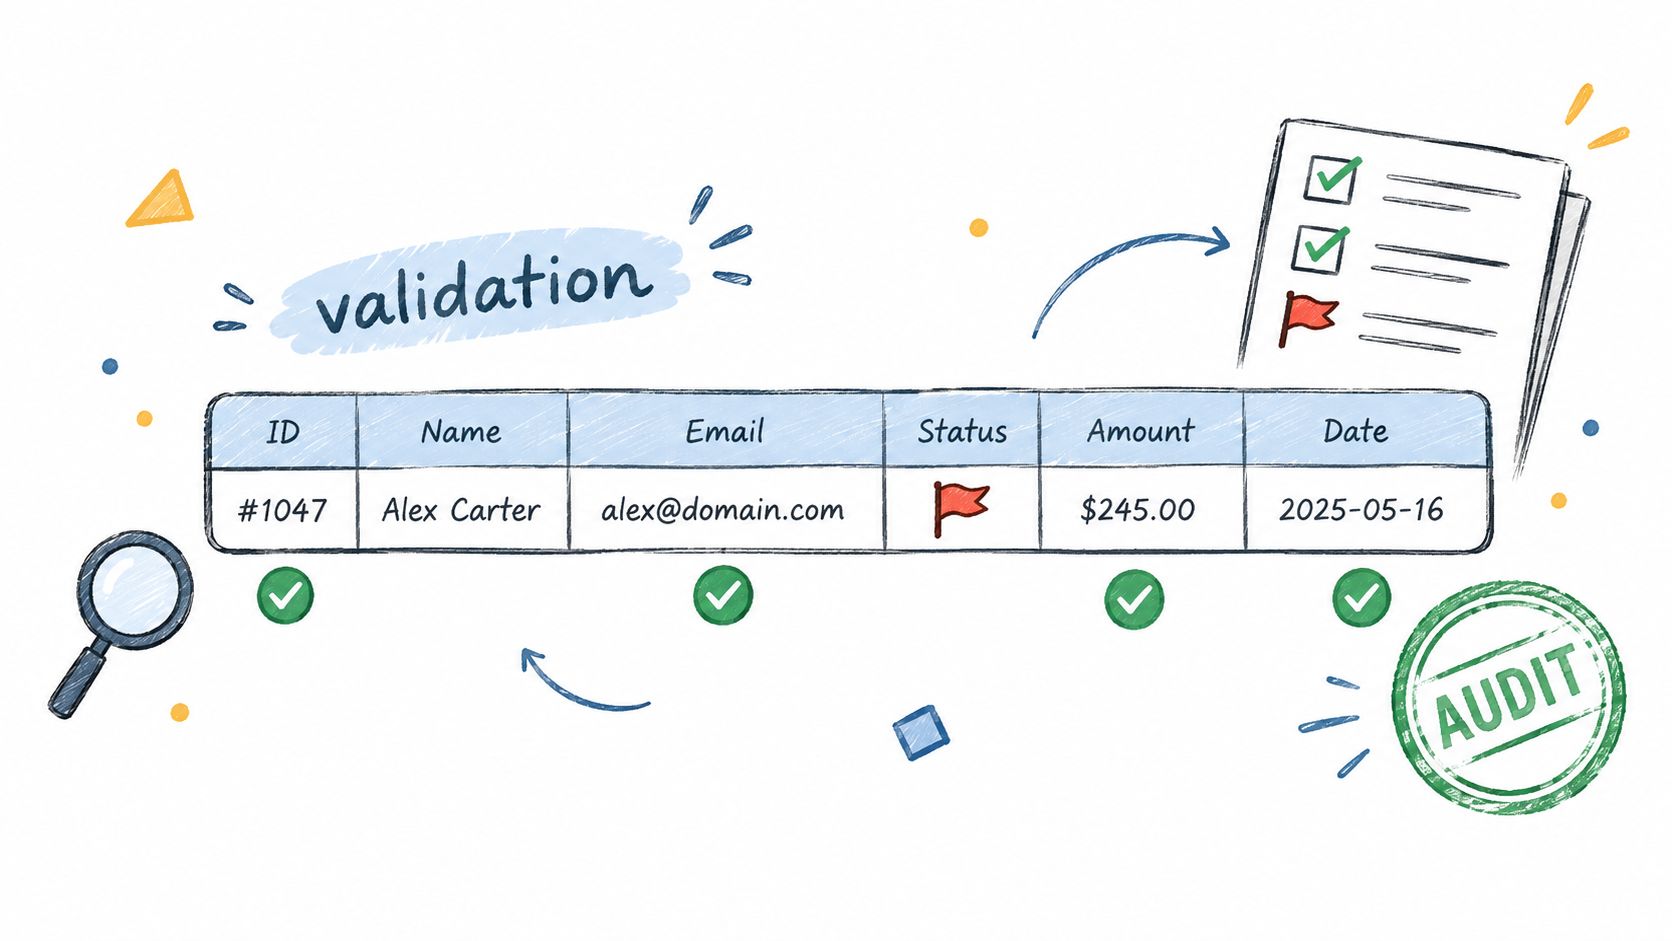
La validation au niveau de l'enregistrement répond à une question précise : cette ligne respecte-t-elle les règles qui la rendent exploitable ? Elle vérifie chaque enregistrement par rapport aux champs obligatoires, aux valeurs acceptées, aux plages, aux formats, aux relations et à la logique métier. Contrairement à un signal d'anomalie agrégé, elle peut identifier l'enregistrement, la règle et le résultat exacts qui nécessitent une correction.
Les types de règles courants incluent les contrôles de non-nullité, d'unicité, de type de données, de plage, de format, d'intégrité référentielle et de logique métier. Ce guide sur la validation des données décrit comment les équipes appliquent ces contrôles via des contraintes de base de données, la validation de schéma et des tests automatisés. Un établissement financier peut valider les plafonds de transaction et les exigences sur les contreparties. Un système de santé peut vérifier les identifiants patients et les codes de diagnostic. Un organisme public peut contrôler les informations de licence ou les champs d'éligibilité aux prestations.
Rendre les échecs traçables
Ne commencez pas par valider tous les champs de la même manière. Donnez la priorité aux enregistrements qui touchent le reporting réglementaire, les paiements, les décisions cliniques, l'identité des clients ou les KPI de la direction. Ce sont les responsables métier qui doivent définir ce que « valide » signifie, car une valeur techniquement acceptable peut tout de même enfreindre une politique opérationnelle.
Versionnez les règles et conservez les preuves de réussite ou d'échec. Les ingénieurs peuvent ainsi distinguer un défaut de la source d'un changement de politique délibéré, et les équipes de gouvernance disposent d'une piste d'audit.
Les règles de validation des données et la qualité des données en continu de digna prennent en charge une logique de validation personnalisée, exécutée dans la base de données, avec des résultats de règles traçables. Le compromis, c'est la maintenance. Les règles sont fiables pour les conditions connues, mais elles ne détectent pas un changement inhabituel tant que personne ne l'a formulé comme règle ou n'a associé la validation à la détection d'anomalies.
3. Surveillance de la fraîcheur et de l'arrivée des données avec calcul de l'heure de livraison attendue
Un dataset peut être complet et valide, et pourtant inutilisable parce qu'il est arrivé trop tard. La surveillance de la fraîcheur compare les arrivées réelles au comportement de livraison attendu et identifie les chargements retardés, les fichiers manquants, les arrivées anticipées et la dégradation progressive des performances d'une source. Elle protège les tableaux de bord, les modèles en aval, les rapprochements et les processus opérationnels qui dépendent de données disponibles à un moment précis.
Une équipe bancaire peut s'appuyer sur un moniteur de fraîcheur pour détecter un batch nocturne manquant avant le reporting du matin. Un établissement de santé peut enquêter sur des informations patients retardées avant qu'elles ne perturbent la coordination. Un opérateur télécom peut vérifier que les données d'usage ou de facturation arrivent à destination dans la fenêtre prévue. Le module Timeliness de digna calcule l'heure de livraison attendue à partir des schémas observés, au lieu de traiter chaque source comme si elle suivait le même calendrier.
Distinguer le retard de l'absence
Un seul moniteur ne devrait pas servir des sources aux rythmes de livraison différents. Définissez des attentes par source, par table ou par workload, et reliez les alertes au processus de gestion des incidents et d'astreinte. Une alerte qui reste dans un tableau de bord sans responsable n'est qu'un mécanisme de découverte tardive.
Associez la surveillance des arrivées à celle des volumes. Un fichier qui arrive à l'heure sans aucun enregistrement est une défaillance différente d'un fichier qui contient le volume attendu mais arrive en retard. Suivez aussi l'évolution du schéma de livraison dans le temps, car un pipeline qui glisse progressivement peut nécessiter une intervention avant de manquer une échéance formelle.
Cette définition de la fraîcheur des données et ce guide de surveillance fournissent un cadre utile pour distinguer la fraîcheur, les attentes de livraison et la réponse opérationnelle. Le principal compromis porte sur la sévérité des alertes. Les fenêtres fixes sont faciles à expliquer, tandis que les attentes apprises s'adaptent mieux aux opérations réelles mais doivent être revues quand les calendriers changent.
4. Détection des changements de schéma et surveillance structurelle
La dérive de schéma provoque des défaillances que les contrôles au niveau des lignes peuvent ne jamais voir. Un fournisseur peut ajouter un champ, supprimer une colonne, changer un type de données ou modifier une contrainte tout en continuant d'envoyer des enregistrements qui, pris un par un, semblent plausibles. Les transformations, rapports et modèles en aval peuvent alors échouer bruyamment ou, pire, continuer avec une interprétation modifiée.
La surveillance de schéma compare la structure entrante à une référence contractuelle approuvée. Elle peut quantifier le changement avec des mesures comme le taux de non-concordance des colonnes ou un score composite de similarité de schéma, ce qui rend les changements structurels compatibles avec des alertes automatisées. Ces métriques de dérive de schéma décrivent cette approche, qui mesure l'écart structurel plutôt que de traiter tous les changements comme également graves.
Mettre l'impact derrière l'alerte
Une colonne facultative ajoutée peut présenter un faible risque. Un identifiant supprimé ou un changement de type dans un flux réglementaire peut exiger un arrêt immédiat. Documentez les dépendances entre tables afin que l'alerte puisse identifier les jobs ETL, modèles sémantiques, tableaux de bord et data products concernés, au lieu d'envoyer les ingénieurs enquêter à l'aveugle.
L'explication de la dérive de schéma de digna décrit le risque opérationnel des changements structurels non annoncés. Son Schema Tracker détecte les colonnes ajoutées ou supprimées ainsi que les modifications de type de données. Associez la détection à un processus d'approbation des changements et à des tests de compatibilité automatisés. La surveillance seule vous dit que la structure a changé. La gouvernance détermine si le changement est autorisé, mis en quarantaine ou escaladé.
5. Analyse statistique et analyse des tendances des métriques de données
L'analyse statistique examine l'évolution des métriques de qualité et des indicateurs métier dans le temps. Elle peut révéler une dérive progressive, une volatilité changeante, des distributions inhabituelles et des schémas qu'une simple règle réussite/échec ne voit pas. Moyennes mobiles, analyse de l'écart-type et décomposition des tendances sont des choix utiles, mais la méthode doit correspondre à la métrique. Une mesure continue, une distribution catégorielle et un comptage d'événements n'ont pas le même comportement statistique.
Une équipe finance peut analyser la volatilité du chiffre d'affaires, tandis qu'un établissement de santé étudie les taux d'admission, les volumes de traitement ou les indicateurs de résultats. Une équipe télécom peut surveiller une hausse progressive des appels abandonnés ou une évolution du churn. Le module Data Analytics de digna est conçu pour l'analyse historique des métriques d'observabilité et du comportement métier, afin d'aider les équipes à déterminer si un changement est isolé ou s'inscrit dans une tendance.
Utiliser un historique représentatif
Une référence construite sur une période anormale peut mener à de mauvaises conclusions. Excluez les pannes connues, les migrations et les événements exceptionnels lorsqu'ils ne représentent pas le fonctionnement normal, ou annotez-les pour que les analystes puissent interpréter correctement le résultat. L'expertise métier reste indispensable, car une valeur statistiquement inhabituelle n'est pas forcément incorrecte du point de vue métier.
Pour les alertes d'anomalie, les intervalles de confiance et les règles d'écart glissant offrent des limites plus défendables que des seuils fixes arbitraires. Une approche documentée déclenche une alerte lorsqu'une métrique sort de l'intervalle de confiance à 99 % du même jour de l'année précédente, ou lorsqu'elle s'écarte de plus de 3 écarts-types d'une moyenne mobile. Ces exemples de détection statistique d'anomalies illustrent ces techniques.
Le compromis, c'est l'interprétabilité. Les méthodes statistiques détectent efficacement les schémas, mais les équipes ont besoin d'explications claires et de contexte avant de bloquer un pipeline ou d'escalader vers la direction. Consultez l'analyse des tendances des données de digna pour une approche analytique voisine.
6. Calcul et analyse des métriques directement dans la base de données
La surveillance de la qualité n'exige pas d'exporter les données de production vers un service externe. L'exécution dans la base de données calcule les métriques, lance les contrôles et réalise les analyses à l'intérieur du data warehouse, du data lake ou de la base de données du client. Cette architecture réduit les déplacements de données et répond aux exigences de gouvernance lorsque les enregistrements sensibles doivent rester dans l'infrastructure de l'organisation.
Un établissement financier peut exécuter des validations de conformité sur des données réglementées sans les copier ailleurs. Un établissement de santé peut évaluer la qualité des données patients tout en conservant les informations protégées dans son environnement contrôlé. digna exécute les contrôles d'anomalies, de validation, de fraîcheur et les contrôles associés dans les bases de données du client : la couche de surveillance peut ainsi inspecter les données sans prendre possession des enregistrements sous-jacents.
Protéger les performances autant que la confidentialité
L'exécution dans la base de données transfère la responsabilité à l'environnement de la base. Les requêtes de surveillance ont besoin des droits adéquats, idéalement en lecture seule, et doivent être conçues pour que les contrôles qualité n'entrent pas en concurrence avec les workloads de production. Planifiez le profilage coûteux ou l'analyse historique pendant les périodes de faible charge, puis mesurez la durée des requêtes et la consommation de ressources dans le cadre de la conception de la surveillance.
Garder les données en place réduit l'exposition, mais ne dispense pas du contrôle d'accès, de la gouvernance des requêtes ni des tests de performance.
Le compromis porte sur la portabilité et la complexité opérationnelle. Un contrôle qui fonctionne bien dans un data warehouse peut nécessiter une optimisation dans un autre, notamment lorsque la taille des tables, le partitionnement ou les profils de charge diffèrent. Les équipes doivent tester les plans d'exécution, utiliser le calcul incrémental lorsque c'est pertinent et surveiller la charge de la surveillance elle-même.
7. Surveillance des KPI métier et des métriques opérationnelles
Les signaux techniques de qualité comptent parce qu'ils influencent les décisions et les opérations. La surveillance métier relie les données sous-jacentes à des indicateurs comme le chiffre d'affaires, le volume de transactions, l'activité client, la conversion, les résultats de traitement, le churn ou la disponibilité du réseau. Une variation inattendue d'un KPI peut révéler un problème de données avant qu'un responsable technique ne remarque un test en échec, tandis qu'un pipeline techniquement sain peut tout de même produire un résultat métier qui mérite une investigation.
Une équipe financière peut constater une variation inattendue du chiffre d'affaires ou du volume de transactions. Un prestataire de santé peut surveiller les volumes d'admission et les résultats opérationnels. Un opérateur télécom peut suivre le churn, le revenu moyen par utilisateur ou la disponibilité du réseau. Il ne s'agit pas automatiquement de défauts de données. Un véritable événement de marché peut provoquer un véritable mouvement de KPI, c'est pourquoi la surveillance métier doit déclencher une investigation plutôt que conclure à une causalité.
S'entendre sur l'escalade avant l'alerte
Choisissez les indicateurs les plus critiques pour la prise de décision et définissez le comportement attendu avec leurs responsables. Indiquez qui reçoit une alerte, de quels éléments il a besoin et à quel moment le problème devient un incident métier. Si le KPI bouge, remontez la chaîne via les signaux de fraîcheur, de volume, de schéma, de validation, de source et de plateforme.
Les indicateurs métier sont aussi utiles pour prioriser. Un contrôle en échec sur une table de développement inutilisée ne devrait pas rivaliser avec un défaut plus modeste qui touche un rapport réglementaire. La configuration la plus solide relie les anomalies de KPI au lignage et au contexte technique, ce qui permet aux analystes et aux ingénieurs d'enquêter sur le même incident sous des angles différents.
Le module Business Monitoring de digna combine l'analyse des indicateurs métier et opérationnels avec les signaux de qualité plus larges nécessaires à l'analyse des causes racines. Le compromis pratique, c'est la responsabilité. Les équipes métier doivent aider à définir le sens et la matérialité des indicateurs, sinon les ingénieurs devront deviner quels changements comptent.
8. Observabilité de la plateforme de données et des workloads
Les contrôles sur les datasets peuvent montrer que les données sont fausses. L'observabilité de la plateforme aide à expliquer pourquoi. Elle surveille le comportement des workloads, la consommation de ressources, la disponibilité, les performances des requêtes, la durée des jobs et les changements de l'infrastructure qui déplace et stocke les données. Cette vue au niveau du système détecte des défaillances invisibles dans une table isolée.
Un job ETL peut durer plus longtemps parce qu'un data warehouse est sous pression. Un pic soudain de charge peut révéler des pipelines dupliqués ou une transformation inefficace. Un changement de plateforme peut affecter de nombreux datasets à la fois, même lorsque la dernière validation de chaque table a réussi. Ces signaux aident les équipes à distinguer un défaut de source d'un problème de capacité, d'un changement de configuration ou d'un déséquilibre de charge.
Corréler les signaux, sans les fusionner
Établissez le comportement normal de la plateforme, puis corrélez les écarts avec les incidents de qualité des données. Si plusieurs alertes de fraîcheur apparaissent après une hausse de la consommation de ressources, la télémétrie de la plateforme peut orienter l'investigation vers l'infrastructure. Si une seule source change alors que la santé de la plateforme reste stable, c'est la source ou la transformation qui mérite une attention particulière.
Gardez les incidents de plateforme distincts des défauts de données. Une requête lente ne signifie pas automatiquement des données erronées, et une table valide ne prouve pas que la plateforme est en bonne santé. Une responsabilité séparée peut améliorer la réponse, à condition que le système de gestion des incidents conserve les liens entre workload, pipeline, dataset et impact métier.
Le module Data Platform Observability de digna surveille la santé de la plateforme, le comportement des workloads, la consommation, la disponibilité et les signaux liés aux performances. Le compromis, c'est l'étendue. Plus de télémétrie peut produire plus de bruit : les équipes doivent donc définir quels changements de plateforme exigent une action immédiate et lesquels relèvent de la planification des capacités ou d'une revue d'ingénierie.
9. Tableaux de bord complets d'observabilité des données et surveillance collaborative
Un contrôle que seul un spécialiste sait interpréter ne passera pas à l'échelle d'une organisation data. La surveillance collaborative réunit résultats de validation, signaux d'anomalie, fraîcheur, changements de schéma, KPI, santé de la plateforme, responsabilités et historique des incidents dans des vues opérationnelles partagées. Les data engineers ont besoin de détails techniques, les analystes du contexte des indicateurs, les équipes de gouvernance de preuves, et les dirigeants d'une vue concise de la fiabilité et de l'impact.
Le tableau de bord doit s'adapter à ces décisions plutôt qu'afficher par défaut toutes les métriques disponibles. Un ingénieur peut avoir besoin de la règle en échec, de la partition source, de la requête et du lignage. Un analyste peut avoir besoin du KPI concerné, de l'état de fraîcheur et de la définition métier. Un responsable de la gouvernance peut avoir besoin du responsable, de l'historique de résolution et de la preuve qu'un contrôle s'est exécuté comme prévu.
Réduire délibérément la fatigue d'alerte
Regroupez les alertes liées en incidents, supprimez les doublons et affichez d'abord le signal le plus utile. Ajoutez des vues détaillées pour l'investigation, mais gardez l'écran par défaut centré sur ce qui demande une action. Le retour des utilisateurs est en soi un contrôle opérationnel. Si les équipes ignorent systématiquement une catégorie d'alerte, modifiez le seuil, le routage ou la conception du contrôle.
Intégrez le tableau de bord aux outils de communication des équipes et de gestion des incidents. Attribuez des responsables aux datasets et aux règles, consignez les étapes de correction et conservez la trace des décisions. La couche de visualisation devient alors un système de collaboration.
digna propose un tableau de bord centré sur l'utilisateur pour les ingénieurs, les analystes et les parties prenantes, avec une visibilité partagée sur les incidents, les tendances et les statuts. Le compromis, c'est la gouvernance du tableau de bord lui-même. Sans définitions ni responsabilités claires, une vue centralisée peut devenir un catalogue encombré de signaux non résolus plutôt qu'un outil de décision.
10. Architecture modulaire de contrôle qualité avec déploiement rapide
Le programme de qualité des données le plus efficace se construit généralement par couches plutôt qu'en un seul grand projet. Une architecture modulaire permet à une équipe de commencer par le mode de défaillance le plus dommageable, de prouver que le contrôle fonctionne, puis d'ajouter une couverture complémentaire sans remplacer le modèle opérationnel. Une organisation financière peut commencer par la validation et la détection d'anomalies, puis ajouter la surveillance de la fraîcheur et du schéma. Une équipe dans la santé peut démarrer par la gestion de la qualité et relier plus tard les indicateurs de résultats cliniques. Un opérateur télécom peut mettre en place l'observabilité de la plateforme avant d'étendre la démarche aux contrôles au niveau des enregistrements.
Ordonner les contrôles selon le risque
Commencez par une évaluation de la qualité des données qui identifie les datasets critiques, leurs consommateurs, leurs responsables et les incidents connus. Choisissez le premier module sur la base de faits, et non selon la fonctionnalité la plus facile à démontrer. Un problème de chargement manquant appelle une surveillance de la fraîcheur. Un flux fournisseur défaillant appelle un suivi du schéma. Un champ d'éligibilité incorrect appelle une validation des enregistrements.
Planifiez une feuille de route d'extension sur 6 à 12 mois, avec des jalons liés à la couverture et à la correction plutôt qu'à la seule installation. Obtenez le soutien de la gouvernance des données, prévoyez des capacités d'intégration en interne et n'utilisez les modèles sectoriels que comme point de départ. Les premiers succès doivent financer une adoption plus large, pas rester des démonstrations isolées.
Visez la couverture : ajoutez des contrôles qui révèlent des modes de défaillance différents, pas trois versions du même test.
La plateforme modulaire de digna inclut un planificateur, un catalogue de données, des intégrations et des fonctions de collaboration dès le choix du premier module. Les options de déploiement comprennent le cloud privé et l'installation on-premises dans le cloud, le VPC ou le data center du client. Le compromis, c'est la discipline. Les licences et le déploiement modulaires peuvent abaisser la barrière à l'adoption, mais les équipes ont toujours besoin d'un modèle de contrôle commun, de responsabilités cohérentes et d'une règle claire sur le moment où une alerte devient une tâche de correction.
Comparatif en 10 points : méthodes de contrôle de la qualité des données
Méthode | Complexité de mise en œuvre 🔄 | Ressources nécessaires ⚡ | Résultats attendus 📊 | Cas d'usage idéaux 💡 | Principaux avantages ⭐ |
|---|---|---|---|---|---|
Détection d'anomalies par IA avec apprentissage d'une référence | Moyenne à élevée ; nécessite des pipelines ML et du model ops | Moyennes à élevées ; historique de données et puissance de calcul | Élevés ⭐⭐⭐ ; détecte tôt les écarts nouveaux & subtils | Séries temporelles complexes, indicateurs métier saisonniers | Référence adaptative ; moins de faux positifs |
Validation des données au niveau de l'enregistrement selon les règles métier | Faible à moyenne ; rédaction et maintenance des règles | Faibles à moyennes ; moteur de règles et apport métier | Élevés ⭐⭐⭐ ; réussite/échec déterministe avec piste d'audit | Conformité réglementaire, intégrité transactionnelle | Violations traçables ; cibles de correction précises |
Surveillance de la fraîcheur et de l'arrivée des données avec calcul de l'heure de livraison attendue | Faible à moyenne ; planification + apprentissage des schémas | Moyennes ; historique des arrivées et intégration | Élevés ⭐⭐⭐ ; détection rapide des chargements retardés/manquants | Pipelines ETL, livraisons de données critiques pour les SLA | Alertes prédictives sur les défaillances de pipeline |
Détection des changements de schéma et surveillance structurelle | Faible ; suivi continu du schéma & mapping | Faibles à moyennes ; catalogue de métadonnées et de dépendances | Élevés ⭐⭐⭐ ; évite les défaillances bloquantes en aval | Flux fournisseurs, jobs ETL, systèmes sensibles au schéma | Alertes structurelles en temps réel et historique des versions |
Analyse statistique et analyse des tendances des métriques de données | Moyenne ; modèles statistiques et interprétation | Moyennes ; historique des métriques et temps d'analyste | Élevés ⭐⭐⭐ ; analyse des tendances et signaux d'alerte précoces | Indicateurs métier agrégés, détection de la volatilité | Analyse statistique contextualisée ; détecte les dérives progressives |
Calcul et analyse des métriques directement dans la base de données | Moyenne ; requêtes et optimisations propres à chaque base | Faibles à moyennes ; s'appuie sur les ressources existantes de la base | Élevés ⭐⭐⭐ ; contrôles sécurisés en temps réel avec peu de déplacements | Environnements de données sensibles, organisations axées sur la conformité | Résidence des données préservée ; moins de déplacements de données |
Surveillance des KPI métier et des métriques opérationnelles | Moyenne ; définition des KPI, mapping et tableaux de bord | Moyennes ; apport des parties prenantes et outils BI | Élevés ⭐⭐⭐ ; relie les problèmes de données à l'impact métier | Tableaux de bord de direction, suivi des OKR, supervision opérationnelle | Relie la qualité des données aux résultats métier |
Observabilité de la plateforme de données et des workloads | Élevée ; intègre une télémétrie multi-composants | Élevées ; télémétrie de la plateforme, logs et outils | Élevés ⭐⭐⭐ ; vision globale de la santé de la plateforme et des coûts | Exploitation de la plateforme, planification des capacités, optimisation des coûts | Détecte les problèmes d'infrastructure qui touchent de nombreux datasets |
Tableaux de bord complets d'observabilité des données et surveillance collaborative | Moyenne à élevée ; UX, vues par rôle et intégrations | Moyennes ; adoption transverse et outils | Élevés ⭐⭐⭐ ; réponse aux incidents plus rapide et meilleur alignement | Équipes transverses ayant besoin d'un contexte partagé | Vue centralisée ; moins de silos ; informations par rôle |
Architecture modulaire de contrôle qualité avec déploiement rapide | Faible à moyenne au départ ; extension modulaire à planifier | Faibles au départ ; évoluent avec les modules (paiement par table) | Élevés ⭐⭐⭐ ; valeur rapide et déploiement itératif | Adoption progressive, modèles sectoriels, pilotes rapides | Déploiement rapide ; extension incrémentale ; risque initial réduit |
Construire une pile de contrôles, pas une checklist
Les bonnes méthodes de contrôle de la qualité des données dépendent de la défaillance que vous devez détecter. La validation des enregistrements est la meilleure première réponse lorsque l'exigence est explicite : un identifiant non nul, une valeur autorisée, une plage valide, une référence correspondante ou une règle métier qui doit être respectée par chaque enregistrement. Elle produit des preuves concrètes et permet une correction ciblée, mais elle ne peut pas reconnaître tous les schémas inhabituels.
La détection d'anomalies et l'analyse statistique couvrent les changements de comportement. L'apprentissage d'une référence est utile lorsque le comportement normal varie avec la saisonnalité, la croissance ou la répartition des catégories. L'analyse statistique aide les équipes à comprendre les tendances, la volatilité et l'évolution des distributions dans le temps. Aucune de ces approches ne devrait bloquer automatiquement des données sans contexte. Une campagne légitime, une acquisition, une migration ou un événement opérationnel peut sembler anormal : les responsables ont donc besoin d'un moyen d'expliquer et d'approuver les changements attendus.
La surveillance de la fraîcheur traite la fiabilité des livraisons. Elle signale aux équipes qu'une source est arrivée en retard, en avance ou n'est pas arrivée au moment prévu. Associez-la à des contrôles de volume pour distinguer un chargement manquant d'un chargement vide ou partiel. Le suivi du schéma gère la dérive structurelle, notamment les colonnes ajoutées ou supprimées et les changements de type de données. La gravité doit dépendre des dépendances en aval. Une extension inoffensive et un changement d'identifiant bloquant ne devraient pas recevoir la même réponse.
L'architecture compte lorsque des contraintes de gouvernance, de confidentialité ou de résidence limitent les déplacements de données. L'exécution dans la base de données permet aux équipes de calculer les métriques et d'exécuter les contrôles là où se trouvent déjà les données, tout en exigeant contrôle d'accès, optimisation des requêtes et surveillance de la charge. La pile de contrôles a aussi besoin de contexte. La surveillance métier montre si un changement technique affecte le chiffre d'affaires, les transactions, les opérations, les résultats cliniques ou un autre indicateur de décision. L'observabilité de la plateforme aide à identifier les conditions de ressources, de charge, de disponibilité et de performance qui peuvent expliquer l'incident.
La couche opérationnelle détermine si la détection mène à une amélioration. Attribuez des responsables aux datasets critiques, documentez les définitions métier, reliez les alertes à la gestion des incidents et conservez les preuves de réussite ou d'échec avec la version de la règle qui les a produites. Utilisez des contrôles bloquants pour les violations qui rendent l'usage en aval dangereux, et des alertes d'anomalie non bloquantes lorsqu'une investigation est nécessaire avant d'agir. Fixez des seuils de conformité pour les contrôles explicites, et utilisez des intervalles de confiance ou des références apprises lorsque le comportement évolue dans le temps.
Un déploiement raisonnable commence par les datasets critiques plutôt que par l'ensemble du patrimoine de données. Cartographiez leurs consommateurs et leur historique de défaillances, choisissez le premier contrôle pour la lacune la plus risquée, et convenez d'un responsable et d'un circuit de réponse avant d'activer les alertes. Ajoutez ensuite des méthodes complémentaires, comme la validation avec la surveillance de la fraîcheur, la détection d'anomalies avec la surveillance du schéma, et les indicateurs métier avec la télémétrie de la plateforme. digna peut accompagner cette approche modulaire avec Data Anomalies, Data Validation, Timeliness, Schema Tracker, Business Monitoring et Data Platform Observability, le tout exécuté dans la base de données.
Le programme doit s'étendre lorsque les équipes peuvent montrer que les contrôles s'exécutent de manière régulière, que les incidents parviennent au bon responsable et que les corrections améliorent le processus en amont. C'est ainsi que la qualité des données devient une infrastructure opérationnelle plutôt qu'un audit périodique ou une longue checklist que personne ne relit.
digna est une plateforme de qualité et d'observabilité des données pour les entreprises qui s'exécute dans l'environnement du client et combine validation, détection d'anomalies, fraîcheur, schéma, surveillance métier et surveillance de la plateforme. Utilisez-la pour construire des couches de contrôle complémentaires autour de vos datasets critiques, puis découvrez la plateforme modulaire sur digna et planifiez votre premier déploiement autour du mode de défaillance qui compte le plus.
Si vous hésitez sur la couche à mettre en place en premier, la solution de gestion de la qualité des données de digna montre comment Data Validation, Data Anomalies, Timeliness et Schema Tracker fonctionnent comme des modules séparés dans votre propre base de données : vous pouvez commencer par un contrôle et ajouter les autres à mesure que la couverture s'étend.
Questions fréquentes
Quelles sont les principales méthodes de contrôle de la qualité des données ?
Les principales méthodes sont la détection d'anomalies, la validation au niveau de l'enregistrement, la surveillance de la fraîcheur, la détection des changements de schéma, l'analyse statistique des tendances, le calcul dans la base de données, la surveillance des KPI, l'observabilité de la plateforme, les tableaux de bord partagés et un déploiement modulaire. Chacune détecte un mode de défaillance différent, c'est pourquoi l'article recommande de les empiler en couches complémentaires plutôt que de s'appuyer sur un seul jeu de règles.
Quelle est la différence entre validation des données et détection d'anomalies ?
La validation prouve qu'une ligne précise a enfreint une règle connue, tandis que la détection d'anomalies signale un comportement qui s'écarte d'une référence apprise. Les règles vous donnent l'enregistrement exact et une piste d'audit, mais passent à côté des changements inhabituels, comme un effondrement de volume d'apparence légitime. La bonne pratique consiste à trouver l'inattendu avec les anomalies, puis à prouver les échecs avec la validation.
Comment définir les seuils des alertes statistiques de qualité des données ?
Utilisez des intervalles de confiance ou des règles d'écart glissant plutôt que des seuils fixes arbitraires. Une approche documentée déclenche une alerte lorsqu'une métrique sort de l'intervalle de confiance à 99 % du même jour de l'année précédente, ou s'écarte de plus de 3 écarts-types d'une moyenne mobile. Excluez d'abord les pannes et les migrations de l'historique de référence.
Pourquoi surveiller la fraîcheur des données si elles sont déjà validées ?
Parce qu'un dataset peut être complet et valide, mais inutile s'il arrive après l'exécution du rapport du matin. La surveillance de la fraîcheur compare les arrivées réelles aux heures de livraison attendues pour chaque source, et la combiner avec des contrôles de volume permet de distinguer un fichier en retard d'un fichier arrivé à l'heure mais vide.
Par où une équipe doit-elle commencer pour déployer des contrôles de qualité des données ?
Commencez par une évaluation de la qualité des datasets critiques, puis choisissez le premier contrôle pour la lacune la plus risquée : la fraîcheur pour les chargements manquants, le suivi du schéma pour les flux fournisseurs défaillants, la validation pour les champs incorrects. L'article recommande de planifier l'extension sur 6 à 12 mois, avec des jalons liés à la couverture et à la correction.


