Qu'est-ce qu'une base de données en mémoire ? Les compromis clés
|
7
minute de lecture

Une base de données en mémoire ne supprime pas le disque. Elle utilise la RAM comme couche de travail principale et le stockage persistant comme socle de reprise, ce qui explique qu'une architecture en apparence volatile puisse porter des workloads de production durables. L'argument de performance est tout aussi direct : des analyses du secteur ont décrit l'accès à la mémoire comme environ 10 fois plus rapide que l'accès au disque, et les références techniques actuelles associent les systèmes en mémoire à une latence de lecture de l'ordre de la microseconde et à une latence d'écriture de quelques millisecondes (Mordor Intelligence retrace l'évolution historique, AWS décrit le fonctionnement actuel des systèmes en mémoire).
Cela répond à la question de fond : qu'est-ce qu'une base de données en mémoire ? C'est une base de données conçue pour garder les données actives en mémoire principale, les traiter sur place et s'appuyer sur des journaux, des snapshots, des save points ou d'autres mécanismes de persistance pour se rétablir après une panne. Le gain de vitesse est réel, mais les coûts, les limites de capacité, les choix d'exploitation et les responsabilités en matière de durabilité le sont tout autant.
Table des matières
Le paradoxe de la vitesse - des données en mémoire, mais en sécurité sur disque
En mémoire ou stockage traditionnel - la réalité des performances
Résoudre l'énigme de la durabilité - persister sans pénalité
Une base de données en mémoire a-t-elle sa place dans votre stack ?
Le paradoxe de la vitesse - des données en mémoire, mais en sécurité sur disque
Le modèle mental courant est faux : « en mémoire » ne signifie pas « stocké nulle part ailleurs ». Un système de production garde les données fréquemment utilisées en RAM parce que le CPU peut y accéder sans attendre un aller-retour vers le stockage traditionnel, tandis que le stockage persistant conserve les informations nécessaires après un crash ou une coupure de courant. SAP présente la RAM comme l'emplacement central du traitement dans une base de données en mémoire, tout en exigeant un stockage sur disque ou SSD pour la persistance permanente (SAP explique la distinction fondamentale).
Pourquoi les ingénieurs acceptent le surcoût de la RAM
Prenons un service transactionnel qui doit consulter en permanence des comptes actifs, des événements récents ou l'état actuel des stocks. Une conception orientée disque paie sans cesse le coût des I/O de stockage. Une conception orientée mémoire paie davantage pour la RAM et pour les mécanismes qui la maintiennent alimentée, mais elle raccourcit le chemin entre une requête et les données nécessaires pour y répondre.
Cette architecture est devenue commercialement viable dans les années 1980 et au début des années 1990, lorsque la baisse du prix de la RAM et l'extension de la mémoire adressable en 64 bits ont rendu possibles des working sets plus volumineux. La version en mémoire d'IBM DB2 est sortie au début des années 1990 et, en 2014, une enquête DBTA citée dans l'historique du marché de Mordor Intelligence faisait état d'un usage de l'in-memory dans environ 32 % des entreprises, tandis que 75 % des répondants prévoyaient de l'étendre au cours des 3 années suivantes.
Règle pratique : considérez la RAM comme la surface de travail rapide, pas comme l'enregistrement permanent.
Cette distinction résout l'énigme de la coupure de courant. Si le serveur perd l'alimentation, la base de données ne compte pas sur la survie du contenu de la RAM. Elle reconstruit son état à partir d'enregistrements durables, puis recharge la mémoire. La conception exacte de la reprise varie selon les produits, mais la durabilité n'est pas une option pour un système qui gère des transactions.
Le compromis reste important. La RAM coûte plus cher que le stockage persistant, et tout garder en mémoire peut être du gaspillage quand seule une partie des données doit être accessible immédiatement. Les systèmes modernes combinent donc une exécution orientée mémoire avec des niveaux de stockage : les données chaudes restent en RAM et les données plus froides passent sur des SSD NVMe lorsque c'est pertinent (AWS décrit cette approche par niveaux).
Comment fonctionnent les bases de données en mémoire
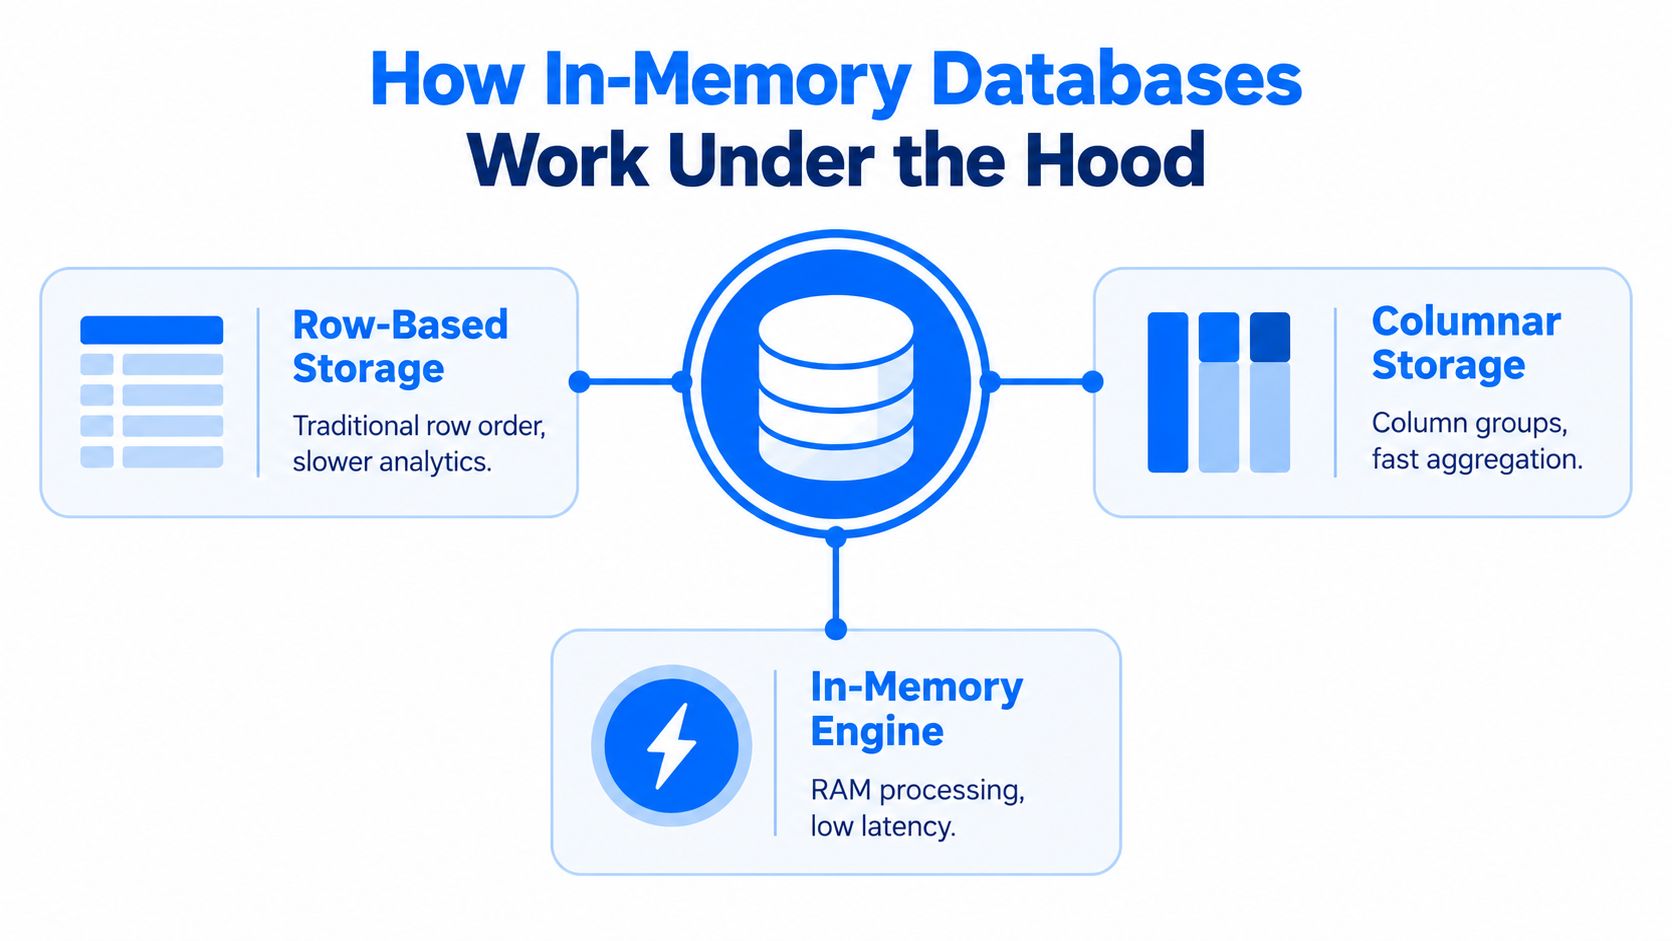
Une base de données en mémoire ne change pas seulement l'emplacement des données. Elle change ce que le moteur cherche à optimiser. Un système orienté disque est conçu pour minimiser les lectures sur le stockage, gérer des pages et exploiter efficacement un buffer pool. Un moteur en mémoire peut consacrer une plus grande part de sa conception à l'efficacité CPU, à la bande passante mémoire, à la compression, à l'exécution parallèle et à des chemins d'accès rapides.
Le premier choix d'architecture porte sur l'organisation des données. Le stockage orienté lignes regroupe les champs d'un enregistrement, ce qui convient à de nombreuses opérations transactionnelles qui lisent ou mettent à jour des enregistrements complets. Le stockage en colonnes regroupe les valeurs par colonne : une requête analytique qui n'a besoin que d'une mesure et de quelques filtres n'a donc pas à traiter chaque champ de chaque ligne. SAP cite l'organisation en colonnes et la distribution sur plusieurs serveurs comme des capacités importantes des systèmes en mémoire (présentation de HANA par SAP).
Compression et distribution
La compression compte parce que la RAM est précieuse. Les valeurs répétées, les colonnes triées et les encodages compacts permettent au moteur de garder davantage d'informations actives en mémoire et de réduire le volume de données que le CPU doit déplacer. La compression n'est pas gratuite pour autant. Le moteur consomme du temps CPU pour encoder et décoder les valeurs : la vraie question n'est donc pas de savoir si la compression existe, mais si son coût CPU est inférieur au coût mémoire et I/O qu'elle évite.
La distribution répond à une autre contrainte. Un seul serveur dispose d'une mémoire et d'une puissance de calcul limitées, si bien que les systèmes peuvent partitionner les données et les traitements sur plusieurs machines. Cela introduit de la coordination, du trafic réseau, des choix de réplication et des domaines de défaillance. Le scale-out peut étendre le working set, mais il ne rend pas les opérations distribuées gratuites.
La relation entre mémoire et disque doit rester explicite dans la conception. La RAM prend en charge le traitement actif, tandis que le stockage persistant assure la reprise et héberge les données plus froides. Certaines plateformes utilisent le tiering pour que les applications n'aient pas à gérer chaque déplacement manuellement. D'autres gardent en mémoire un working set plus réduit et choisi délibérément, et laissent la source de vérité dans une base de données classique.
Pour les équipes qui se demandent où le calcul doit avoir lieu, le traitement in-database offre un point de comparaison architectural utile. Exécuter les calculs au plus près des données peut réduire les déplacements, mais la base de données doit tout de même disposer de suffisamment de marge en mémoire, en CPU et en concurrence pour servir à la fois les requêtes opérationnelles et le travail analytique.
En mémoire ou stockage traditionnel - la réalité des performances
Les bases de données en mémoire sont plus rapides parce qu'elles retirent les I/O de stockage du chemin le plus sollicité, pas parce qu'elles changent le SQL lui-même. Le moteur doit toujours parser les requêtes, évaluer les prédicats, maintenir des index ou d'autres structures, coordonner les workers et gérer la contention. Un workload limité par le CPU ou un mauvais modèle de données peut annuler le bénéfice de garder les données en RAM.
Les références techniques décrivent couramment les bases de données en mémoire comme offrant des lectures à la microseconde et des écritures de quelques millisecondes. La latence réelle dépend du moteur, du matériel, de la configuration de durabilité, de la forme des requêtes et de la concurrence (AWS documente ces caractéristiques de latence). Ce profil convient aux décisions qui doivent être prises tant qu'un événement est encore d'actualité.
Performances : base en mémoire ou base sur disque
Indicateur | Base de données en mémoire | Base de données sur disque |
|---|---|---|
Latence de lecture | Évite la plupart des allers-retours vers le stockage, mais les cache misses, les verrous, la sérialisation et les sauts réseau affectent toujours la latence de queue | L'accès au stockage, les défauts de buffer cache, les index et la profondeur de file d'attente ajoutent un délai plus variable |
Latence d'écriture |
| La latence dépend du matériel de stockage, de la journalisation, des checkpoints, des index et de la contention du workload |
Profil de débit | Très adapté aux lectures fréquentes à faible latence et au traitement transactionnel actif | Très adapté au stockage orienté capacité, aux données d'archive et aux workloads batch |
Coût matériel | Coût mémoire plus élevé, avec d'éventuelles exigences de réplication et de persistance | Capacité moins chère par unité de données stockées, avec une dépendance plus forte à l'infrastructure de stockage |
Usage opérationnel idéal | Tableaux de bord en direct, services de décision, sessions et working sets qui évoluent rapidement | Données froides, longue rétention, grands historiques et traitements batch sans contrainte de délai |
Ce tableau sert aux décisions d'architecture, pas à comparer des produits selon leur étiquette. Une base de données sur disque peut surpasser un système en mémoire si la requête est mieux conçue, tandis qu'un système en mémoire peut décevoir si son working set déborde vers des niveaux plus lents. Mesurez ensemble le modèle d'accès et le comportement de durabilité.
La vitesse ne compte que si l'application peut tirer parti d'un temps de réponse plus court.
Évaluez la latence p95 et p99, les exigences de durabilité des écritures, l'utilisation de la mémoire, le comportement d'éviction ou de tiering, le retard de réplication et le temps de reprise. Le tuning des performances de base de données est pertinent, car la forme des requêtes et le comportement du workload peuvent annuler le bénéfice d'un stockage plus rapide lorsque les schémas d'exécution ne sont pas mesurés.
Résoudre l'énigme de la durabilité - persister sans pénalité
En mémoire ne veut pas dire sans stockage. La RAM fournit l'état de travail à faible latence, mais une base de données de production a toujours besoin d'enregistrements durables pour le redémarrage, le failover et la reprise après sinistre. La revue Springer traite de la durabilité et du benchmarking des IMDB et considère la persistance comme partie intégrante de la conception d'une base en mémoire, et non comme une protection optionnelle.
Journaux, snapshots et save points
Un journal de transactions enregistre les modifications dans une séquence durable. Après un redémarrage, le moteur charge un état de base sauvegardé et rejoue les entrées de journal concernées. Le travail validé est conservé, tandis que le traitement actif se poursuit sur les données résidant en mémoire.
Les save points et les snapshots définissent des points de reprise. À intervalles réguliers, le moteur écrit une représentation cohérente de l'état de travail sur le stockage persistant. Après un crash, la base de données doit restaurer cette représentation et appliquer les entrées de journal ultérieures. Une persistance plus fréquente peut réduire l'exposition lors de la reprise, mais elle consomme de la bande passante de stockage et peut entrer en concurrence avec les requêtes et écritures en cours.
La conception combine généralement quatre mécanismes :
Journalisation des transactions : enregistre les modifications pour la reprise et préserve durablement les transactions validées.
Save points : persistent un état récupérable sans réécrire l'ensemble du jeu de données à chaque opération.
Snapshots : créent une représentation durable à un instant donné qui peut accélérer le redémarrage et la reprise.
Sauvegardes asynchrones : exécutent les sauvegardes en arrière-plan, dans le respect des garanties de reprise de la base de données.
SAP indique qu'un stockage sur disque ou SSD reste nécessaire pour une persistance permanente après une coupure de courant ou une catastrophe, même lorsque les données sont disponibles en mémoire (recommandations de SAP sur la persistance). SAP HANA illustre cette même conception avec un traitement conforme ACID, des données en colonnes compressées en mémoire et des transactions validées persistées via la journalisation et les save points, afin que le système puisse se rétablir après un redémarrage (supports d'administration HANA de SAP).
Test de reprise : ne vous arrêtez pas à « la base de données a de la persistance ». Restaurez un nœud défaillant, rejouez les journaux et validez les transactions validées, comme décrit dans notre guide sur le database reliability engineering, puis mesurez le comportement de l'application pendant la reprise.
Les paramètres de durabilité révèlent un compromis direct. Une persistance agressive protège davantage d'écritures récentes, mais augmente la pression sur le stockage et le travail de coordination. Des paramètres plus souples peuvent améliorer le débit d'écriture tout en laissant davantage de travail à la reprise. Choisissez la configuration en fonction des conséquences métier d'une perte de données récentes, de l'objectif de reprise et de la capacité de stockage disponible pour le workload.
Cas d'usage en entreprise où la vitesse compte le plus
Une base de données en mémoire justifie son coût lorsqu'une réponse tardive change le résultat. Les meilleurs candidats génèrent des données en continu, les évaluent immédiatement et ne peuvent pas attendre un chargement dans le data warehouse ou un long cycle batch. La bonne question n'est pas seulement la vitesse d'exécution de la requête, mais ce que l'application doit faire lorsqu'un nœud redémarre.
Les services financiers en offrent un exemple clair. Une transaction arrive, et un service de détection de fraude a besoin du comportement actuel du compte, du contexte de la transaction et des signaux de risque avant de l'approuver ou de la contester. Garder ces signaux actifs en RAM raccourcit le chemin entre l'ingestion de l'événement et la décision. Le workload a tout de même besoin d'une politique de durabilité définie : les décisions validées doivent être récupérables, tandis que les features temporaires ou les signaux dérivés peuvent être reconstruits. L'analyse des risques en bénéficie pour la même raison, notamment lorsque les analystes ou les contrôles automatisés ont besoin de positions qui évoluent plutôt que des extractions de la veille.

Adapter le moteur à la décision
Les équipes de production industrielle et de logistique font face à un problème similaire. Les capteurs, les commandes, les mouvements de stock et les événements de livraison modifient en permanence la situation opérationnelle. Une couche orientée mémoire peut alimenter des tableaux de bord en direct, la détection d'exceptions, les décisions de dispatch et les vues de capacité sans faire passer chaque requête par un chemin analytique gourmand en stockage. Elle convient aux workloads où une information périmée peut entraîner une livraison manquée, un changement de production inutile ou une mauvaise décision d'allocation.
Définissez le working set actif avant de choisir la plateforme :
Identifiez la fenêtre de décision. Déterminez quels événements, entités et mesures doivent être disponibles immédiatement.
Séparez les données actives des données historiques. Gardez le contexte opérationnel actuel dans la couche rapide et conservez les enregistrements plus anciens dans des systèmes persistants adaptés.
Définissez le comportement en cas de panne. Décidez ce qui doit survivre à un redémarrage, ce qui peut être reconstruit et en combien de temps le service doit être rétabli.
Mesurez le chemin complet. Incluez l'ingestion, la transformation, l'exécution des requêtes, la persistance, la réplication et le temps de réponse de l'application.
SAP HANA est un exemple marquant de plateforme qui combine traitement transactionnel et analytique, ce qui peut supprimer une étape de déplacement des données entre les mises à jour opérationnelles et l'analyse. L'enseignement plus large dépend du workload : la consolidation aide lorsque des systèmes séparés ajouteraient un délai inacceptable, mais elle concentre aussi les enjeux de performance, de reprise et de capacité sur une seule plateforme.
La surveillance des données en temps réel exige plus qu'un moteur de requêtes rapide. Les équipes doivent savoir si les données sont arrivées, si leur structure a changé et si les valeurs restent plausibles. Une approche de surveillance des données en temps réel peut compléter la couche base de données en vérifiant le comportement et la disponibilité des données dont dépendent les applications rapides. Ces éléments ont leur place dans le modèle opérationnel, aux côtés des mesures de latence, de reprise et de capacité.
Idées reçues sur la technologie en mémoire
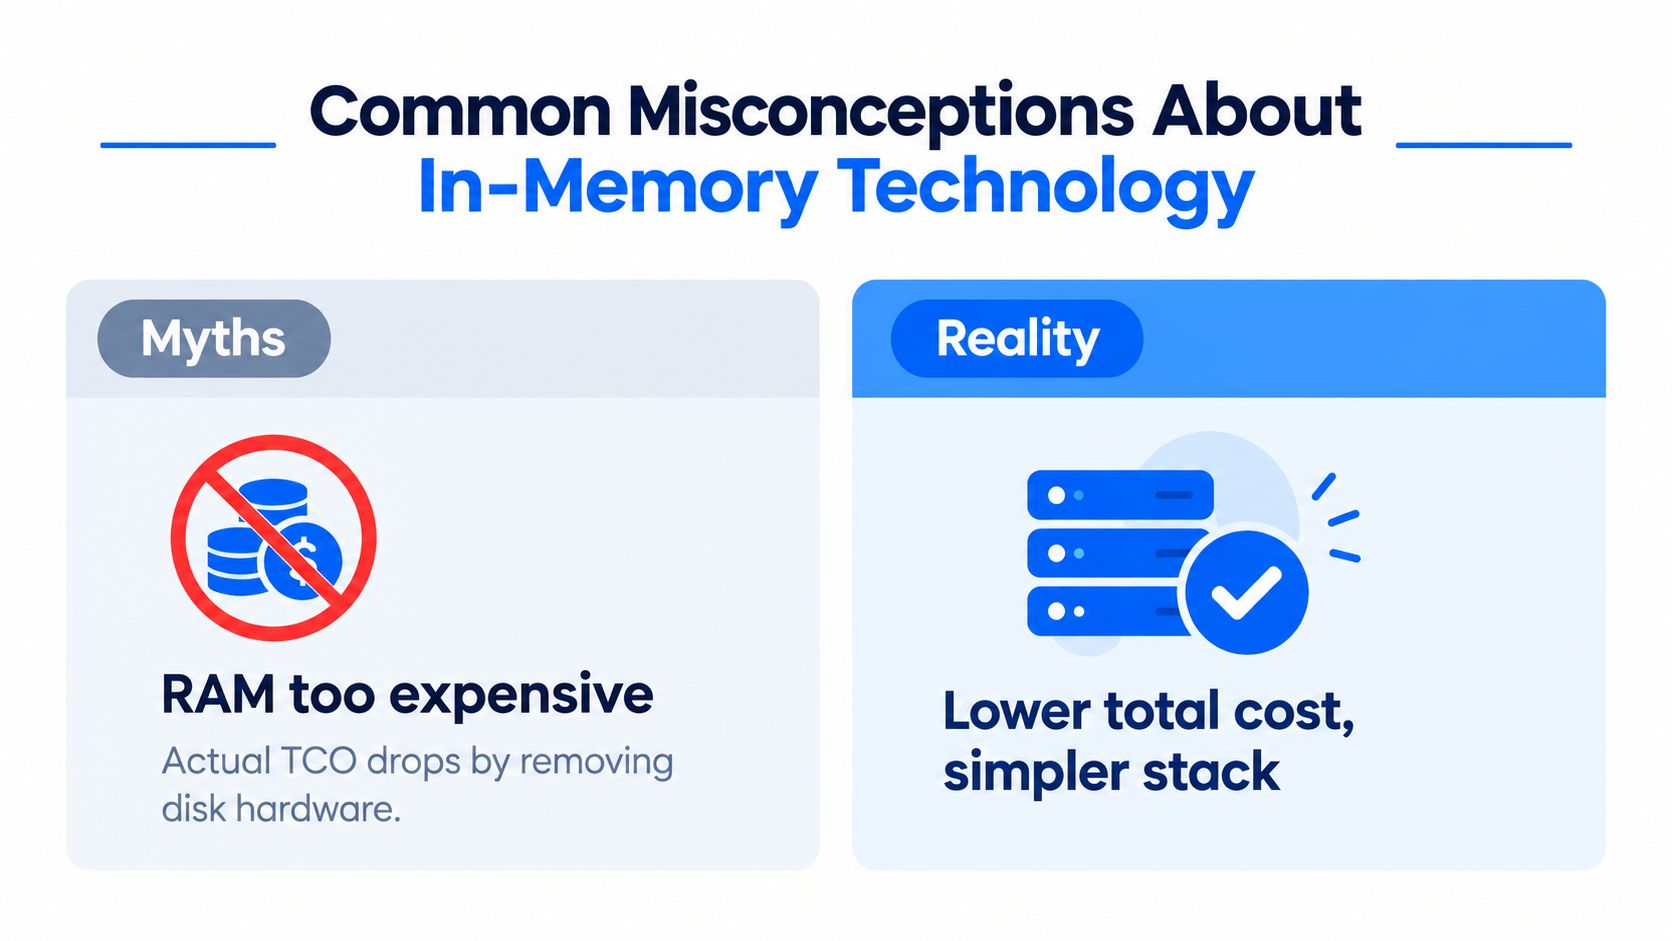
La première idée reçue veut que le coût de la RAM rende automatiquement une base de données en mémoire non rentable. La RAM coûte plus cher que la capacité disque, la préoccupation est donc légitime. Mais la comparaison ne devrait pas s'arrêter à la facture mémoire. Une conception orientée mémoire peut réduire les I/O répétées, simplifier certains chemins de traitement et supprimer des pans d'une architecture fragmentée. La baisse ou non du coût total dépend de la forme du workload, des licences, de la réplication, de l'exploitation et du volume de données qui nécessite un accès rapide.
Trois hypothèses à remettre en question
« L'ensemble des données doit tenir en RAM. » Pas nécessairement. Les architectures modernes peuvent placer les données chaudes en RAM et les données plus froides sur des SSD NVMe, tandis que les architectures distribuées peuvent répartir le traitement actif sur plusieurs serveurs (AWS décrit le tiering entre mémoire et SSD). La question de dimensionnement importante porte sur le working set actif et son modèle d'accès, pas seulement sur l'empreinte historique totale.
« En mémoire, les données disparaissent en cas de panne. » Un prototype purement en mémoire peut se comporter ainsi. Une base de données en mémoire de production utilise des mécanismes de persistance tels que des journaux, des snapshots ou des fichiers de reprise, et la configuration de durabilité détermine ce que le système peut reconstruire. Les équipes doivent tester ces garanties plutôt que de les déduire du nom du produit.
« Un stockage plus rapide règle tous les problèmes de base de données. » Ce n'est pas le cas. Des jointures mal conçues, une sérialisation excessive, la contention sur les verrous, une modélisation inefficace des données et une cardinalité non maîtrisée peuvent garder lent un moteur rapide. La technologie en mémoire supprime une catégorie de goulot d'étranglement, la latence du stockage, mais laisse le reste du système bien visible.
La bonne question n'est pas « Peut-on mettre cette base de données en mémoire ? », mais « Quelles données et quelles décisions justifient une exécution orientée mémoire ? »
Une autre idée reçue veut qu'une seule architecture doive servir tous les workloads. Les archives historiques, les grands stockages à longue rétention et les transformations batch tirent souvent parti d'un stockage persistant orienté capacité. Une couche en mémoire peut cohabiter avec ces systèmes et accélérer le chemin actif sans devenir le seul endroit où résident les données.
Une base de données en mémoire a-t-elle sa place dans votre stack ?
Choisissez le workload avant le produit. Une base de données en mémoire convient lorsque les utilisateurs ou les services exigent une latence faible et constante, que les transactions arrivent en continu, que les enregistrements actifs sont souvent réutilisés et que les décisions tardives génèrent des coûts opérationnels. Elle est moins adaptée aux accès d'archive, aux requêtes batch planifiées ou à un working set trop froid pour justifier son empreinte en RAM.
Utilisez ce filtre de décision :
Choisissez l'exécution orientée mémoire pour les signaux de fraude, les vues opérationnelles en direct, l'état de session, les décisions à haute fréquence et les workloads où les I/O de stockage dominent le temps de réponse.
Gardez le stockage traditionnel au centre pour les archives froides, les jeux de données à longue rétention, le reporting occasionnel et les traitements batch aux fenêtres d'exécution souples.
Optez pour une architecture hybride lorsque seule une partie du jeu de données nécessite un accès immédiat et que le reste demeure sur des niveaux persistants.
Le marché a dépassé le stade de l'expérimentation de niche. Les estimations situent le marché mondial des bases de données en mémoire à environ 7,20 milliards USD en 2024, 8,14 milliards USD en 2025 et 9,05 milliards USD en 2026, pour atteindre 15,31 milliards USD d'ici 2031, selon l'estimation de marché de Fortune Business Insights. La croissance du marché soutient une adoption continue, mais elle ne remplace ni les tests de workload ni la validation de la reprise après panne.
Avant de vous engager, benchmarkez des requêtes représentatives, vérifiez la persistance lors d'une coupure de courant et d'un redémarrage, mesurez la pression mémoire et contrôlez le comportement du tiering. Optimisez le chemin SQL grâce à l'optimisation des requêtes SQL, puis comparez les gains de latence mesurés aux coûts de mémoire, de licences, de réplication et d'exploitation. Le résultat doit être un choix d'infrastructure fondé sur le système que vous exploitez réellement.
digna aide les équipes data à surveiller les anomalies, la ponctualité des données, les changements de schéma et les contrôles de qualité au niveau des enregistrements, directement dans leurs propres bases de données. Si une architecture en mémoire dépend d'entrées actuelles et fiables, rendez-vous sur digna pour évaluer une approche d'observabilité in-database.
Un moteur rapide n'est utile que si les données qui l'alimentent sont à jour : il vaut donc la peine de vérifier si chaque table source est réellement arrivée à l'heure prévue. Découvrez comment digna Timeliness apprend les schémas d'arrivée attendus et signale les chargements en retard ou manquants.
Questions fréquentes
Une base de données en mémoire perd-elle ses données en cas de coupure de courant ?
Pas dans un système de production. La RAM sert de surface de travail rapide, pas d'enregistrement permanent : après une coupure de courant, le moteur restaure un état sauvegardé depuis le disque ou le SSD, puis rejoue son journal de transactions. SAP HANA, par exemple, persiste les transactions validées grâce à la journalisation et aux save points.
Une base de données en mémoire est-elle beaucoup plus rapide qu'une base sur disque ?
L'accès à la mémoire a été décrit comme environ 10 fois plus rapide que l'accès au disque, et les références techniques citent des lectures à la microseconde et des écritures de l'ordre de quelques millisecondes. La latence réelle dépend toutefois du matériel, des paramètres de durabilité, de la forme des requêtes et de la concurrence : mesurez donc la latence p95 et p99 plutôt que de vous fier aux chiffres annoncés.
Toutes mes données doivent-elles tenir en RAM ?
Non. Les architectures modernes gardent les données chaudes en RAM et déplacent les données plus froides vers des SSD NVMe, et les déploiements distribués répartissent le working set sur plusieurs serveurs. La vraie question de dimensionnement porte sur le working set actif et sur la manière dont on y accède, pas sur l'empreinte historique totale de la base.
Quand faut-il choisir une base de données en mémoire plutôt qu'une base traditionnelle ?
Lorsqu'une réponse tardive change le résultat : signaux de fraude, tableaux de bord opérationnels en direct, état de session ou décisions de dispatch. Les archives froides, les données à longue rétention et les traitements batch aux fenêtres souples relèvent généralement d'un stockage sur disque orienté capacité, tandis qu'une architecture hybride convient aux workloads dont seule une partie des données est chaude.
Quelle est la différence entre fsync-per-commit et group commit ?
Les deux déterminent le moment où les écritures atteignent le stockage durable. Fsync-per-commit force l'écriture de chaque transaction immédiatement, ce qui offre la durabilité la plus forte avec un coût plus élevé par écriture. Le group commit regroupe plusieurs flushs, ce qui augmente le débit mais ajoute de la coordination au commit : le bon choix dépend de ce que coûterait la perte des écritures les plus récentes.


